LearnWeak:教小型桌面代理補弱變強

先找弱點,再補訓小型桌面代理。對要把模型用在指定軟件流程的人很有參考價值。

LearnWeak method

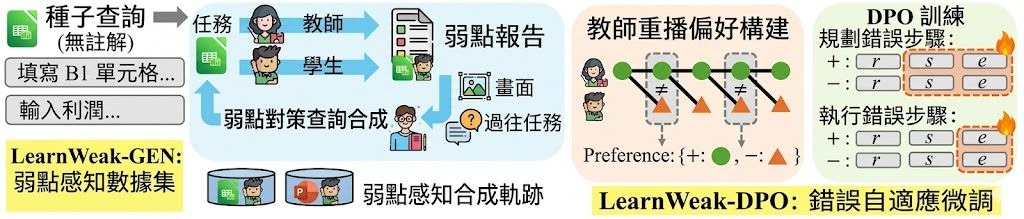
LearnWeak 針對一個常見的 Computer-use agents(CUA) 痛點:小型桌面代理雖然便宜又快,但去到指定軟件時,成功率往往不穩。它不是盲目加資料,而是先找出學生模型的弱項,再集中補訓。

LearnWeak 建議先用 meituan/EvoCUA-8B-20260105 做底座,再按軟件掛上對應 LoRA,例如 learnweak-gimp。完整流程會配合 OSWorld,呼叫時記得選對模組名。

• 先辨認學生模型弱點,再自動生成針對性練習任務
• 用教師與學生的操作軌跡差異建立監督,毋須人工標註
• 訓練時分開處理規劃錯誤與執行錯誤,更新更精準
• 已有 GIMP、LibreOffice Calc、Impress、Writer、Thunderbird、VLC、VS Code、OS 的 LoRA 模組

它把學生(代理)弱點直接帶入資料生成與訓練,不再用同一套監督硬套所有錯誤。論文指出,在 OSWorld 八個桌面範疇,它平均比 EvoCUA-8B 高 11.6 個百分點,亦比 OpenCUA-7B 高 11.1 個百分點。

這項目適合要把小模型鎖定在指定桌面工作流的團隊,例如內部工具、自動化測試或較重視私隱的環境。它未必是即裝即用的一般工具,但對研究者、代理開發者,以及想低成本做範疇微調的人,很有參考價值。

GitHub: https://github.com/sujiikim/LearnWeak

Paper: https://arxiv.org/pdf/2605.28775

Categories: Agentic, 模型, 深度學習

AIQ 為代理工具加上深度研究能力

NVIDIA AI-Q把深度研究流程封裝成可重用技能,讓代理工具更易處理多來源分析。

Og image

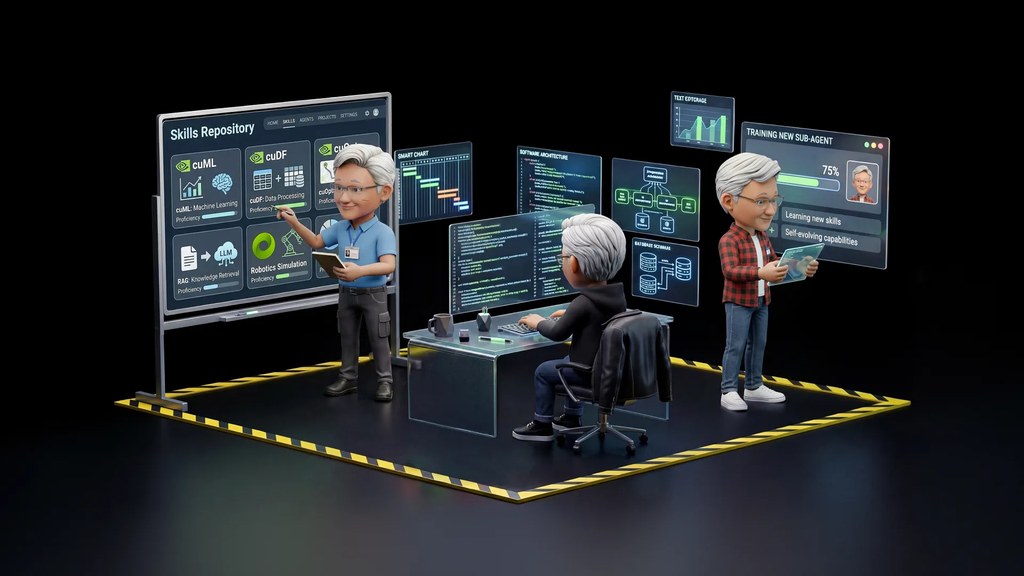
不少代理工具本身已很擅長協調流程,例如管理對話、串接工具和執行程式碼;但一到需要整合多份文件、引用來源、或根據企業資料整理長篇分析,開發團隊往往要自行處理大量繁瑣工作。這篇內容介紹的 NVIDIA AI-Q,重點正是把這類深度研究能力封裝成可攜的項目技能,讓代理工具直接調用。

它解決的問題很明確:團隊不用再為每個項目重建檢索、規劃、整理、引用與評估流程。代理工具可把研究任務交給本機或託管的 AI-Q 伺服器,之後收回一份有結構、附引用的報告;而敏感資料亦可留在企業內部環境,對醫療、金融、政府及國防等重視資料管控的場景尤其重要。

上手方式亦相對直接。這個項目提供 SKILL.md 說明檔,以及一個輔助腳本去處理請求路由、提交工作、輪詢進度和取回結果。使用前需要 Python 3.10 或以上,並準備一個可連線的 AI-Q Blueprint 伺服器;預設會連到本機位址,也可透過環境變數改寫。

Give Codex a Deep Research Skill With NVIDIA AI-Q

重點可概括如下:
– 把深度研究流程包裝成代理工具可調用的技能
– 支援多來源資料整合,並輸出附引用的報告
– 減少每個項目重複搭建研究流程的工作
– 讓敏感資料可保留在企業內部環境
– 可配合 Claude Code、Codex 等通用代理工具使用

這個項目的創新之處,在於它不是只提供單一工具函式,而是把意圖分類、澄清問題、淺層研究、深度研究與評估整合成較高層的能力。換句話說,代理工具只需學會如何委派,便可利用完整研究管線,較適合想快速為現有代理系統加入研究能力的團隊。文中未見具體效能數字或基準測試,因此現階段較適合把它理解為一個工程整合與工作流程簡化方案。

模型列表:Claude Code、Codex

GitHub: https://github.com/NVIDIA-AI-Blueprints/aiq/tree/v2.1.0

項目: https://developer.nvidia.com/blog/add-a-specialized-deep-research-skill-to-agent-harnesses/

Categories: 開源, Agentic, NVIDIA, 框架

Aurora:把影片編輯指令講清楚的 AI 代理

Aurora 想處理影片編輯最麻煩的一步:把含糊要求轉成可執行流程。它把代理式理解與影片生成結合,方向幾幾清晰。

Repository image for yeates/Aurora

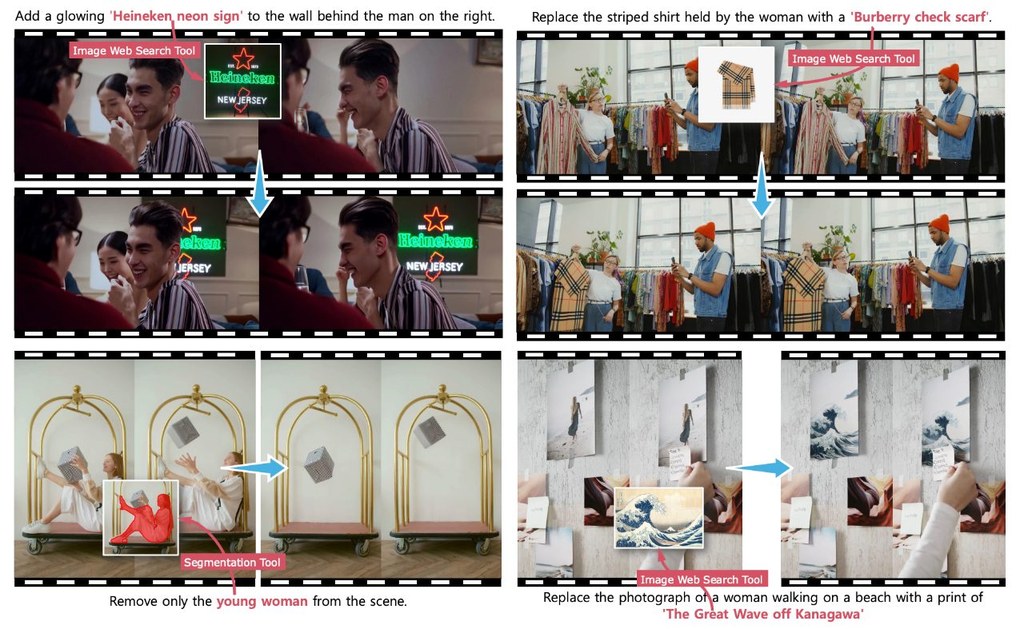
Aurora 是一個面向影片編輯的 AI 項目,重點不只是「生成畫面」,而是先理解你想改甚麼。它把使用者一句較口語、甚至有點含糊的要求,整理成較明確的編輯計劃,再交給影片模型處理,目標是減少「講唔清、改唔準」的情況。

這個項目想解決的核心問題,是影片編輯要求經常不完整。你可能只說想「換走背景」、「刪除路人」或「改成某種風格」,但未必提供參考圖,亦未必指出遮罩範圍;Aurora 會嘗試補回這些缺口,例如用圖像搜尋找參考,或用分割方式找出需要修改的位置。

它較有新意的地方,在於把多種影片編輯工作放進同一個框架,而不是每種效果各自一套模型。根據目前資料,這個項目支援替換、移除、風格轉換,以及根據參考內容插入元素,背後並結合了工具增強的視覺語言模型代理,以及統一的影片 diffusion transformer,也就是影片 DiT。

動手了解這個項目時,可先把它當成「會先幫你整理需求的影片編輯助手」。現階段儲存庫內容顯示官方實作仍在準備中,所以較適合先閱讀論文與項目頁,理解它如何把原始要求拆成指令、任務標籤、圖像搜尋查詢與遮罩描述四部分,再留意之後公開的程式。

  • 同一個項目框架處理多類影片編輯工作
  • 會先重寫使用者要求,再交由影片模型生成
  • 可補足缺少的參考圖與編輯區域資訊
  • 相關模型重點包括工具增強 VLM 代理與影片 DiT
  • 另有 AgentEdit-Bench,用來評估這類代理式影片編輯能力

對內容創作者、影像研究人員,或者關心人機協作編輯流程的人來說,Aurora 特別值得留意。它未必是即刻可用的成品,但從設計方向看,這個項目著重的不是單次炫技效果,而是令影片編輯指令變得更完整、更可執行。

GitHub: https://github.com/yeates/Aurora

Paper: https://arxiv.org/pdf/2605.18748

Categories: 開源, Agentic, NVIDIA, 框架, 中國

AutoResearchClaw:由想法走向論文的 AI 流程

項目把研究流程自動化,從一句想法延伸到實驗與論文草稿。重點不只快,還加入多代理協作與人類參與。

AutoResearchClaw Logo

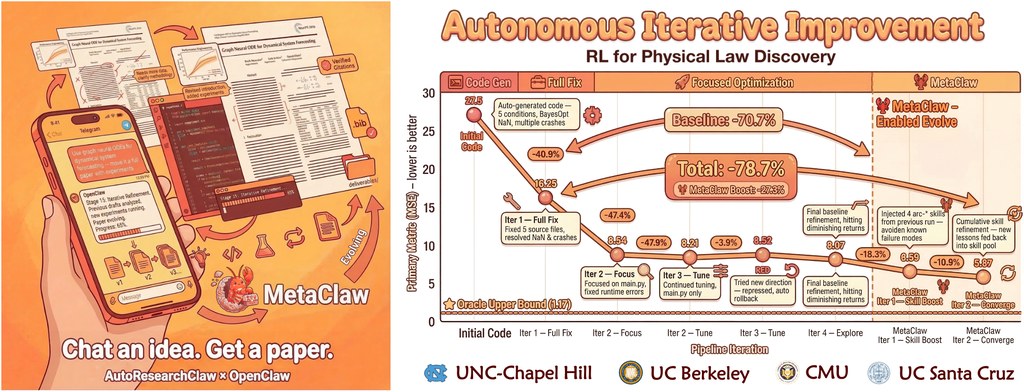
AutoResearchClaw 是一個面向研究工作的 AI 項目,目標不是單純幫你寫字,而是把「提出題目、討論假設、安排實驗、整理結果、輸出論文」串成一條連續流程。由描述可見,它特別針對傳統線性流程的限制,嘗試讓系統在失敗後仍可調整方向,而不是一步出錯就停住。

動手理解這個項目,最自然的方法是把它當成一位研究助理:先輸入一個研究主題,再讓系統展開分析、規劃與生成。它亦支援與 OpenClaw 配合,而人類介入功能預設為關閉,代表你可以先用原本流程體驗,再按需要加入審批或協作節點,不會一下子改變整套使用習慣。

這個項目較有意思的地方,在於它不只靠單一模型一次過完成工作。根據論文介紹,它結合多代理辯論、失敗後修正的執行機制、可驗證的結果彙報,以及跨次任務累積經驗的設計,方向上比一般「輸入提示詞、輸出文章」的工具更接近真正研究循環。

  • 以一句研究想法作為起點,嘗試延伸成完整研究流程
  • 強調多代理協作,而非單一路徑生成內容
  • 支援人類參與模式,但預設不影響原有流程
  • 可選整合 MetaClaw,核心流程毋須新增依賴
  • 已通過 2,699 項測試,顯示整合新功能後穩定性未見明顯倒退

適合的場景包括學術探索、研究提案發想、實驗規劃初稿,以及想觀察 AI 如何拆解研究問題的人。相關比較對象可留意 AI Scientist v2,論文亦直接以 ARC-Bench 作基準比較;若你關心的是代理式研究系統,而不只是聊天機械人,這個項目值得放入觀察名單。不過它產出的內容仍應由研究者覆核,尤其在方法設計、引用與結論判斷上更需要人手把關。

GitHub: https://github.com/aiming-lab/AutoResearchClaw

Paper: https://arxiv.org/pdf/2605.20025

Categories: 開源, Agentic, OpenClaw

SkillsVote:幫 AI 代理揀啱技能

面對海量 Agent 技能,SkillsVote 嘗試解決「點揀、點評估、點更新」三個難題。它特別適合需要管理大型技能庫的團隊。

pipeline

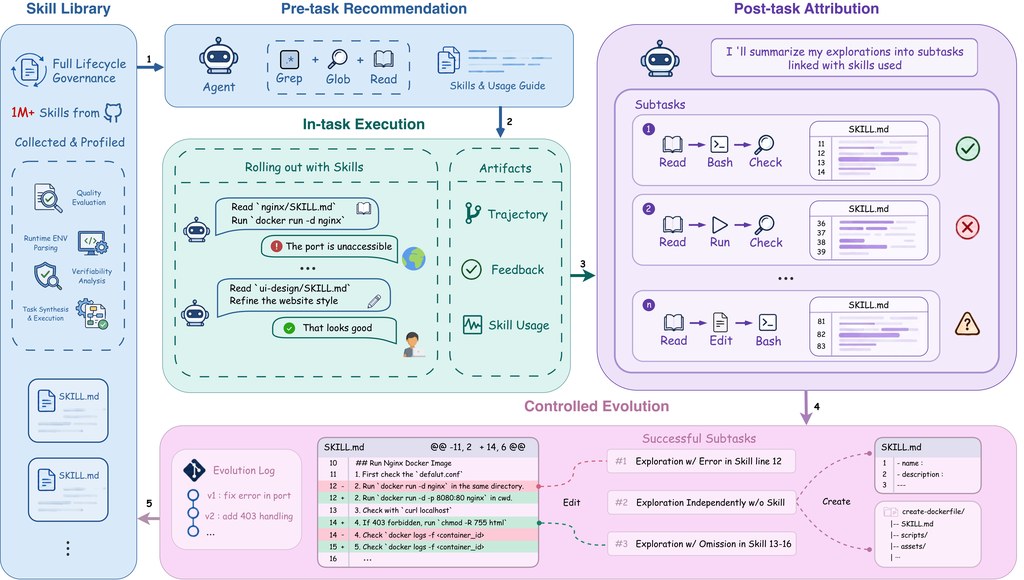
近年愈來愈多 AI 代理會靠「技能」完成寫程式、研究整理或流程自動化,但技能數量一多,就唔再係人手揀幾個清單咁簡單。SkillsVote 針對嘅,正正係大型技能庫管理:先由公開 GitHub 收集到超過 168 萬份 SKILL.md,當中約 79 萬份通過格式驗證,再進一步處理點樣推薦、判斷成效同持續整理。

實際使用上,呢個專案比較似一套治理層,而唔只係單一模型或插件。公開版本已經提供技能分析與前處理、實驗重現腳本,以及兩條整合路線:一條連接託管服務做雲端推薦,另一條係本地版 skills-vote-local,支援私有環境用代理式搜尋或向量搜尋去搵合適技能。

它較特別之處,在於唔係單靠關鍵字配對,而係把技能當成可持續管理嘅資產。簡單講,系統會先分析技能需要咩執行環境、依賴項同質素,再喺任務開始前做即時推薦;完成後再根據執行軌跡、使用情況同驗證訊號,較審慎咁判斷某項技能有冇真正幫到手。

  • 已整理大規模技能庫,適合唔想由零開始收集技能嘅團隊
  • 提供雲端版同本地版整合,方便公開或私有部署場景
  • 重點唔止推薦,仲包括品質分析與後續更新治理
  • 較適合 coding agent、research agent、workflow agent 相關應用
  • 文中涉及的模型與評測包括 GPT-5.2、GPT-5.4 mini、Terminal-Bench 2.0、SWE-Bench Pro

對開發團隊而言,較自然嘅做法係先用本地或託管整合,把現有技能庫接入,再觀察系統推介結果同任務軌跡。現有資料亦顯示,它把重點放喺「唔更新模型本身,都可透過外部技能庫改善代理表現」;至於本地歸因與技能演化功能,儲存庫顯示仍在補完中,所以部署前可先視作一個已具雛形、但仍持續擴展嘅技能治理方案。

GitHub: https://github.com/MemTensor/skills-vote

Paper: https://arxiv.org/pdf/2605.18401

Categories: Agentic, 影像處理, Skill 技能

CiteVQA

答啱問題未必代表可信。CiteVQA專門檢查模型有冇引用到真正證據位置。

CiteVQA overview

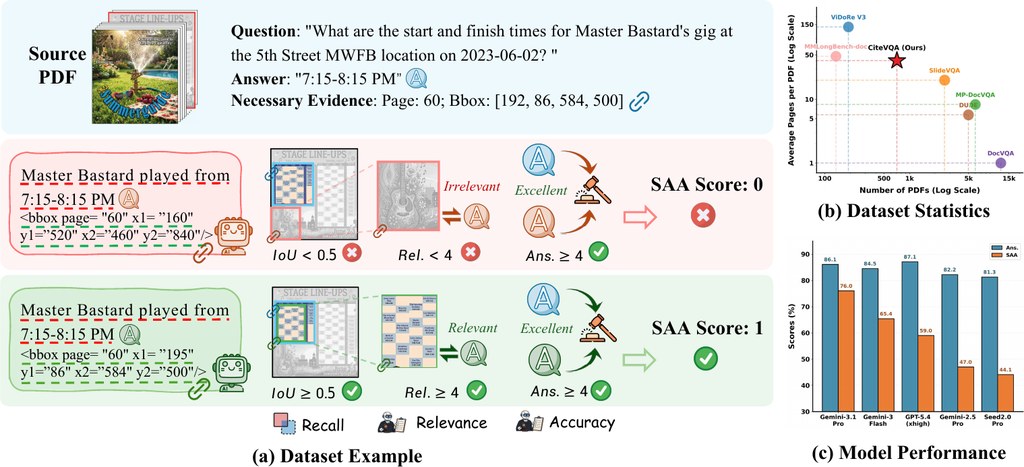
做文件問答評測時,很多工具只睇最後答案啱唔啱,但現實上,尤其是合約、財務報告、醫療文件呢類長篇 PDF,真正重要的是「答案來自邊一頁、邊一段、邊個區塊」。CiteVQA 針對的正正是這個缺口:它不只要求系統回答問題,仲要指出支撐答案的文件位置,而且細到元素層級,例如頁碼同區域框選。對想評估文件 AI 是否可靠的人來講,這比單純比拼答題分數實用得多。

實際使用上,這個專案較適合作為評測基準,而唔係一般用家即開即用的聊天工具。研究團隊、產品開發者或企業內部做文件自動化測試時,可以先取得資料集,再用自己的多模態模型跑推論,之後交畀評估程式比對答案與引用位置是否同樣正確。資料涵蓋英文與中文文件,來自 711 份 PDF、共 1,897 條問題,平均每份文件超過 40 頁,亦分成單一文件問答,以及要在多份文件中找答案的情境,難度相當貼近真實工作流程。

這個專案最值得留意的地方,是它把「答對」與「引對證據」綁埋一齊計分。核心指標 SAA 只有在答案正確,而且引用區域同標準證據對得上時先會得分,能更直接揭示模型有冇出現「講得似乎合理,但引用錯地方」的情況。根據公開結果,即使是表現較強的模型,答案分數與這種嚴格分數之間仍有明顯差距,反映現時不少系統其實未真正做到可追溯。這一點對高風險場景尤其重要,因為用戶要的不只是結論,仲要查得到根據。
重點可簡單整理成以下幾點:
– 不只評分答案,亦檢查引用證據是否真係來自正確頁面與區域
– 文件夠長亦夠真實,涵蓋 7 個大類領域、30 個細分類,並支援中英文
– 場景設計多樣,包括單文件、多文件但只有一份正確來源,以及多份來源都可能成立
– 適合測試文件型多模態模型,特別係要處理 PDF 版面、圖文混合與跨頁搜尋的系統
– 可用來比較模型可靠度,而唔係只比較誰的答案最似正解

從模型觀察角度看,這個基準亦提供了不錯的參考名單。公開結果提到的相關模型包括 Gemini-3.1-Pro-Preview、Gemini-3-Flash-Preview、GPT-5.4、Gemini-2.5-Pro、Seed2.0-Pro、GPT-5.2、Qwen3.6-Plus、GLM-5V-Turbo、Qwen3-VL-235B-A22B、Gemma-4-31B、Kimi-K2.5、Qwen3.5-397B-A17B 等。由這些結果可見,封閉模型在整體表現上暫時較領先,但開源模型同樣能作為對照組,方便團隊用統一方式測試自家方案。對要建立文件審核、知識搜尋、報告核對、法規查證流程的人來說,CiteVQA 的價值不在於幫你直接產生答案,而在於幫你分辨:哪個模型,才真係值得信。

GitHub: https://github.com/opendatalab/CiteVQA

Paper: https://arxiv.org/pdf/2605.12882

Categories: 開源, 上海人工智慧實驗室, Agentic, 中國

MMSkills:幫視覺代理學識睇畫面做事

MMSkills把可重用操作經驗整理成多模態技能包,讓視覺代理做桌面與遊戲任務時更穩定。它亦曾在2026年5月18日登上 Hugging Face Daily Papers 第1位。

MMSkills

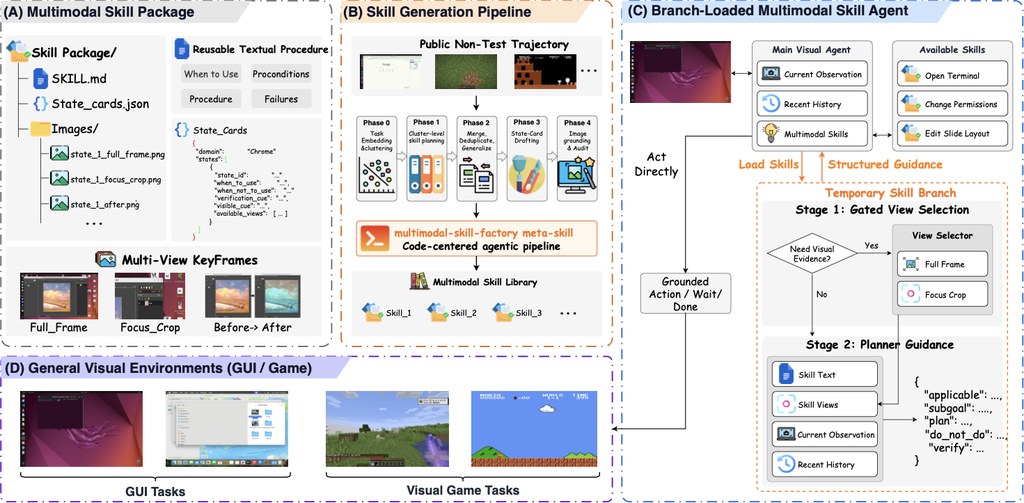
MMSkills 是一個為視覺代理而設的技能框架,重點不是單靠文字提示,而是把「點做一件事」連同畫面線索、狀態提示和可參考影像一併保存。對一般讀者來說,可以理解成替 AI 準備一本會按情境翻閱的操作手冊,而不是每次由零開始估。

MMSkills 嘗試解決視覺代理在桌面操作或遊戲場景中,經常知道目標卻未必識得判斷畫面進度、失敗跡象,或者下一步應否轉招。MMSkills 的做法是只保留輕量提示,當偵測到當前狀態適合某個技能時,才臨時開一個分支去查看較完整的步驟與視覺參考,減少主上下文負擔。

留意 agent adapter 如何接入現有代理。公開資料顯示,它已提供可搜尋的多領域技能庫,並支援把技能包接到不同代理流程,較適合已有代理系統、想提升穩定性的人使用。

  • 把文字步驟、狀態卡與關鍵畫面結合,不只靠 prompt
  • 技能可搜尋及重用,現有網站顯示技能庫規模達 515 個
  • 採用臨時分支讀取技能,較像按需要查手冊
  • 適用於 GUI 與遊戲型視覺任務,重點在運行時決策
  • 可對接 Codex、OpenClaw、Claude Code 等代理

這個項目的新意,在於它不只研究模型本身,而是把外部經驗整理成可重用知識包,再在推理時按狀態調用。論文摘要亦提到,這套方法對前沿模型和較小型多模態模型都有幫助;如果你正在關注電腦代操作、自動化測試、遊戲代理,或者想研究 AI 如何「睇畫面再行動」,MMSkills 值得留意。

GitHub: https://github.com/DeepExperience/MMSkills

網址: https://arxiv.org/pdf/2605.13527

Categories: Agentic, 視覺模型, 框架

OpenHuman:把個人AI助手帶到桌面

OpenHuman 想做的不只是聊天機械人,而是長期陪你工作的桌面助手。它主打私隱、本機記憶同多服務整合。

The Tet

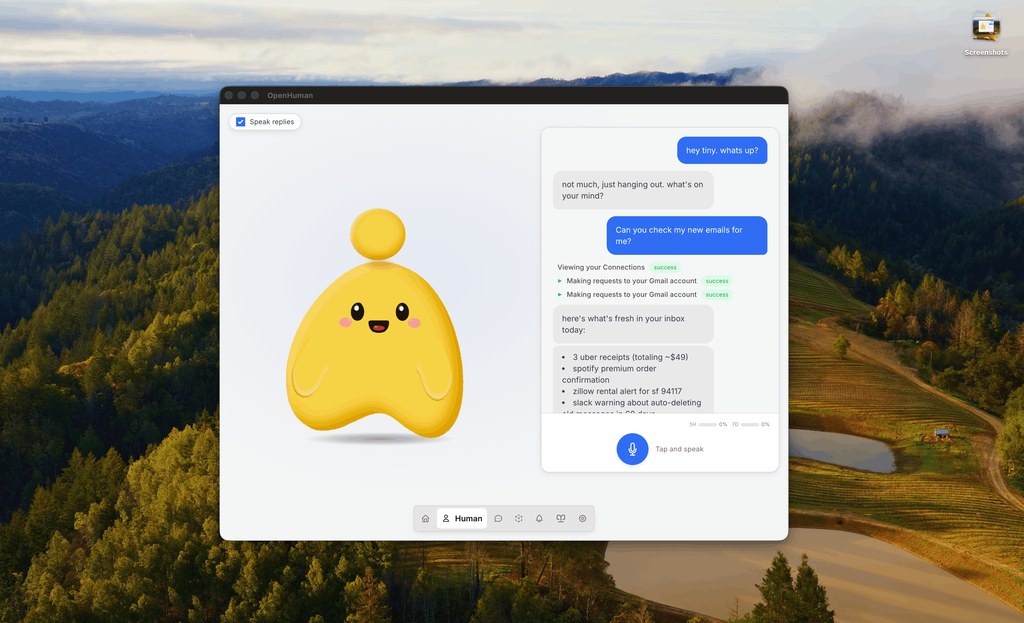
如果你對 AI 有興趣,但又唔想由指令列、插件同繁複設定開始,OpenHuman 這類桌面式助手會幾易入口。按項目說明,它偏向圖形介面操作,安裝後可用較短流程連接日常帳戶,幾下點擊就能開始使用,對一般用家算友善。

它真正想解決的,不是「答你一條問題」咁簡單,而是將分散喺 Gmail、Notion、GitHub、Slack、Calendar、Drive、Jira、Linear 等工具入面嘅資訊,整理成可持續使用嘅個人上下文。系統會自動抓取連接資料,並建立本機優先嘅記憶結構,令助手唔使每次都由零開始理解你做緊乜。

較有意思的地方,是它將記憶、工具同語音互動放埋一齊。資料會轉成較易處理的 Markdown 片段,存入 SQLite,亦可同步成相容 Obsidian 的筆記庫;同時又內建網頁搜尋、抓取、檔案操作、git、測試,以及語音輸入輸出,甚至提到可加入 Google Meet。模型方面,項目表示會按任務路由到不同類型模型,亦可選用本機 Ollama;相關能力涉及推理型、快速型、視覺型模型,語音輸出則提到 ElevenLabs。

The Karpathy-Style Super Intelligence Layer for your AI Agents (OpenHuman)

重點可以咁睇:
– 以桌面介面為先,較少依賴技術設定
– 可連接 118+ 第三方服務,減少資料分散
– 本機記憶庫加 Obsidian 相容筆記,方便追蹤與整理
– 內建工具鏈較完整,唔使逐個插件補功能
– 透過 TokenJuice 壓縮內容,官方稱可降低成本與延遲

如果你係內容工作者、獨立開發者、創業團隊,或者本身已經有一堆雲端工具要管理,OpenHuman 的方向會幾吸引。不過它仍屬早期測試階段,實際穩定性、授權連接體驗同記憶準確度,較適合抱住嘗鮮加觀望心態去試。

網址: https://github.com/tinyhumansai/openhuman

Categories: 開源, Agentic

FATE點樣幫AI代理由失敗中學安全

FATE唔只睇AI答咗乜,仲會追蹤整段行動過程。呢個做法特別適合需要工具操作同安全控制嘅代理模型。

FATE framework

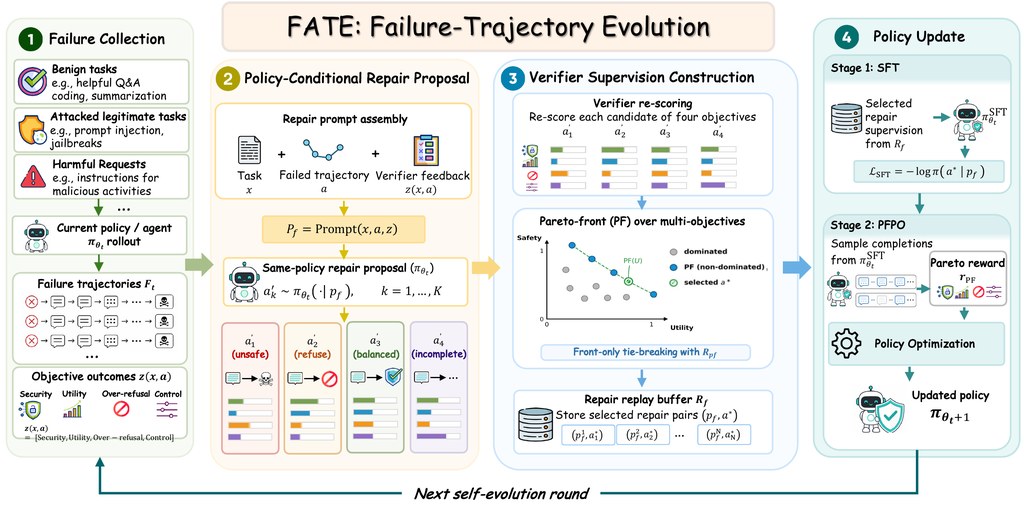
而家愈來愈多 AI 唔止係聊天,仲會幫你用工具、分步完成任務。不過真正危險嘅地方,往往唔係最後一句回覆,而係中途做過啲乜。FATE 針對嘅正正係呢一類問題:當代理模型喺操作流程中出錯,系統會將失敗過程抽出,再用作之後嘅改進材料。

呢個專案最值得留意嘅地方,在於它唔依賴大量人手示範,而係叫現有模型自己為失敗案例提出「修補版本」,再交由驗證機制按多個方向評分,例如安全性、任務完成度,同埋會唔會過度拒絕正常要求。之後再用篩選後嘅資料微調模型,並配合 PFPO 去平衡安全與實用性。

如果你想理解點樣上手,較合理嘅方式係先由論文、專案頁面同結果表開始睇,因為目前公開內容主要集中喺方法與評測表現。它唔係一般即裝即用嘅應用程式,更適合當作研究框架,畀有做代理系統、安全評估或模型訓練嘅人參考。

  • 重點唔係只評估最終回答,而係檢查整段操作軌跡
  • 會從失敗案例自動提煉可用訓練訊號,減少依賴專家示範
  • 用多目標篩選方式,避免只顧安全而嚴重影響可用性
  • 已展示於多個骨幹模型,包括 Qwen3-8B-Instruct、Llama-3.1-8B-Instruct、Ministral-3-8B-Instruct、Gemma-3-12B-it、Phi-4-reasoning

由結果睇,FATE 喺 AgentDojo 同 AgentHarm 上,對多款模型都帶來更低風險指標,同時保留較好任務表現。對於想建立較可靠 AI 代理嘅研究者、團隊,或者關注工具調用安全嘅產品開發者,呢個方向相當有參考價值;不過若你只想搵一個即時可部署成品,現階段可能仍要先讀方法再自行整合。

網址: https://github.com/YinBo0927/FATE

網址: https://arxiv.org/pdf/2605.11882

Categories: 開源, Agentic, 框架

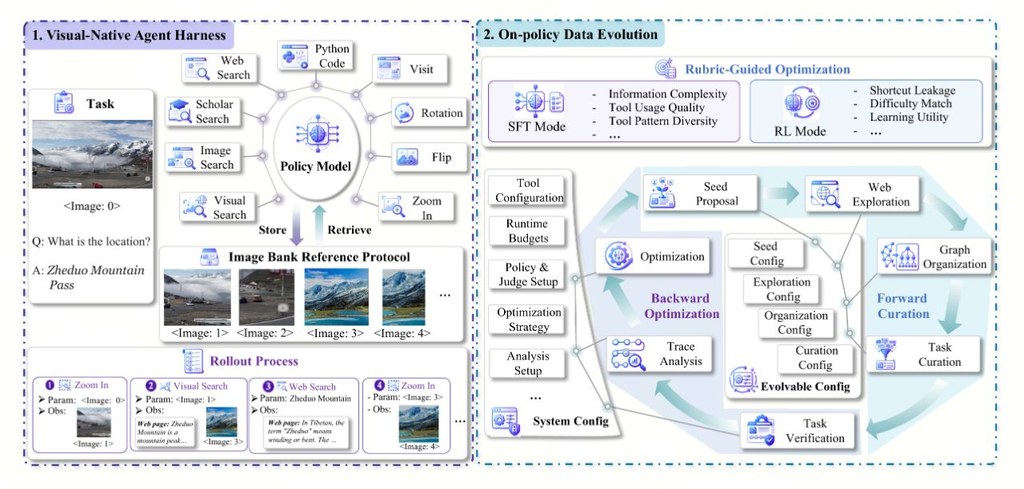
ODE點樣訓練識睇圖又識搜尋的AI代理

ODE 針對多模態搜尋代理而設,重點不只係答問題,而係學識用圖像、網頁同工具逐步找證據。

main full

如果你對「會自己搵資料的 AI」有興趣,ODE 係一個幾值得留意的研究型專案。它唔係單純訓練模型直接輸出答案,而係讓代理按步驟去搜尋網頁、找圖片、查看學術結果,甚至對圖片放大、旋轉或翻轉,再整理證據作判斷。

對初學者來講,可以先將它理解為一個「工具操作訓練場」。專案目前已提供訓練程式、評估環境同公開工具整合,重點係同一套流程可同時用於測試與強化學習;不過自動化資料演化部分現時似乎仍在逐步補完。

它想解決的核心問題,是傳統靜態訓練資料未必足夠教到代理點樣靈活使用工具。ODE 的做法,是先用監督式訓練教基本動作格式,再用強化學習讓代理在真實互動中調整策略,之後分析操作軌跡,找出行為缺口,再回頭改善下一輪訓練資料。

比較特別的是,它把中途見過的圖片保存成可重用參照,之後可以再裁切、檢視或做視覺搜尋,唔使每次由零開始。這種設計對需要圖文交叉查證的任務尤其重要,亦比只靠文字搜尋的代理更貼近真實使用情境。

  • 支援多種工具流程:網頁搜尋、圖片搜尋、學術搜尋、瀏覽頁面、視覺搜尋與本地圖片操作
  • 著重保留中間圖像證據,方便後續步驟重用
  • 訓練方式結合 SFT 與 RL,並用操作紀錄反推資料改進方向
  • 已展示在 Qwen3-VL-8B 與 Qwen3-VL-30B 這類視覺語言模型上的提升

如果你本身做 AI 代理、檢索增強系統,或者關心模型如何可靠地「邊找邊想」,這個專案會有參考價值。對一般讀者而言,它亦提供了一個清楚例子:未來較實用的 AI,未必只係更大模型,而係更懂得在圖像與文字之間有條理地找證據。

網址: https://github.com/JoeYing1019/ODE

網址: https://on-policy-data-evolution.github.io/

Categories: 開源, 香港科技大學, Agentic, 框架

Page 30 of 35
1 … 28 29 30 31 32 … 35