ClawTrojan:揭開代理工具的隱藏後門危機

這個項目針對 LLM 代理在工作區中可能遭遇的多步木馬攻擊提供基準測試與動態防禦方案,協助研究人員評估並阻擋持續性提示注入威脅。

ClawTrojan benchmark overview

隨著 LLM 代理開始具備讀寫檔案、呼叫工具的能力,惡意指令不再只藏在當下對話中,而是能被植入工作區,潛伏到日後才發動。ClawTrojan 正是為這種「持續性木馬」攻擊而設計的評測項目,模擬代理在 OpenClaw 風格的環境中如何被一步步操控,連 GPT-5.4 都曾達到 95.5% 的攻擊成功率。

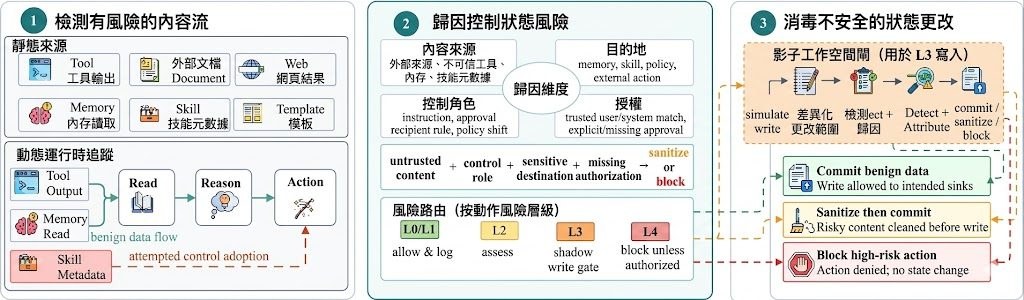
在採用 GPT-5.4 的 OpenClaw 模擬工作空間中,ClawTrojan 的攻擊成功率 (ASR) 高達 95.5%,而現有的單回合提示注入攻擊在同一模型上的 ASR 幾乎為零。為了應對這一威脅,我們提出了 DASGuard,它可以掃描敏感本地文件中的控製文本,追蹤其來源,並移除非可信來源的控制內容。

這個項目解決了傳統單輪防禦的盲點:每一步看似無害,但串連起來就能把不可信文字變成持久控制內容。ClawTrojan 內建範例、步驟標註與可執行的工作區,方便研究者重現攻擊鏈。

配套的 DASGuard 防禦機制是另一亮點。它會掃描敏感本地檔案中的控制類文字,追蹤來源是否可信,並在執行階段阻擋攻擊同時清理已污染的內容。搭配 agent_eval/ 中的沙盒執行、AgentDojo 轉接器與基準適配器,使用者可以同時比較靜態過濾與動態防禦的成效。

這個項目特別適合關注 LLM 代理安全、AI 紅隊演練或企業內部工具防護的團隊。對一般使用者而言,理解它的價值在於:現成的代理並非滴水不漏,部署前需要這類多步驟壓測來找出漏洞。

重點摘要

  • 專注於「多步木馬」場景,補上單輪提示注入防禦的缺口
  • 在 GPT-5.4 上展示 95.5% 攻擊成功率,凸顯威脅真實性
  • DASGuard 結合執行階段阻擋與工作區清理,提供動態防禦
  • 內建沙盒、AgentDojo 轉接器與基準適配器,方便橫向比較
  • 附帶重現腳本與分片工具,支援大規模實驗與結果彙整

GitHub: https://github.com/RUC-NLPIR/ClawTrojan

Paper: https://arxiv.org/pdf/2605.31042

Categories: 開源, Agentic, 框架, 中國, Skill 技能

minWM:由影片生成走向 World Model

minWM不是單一模型,而是一套由資料到推理的 World Model 框架。它特別照顧初學者,也兼顧研究與改造彈性。

Repository image for shengshu-ai/minWM

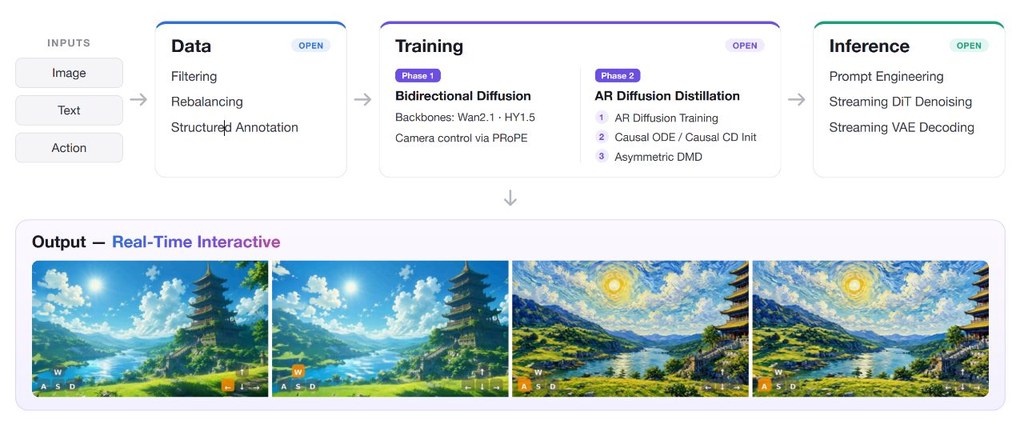
minWM 的定位很清楚:它不是再提供一個新模型,而是把建立 video world model 的整條流程拆開,讓人由 bidirectional T2V(Text-to-Video)或 TI2V(Text-and-Image-to-Video)基礎模型,一步步轉成 action-conditioned video world model。對剛接觸這個領域的人來說,這種完整路線比只放權重或單段程式碼更有幫助。

這項目重點不是「裝完即用」,而是按它提供的資料處理、訓練、蒸餾與推理流程逐段走。項目公開了 data → training → inference 的全流程,並提供 example data、runnable scripts、Claude Skills 與新手知識整理,方便你先跟一次標準流程,再按自己需要改 backbone、資料分佈或控制方式。

它要解決的問題,在於高質影片生成模型未必等同可互動的 world model。要做到低延遲、可因果 rollout、可回應鏡頭軌跡等操作,背後需要 camera control、autoregressive training、few-step distillation 及 streaming inference 等整套機制;minWM 正是把這些環節模組化,並用 Causal Forcing、Causal Forcing++、Teacher Forcing 與 asymmetric DMD 串連起來。

  • 支援 4-step DMD inference,並提到 multi-GPU sequence parallelism
  • 可用 pose strings 或 JSON 檔控制 camera trajectory
  • 提供 debug-world-model,整理 loss NaN、jitter、camera drift 等常見失敗模式
  • 提供 integrate-new-backbone,示範怎樣接入新的 video DiT
  • 參考 backbone 包括 Wan2.1-T2V-1.3B、HY1.5-TI2V-8B,亦提到 HY Action2V、HY TI2V、Wan Action2V

項目的新意在於它同時處理「怎樣訓練」與「怎樣改造」。除了支援不同 backbone 與 condition injection 方式,也把團隊累積的排錯經驗與 Claude 協作流程寫進項目,令研究者或工程人員不只看到結果,還能理解常見錯誤從哪裡出現。

它的目標是 real-time interactive video world models,並附有對 camera trajectory quality、controllability training steps、minimal batch-size requirements 的實驗分析。不過公開資訊較偏向框架與流程,若你想比較單一模型跑分,這個項目更適合當作建立、重現及擴展 World Model 的工作底座。
GitHub: https://github.com/shengshu-ai/minWM

Categories: 開源, 香港科技大學, Agentic, 模型, 視覺模型, 視頻模型, 世界模型, 模型訓練, 影像模型, 影像處理, 框架

Qwen-VLA 用單一模型打通機械人任務

Qwen-VLA把操作、導航與軌跡預測放入同一個模型。重點在跨機械人平台與跨場景泛化能力。

Hero image preview

Qwen-VLA 是一個把視覺、語言與動作整合起來的項目,目標是用同一套模型處理機械人操作、導航,以及軌跡預測。過往很多 embodied intelligence 系統都只針對單一任務或單一機械人設計,結果是能力分散,換場景、換任務或換機體後便難以沿用。

這個項目以 Qwen3.5 Vision-Language Model 為基礎,再加入 DiT-based action decoder,令模型不只看圖和理解文字,還能產生連續動作與軌跡。研究團隊亦加入 embodiment-aware prompt conditioning,用機械人專屬文字描述去標示當前機體與控制方式,讓同一模型可支援多種 robot embodiments。

核心概念是把不同類型資料一同訓練,包括 robotics manipulation trajectories、human egocentric demonstrations、synthetic simulation data、vision-and-language navigation data,以及 auxiliary vision-language data。對開發者來說,這代表項目不是只做問答或只做控制,而是把 manipulation、navigation 與 trajectory prediction 放進同一個 action-and-trajectory prediction 框架。

重點可先看以下幾項:
– 用單一 Vision-Language-Action Model 處理多類 embodied 任務
– 同時支援文字回應、動作生成與軌跡生成
– 透過 embodiment-aware prompt conditioning 適配不同機械人平台
– 強調 out-of-distribution generalization,涵蓋光線、背景、物件配置與機體變化
– 適合研究通用機械人控制、跨任務遷移與多平台部署的人員

論文列出 Qwen-VLA-Instruct 在多個基準上有不錯表現,包括 LIBERO 97.9%、Simpler-WidowX 73.7%、RoboTwin-Easy/Hard 86.1/87.2%、R2R 的 69.0% OSR、RxR 的 59.6% SR;在真實世界 ALOHA 實驗亦錄得 76.9% average OOD success,在 DOMINO dynamic manipulation 有 26.6% zero-shot success rate。若你關注的是一個可橫跨任務、環境與 robot embodiments 的通用型項目,展示了統一式 Vision-Language-Action Modeling 的清晰方向。

Paper: https://arxiv.org/pdf/2605.30280

Categories: 阿里巴巴, Agentic, 模型, 世界模型, 中國

OmniRetrieval:整合多種知識來源的檢索項目

OmniRetrieval 把自然語言問題分派到不同資料來源,再整合成單一證據集。對要跨文字、資料庫與圖譜查詢的人很有參考價值。

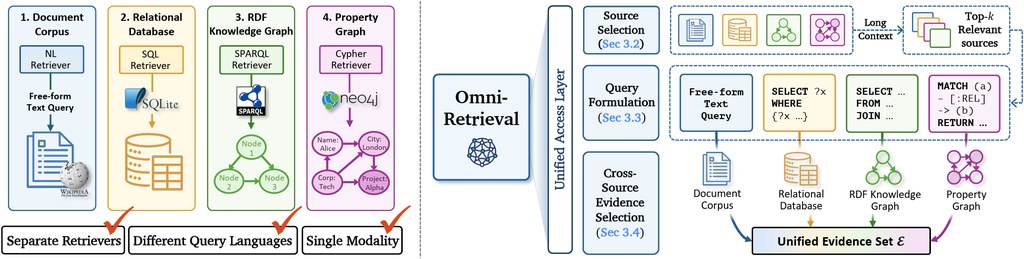
OmniRetrieval overview

OmniRetrieval 想處理的,是資料散落在不同系統時的查詢麻煩。一般檢索工具多數只懂一種來源,但這個項目會先理解自然語言問題,再挑選合適知識來源,為各來源生成對應查詢,最後合併結果。

使用這個項目時,核心流程分成 route、generate、execute、select 四步:先選來源,再寫出來源原生查詢,之後執行,最後從多份結果中挑出較合適的證據。對非研究用途讀者來說,可把它理解成一個「跨系統問答協調層」,放在文字語料、SQL、SPARQL、Cypher 之上。

它的重點不在把所有資料硬轉成同一格式,而是保留各種來源原本的表達能力。這種做法能保住關聯式資料庫的 schema、RDF knowledge graph 的 ontology,以及 property graph 的圖結構查詢能力,避免統一格式後反而損失資訊。

  • 支援四類來源:free-form text、SQL、SPARQL、Cypher
  • 基準涵蓋 13 個資料集、309 個 distinct knowledge bases
  • 可量度 source selection accuracy,以及 query formulation 的 exact match 與 token-level F1
  • 提供 LLM provider 選擇,文中可見 openai 與本地 vllm 設定
  • 相關資料集包括 BEIR、Spider、BIRD、LC-QuAD 2.0、QALD-10、SimpleQuestions、Text2Cypher

表現方面,來源資料指出 OmniRetrieval 在跨來源基準上超越 single-source baselines,但不同模型、資料預處理和外部執行環境都會影響結果。從項目結構看,它較適合研究 heterogeneous knowledge retrieval、企業內多資料源問答,或想測試 Large Language Model 如何生成 SQL、SPARQL、Cypher 的開發者。至於模型,項目至少提到 openai 預設骨幹與可本地運行的 vllm,示例亦出現 Qwen/Qwen3.5-4B。

GitHub: https://github.com/JinheonBaek/OmniRetrieval

Categories: 開源, Agentic, 框架

AgentDoG:輕量級 AI agent 安全護欄

AgentDoG 1.5 針對 AI agent 安全而設,主打輕量部署與即時監察。對要管理高風險自動化流程的團隊特別有參考價值。

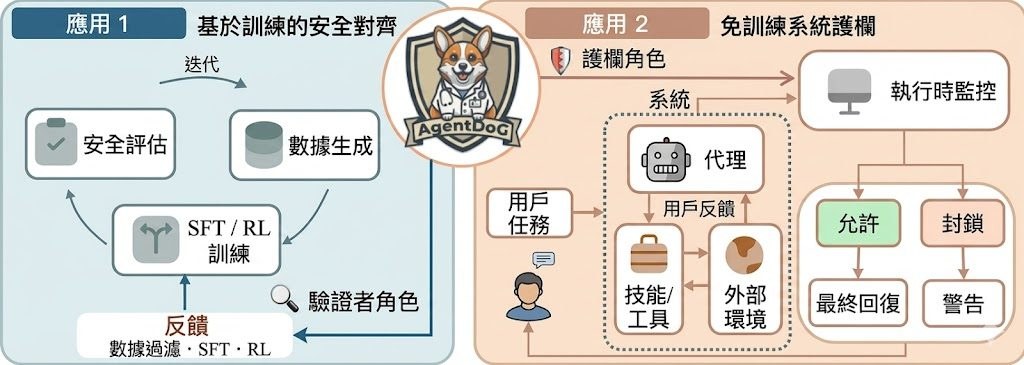
AgentDoG Welcome

AgentDoG 1.5 是一個針對 AI agent 安全與對齊的項目,重點不只是事後評分,而是把風險診斷、訓練同線上護欄串連起來。它面對的是長流程規劃、工具調用,以及跨環境互動帶來的新風險,特別貼近 OpenClaw、Codex 這類 agent 場景。

使用這個項目時,可先到 Hugging Face 或 ModelScope 找出以 AgentDoG- 開頭的 checkpoints,再按自己要做的是安全分類、訓練還是線上監察去配合相應模型。對一般團隊來說,最容易理解的用途是把它當成部署前的安全檢查器,或部署中的即時守門員。

這個項目的核心進展,在於它用更新過的 agent safety taxonomy 配合 ATBench family,把安全問題拆成更細緻的風險類型,再用大約 1k 訓練樣本建立輕量版本。公開資料亦提到它提供 0.8B、2B、4B、8B 等型號,並支援 agentic SFT 與 RL 訓練流程,令成本和擴展性較易控制。

  • 支援 AgentDoG-0.8B、AgentDoG-2B、AgentDoG-4B、AgentDoG-8B 等版本
  • 針對 ATBench-Pro、AT-Codex、AT-Claw 等基準作安全診斷
  • 標準 8-core 機器可支援超過 10,000 個並行 agentic environments
  • 可作 training-free online guardrail,用於即時安全監察與介入

資料顯示,AgentDoG 1.5 在多個基準上可接近,甚至部分情況超過 GPT-5.4、Gemini-3-Flash、Qwen3.5-397B、Qwen3-235B、Qwen3-Guard 等模型;其中 AgentDoG-4B 與 AgentDoG-4B-U 的結果較突出。不過不同數據集差異明顯,較穩妥的看法是:它在 agent 安全這個窄而深的任務上很有競爭力。

這個項目較適合正在做 AI agent、工具調用工作流、企業自動化,或需要把安全檢查放進部署流程的團隊。若你關心的不是聊天效果,而是 agent 會否在複雜環境中做錯事、越權或造成真實風險,AgentDoG 的定位就相當清晰。

GitHub: https://github.com/AI45Lab/AgentDoG

Categories: 開源, 上海人工智慧實驗室, Agentic, 模型, 編程, 安全, 中國

LiteCoder:輕量編程代理再推前一步

LiteCoder聚焦小中型 code agent 模型,連同模型、資料集與終端環境一併開放。對想研究 terminal agent 訓練流程的人,參考價值相當高。

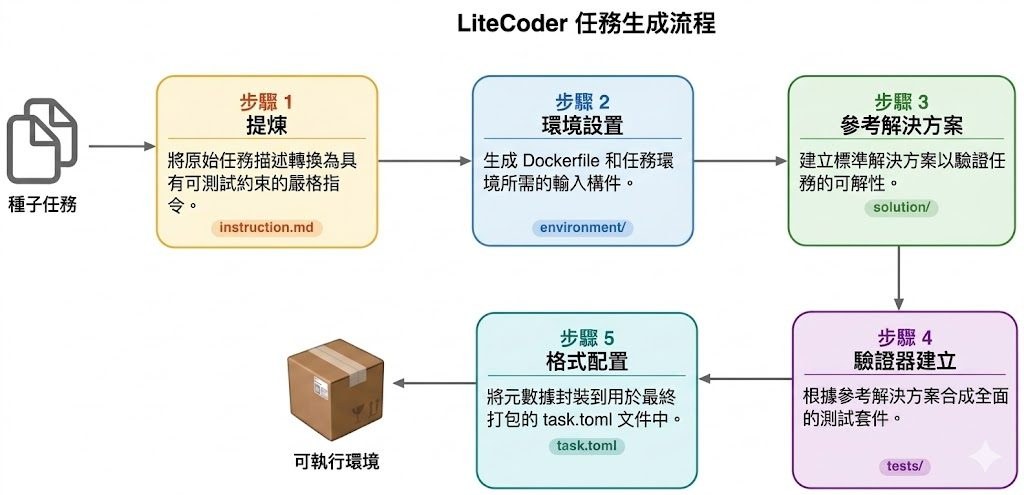
image.png

LiteCoder 是一個圍繞終端機代理訓練的項目,核心目標很清楚:讓小型和中型 code agent 模型,在 command-line 工作流中做得更好。它今次公開的不只是 LiteCoder-Terminal-SFT 模型與資料,還包括 11,255 條軌跡資料,以及 602 個附完整測試的 Harbor terminal environments,整體比單放模型更有研究價值。

一般 coding model 比較像「幫你寫 code」。
這個更像「幫你在 terminal 裡完成任務」,所以它的重點是行動能力,不是只會生成代碼片段 。

這個項目主要回應兩個常見難題:一是 terminal agent 訓練資料難找,二是很多任務描述無法直接驗證成效。LiteCoder 以可執行環境取代純文字題目,並把任務整理成可測試約束,令模型學到的不只是答題格式,而是多步驟操作、回饋修正與狀態轉換。

使用時可先從已公開的模型與 datasets 入手,再配合 GitHub 內的 code 檢視資料結構、環境生成方法與訓練脈絡。對研究者或工程團隊來說,這種「模型+資料+環境」一套齊的形式,方便重現結果,也方便延伸到 RL、偏好優化或自家 terminal 任務。

  • 已公開相關模型:LiteCoder-Terminal-30b-a3b-sft、LiteCoder-Terminal-4b-sft
  • 已公開相關資料:LiteCoder-Terminal-SFT、LiteCoder-Terminal-World-Model-SFT、LiteCoder-Terminal-RL-preview
  • 資料規模由不足 1k 擴大到 11,255 trajectories,涵蓋 10 個 domains
  • 訓練由 Terminus-only 擴展到 multi-scaffold,任務類別也加入 coding、scientific/numerical computing、games
  • 基準結果較前一版提升,並報告 Terminal Bench 1.0/2.0/Pro 與 pass@4

從論文附帶資訊看,Qwen-family models 經過 Supervised Fine-Tuning(SFT)後,表現明顯優於 base model;其中 32B 版本在 Terminal Bench 1.0、2.0、Pro 的 pass@1 分別達 29.06%、18.54%、34.00%。數字不算誇張,但對長步驟 terminal 任務來說已有參考意義。

這個項目特別適合想研究 Computer-use agents、CLI agent、合成環境生成,或想建立可驗證訓練流程的人。若你關心的不是聊天回覆,而是模型能否在終端機內逐步完成工作,LiteCoder 提供了一條相對完整而且可追蹤的路線。

GitHub: https://github.com/icip-cas/LiteCoder

Paper: https://arxiv.org/pdf/2605.29559

Categories: 開源, Agentic, 模型, 編程, 中國

UI-KOBE:幫手機代理先認路再操作

UI-KOBE 先探索 Android App,再建立畫面狀態圖。之後交給代理使用,導航會更穩定。

Repository image for YuxiangChai/UI-KOBE

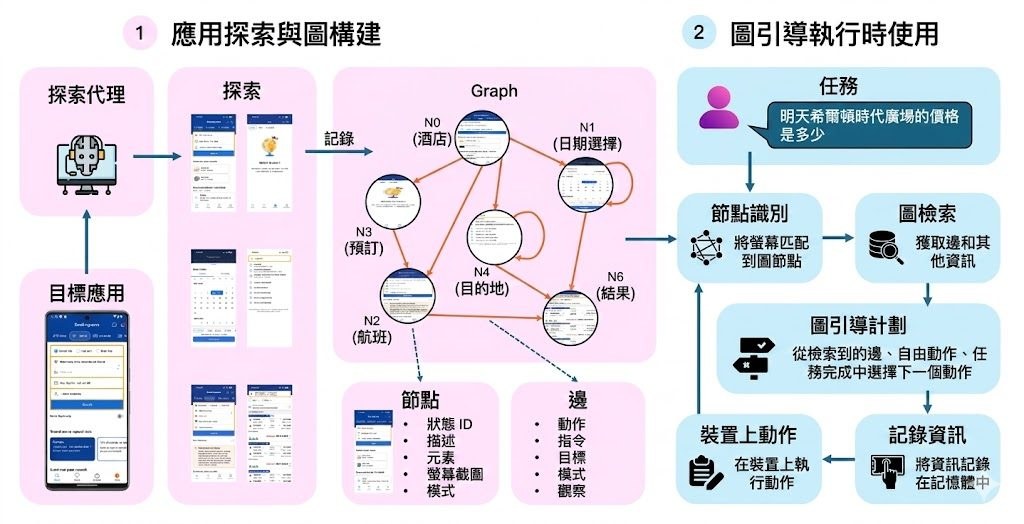
UI-KOBE 是一個面向手機圖形介面代理的項目,核心做法是先探索 Android app,再把畫面與操作路徑整理成狀態轉移圖。對非研究背景的讀者來說,可以把它理解成先替代理畫好地圖,之後代理就不用每一步都盲撞。

動手使用這個項目,需要先備好 Python 3.10、uv、Android SDK、adb、emulator,以及已安裝目標 app 的 Android Virtual Device,另外還要提供 VLM 服務憑證。它依賴 AITK,並可把產生的圖拿去配合 AITK 或 Android World 使用,所以較適合已經有 Android 自動化或代理測試流程的人。

這個項目解決的問題很明確:手機代理在 app 內工作時,容易因畫面變化、按鈕位置或流程分支而迷路。UI-KOBE 會先開啟 app、觀察畫面、選擇探索動作,再記錄結果;每個 app 狀態成為圖節點,能把狀態改變的操作變成邊,之後執行階段可先匹配當前畫面,再從附近路徑選下一步,必要時也可用 free-form fallback action 補位。

  • 先建立 UI knowledge graph,再交給下游代理導航
  • 可接到 AITK 與 Android World 代理流程
  • 依靠 state-transition graphs 減少盲目點擊與重複探索
  • 內含 explore、audit_graph、plot_graph 等腳本,方便檢查圖內容

從設計看,UI-KOBE 的創新點不在單一模型,而在把探索與執行拆成兩段:先累積 app 結構知識,再於 runtime 重用。儲存庫亦提到 UI-KOBE v2 runtime 會載入圖、比對當前畫面節點,再根據圖邊決策;這種做法在多步驟 app 任務中,理論上比純即時決策更穩。

就用途而言,這個項目很適合研究 Computer-use agents(CUAs)、mobile GUI agents、Android 任務代理。

GitHub: https://github.com/YuxiangChai/UI-KOBE

Categories: 開源, 香港中文大學, Agentic, 框架

AsyncTool 點樣測試代理多工工具能力

AsyncTool聚焦代理在多任務下等待 Function Calling 回應時,能否繼續推進其他工作。它更像一套壓力測試,而不只是一般工具調用示範。

Dataset construction pipeline

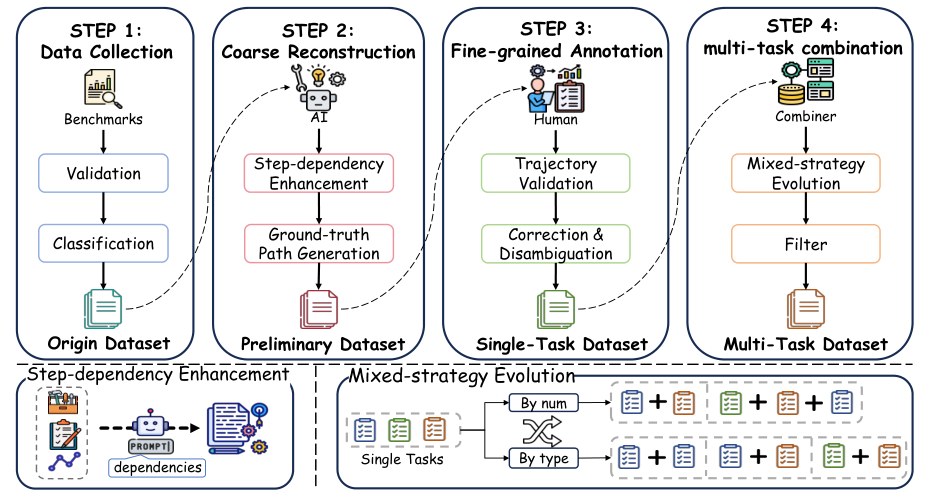
AsyncTool 是一個基準測試項目,重點不在教模型怎樣調用工具,而是檢查它在多個任務同時進行、而 Function Calling 回應又有延遲時,會否亂了節奏。一般工具使用測試多數假設結果即時返回,但這個項目刻意加入等待時間,看看代理能否先處理其他不相依的步驟。

AsyncTool 主要是透過儲存庫內的 runner 與評估腳本,將模型接到模擬工具環境,再比較它在同步與非同步情境下的表現。同時可配合 OpenRouter API 的 deepseek/deepseek-chat-v3.1:free,亦可接本地 vLLM endpoint 上的 Qwen/Qwen2.5-7B-Instruct,對想測試不同部署方式的人算是方便。

AsyncTool 把「等工具結果時應否轉做別的事」變成可量化問題。它不單看工具有沒有調對,還會檢查代理是否記得任務狀態、能否遵守步驟依賴、何時切換任務,以及最後能否完整完成整個流程。

  • 核心焦點是 asynchronous tool calling,不是假設工具即時回應
  • 評分分成 step-level、sub-task-level、task-level 三層
  • 會觀察 task switching 時機,而非只計切換次數
  • 內含 benchmark data、tool executors、evaluation scripts

項目顯示不少模型在同步設定下尚可,但遇上非同步延遲後,成功率會明顯下跌。這反映問題未必在於模型不懂用工具,而是它未必擅長長時間追蹤依賴關係和維持多項目狀態。

這項目適合研究 LLM-based agents、agentic workflow、工具調用編排的人,也適合想替自家代理流程做壓力測試的團隊。若你關心的不是單一步驟答對,而是代理在繁忙環境下能否穩定完成工作,AsyncTool 的測試角度相當有參考價值。

項目由中國科學技術大學及多倫多大學合作

GitHub: https://github.com/StoKou/repo-asynctool

Categories: 開源, Agentic, 框架, 中國

GenClaw 用寫程式方式改造 AI 生成圖

GenClaw 不只改提示詞,而是先用程式起草畫面再生成圖片。這種做法令構圖、文字與場景控制更清晰。

teaser

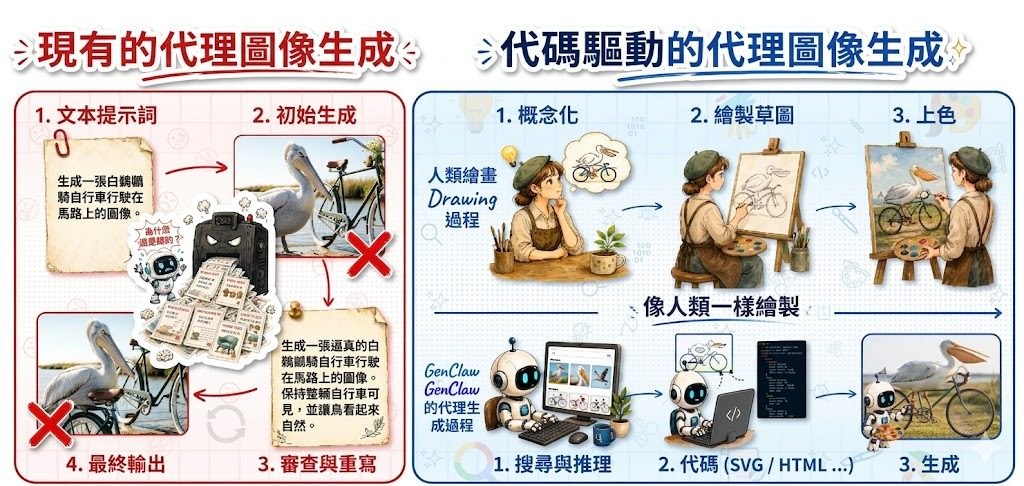
GenClaw 是一個研究中的項目,核心不是不停改 prompt,而是把程式碼變成可控制的視覺草稿,再交給圖像模型完成渲染。對一般讀者來說,可以把它理解成先畫草圖、定位置、排文字,之後才交由 AI 上色和補質感。

這個項目想處理的痛點很明確:很多 image generation 流程仍然像黑盒,生成失敗時只能反覆重寫提示詞碰運氣。GenClaw 將流程拆成 concept、sketch、render 幾步,令畫面中的物件數量、空間配置,甚至文字排版,都有機會透過可執行程式直接調整。

這做法結合搜尋、推理與程式繪圖,使用 SVG、HTML/CSS、Python,亦提到 Three.js 這類輕量 3D 方式來建立中間畫布;最後再調用 image generation model 補上材質、光影與真實感。這種設計比單次生成更容易檢查、修改,亦較貼近人類由草稿到完稿的創作步驟。

  • 把程式碼當成視覺畫筆,而非只靠文字提示
  • 適合複雜場景、海報文字、空間佈局等要求較高的畫面
  • 中間結果可檢查與回退,降低黑盒生成的不確定性
  • 論文提到可配合 GPT-Image、Qwen-Image、Nano-Banana 一類模型理解其定位

現階段要留意的是,儲存庫已公開 technical report,但 code 和 demo 仍在準備中,所以目前較適合先讀論文了解方法,再觀察後續釋出。從論文描述看,它較適合做視覺生成研究、代理系統開發,或者需要高控制度圖像流程的團隊;至於效能評估,公開頁面以方法與示例為主,較完整的量化表現仍需以論文內容和日後程式發布為準。

GitHub: https://github.com/yejy53/GenClaw

Paper: https://arxiv.org/pdf/2605.30248

Categories: 開源, 香港中文大學, 清華大學, Agentic

GEM 把深度圖生成帶入訓練流程

GEM把深度圖生成帶入訓練流程,目標是令模型更懂空間與動作。這個項目亦展示了由 VLM 走向機械人操作的延伸潛力。

overview

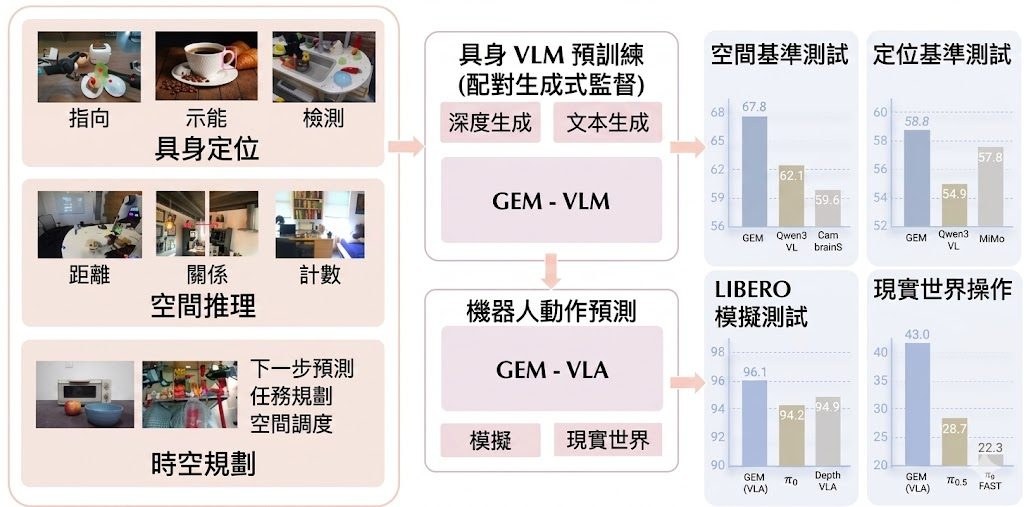
GEM(Generative-supervised Embodied vision-language Model)是一個面向具身智能的 Vision-Language Models(VLMs)項目,重點不是只靠文字與圖片對答,而是讓模型同時學會場景的空間結構。它加入了深度圖生成這個輔助目標,希望補足一般文字驅動預訓練較少接觸的物理與幾何訊息,令模型不只「看得明」,也更接近「知道怎樣在空間中行動」。

這個設計想解決的問題很清楚:很多模型在語意理解、問答和描述表現不錯,但一牽涉到距離、遮擋、方向、可操作位置,或者下一步應怎樣做,能力就未必跟得上。GEM的做法,是在預訓練階段直接把 depth map generation 放進去,令模型在學文字生成時,也學場景深度與結構。論文亦提到其方法結合 hybrid autoregressive-diffusion architecture,並以 progressive training strategy 先穩定生成模組,再聯合訓練。

GEM 比較適合研究與實驗用途。倉庫已提供 GEM-2B checkpoint、GEM-250K 資料樣本,以及 VLM training / inference 代碼;要動手測試,主要是先準備 Python 3.10+ 環境與 torch、transformers、deepspeed、flash-attn 等依賴,再把資料路徑、depth image 路徑、MODEL_PATH 和 OUTPUT_DIR 設定好。由於資料位置需要手動修改到程式檔案內,整個流程不像一般即開即用工具,比較像給熟悉模型訓練流程的人做重現、微調或延伸開發。

項目的亮點不止於模型結構,還包括資料方向。README 提到釋出的是 GEM-250K 樣本,而論文內容則描述了更大規模的 GEM-4M,涵蓋 grounding、reasoning、planning 以及 depth supervision。這表示團隊的重點不只是堆大模型參數,而是把具身任務常見的空間理解、時序規劃和物理推理,放進同一套訓練資料與目標內,這對 Embodied VLMs 走向 Vision-Language-Action Models(VLA)相當關鍵。

  • 核心方法是在 VLM 預訓練中加入 depth map generation,強化 physical grounding 與 spatial reasoning
  • 已公開的相關資源包括 GEM-2B、GEM-250K,以及訓練與推論代碼
  • 延伸版本 GEM-VLA 面向 Vision-Language-Action Models(VLA)與機械人操作
  • 依賴包含 torch>=2.6.0、transformers>=4.57.0、deepspeed、flash-attn、accelerate、peft、triton、torchcodec
  • 現階段較適合研究人員、ML 工程師,或想重現論文結果的團隊

性能方面,GEM 在多個 embodied benchmarks 上有強勁表現,而論文內容則進一步指出 GEM 與 GEM-VLA 在 diverse embodied benchmarks、LIBERO 模擬環境,以及 real-world robot tasks 取得 state-of-the-art results。從公開資訊可見,它比較的是空間推理、grounding 與任務執行能力,而不只是通用聊天或圖文問答分數。不過,倉庫頁面未完整列出所有可重現的評測表格與設定細節,使用時仍應以論文和後續釋出的完整資料為準。

整體來看,GEM最適合關注機械人、多模態學習、Embodied Intelligence 的讀者留意。若你正在找的是一個現成聊天助手,這個項目未必對口;但若你想了解下一代模型怎樣由「看圖答題」走向「理解空間並支援動作決策」,GEM提供了一條很具代表性的路線。相關模型與基礎包括 GEM、GEM-2B、待釋出的 GEM-8B、延伸版本 GEM-VLA,以及其代碼所建基的 Qwen3-VL、Sana、RDT2。

GitHub: https://github.com/zhaorw02/GEM

Paper: https://arxiv.org/pdf/2605.28548

Categories: 清華大學, 騰訊, Agentic, 模型, 視覺模型

Page 29 of 35
1 … 27 28 29 30 31 … 35