3dcodeverse 讓 AI 以程式碼建立可驗證 3D 世界

3DCodeVerse 將可執行程式、空間檢查與視覺評審接成工作流,讓 AI 產生的 3D 內容不止能看,亦能修改和驗證。

3DCodeVerse

由幾百行 Blender Python、Three.js 或 GLSL 生成互動場景,內容仍可編輯和檢查,正是 3DCodeVerse 的實用定位。它屬於面向 coding agents 的 3D 研究生態系,處理文字要求轉化為可執行 3D 程式的問題,而不是只輸出一張渲染圖。

核心資料集 3DCodeVerse-2M 收錄約 2.03M 個 code-condition pairs,來自 269,597 個可執行程式,涵蓋 bpy、CadQuery、OpenSCAD、Three.js、URDF、GLSL、OpenGL 七種語言或 runtime,並分為物件、可動物件、場景及圖形渲染四條軌道。每個項目附有程式、所需資產、指令描述、視覺描述、建構步驟和驗證記錄,較適合訓練及測試,而非只作展示素材。

3DCodeVerse Harness 以多智能體和 DAG 結構規劃 3D 項目,再交由空間工具、MCP 服務及確定性檢查驗證連接、介面合約、關節掃描和畫面指標;VLM 評審則用二元缺陷清單及程式上限評分。讀者可先在項目網站瀏覽器執行示例,再從 Hugging Face 取得資料集;自行運行則要準備相應的 Blender、Three.js、OpenGL 等 runtime,不能只靠單一推理套件完成。

開放模型部分提供 Qwen 的 LoRA、DPO 微調配方,並列出 27B 模型在 3DCodeBench 的執行率由 51.9% 提升至 92.9%;項目亦列出相對同一 Claude Opus 5.5 backbone 的 90% 人類偏好結果。這些數字反映訓練資料和驗證流程的價值,但仍應留意評測設定、成本及不同 runtime 對結果的影響。

  • 可生成可修改的程式化 3D 物件、場景和渲染效果
  • 以 DAG Harness 串連規劃、執行、空間檢查和視覺評審
  • 2.03M code-condition pairs 支援模型訓練與基準測試
  • Qwen 微調配方兼顧執行成功率和偏好評審

對研究 3D 生成、coding agents、程式化建模或模型微調的團隊,這個項目提供由資料集、工具鏈到模型配方的完整起點。限制在於工作流程依賴多個 3D runtime,評審仍可能受視覺品質和規則覆蓋範圍影響。
項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 視覺模型, 模型訓練, Qwen, Google, 工具, 3D, Python, 編程, 安全, Anthropic, Dataset 數據集, LoRA

ORBIA 測試世界模型當鏡頭回頭後場景是否仍在

影片流暢,不代表場景能保持一致。ORBIA 讓鏡頭離開再折返,檢查世界模型有沒有「忘記」剛生成的內容。

ORBIA overview

鏡頭繞一圈後,同一件物件應該仍在原位。ORBIA 這套互動影片世界模型基準測試,透過探索與重訪場景,檢查生成畫面能否構成一致的 3D 世界,而不只看影片是否漂亮。

測試輸入包括圖片、場景描述及鏡頭軌跡,並以已對齊的彩色與深度影像(Red Green Blue–Depth,RGB-D)及標註物件作參照,比單一整體影像分數更能定位場景改變的位置。

  • 輸入保留(input preservation):原有場景與地標是否保留。
  • 生成內容持續性(generated-content persistence):重訪時,新生成內容是否一致。
  • 3D 自洽性(3D self-consistency):不同視角能否支持同一個 3D 重建。

儲存庫提供評估程式、模型適配器及資料建構流程,供研究團隊接入模型測試。720 個案例涵蓋六種軌跡,包含 22 秒及一分鐘版本;長版本安排三次重訪,能檢查較長時間的場景記憶。

項目已評估 27 個模型,但所提供資料沒有具體排名或分數。它適合補強世界模型的驗證流程,不能單憑測試規模判斷哪個模型更可靠。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, Video, Image, 3D, 庫, Dataset 數據集

ATAS 以持續世界記憶改善長片生成一致性

ATAS 讓每個鏡頭共享可回訪的世界狀態,減少長片生成中人物、場景與事件難以保持連貫的問題。

ATAS: Any Time, Any Space

長片生成最難處理的不是單一鏡頭是否漂亮,而是角色重返同一地點、事件在不同時間再次出現時,畫面能否維持一致。ATAS(Any Time, Any Space)屬於 agentic video generation 框架,將劇本拆成包含場景、鏡頭、時間及事件的 shot request,再以持續更新的世界狀態支援後續生成。

ATAS 沒有只把上一個鏡頭或提示詞傳給下一次生成,而是分開保存兩類記憶:Scene Memory 記錄已註冊的靜態幾何,Event Memory 則按場景、事件和時間索引動態觀察。新片段生成後會被重建、註冊及檢查,只有通過審核和狀態驗證的內容才會更新記憶;影片交付則不受記憶是否接納影響,減少錯誤觀察污染後續鏡頭的風險。

• 將劇本編譯成具體的場景、相機和事件時間要求
• 支援從不同視角回訪同一場景
• 可重現較早時間點發生過的事件
• 生成後進行註冊、審核及世界狀態檢查

項目展示的差異,在於把跨鏡頭一致性視為世界狀態管理問題,而不是單純延長上下文或串接最近畫面。這會增加記憶建立、片段重建和驗證所需的計算與流程複雜度,但更適合長片、分段製作及需要角色與場景持續連貫的內容工作流。

研究結果涵蓋四個影片生成器;ATAS 在報告的跨鏡頭一致性指標均有改善,並在每個 backbone 取得最高綜合 benchmark 分數。它亦在目標影像空間回訪、三項事件重現指標及六項人工評分準則中領先比較的 agents 和 3D-guided methods。儲存庫目前主要提供研究程式碼、技術資料及示範,使用者需要按項目頁面的環境與模型依賴自行重現流程。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 視頻模型, Video, Image, World-Action Model, 提示詞, 框架, 3D, 庫, Dataset 數據集

ManimGX 高速 3D 動畫渲染

面向 AI agents 的 Manim 相容動畫引擎,以 Rust 和 wgpu 大幅縮短 2D、3D 教學動畫的製作等待時間。

ManimGX

製作數學教學片時,渲染速度往往比寫動畫程式更容易拖慢流程。ManimGX 屬於開源 3D 動畫引擎,兼容 Manim CE API,讓 Python 使用者可用熟悉的文字、方程式、曲面和鏡頭,處理 2D 與 3D 動畫生成。

它以 Rust 和 wgpu 重寫渲染核心,並加入完整靜態類型、關鍵字參數及 .animate 鏈式寫法;LaTeX 或 Typst 不需另行安裝。項目亦支援瀏覽器執行,透過 Pyodide 讓示範、教學或 AI agents 生成的動畫毋須先配置完整本地環境。

• M4 Pro、1080p60、五個場景合計 36.2 秒影片,渲染需時 3.08 秒
• 同一測試中,比 Manim CE 快 90.6 倍、ManimGL 快 11.5 倍、Blender Workbench 快 18.7 倍
• manimgx inspect 可檢查 storyboard、2D 版面,以及指定時間或播放結束時的畫面
• 支援語音同步,方便按旁白內容安排動畫節奏

安裝可選 prompt、PyPI 或 npm,適合數學教育、技術內容製作,以及需要反覆生成和檢查畫面的 agent 工作流。速度數字來自 Apple M4 Pro 的固定場景測試,不能直接代表所有硬件、動畫複雜度或互動需求;對已深度依賴 Manim CE 生態的團隊,API 相容性可降低遷移成本,但仍應先驗證現有場景和第三方功能。

GitHub

Categories: 開源, Agentic, AI productions, API, Video, 教學, 3D, Python, 語音, 動畫, 蘋果

Urbex 讓城市級 3D 定位改用主動搜尋

Urbex 讓視覺語言代理在城市級 3D 場景自行搜尋證據,毋須預先建立物件候選框,定位能力與效率取捨更值得檢視。

Urbex logo

面對城市級 3D 場景,逐一比較預先產生的物件候選框容易拖慢搜尋,也會受候選品質限制。Urbex 屬於開源的 Agentic 視覺模型項目,將 3D grounding 改成主動空間搜尋,讓 vision-language agent 按需要查詢地標、縮放區域、切換斜視角,再提交目標 bounding box。

它不是只靠一次影像判斷,而是在互動式 multi-view environment 逐步收集證據。Reinforcement learning 同時訓練定位和搜尋決策,模型會學習應該檢查哪裏、何時縮窄範圍,以及幾時足以作答;這免除對 precomputed instance proposals 和 ground-truth boxes 的依賴,但每次搜尋仍要承受多步操作成本。

CityRefer 測試中,Urbex 的 ND Hit@1、Hit@3、Hit@5 為 25.8、39.2、42.3,NO 對應為 23.9、36.9、40.7,搜尋時間約 3.2 秒。相較 CityAnchor 的 32.1 秒,速度明顯較快;模型亦在 STPLS3D-Refer 取得 zero-shot 結果,反映跨場景泛化潛力,但不能直接等同於所有城市環境都同樣穩定。

• 支援 CityRefer 訓練及單查詢互動式 3D 推理
• 提供 Hugging Face 的 Urbex-4B 模型和 Urbex-Data 數據集
• 可透過 Colab notebook 試用預測視圖
• 安裝需要 Linux、Python 3.11、CUDA 12.8 及 C++ 編譯器

研究城市建模、3D 視覺定位或多模態代理的團隊,較適合用它測試 candidate-free grounding;想快速驗證概念的人則可先用 Colab。完整訓練需要 CUDA 12.8、Megatron Core、Transformer Engine 和 FlashAttention,硬件及環境門檻明顯高於單純推理,因此本地部署前應先確認 GPU、編譯工具和數據下載流程。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Image, 工具, 3D, Linux, Python, Dataset 數據集, 強化學習

CineRecon 以 Blender 重建實景影片

CineRecon 將影片重建變成可檢驗的 Agent 任務,要求模型由參考影片建立可編輯、可動畫化的 Blender 場景。

CineRecon logo

由完整參考影片出發,Coding Agent 透過 Blender MCP 撰寫及修改 Python,反覆比對渲染畫面,再建立包含幾何、材質、角色動作與鏡頭動畫的可編輯場景。CineRecon 屬於影片重建 benchmark,處理的是模型能否將時間連續的影像內容還原成可修改的 3D 工作成果,而不只是產生相似畫面。

項目以三個重建層級拆開能力差異:Proxy 只要求位置、互動及鏡頭運動,Simplified 再保留可辨認形狀和主要外觀,Detailed 則加入特色形狀、材質和細節。三個層級都要求相同的主體動作、事件及攝影機行為,方便分辨模型是只掌握構圖,還是能重建完整視覺內容。

  • 50 段參考影片,切分成 360 個評估片段
  • 35,836 筆獨立 checklist 記錄,按層級擴展至 49,668 項檢查
  • 評估 Camera、Static、Dynamic 三類一致性
  • 支援畫面選取、時間戳對齊、並行評分、續跑及分數彙總

評分由獨立 VLM judge 對齊參考與渲染影片,按片段 checklist 檢查 11 個類別,並以 Camera、Static、Dynamic 三個同等權重維度計算結果。這比單一影像相似度更能揭示鏡頭是否跟足、物件是否保持穩定,以及動作和事件有沒有在正確時間發生。

測試需要 Python 3.10 或以上,支援 Linux 及 macOS;項目提供資料、提示詞、驗證工具和離線 smoke test,但不包含 Agent launchers。團隊可先用離線流程確認資料與評分管線,再接駁 Blender MCP 和隔離 worker 執行重建;研究模型能力時,CineRecon 的價值在於把「看似相似」拆成可追蹤的鏡頭、靜態內容和動態內容,而不是只比較最後一段影片。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, MCP, 模型, 視覺模型, Video, Image, 提示詞, Vibe Coding, 工具, Mac, 3D, Linux, Python, 編程, Anthropic, 動畫, Dataset 數據集

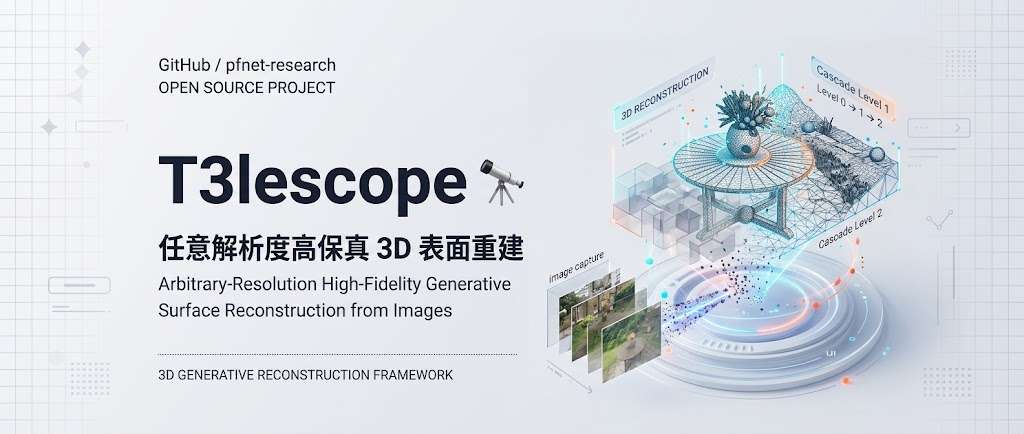
T3lescope 把多視角影像變成高質 3D 場景

由單一物件到城市級戶外場景,T3lescope 嘗試以生成模型兼顧整體幾何、細節,以及玻璃和鏡面表面重建。

T3lescope teaser

面對影像稀疏、表面反光或透明等情況,T3lescope 仍嘗試由已標定相機姿態的多視角影像重建高保真 3D scene mesh。它屬於生成式 3D 重建模型,處理的是大型場景難以同時維持覆蓋範圍與局部細節的問題。

模型以 mesh flow models 直接生成高解析度網格,並在推理階段採用 coarse-to-fine cascade:先用較粗層級建立全局布局,再於更細的 spatial cells 內擾動、去噪和補回幾何細節。各層共用同一個 fixed-resolution generator,訓練時以不同尺度的 cells 學習,因此層級數量、cell 尺度和位置都可於推理時調整。

這做法減少把大型場景切成多個獨立重建區域後出現的接縫和全局不一致風險,也不需要逐個場景進行 per-scene optimization。代價是重建品質仍取決於輸入影像數量、視角覆蓋和模型推理配置,而 README 未提供硬件要求、速度或完整操作流程。

T3lescope: Arbitrary-Resolution High-Fidelity Generative Surface Reconstruction from Images
  • 支援由單一物件、室內環境延伸至戶外和城市級場景
  • 可在推理階段選擇 cascade 層級與網格細緻程度
  • 針對稀疏觀測、細小結構、glossy 及 transparent surfaces 提供生成式補全
  • 在室內、戶外及城市場景測試中勝過 feed-forward 和生成式基線,並達到或超越部分 per-scene optimization 方法

適合需要多視角影像轉 3D 資產的視覺研究、數碼孖生、機械人感知和場景製作團隊,較容易受惠於這種跨尺度重建能力。不過 GitHub 項目目前只標示 Code is coming soon,尚未提供可安裝程式碼;現階段可參考 arXiv、項目網站和示範影片理解結果,未能按儲存庫直接測試。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Image, 3D, 庫

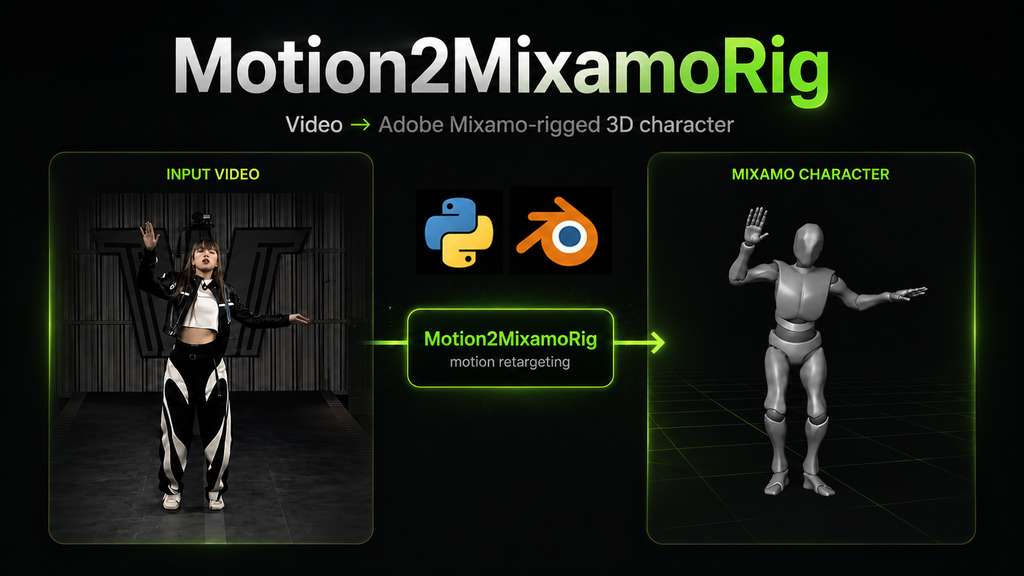
Motion2MixamoRig:把真人動作搬入 Mixamo 角色的開源工具

Motion2MixamoRig 將單人影片或照片姿勢轉成 Mixamo 角色動作,直接輸出可供 Blender、Unity 使用的 3D 檔案。

Motion2MixamoRig

把單人動作影片或一張姿勢照片套到 Mixamo 角色上,Motion2MixamoRig 便可輸出預覽影片及帶蒙皮的 .glb 角色檔,減少遊戲開發者重新製作基礎動作的工序。它屬於 3D 動作轉移工具,處理的是真人影像與已綁定骨架角色之間的動作銜接問題。

流程以 SMPL-X、GVHMR 等模型先從影像估計人體動作,再將結果映射到 Adobe Mixamo rig;模型不負責生成全新動作,而是把影片或照片中的姿勢重建後套用到指定角色。輸出可放入 Blender 或 Unity,仍要留意單人畫面、遮擋、鏡頭角度及原角色骨架會影響結果。

模型權重首次執行時約需下載 5 GB;原始資料沒有提供正式性能基準或準確率數字。項目目前仍屬 experimental,0.1.0 提供 command-line pipeline,亦附有 Blender 4.2+ Extension,並在外部 Python 環境執行同一套流程。

  • 支援影片動作及單張照片姿勢
  • 輸出預覽影片與 .glb 檔案
  • 兼容 Blender、Unity 工作流程
  • 需要單人素材及外部模型權重

遊戲原型、角色動畫測試及需要快速重用真人動作的團隊較適合採用。ffmpeg 並非流程必需,但缺少它會令輸出影片沒有聲音,並可能無法在瀏覽器播放;對需要穩定製作級動畫的人員而言,仍要自行檢查骨架映射、腳部滑動和遮擋造成的誤差。

GitHub

Categories: 開源, AI productions, 數字人, 模型, Video, Image, Audio, 工具, 3D, Python, 庫, 動畫

OuroWorld 讓靜態 3D 世界循環動起來

OuroWorld 把靜態 3D 場景轉成可由移動鏡頭觀看、動作無限循環的 3D cinemagraph,亦毋須手動製作遮罩。

OuroWorld Logo

想把重建好的 3D 場景變成有火焰、流水、物件活動或光線變化的循環畫面,OuroWorld 提供了一條直接的處理流程。它屬於 mask-free 的 3D 動態生成框架,會將任何來源的靜態 3D Gaussian Splatting (3DGS) 場景轉成可從不同視角觀看的 3D cinemagraph。

項目不只處理流體般的局部變化,也涵蓋一般形變、物件運動及 illumination change;輸入可以來自傳統重建,亦可以是 HY-World 2.0、Marble 或 Lyra 2.0 等 3D world model。相比需要逐個區域製作遮罩的流程,OuroWorld 減少了前期標註工作,但動態內容的控制精度和生成結果仍要視乎輸入場景與模型能力。

測試時需準備符合格式的 3DGS 場景,以及描述鏡頭的 camera JSON。c2w 使用 OpenCV convention 的 4×4 camera-to-world pose,K 以像素表示,principal point 必須位於影像中心;項目亦提供 ouroworld-import world 方式匯入場景,沒有 camera JSON 時會採用預設鏡頭配置。README 的資料格式說明對接駁外部 3D 世界尤其重要。

可留意的重點包括:
– 由靜態 3DGS 場景生成動態 3D cinemagraph
– 支援移動鏡頭,而非只輸出固定視角動畫
– 不需人工 mask,並處理形變、物件運動與光線變化
– 可接駁重建場景及多種 3D world model
– 筆者被拒下載 Hugging Face 由 Meta 管理的權重

對 3D 重建、世界模型展示、互動場景預覽及視覺內容製作團隊而言,OuroWorld 的價值在於把靜態資產延伸成可循環播放的動態內容。它較適合研究原型和展示項目,正式製作前仍應檢查鏡頭參數、場景格式,以及長時間循環時是否出現動作或光照接縫。

項目主頁 · GitHub

Categories: 開源, 模型, 世界模型, Image, 框架, 3D, 動畫, Dataset 數據集

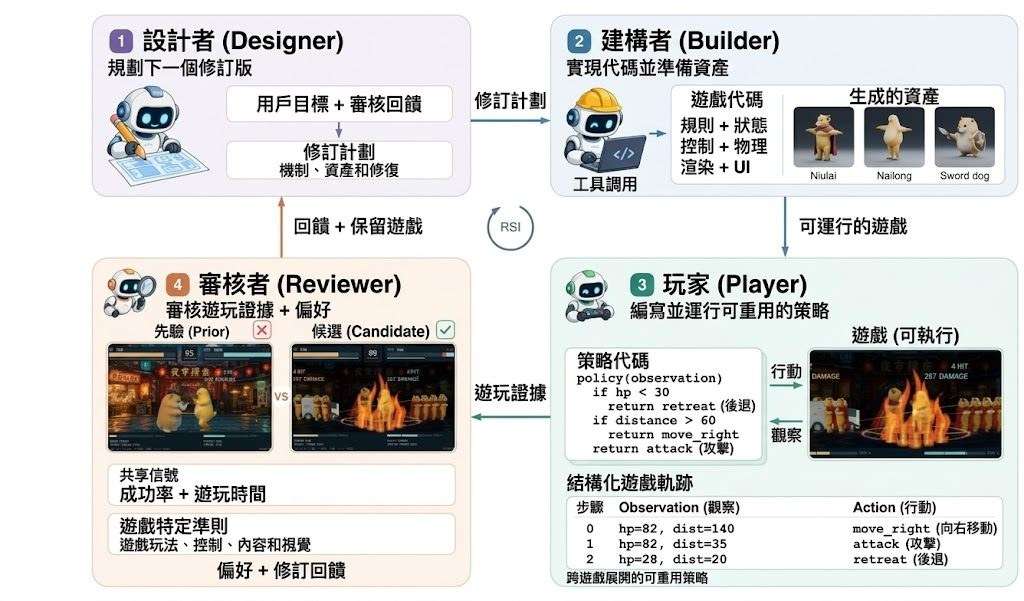
RecursiveGameCreator:讓你的創意從原型走向成功的遊戲開發框架

Recursive Game Creator 把設計、開發、遊玩與評審串成循環,令 AI 遊戲開發不止於成功運行。

Recursive Game Creator framework: Designer, Builder, coding-native Player, and Reviewer connected through game developme

遊戲能夠運行,不代表玩家會覺得好玩。Recursive Game Creator 將 Designer、Builder、coding-native Player 與 Reviewer 串成循環,屬於一個 Agentic Product-Level Experience-Oriented Game Harness,處理 AI 由可玩原型持續改良至完整遊戲時,缺乏體驗評估的問題。

Player 會透過程式介面執行可重用的 gameplay policies,收集多條 gameplay trajectories,毋須每個動作都重新呼叫模型,較適合反覆測試機制與內容。Reviewer 再結合行為軌跡、畫面觀察、玩家偏好及遊戲專屬準則,為下一輪 Designer 計劃提供修訂回饋。

項目支援 HTML 和 Godot,遊戲可在隔離 runtime 內開發及測試,亦可選擇接入影像、3D asset 與 Blender。macOS 或 Linux、Git、Node.js 22/npm,以及運行中的 Docker daemon 是主要環境要求;Docker 使用 software rendering,主機不必配備 GPU。

目前公開結果以三輪迭代展示改良,GameCraft-Bench overall 由 R1 至 R3 提升 5.19 points。這個數字反映循環式修訂的效果,但未等同所有遊戲都能獲得相同體驗,因為評審準則、玩家偏好及遊戲類型仍會影響結果。

較適合研究 agentic game development、需要大量自動 playtesting 的團隊,以及希望比較遊戲版本演進的開發者。實驗可從 HTML 遊戲開始,再按需要加入 Godot、視覺素材或 Blender 整合,先驗證設計—開發—遊玩—評審流程是否符合自身工作流。

  • 以四個角色連接設計、實作、遊玩與評審
  • 透過 reusable policies 收集 gameplay trajectories
  • 同時考慮行為、畫面與玩家偏好
  • 支援 HTML、Godot、3D asset 及 Blender 整合
  • GameCraft-Bench 三輪迭代提升 5.19 points

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, DeepSeek, Image, 框架, 香港, 軟件, Mac, 3D, Linux, 編程

Page 3 of 15
1 2 3 4 5 … 15