Building Rome 單張相片重建完整 3D 場景

只用一張相片,Building Rome 便嘗試補全鏡頭外的建築與室內結構,生成可探索的 3D 場景網格。連看不見的空間也能生成。

Og image

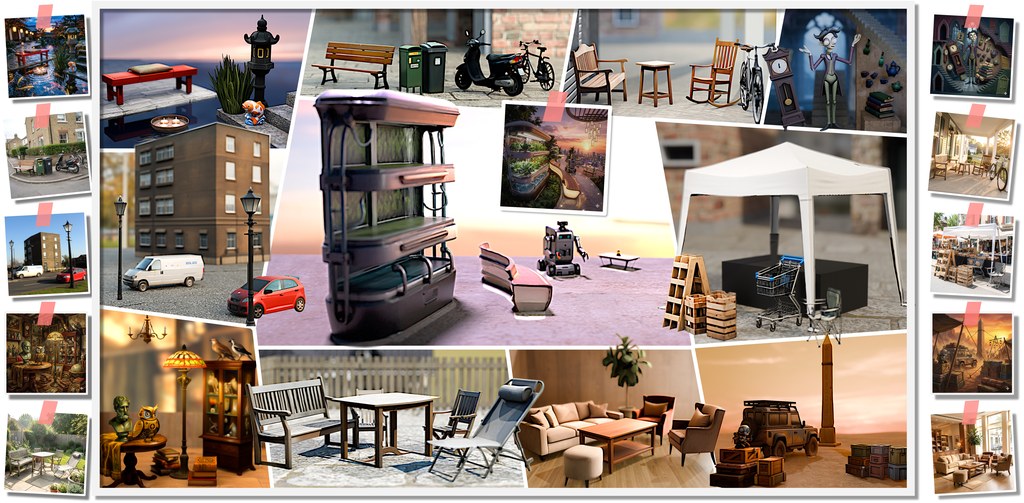
只得一張相片,Building Rome 便嘗試補全鏡頭未拍到的空間,生成室內、戶外及大型環境的完整 3D scene mesh。這個單影像 3D 場景重建項目,處理的是照片只提供單一視角、遠近物件細節不一致,以及隱藏幾何無法直接觀察的問題。

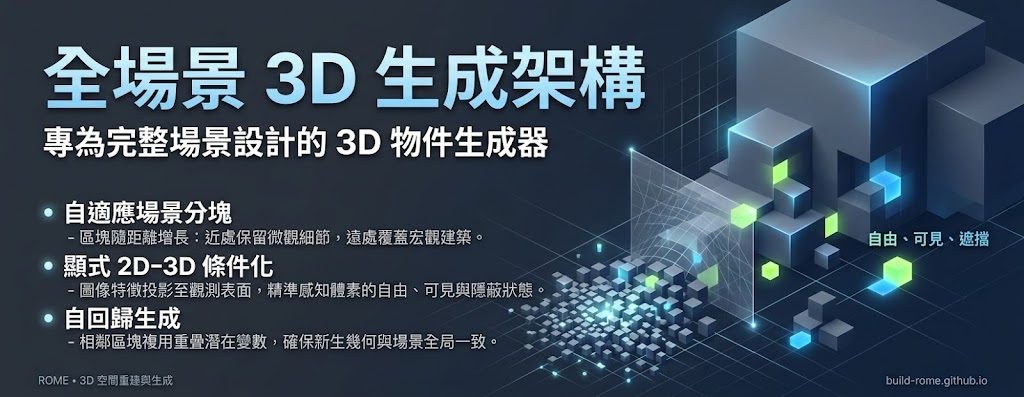
方法把場景切成會隨距離變化的 adaptive chunks:近處使用較細區塊保留細節,遠處則用較大區塊涵蓋建築。影像特徵會投射到已觀察到的表面,而每個 voxel 亦會標示空置、可見或隱藏狀態;生成鄰近區塊時重用重疊 latent,令新加入的幾何結構較能保持連貫。

讀者可以透過互動檢視重建結果,透過拖曳旋轉、滾輪縮放及 WASD、Q、E 移動,亦可選取兩點量度距離。網頁展示用 mesh 為方便瀏覽而簡化至約 1.5M faces,論文圖像及影片則採用完整解析度,因此兩者的視覺細節不應直接視為相同。

  • 單張相片重建室內、戶外及大型場景
  • 以 adaptive chunks 處理不同距離的細節
  • 透過 2D&3D conditioning 推斷可見與隱藏幾何
  • 以 autoregressive generation 延續相鄰區塊的一致性
  • Code 標示為即將提供,現時可先透過互動網頁查看結果

項目由 Applied Intuition 聯同 Purdue University、UIUC 及 UC Berkeley 研究人員完成,並以 World Tracing、GenRecon、VolFill 及 Lyra 2.0 等方法作比較。對需要由照片建立可探索環境、進行空間分析或製作 3D 內容的人,這種由單一視角推算完整場景的做法提供了另一條工作流程,但隱藏區域屬於模型生成,不能當作相片直接觀察所得的精確測量。
項目主頁 · 項目

Categories: 開源, AI productions, 模型, 視覺模型, Video, Image, 3D, Anthropic

DistScene 從圖片生成可供導航模擬的 3D 場景

生成物件之外,DistScene 也建立周邊環境,讓圖片轉成的 3D 場景可直接匯入導航模擬器。

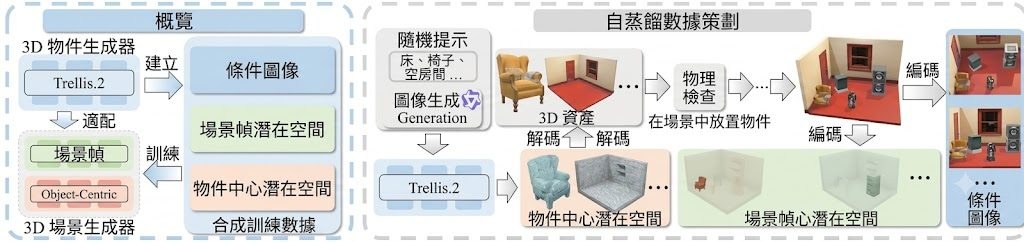
DistScene self-distilled data curation: Trellis.2 generates objects and environments, physics checks guide scene assembly, and rendering provides conditioning images.

把圖片轉成可供導航模擬的 3D 空間,需要同時建立物件與周邊環境。DistScene 這個 3D 場景生成研究項目,讓兩者在同一場景中生成,再逐件細化物件。

其 Object-to-Scene Distillation 方法以 Trellis.2 生成訓練素材:先由視覺語言模型(Vision-Language Model,VLM)描述物件與環境,再生成輸入圖片及 3D 資產,組合時加入物理檢查。

生成流程採用 Unified Scene Representation,先在共用 scene frame 內完成 sparse structure generation 與 geometry-latent generation,再把物件轉到 local voxel support,結合場景資訊細化後放回原位。

  • 同時生成環境及可分開處理的物件。
  • 場景可直接匯入導航模擬器。
  • 互動預覽經壓縮,約為原始結果的 10%。

導航模擬是已展示的用途,但程式碼、Checkpoint 及 Dataset 仍標示即將公開;目前未提供量化性能或對比結果,重現效果仍有待驗證。

項目主頁

Categories: 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, 3D, Dataset 數據集

Fold2Reason 讓語言模型學懂蛋白質結構

Fold2Reason 把蛋白質結構監督加入語言模型訓練,嘗試兼顧一般推理與三維結構讀取。

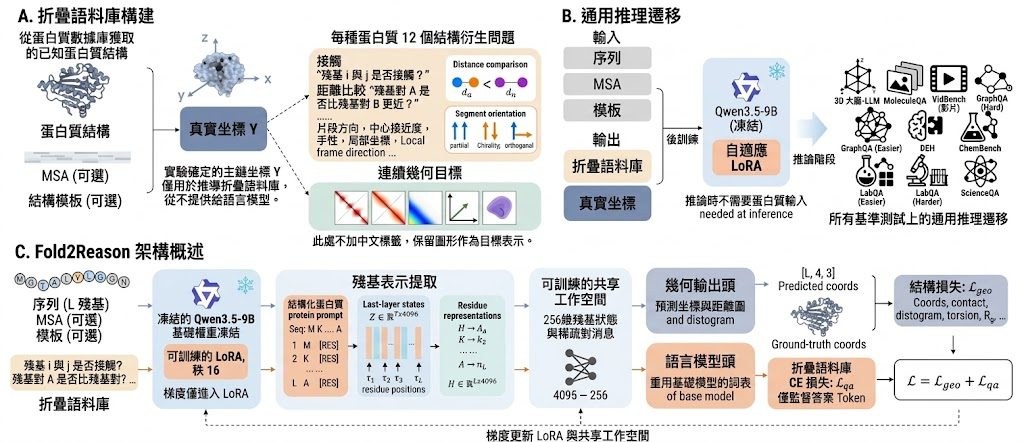
Fold2Reason diagram showing FoldingCorpus construction, general reasoning transfer, and the model architecture

要讓語言模型處理蛋白質問題,難點不只在文字理解,還包括如何保存三維空間關係。Fold2Reason 屬於模型訓練與研究型開源項目,透過 FoldingCorpus 監督資料、共享 spatial workspace 和凍結的 geometry decoder,處理語言模型推理與蛋白質結構讀取之間的銜接。

項目以 Qwen3.5 為主要訓練及評估流程,適合研究人員比較蛋白質結構後訓練對一般能力的影響。結構輸出不直接由語言模型單獨完成,而是交由 workspace 配合 decoder 讀取;一般推理則以適配後的語言模型評估,兩條結果路徑有清楚分工。

相較於只用 FoldingCorpus 訓練的 Pure-LoRA baseline,Fold2Reason 額外引入共享空間表示和凍結幾何解碼器,換來較完整的結構處理流程,同時增加資料、權重與硬件要求。項目提供確定性資料準備、LoRA/workspace checkpoint、已訓練 checkpoint 評估,以及重新訓練所需的管線。

  • 需要 Python 3.12、CUDA 相容的 PyTorch,以及指定版本的 Transformers 和 PEFT
  • dataset.zip 另行提供訓練資料、凍結 decoder 和三組 checkpoint
  • 可評估已發布 checkpoint,亦可重新進行 Qwen3.5 訓練
  • General-10 分數聚合器用於整理一般推理結果
  • 各基準測試相對基礎模型的增益,但未在提供內容列出完整數值

適合研究團隊、蛋白質 AI 模型後訓練及多模態空間表示方向的開發者。它未必適合只想快速調用蛋白質預測功能的使用者。但作為比較 LoRA、空間 workspace 與凍結幾何 decoder 的可重現實驗基礎,項目提供了比單一模型權重更完整的驗證路徑。

GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Medical醫學, 3D, Python, Dataset 數據集, LoRA

mg-styles-15:AI 寫出 15 種動態設計短片

Claude Opus 5.5 以程式碼生成畫面、動畫、音樂與音效,並公開提示詞和完整源碼。

The showcase page: the Frame-by-Frame film next to its style notes, with the prompt open below

由一段提示詞開始,Claude Opus 5.5 便能寫出 15 支各具風格的 10 秒動態設計短片,連畫面、動畫、配樂和音效都由程式碼生成。這個開源項目同時提供成片、風格說明、完整提示詞和源碼,實際解決的是把視覺創意轉成可重現瀏覽器渲染流程的問題。

每支片本質上是一個能按時間繪製畫面的網頁,以背景執行 Chrome 逐幀截圖,再由 ffmpeg 合成影片和音軌;3D 作品則額外使用 Blender。使用者需要 Node、Chrome 和 ffmpeg,複製指定提示詞後可修改故事、品牌、配色、尺寸和時長,亦可用 rubric.md 交由另一個 AI 評審再迭代。

• 15 種風格,涵蓋逐格動畫、等距 2.5D、像素藝術、液態動態及 9:16 字幕作品
• 畫面每次重新生成未必相同,原作經過多輪修訂,單次執行通常達不到相同完成度
• 音效腳本具確定性,但只有 4 支能在指定環境精確重現原音軌,其餘 11 支可能因數值庫版本而有差異
• 字體未隨倉庫提供,缺少指定字體會令文字造型與原片不同

對內容創作者、動態設計師和想研究 AI 輔助編程的人,這個項目更像可拆解的製作案例,而不是按掣即出的成品工具。它把創意、提示詞、瀏覽器渲染和聲音合成放在同一條可閱讀的流程內,方便比較不同風格如何透過程式結構呈現;代價是需要自行處理環境、字體和多輪修訂。

項目主頁 · GitHub

Categories: 開源, AI productions, Video, Audio, 提示詞, 工具, Content Creator, 3D, 庫, 編程, Anthropic, 動畫, 音樂

4Director:3D 幾何精準控制影片世界模型

4Director 將鏡頭、物件與新加入的物件放進同一個 3D 空間,改善影片生成中動作失控和視角不一致的問題。

4Director

想令影片中的鏡頭、原有物件和新加入的物件按指定路徑移動,4Director 提供了一個較接近 3D 動畫製作的控制方式。它屬於影片世界模型,處理的是生成影片時深度、旋轉和跨視角一致性難以同時維持的問題。

系統會先為每件物件重建一個 canonical mesh,再以每幀一組 rigid transformation 推動物件,並把整個場景渲染成深度影片。Motion Adapter 之後將這份幾何骨架轉換成具備外觀、光照和非剛性動態的影片;新物件則可透過參考影像插入場景,並與鏡頭及原有物件共同控制。

相較只控制鏡頭、依賴 image-plane cues,或使用 3D tracks、blobs 的方法,完整網格能保留物件未被鏡頭看見的幾何,減少物件離開畫面後再出現時形狀和身份改變的情況。影片生成研究、視覺特效預演,以及需要精確安排物件運動的製作團隊較容易受益,但重建網格和建立剛性軌跡亦增加了準備工作。

  • RealCOD-Rigid 提供 20,774 段附有剛性 3D 場景標註的影片片段。
  • Identity-Gated IoU(IG-IoU)同時衡量物件動作是否跟隨指令,以及物件身份能否保持。
  • 實驗報告指 4Director 在畫質、鏡頭控制和物件控制方面優於多種先前方法。

4Director 目前更適合作為研究原型和可控影片生成的實驗基礎,而非即裝即用的剪片工具。理解其效果時,應同時檢查生成畫面的外觀品質、指定軌跡的遵循程度,以及物件離開後重新出現時的身份一致性。

項目主頁 · GitHub

Categories: 開源, AI productions, 世界模型, Video, 工具, 3D, 動畫

EngiWorld 把工程代理接入真實軟件工作流

EngiWorld 不只測試代理人能否操作介面,更檢查它能否交付合乎工程規範的成果。

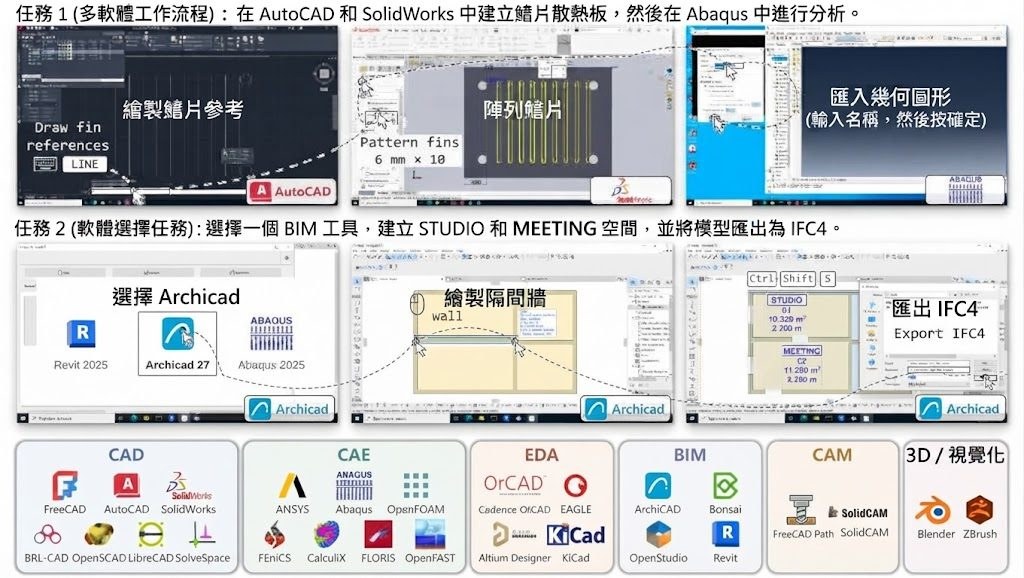
EngiWorld task examples and engineering software coverage

代理人要在 CAD、CAE、CAM、BIM、EDA 和 3D 視覺化軟件中完成工作,難點不只是點擊按鈕,而是要維持幾何、物理條件及跨軟件流程的正確性。EngiWorld 屬於工程代理人評測基準,實際處理的是「能否由指令一路產出可驗證工程成果」這個問題。

項目收錄 1,301 個專家編寫任務,涵蓋 26 個軟件平台、6 個工程領域及 6 類任務,支援 GUI 和 CLI。評測會檢查最終及中間工程文件的幾何有效性、物理可行性和規則符合度,數值設計任務亦會按規格達成程度連續計分,而非只分成功或失敗。

  • 提供完整任務、驗證器及 GUI/CLI 評測執行環境
  • 主實驗採用 300 個任務,清單位於 task/splits/main-300.txt
  • 本地環境以 Linux、Docker 及虛擬機器執行,預設每個環境使用 4 個 CPU 和 16 GB RAM
  • 七個前沿模型中,最高 EngiScore 只有 44.3;多軟件嘗試成功率為 3.6%

同類 Computer-use agents 評測多集中於一般桌面操作,EngiWorld 把判斷標準推到可交付的工程 artifact,因此更能揭示模型在長流程、跨軟件依賴及專業規範上的不足。代價是執行門檻較高:需要 x86_64 Linux、Python 3.10、Docker Engine 和環境映像,沒有 /dev/kvm 時亦可運行,但軟件模擬會較慢。

研究團隊、工程軟件開發商,以及想比較 GUI agent、CLI agent 或多模態模型能力的團隊,都可以用它重現測試並保存評測結果。它目前更適合作為嚴格的研究及模型比較工具,而非即插即用的生產自動化方案;最高分數與多軟件成功率反映,代理人距離穩定完成專業工程流程仍有明顯距離。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, Agentic, 模型, 多模態模型, 軟件, 工具, 3D, Python, Dataset 數據集

LEGO-Anything:由單張圖片生成可編輯 3D 世界

由一張圖片開始,coding agent 會逐步寫程式、渲染和修正,產出可查詢及編輯的 Blender 3D 場景。

Og image

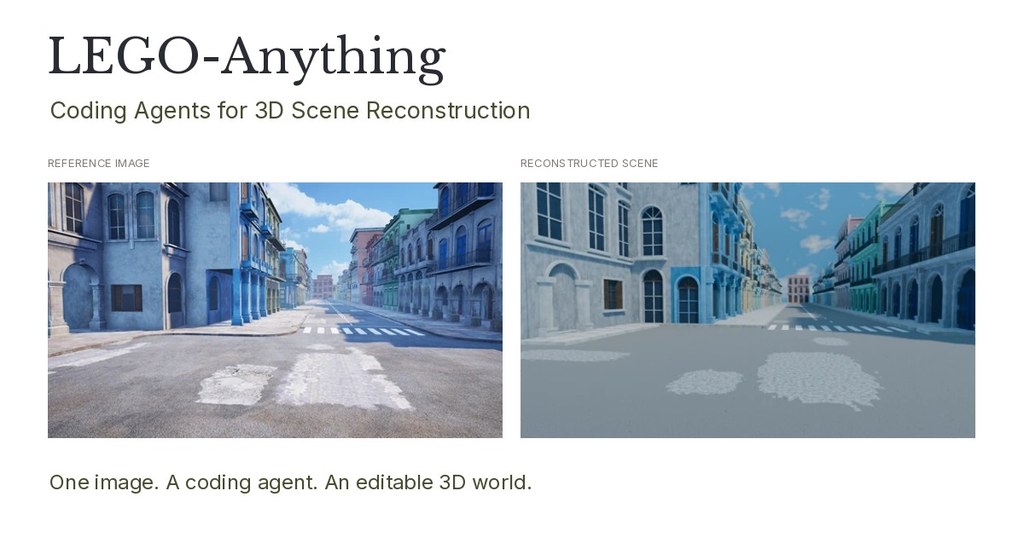
由一張 RGB 圖片開始,coding agent 會自行規劃、執行 Blender 程式、渲染結果,再按視覺檢查持續修正,將參考畫面轉成可編輯、可查詢及可匯出的 3D 世界。LEGO-Anything 同時涵蓋 agentic scene reconstruction 的框架、評測基準 LEGO-Bench,以及協助分析建構過程的 LEGO-Plugin。

項目處理的核心問題,是如何讓模型不只生成一張相似圖片,而是建立具備幾何結構、鏡頭和物件狀態的可執行場景。Agent Workspace 管理產物,Action Space 提供操作,Blender Code Structure 保存可修改的場景狀態,Scene Construction Workflow 則把參考解讀、程式生成、渲染和驗證串連起來。

LEGO-Bench 收錄來自104個場景的208張圖片,涵蓋8個環境、17個主題及443項資產,並以 Indoor、Outdoor 和 Easy 至 Hard 的物件集合測試不同難度。評分同時考慮 Blender 場景是否有效、可見表面幾何重建,以及重新渲染後的色彩吻合度;無效提交或未能完成評估的案例會取得零分。

目前公開結果顯示,GPT-6-astra 在室內及戶外分別取得53.4%及39.6%的 Overall 分數,高於其他參與比較的 coding agents;戶外場景在各難度層級都較難處理,而場景有效率仍未代表幾何和視覺細節已經高度吻合。對需要可修改 Blender 資產、可重現場景或研究 Computer-use agents 3D 操作能力的工作流,這套框架提供了較完整的測試方式。

  • 由單張圖片生成可執行的 Blender 場景
  • 透過寫程式、渲染和驗證逐步修正結果
  • 同時評估場景有效性、幾何重建和外觀吻合度
  • LEGO-Bench 涵蓋室內、戶外及多級物件難度
  • 戶外場景和高視覺保真度仍是主要限制

項目主頁

Categories: 開源, Agentic, Image, 框架, Vibe Coding, 3D, 編程, Dataset 數據集

MiniMax-H3 Orbit LoRA 360° Bullet Time 環繞鏡頭

一張相片配合同一張首尾關鍵幀,鏡頭可繞主體 360°移動,場景保持凝固並回到原始畫面。

Og image

想把靜態相片製成可循環播放的環繞鏡頭(Bullet Time),MiniMax-H3 360° Orbit LoRA 針對的正是首尾畫面難以對齊、場景容易變形的問題。它是基於 MiniMaxAI/MiniMax-H3、FL2VA variant 的 LoRA adapter,配合同一張圖片作為 first frame 與 last frame,令鏡頭完成連續 360°orbit,而人物和物件維持原本位置、姿勢及形狀。

模型的 instance prompt 明確要求只移動相機,利用 camera parallax 產生視覺變化;模型不應加入縮放、切鏡、變形或新物件。影片末端回到開始畫面,因此多段 orbit 可以串接,減少循環接點出現跳變。

  • 適合產品展示、人物定格、場景掃視,以及需要無縫循環的短片項目。
  • LoRA 屬於附加權重,不能單獨取代 MiniMax-H3;頁面未提供參數規模、上下文長度或訓練細節。
  • MTP draft speculation、v2 更新、檔名變更及 chat template 注意事項亦未有資料,不能據此推斷推論效能或資源需求。

結果比較採用相同 seed、prompt、解析度和 step count,但展示內容仍屬範例,未有量化的畫質、穩定性或速度指標。對需要精確幾何還原、長片一致性或非環繞運鏡的項目,頁面資料不足以證明效果。

模型

Categories: AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 3D, MiniMax, LoRA

Segment-Snap:讓 AI 看懂3D 場景怎樣開門

由室內3D掃描推斷可動部件、運動方式和把手位置,Segment–Snap把幾何線索與語義判斷接在同一條流程內。

Paper on arXiv

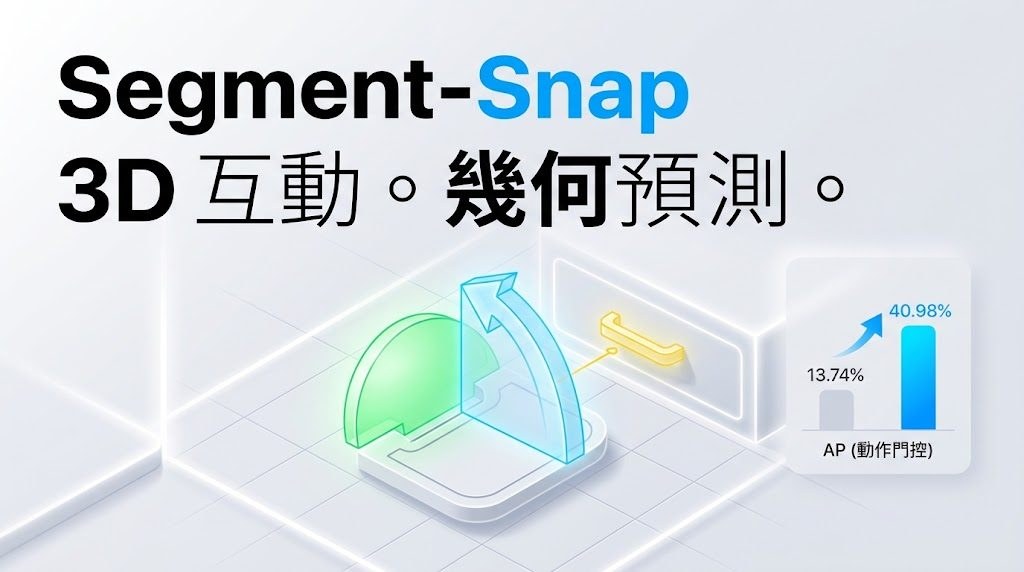
一張室內3D掃描不應只告訴你有門櫃,還要指出哪個部件會動、沿甚麼方向移動,以及人應在哪裏操作。Segment–Snap 屬於3D場景互動理解模型,處理的正是可動部件、運動類別、鉸鏈位置和把手之間的關係。

項目採用三個獨立訓練的 predictor 讀取同一個 RGB point cloud:Movable-part predictor 負責部件分割及旋轉、平移類別;Dense handle predictor 尋找細小把手;Joint part-handle predictor 再提出與部件相關的把手候選。把手位置會協助判斷旋轉部件的鉸鏈線,部件的幾何和類別則反過來改善把手標籤,兩個方向各行一次,沒有迭代式 feedback。

固定的 training-free decoder 會為可靠部件支援擬合方盒,利用垂直軸先驗推斷旋轉,並以表面法線處理平移;這令模型毋須另行訓練 motion regression。Joint predictor 的 parent parts 只作內部脈絡,最終輸出仍以獨立 Movable-part predictor 的部件結果為準,取捨相當清楚。

• Handles → part motion +27.25 個百分點,主要改善 hinge placement
• Parts → extra handles +5.01 個百分點,補充把手 proposals
• Part classes → handle labels +0.98 個百分點,修正部分 motion-class 判斷
• 三項結果來自 Articulate3D validation,指標為 motion AP 或 handle AP,增幅不可直接相加

測試時可按資料準備文件處理場景,再使用 Hugging Face 提供的 pretrained checkpoints 和 repository 內的 training configurations,重現公開 Articulate3D validation 實驗。項目較適合研究3D視覺、機械人感知、具身互動或需要分析門櫃等室內物件操作方式的團隊;它提供的是研究參考實作,並非可直接接駁家居控制系統的完整產品。

項目主頁 · GitHub · 模型

Categories: 開源, 香港理工大學, 模型, 模型訓練, 香港, 3D

Mira-Scene 單張圖片重建可編輯 3D 場景,讓畫面變成可拆解空間

Mira-Scene 將單張圖片拆成物件、深度與環境,再組合成可編輯 3D 場景,降低由 2D 畫面建立空間內容的門檻。

Mira-Scene teaser

由一張圖片開始,Mira-Scene 能分辨場景內的物件、估算深度,再為各物件建立網格並組合成可編輯 3D 場景。它屬於單圖 3D 場景重建模型與推理項目,處理的是影像缺乏空間結構、物件難以獨立編輯的問題,適合概念設計、虛擬場景和後續模擬工作。

完整流程包括互動式 instance segmentation、monocular depth estimation、canonical coordinate map(CCM)、voxel prediction、逐物件 mesh generation、支援物件接觸關係的 scene assembly,以及 environment-map generation。Hugging Face 提供的 CCM diffusion checkpoint 只負責其中一個階段,並不是可直接輸出 GLB 的獨立 image-to-3D 模型;分割遮罩、mesh backend 和場景組裝階段仍要配合使用。

Mira-Scene 採用分階段推理,支援中斷後繼續執行、多個深度及網格後端,亦可按個案分配多張 GPU。使用者可依照中文 inference、visualization 和 evaluation 指南準備輸入圖片及遮罩,再檢視各階段產物;訓練程式碼和示例訓練數據仍列在待辦事項,研究用途以外需要自行處理環境和模型資源。

• 單張圖片重建可拆解的 3D 場景
• 以 CCM 和稀疏 voxel 表示物件空間結構
• 對比 SAM3D,3D-IoU 為 0.727,較 0.520 高
• 部分指標領先,但 EMD 略遜於 SAM3D
• 開源推理流程完整,訓練部分尚未公開

評測表中,Mira-Scene 使用 80k 規模、全自動流程的數據,CD、FS@0.1、3D-IoU、ICP-Rot、2D-IoU 和 ADD-S 均優於 SAM3D;EMD 則為 0.169,稍高於對方的 0.163。這反映它在整體形狀、投影對齊和姿態誤差上具競爭力,但不能把單一圖片重建視為完整真實世界掃描,遮擋、不可見背面和網格後端仍會影響結果。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 影像處理, 3D, 蘋果

Page 4 of 15
1 2 3 4 5 6 … 15