Lucida:用「解析、生成、放置」三步把實景變成可編輯的模擬場景

字節跳動 Seed 團隊把真實室內環境拆解成獨立物件資產,透過閉環姿態修正讓重建結果能直接用於模擬。

Og image

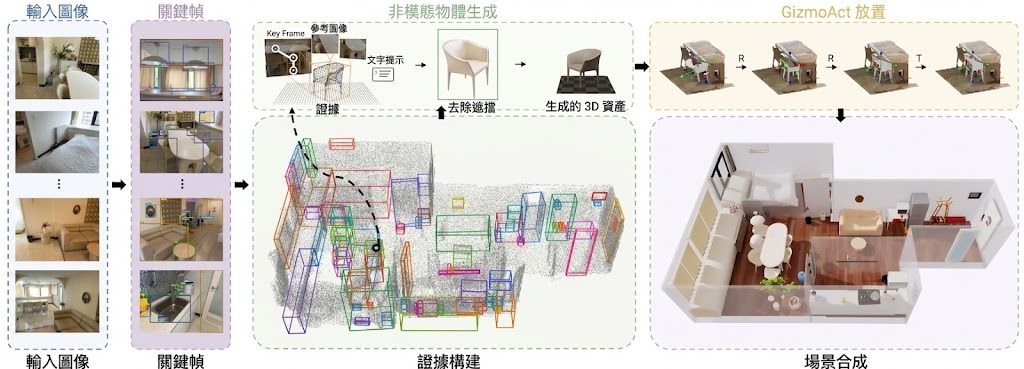
從一段真實拍攝的室內影片,要還原成可以模擬、可逐個編輯嘅場景,一直都係 3D 重建嘅痛點:擺位、遮擋同殘缺幾何往往令資產難以重用。Lucida 就係針對呢個矛盾提出嘅方案,屬於實景到模擬(real-to-sim)類嘅場景建模系統。

整個流程分成三步。第一步 Parse 揀選有用嘅關鍵幀,跨視角對應實例並建立場景圖,輸出遮擋、局部點雲同參考視圖等證據。第二步 Generate 利用每組證據合成無遮擋嘅物件影像,再提升成完整、可編輯嘅 3D 資產。第三步 Place 先粗略初始化,再用 GizmoAct 喺閉環中反覆執行姿態編輯,直到渲染結果同觀察對齊。

GizmoAct 係呢套系統嘅核心控制器,由視覺語言模型(VLM)操作 3D 編輯器,每一步根據渲染觀察、點雲疊加同正交視圖等線索,落一個可執行嘅姿態修正。同一條策略可應付由 Boxer、Any6D* 到 SAM 3D 等不同初始化,並以最多 4 個視圖同 12 步修正完成對齊。

Lucida 喺 R2S、CA-1M 同 Aria Digital Twin 數據集上都提升咗場景級 3D 物件檢測、姿態估計同完整場景重建指標。重建出嚟嘅場景以一組獨立、可編輯嘅 mesh 呈現,每件物件都準備好進入模擬階段。

對從事機器人模擬、室內數據合成或場景理解嘅團隊,呢套閉環做法比起傳統單次擬合更能容忍幾何誤差同遮擋問題,令實景資產更易直接落落去模擬器使用。

重點摘要

  • 三步流程:Parse、Generate、Place 把實景拆解成可重用物件資產
  • GizmoAct 閉環修正:VLM 操作 3D 編輯器,反覆落姿態編輯直到對齊
  • 初始化容忍度高:同一策略兼容 Boxer、Any6D*、SAM 3D 等不同起點
  • 輸出可直接模擬:每件物件係獨立、可編輯 mesh
  • 多數據集提升:喺 R2S、CA-1M、Aria Digital Twin 都有指標改進
項目主頁

Categories: 北京大學, 字節跳動, 視覺模型, Video, Image, 3D

GeoNeXt 把影片生成模型當幾何學習:統一深度與法向量估計

GeoNeXt 把現成的影片生成模型改造成單一架構,同時預測單目深度與表面法向量;只需五萬九千筆訓練樣本,就能做到跨場景的零樣本遷移。

GeoNeXt framework

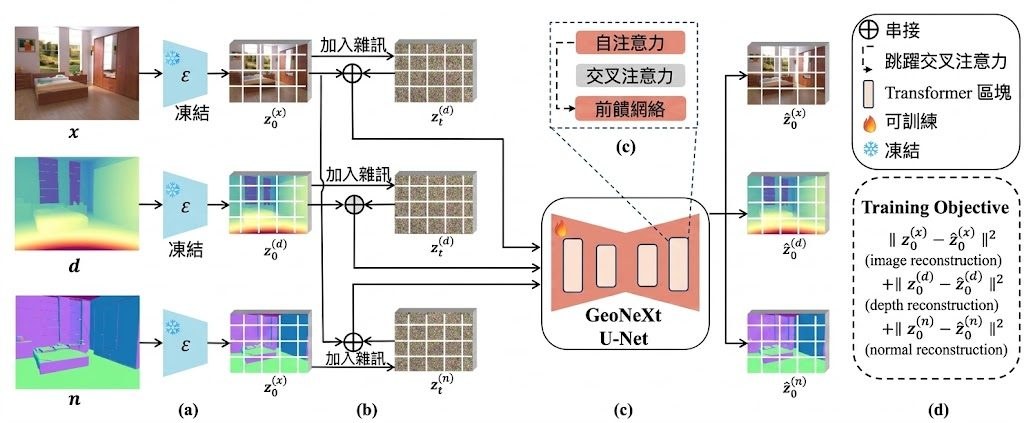
過往要從一張 RGB 影像同時取得深度圖與表面法向量,往往要靠兩個獨立網路串接,幾何一致性也容易在接縫處走樣。GeoNeXt 的切入點是把這些幾何訊號當成影片生成模型的「下一幀」:以 Stable Video Diffusion 為骨幹,把 RGB、深度、法向量一起送進 VAE 潛空間,在同一條去噪軌跡上共同生成,讓外觀與幾何從訓練開始就互相對齊。

兩個權重版本都放在 Hugging Face:GeoNeXt-Wan 約 1.42B 參數,GeoNeXt-SVD 約 1.52B 參數,兩者都能輸出深度與法向量。本地跑推論需要一張 24 GB VRAM 的 CUDA GPU,並透過 Conda 建立獨立環境;首次執行會自動從 Hub 下載所需的 checkpoint、base model 與 VAE,之後會從本地快取載入,因此斷網或重複測試時可直接用 –checkpoint、–base-model、–vae-model 指向本地檔案。

從應用角度,3D 重建、AR/VR 場景理解、機器人視覺等需要一致幾何的工作流都會受惠;研究員也能把它當作零樣本基準,與 GeoWizard 等專用模型直接比較深度、法向量及重建網格品質。

重點摘要:

  • 新意:把幾何估計重新表述為影片模型的下一幀預測,讓 RGB、深度、法向量共享同一條去噪軌跡。
  • 規模:以 Stable Video Diffusion 為基礎,提供 Wan 與 SVD 兩組約 1.4B–1.5B 參數的權重。
  • 數據效率:只用 59K 訓練樣本,就在多個基準上做到強健的零樣本泛化。
  • 硬體門檻:24 GB VRAM 的 CUDA GPU 即可推論,兩個版本需分開建立 Conda 環境。
  • 差異:相比串接兩個專用網路,單一模型同時輸出深度與法向量,有助於改善跨通道的一致性。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 世界模型, Video, Robotic, 3D, Dataset 數據集

ABot-Recon 用 12 幀極簡局部記憶重建 3D

AMAP CVLab 提出的 ABot-Recon 放棄複雜的長程記憶機制,改用固定的 12 幀局部上下文,逐步拼接出穩定的長影片 3D 重建結果。

ABot-Recon long-horizon reconstruction teaser

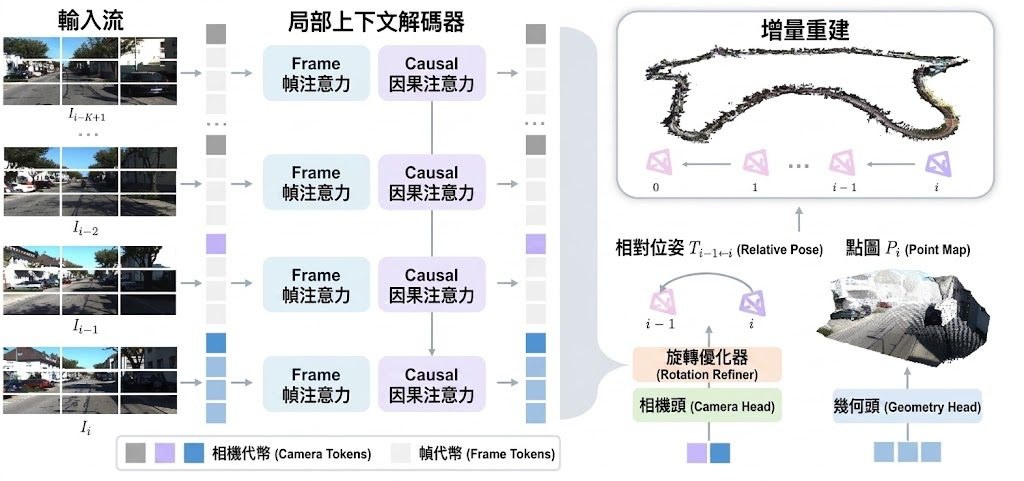
ABot-Recon 是一款專為長影片流(streaming)設計的 3D 重建框架,來自阿里 AMAP CVLab。它選擇了一條反潮流的路線:不堆疊長程記憶模組,而是用固定的 12 幀局部上下文,邊看邊重建。對於自駕車、機器人或 AR 導航這類需要持續處理長影片的場景,直接解決了「序列越長、記憶越爆」的核心痛點。

運作上,模型每一幀只參考前 11 幀的 KV 特徵,預測當前幀的點圖(point map)與相鄰幀的相對位姿,再透過位姿串接逐步還原出全域軌跡與點雲。這意味著模型狀態記憶與單幀計算量都不會隨影片長度增長,硬體門檻更容易控制。

與傳統做法相比,ABot-Recon 刻意避開了持久學習式長程記憶,用一個輕量的 motion-visual rotation refiner 和 composition-aware pose loss 來壓制位姿累積誤差,把「記憶」的責任還給幾何拼接本身。

這套做法適合需要長時間穩定重建、又不想被龐大 GPU 記憶體綁架的團隊,例如自駕資料處理、機器人 SLAM 或城市級掃描項目。Hugging Face 與 ModelScope 已有現成 Demo 可即時試玩,模型權重同步開源;訓練代碼與完整訓練方案預計於 9 月 30 日前釋出。

重點摘要:
– 固定 12 幀局部上下文,拒絕堆疊長程記憶
– 記憶與單幀計算量與序列長度解耦
– 以位姿拼接 + 旋轉優化抑制長距離誤差累積
– Hugging Face / ModelScope 提供線上 Demo
– 訓練代碼與配方預計 9 月 30 日前開源

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視覺模型, 世界模型, Robotic, 3D

God’s Eye View 開源:用瀏覽器砌出間諜衛星視角

把航班、船舶、地震同公共鏡頭即時疊上一個寫實 3D 地球,配以 AI 聲控同 GLSL 濾鏡,唔使安裝就玩到。

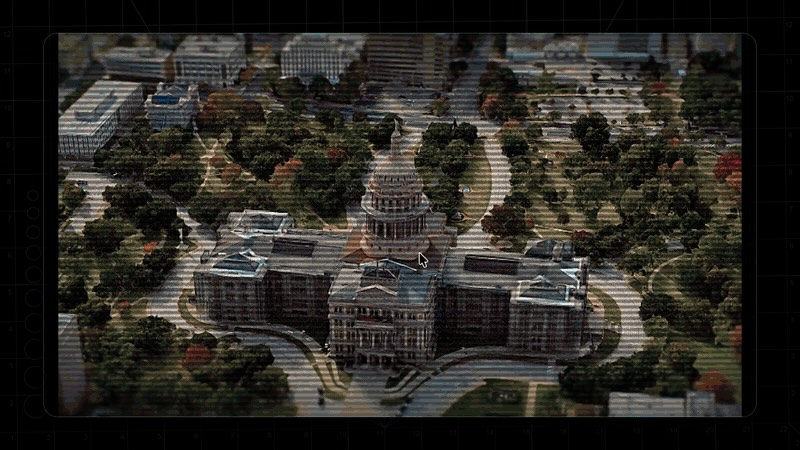
YouTube 上 God View 系列影片累積過五百萬次觀看,開發者 Bilawal Sidhu 直接把整套介面開源——God’s Eye View 是個純瀏覽器端的 3D 地球模擬器,把 ADS-B 航班、AIS 船舶、衛星軌道、地震儀、公開 CCTV 等公開訊號源即時疊加到寫實地球儀上。對於想用單一畫面追蹤全球動態的研究者、航迷或 OSINT 玩家來說,它把過往要開十幾個分頁的情報工作濃縮成一個可縮放、可標註、可聲控的 3D 空間。

與坊間 OSINT 工具最大分別是「空間感」與「混合實境感」:點擊飛機即可進入模擬駕駛艙鏡頭,相機會貼着地形俯衝;鎖定目標後會拖出淡出軌跡,遇上山火或船艦更會一鍵交棒到最近公共鏡頭。沒實時鏡頭的位置會清楚標示為模擬畫面,連火箭上升軌跡都標明 RECONSTRUCTED ESTIMATE,刻意延遲一個輪詢週期以換取流暢插值。

God’s Eye View Blew Up. Here's What You Can Do With It.

技術上它由 Three.js + GLSL 自定着色器渲染地球,加入夜視、紅外熱成像、雪花雜訊等感測器風格濾鏡,並用一個 realtime AI agent 接管語音指令——可以直接講「追蹤呢班機」、「喺這個位置畫邊界」落去執行。3D Hangar 提供 787、ATR-72、Citation、Bell 206、MQ-9 等真實飛機模型,鏡頭拉近時符號會自動切換成 3D 模型。

We Got Open Source Palantir Before GTA 6

目前主要以開源 GitHub 項目形式發佈,實際部署流程仍須查閱儲存庫內容。適合做簡報 demo、地理課堂或開源情報練習的展示層,但若需要穩定商用級數據準確度,仍要自行評估延遲同模擬標記帶來嘅限制。

GitHub

Categories: 開源, Agentic, 3D

UrbanGround 開源:真實香港城市級 3D 沙盒多模態智能體

UrbanGround 是一個以香港全境 3D 地理數據搭建的城市級模擬環境,可直接用第一人稱遊玩,亦可讓 MLLM 智能體透過程式介面操作同一個世界。

UrbanGround: From Local Perception to Spatial Agency in a Real-Scale City

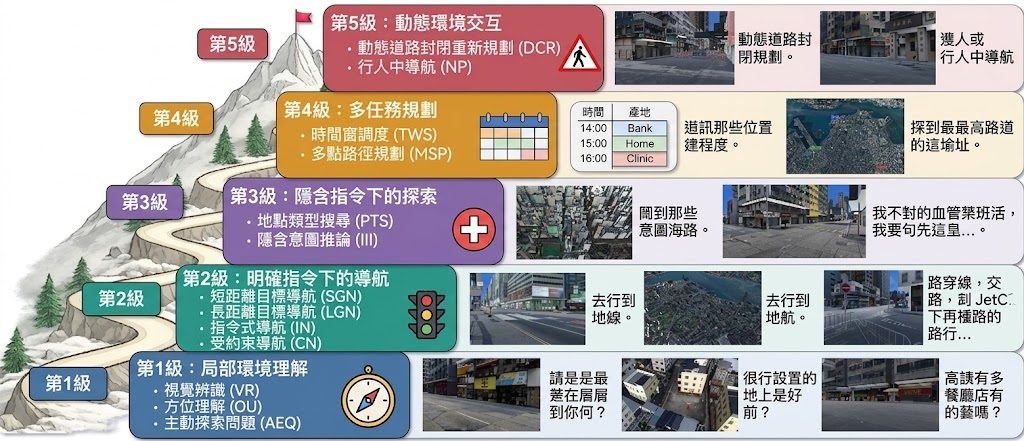
UrbanGround 由一個學術團隊在 GitHub 上開源,整個項目的野心在於把「真實城市規模」這件事帶進多模態智能體(Multimodal Large Language Model, MLLM)的研究裡。它以香港的 3D Visualisation Map 為底層地理數據,搭配 Unity 場景提供第一人稱連續移動、碰撞與日夜、天氣、行人等動態變化,使用者可以直接以 WASD 鍵盤操作在城市裡行走、爬樓梯、找地點、切換視角,亦可以交由 AI 智能體透過程式介面(HTTP API)取得 RGB 觀察、物理動作與地圖資訊,自行決策。

這個環境和過往以小型合成場景或封閉遊戲引擎為主的做法相比,核心差異在於「規模」與「真實地理閉環」:智能體看到的不是抽象方塊,而是一座真實城市的街道、樓宇、地形,並且觀察、動作、地圖三者來自同一個介面,方便研究者設計貼近真實導航、空間感知與任務規劃的測試。整個項目同時釋出網頁版、macOS、Windows 與 Linux 原生版本,並附上多個由五個能力層級組成的評測任務,供 MLLM 在感知與行動兩端做系統性比較。

對研究 MLLM 空間智能、城市導航或數字孿生的團隊來說,UrbanGround 提供了一個比手工搭建的小場景更貼近現實的測試場;對一般玩家或開發者而言,它也是一個能在瀏覽器直接探索香港街景的實驗性沙盒。需要留意的是,網頁版首次載入完整 Unity 場景在繁忙時段或慢速網絡下需時約 3 至 5 分鐘,作者建議從 GitHub 下載並在本地網絡提供 tile 數據以加快速度。目前場景仍有「模糊或不完整幾何」以及「車輛與行人種類有限」等已知限制,相關修正在路線圖中。

重點摘要:

  • 真實城市規模:以香港全境 3D 地理數據驅動,非抽象小型合成場景。
  • 雙操作介面:第一人稱玩家與 MLLM 智能體共享同一套 RGB 觀察與動作 API。
  • 跨平台發佈:提供網頁版與 macOS、Windows、Linux 原生應用。
  • 結構化評測:內建多層級任務,用於量度多模態智能體在感知與行動上的能力。
  • 已知限制:場景幾何仍有缺損,車輛與行人種類待擴充。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 多模態模型, API, 香港, Mac, 3D, Linux, Dataset 數據集

Super-Star:讓數字人邊聽邊做

Super Star 將串流語音、對話和身體動作連成一條即時管線,令 3D 數字人毋須等待完整語音才開始配合手勢。

logo

數字人要一邊回應、一邊自然做出配合語氣的動作,關鍵不只是生成語音,而是不能偷看未來內容。Super Star 屬於面向 3D 數字人的即時互動框架,處理多模態輸入、串流回應語音,以及與語音同步的身體姿態生成。

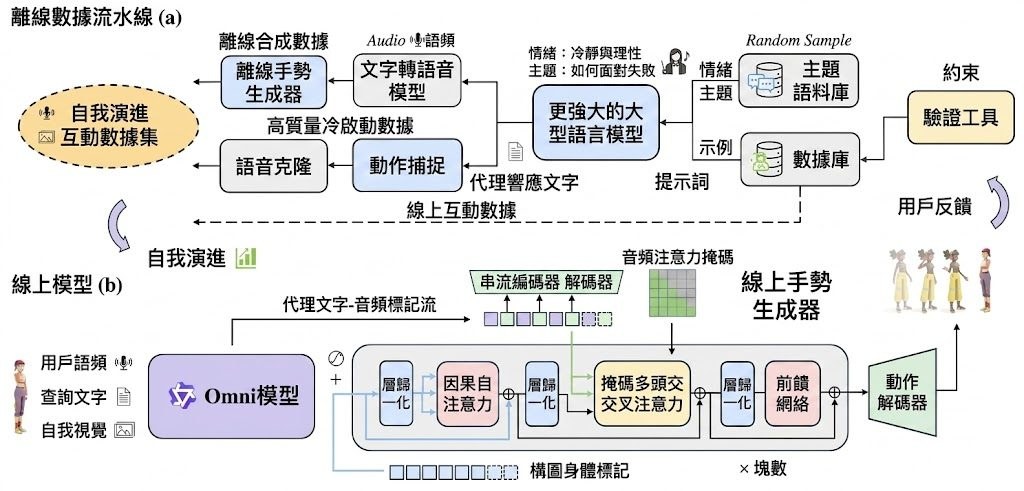
Super-Star 把 Streaming Speech Response 與 Online Gesture Generator 兩個模組接合。前者採用 Qwen3-omni 產生串流回應語音,後者是因果多模態自回歸模型,根據目前收到的語音和 motion history 預測下一段動作,因此可在低延遲下生成手勢,不需等整段對話完成。

離線資料流程會按主題和情緒建立人機對話,再為回應語句生成 co-speech gestures;線上互動收集到的使用者偏好,會回流到 closed-loop self-evolving data pipeline,支援持續調整。相比先取得完整語音再生成動作的做法,Super Star 以較少未來資訊換取即時性,但動作預測亦更依賴目前語音片段和歷史狀態。

  • 串流語音與動作同步,適合虛擬陪伴、直播角色及互動式數字人
  • Qwen3-omni 負責回應語音,Online Gesture Generator 負責身體動作
  • 研究結果主張改善 latency-quality trade-off、語音動作同步及使用者偏好
  • 訓練 Motion Tokenizer 和 Online Gesture Generator 時需要 WAV 音訊
  • CUDA driver 需為 12.4 或以上,完整執行細節仍要配合 Qwen3-omni 及 vLLM-Omni 文件

提供的資料包含 training、inference 和 evaluation code。訓練部分使用 RQVAE 的第一層 codebook 解碼,對應論文線上模型採用的 VQVAE,測試者需要準備 WAV 檔案並填寫音訊路徑和輸出目錄。對研究團隊及需要低延遲數字人互動的開發者而言,項目較適合作為研究原型或客製化系統的起點,而非即裝即用的成品。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, 多模態模型, 模型訓練, Qwen, NVIDIA, Audio, 3D, 語音, Dataset 數據集

[影片教學] 利用開源探索 3D 世界

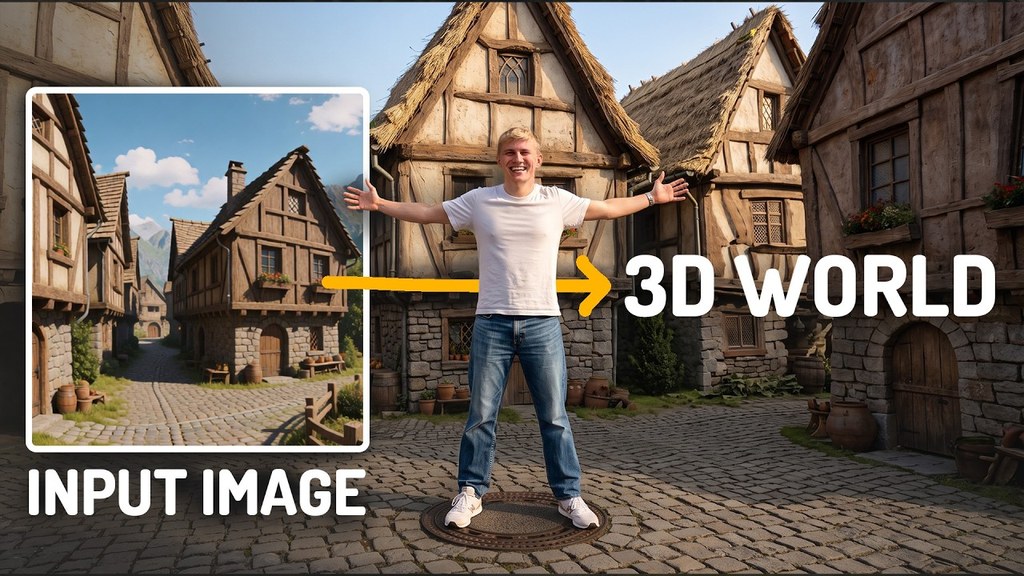
這個開源項目讓你用一張圖或一段文字 prompt,在本地免費生成可自由行走的 3D 世界,毋須依賴雲端服務。

Og image

過往要把一張圖變成可探索嘅 3D 場景,往往需要動用雲端 GPU 或者封閉式商業工具。一個新開源嘅世界生成項目反其道而行,主打「本地、免費、完全開源」,用家只需要餵一張圖片,或者寫一段文字 prompt,就可以產出一個可以行入去慢慢逛嘅 3D 場景。對遊戲開發、空間設計或者 VR 內容創作嚟講,呢種「零門檻起手」嘅流程可以省卻大量建模時間。

同一般文生圖或者文生影片模型唔同,呢類世界生成系統要處理嘅唔係單一畫面,而係保持視點一致嘅連續空間。背後通常會結合影像生成、深度估計同體積渲染(volumetric rendering)等幾組技術,再用 NeRF(Neural Radiance Fields,神經輻射場)或類近嘅 3D 表徵方式重建場景,等用家可以即時改變視角行入去睇。

對玩家嚟講,最直接嘅體驗係輸入一張京都街景相或者一句「霧夜嘅科幻實驗室」,幾分鐘之後就有一個可以操控角色行入去嘅小型世界;對開發者嚟講,由於整套工具鏈都係本地行得通,唔使擔心 prompt 或者素材被上傳到第三方伺服器,私隱同成本都較易掌控。

不過本地跑呢類模型對 GPU 仍然有要求,視訊記憶體唔夠嘅話生成時間會明顯拉長;另外世界嘅規模同互動深度仲未去到遊戲引擎嗰種水平,比較適合作為概念驗證或者素材起手稿,而唔係完整場景嘅最終方案。

以下係幾個值得留意嘅重點:

  • 支援圖生世界(image-to-world)同文生世界(text-to-world)兩種入口
  • 完全開源,可在本地離線運行
  • 採用神經輻射場或類近技術做 3D 重建,保持視角一致
  • 私隱同成本上比雲端方案更具優勢
  • 對 GPU 仍有要求,目前較適合做概念驗證階段

項目主頁

Categories: AI productions, 世界模型, Image, 影像處理, 教學, 3D

Block3D 把文字轉 3D 生成加速至 4.99 秒

Block3D 以區塊式擴散處理 3D shape tokens,在保留幾何質素及修正能力的同時,將生成時間大幅縮短。

Block3D conceptual comparison

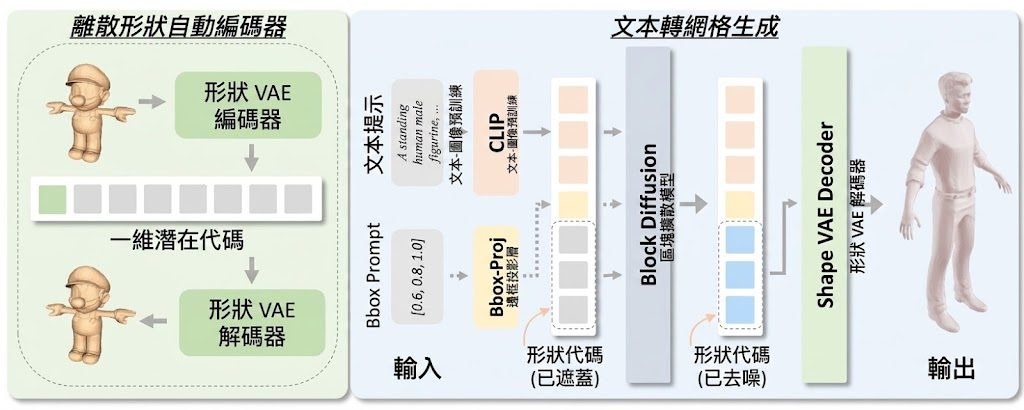
由文字描述生成可用 3D 網格,往往要在幾何細節、生成速度和錯誤修正之間取捨。Block3D 是一個開源 text-to-3D 生成框架,針對離散 shape tokens 的逐個生成瓶頸,把固定長度的序列分成連續區塊,逐區塊生成並同時更新區內所有 token。

Block3D 延續自回歸模型由左至右的因果結構,但不再逐個 token 等待生成。每個 active block 會先進行 mask-to-token recovery,再以 token-to-token correction 修正低信心內容,確認後才提交並快取;凍結的 Cube shape encoder、text encoder 負責提供條件,Cube shape decoder 則把完整序列轉成輸出網格。這讓它比需要反覆處理整個 3D 表示的 diffusion 或 flow-matching 方法節省計算,也補上傳統 autoregressive decoding 難以回頭修正的限制。

在 TRELLIS-500K 留出測試集上,Block3D 的平均端到端生成時間為 4.99 秒,較微調後的 autoregressive baseline 25.71 秒快 5.15 倍,同時維持相近的幾何質素;報告指標包括 1% 閾值 F-score 0.309 和 normal consistency 0.668。結果適合需要批量產生概念模型、遊戲資產草稿或 3D 設計初稿的研究及開發團隊,但不能直接理解為所有提示詞和複雜網格都能維持同一水平。

測試需要 Linux、Python 3.10+、PyTorch 2.2+ 及 CUDA,訓練報告使用四張 NVIDIA A100 80GB GPU;TRELLIS-500K 數據不隨儲存庫提供。推理、訓練和評估程式已公開,pymeshlab 屬可選元件,Blender 只在 trimesh 無法直接讀取某些網格格式時需要,PyTorch3D 則用於 eight-view CLIPScore 評估。

  • 速度:平均 4.99 秒完成一次端到端生成。
  • 方法:區塊間保持因果生成,區塊內進行並行去噪及信心導向修正。
  • 質素:在 TRELLIS-500K 測試集維持 0.309 F-score@1% 及 0.668 normal consistency。
  • 門檻:需要 CUDA 環境;訓練成本以四張 A100 80GB GPU 為參考。

Block3D 的價值不只在於縮短等待時間,而是以區塊為單位保留部分修正空間,兼顧自回歸生成的結構控制和並行處理的效率。對需要自行研究 text-to-3D 推理流程、比較 Cube 與 TRELLIS 相關方法,或建立批量生成管線的團隊,它提供了可直接檢驗的開源基礎;對只有一般消費級 GPU 的個人使用者,則應先確認推理配置和模型資源是否足夠。

項目主頁 · GitHub

Categories: 開源, NVIDIA, 3D, Linux, Python

GameXpert-Bench | Coding Agents for Game Development

騰訊團隊聯同多間院校提出 GameXpert-Bench,專門看 Coding Agents 能否做出、修好再優化可玩遊戲。它把生成、修復同多輪改進放入同一條流程去評估。

Og image

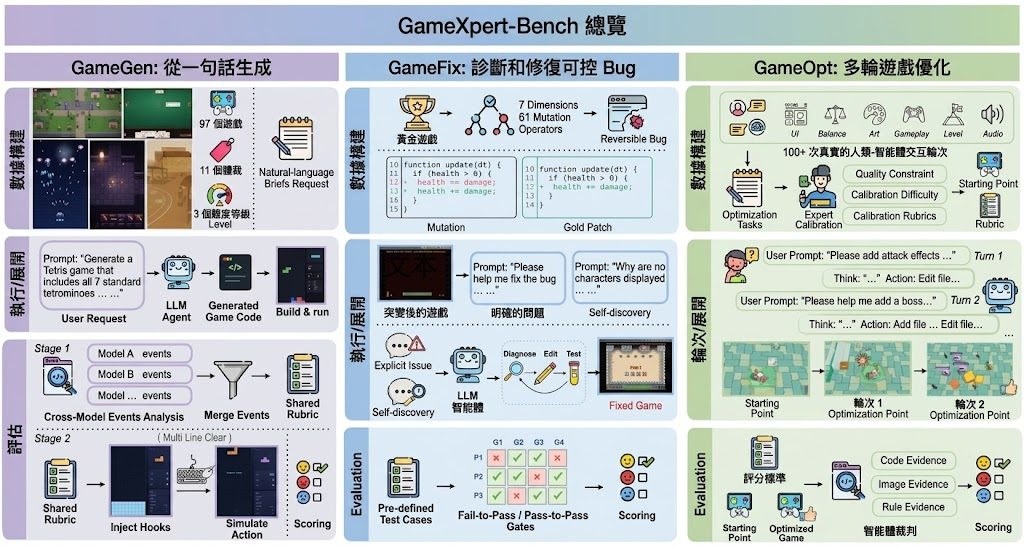
騰訊 Hunyuan Team、Lightspeed Studios,聯同 CASIA、清華大學、香港科技大學、香港中文大學深圳等團隊,提出 GameXpert-Bench,用來檢驗 Coding Agents 在遊戲開發上的真實能力。它不只看程式碼寫得像不像,還看能否真的做出可玩遊戲、找出錯誤,並在多輪修改後保持功能完整。

這個項目處理的是一個很實際的落差:很多代理可以生成看似合理的程式,但一到互動、畫面、音效、介面同可玩性要同時成立,就容易出問題。GameXpert-Bench 把整個生命週期拆成三條軌道,分別測首次生成、修復缺陷,以及連續優化,逼近真實開發流程。

  • GameGen 測試從零開始生成可玩遊戲,沒有預設引擎或素材
  • GameFix 測試對已知缺陷的診斷與修復,亦包括自行發現問題的情況
  • GameOpt 測試多輪改進時能否保住核心玩法與既有功能
  • 評估不只看程式,還結合互動行為、代碼檢查同人工判斷

目前公開資料提到共有 97 個生成任務、100 個修復任務,以及 17 條多輪優化鏈,涵蓋 2D 和 3D 遊戲。整體結果指向一個清楚結論:寫出看似合理的實作,比起交出經過驗證、又唔會在後續修改中壞掉的遊戲容易得多。

對做 Coding Agents、遊戲工具鏈、或研究 agentic software engineering 的讀者,這個基準特別有參考價值。它把「能寫」和「能交付」分開,令模型在真實工作流中的短板更容易被量度出來。

項目主頁

Categories: 香港中文大學, 香港科技大學, 清華大學, 騰訊, Agentic, Audio, 軟件, 3D, 編程, Dataset 數據集

RapidLiDAR:單次前向傳播做到 10 Hz 嘅 LiDAR 場景補全

佢將稀疏嘅部分點雲一次性還原成稠密場景,主打即時同可調速度,適合對延遲敏感嘅自動駕駛同機器人開發者。

Repository image for AzharSindhi/RapidLiDAR

對做自動駕駛或機械人感知嘅人嚟講,LiDAR 場景補全最頭痛嘅唔係質素,而係慢——好多現有方法要幾百毫秒先出一幀,根本追唔上車規或即時反應嘅需求。RapidLiDAR 嘅定位就喺呢度:佢設計成一個端到端、單次前向傳播嘅補全模型,目標係跑到接近 10 Hz,同時保留可調速度同可調節輸出密度嘅彈性。

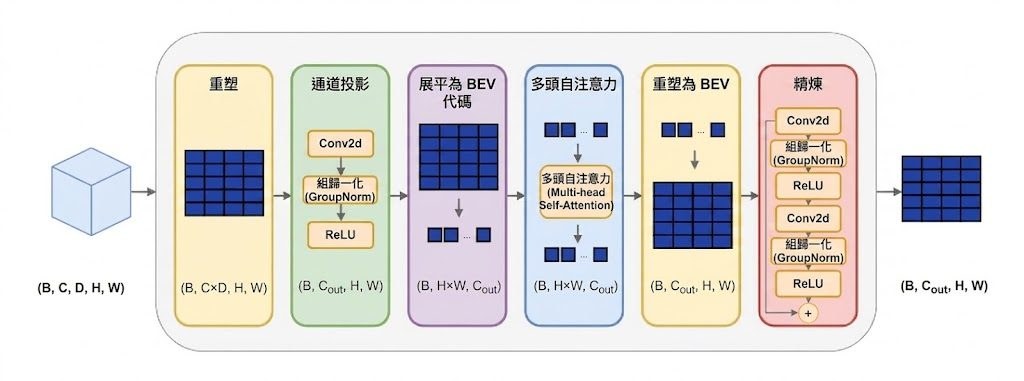
做法上,佢先用體素化抽取多尺度 3D 特徵,再透過一個自注意力 BEV 頭產生密集 2D 特徵圖。Adaptive Initialization Module 會預測一個空間變化嘅位移,把稀疏點雲「撐開」做粗略初始化;之後 Multi-Scale Reconstruction Module 用可變形注意力(deformable attention)將每點特徵同多尺度 BEV 特徵對齊做精修。如果想再稠密仲可以加一個可選嘅 Refinement Network 喺凍結嘅主模型上做上採樣,倍率為 κ。

換句話講,舊方法通常分開做初始化同迭代 refinement,或者用兩階段網絡先粗後細;RapidLiDAR 將呢幾步壓入一次前向,靠 BEV 座標化同可變形注意力同時兼顧效率同幾何一致性。代價係依賴 SemanticKITTI 風格嘅資料 loader,需要 .npy 格式嘅 GT 同 input 配對,唔係 out-of-the-box 處理原始 Velodyne 掃描。

適合做自動駕駛 stack、實時 SLAM、機械人感知原型,或者想喺邊緣裝置上試稠密 LiDAR 預測嘅團隊。原文強調即時性為 10 Hz,具體 mIoU 或 Chamfer distance 等數字未在 README 完整列出,安裝需 CUDA 12.4 同 PyTorch 2.4.1,並要自行 JIT 編譯 Chamfer distance CUDA extension。

GitHub · Paper

Categories: 開源, 模型, 視覺模型, NVIDIA, Robotic, 3D, Python, Dataset 數據集

Page 2 of 10
1 2 3 4 10