Film space:用 iPhone 走出 AI 鏡頭路徑

想為 AI 影片保留真人運鏡感,Film space 提供一個幾直接的方法。你可以先喺 3D 場景排位,再用 iPhone 把走位同鏡頭移動錄成參考片段。

Film space

拍 AI 風格化影片時,最難控制的往往唔係畫風,而係鏡頭點樣郁、人物點樣企。Film space 把呢個問題拆得幾務實:它屬於 3D 預演工具,用 iPhone ARKit 把你真實行走時的裝置移動,轉成可錄製的虛擬鏡頭路徑,之後再交畀 Seedance 2.0 呢類工具做 AI style transfer 參考。

它的定位唔係直接生成影片,也唔係完整剪接系統,而係補上 AI video workflow 入面最易失真的一段:先用虛擬 studio 做 blocking,再用手機走一次鏡頭。相比純文字提示詞或者只靠模型自己猜運鏡,Film space 換來的是更清楚的鏡頭方向感;代價是你需要親身拿住 iPhone 進行錄製,而且目前明顯偏向單機、裝置端流程。

部署方式:整個流程在裝置上完成,建議橫向畫面使用,錄好的片段會存入相簿,再帶去後續生成工具。場景編排包括棋盤地板、格線、座標軸,亦可加入 human stand-ins 來模擬人物站位;去到 Camera mode,手機的移動、轉向與傾斜會直接變成鏡頭運動,配合 35mm、50mm、75mm、200mm 焦段預覽,對做分鏡、音樂錄像、短片測鏡頭的人尤其有幫助。

  • blocking、走位同運鏡參考集中在同一個 iPhone 流程處理
  • 重點唔在生成畫面,而在為 Seedance 2.0 等模型提供更穩定的鏡頭參考
  • 以 ARKit 驅動 Camera mode,保留真人手持鏡頭的節奏感
  • 有基本 lens simulation 同 stand-ins,足夠做前期預演,但未見到進階場景製作能力

效能數據同正式 benchmark 目前未有公開,因此較難量化追蹤精度或錄製穩定性;現有資訊較能確認的是工作流設計,而唔係模型級指標。Film space 最適合用來做前期測試、概念驗證同低成本鏡頭預演,尤其當你想保留真人運鏡感,但又準備把最終畫面交畀 AI 重新風格化,這個項目的價值就會幾明顯。
GitHub

Categories: 開源, AI productions, Video, 工具, 3D, Dataset 數據集

AsySplat:3D 場景重建更省算力

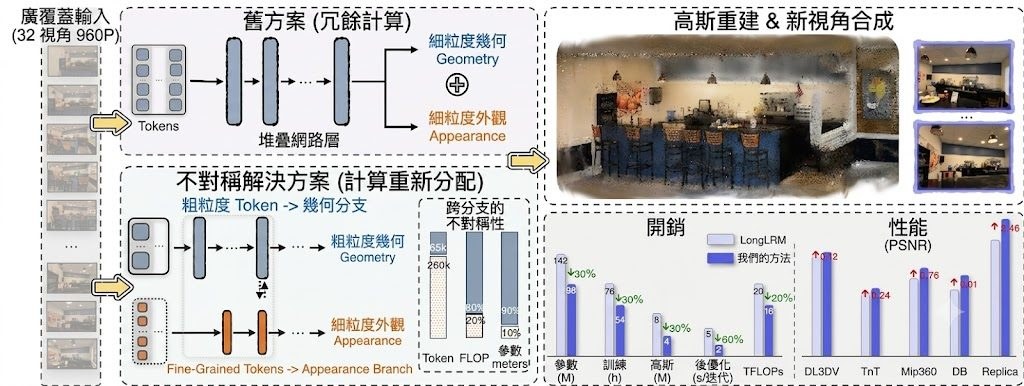
長場景的新視角合成,常見難點是算力花得多,但畫面未必再明顯變好。AsySplat 直接把幾何和外觀分開處理,在保留細節之餘減少重複計算。

Teaser Image

AsySplat 是一個用於 3D Gaussian Splatting 的重建框架,主力解決長序列、廣覆蓋場景做新視角合成時,訓練和推理都太重的問題。現階段這個 GitHub 儲存庫主要提供項目頁、論文連結和資源,程式碼尚未公開,所以要理解它,重點放在方法設計而不是直接安裝部署。

它的做法是把 geometry branch 和 appearance branch 分開,前者處理較粗粒度的資訊,後者用較少參數補回外觀細節,再用 bilateral connections 互相引導。這種取向和一般把所有資訊一起硬塞進去的做法不同,目標是把算力用在更值得的位置。

從現有資料看,AsySplat 比較適合做多視角場景重建、研究級新視角合成,或需要在較大輸入規模下控制訓練成本的團隊。同時使用 sparse attention module,結合 convolution blocks 和 self attention 來減少開銷,並在 32-view 960P 輸入上取得較少參數和較低訓練、推理負擔的結果。

  • 類型:3D Gaussian Splatting 重建框架
  • 目標:降低 wide-coverage scene modeling 的重複計算
  • 特色:幾何與外觀分流處理,再以 bilateral connections 協調
  • 效能:在 32-view 960P 設定下,宣稱比之前的 generalizable models 更省參數和開銷
  • 相關模型:3D Gaussian Splatting、generalizable 3DGS models、novel view synthesis (NVS)

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港城市大學, 香港, 3D, Dataset 數據集

VideoChat3 一個睇得耐又睇得準的影片模型

要同一個模型同時處理細微動作、長片理解同直播回應,一向好難。VideoChat3 把重點放在時序理解同效率,定位相當清晰。

VideoChat3 logo

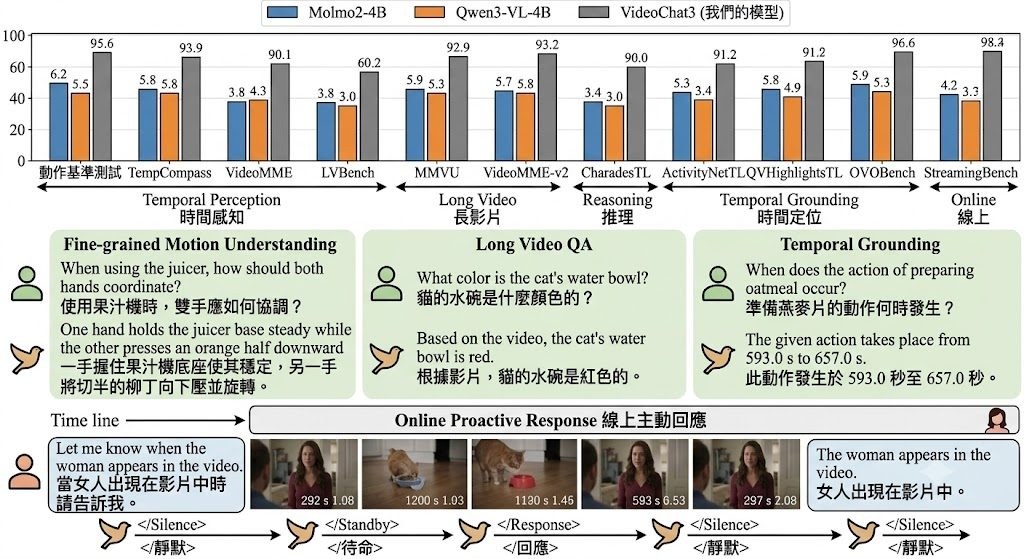
影片理解最麻煩的地方,往往唔係「識唔識睇」,而係要一邊保留動作細節,一邊捱得住長時間片段。VideoChat3 就係朝住呢個矛盾落手:它屬於多模態模型(Multimodal Large Language Model, MLLM),目標係用同一個 4B 模型處理細微動作、長片推理、temporal grounding 同 live streaming 回應。

同類項目好多時只會專注其中一段工作流,例如短片動作辨識,或者長片問答。VideoChat3 的取向係做 generalist video understanding,代價就唔係追求單一場景最極致的規格,而係用 I3D-ViT 同 Adaptive Frame Resolution 平衡 token 成本、時序證據同延遲,令模型唔需要全程用高成本方式讀完整段影片。

  • 重點唔只係睇單格畫面,而係保留跨時間的證據
  • I3D-ViT 提供 16× spatiotemporal compression,主打效率
  • Adaptive Frame Resolution 會按需要提高畫面解析度,較適合 streaming 場景
  • 已公開 model weights 同完整訓練數據,但 training code 仍未釋出

部署同測試的理解方式幾直接:現階段較接近研究釋出與模型體驗,適合先經 Hugging Face 取用 models & data,再按示範場景驗證長片問答、時間定位同串流回應表現。README 已列明完整訓練資料包括 Academic2M、LV116K、OL617K,對研究團隊、做 video agent、或者要建構影片檢索與監察流程的團隊最有參考價值。

公開資訊亦交代咗幾個關鍵數字:4B parameters、3M curated instruction samples、2,048 frames 下約 20.4s latency。呢啲數據未必代表所有環境都會有同樣效果,但至少講清楚它想證明的方向:唔靠超大模型,都可以把影片中的時間線索、事件關聯同即時反應放入同一套架構。相關模型與模組則以 VideoChat3、I3D-ViT、Adaptive Frame Resolution 為核心,整體更似一個面向研究與進階應用的開源影片理解項目。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, 模型, 視覺模型, 多模態模型, Video, 框架, 3D

Hallo4D 點樣補救 3D 與 4D 生成穿崩

3D同4D生成最怕畫面一轉角度就走樣,或者動起來之後角色忽然變臉。Hallo4D想處理的,正正是這類跨視角、跨時間都難收拾的失真。

4d boy

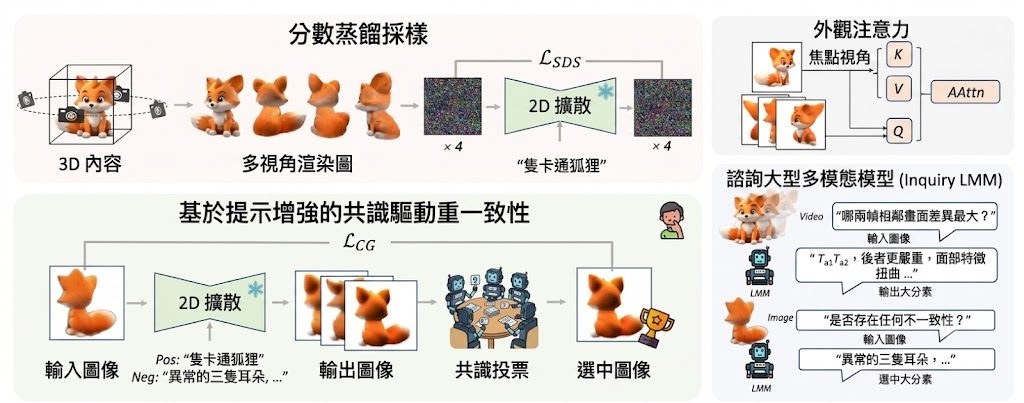
做3D同4D內容生成,最麻煩往往唔係單張畫面唔夠靚,而係鏡頭一轉、時間一推進,物件結構開始重複、錯位,角色仲會出現 jitter、identity flicker 同 structural drift。Hallo4D沿住呢個痛點出發,屬於一個研究型框架,重點唔係再訓練新模型,而係插入現有流程,幫3D與4D生成結果找出並修正時空不一致。

而家常見做法多數仍然依賴 2D diffusion-based supervision,但欠缺直接約束幾何一致性的機制,所以會出現 duplicated structures 同 misaligned geometry;去到4D,問題再擴大到時間軸。Hallo4D提出的是 generation-detection-correction 範式:先生成,再用 Large Multimodal Models(LMMs)從 multi-view、multi-frame renderings 判斷邊度出錯,之後以 image-space consistency optimization 做修正,並用 multi-model voting 揀較穩定的候選結果。

它不是跟同類方法鬥基礎生成能力,而是做一層 tuning-free、model-agnostic 的補救機制,聲稱毋須 retraining 或 architectural modification。代價亦很明顯,整個流程更依賴外部 LMM 推理、候選修正與投票判斷,較像高質後處理,而唔係最省算力的路線。

  • 重點放在 spatio-temporal hallucination mitigation,不是直接取代原有 3D / 4D 生成模型
  • 用 LMMs 檢查多視角、多幀輸出,再引導修正不一致位置
  • 針對時間穩定性加入 optical flow 驅動的 keyframe sampling
  • 以 CSEA、log-dynamic-range loss 同 union-of-frusta visibility pruning 處理曝光崩壞

目前較適合當作研究方法理解,而不是即開即用的產品工具。測試方式大致應是把它接到既有 Text-to-3D、Image-to-3D 或 4D pipeline,對比 baseline 與修正後結果,觀察多視角幾何、角色身份穩定度同曝光控制有無改善;頁面亦提供多組 visual comparisons,以及在 SV4D 的額外 4D 場景結果。

十分適合本身已經在做 3D / 4D 生成、又經常被跨視角穿崩同時序閃爍拖慢流程的研究團隊。相關脈絡亦值得一併看:Hallo3D主攻 multi-view-consistent 3D generation,Hallo4D則把範圍擴展到統一處理 3D + 4D 的時空一致性;量化表現,現有儲存庫文字未見完整指標表,判斷仍要以論文與項目頁面的可視化對比為主。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, Image, 3D, 中國, Dataset 數據集, 任何模型

MetaView 補回生成的空間感

只用一張相就想轉出大幅度新視角,最難是畫面似真之餘仲要守住空間比例。MetaView 針對的正是這個卡位。

teaser

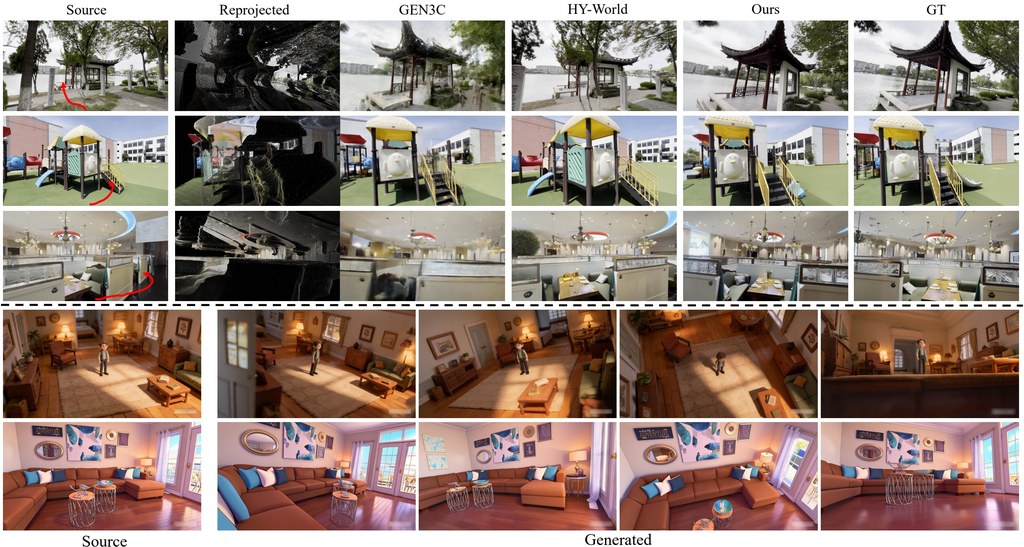
單靠一張圖片生成大角度新視角,很多方法一轉得遠就會出現結構鬆散、比例飄移,鏡頭控制亦未必準。MetaView 屬於影像生成框架,集中處理 monocular novel view synthesis,目標是在不做顯式 3D reconstruction pipeline 的前提下,仍然保住 geometry consistency 同可控的 camera pose rendering。

它的取向幾清楚:唔想被重建流程綁死泛化能力,但又唔接受純 implicit 方法常見的 scale drifting。項目把 Depth Anything 3 提供的 implicit geometry priors 接到 pretrained MM-DiT backbone,做法是加入 non-invasive parallel attention layers;同時再用 modified RoPE,配合 PRoPE 為 z-axis 留出額外子空間,把場景尺度固定在較一致的 3D metric space。

對研究團隊、做 novel view synthesis、3D-aware image generation,或者需要從單張圖控制鏡頭輸出的工作流,這個項目值得留意。現有資訊較像研究原型:README 與 project homepage 已提供 paper、demo 與 model 入口,但未見完整安裝與部署細節,所以現階段較合理的理解方式,是先用 demo 看大視角轉換與 spherical poses control 的效果,再等待公開模型與程式流程補齊。

  • 單張圖片輸入,主打大幅度 viewpoint changes 下仍保持高保真輸出
  • 不走 explicit 3D reconstruction pipelines,換取更高彈性與泛化空間
  • 用 Depth Anything 3 幾何先驗補結構,再用 modified RoPE 處理 scale anchoring
  • 比較對象包括 ViewCrafter、Gen3C、Voyager、PE-Field、HY-World、Lingbot-World

MetaView 在具挑戰性的 monocular large viewpoint changes 測試中,表現優於多個 reconstruction-based 與 implicit 方法,強調的是 geometry consistency、precise controllability 與 generalization。現階段較適合把它視為一個方向鮮明的研究項目:它不是單純追求更靚畫面,而是嘗試把單圖生成長期欠缺的空間尺度感補回來。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, Image, 影像模型, 香港, 3D

AMID 把醫學影像建模流程交畀代理協作

AMID唔係只幫你諗模型,而係想連驗證、提交物料同審計痕跡一併產出。你可以把它理解成面向醫學影像比賽與研究任務的自動化建模工作流。

AMID logo

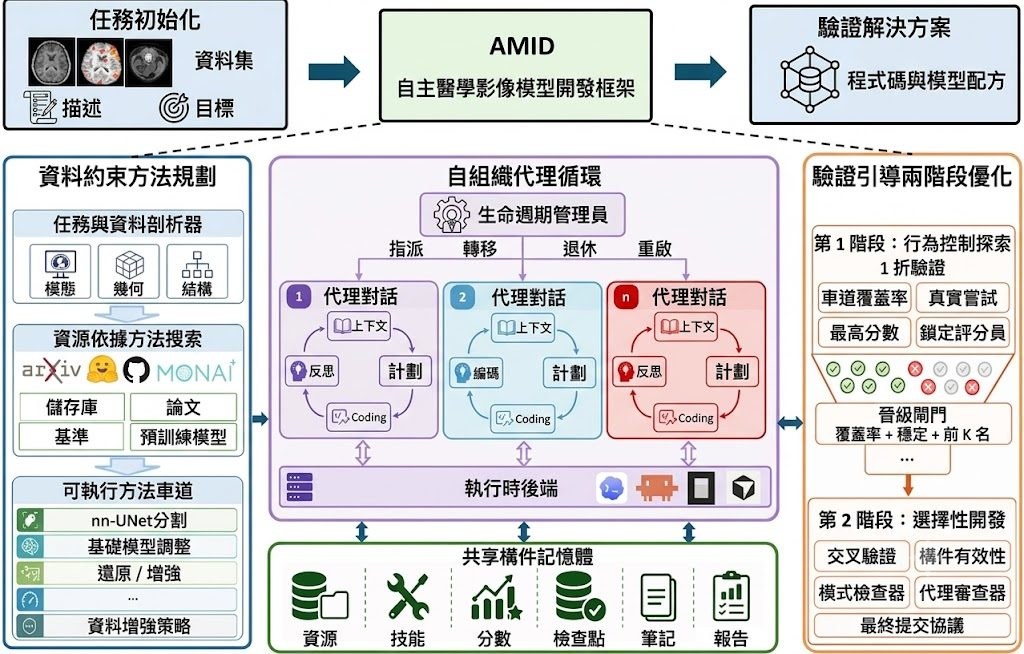
醫學影像建模最麻煩的位,往往唔係只係揀網絡,而係每個任務都有唔同資料形態、指標、切分規則同提交要求。AMID把呢個痛點拉到枱面:它屬於一個 autonomous multi-agent framework,目標唔係產生一段建議文字,而係交出可訓練、可推理、可驗證、可提交的完整模型產物。

現有通用 MLE agent 往往沿用比較粗略的搜尋與試錯範式,先提方案、再寫碼、再靠結果反覆修補;作者認為放到醫學影像場景,呢種做法容易忽略資料條件、驗證協議同提交格式。AMID改用 Data-Conditioned Method Planning,先按任務資料與可運行資源整理出可執行的 method lanes,再用 Verification-Guided Two-Stage Optimization 由早期廣泛探索,轉去後期集中追蹤有潛力路線,同時持續檢查 metric computation、validation protocol 同 prediction artifacts。

呢種取向的差異,在於它把「做得出分數」同「流程可核對」放埋一齊處理。對醫療 AI 團隊、挑戰賽參賽者,或者要同時管理 2D 影像、3D volumes、segmentation masks、class labels 等異質資料的人,AMID的吸引力在於減少人手串接流程的時間;代價是它目前仍以技術報告與任務解法報告為主,README亦寫明 source code 尚未釋出,暫時未到可以直接部署測試的階段。

效能方面,AMID用 ReX-MLE 的 20 個 medical imaging challenge tasks 做基準,比較對象包括一般用途 MLE systems,同時拿 human-designed challenge solutions 作參照。作者指出它整體表現優於被評測的通用系統,部分任務接近或追平人手設計方案;現階段較適合把它理解成一套清晰的方法論與工作流藍圖,而唔係即裝即跑的開源工具。

  • 核心定位係 autonomous multi-agent framework,處理醫學影像模型開發與驗證交付
  • 主要方法包括 Data-Conditioned Method Planning 同 Verification-Guided Two-Stage Optimization
  • 輸出唔止模型建議,仲包括 training code、inference code、weights、prediction files 同 audit trail
  • 基準測試來自 ReX-MLE 的 20 個任務,整體表現優於通用 MLE systems
  • 目前已公開 technical report 同 20 份 solution reports,source code 尚未發布

相關模型與系統脈絡方面,AMID直接對比的是 general-purpose MLE systems,同時以 human-designed challenge solutions 作為高水位參考。它未有把重點放在單一 backbone 或某個固定醫學影像模型,而是把多代理規劃、優化與驗證流程包成可重複的方法,呢點比單次調參工具更值得留意。

GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 多模態模型, 模型訓練, 微軟, Image, 影像處理, 框架, 香港, Medical醫學, 3D, Dataset 數據集

ABot-N1 點樣令導航模型更穩更易懂

ABot-N1瞄準機械人導航最難搞的斷層:一邊要理解場景與指令,一邊又要即時控制移動。它把思考與動作拆開處理,令跨場景導航更穩定,也較容易追蹤模型點樣作決定。

AMAP CV Lab

做室內外導航時,最麻煩往往不是單純避障,而是模型要同時理解語言、辨認目標,再即時走出合理路線。ABot-N1屬於 VLA(Vision-Language-Action)navigation model,焦點放在處理黑盒式策略常見的座標漂移、長尾語意理解不足,以及決策過程難以解釋的問題。

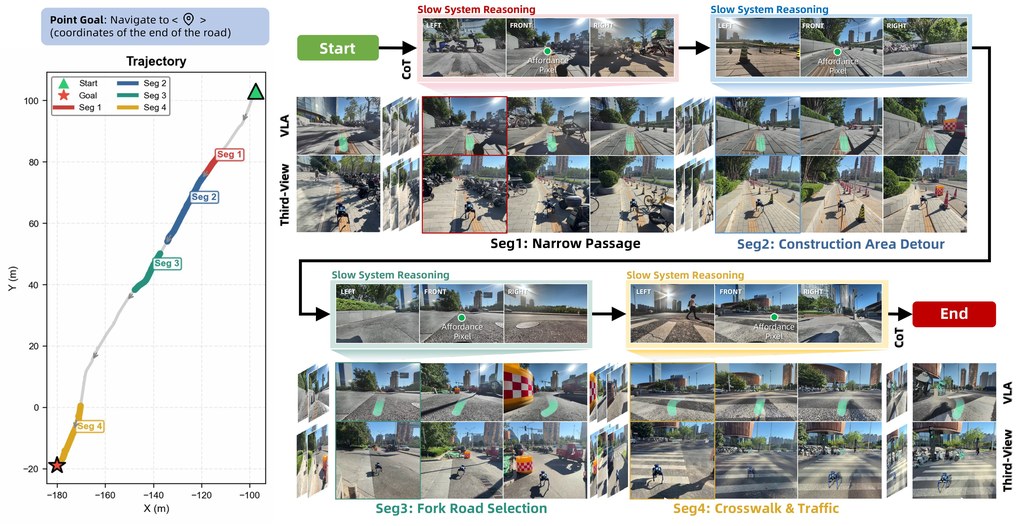
它的做法不是把所有事塞進同一個控制器,而是用 slow-fast 架構把認知與控制分開。較慢的 vision-language reasoner 會讀取歷史畫面與任務提示,產生明確的 Chain-of-Thought reasoning,並輸出 pixel goals 作為通用的影像空間錨點;較快的 action expert 再結合文字線索與 pixel guidance,持續生成 waypoint,將高層意圖接到低層移動控制。

這種設計的好處,在於同一套框架可以覆蓋多種導航任務,而不只是單一路徑跟隨。現有資料提到它支援 point-goal、POI-goal、object-goal、instruction-following 同 person-following,當中 POI-goal 需要由戶外走到實際入口,特別能反映語意理解與跨場景移動是否連得上。

  • 把 cognition 與 control 非同步拆分,減少黑盒式端到端策略的不透明問題
  • 用 dual visual-language signals 連接推理與動作,核心輸出包括 Target Pixel 與 Affordance Pixel
  • 涵蓋 point-goal、POI-goal、object-goal、instruction-following、person-following 等任務
  • 成績上錄得新 state-of-the-art,POI arrival 提升 35.0% 至 77.3%
  • 複雜室內與室外場景分別達到 95.4% 與 92.9% SR,亦同步開源新 benchmark

整體來看,ABot-N1最值得留意的不是單一指標,而是它試圖把「看得懂、講得清、走得穩」放進同一個導航模型。對做 embodied AI、robotics 或通用導航工作流的人來說,這個項目提供了一條比純黑盒控制更可分析、也更容易擴展到不同任務的路線。

項目主頁

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 多模態模型, 模型訓練, Image, VLA, Robotic, 3D, Dataset 數據集

PanoWorld 把 360 影片生成拉回真實場景

想做會記得路徑同方位的全景生成,PanoWorld比一般短片模型更有方向感。它瞄準長距離一致性,重點不只係畫面靚,仲要前後場景講得通。

PanoWorld logo

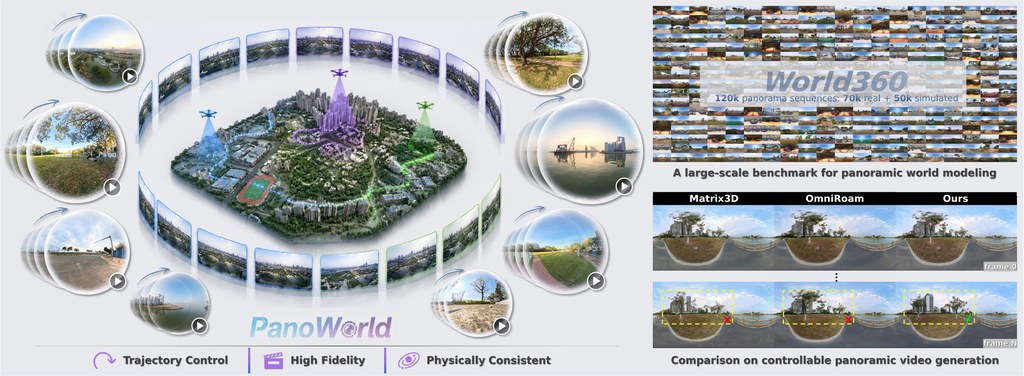
做 360° 影片生成,最易穿崩的往往不是單幀畫質,而是鏡頭轉了一大圈之後,場景記憶是否仍然連貫。PanoWorld屬於世界模型兼影片生成模型,針對全景 world model 的 long-range memory 問題,目標是生成更符合空間幾何與物理一致性的 panoramic video。

這個項目的取向幾明確:不是單純追求更短時間出片,而是利用 omnidirectional representations 的 rotation-equivariant 特性,將旋轉視為隱含幾何變換,再把相機軌跡簡化成固定朝向下的平移。核心做法包括 Dense Panoramic Ray-Conditioning (DPRC)Geometry-aware Memory Augmentation (GMA),並建基於 Wan2.2 backbone 的 triple-stream DiT,處理當前動作建模與長程記憶。

現階段公開資訊較適合做推理測試與結果驗證,訓練代碼仍未釋出。環境要求也不算輕:Linux(已測 Ubuntu 22.04)、CUDA 12.8 以上、Python 3.10,並需要至少 20GB VRAM 的 CUDA GPU;README 亦提供 demo assets,可先用來跑 inference,觀察 81-frame 與 161-frame panoramic video 的生成表現。

  • 重點放在 long-range memory,而非只提升單段片段觀感
  • 可生成 81-frame、161-frame 的 panoramic video
  • 評測依託 World360,涵蓋真實全景無人機片段與 AirSim360 模擬資料
  • 官方表示在 World360 上明顯勝過其他方法,但目前公開細節以展示頁與推理資源為主

受益最明顯的,會是做 360 內容生成、沉浸式視覺、無人機視角模擬,或研究世界模型長時序一致性的團隊。它未必是最容易部署的項目,但定位很清楚:當一般 video model 在大範圍空間變化與光照變化下容易失憶,PanoWorld正面處理這個痛點,並且連同 World360 一起把評測場景拉近真實世界。

項目主頁 · GitHub

Categories: 開源, 清華大學, 視頻模型, 世界模型, NVIDIA, Video, 影像處理, 3D, Linux, Python, Dataset 數據集

GenCeption 單一模型多種視覺任務

同一個模型就想處理深度、分割、姿態同關鍵點。GenCeption 把影片生成預訓練轉成通用視覺能力,方向相當清晰。

Og image

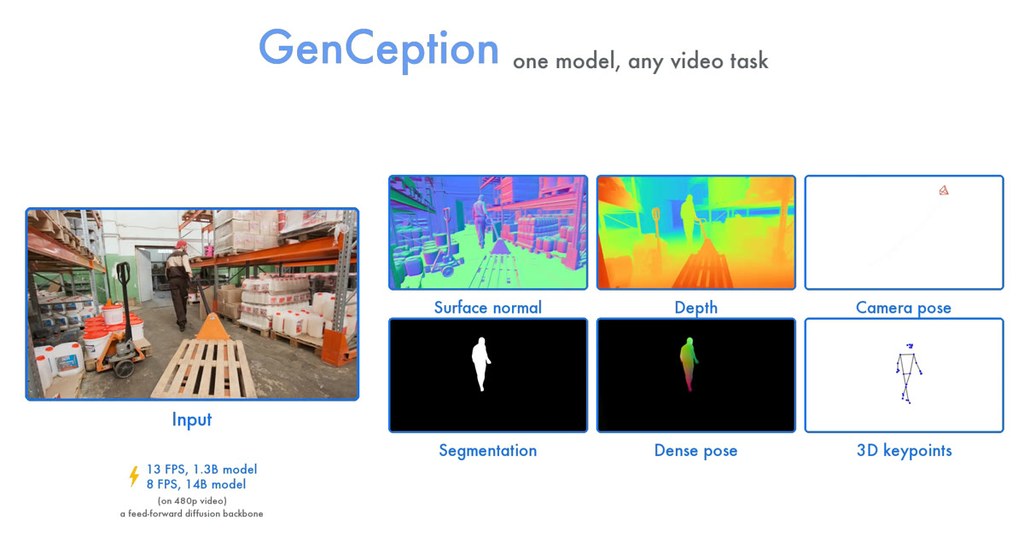
做影像理解時,很多人最頭痛的不是單一任務做唔到,而是每做一種任務就要換一套模型。GenCeption 屬於通用視覺模型,目標是把深度估計、法線、相機姿態、分割、2D/3D 關鍵點甚至 4D grounding 放入同一個流程,並且用文字指令控制輸出。

它處理的核心問題,是電腦視覺長期依賴任務專用模型,工作流容易分散、訓練與部署成本亦高。GenCeption 的做法,是先用 video generative diffusion model 做預訓練,吸收空間與時間上的 world priors,以及原生的 vision-language alignment,再經過 multi-task post-training,把原本偏生成式、多步驟的骨幹,改造成單步 feed-forward 推理模型。

這種路線跟常見做法最大分別,在於它不是為每個任務各自砌一個模型,而是用單一、task-agnostic architecture 應付 dense 與 sparse vision tasks。資料上亦以 synthetic data 為主,重點放在學習效率、sim-to-real transfer,以及遇到 out-of-distribution 物件類別時的泛化能力。

  • 支援多種視覺任務,包含 depth、surface normal、camera pose、segmentation、2D/3D keypoint prediction
  • 透過文字指令切換任務,保持同一模型介面
  • 把影片生成預訓練轉成 feed-forward 視覺推理,而不是停留在多步生成流程
  • 官方描述指它在多個任務上可與專用 SOTA 模型競爭,對比對象包括 DepthAnything3、D4RT、VGGT-Ω、SAM3、Sapiens、DAVID

對研究多模態模型、通用機械視覺,或者想整合複數感知任務的人來說,GenCeption 值得留意。現時公開內容仍以研究展示為主,Code 亦標示為 TBA,所以較適合先理解方法方向與能力邊界,再觀察後續開源與可重現程度。

項目主頁

Categories: 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Google, Video, 影像處理, 3D

ARDY 讓 3D 角色動作可即時受控

想像你一邊改文字指令,一邊即時見到角色順住路徑、姿勢同目標動起來。ARDY把可控性同即時回應拉到同一個工作流入面。

Og image

一邊輸入文字、一邊指定角色要去邊、幾時抬手或者身體要擺成咩姿勢,系統仍然可以即時生成自然動作;ARDY瞄準的正正是呢種互動式 3D human motion generation 場景。呢類能力對動畫、模擬同 humanoid robotics 都重要,因為傳統離線方法雖然控制精準,但速度未必跟得上互動需求;純即時方法又常常在語意理解、長距離目標同約束服從度上打折扣。

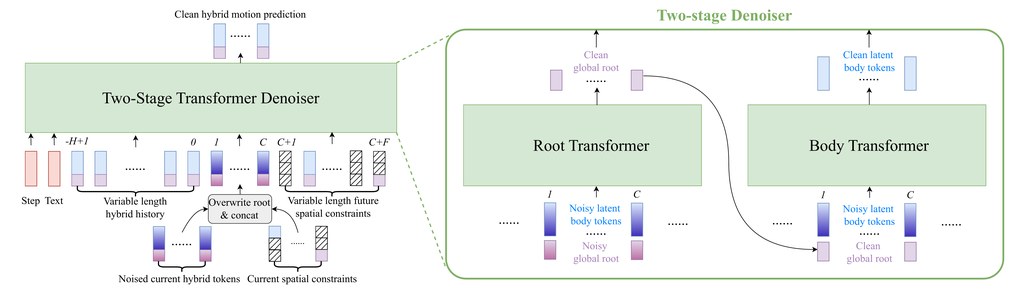
ARDY 採用 autoregressive diffusion model,同時配合 hybrid representation,把角色移動軌跡相關的 root features 同 latent body embedding 結合。咁樣做的用意很直接:一方面保留對路徑與朝向的明確控制,另一方面維持生成模型學習複雜全身動作時的效率與彈性。配合 two-stage autoregressive transformer denoiser,同一套框架可以處理 online text prompting,亦能接住較長時間範圍的 kinematic constraints。

它支援的約束方式幾完整,包括 root paths、waypoints、full-body keyframes,以及 sparse joint positions/rotations,亦可混合使用。更重要的是,約束唔一定只限當前生成視窗,較遠將來的目標都可以先講定,令角色更容易朝長程目標連續行動,而唔係每幾步就失去方向。

  • 支援 online text-to-motion generation,可即時改提示詞
  • 可加入 root paths、waypoints、full-body keyframes 同 sparse joint constraints
  • 兼顧即時反應、動作品質同長距離控制
  • 面向動畫、模擬、humanoid robotics 等互動工作流

資料提到,ARDY 以大型 motion capture dataset 訓練,並直接用文字標籤與來自真實姿勢抽樣的 kinematic constraints 作條件,令模型原生學會受控生成。研究團隊亦展示了互動式 demo,涵蓋動態文字控制、關鍵幀約束、路徑跟隨同即時 locomotion control;定位上,它較適合需要邊調邊看結果的內容製作與研究場景。

項目主頁 · 模型

Categories: Embedding, 世界模型, 模型訓練, NVIDIA, Video, VLA, 提示詞, Robotic, 框架, 軟件, 3D, 動畫, Dataset 數據集

Page 5 of 10
1 3 4 5 6 7 10