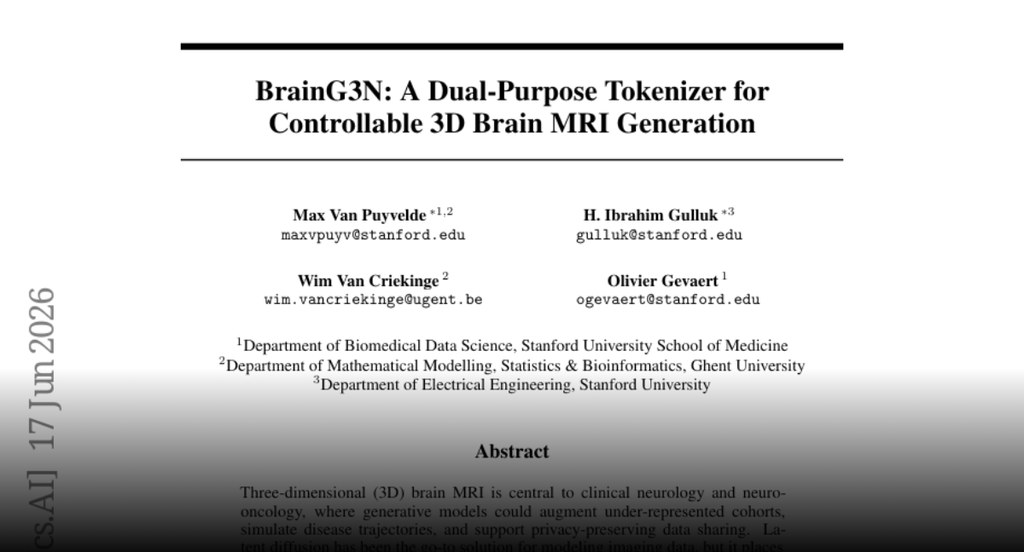
可控制生成 3D 腦 MRI 的 BrainG3N

BrainG3N把3D腦MRI生成放進具臨床意義的潛在空間,兼顧可控生成與表徵能力。

Og image

BrainG3N是一個面向3D腦部 MRI 的生成模型,重點不只是「生成影像」,而是按指定條件產生帶有臨床訊息的合成掃描。它先用凍結的 3D MAE encoder 處理資料,再由 conditional flow-matching DiT 在潛在空間生成新樣本,最後用 fine-tuned CNN decoder 轉回 voxel 影像。

這類方法要解決的,是醫學影像生成常見的「生成到,但控制不準」問題。BrainG3N聲稱可按 disease、age、sex、modality、site、IDH1 status 等條件控制輸出,亦支援病人縱向變化預測,對研究病程模擬與稀有群組補數據尤其有用。

和一般直接在像素或 voxel 空間生成的做法相比,它把生成放在 clinically grounded latent space 內進行,目標是令合成結果更容易保留指定屬性。頁面列出的結果顯示,從生成掃描中可重新探測出目標條件,例如年齡相關性達 Pearson r=0.93,反映控制訊號並非只停留在文字或標籤層面。

同一個 frozen encoder 本身亦被當作 foundation model 使用,在 21/23 個 linear-probing tasks 上達到或超過 BrainIAC、BrainSegFounder、MedicalNet;其中 IDH1 AUC 0.937、brain-age MAE 4.43 years,而且無需 fine-tuning。對醫學 AI 研究者來說,這代表同一套架構可同時支援表徵學習與合成數據生成。

  • 可控制條件包括 disease、age、sex、modality、site、IDH1 status
  • 支援 patient-specific longitudinal forecasting
  • 生成流程包含 3D MAE encoder、conditional flow-matching DiT、CNN decoder
  • 可用於 under-represented cohorts 補充、counterfactual disease trajectories、privacy-preserving synthetic data sharing

目前頁面只提供論文簡介,model、code 與 synthetic dataset 尚未釋出,所以現階段較適合先了解方法設計與指標表現。若你關注 Medical醫學影像、合成數據或可控生成,這個項目很值得留意。
項目主頁: https://huggingface.co/papers/2606.19651

Paper: https://arxiv.org/pdf/2606.19651

Categories: 模型, 模型訓練, Image, Medical醫學, 3D, Dataset 數據集

SR-REAL 把空間推理拆成兩條路

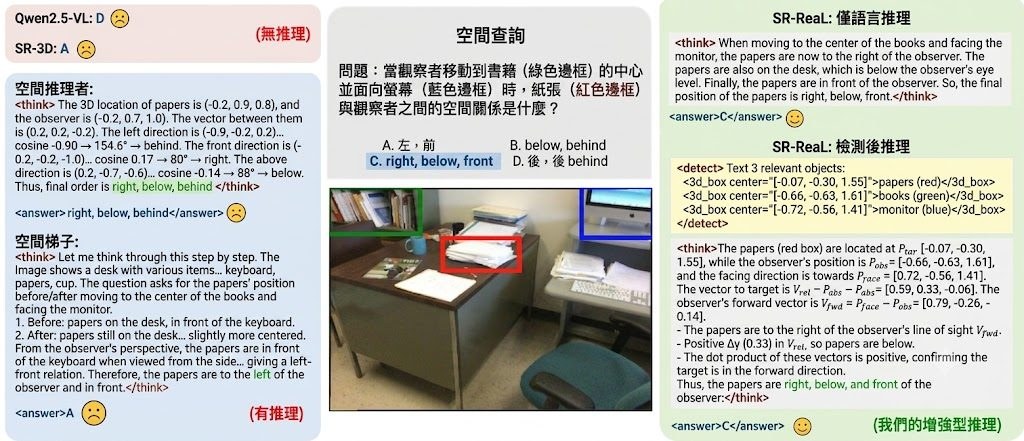
SR-REAL 不是只靠文字推理,也加入 3D 定位再判斷。它想解決空間 VLM 遇到距離、方位、多步推理時常出錯的問題。

Repository image for jiyt17/SR-REAL

現有 spatial VLM 往往用單一路線回答空間問題,不是純文字 chain-of-thought,就是直接靠感知結果輸出答案;作者認為這種固定範式難以同時處理語意推理與精確幾何判斷。SR-REAL 提出的做法,是把空間推理分成 Language-Only Reasoning(LOR)與 Detect-Then-Reason(DTR)兩條互補路徑,前者逐步文字推理,後者先找 3D 幾何線索,再做明確幾何推斷。

這個項目屬於框架加訓練流程實作,核心是強化 spatial vision-language models 在複雜空間問答中的判斷能力。它不是單純新增資料集,而是從 cold-start supervised fine-tuning 到 reinforcement learning(RL)都重新安排,並加入 region-to-3D 介面,令模型可把 region tokens 連到 3D 座標、中心點或 bounding boxes。

SR-REAL 重點集中在資料準備與訓練前處理。流程上會先用 SPAR、EmbodiedScan 等來源整理物件對應與 3D 座標,再由 expert.py 生成推理鏈,配合 qwen3.py 抽取物件名稱,最後組成 DTR 指令微調資料;若不想自行重建,也可直接下載作者已整理好的 Hugging Face 數據。這表示它較適合有 Python、資料處理及多模態訓練基礎的研究團隊,而不是即裝即用的終端工具。

和同類做法相比,SR-REAL 不假設所有空間問題都應該用同一種 reasoning path。作者的取向很清楚:語意關係適合 LOR,涉及明確位置、距離、中心點、框選區域的題目則交給 DTR;代價是整個資料構建與訓練流程更複雜,對 grounding 資料品質亦更敏感。

  • 重點不在單一模型結構,而在 LOR + DTR 雙路徑推理設計
  • DTR 會先處理 region tokens 與 3D 幾何線索,再做空間判斷
  • 訓練分為 cold-start supervised fine-tuning 與 reinforcement learning(RL)兩段
  • 已提及 accuracy、format、detection rewards,顯示評測不只看答對與否,也看輸出格式及幾何對齊
  • 相關模型與資料來源包括 spatial VLM、SR-3D、Qwen3、SPAR、EmbodiedScan、SpatialRGPT、Omni3D、CA1M、OmniNOCS

SR-REAL 在多個 spatial benchmarks 有明顯提升,並強調單一 RL-trained model 可同時支援兩條路徑,且不用 per-task tuning 也能跨資料集泛化。不過儲存庫片段未完整列出詳細分數與對照表,因此較穩妥的判斷是:這是一個研究味很重、方法論清晰的項目,適合關注 spatial reasoning、3D grounding、multimodal instruction tuning 的團隊拿來重現與延伸。

GitHub: https://github.com/jiyt17/SR-REAL

項目主頁: https://sr-real.github.io/

Categories: 香港大學, Agentic, 模型, 多模態模型, 模型訓練, Qwen, Google, NVIDIA, OpenAI, DeepSeek, 框架, 香港, 工具, 3D, Python NLP, Python, , 編程

MolmoMotion 把語言變成 3D 動作預測

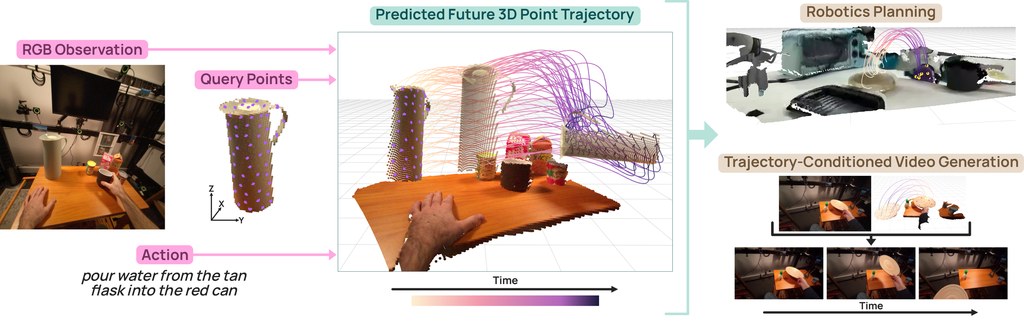
這是一個會按文字指令預測物件未來移動路徑的 4B 視覺語言模型,也連同資料集與基準一併公開。

MolmoMotion teaser

現有做法多數偏向追蹤已經發生的移動,或者只在 2D 畫面估計下一步位置;作者認為這種 retrospective 範式難以支援機械人規劃與可控影片生成,所以提出 MolmoMotion、MolmoMotion-1M 同 PointMotionBench,把問題改成「根據語言指令預測 3D 點位未來軌跡」。這不是單純看影片理解內容,而是要模型根據短段 RGB 歷史、2D query points、初始 3D 位置,以及文字動作描述,預測之後約 2 秒的 3D movement。

MolmoMotion 本身屬於模型,更準確地說是 4B vision-language model,處理的是物件上指定點會怎樣移動的預測問題。儲存庫目前公開的是 autoregressive (AR) variant,並提供訓練資料、評測集、已釋出模型,以及由 pretrain 到 long-horizon finetune 的兩階段流程,較適合研究團隊直接重現結果或改成自家任務。

和同類方法相比,這個項目的取向很鮮明:它不是先做一般影片理解,再另外接 motion head,而是把 language-guided 3D point trajectory forecasting 當成核心任務。代價是輸入要求較多,你要有 query points 同初始 3D 資訊;回報則是輸出更貼近規劃用途,特別適合要預測「物件將會點樣郁」而不是只想分類場景的人。

  • 可預測最長約 2 秒未來軌跡,文件提到 15 fps、F=30 或 F=32 的設定
  • 評測指標列出 ADE、FDE、PWT,焦點放在軌跡準確度而非只看畫面相似度
  • 配套包含 MolmoMotion-1M 訓練資料集與 PointMotionBench 評測基準
  • 作者指出學到的 motion prior 可轉移到 robotics planning 與 motion-guided video generation

部署與測試的理解方式相當直接:先下載模型、資料集或 benchmark,再按儲存庫提供的 evaluation 與 training 流程執行;若不打算重訓,較合理是先拿已釋出模型跑 PointMotionBench 或自家樣本,看看語言指令改變時,3D 點位預測是否穩定。現有資訊未見完整效能數字摘錄,但官方明確聲稱表現明顯優於既有 forecasting 方法;較保守的判斷是,它最適合 embodied AI、robotics、可控影片生成研究者,以及需要把語言意圖轉成未來運動假設的團隊。

相關模型與資源包括:MolmoMotion、其 autoregressive (AR) variant、MolmoMotion-1M、PointMotionBench;底層 backbone 初始化與從零訓練入口亦有提供。

GitHub: https://github.com/allenai/molmo-motion

項目主頁: https://allenai.org/blog/molmo-motion

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Video, Robotic, IDE, 3D, , Dataset 數據集

LooseControlVideo 用 3D 方框指揮 AI 影片動作

LooseControlVideo用稀疏3D方框控制影片生成。比起密集深度或光流條件,更易畫亦更易改。

Hero image preview

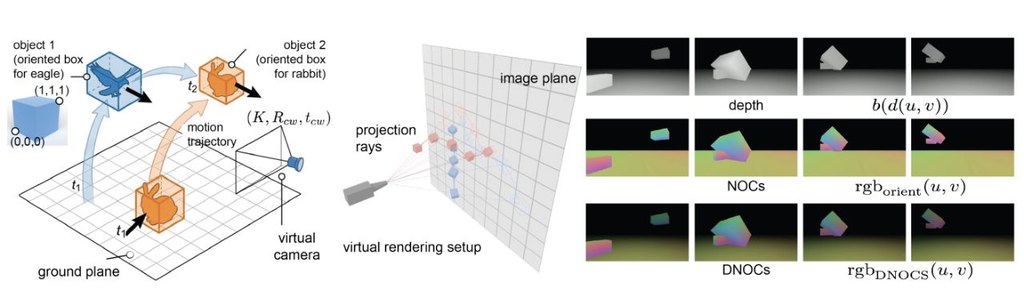
LooseControlVideo(LCV)是一個針對影片生成與編輯的框架,核心做法是用稀疏、帶方向的 3D boxes 來安排物件移動、旋轉、遮擋關係,以及鏡頭運動。它想解決的,是多物件場景中「位置安排」與「時間變化」經常纏在一起,令文字轉影片很難精準控制。

常見控制方法多數依賴 dense depth maps、optical flow 或 3D point tracks,雖然細緻,但要逐格準備條件,製作成本高。LCV 改用人手較易繪製的 3D boxes,讓使用者先定出高層次 blocking,再交由生成模型補足自然的動態、互動與遮擋,控制感和自由度之間取得較好平衡。

技術上,項目以 Wan 2.2 backbone 為基礎微調,並配合 DNOCS 這種編碼方式,表示 3D 尺寸、方向及按深度排序的遮擋資訊。頁面亦提到它支援局部修訂,例如只調整跳躍軌跡,或加入新的互動,而不必大幅破壞整體場景。

重點可先看這幾項:
– 可控制軌跡、旋轉、遮擋、鏡頭運動與局部編輯
– 輸入形式是稀疏 oriented 3D boxes,較易手動建立
– 適合多物件場景與需要導演式安排動作的影片生成
– 在 nuScenes、HO-3D、BEHAVE 上,優於 2D-box 與 flow-based baselines
– 指標上約有 1.2 至 3 倍 Trajectory Error 改善、2 倍 Rigid Motion Consistency 改善,以及 1.5 至 2 倍 Occlusion Accuracy 提升

這類方法特別適合想精準安排角色走位、物件互動,或需要補拍式修改片段的人。現有資料主要展示項目頁與結果示例,若讀者想接觸這個項目,較可行的做法是先觀察它如何用少量 3D boxes 改動單一動作,再比較與傳統 layout-conditioned models 在遮擋與旋轉控制上的差別。

項目: https://shariqfarooq123.github.io/LooseControlVideo/

Categories: 模型, 視覺模型, 視頻模型, Video, 影像處理, 框架, 3D

S-Agent 把視覺推理帶入 3D 場景記憶

S-Agent不是只看單張圖下判斷,而是把多視角與影片線索慢慢累積。它主打空間推理,方向比一般 Vision-Language Model 更進取。

Watch the S-Agent demo video on YouTube

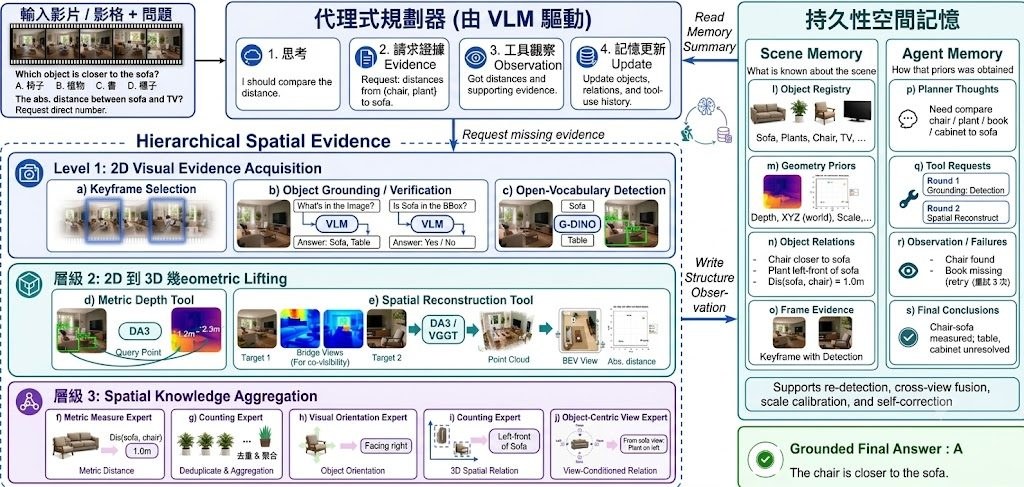
現時不少 Vision-Language Model 都偏向用單張圖片、單步回答去做空間判斷;就算加入 agent,也常見為 stateless inference,缺少持續記錄場景變化的能力。S-Agent 提出的做法,是把空間推理改寫成 spatio-temporal evidence accumulation:不是即時猜答案,而是逐步收集 2D、3D 和時間序列證據。

這是一個偏向 Agentic 視覺推理框架 的研究項目,目標是解決多視角圖片與影片中的 3D 空間理解問題。它把 Vision-Language Model 當成 semantic planner,再配合 hierarchical spatial tools、Scene Memory 與 Agent Memory,處理 counting、measurement、orientation、relative position 這類單幀方法較易出錯的任務。

同類做法多數停留在 frame-level prediction,S-Agent 的取向明顯不同:先 grounding 物件,再做 2D-to-3D lifting,之後把幾何線索整合成可推理的 scene-centric understanding。這種設計的代價,是系統比單次問答複雜,亦更依賴工具鏈、記憶狀態與多步推理流程,不算是輕量型項目。

S-Agent: Spatial tool-use elicits reasoning for spatial intelligence.sagent demo video

目前 GitHub 提供的是論文與示範資訊,code、data、checkpoint 仍標示 coming soon,所以現階段較適合當成研究方向來理解,而不是即裝即跑的工具。若要測試它的價值,較合理的方法是留意之後公開的 inference / evaluation code,並對照 MMSI-Bench 一類 multi-view 與 video spatial reasoning benchmark 的表現。

  • 核心主張是用 spatio-temporal evidence accumulation 取代 isolated frame-level prediction
  • 系統結構包含 VLM semantic planner、hierarchy of spatial tools、Scene Memory、Agent Memory
  • 論文指在 zero-shot 設定下可提升 Gemini-3-Pro,SFT 後的 S-Agent-8B 亦能接近高階 closed-source models
  • 適合研究 spatial intelligence、multi-view reasoning、video understanding 的團隊留意

相關模型方面,文中明確提到 Gemini-3-Pro、Qwen-VL-8B,以及蒸餾後的 S-Agent-8B。若你關心 Computer-use agents、CUAs 以外,AI 如何真正理解連續 3D 世界,這個項目比一般圖片問答更有研究價值。

GitHub: https://github.com/Ropedia/S-Agent

項目:https://ropedia.github.io/S-Agent/

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 多模態模型, Qwen, Gemini, 框架, 工具, 3D

JanusMesh 把雙提示變成 3D 視覺

JanusMesh 用兩句文字生成同一個3D物件,從不同角度看出不同意思。它主打免訓練、速度快,亦針對舊方法的接縫與語意外漏問題。

Teaser

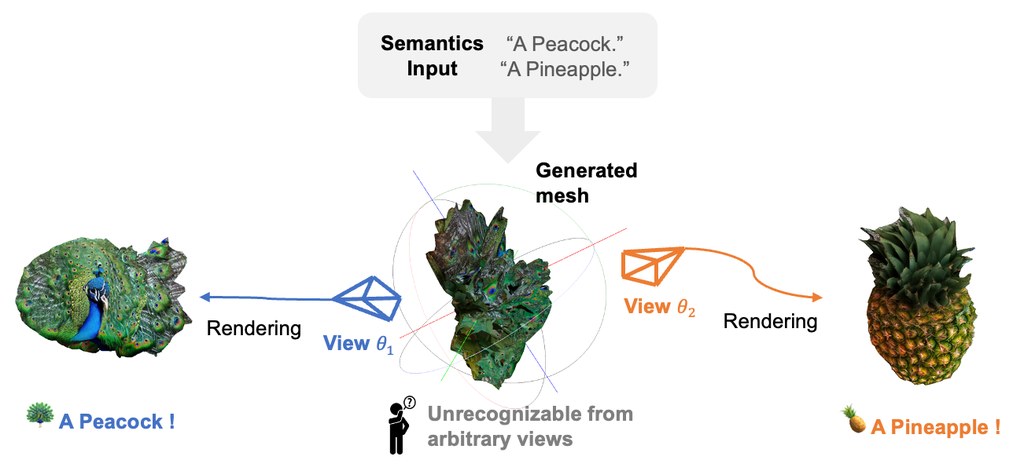
現有 3D visual illusions 做法,多數不是走 optimization-based methods,就是把兩個形體直接拼接。前者慢,還容易出現過飽和顏色;後者雖然直接,但會留下明顯幾何接縫,亦會有 semantic leakage。JanusMesh 提出的不是新訓練模型,而是一條 training-free pipeline,目標是把兩個文字提示融合成一個 3D mesh,並在指定視角各自呈現不同語意。

它的核心分成兩步:先用 cross-space dual-branch denoising,在 voxel 與 Signed Distance Field (SDF) 之間處理形體融合,再配合 CLIP 做 orientation alignment;之後再用 view-conditioned 2D diffusion 補貼圖與外觀。這種拆法的重點,不是單純把兩個物件疊上去,而是先解決幾何是否連貫,再處理不同視角看到的表面語意。

部署上,現有資訊顯示它較適合有 CUDA 環境的研究或圖像團隊,因為要安裝多個 CUDA extensions,例如 flash-attn、nvdiffrast、diff-gaussian-rasterization、pytorch3d。測試思路相當清晰:可先用 case 1 或 case 2 直接生成固定 voxel split 結果,再用 case 3 加入 CLIP pose search,比較視角對齊是否更穩定;另外也可調整 noise guidance、space control、t0 idx value 與 guided structure weight,觀察語意強度與形體穩定度之間的取捨。

JanusMesh 的表現頗有競爭力:生成時間約 3–5 分鐘,主打 geometric integrity、semantic recognizability、efficiency 都比同類方法好。不過它目前更像研究型工具,適合做 3D 內容展示、視覺實驗、生成式藝術或學術比較;若想要任意角度都自然,文中亦明言這類物件在非目標視角本來就可能難以辨認,這其實是 3D 視覺錯覺成立的一部分。

  • 項目類型:一個 training-free 的 3D 生成流程,解決雙語意 3D visual illusions 的幾何接縫、語意外漏與生成速度問題。
  • 最值得留意的差異:不是 per-shape optimization,也不是 direct concatenation,而是先做 cross-space 幾何融合,再做 view-conditioned 外觀細化。
  • 較適合的情境:3D 生成研究、視覺傳達、展覽內容、概念設計,以及想比較多種 3D illusion 範式的團隊。
  • 性能重點:論文聲稱 3–5 分鐘可完成,較傳統 SDS-Based Methods 快,亦減少 oversaturation 與 seams。
  • 相關模型/組件:CLIP、2D diffusion、voxel、Signed Distance Field (SDF)、flash-attn、nvdiffrast、diff-gaussian-rasterization、pytorch3d。

GitHub: https://github.com/siang1105/JanusMesh

項目: https://siang1105.github.io/JanusMesh.github.io/

Categories: 開源, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 工具, IDE, 3D, Python

AdaVoMP 讓 3D 場景有可互動物理材質

AdaVoMP 會為 3D 物件補上物理材質資料,令模擬更真實,亦更高解像與省記憶體。

Og image

不少 3D 資產只有外形,欠缺 Young’s modulus(E)、Poisson’s ratio(ν)同 density(ρ)等物理資料,結果做模擬時只係「睇落似」,但受力、變形同碰撞未必可信。AdaVoMP 就係針對呢個缺口,為輸入 3D 物件預測高密度、空間可變的物理屬性場,令數碼世界更接近可互動、可模擬的狀態。

同前一代 VoMP v1 比,AdaVoMP 的重點唔止係更清晰,而係改用 sparse and adaptive voxel structure(SAV)同 sparse transformer encoder-decoder,將固定體素表示換成可自適應結構。頁面指出,它可生成高出 16^3 倍解析度的屬性場,亦支援 test-time 調整解析度,兼顧準確度、記憶體效率同細節保留。

AdaVoMP short video [ICML 26]

AdaVoMP 展示咗幾種直接可理解的用途,例如將 Gaussian Splat + mesh 場景轉成可互動世界、為純 mesh 或 gaussian splats 場景做較真實的物理模擬,以及配合 RoboLab 與 Isaac Sim 建立機械人測試環境。對做 robotics、simulation、數碼孿生,或者想將 NeRF、Gaussian Splat 資產變成可操作場景的人,呢類流程會特別有參考價值。

  • 補回 3D 資產常見缺失的物理材質資訊
  • 比 VoMP v1 提供更高解析度與可縮放輸出
  • 同時支援 mesh、Gaussian Splat 等不同表示
  • 可用於 Isaac Sim 機械人基準測試與互動場景建立

從頁面資料看,AdaVoMP 亦有同 NeRF2Physics、PUGS、Phys4DGen、Pixie、VoMP 及 Ground Truth 作視覺比較,重點放在 physics material fields 的品質。若要自行測試,查看 Code 同 Model/Data,再留意它在自己場景表示、模擬器同資產格式上的接入成本。

項目: https://research.nvidia.com/labs/sil/projects/adavomp/

Categories: 開源, 模型, NVIDIA, Robotic, 3D

iMaC:把機械臂動作變成可預測影像

iMaC 不是只餵動作向量入模型,而是把未來動作轉成影像控制。這種 world model 更貼近機械臂與場景的空間互動。

overview

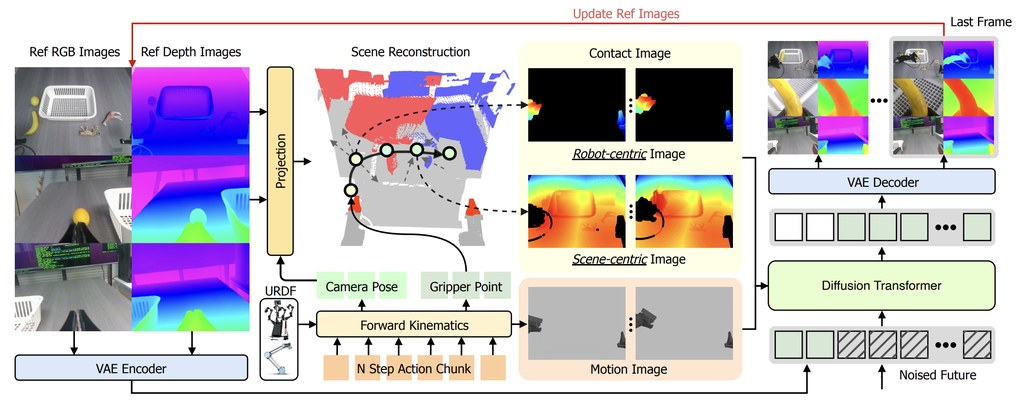
現時不少 action-conditioned video models 會把未來動作壓成 compact vectors,再經 learned conditioning modules 交給模型處理;作者認為這種做法要模型自行猜測細微空間後果,遇到 real manipulation 時,幾厘米差距已足以改變接觸、物件移動與任務成敗。iMaC 屬於世界模型與影片生成模型,核心是把 future joint actions 轉成 image-like controls,減少「動作有輸入,但空間關係表達不足」的問題。

這個項目的方法相當具體:先利用 robot URDF 與 forward kinematics,渲染 future robot-observation control videos,也就是 motion images;之後再加入 depth 作為輔助訊號,配合 3D pointclouds 建立 two-stream geometry controls,也就是 contact images。舊範式主要靠抽象向量條件化,iMaC 則把「未來機械臂會出現在哪裡、如何接近場景」直接變成可見控制,這是它最清晰的技術分野。

GitHub 儲存庫提供 training、preprocessing 與 inference code,覆蓋 RND-mix stage-one、stage-two,以及 WorldArena 三條流程。想試這個項目的人,會先由資料前處理、depth 與 3D condition 建立開始,再跑 validation inference 看生成影片是否跟動作一致;若本身做 robotic policy evaluation,還可以接到 WorldArena 或 online RND evaluation 場景。

  • 把 actions 轉成 motion images 與 contact images,空間條件更明確
  • 用 depth encoding 和 3D pointclouds 強化 robot-scene 幾何理解
  • 加入 training-time rollout strategy,目標是支援更長時序生成並減少 exposure bias
  • 儲存庫同時涵蓋訓練、前處理、推論,不只是論文展示模型
  • 相關組件包括 Wan transformer variants、Diffusion inference pipelines、RobotWin 2.0、WorldArena

性能方面,論文指出它在八個長時序真實機械人操作任務中,world-model success estimates 與真實 policy performance 呈強正相關。這個結果的價值不在於取代真機測試,而是在正式落機前,先用生成式 world model 篩選 policy checkpoints;對研究 embodied evaluation、robotics 與世界模型的人來說,iMaC 屬於相當值得跟進的一個方向。

GitHub: https://github.com/imac-wm/iMac

Paper: https://arxiv.org/pdf/2606.09813

Categories: 開源, 清華大學, AI productions, 模型, 視頻模型, 世界模型, 模型訓練, Stable Diffusion, Video, Image, Robotic, Vibe Coding, Mac, 3D, , 編程, Win

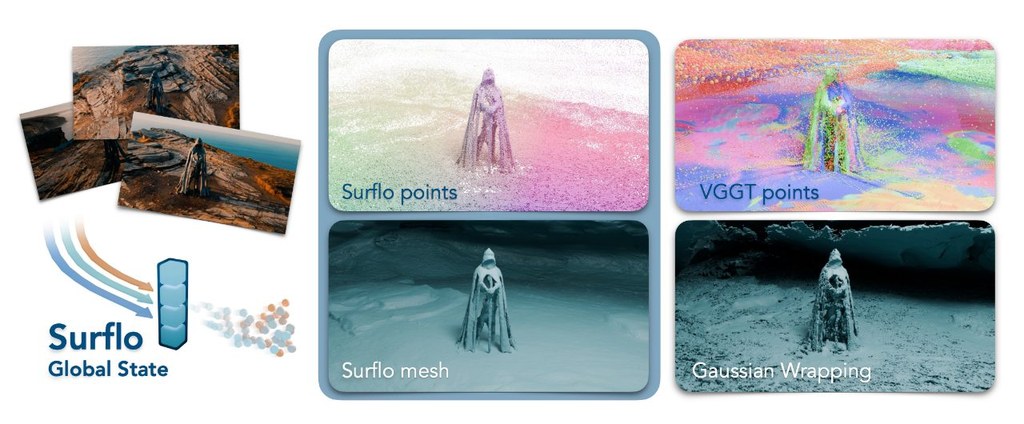
Surflo 用全域狀態重建一致 3D 表面

Surflo把多張未對位影像壓成固定狀態,再生成一致的3D表面。它兼顧彈性輸入與高解析輸出。

Surflo: a single coherent surface decoded from one global state

Surflo 是一個由多張未對位影像重建 3D 表面的項目。它先把數量可變的輸入視角整合成單一 global latent state,再用 flow-matching ODE 逐點生成表面,目標是避免傳統每個視角各自輸出、最後難以拼合的問題。

這個項目的核心做法,是把 N 張影像壓縮成固定大小的全域狀態 z,當中只有 K=128 tokens,之後再按需要解碼任意數量的表面點。因為每個點可獨立生成,同一次編碼之後便能輸出不同解析度,最高提到可處理 M up to 10^6 oriented points。

為了令獨立生成的點仍然保持同一個連貫表面,Surflo 加入 communication guidance 機制,利用 shared rendering loss 在 ODE 積分過程中協調鄰近點。系統會把點轉成 3D Gaussians,再用 Gaussian Splatting 渲染,藉此減少局部表面互相矛盾的情況。

Surflo: Consistent 3D Surface Flow from a Global State

重點項目:
– 支援 variable number of unposed images,不要求固定視角數量
– 以單一 global state 取代 per-view tokens 堆疊,控制表示大小
– 可按需要解碼任意表面解析度,不必重新編碼
– 在 8 個 benchmarks、2 到 32 views 條件下報稱達到 state of the art performance
– 另提供真實場景資料集,約 10.5K DL3DV scenes,包含 full scene meshes

這類項目較適合做多視角 3D 重建、場景數碼化,或者需要由少量到多量視角靈活輸入的研究工作。文中亦點名對比現代 feed-forward 3D 模型如 VGGT(https://huggingface.co/facebook/VGGT-1B)、DUSt3R、DepthAnything-3;若你關心的是如何由多張相片穩定得到同一個完整表面,Surflo 的全域狀態設計值得留意。

模型列表:VGGT(https://huggingface.co/facebook/VGGT-1B)、DUSt3R、DepthAnything-3。

項目: https://anttwo.github.io/surflo/

Categories: 開源, Agentic, 框架, 3D, Meta

DIRECT:可調 3D 角度的物件插令合成更自然

DIRECT 以 3D 代理配合分解式條件注入,讓物件插入既可控又自然。它同時兼顧姿態調整、外觀保留與場景融合。

DIRECT Logo

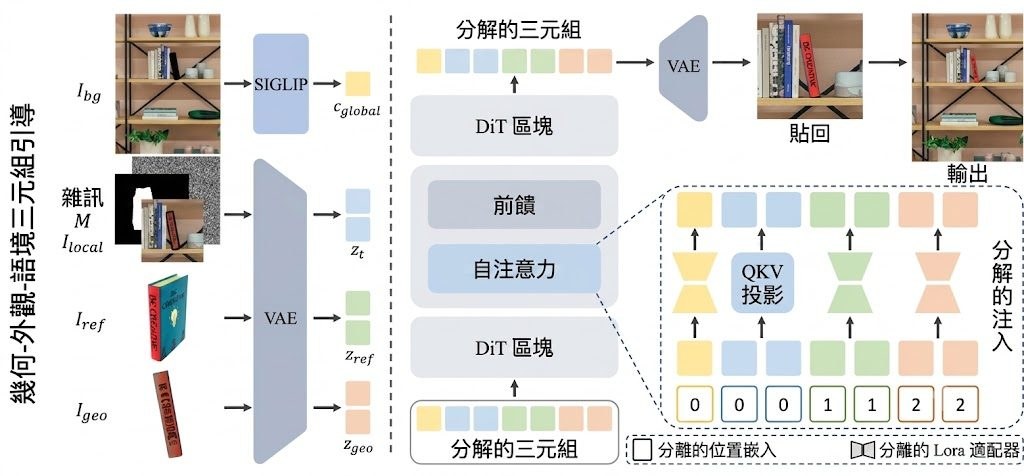
DIRECT(Decomposed Injection for Reference Composition and Target-integration)是一個用來把參考物件放入背景圖片的生成項目,重點不是單純補圖,而是加入明確的 3D 控制。網頁內容指出,現有 diffusion-based 方法多數把這類工作當成 2D inpainting,畫面雖然好看,但物件角度與空間位置較難精準控制。

DIRECT 先把參考物件提升成可互動的 3D proxy,讓使用者在目標場景內直接調整姿態,再把調整後的結果渲染成 geometry guidance。之後,生成器會同時接收參考物件的 appearance guidance、3D proxy 提供的 geometry guidance,以及背景圖片的 context guidance,合成最終插入效果。

它的核心創新在於 decomposed injection,把不同條件分開經由獨立路徑注入,而不是混在一起處理。這樣可減少 feature entanglement,較有機會同時保留原物件外觀、跟隨指定姿態,並令物件更自然融入目標場景。

重點可先留意以下幾點:
– 支援 pose-controllable object insertion,可直接調整物件姿態
– 以 reconstructed 3D proxy 提供明確幾何引導
– 把 appearance、geometry、context 三種訊息分開處理
– 附有 automated data construction pipeline,以提升訓練資料多樣性與質素
– 頁面表示在 geometric controllability 與 visual quality 上優於以往方法

這類項目特別適合影像合成、視覺生成、商品展示與內容製作等場景,當你需要指定物件朝向、位置感與場景一致性時會較有用。若你想跟進研究與重現結果,頁面已提供 Paper、Code,Model 與 Dataset 則標示為 soon。

GitHub: https://github.com/Gong1130/DIRECT

項目: https://gong1130.github.io/DIRECT/

Categories: 影像處理, 框架, 3D

Page 8 of 10
1 6 7 8 9 10