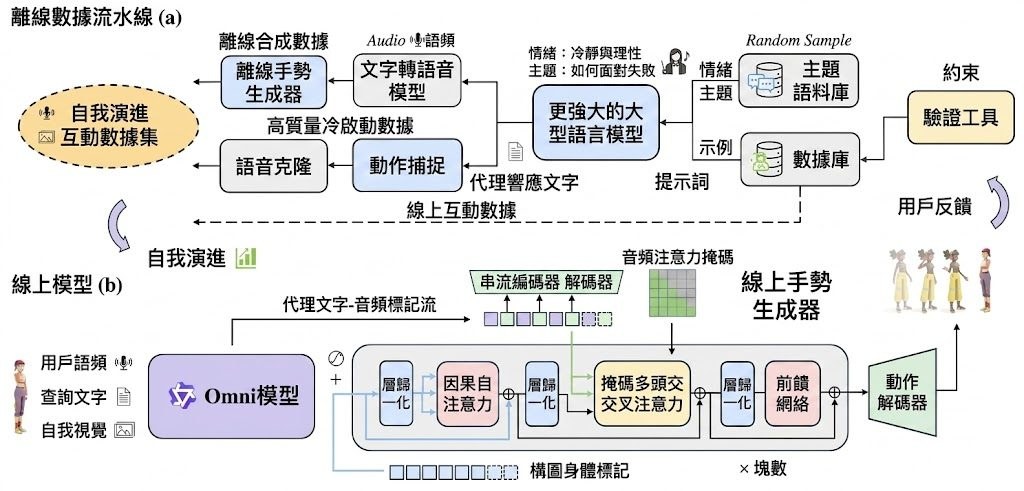
Super-Star:讓數字人邊聽邊做

Super Star 將串流語音、對話和身體動作連成一條即時管線,令 3D 數字人毋須等待完整語音才開始配合手勢。

logo

數字人要一邊回應、一邊自然做出配合語氣的動作,關鍵不只是生成語音,而是不能偷看未來內容。Super Star 屬於面向 3D 數字人的即時互動框架,處理多模態輸入、串流回應語音,以及與語音同步的身體姿態生成。

Super-Star 把 Streaming Speech Response 與 Online Gesture Generator 兩個模組接合。前者採用 Qwen3-omni 產生串流回應語音,後者是因果多模態自回歸模型,根據目前收到的語音和 motion history 預測下一段動作,因此可在低延遲下生成手勢,不需等整段對話完成。

離線資料流程會按主題和情緒建立人機對話,再為回應語句生成 co-speech gestures;線上互動收集到的使用者偏好,會回流到 closed-loop self-evolving data pipeline,支援持續調整。相比先取得完整語音再生成動作的做法,Super Star 以較少未來資訊換取即時性,但動作預測亦更依賴目前語音片段和歷史狀態。

  • 串流語音與動作同步,適合虛擬陪伴、直播角色及互動式數字人
  • Qwen3-omni 負責回應語音,Online Gesture Generator 負責身體動作
  • 研究結果主張改善 latency-quality trade-off、語音動作同步及使用者偏好
  • 訓練 Motion Tokenizer 和 Online Gesture Generator 時需要 WAV 音訊
  • CUDA driver 需為 12.4 或以上,完整執行細節仍要配合 Qwen3-omni 及 vLLM-Omni 文件

提供的資料包含 training、inference 和 evaluation code。訓練部分使用 RQVAE 的第一層 codebook 解碼,對應論文線上模型採用的 VQVAE,測試者需要準備 WAV 檔案並填寫音訊路徑和輸出目錄。對研究團隊及需要低延遲數字人互動的開發者而言,項目較適合作為研究原型或客製化系統的起點,而非即裝即用的成品。
項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, 多模態模型, 模型訓練, Qwen, NVIDIA, Audio, 3D, 語音, Dataset 數據集

WeMM-Embedding 統一多模態向量

WeMM-Embedding 把文字、圖片、影片和視覺文件放進同一套向量空間,適合要做檢索、比對和跨模態搜尋的場景。它同時提供不同尺寸選擇,方便在準確度與成本之間取捨。

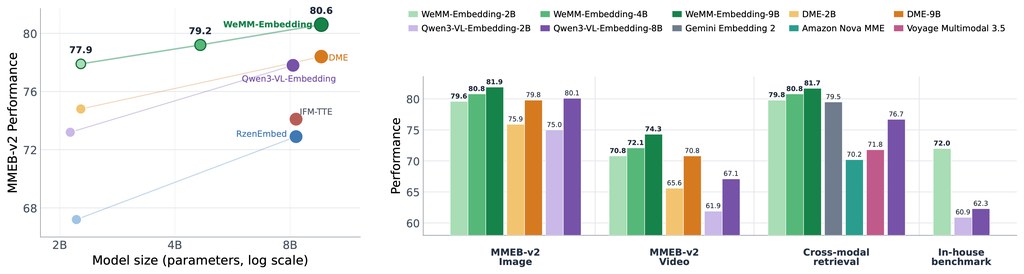
WeMM-Embedding Performance Overview

WeMM-Embedding 是一組多模態 embedding 模型,目標是把文字、圖片、影片、視覺文件和交錯式多模態輸入,轉成可直接比對的統一向量。對要做搜尋、相似度比對、內容檢索或跨媒體匹配的團隊來說,這種做法比逐一分開處理不同素材更省事。

它提供 2B、4B、9B 三個版本,還支援 Matryoshka dimensions,代表可以按需要輸出不同長度的 embedding,減少計算和儲存成本。README 也提到,向量來自 <embedding> token 的最後一層 hidden state,再做 L2 normalization;目前不支援 audio。

實作和試跑方式都算直接,既可以用 transformers,也可以用 SentenceTransformer 直接載入 Hugging Face 模型 ID。作者同時標明推理較建議用 transformers==5.2.0,原因是較新的版本在前處理行為上可能有差異;serving 方面則測過 vLLM 和 SGLang。

  • 統一處理 text、image、video、visual document 和 interleaved multimodal inputs
  • 支援 Matryoshka dimensions,可按成本需要縮短 embedding 長度
  • 適合做跨模態搜尋、內容去重、相似度比對和檢索索引
  • 推理可用 transformers 或 SentenceTransformer,部署可接 vLLM、SGLang
  • 現階段不支援 audio,做語音相關流程要另配其他模型

對要處理多媒體內容的應用團隊、檢索系統、內容平台和資料整理流程,這類模型最直接的價值是減少多套表示法之間的銜接成本。它在多個基準上取得領先結果,但實際選型仍要看你要的是完整維度、較低成本版本,還是偏向部署效率的配置。

GitHub · 模型

Categories: 開源, 騰訊, AI productions, Embedding, 模型, 多模態模型, Video, Image, Audio

GameXpert-Bench | Coding Agents for Game Development

騰訊團隊聯同多間院校提出 GameXpert-Bench,專門看 Coding Agents 能否做出、修好再優化可玩遊戲。它把生成、修復同多輪改進放入同一條流程去評估。

Og image

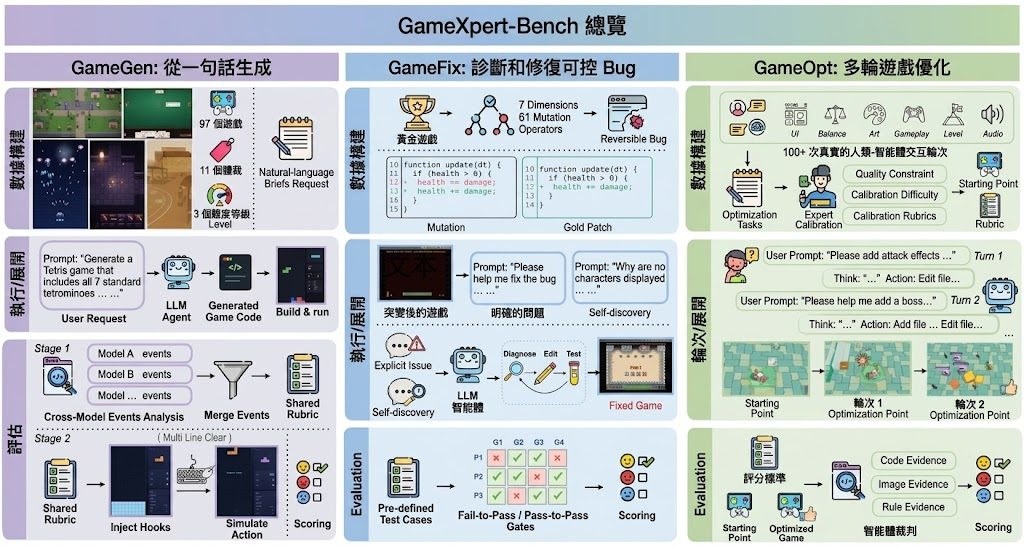
騰訊 Hunyuan Team、Lightspeed Studios,聯同 CASIA、清華大學、香港科技大學、香港中文大學深圳等團隊,提出 GameXpert-Bench,用來檢驗 Coding Agents 在遊戲開發上的真實能力。它不只看程式碼寫得像不像,還看能否真的做出可玩遊戲、找出錯誤,並在多輪修改後保持功能完整。

這個項目處理的是一個很實際的落差:很多代理可以生成看似合理的程式,但一到互動、畫面、音效、介面同可玩性要同時成立,就容易出問題。GameXpert-Bench 把整個生命週期拆成三條軌道,分別測首次生成、修復缺陷,以及連續優化,逼近真實開發流程。

  • GameGen 測試從零開始生成可玩遊戲,沒有預設引擎或素材
  • GameFix 測試對已知缺陷的診斷與修復,亦包括自行發現問題的情況
  • GameOpt 測試多輪改進時能否保住核心玩法與既有功能
  • 評估不只看程式,還結合互動行為、代碼檢查同人工判斷

目前公開資料提到共有 97 個生成任務、100 個修復任務,以及 17 條多輪優化鏈,涵蓋 2D 和 3D 遊戲。整體結果指向一個清楚結論:寫出看似合理的實作,比起交出經過驗證、又唔會在後續修改中壞掉的遊戲容易得多。

對做 Coding Agents、遊戲工具鏈、或研究 agentic software engineering 的讀者,這個基準特別有參考價值。它把「能寫」和「能交付」分開,令模型在真實工作流中的短板更容易被量度出來。

項目主頁

Categories: 香港中文大學, 香港科技大學, 清華大學, 騰訊, Agentic, Audio, 軟件, 3D, 編程, Dataset 數據集

WithEveryone 多人合照不再撞臉

復旦大學、騰訊混元與香港大學研究團隊,嘗試一次保留五至十個人物身份的群組生成。

WithEveryone teaser

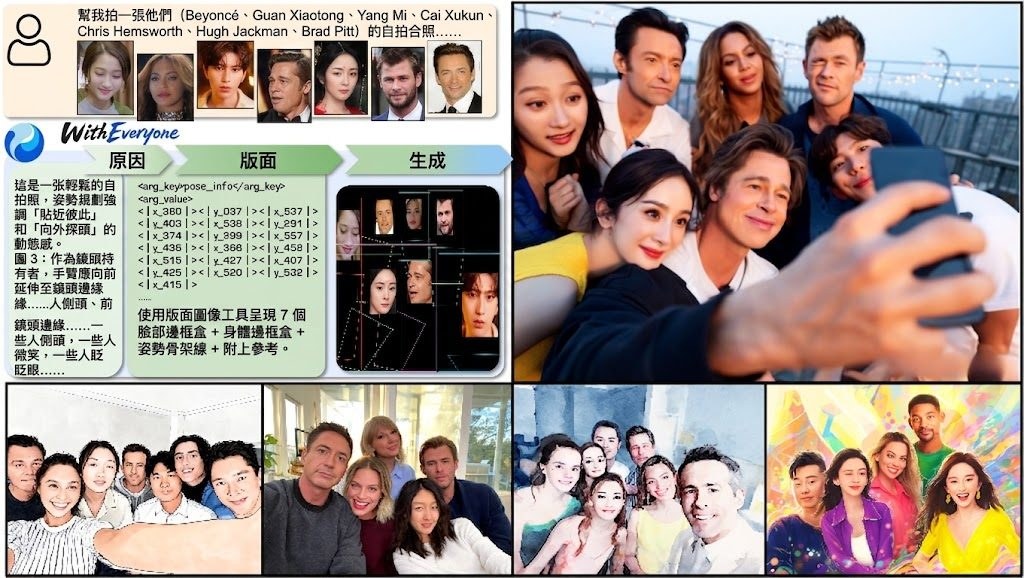
復旦大學、騰訊混元(Hunyuan)及香港大學的研究團隊共同開發 WithEveryone,針對 AI 生成多人合照時人物身份容易混淆的問題,讓五至十個參考身份可以同時出現在連貫場景中。它屬於群組影像生成研究項目,核心價值是維持每個人「誰是誰」的對應關係,而不只是增加畫面人物數量。

系統會把每個參考人物轉換成獨立的 identity token,再透過 Layout CoT 預先推理人物、臉部、身體區域與姿勢的位置,最後交由 renderer 生成視覺條件。Layout-Grounded ID Loss 會在指定臉部區域提供身份監督,ID Representation Forcing 則要求模型在合成前先為每個身份建立預測,減少多人場景中的錯配。

研究展示提供了 63 組生成結果,並在 identity-disjoint benchmark 上比較身份保真度與複製參考圖程度:WithEveryone 的 ArcFace similarity 為 0.614,高於 GPT-Image-2 的 0.566;Copy-paste score 為 0.055,低於 GPT-Image-2 的 0.169。這表示它一方面維持人物特徵,另一方面較少直接照搬參考圖,但目前資料未提供更完整的速度、硬件需求或不同人數下的細分結果。

目前 GitHub 儲存庫尚未提供可下載的研究版 checkpoint,亦沒有完整安裝及測試流程。原因是研究版本依賴的 foundation model 授權不容許公開 checkpoint;團隊正以支援開源發佈的 foundation model 訓練新版本,待程式碼及 checkpoint 準備好後才會分享。

  • 支援五至十個參考身份的群組影像生成
  • 以 identity token 綁定人物,配合身份感知的版面推理
  • 透過 Layout-Grounded ID Loss 監督指定臉部區域
  • 研究結果在 ArcFace similarity 及 Copy-paste score 上勝過 GPT-Image-2
  • 現階段只能閱讀研究展示,未能按儲存庫資料自行安裝重現

對需要製作多人宣傳照、角色群像或指定人物場景的影像研究團隊,這個方法提供了比單純堆疊參考圖更完整的身份與構圖處理思路。一般創作者暫時仍要等待開源版本,因為未公開 checkpoint 令項目現階段更接近研究展示,而不是可即時採用的生成工具。

項目主頁 · GitHub

Categories: 開源, 香港大學, 騰訊, 模型, 多模態模型, Image, 香港, Dataset 數據集

ForgeWM 把遊戲世界模型推向 72 FPS 即時互動

由中大、騰訊等團隊開發的 ForgeWM,將遊戲畫面生成壓縮至一至四步,讓鍵盤、滑鼠及手掣輸入能即時改變虛擬世界。

ForgeWM

中香港中文大學、騰訊 PCG、復旦大學、上海人工智慧實驗室及香港科技大學的研究團隊,將 ForgeWM 做成開源的 action-conditioned video world models 訓練項目,處理遊戲輸入與連續畫面生成難以兼顧的問題。它以 Matrix-Game 2(MG2)為基礎,讓模型根據鍵盤、滑鼠或 gamepad 操作即時推演遊戲畫面。

ForgeWM 的價值在於把生成步數降至 1、2 或 4 步,換取更低延遲的互動體驗;取捨是畫面質素、控制準確度與推理速度仍要依賴訓練資料和硬件。相較只展示影片生成的做法,ForgeWM 直接處理 frame-aligned 的動作訊號,並將同一套流程移植到另一個 gamepad 驅動的 FPS 領域。

  • 一套四階段流程:bidirectional SFT、teacher-forced causal AR、consistency distillation、on-policy DMD
  • ForgeWM-1、ForgeWM-2、ForgeWM-4 分別對應一、二及四步生成
  • 單張 H20、352×640 畫面下,1-step 模型最高達 72 FPS
  • 完整公開 weights、training code 及 pre-encoded data

模型並非各自獨立訓練:Stage 0 先對目標遊戲作 bidirectional fine-tuning,之後固定為教師;Stage 1 將生成器改成 causal AR,Stage 2 壓縮 sampling trajectory,Stage 3 再用學生自行 rollout 的結果進行 on-policy matching。這個結構讓 ForgeWM-1、-2、-4 可從相同基礎流程按步數預算建立。

研究、遊戲 AI 及需要即時互動生成的團隊較容易受益,尤其適合測試鍵鼠控制的 Minecraft 或 gamepad FPS。資料提供的指標包括 168 ms per chunk、72 FPS 及 8×H20 完整訓練配置;模型及數據連結整理環境,要預留 8 張 H20 重現完整訓練流程。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, 上海人工智慧實驗室, 騰訊, 世界模型, 模型訓練, Video, World-Action Model

Tencent UI-Mate 桌面操作示範變成可重用工作流

開源權重的通用 GUI 智能體:環境驅動訓練 + 上下文演示學習——流程演示一次即可,不必把所有約定寫進提示。

UI Mate icon

很多桌面任務難寫成一段完整提示,問題不在指令太短,而是在檔名規則、視窗擺位、公司流程這些細節往往靠示範更容易講清。UI-Mate 就是朝這個位置切入的開源 GUI agent 項目:它在原生桌面看螢幕畫面,用鍵盤和滑鼠跨應用程式執行長流程工作,並且支援把一次人手操作示範轉成可重用工作流。

UI-Mate 把示範當成建議。當畫面內容、資料、視窗狀態或任務目標有變化,代理仍會按即時畫面重新判斷,避免變成只懂重播錄製腳本的 Computer-use agents(CUAs)。這個取捨很重要,因為它直接回應了 GUI 自動化最常見的失敗位:流程相似,但畫面從來不會完全一樣。

訓練方法亦反映它想處理真實環境,而不只是跑單一 benchmark。項目提到 closed-loop data engine,會串連任務合成、環境建構、rollout、驗證與 filtering,再用 capability tree 補回覆蓋不足的能力;同時支援 Ubuntu、Windows 和 macOS 的統一 rollout layer,並以 asynchronous group-relative optimization 處理長而且變化大的 rollout。整體方向很清晰:先把可執行環境和驗證機制搭好,再談代理怎樣學會跨系統做事。

公開結果亦有參考價值。UI-Mate 在 OSWorld-Verified 達到 77.0%,WindowsAgentArena 為 66.2%,而 OSWorkerBench 嚴格成功率 41.0%、progress 76.9%;加入一次 same-task demonstration 後,OSWorker self-demo strict success 由 17.2% 升到 35.4%。這些數字未必代表它已經能穩定接手所有桌面工作,但至少說明示範式引導不只是概念包裝,對長流程任務有明顯幫助。

  • 屬於開源 GUI agent 項目,重點是處理跨應用、跨作業系統的長流程桌面任務
  • 核心差異在於支援 in-context demonstrations,把一次示範整理成可重用工作流
  • 示範不是腳本重播,代理會按 live screenshot 即場重新規劃
  • 較適合需要固定流程但畫面與資料經常變動的團隊、營運與辦公自動化場景
  • 目前已公開模型與結果,但 OSWorkerBench 等配套仍有部分內容標示為 Coming Soon

部署與理解方式上,現有資料較接近研究原型加可試權重,而不是開箱即用的完整產品。官方已放出 code、weights、technical report 和 Try App,較合理的看法是先把它當成可驗證 demonstration-guided GUI agent 能力的開源基線,再看後續 benchmark、資料集與工具鏈是否補齊。對研究 GUI agent、企業桌面自動化,或者想比較文字指令與示範引導差異的團隊,這個項目很值得跟進。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, 模型, Mac, Linux, Dataset 數據集, UI/UX

WorldClaw 把一句提示詞變成可編輯 3D 世界

WorldClaw 將開放式描述轉成可探索、可修改的 3D open-world scene,重點不只在生成,還在把世界結構交到使用者手上。它適合想快速做場景原型、互動展示或內容雛形的團隊。

teaser

WorldClaw 是一個 agentic 3D 生成框架,處理的問題很直接:把一句開放式提示詞,變成一個可以走進去、調整、再延伸的 3D open-world scene。它的價值不在於單次出圖,而是把「生成」和「可編輯」連在一起,令內容創作更接近真正可用的場景製作流程。

這個項目目前更像研究原型與方法展示,重點放在論文、項目頁與流程圖;README 沒有提供完整安裝指令,使用者主要應透過論文和項目頁理解它的工作方式。它由 Tencent-Hunyuan 團隊提出,核心方向是把 agentic 流程套進 3D 世界生成,讓模型不只產生外觀,還能維持場景可探索性與修改空間。

  • 由單一提示詞推進到可互動的 3D 世界,不是只生成靜態資產。
  • 強調 editable 與 explorable,較適合做場景原型和概念驗證。
  • 內容定位偏研究與展示,公開資訊未見完整部署流程。
  • 相比一般 3D 生成方法,它更重視世界結構與後續修改。
  • 對遊戲原型、虛擬場景、數字內容團隊較有參考價值。

從命名和定位看,WorldClaw 把自己放在 3D 生成與 agentic workflow 的交界位,關心的不是單一模型輸出,而是生成過程怎樣逐步組裝成世界。現階段公開材料主要講方法與成果,沒有明確性能表格可供直接比較;讀它時,重點應放在它如何把開放式描述轉成可操作場景,而不是當成現成工具包看待。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, 3D

Ex-Omni-2D 直接對話生成同步發聲與表情的數字人影片

Ex-Omni-2D 讓對話模型同時輸出文字、個人化語音與表情同步的頭像影片,以多碼本語音單元串接語音與畫面,並提供 Teacher 與 Prefix-Streaming Student 兩種部署模式。

Ex-Omni-2D framework

想讓 AI 數字人不只是「會打字」,而是真的「邊說邊演」?香港中文大學(深圳)與 LIGHTSPEED 合作開源的 Ex-Omni-2D,正是針對這個目標設計。它是一個開源對話框架,接受多模態查詢、參考圖像與參考音訊後,先由語言模型輸出一份結構化的 Visual Thought Plan(VTP),再依此生成文字回應、個人化語音,並產出嘴形與動作同步的頭像影片。

傳統做法通常把語音合成與人物影片視為兩條獨立管線,需要額外對齊文字、聲音與嘴形,容易出現時間錯位。Ex-Omni-2D 的差異在於採用 16 個 codebook 構成的原生多碼本語音單元,作為語音與影片共享的聲學與時序介面:同一組語音單元既驅動 TTS,也作為影片生成器的緊緻條件,從而降低跨模態錯位的風險。

影片生成路徑提供兩種互補模式:Full-sequence Teacher 採雙向注意力,追求最高畫質;Prefix-Streaming Student 則是蒸餾而來的少步數 block-causal 版本,支援 2、4、8 步串流推論,方便在工作站、GPU 伺服器甚至 Hugging Face Spaces 上做漸進式部署。

這個項目的重點:

  • 對話原生影片:視覺行為直接從多模態對話上下文規劃,不必再手動撰寫影片提示詞。
  • 結構化 VTP:明確定義首幀、場景、情緒、動作風格與動作細節,方便後續控制與除錯。
  • 共享語音介面:16 個 codebook 同步驅動語音合成與人物動作。
  • 品質與效率取捨:Teacher 負責最高畫質,Student 支援 2/4/8 步串流。
  • 彈性部署:同一套代碼可在個人工作站、GPU 伺服器或 HF Spaces 執行,並提供線上 Demo 試玩。

在串流場景中,作者指出 Prefix Streaming 從第 9 至 16 chunk 的一致性明顯較強,將 last-to-first consistency error 降低 21.4%,這對需要長時間維持角色身份一致的應用相當關鍵。論文亦提到 Prefix Streaming 能減少長序列累積形變,同時保留參考圖像的人物外觀。

較適合的對象包括需要快速打造可對話 AI 助手、虛擬主播、客服分身或教學數字人的團隊;對研究多模態對話、語音驅動動畫的人來說,這份開源代碼、模型權重與 arXiv 論文也是一個方便的起點。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 騰訊, 文字轉語音, AI productions, 數字人, 多模態模型, 視頻模型, Qwen, 香港, 語音

用行為地圖看懂 Agent Harness

想查清代理會唔會刪檔前先確認,最難唔係搵唔到碼,而係搵唔齊完整行為鏈。Harness Handbook 把分散實作整理成可追溯的行為地圖。

Hero image preview

想理解 coding agent 點樣真正執行、點樣做安全檢查,或者想改成自己團隊用得上的流程,卡位通常唔在於缺少文件,而在於行為分散喺大量程式碼之中。Harness Handbook 就是針對 agent harness 的整理方法,把「某個行為點樣發生」變成可導航、可核對、可修改的路徑。

它處理的是行為同實作之間斷開的問題。像「刪除檔案前會否先詢問」這類問題,往往涉及多個 implementation sites,不是搜 delete、permission、confirm 就能直接還原全貌。Harness Handbook 以 behavior-level manual 方式重組這些零散位置,讓人可以由問題出發,一步步找到對應的 behavior units、相關程式碼證據,以及可能受影響的修改位置。

  • 把分散程式碼整理成可閱讀的 behavior map
  • 每個行為步驟都連到可驗證的 code evidence
  • 支援理解、審核與修改共用同一套入口
  • 著重 human in the loop,方便持續檢查系統變化

這種做法同一般 code index 或關鍵字搜尋的差異,在於它不是單純列出檔案,而是直接對應「系統會點做」。對開發者、維護大型 agent 項目的人,或者要審視安全邏輯的團隊,都會比較實用;連 coding agents 也可借這份 Handbook 更準確找到相關程式碼。

資料顯示,項目還提供 Handbook Studio,將這套 behavior map 變成可操作的入口。現階段重點不在推出另一個模型,而是為複雜 agent harness 建立一層可解釋、可審核的結構,令系統隨版本演進時,仍然保留清晰的行為脈絡。

項目主頁

Categories: 開源, 騰訊, Agentic, 框架, Vibe Coding, 編程

騰訊 Hy3 295B 參數 MoE 開源新模型

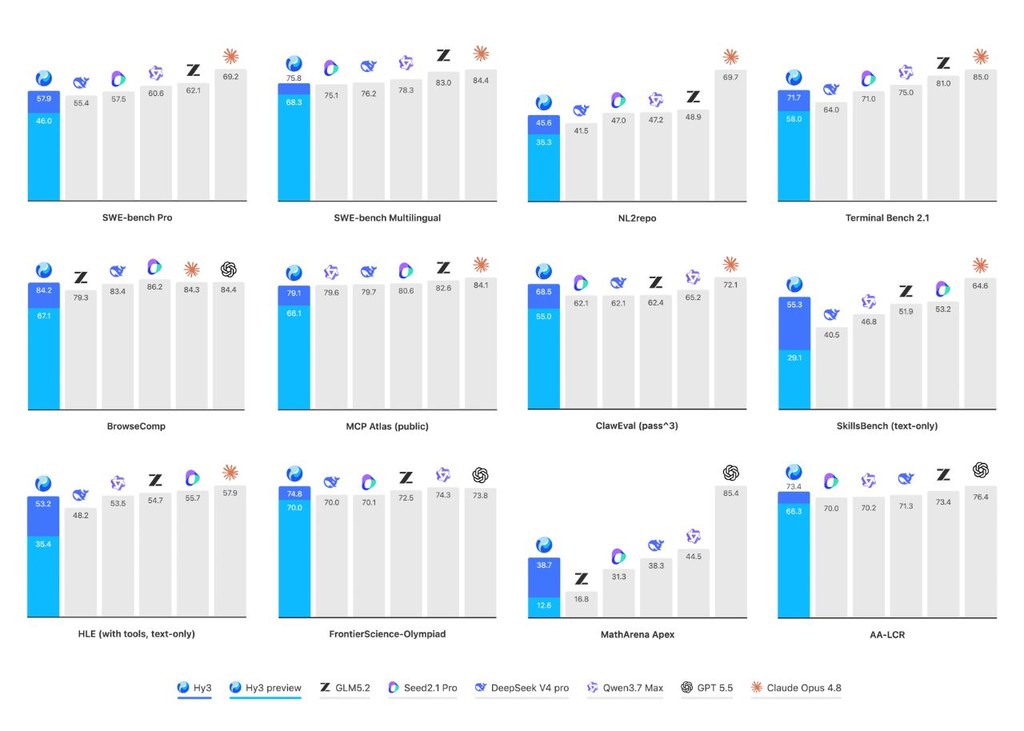
騰訊混元團隊推出 295B 參數 MoE 語言模型 Hy3,支援 256K 上下文,主打 Agent 能力與高效推理。

Og image

Hy3 是由騰訊混元(Tencent Hy)團隊開發的大型語言模型,屬於 Mixture-of-Experts(MoE)混合專家架構,總參數量達 295B,每次推理僅啟用 21B 活躍參數,並額外配備 3.8B 嘅 Multi-Token Prediction(MTP)層參數。此模型基於 Hy3 Preview 進行後訓練擴展,從 50 多個產品團隊收集意見後,以更高品質數據及更大規模強化學習(RL)完成優化。頁面未明確標示 Hy3 係基於邊個外部基礎模型(base model)進行微調,但模型採用原生 MoE 設計,整體架構並非由其他既有模型衍生。

Hy3 共有 80 層非 MTP 主體層加 1 層 MTP 層,採用 GQA 注意力機制(64 個查詢頭、8 個 KV 頭,head dim 128),隱藏維度為 4096,中間層維度 13312,上下文長度支援 256K token,詞表大小為 120832。MoE 部分配置 192 個專家,每次推理啟用 top-8 專家,目前僅提供 BF16 精度版本。

Hy3 官方推薦使用 vLLM 及 SGLang 兩種高效推論框架,頁面亦提供針對兩者嘅部署指南及 finetuning 流程。由於模型體積龐大,即使只有 21B 活躍參數,完整 BF16 權重對消費級 GPU 而言仍然極具挑戰性,需要多張高階加速器才能承載。

Tencent Hy3 (Fully Tested) + Fully Free API: BEATS GLM-5.2?

值得留意嘅係,Hy3 配備 MTP 層參數,可配合 speculative decoding 等加速技術提升 token 生成效率,呢類進階功能適合追求低延遲嘅應用場景。

  • 模型類型:295B 參數 MoE 語言模型,每次啟用 21B 參數
  • 上下文長度:256K token,詞表 120832
  • 精度支援:目前僅提供 BF16 版本,未見 GGUF 或 AWQ 等量化檔案
  • 部署框架:官方推薦 vLLM 與 SGLang
  • 核心強項:Agent 能力、推理表現,以及 MTP speculative decoding 加速潛力

項目主頁

Categories: 開源, 騰訊, 模型

Page 3 of 5
1 2 3 4 5