Tencent UI-Mate 桌面操作示範變成可重用工作流

開源權重的通用 GUI 智能體:環境驅動訓練 + 上下文演示學習——流程演示一次即可,不必把所有約定寫進提示。

UI Mate icon

很多桌面任務難寫成一段完整提示,問題不在指令太短,而是在檔名規則、視窗擺位、公司流程這些細節往往靠示範更容易講清。UI-Mate 就是朝這個位置切入的開源 GUI agent 項目:它在原生桌面看螢幕畫面,用鍵盤和滑鼠跨應用程式執行長流程工作,並且支援把一次人手操作示範轉成可重用工作流。

UI-Mate 把示範當成建議。當畫面內容、資料、視窗狀態或任務目標有變化,代理仍會按即時畫面重新判斷,避免變成只懂重播錄製腳本的 Computer-use agents(CUAs)。這個取捨很重要,因為它直接回應了 GUI 自動化最常見的失敗位:流程相似,但畫面從來不會完全一樣。

訓練方法亦反映它想處理真實環境,而不只是跑單一 benchmark。項目提到 closed-loop data engine,會串連任務合成、環境建構、rollout、驗證與 filtering,再用 capability tree 補回覆蓋不足的能力;同時支援 Ubuntu、Windows 和 macOS 的統一 rollout layer,並以 asynchronous group-relative optimization 處理長而且變化大的 rollout。整體方向很清晰:先把可執行環境和驗證機制搭好,再談代理怎樣學會跨系統做事。

公開結果亦有參考價值。UI-Mate 在 OSWorld-Verified 達到 77.0%,WindowsAgentArena 為 66.2%,而 OSWorkerBench 嚴格成功率 41.0%、progress 76.9%;加入一次 same-task demonstration 後,OSWorker self-demo strict success 由 17.2% 升到 35.4%。這些數字未必代表它已經能穩定接手所有桌面工作,但至少說明示範式引導不只是概念包裝,對長流程任務有明顯幫助。

  • 屬於開源 GUI agent 項目,重點是處理跨應用、跨作業系統的長流程桌面任務
  • 核心差異在於支援 in-context demonstrations,把一次示範整理成可重用工作流
  • 示範不是腳本重播,代理會按 live screenshot 即場重新規劃
  • 較適合需要固定流程但畫面與資料經常變動的團隊、營運與辦公自動化場景
  • 目前已公開模型與結果,但 OSWorkerBench 等配套仍有部分內容標示為 Coming Soon

部署與理解方式上,現有資料較接近研究原型加可試權重,而不是開箱即用的完整產品。官方已放出 code、weights、technical report 和 Try App,較合理的看法是先把它當成可驗證 demonstration-guided GUI agent 能力的開源基線,再看後續 benchmark、資料集與工具鏈是否補齊。對研究 GUI agent、企業桌面自動化,或者想比較文字指令與示範引導差異的團隊,這個項目很值得跟進。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, 模型, Mac, Linux, Dataset 數據集, UI/UX

WorldClaw 把一句提示詞變成可編輯 3D 世界

WorldClaw 將開放式描述轉成可探索、可修改的 3D open-world scene,重點不只在生成,還在把世界結構交到使用者手上。它適合想快速做場景原型、互動展示或內容雛形的團隊。

teaser

WorldClaw 是一個 agentic 3D 生成框架,處理的問題很直接:把一句開放式提示詞,變成一個可以走進去、調整、再延伸的 3D open-world scene。它的價值不在於單次出圖,而是把「生成」和「可編輯」連在一起,令內容創作更接近真正可用的場景製作流程。

這個項目目前更像研究原型與方法展示,重點放在論文、項目頁與流程圖;README 沒有提供完整安裝指令,使用者主要應透過論文和項目頁理解它的工作方式。它由 Tencent-Hunyuan 團隊提出,核心方向是把 agentic 流程套進 3D 世界生成,讓模型不只產生外觀,還能維持場景可探索性與修改空間。

  • 由單一提示詞推進到可互動的 3D 世界,不是只生成靜態資產。
  • 強調 editable 與 explorable,較適合做場景原型和概念驗證。
  • 內容定位偏研究與展示,公開資訊未見完整部署流程。
  • 相比一般 3D 生成方法,它更重視世界結構與後續修改。
  • 對遊戲原型、虛擬場景、數字內容團隊較有參考價值。

從命名和定位看,WorldClaw 把自己放在 3D 生成與 agentic workflow 的交界位,關心的不是單一模型輸出,而是生成過程怎樣逐步組裝成世界。現階段公開材料主要講方法與成果,沒有明確性能表格可供直接比較;讀它時,重點應放在它如何把開放式描述轉成可操作場景,而不是當成現成工具包看待。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, 3D

Ex-Omni-2D 直接對話生成同步發聲與表情的數字人影片

Ex-Omni-2D 讓對話模型同時輸出文字、個人化語音與表情同步的頭像影片,以多碼本語音單元串接語音與畫面,並提供 Teacher 與 Prefix-Streaming Student 兩種部署模式。

Ex-Omni-2D framework

想讓 AI 數字人不只是「會打字」,而是真的「邊說邊演」?香港中文大學(深圳)與 LIGHTSPEED 合作開源的 Ex-Omni-2D,正是針對這個目標設計。它是一個開源對話框架,接受多模態查詢、參考圖像與參考音訊後,先由語言模型輸出一份結構化的 Visual Thought Plan(VTP),再依此生成文字回應、個人化語音,並產出嘴形與動作同步的頭像影片。

傳統做法通常把語音合成與人物影片視為兩條獨立管線,需要額外對齊文字、聲音與嘴形,容易出現時間錯位。Ex-Omni-2D 的差異在於採用 16 個 codebook 構成的原生多碼本語音單元,作為語音與影片共享的聲學與時序介面:同一組語音單元既驅動 TTS,也作為影片生成器的緊緻條件,從而降低跨模態錯位的風險。

影片生成路徑提供兩種互補模式:Full-sequence Teacher 採雙向注意力,追求最高畫質;Prefix-Streaming Student 則是蒸餾而來的少步數 block-causal 版本,支援 2、4、8 步串流推論,方便在工作站、GPU 伺服器甚至 Hugging Face Spaces 上做漸進式部署。

這個項目的重點:

  • 對話原生影片:視覺行為直接從多模態對話上下文規劃,不必再手動撰寫影片提示詞。
  • 結構化 VTP:明確定義首幀、場景、情緒、動作風格與動作細節,方便後續控制與除錯。
  • 共享語音介面:16 個 codebook 同步驅動語音合成與人物動作。
  • 品質與效率取捨:Teacher 負責最高畫質,Student 支援 2/4/8 步串流。
  • 彈性部署:同一套代碼可在個人工作站、GPU 伺服器或 HF Spaces 執行,並提供線上 Demo 試玩。

在串流場景中,作者指出 Prefix Streaming 從第 9 至 16 chunk 的一致性明顯較強,將 last-to-first consistency error 降低 21.4%,這對需要長時間維持角色身份一致的應用相當關鍵。論文亦提到 Prefix Streaming 能減少長序列累積形變,同時保留參考圖像的人物外觀。

較適合的對象包括需要快速打造可對話 AI 助手、虛擬主播、客服分身或教學數字人的團隊;對研究多模態對話、語音驅動動畫的人來說,這份開源代碼、模型權重與 arXiv 論文也是一個方便的起點。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 騰訊, 文字轉語音, AI productions, 數字人, 多模態模型, 視頻模型, Qwen, 香港, 語音

用行為地圖看懂 Agent Harness

想查清代理會唔會刪檔前先確認,最難唔係搵唔到碼,而係搵唔齊完整行為鏈。Harness Handbook 把分散實作整理成可追溯的行為地圖。

Hero image preview

想理解 coding agent 點樣真正執行、點樣做安全檢查,或者想改成自己團隊用得上的流程,卡位通常唔在於缺少文件,而在於行為分散喺大量程式碼之中。Harness Handbook 就是針對 agent harness 的整理方法,把「某個行為點樣發生」變成可導航、可核對、可修改的路徑。

它處理的是行為同實作之間斷開的問題。像「刪除檔案前會否先詢問」這類問題,往往涉及多個 implementation sites,不是搜 delete、permission、confirm 就能直接還原全貌。Harness Handbook 以 behavior-level manual 方式重組這些零散位置,讓人可以由問題出發,一步步找到對應的 behavior units、相關程式碼證據,以及可能受影響的修改位置。

  • 把分散程式碼整理成可閱讀的 behavior map
  • 每個行為步驟都連到可驗證的 code evidence
  • 支援理解、審核與修改共用同一套入口
  • 著重 human in the loop,方便持續檢查系統變化

這種做法同一般 code index 或關鍵字搜尋的差異,在於它不是單純列出檔案,而是直接對應「系統會點做」。對開發者、維護大型 agent 項目的人,或者要審視安全邏輯的團隊,都會比較實用;連 coding agents 也可借這份 Handbook 更準確找到相關程式碼。

資料顯示,項目還提供 Handbook Studio,將這套 behavior map 變成可操作的入口。現階段重點不在推出另一個模型,而是為複雜 agent harness 建立一層可解釋、可審核的結構,令系統隨版本演進時,仍然保留清晰的行為脈絡。

項目主頁

Categories: 開源, 騰訊, Agentic, 框架, Vibe Coding, 編程

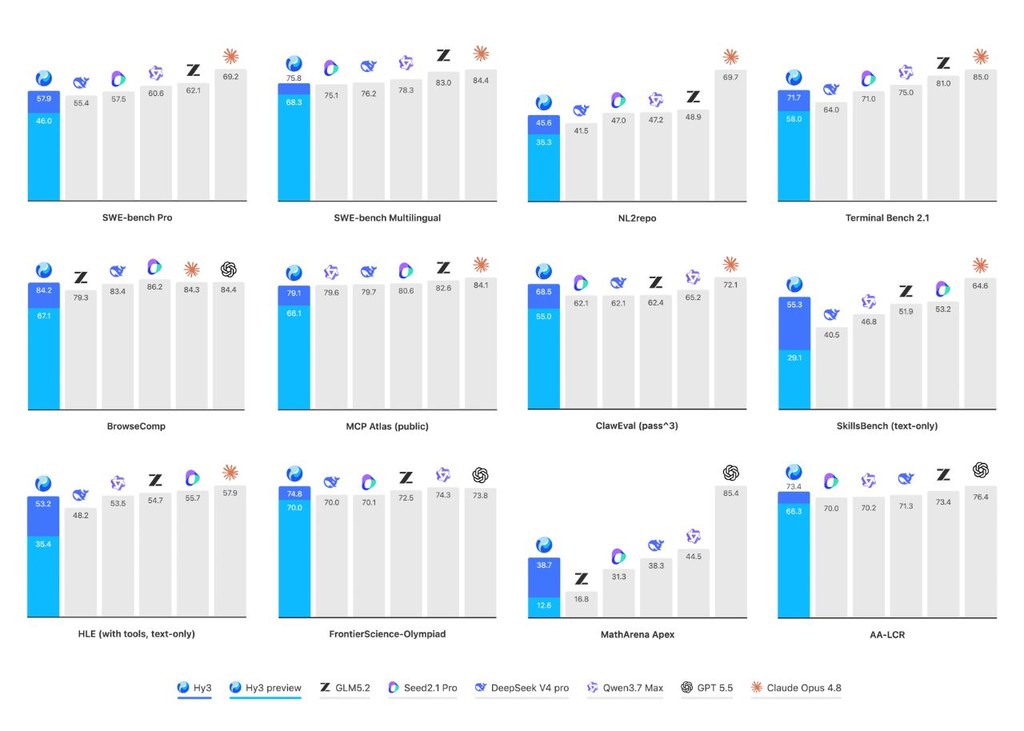
騰訊 Hy3 295B 參數 MoE 開源新模型

騰訊混元團隊推出 295B 參數 MoE 語言模型 Hy3,支援 256K 上下文,主打 Agent 能力與高效推理。

Og image

Hy3 是由騰訊混元(Tencent Hy)團隊開發的大型語言模型,屬於 Mixture-of-Experts(MoE)混合專家架構,總參數量達 295B,每次推理僅啟用 21B 活躍參數,並額外配備 3.8B 嘅 Multi-Token Prediction(MTP)層參數。此模型基於 Hy3 Preview 進行後訓練擴展,從 50 多個產品團隊收集意見後,以更高品質數據及更大規模強化學習(RL)完成優化。頁面未明確標示 Hy3 係基於邊個外部基礎模型(base model)進行微調,但模型採用原生 MoE 設計,整體架構並非由其他既有模型衍生。

Hy3 共有 80 層非 MTP 主體層加 1 層 MTP 層,採用 GQA 注意力機制(64 個查詢頭、8 個 KV 頭,head dim 128),隱藏維度為 4096,中間層維度 13312,上下文長度支援 256K token,詞表大小為 120832。MoE 部分配置 192 個專家,每次推理啟用 top-8 專家,目前僅提供 BF16 精度版本。

Hy3 官方推薦使用 vLLM 及 SGLang 兩種高效推論框架,頁面亦提供針對兩者嘅部署指南及 finetuning 流程。由於模型體積龐大,即使只有 21B 活躍參數,完整 BF16 權重對消費級 GPU 而言仍然極具挑戰性,需要多張高階加速器才能承載。

Tencent Hy3 (Fully Tested) + Fully Free API: BEATS GLM-5.2?

值得留意嘅係,Hy3 配備 MTP 層參數,可配合 speculative decoding 等加速技術提升 token 生成效率,呢類進階功能適合追求低延遲嘅應用場景。

  • 模型類型:295B 參數 MoE 語言模型,每次啟用 21B 參數
  • 上下文長度:256K token,詞表 120832
  • 精度支援:目前僅提供 BF16 版本,未見 GGUF 或 AWQ 等量化檔案
  • 部署框架:官方推薦 vLLM 與 SGLang
  • 核心強項:Agent 能力、推理表現,以及 MTP speculative decoding 加速潛力

項目主頁

Categories: 開源, 騰訊, 模型

ViQ 想把影像變成更懂語意的離散碼

ViQ 是把影像量化成離散表示的研究框架,目標是在語意理解與細節保留之間取得平衡。它也支援任意解析度輸入,對多模態訓練效率有明顯吸引力。

hunyuan logo

ViQ 是一個視覺量化表示研究框架,也是把影像轉成離散 codes 的模型方法。它要解決的問題,是讓圖片像文字 token 一樣可交給多模態大模型處理,同時盡量不要在量化過程丟失太多語意與畫面細節。

現有做法常見兩條路:一類偏重重建,還原畫面能力較好,但語意資訊不足;另一類依賴 contrastive vision-language learning 的連續特徵,語意較強,卻不容易直接變成高品質離散表示。ViQ 的切入點是先做 Text-Aligned Pre-training,再做量化學習,把「先對齊語言語意、後逐步離散化」拆成清楚兩段。

它的核心設計有幾個辨識度很高的部件:以 pretrained language model 監督視覺編碼器、用 resized positional embedding 與 native patchify 支援 any-resolution input、再用 Proximal Representation Learning 配合 L∞-norm 約束,把特徵逐步推近量化錨點,最後交給 position-aware、head-wise FSQ(Finite Scalar Quantization)處理。論文亦提到基座可接 SigLIP2 vision tower、Qwen2.5 backbone,並透過 LoRA 等輕量組件訓練量化部分,而不是全面微調整個系統。

  • 支援任意解析度輸入,不用被固定尺寸綁死
  • 目標不是只重建圖片,而是兼顧語意理解與細節
  • 多模態訓練可直接吃離散視覺 codes,論文稱效率可提升約 20% 至 70%
  • 已公開訓練與推論程式,並提供 HuggingFace 權重

從部署與測試角度看,這個 GitHub 儲存庫較適合當研究實作與模型驗證項目來理解:可先用已公開權重跑 inference,觀察影像如何被編成離散 codes,再進一步重現單階段訓練示例,之後才嘗試論文中的兩階段 recipe。較受惠的會是做 MLLM、視覺 tokenization、影像重建或訓練加速的團隊;限制則是概念與訓練流程都不算輕,重點較偏研究價值,未必是即裝即用的通用工具。

GitHub: https://github.com/yuxumin/ViQ

Paper: https://arxiv.org/pdf/2606.27313

Categories: 開源, 清華大學, 騰訊, Embedding, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架

WATER:WordArt 場景文字識別新突破

復旦大學與騰訊 WeChat Vision 團隊推出 WATER 項目,從數據與模型兩端突破藝術文字識別瓶頸,於 WordArt-Bench 創下 90.40% 準確率。

overview

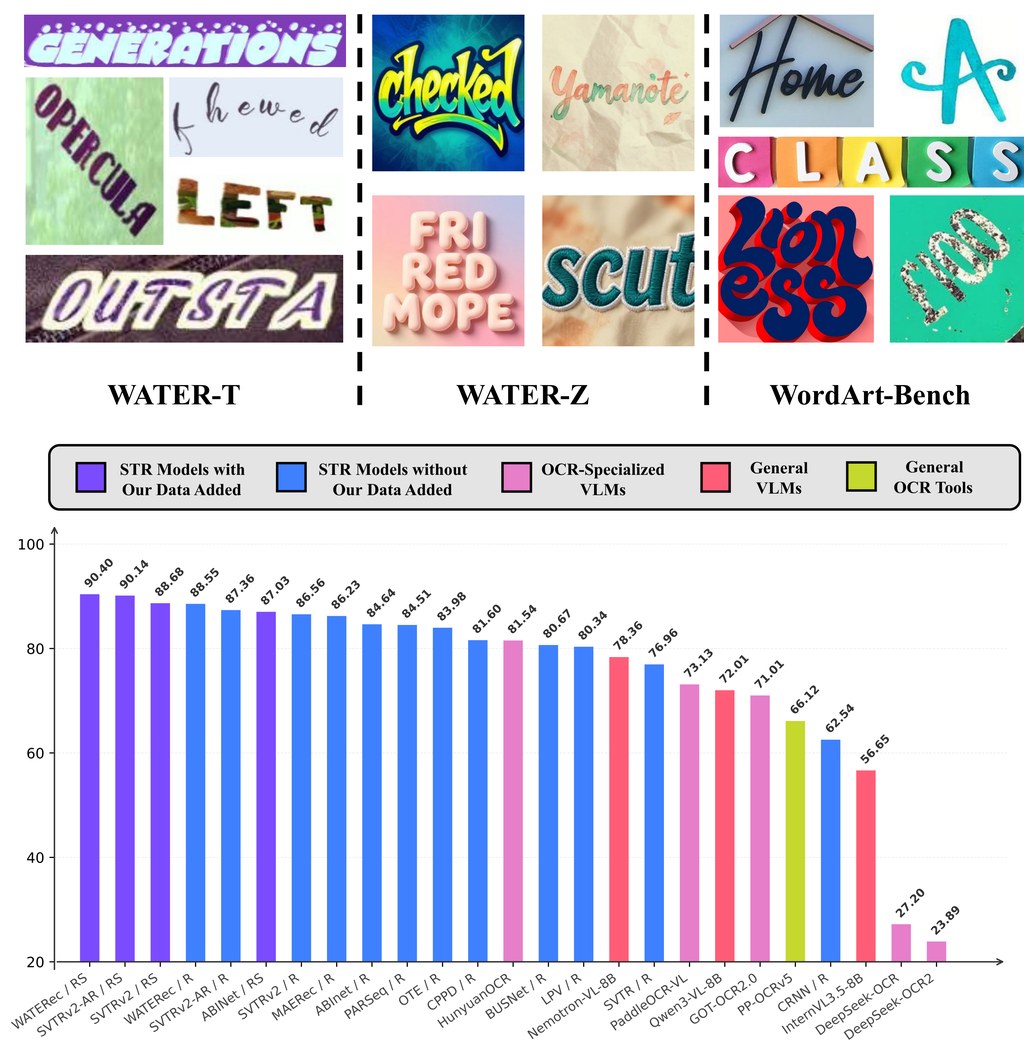
這是一個由復旦大學(上海多模態具身 AI 重點實驗室)與騰訊 WeChat Vision 聯合發佈的研究項目(屬於數據集+模型基準組合),同時收錄於 ECCV 2026。針對 WordArt-oriented scene TExt Recognition(WATER)這項任務,原有 STR 數據集與方法普遍圍繞「規則場景文字」與「固定模板輸入」建構,難以應對 WordArt 高度自訂的字體、紋理與版面,因此表現受限。WATER 從兩端突破:數據方面構建 2M 規模合成數據集 WATER-S,模型方面提出支援任意形狀輸入的 STR 基線 WATERec。

WATER-S 數據集設計包含兩個互補子集:WATER-T(1M)由 SynthWordArt 渲染引擎透過 11,250 款藝術字體生成,提供高可控的精準合成樣本;WATER-Z(1M)則結合 Qwen3-VL 提示詞挖掘與 Z-Image 影像合成,覆蓋更真實且多元的場景。再搭配 WATER-R(3.2M,整理自 Union14M-L、WordArt、WAS-R 並去重)作為真實訓練集,整體數據規模較既有藝術文字數據提升數百倍。

WATERec 模型架構採用類似 NaViT 的編碼器搭配 RoPE,支援任意形狀輸入,再以自回歸解碼器處理複雜版面,從結構上打破固定模板 STR 的瓶頸。在 WordArt-Bench 上以 90.40% 準確率成為首個突破 90% 的結果,大幅超越 HunyuanOCR(81.54%)及其他通用或 OCR 專用視覺語言模型。

使用方法需配合外部資源:WATERec 訓練與推理程式碼位於 OpenOCR-WATERec 倉庫;模型權重、數據集(包含 WordArt-Bench)、273K 條 WATER-Z 提示詞模板與 112K 款藝術字體皆託管於 HuggingFace。複製本倉庫後,可透過 SynthWordArt/ 目錄取得 WATER-T 渲染流程,prompts/ 目錄提供 caption_mining.py 與 fewshot_expansion.py 兩階段提示詞挖掘,Z-Image/gen_zimage.py 支援多 GPU 並行生成,eval_vlm/ 則整合 Qwen3-VL-8B、InternVL3.5-8B、GOT-OCR2.0、DeepSeek-OCR-2、PaddleOCR-VL、PP-OCRv5、HunyuanOCR、Nemotron-VL-8B 等基線評測腳本。

重點摘要:
– 復旦大學與騰訊 WeChat Vision 團隊合作,獲 ECCV 2026 收錄
– WATER-S 含 WATER-T(字體渲染)與 WATER-Z(VLM + 影像合成)兩條合成路徑
– WATERec 以任意形狀編碼器 + 自回歸解碼器突破固定模板限制
– WordArt-Bench 90.40% 為首次突破九成,超越 HunyuanOCR 等專用 VLM
– 所有模型、數據、字體與提示詞均開源於 HuggingFace

從評估對照來看,不論是通用 VLM、OCR 專用 VLM 或一般 OCR 工具,在 WordArt-Bench 上皆明顯落後於 WATERec,反映藝術文字仍是當前多模態模型的弱項。對從事海報辨識、品牌素材處理、廣告設計自動化,以及需要處理高度風格化文字的團隊而言,這套數據+模型組合是目前少數針對該場景強化的開源方案。

GitHub: https://github.com/YesianRohn/WATER

模型: https://huggingface.co/Yesianrohn/WATERec-Models

Categories: 開源, 北京大學, 騰訊, 模型, 視覺模型, 多模態模型, DeepSeek, Image, 深度學習, 中國, Dataset 數據集

PhoneBuddy:訓練手機代理的雙路徑做法

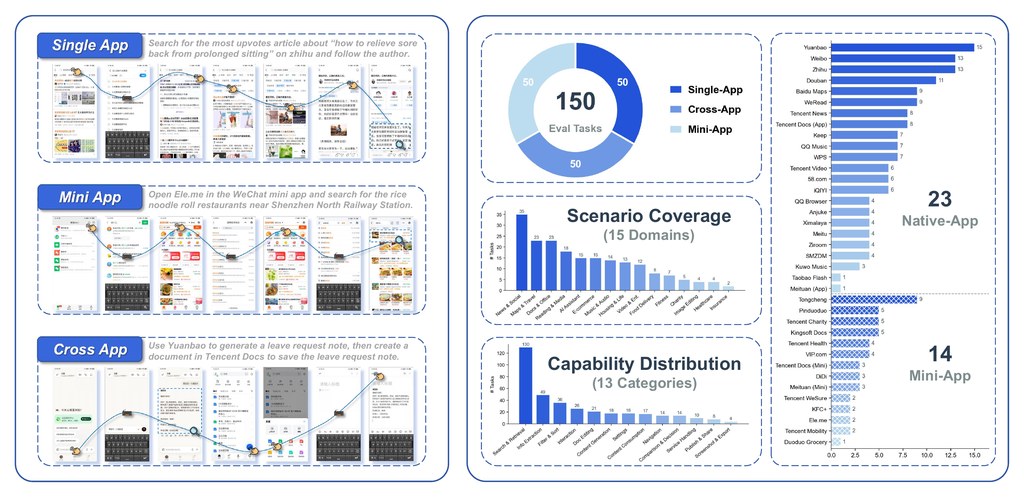
PhoneBuddy 是訓練開放式手機代理的研究項目,重點在結合真實 App 與模擬環境。它想解決手機代理難以同時兼顧真實性與可擴展訓練的問題。

PhoneBuddy logo

PhoneBuddy 是一個開放式 phone-use agent 訓練研究項目,也是面向手機操作代理的模型訓練配方。它主要解決的問題,是讓代理不只會看畫面點擊與輸入,還能同時從真實手機執行回饋與可重設、可驗證的模擬環境中持續改進。

現有 mobile agents 常被當成 GUI controller 來訓練或評測:看螢幕、點擊、輸入、滑動,再重複下一步。PhoneBuddy 指出,單靠真實 App reinforcement learning(RL)雖然更貼近真機,但成本高、難重設、驗證麻煩;只靠 PhoneWorld 風格的 mock-app RL 又較易擴展,卻未必完全反映真實手機情境,所以它採用 real-app RL 加 mock-app RL 的混合路線。

這個取向的重點,不是單純把資料加多,而是把兩種訊號分工:真實執行提供 realism,模擬環境提供 resettable 與 verifier-backed tasks。根據公開頁面,PhoneBuddy-4B 在 Real+Mock RL 後,AndroidWorld 成功率達 83.2%,比只做 real-app RL 平均高 5.0;不過 cross-app 任務只有 18.0,反映跨 App 長流程仍是明顯短板。

現階段較適合把它理解成研究原型加公開模型,而不是完整可即裝即用產品。公開資訊顯示已有 Hugging Face 模型,包括 PhoneBuddy-4B、PhoneBuddy-4B-RealApp 與 PhoneBuddy-0.8B;但 code release、evaluation documentation 仍在補,dataset 亦未公開,所以目前較合理的測試方式,是先比較不同 checkpoint 的能力定位,再配合 PhoneWorld、PhoneHarness、PhonePrivacy、PhoneSafety 這條研究線一併理解。

  • 核心差異:把 real-app RL 的真實性,與 mock-app RL 的可驗證擴展性結合
  • 已公開模型:PhoneBuddy-4B、PhoneBuddy-4B-RealApp、PhoneBuddy-0.8B
  • 公開成績:AndroidWorld 83.2%,平均比 real-app RL only 高 5.0
  • 主要限制:cross-app 表現偏低,資料集未公開,程式與評測文件仍未齊備
  • 較適合人群:研究 Computer-use agents(CUAs)/手機代理、做 agent training、benchmark 或安全與私隱分析的團隊

想了解「手機代理怎樣訓練得更像真機、又不至於每次都要真人手動重置環境」,PhoneBuddy 的判斷相當清晰:真實世界負責可信度,模擬世界負責規模。它未必已經提供完整部署流程,但作為 open phone-use agents 的訓練方向,取捨、限制和下一步研究空間都表達得很明確。

GitHub: https://github.com/PhoneBuddyAI/phonebuddy

項目主頁: https://phonebuddyai.github.io/

項目: https://huggingface.co/PhoneBuddyAI/PhoneBuddy-4B

Categories: 開源, 香港中文大學, 騰訊, Agentic, 模型, 模型訓練, Qwen, OpenAI, Gemini, 香港, 安全, 中國, Dataset 數據集

ActWorld 讓世界模型學懂互動

ActWorld不只可移動視角,亦能在生成過程中操作物件。它把導航與互動放入同一個 Interactive World Model。

Og image

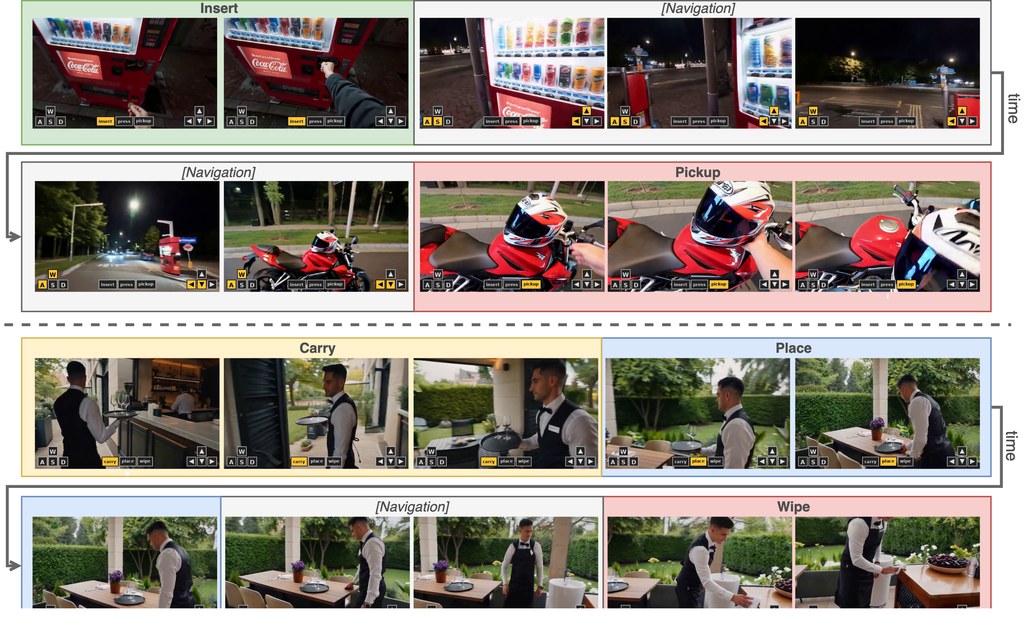
ActWorld 是一個 Interactive World Model,目標是把「可四處觀看的世界」推進到「可以即時操作的世界」。以往不少世界模型主要支援移動、轉向、環視等導航動作,對場景中的物件互動支援有限;這個項目則加入中途操作物件的能力,例如拾取、搬運、放置,令同一次 rollout 不只是在場景中行走。

這個項目想處理兩個核心問題:一是缺少高質素的人與物件互動數據,二是模型容易忘記早前發生、但會影響之後物件狀態的關鍵畫面。為此,團隊建立了 100K interaction video dataset,並以 chain-of-thought reasoning 產生 per-chunk captions;同時提出 hierarchical action-aware memory 和 persistent memory bank,讓模型按互動重要性保留歷史資訊,減少 action-forgetting。

使用時,讀者可先從項目頁面的 Paper、Code、Video 和 Comparisons 了解能力範圍。從內容描述判斷,ActWorld 適合研究 Interactive World Model、Computer-use agents(CUAs)相關模擬環境、機械人互動、或需要長時序場景生成與控制的團隊參考。

  • 在單一模型內同時處理 long-horizon navigation 與 object interaction
  • 透過 100K interaction video dataset 補足互動數據不足
  • 用 hierarchical action-aware memory 保留較重要的互動歷史
  • 以 persistent memory bank 追蹤事件更新與物件身份

按頁面說明,實驗結果顯示它在不犧牲 viewpoint control 的情況下,interaction fidelity 明顯優於只做導航的 baseline。現階段公開資訊以研究展示為主,若想深入理解效果,最應留意 Comparisons 及論文中的評測設定與限制。

項目: https://interactwm.github.io/ActWorld/

Categories: 開源, 騰訊, Agentic, AI productions, 模型, 多模態模型, 世界模型, Video, Dataset 數據集

RhymeFlow:加快影片生成的新路線

RhymeFlow 針對影片生成太慢的老問題,提出免訓練加速方法。它不只追求更快,亦嘗試保住畫面連貫度。

Repository image for Simon-Dcs/RhymeFlow

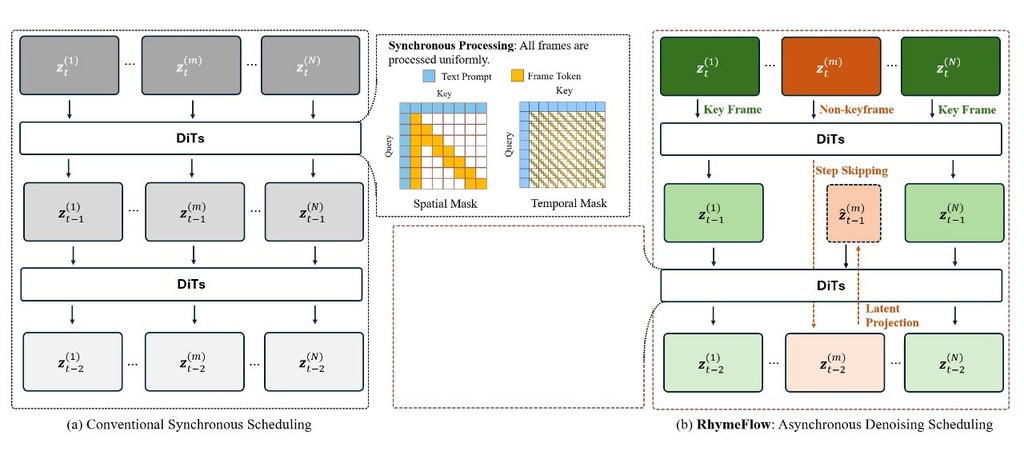
現時不少影片生成加速方法,主要仍沿用標準 diffusion pipeline:每一幀都要在所有 diffusion timesteps 完整做一次 dense denoising,再配合 sparse attention 或 KV-caching 減少單步計算。RhymeFlow 指出,這種固定範式忽略了相鄰影格內容與動作高度相關,令自然影片裡大量中間步驟其實屬於重複運算。

這是一個免訓練的影片生成加速框架,核心目標是替 DiT(Diffusion Transformers)影片模型減少推理延遲與運算成本。它將不同影格的 denoising trajectory 拆開處理:先找出主導語意變化的 keyframes,讓 keyframes 保持逐步去噪,非 keyframes 則逐步跳過部分步驟,再用 latent trajectory projection 補回時間一致性。

這個做法的創新,不在於單純把 attention 再稀疏化,而是直接挑戰「所有影格都要同步、密集去噪」的舊假設。論文描述,RhymeFlow 在現有 DiT-based video generation models 上,能同時取得更高 inference speed 與更好 visual quality;不過 GitHub 目前公開重點放在 Wan 2.1 adaptation,HunyuanVideo adaptation 仍在準備中。

如果你想試,較合理的切入點是把它當成 Wan 2.1 的加速實驗框架,比較 dense、svg、sap、rhyme、rhyme_sap 幾種方法輸出時間與畫面差異。環境要求偏高,文件列出 CUDA 12.4 / 12.8 與 PyTorch 2.5.1 / 2.6.0,亦牽涉 FlashInfer、flash-attn 和自訂 kernels,較適合已有 GPU 與 PyTorch 經驗的人。

  • 項目類型:training-free 影片生成加速框架,處理 DiT 影片模型推理太慢的問題
  • 方法重點:keyframes 做 dense denoising,非 keyframes 跳步處理,再用 latent trajectory projection 維持時序一致
  • 可比較方法:dense、svg、sap、rhyme、rhyme_sap
  • 相關模型:Wan 2.1 已有 adaptation,HunyuanVideo adaptation 尚未完整釋出
  • 適合場景:研究影片生成推理優化、比較不同加速策略、測試速度與畫質取捨

整體來看,RhymeFlow 的價值很明確:它不是改模型權重,也不是重新訓練,而是重排 denoising flow scheduling,從流程層面節省計算。對研究者與進階開發者而言,這類思路比單純堆硬件更有參考價值;對一般創作者來說,現階段門檻仍在部署與 GPU 環境。

GitHub: https://github.com/Simon-Dcs/RhymeFlow

Paper: https://arxiv.org/pdf/2606.06309

Categories: 開源, 清華大學, 騰訊, AI productions, 視頻模型, 模型訓練, NVIDIA, Video, 框架, Content Creator, Python, 深度學習

Page 2 of 4
1 2 3 4