Artifact-Bench:幫你看穿 AI 影片破綻

這個項目不只問模型看懂影片內容,還進一步測試它能否分辨 AI 生成影片的細微破綻。對研究影片真實感判斷尤其有參考價值。

teaser

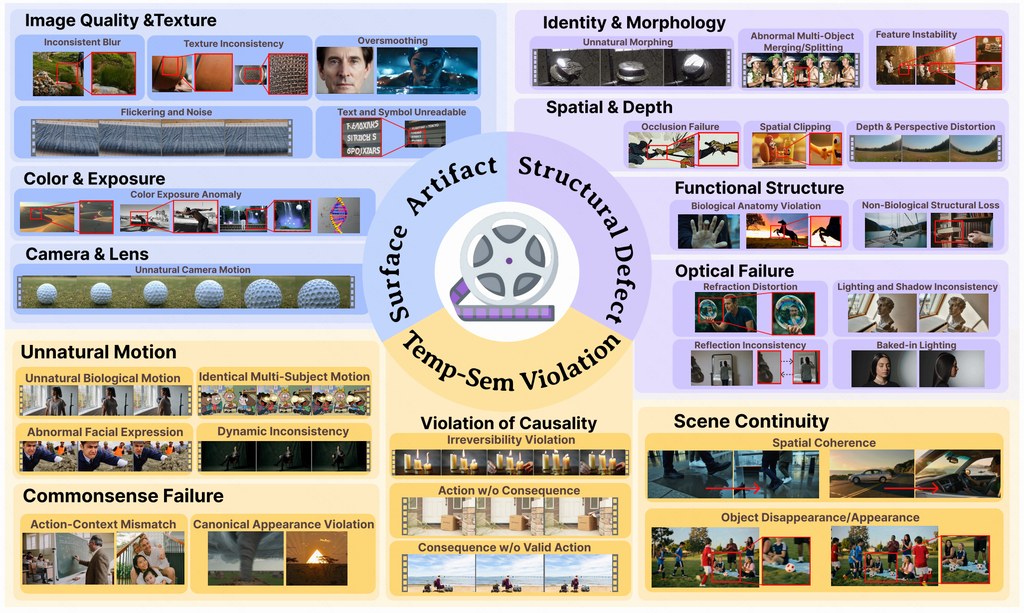
近年 AI 生成影片愈來愈像真,但「似真」不等於毫無破綻。Artifact-Bench 這個項目,重點就是評估多模態大語言模型是否真的看得出 AI 影片中的不自然痕跡,而不只是大概明白畫面講甚麼。

它把測試分成三類:分辨真影片與 AI 影片、比較兩段影片哪段更真實,以及指出影片中可能出現的瑕疵位置或類型。這種設計比一般只看語意理解的評測更細緻,因為它直接針對「真實感」與「畫面破綻」做分析。

動手使用這個項目時,先要準備對應的影片資料集,再按照三個任務的 metadata 檔組織輸入。儲存庫亦提供了針對 Qwen3-VL 的評估流程,並支援選擇指定任務、控制輸出長度,以及用多張 GPU 分工推理,對需要批量測試模型的人較方便。

  • 重點不在影片內容摘要,而在辨認 AI 生成痕跡
  • 包含三種評測角度,覆蓋分類、比較與瑕疵辨識
  • 已提供任務 metadata,較容易整理測試流程
  • 內建 Qwen3-VL 評估管線,亦可作為其他模型的參考框架

這個項目特別適合做影片生成、模型評測、內容審核與研究真實感判斷的人參考。從儲存庫資訊可見,現成流程主要圍繞 Qwen3-VL;相關模型範疇則可延伸到多模態大語言模型,例如不同尺寸或版本的 Qwen3-VL。若你關心模型是否只是「識圖識片」,還是真的能講出哪裡假,這個項目有相當清晰的測試價值。
GitHub: https://github.com/FrankYang-17/Artifact-Bench

Categories: 開源, 香港科技大學, 框架

KVPO 點樣提升影片生成對齊

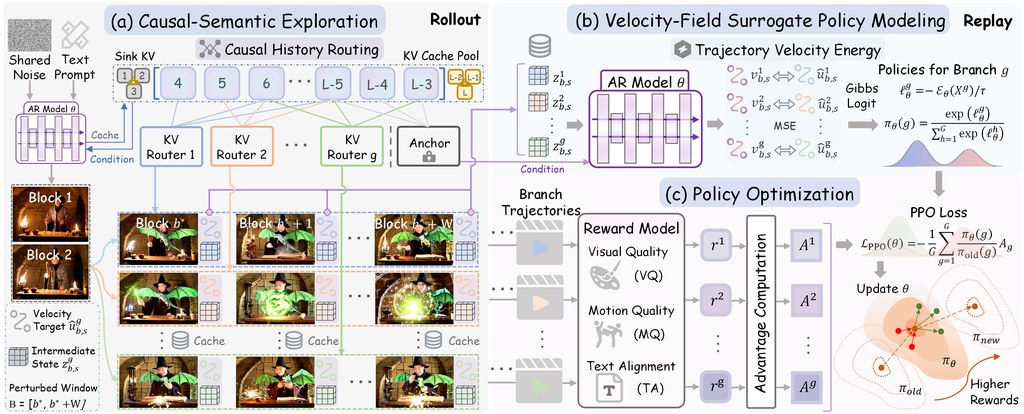
KVPO聚焦自動回歸影片生成訓練,嘗試令結果更貼近提示內容。重點在於用分支探索加獎勵學習,改善畫面走向。

KVPO

KVPO 係一個針對影片生成訓練流程嘅研究型專案,焦點唔係單純「生成到片」,而係令模型喺逐格、逐段生成嘅過程中,更穩定咁貼近文字提示同預期內容。對一般讀者嚟講,可以理解成:佢想改善 AI 影片成日出現嘅「開頭啱、之後走樣」問題。

呢個方法特別之處,在於佢唔只睇最後條影片好唔好,而係會喺生成途中做多條候選路線探索,再用獎勵模型判斷邊條路線更值得學。README 提到佢結合咗類似 PPO 嘅強化學習更新,以及對生成軌跡嘅機率估計,目標係令自動回歸影片模型學得更準。

實際了解同試用呢個專案,會由查看論文、專案頁面同釋出權重開始,再按設定準備對應環境、模型權重同資料。由於文件列出咗 H200、CUDA 12.8、Wan2.1 backbone,以及 HPSv3、VideoReward 等元件,較適合已有 GPU 資源、熟悉深度學習訓練流程嘅讀者,而唔係即開即用型工具。

  • 主要處理影片生成中內容偏離提示、時間一致性變差等問題
  • 核心做法係先探索多個生成分支,再用獎勵分數引導學習
  • 研究重點放喺自動回歸影片模型,而唔係一般圖片生成
  • 文件顯示會配合 Wan2.1-T2V-1.3B 等 backbone 使用
  • 仲會涉及 HPSv3VideoReward 呢類評分或獎勵相關模型

整體而言,KVPO 比較適合關注影片生成訓練方法嘅研究者、工程師,或者想比較唔同對齊策略嘅團隊。對非技術用家,佢未必係直接拎嚟出片嘅方案;但作為觀察新一代影片模型點樣「學識跟指令」嘅方向,呢個專案幾有參考價值。

GitHub: https://github.com/Richard-Zhang-AI/KVPO

Paper: https://arxiv.org/pdf/2605.14278

Categories: 開源, 香港科技大學, 清華大學, 影像模型, 影像處理

CM-EVS:用更少視角看完整個場景

CM-EVS 用較少全景畫面覆蓋更多室內場景,重點在挑選視角而非盲目多拍。對做 3D 資料整理的人特別實用。

Repository image for Strange-animalss/CM-EVS

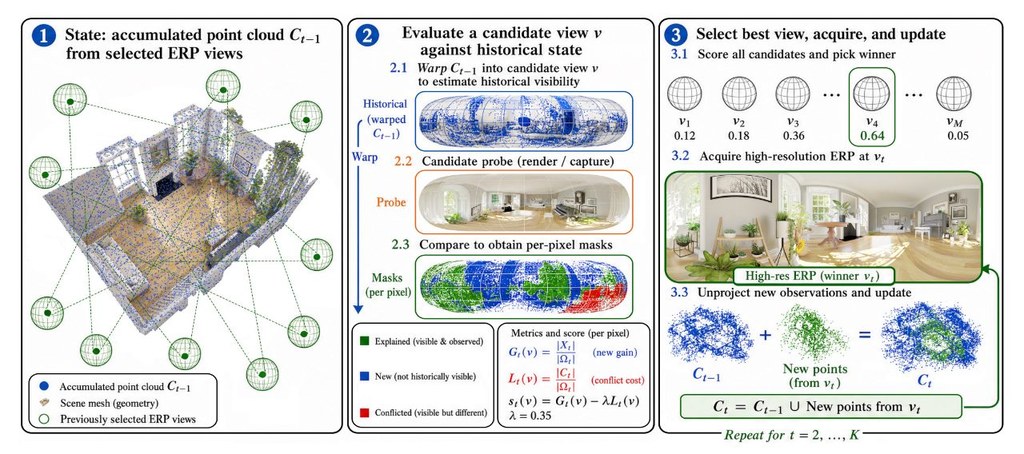
CM-EVS 係一個為 3D 場景整理全景 RGB、深度同姿態資料嘅流程工具,重點唔係不停輸出更多畫面,而係用較少但更有代表性嘅視角,盡量覆蓋完整場景。對需要建立訓練資料、檢查場景覆蓋度,或者整理室內空間視圖嘅工作,方向相當清晰。

實際使用時,較穩陣嘅做法係先由 Blender 室內場景路線開始,之後再按需要接 HM3D、一般 GLB 或 ScanNet++ PLY 這類來源。流程大致分成三步:先產生候選視角,再從中揀選衝突較低嘅視角組合,最後輸出已選畫面與相關記錄,方便重現結果同做後續核對。

呢個專案特別之處,在於佢唔單止計算「邊個視角睇到最多」,仲會考慮視角之間是否過分重疊,避免揀出一堆內容相似嘅畫面。對建立稀疏但有效嘅資料集尤其重要,因為畫面數量少啲,後續儲存、檢查同訓練成本通常都更易控制。

  • 支援統一資料格式,涵蓋 ERP RGB、range-depth 同 pose
  • 可處理多種來源,包括 Blender、HM3D/GLB、ScanNet++/PLY
  • 會輸出候選視角、逐步紀錄同已選結果,方便重做與比對
  • 核心模組拆分得較細,例如投影、深度與變形部分可獨立替換

適合對象包括做 3D 視覺、機械人感知、場景重建,或者要整理研究資料集嘅團隊。文中提到嘅相關資料來源與場景類型,主要有 Blender indoor、HM3D、generic GLB、ScanNet++,亦提及可延伸到戶外來源;不過從公開資訊睇,Blender 室內路線仍然係最建議先試嘅入口。

GitHub: https://github.com/Strange-animalss/CM-EVS

Paper: https://arxiv.org/pdf/2605.15597

Categories: 開源, 香港科技大學, 影像處理, 中國

EffOPD:助訓練模型流程更精明

EffOPD聚焦優化模型訓練中的測試與搜尋流程。對研究型開發者來說,這是一個偏實驗導向、但方向清晰的專案。

Repository image for caiyuchen-ustc/EffOPD

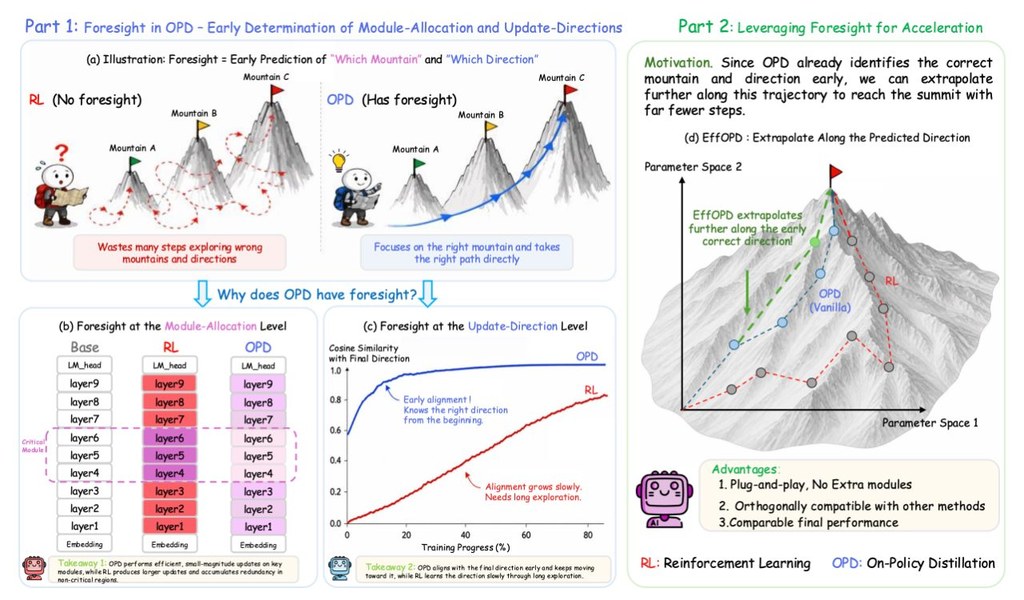
EffOPD 是一個圍繞模型訓練流程改良的研究實作,重點不在做一個全新聊天產品,而是在訓練途中更有效率地挑選值得評估的候選參數。從儲存庫資訊可見,它建基於 verl 與 GOPD,並調整訓練器與工作流程相關檔案,屬於偏底層的優化工具。

實際使用時,做法是沿用原本 OPD 的訓練流程,再加入迭代測試相關設定,並準備一份 parquet 格式的輕量驗證資料。這種安排的意思很直接:模型訓練到某些檢查點時,系統會額外評估幾個外推候選,而不是每次都用完整驗證流程,從而加快判斷。

專案想解決的,是大模型強化學習或蒸餾訓練中,評估成本高、嘗試路線多的問題。它較特別的地方,在於把「外推搜尋」和「即時輕量驗證」結合,讓訓練期間可以更早篩走不理想方向;儲存庫亦提到可設定每次最多測試 5 個候選,反映它著重效率與可控性之間的平衡。

  • 建基於 verlGOPD,較適合已有相關訓練基礎的人
  • 透過啟用迭代測試,在訓練中加入外推式候選搜尋
  • 使用 parquet 驗證檔建立輕量驗證集,減少即時評估負擔
  • 可調整每個檢查點評估的候選數量,預設實驗值為 5

適合主要作為研究實驗、訓練流程調校,以及想比較不同訓練決策成本的人。相關脈絡上,儲存庫明確提到 OPDGOPDEffOPD,而論文方向亦圍繞大型語言模型的強化學習動態與 on-policy distillation;對一般用家未必即插即用,但對做模型訓練研究的人有參考價值。

GitHub: https://github.com/caiyuchen-ustc/EffOPD

Paper: https://arxiv.org/pdf/2605.11739

Categories: 開源, 香港科技大學, 騰訊, 模型訓練

DepthVLM:識睇圖又識估距離

DepthVLM 想將影像理解同深度估算合二為一,兼顧速度與實用性。對想做 3D 視覺應用的人,幾值得留意。

DepthVLM Logo

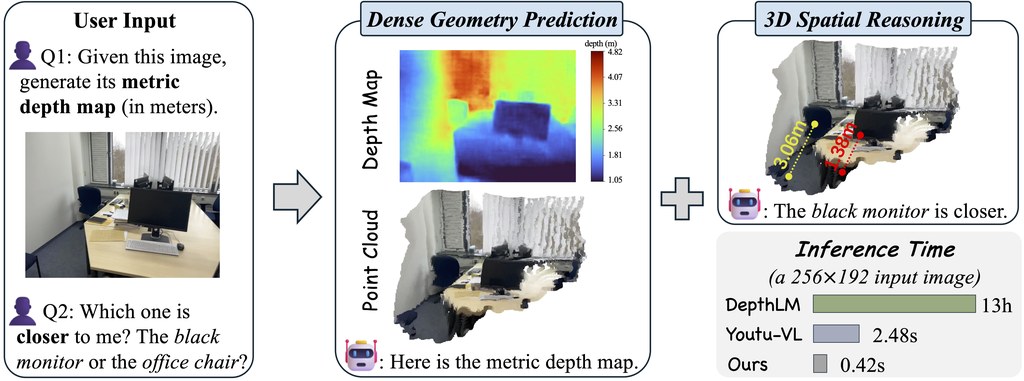
如果你曾經好奇電腦點樣由一張相片判斷物件有幾遠,DepthVLM 就係一個幾有代表性的答案。呢個專案主打由單張圖片直接輸出具實際尺度的深度資訊,同時保留問答、理解畫面內容等多模態能力,唔係只做單一視覺任務。

對一般開發者而言,上手方向算清晰:程式碼、模型權重同基準資料都已有公開入口,亦提供示例視覺化結果方便先睇效果。要留意資料本身受授權限制,作者未有直接派發整理後全集,但有公開資料整理流程,較適合願意自己重現訓練或評估的人。

佢較特別之處,在於唔需要將「睇圖理解」同「估深度」拆開做。論文資訊顯示,DepthVLM 會喺單次推理中同時產生深度圖與文字輸出,並以輕量模組接到語言模型骨幹上,速度亦比同類 VLM 方案如 DepthLMYoutu-VL 更快。

如果你做機械人、AR/VR、室內導航,或者想研究影像中的 3D 空間推理,呢類模型特別有價值。從公開內容看,相關比較對象包括 DepthLM-12BYoutu-VL-4BInternVL3.5-38B,以及偏純視覺路線的 Depth Anything V3UniDepth V2Metric3D v2Depth ProZoeDepth

  • 一個模型兼顧畫面理解與深度預測
  • 可輸出具米制尺度的稠密深度圖
  • 推理效率強調比部分現有 VLM 更快
  • 已提供範例、模型檔與基準標註入口
  • 較適合研究、實驗同進階應用整合

整體來講,DepthVLM 吸引之處唔單止係準確度,而係它試圖將 3D 感知正式帶入視覺語言模型工作流。若你想搵一個連接「識答問題」同「識判斷空間距離」的方案,呢個專案相當值得先收藏再深入試用。

網址: https://github.com/hanxunyu/DepthVLM

網址: https://arxiv.org/pdf/2605.15876

Categories: 開源, 香港科技大學, 騰訊, 視覺模型, 影像模型

NudgeRL:用更聰明方式訓練數學推理

NudgeRL嘗試用「策略提示」提升模型探索能力,減少單靠大量試錯的成本。對數學推理研究尤其值得留意。

Repository image for tally0818/NudgeRL

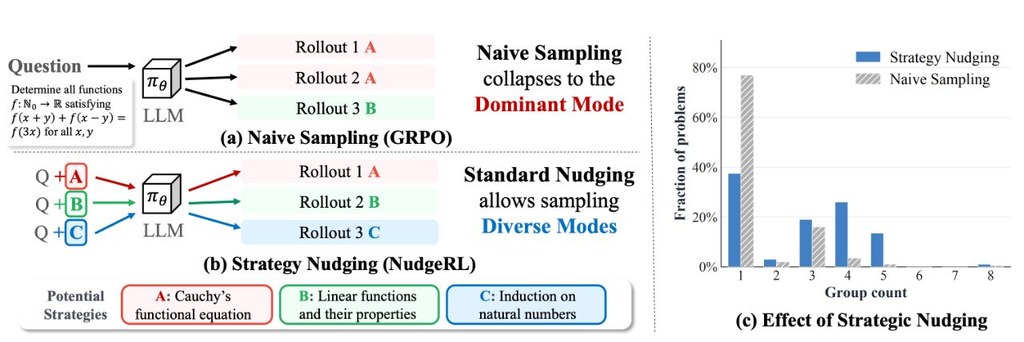
如果你有留意近年大語言模型點樣練習數學題,NudgeRL算係一個幾有方向感的研究型專案。佢主要針對一個常見問題:模型唔係唔努力,而係好多時只會喺自己熟悉的解題路線入面打轉,結果要靠大量重複抽樣先撞到更好答案。

NudgeRL的做法唔係一味加大運算量,而係先提供較輕量的「策略層面背景」,引導模型用唔同思路展開推理,再將當中有效的行為學返去原本模型。簡單講,即係先畀方向去探索,再將成功經驗整理吸收,呢點比純粹盲試更有系統。

實際上手方面,呢個儲存庫已經分好幾部分:資料建立、訓練基線、NudgeRL訓練,同埋評估流程。較適合本身已經會用 Python、PyTorch、CUDA 同 vLLM 的研究者;如果你係一般開發者,都可以先由評估腳本、資料格式同設定檔入手,理解整體流程先。

  • 針對數學推理中的探索不足,而唔係只求更大抽樣數量
  • 內置 GRPO 同 POPE 風格基線,方便比較方法差異
  • 提供 DAPO-Math-17k 相關資料建構工具,唔使由零砌流程
  • 評估涵蓋 AIME、AMC23、MATH500、Apex Shortlist 等數學基準
  • 核心特色係將多樣化策略探索同後續行為蒸餾結合

如果你想比較相關模型或訓練路線,呢個專案最直接涉及的包括以 GRPO 為代表的 RLVR 方法、POPE 風格 oracle-prefix 基線,以及可配合 Hugging Face 模型與 LoRA adapter 的訓練評估流程。整體而言,NudgeRL較適合做推理增強、數學能力研究、後訓練方法比較的人;對想了解「如何更有效探索」而唔係「如何堆更多算力」的讀者,尤其有參考價值。

網址: https://github.com/tally0818/NudgeRL

網址: https://arxiv.org/pdf/2605.15726

Categories: 開源, 香港中文大學, 模型訓練, 深度學習

DexJoCo:靈巧機械手模擬實驗入門

這個專案用 MuJoCo 建立靈巧操作模擬流程,亦照顧到示範收集與遙控操作。對研究機械手任務的人來說,方向相當清晰。

Repository image for brave-eai/dexjoco

DexJoCo 是一個以 MuJoCo 為基礎的模擬基準與工具集,重點放在「有目標的靈巧操作」:例如用機械手完成特定任務,而不只是做單一抓取動作。對初學者來說,它的價值在於把模擬環境、示範收集,以及遙控操作相關元件放在同一個專案內,較容易看清整體流程。

如果你想使用,先把它當成任務模擬平台,再了解示範資料如何被記錄。README 提到可輸出 Zarr 格式重播資料與相機影片,這表示它不只用來「睇畫面」,亦方便之後做訓練、重播或比較不同方法表現。

它較有意思的地方,是把遙控操作設計成依賴明確的 UDP 封包協定。換句話說,模擬器本身與外部裝置之間有一定解耦,無論是 Vive tracker、Rokoko,甚至內含的 GeoRT 流程,都較像可替換的輸入橋樑,令擴充與整合更實際。

  • 以 MuJoCo 為核心,集中處理靈巧操作任務
  • 支援示範收集,並輸出重播資料及影片
  • 內建多種遙控相關橋接元件,方便接駁外部追蹤資料
  • 可切換互動模式與較適合策略執行的無畫面模式

適合的讀者主要是機械人研究者、學生,或者想測試手部操作任務的人;如果你正研究 imitation learning、policy evaluation,這類資料輸出會特別有用。從專案內容可見的相關組件包括 MuJoCo、Vive bridge、Rokoko、GeoRT,以及用於資料儲存的 Zarr;至於 README 亦提到 policy mode 與離屏渲染設定,反映它同時兼顧互動收集與批次實驗兩種場景。

整體來看,DexJoCo 未必是面向一般用家的即開即用工具,但作為研究型基礎設施,它的定位相當清楚。若你需要一個把任務模擬、遙控輸入和示範記錄串連起來的環境,這個專案值得留意。

網址: https://github.com/brave-eai/dexjoco

Categories: 開源, 香港中文大學, 世界模型, Robotic

SU-01:數理推理模型的新示範

SU-01主打奧數級數理推理,重點不在花巧工具,而是把推理流程練得更紮實。對關心AI解題能力的人來說,值得留意。

SU-01 training and inference pipeline

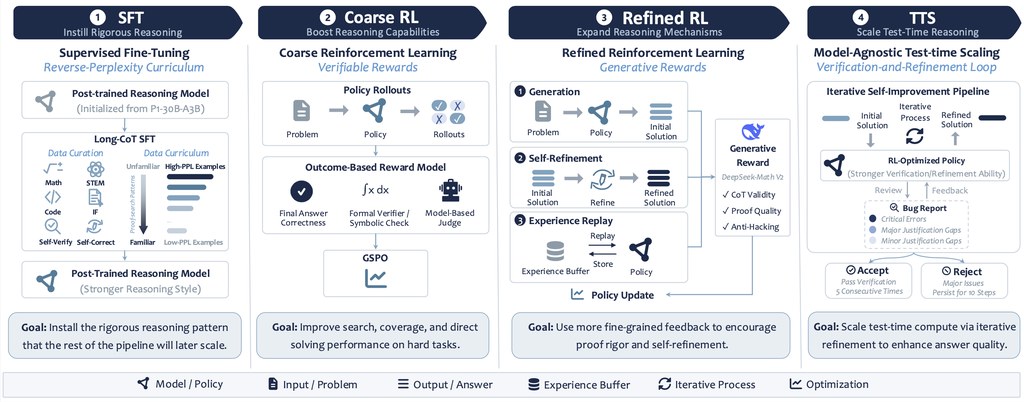
如果你對「AI識答數學題」有興趣,SU-01是一個幾有代表性的案例。它是一個 30B-A3B 推理模型,目標不是單靠背答案,而是嘗試完成較長步驟、較講求證明結構的數學與科學題目,尤其接近競賽題風格。

對一般讀者而言,最易理解的用法,是把它當成一個專注於複雜解題的模型來看,而不是萬能聊天機械人。官方資訊顯示,模型已公開權重,亦有技術報告與專案頁面;如果你本身會用 Hugging Face 一類平台,就可以進一步了解它的輸出表現與測試方式。

SU-01較特別的地方,在於它不依賴外部工具、寫程式執行,或者專門符號求解器,仍然想把長鏈條推理做好。訓練上,它用了較有策略的資料排序方式,以及分兩階段強化學習,先追求可驗證答案,再逐步改善證明質素,這點對處理多步驟題目尤其重要。

  • 重點放在數學、物理等需要嚴謹步驟的解題
  • 嘗試處理長篇推理與證明修正,而非只輸出最終答案
  • 在 IMO 2025(第66屆國際數學奧林匹亞)、USAMO 2026(美國數學奧林匹亞)、IPhO 2024/2025 有高水準成績
  • 相關模型可留意同類推理系統,例如 DeepSeek-R1、OpenAI o1 類型模型,以及其他數理導向大型語言模型

如果你是研究員、教育科技開發者,或者想比較不同推理模型在高難度題目的差異,SU-01很值得觀察。對一般學生來說,它未必是即開即用的溫習工具,但作為理解 AI 如何由「識答題」走向「識證明」的例子,參考價值相當高。

整體來看,SU-01吸引之處不只在分數,而是在方法上走一條相對簡潔統一的路線。從公開資料判斷,它更像是一個展示「後訓練如何提升嚴謹推理」的研究型專案,適合關心 AI 推理上限的人細看。

網址: https://github.com/Simplified-Reasoning/SU-01

Categories: 開源, 香港中文大學, 模型, 深度學習, 中國

AlphaGRPO:能自我修正的多模態生成

呢個框架針對文字生圖與編輯任務,加入可驗證回饋,提升推理同自我修正能力。

Og image

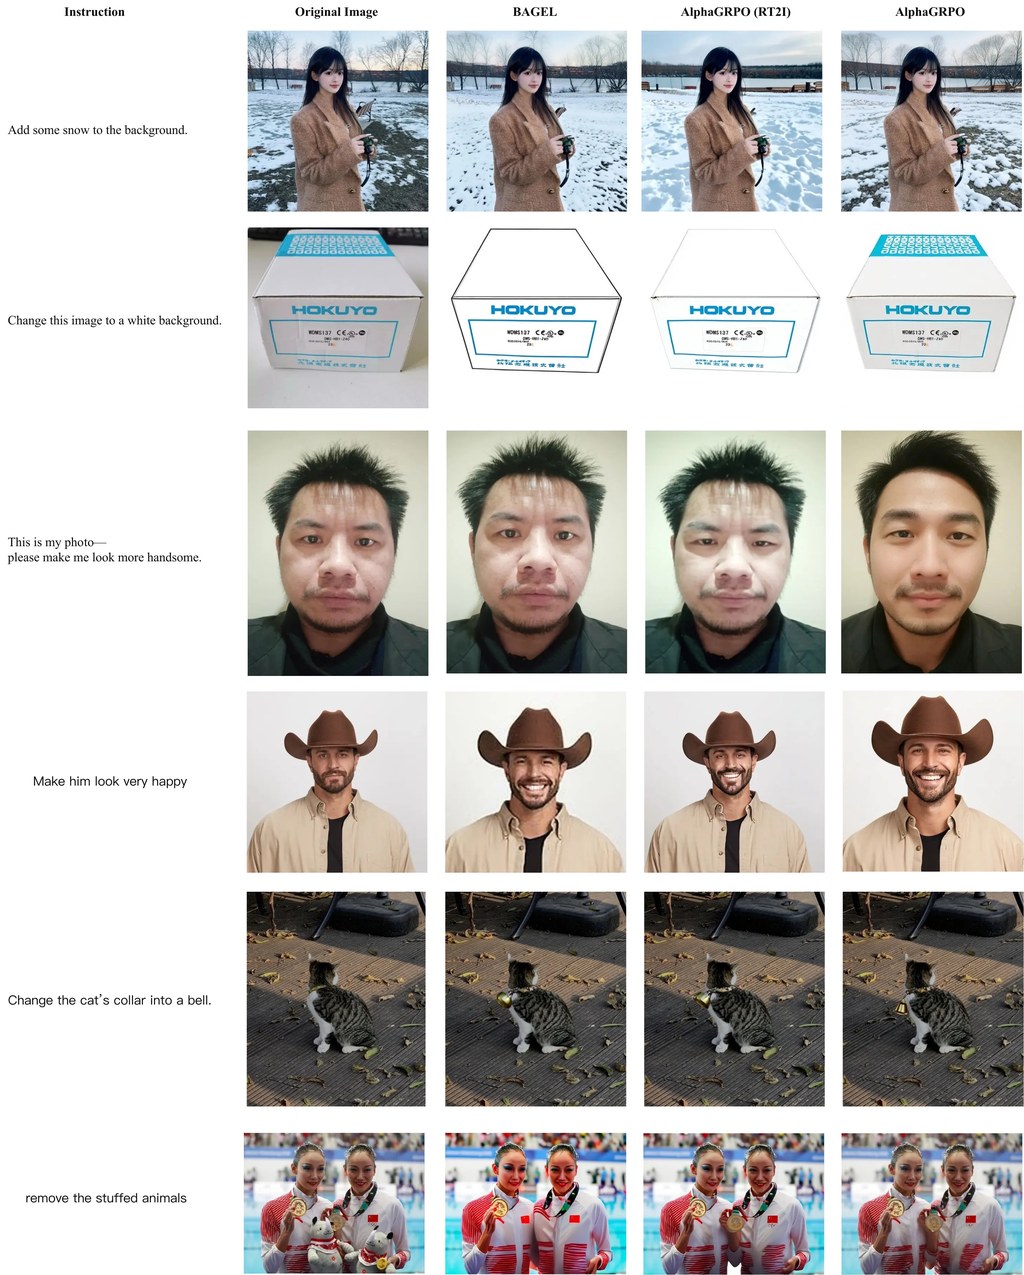
AlphaGRPO 係一個用喺原生統一多模態模型嘅訓練框架,重點係令模型唔只係「生成」,而係會根據提示主動推理,並喺輸出有偏差時嘗試自行修正。網頁內容指出,佢主要面向文字生圖同相關編輯場景,目標係改善細節理解、構圖一致性,同埋對隱含要求嘅掌握。

呢個方法特別之處,在於將 GRPO 引入 AR-Diffusion 類型嘅統一模型,而且唔需要額外 cold-start 階段。另一個核心設計係 DVReward:先將複雜指令拆成多個可核實嘅細問題,再由開源多模態模型按語意對齊同畫面品質提供較穩定、可解釋嘅回饋,避免只靠單一分數太過籠統。

如果你想理解點樣使用,概念上可以當佢係一種訓練或強化現有多模態生成模型嘅方法,而唔係一般終端用家即開即用嘅 App。較適合研究人員、模型工程師,或者需要改善文字生圖、細粒度屬性控制、影像編輯泛化能力嘅團隊參考同實作。

  • 支援推理型文字生圖,能更主動補足用家未明講嘅意圖
  • 可做自我反思式修正,生成後再檢查並調整錯配內容
  • 回饋機制較細緻,將要求拆解成可驗證項目再評估
  • 在多個生成基準上有一致進步,亦可遷移到編輯任務
  • 推論階段加入自我修正後,文中指最高可再提升 5.8%

就評估結果而言,頁面提到 AlphaGRPO 喺 GenEval、TIIF-Bench、DPG-Bench、WISE 等生成基準,以及 GEdit 編輯任務都有提升,而且編輯能力並非靠專門編輯訓練得來,反映泛化表現不俗。不過,具體效果仍應按模型底座、評測設定同實際資料而定。

訓練程式碼和模型權重目前正在進行內部審核,審核通過後將予以發布。

網址: https://huangrh99.github.io/AlphaGRPO/

Categories: 開源, 香港大學, 字節跳動, 影像模型, 影像處理, 框架

ODE點樣訓練識睇圖又識搜尋的AI代理

ODE 針對多模態搜尋代理而設,重點不只係答問題,而係學識用圖像、網頁同工具逐步找證據。

main full

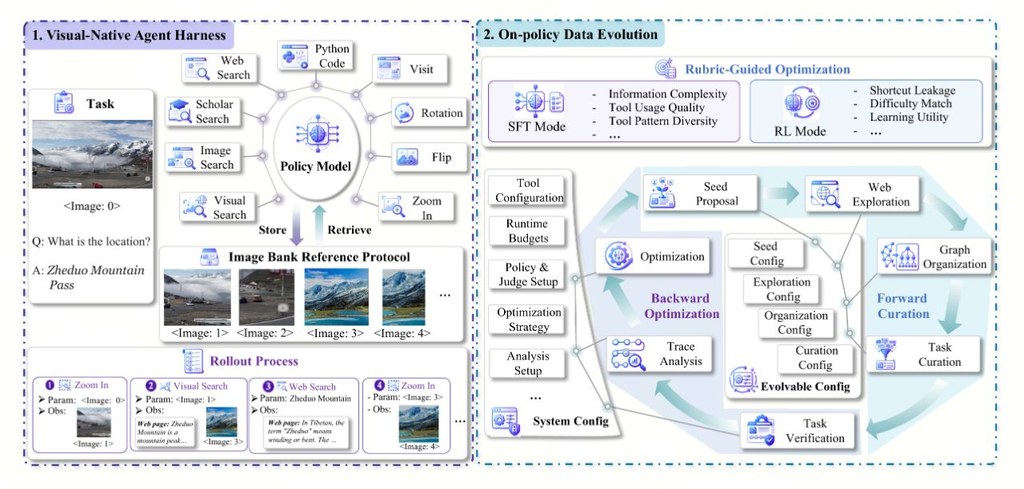
如果你對「會自己搵資料的 AI」有興趣,ODE 係一個幾值得留意的研究型專案。它唔係單純訓練模型直接輸出答案,而係讓代理按步驟去搜尋網頁、找圖片、查看學術結果,甚至對圖片放大、旋轉或翻轉,再整理證據作判斷。

對初學者來講,可以先將它理解為一個「工具操作訓練場」。專案目前已提供訓練程式、評估環境同公開工具整合,重點係同一套流程可同時用於測試與強化學習;不過自動化資料演化部分現時似乎仍在逐步補完。

它想解決的核心問題,是傳統靜態訓練資料未必足夠教到代理點樣靈活使用工具。ODE 的做法,是先用監督式訓練教基本動作格式,再用強化學習讓代理在真實互動中調整策略,之後分析操作軌跡,找出行為缺口,再回頭改善下一輪訓練資料。

比較特別的是,它把中途見過的圖片保存成可重用參照,之後可以再裁切、檢視或做視覺搜尋,唔使每次由零開始。這種設計對需要圖文交叉查證的任務尤其重要,亦比只靠文字搜尋的代理更貼近真實使用情境。

  • 支援多種工具流程:網頁搜尋、圖片搜尋、學術搜尋、瀏覽頁面、視覺搜尋與本地圖片操作
  • 著重保留中間圖像證據,方便後續步驟重用
  • 訓練方式結合 SFTRL,並用操作紀錄反推資料改進方向
  • 已展示在 Qwen3-VL-8BQwen3-VL-30B 這類視覺語言模型上的提升

如果你本身做 AI 代理、檢索增強系統,或者關心模型如何可靠地「邊找邊想」,這個專案會有參考價值。對一般讀者而言,它亦提供了一個清楚例子:未來較實用的 AI,未必只係更大模型,而係更懂得在圖像與文字之間有條理地找證據。

網址: https://github.com/JoeYing1019/ODE

網址: https://on-policy-data-evolution.github.io/

Categories: 開源, 香港科技大學, Agentic, 框架

Page 10 of 15
1 8 9 10 11 12 15