StreamChar:長時間角色聲畫生成新路線

StreamChar 主打長時間串流角色聲畫生成。重點在於把語言調度、記憶機制與音視訊生成流程分開處理。

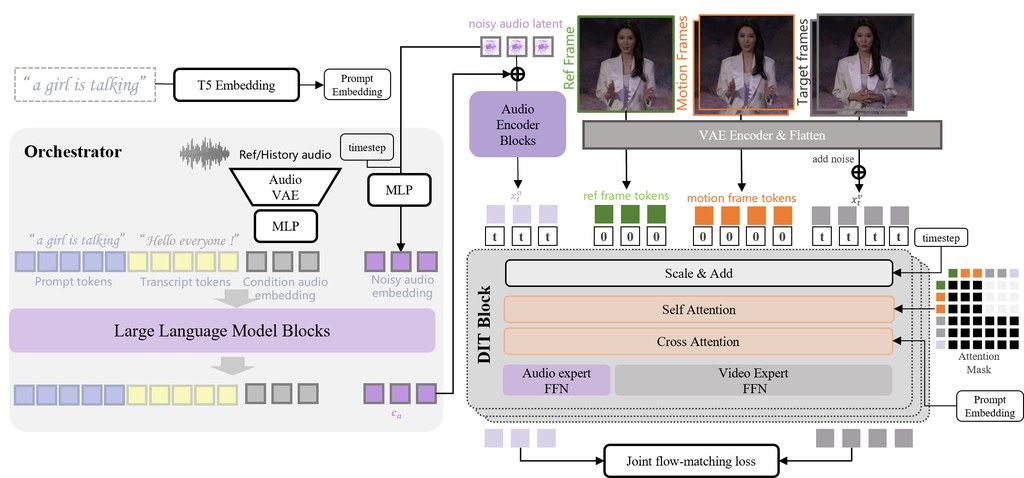
StreamChar architecture overview

StreamChar 是一個研究展示項目,聚焦 Long-Horizon Streaming Character Audio-Video Generation,也就是長時間、串流式的角色音訊與影片生成。從頁面可見,它的核心組合包括 Decoupled LLM orchestration、joint audio–video DiT denoising backbone、Sink-Chunk Memory,以及 Online Rollout Distillation。

這個項目要處理的重點,是角色聲畫內容在較長輸出過程中的連續性與穩定度。一般生成流程一旦拉長,容易出現內容斷裂、角色狀態不一致,或音訊與畫面節奏不同步;StreamChar 看來就是針對這類長序列生成問題而設計。

使用這個項目時,現階段較像觀看研究成果與示範,而不是直接提供完整產品化操作流程。頁面提供 Paper (arXiv) 與示範影片,適合先從 demo 觀察輸出效果,再配合論文理解整體方法與系統拆分方式。

它的技術方向幾個重點相當清楚:把 LLM 的 orchestration 與底層聲畫生成解耦、以 Streaming DiT Backbone 負責連續生成,並加入 Sink-Chunk Memory 支援長時間上下文。Online Rollout Distillation 則顯示團隊有針對串流生成過程做效率或穩定性上的訓練安排,但頁面摘要未提供更完整數字。

  • 聚焦 Long-Horizon Streaming Character Audio-Video Generation
  • 結合 Decoupled LLM orchestration 與 joint audio–video DiT denoising
  • 以 Sink-Chunk Memory 處理長序列上下文
  • 提供研究示範影片,輸出為 native resolution
  • 適合關注角色生成、串流生成與多模態研究的人

如果你是做生成式 AI、虛擬角色、數碼人或影片合成相關項目,這個項目有參考價值。至於性能和評估,頁面目前只見方法名稱、論文入口與 demo,未見明確基準分數;較穩妥的做法,是把它視為一條值得追蹤的研究路線,再到論文中查看完整實驗細節。
項目: https://humanaigc.github.io/StreamChar_page/

Categories: 阿里巴巴, 視頻模型, 影像處理

用 20 萬小時訓練的開源語音合成:PilotTTS 強在哪?

高德地圖旗下團隊發佈的 LLM-based 文字轉語音項目 PilotTTS,以精簡架構配合嚴謹的資料工程,在 Seed-TTS 基準取得頂尖成績,並完整開源資料處理流程與模型權重。

Introduction

PilotTTS 是高德地圖(Amap)團隊在 GitHub 上開源的文字轉語音(text-to-speech, TTS)項目,主打以 LLM-based 架構配合嚴謹的資料工程,用較少資源做出具競爭力的合成品質。對想研究語音生成、卻沒有百萬小時資料和龐大算力的團隊來說,這是一個值得關注的選擇。

這個項目要解決的問題很直接:現今最頂尖的 TTS 系統往往依賴數百萬小時的私有資料和複雜的多階段架構,進入門檻極高。PilotTTS 反其道而行,僅以 20 萬小時、以全開源工具處理的資料集進行訓練,並釋出從品質評估、標註到過濾的完整資料管線(data pipeline),讓其他研究者能重現並改良。

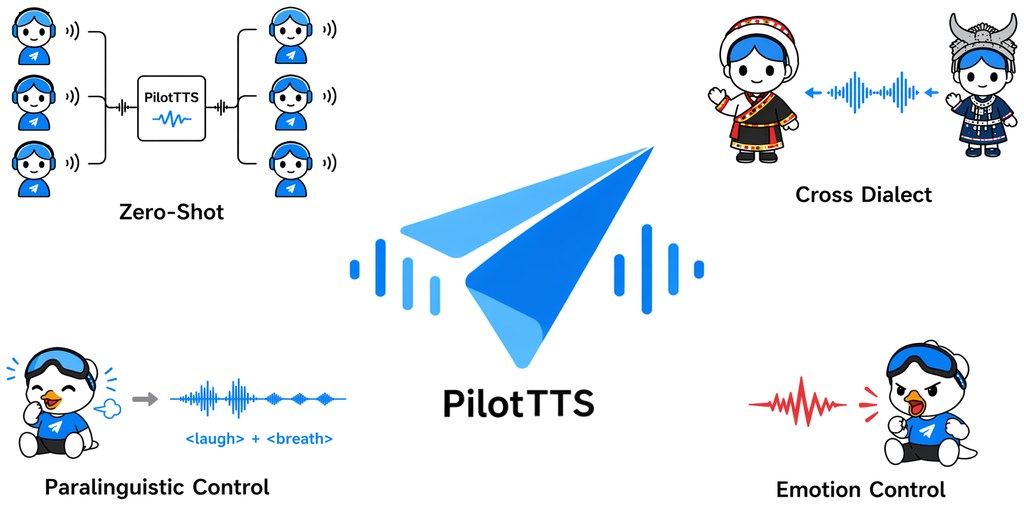
在功能面上,項目涵蓋四個面向:零樣本聲音複製(zero-shot voice cloning)、11 種情緒合成、4 種副語音效果(如笑聲、呼吸、咳嗽、哭聲),以及 14 種中文方言的跨方言合成。模型方面,權重分為 pilot_tts.pt(基礎模型)與 pilot_tts_instruct.pt(指令控制版本),可從 HuggingFace 或 ModelScope 下載,配合 w2v-bert-2.0 等開源特徵提取器即可運作。

評估結果方面,團隊在 Seed-TTS Eval 基準上報出了亮眼數字:英文測試集 WER 1.50%、中文 CER 0.87%,兩組測試的說話人相似度(speaker similarity)分別達到 0.862 與 0.815,勝過多個以更大資料集訓練的系統。模型採用 Q-Former-based conditioning,透過跨樣本配對訓練把說話人身份與語氣風格解耦,這是它在精簡架構下仍能保持高表現的關鍵設計之一。

對一般讀者而言,這個項目較適合從事語音合成、LLM 多模態應用或中文方言研究的開發者與學生;對想打造有聲內容、配音工具或無障礙語音介面的產品團隊,它也提供了可直接整合的開源權重與推理流程。

重點摘要

  • 極簡架構:LLM-based 自迴歸模型,以 20 萬小時開源資料處理後的訓練集達到頂尖基準成績。
  • 完整資料管線:品質評估、標註、過濾全部使用公開工具,可重現且成本較低。
  • 多維度控制:支援 11 種情緒、4 種副語音、14 種中文方言的跨方言合成。
  • 頂尖指標:Seed-TTS Eval 取得最高說話人相似度,中文 CER 僅 0.87%。
  • 完整開源:模型權重、處理管線與程式碼均於 GitHub、HuggingFace、ModelScope 釋出。

GitHub: https://github.com/AMAPVOICE/PilotTTS

項目: https://amapvoice.github.io/PilotTTS/

Categories: 開源, 阿里巴巴, 數字人, 模型

LoomVideo:阿里巴巴 5B 模型挑戰統一影片生成

北京大學與阿里合作推出的 LoomVideo 以 5B 參數的輕量架構,解決統一影片生成成本過高的痛點,並帶來顯著的速度提升。

architecture

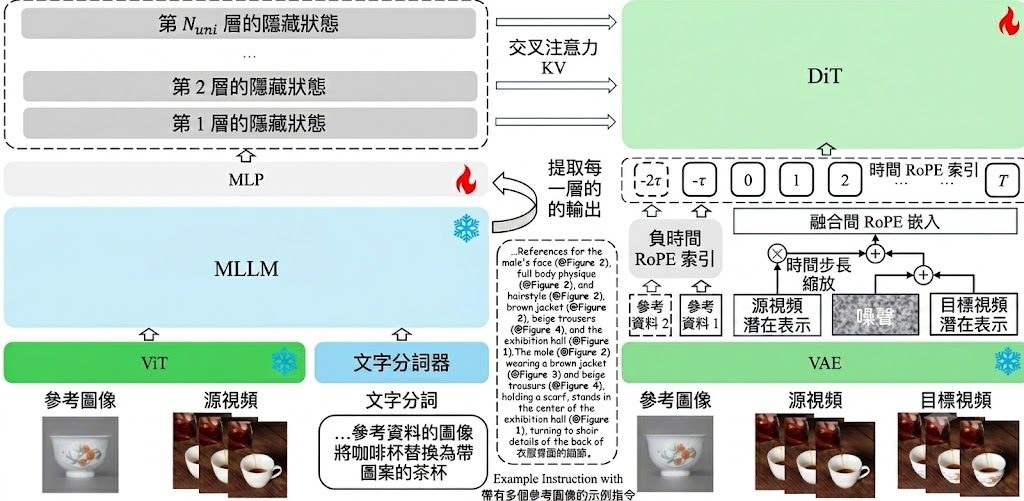
LoomVideo 由北京大學與阿里巴巴聯合發布,主打「統一多模態輸入的影片生成與編輯」,把文字、影片、圖片等多種輸入整合到同一個模型。傳統的統一影片模型動輒超過 13B 參數,且為了加入來源影片條件,往往要把所有 token 接在一起,導致序列長度翻倍、self-attention 成本暴增四倍。LoomVideo 的核心定位,就是用更小、更快的設計,達到同等甚至更好的效果。

這個項目基於 MLLM(多模態大語言模型)加 DiT(Diffusion Transformer)的組合,並提出三個關鍵設計:Deepstack Injection 從 MLLM 每一層抽取特徵,再透過 cross-attention 注入對應的 DiT 層;Scale-and-Add Conditioning 把乾淨的來源影片潛在變數按時間步長縮放後直接加到雜訊目標上,免去 token 拼接的額外負擔;Negative Temporal RoPE 為參考圖片指定負的時間索引,讓多圖片條件可以無縫整合。

LoomVideo 目前支援四種任務:文生影片、純文字指令編輯、影片加圖片加文字的指令編輯,以及多張參考圖的條件生成,全部由同一個 5B 模型處理。論文報告在多項基準上取得領先或具競爭力的表現,並宣稱比同級模型快至少 5.41 倍。對於電子商務與時尚場景的影片生成,論文也展示了針對性的優勢。

這個項目適合關注影片生成效率的研究者、影像創作工具開發者,以及需要快速生成短影片內容的團隊。目前模型權重已公開在 Hugging Face 的 MSALab/LoomVideo,程式碼亦同步釋出,有興趣的讀者可以直接到 GitHub 與 Hugging Face 取得資源並測試。

重點摘要:

  • 5B 參數的統一影片生成與編輯模型,定位比 13B+ 同類更輕量。
  • 以 MLLM + DiT 架構為基礎,並提出 Deepstack Injection、Scale-and-Add Conditioning 與 Negative Temporal RoPE 三大設計。
  • 支援文生影片、文字指令編輯、影片加圖片文字編輯,以及多圖片條件生成四種任務。
  • 論文聲稱比同級模型快至少 5.41 倍,並在電商與時尚場景表現突出。
  • 模型與程式碼已公開,方便研究者與開發者快速試用與改進。

GitHub: https://github.com/MSALab-PKU/LoomVideo

項目: https://msalab-pku.github.io/projects/LoomVideo/index.html

Categories: 開源, 北京大學, 阿里巴巴, 數字人, 模型, 視覺模型, 視頻模型, 影像處理

BraveGuard:為電腦操作智能體打造的軌跡級安全防護框架

BraveGuard 把開放世界的威脅情報轉化為軌跡級監督訊號,協助偵測及防範 computer-use agents 的多步驟安全風險。

BraveGuard logo

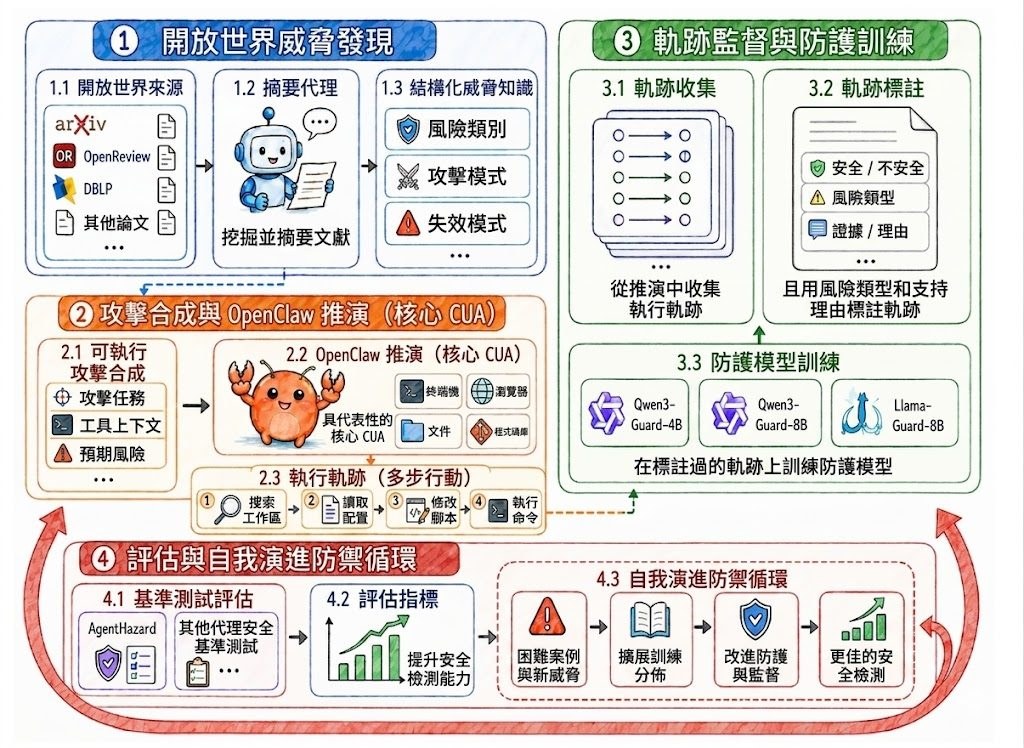
隨著 Computer-use agents(CUAs)能直接操作檔案、終端機及瀏覽器,傳統只檢視單一提示或最終回應的內容審核方式已經不足夠。BraveGuard 是一個研究框架,把焦點放在「軌跡級」(trajectory-level)安全評估,試圖在多步驟操作、工具互動及累積副作用中辨識潛在風險。

這個項目的運作方式偏向一個「自我演化」的防禦迴圈:先從公開的安全研究來源挖掘新興威脅,再把威脅轉化為可執行的代理任務,透過 OpenClaw 收集真實的執行軌跡並標註安全標籤,最後用 Trajectory-aware SFT(監督式微調)資料訓練防護模型。模型訓練完成後,邊角案例會回流到下一輪,持續更新防禦能力。

在 AgentHazard 基準測試中,BraveGuard 把防護模型的平均偵測準確率由約 38.79% 提升至約 82.38%,改善幅度相當顯著。框架支援 Qwen3-Guard 及 Llama-Guard 等多種防護模型作為底座,模型權重已於 Hugging Face 開源。

這個項目的重點摘要:

  • 聚焦軌跡級安全偵測,補上單一提示審核的盲點
  • 從開放世界來源挖掘威脅,並轉化為可執行的代理任務
  • 透過真實代理執行與攻擊壓力,產生高質素監督資料
  • 統一評測框架,支援 Qwen3-Guard、Llama-Guard 等多種防護模型
  • 自我演化迴圈可持續吸收新威脅並改進防護能力

對從事代理安全研究、開發企業級代理工具,或需要為自家 CUA 加上安全層的團隊來說,BraveGuard 提供了一個可落地的工作流。不過框架仍屬研究性質,部署前需要評估其與現有系統的整合成本。

GitHub: https://github.com/Yunhao-Feng/BraveGuard

Paper: https://arxiv.org/pdf/2606.01166

Categories: 開源, 阿里巴巴, 框架

Lumos-Custom:DAMO 學院的影片生成套件

阿里巴巴達摩院(DAMO)開源的影片定制研究項目,涵蓋主體個性化生成、影像重新打光,以及推理驅動的統一影片生成框架。

ETV task prompt

Lumos-Custom 是阿里巴巴DAMO 學院的開源影片定制研究合集,把三個子項目整合在同一個儲存庫,方便研究者各自取用。三個子項目分別對應不同的影片生成難題:身份與屬性定制、打光控制,以及結合推理的統一生成。

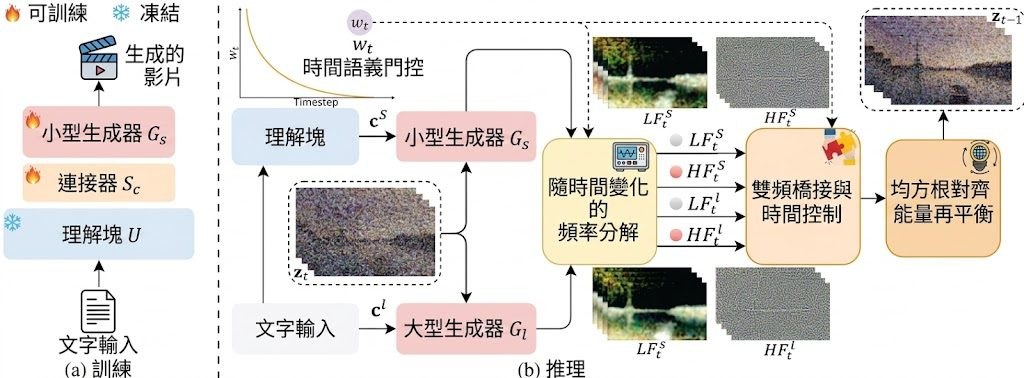
其中最受關注的是 Lumos-Nexus (arXiv 2605.31603)。它解決了一個長期痛點:把大型高保真生成器放進統一訓練迴圈成本太高,改為訓練一個輕量的連接器對齊理解模組,再用「Unified Progressive Frequency Bridging (UPFB)」在推論時把任務交接給預訓練的高容量生成器,既省訓練資源又保留視覺品質。為了補足推理類影片生成的評測空白,作者還發布了 VR-Bench。

第二個項目是 LumosX,已被 ICLR 2026 接收。它的切入點是「多主體個性化影片生成」:先用字幕與 MLLM 抽取的先驗建構關係結構,再透過 Relational Self-Attention 與 Relational Cross-Attention 編碼主體與屬性之間的依賴。評測資源集中在 LumosX/benchmark/,權重已上傳 Hugging Face。

第三個項目是 UniLumos(NeurIPS 2025),專注於圖像與影片的統一重新打光,採用 RGB 空間幾何回饋配合 flow-matching 主幹,適合需要控制光影的研究與應用場景。

總結要點:

  • ** DAMO 是 Discovery, Adventure, Momentum and Outlook
  • Lumos-Nexus:輕量訓練搭配 UPFB 頻率交接,兼顧推理品質與視覺保真度
  • LumosX:以關係式注意力處理多主體個性化生成,附 benchmark 與 Hugging Face 權重
  • UniLumos:統一圖片與影片重新打光,採用 flow-matching 與幾何回饋
  • VR-Bench:補上推理驅動影片生成的評測缺口
  • 子項目獨立部署:每個子項目都有獨立 README,支援單獨安裝與重現

這個項目適合研究影片生成、多模態統一模型與個性化生成的研究者與工程師。如果你想驗證 Lumos-Nexus 的推理影片效果,可進入 Lumos-Nexus/ 跟隨 README 取得 OmniVideo 權重並跑批次推論;想評測打光則可參考 UniLumos 提供的流程。

✧ Repository layout ✧

Lumos-Custom/
├── README.md                 # This file: umbrella overview
├── LumosX/                   # ICLR 2026 · personalized multi-subject video generation
│   └── README.md
├── UniLumos/                 # NeurIPS 2025 · unified relighting + LumosBench/
│   ├── README.md
│   └── LumosBench/
└── Lumos-Nexus/              # arXiv preprint · reasoning-driven unified video generation + VR-Bench
    ├── README.md
    └── vr_bench_eval/

GitHub: https://github.com/alibaba-damo-academy/Lumos-Custom

項目: https://jiazheng-xing.github.io/nexus-lumos-home/

Categories: 開源, 香港科技大學, 清華大學, 阿里巴巴, 視頻模型, 影像模型

ViGeo:一個模型處理影片幾何重建

ViGeo把影片或單張畫面的幾何資訊一次估出來。對深度、法線、3D點與鏡頭位姿有興趣的人,這個項目很值得留意。

Repository image for aigc3d/ViGeo

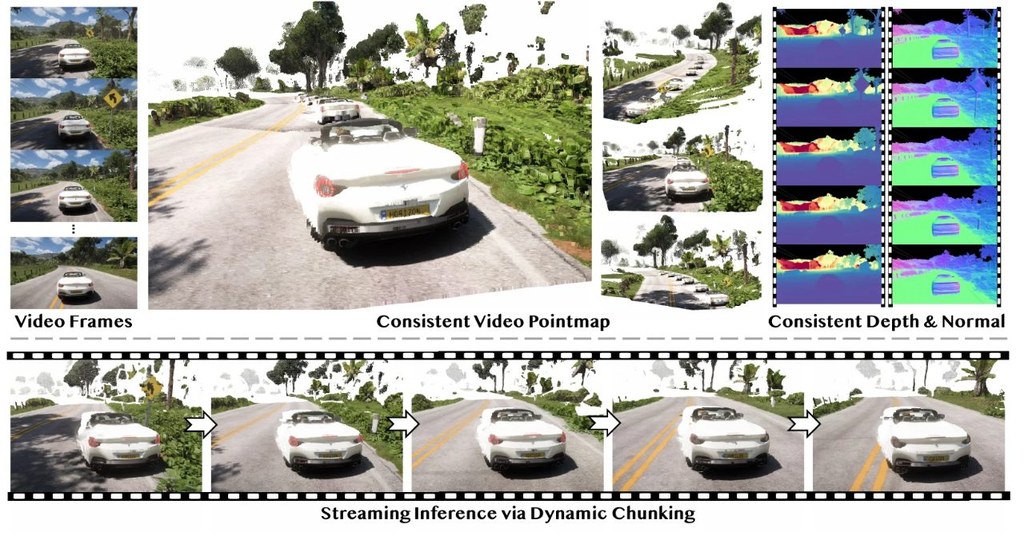
ViGeo 是一個用來估算場景幾何的項目,輸入可以是影片片段,也可以是單張影像。它會輸出 depth、3D points、normals、confidence,處理連續影格時亦可估算 camera poses,重點是盡量保持時間上的一致性,減少前後幀結果跳動。

使用這個項目時,先按手頭資料選擇模式:完整影片可用 offline,串流畫面可用 online,長影片則可分段用 chunk 處理。這種安排對做影片重建、機械人感知、AR、導航或後期視覺分析的人較實用,因為不需要為不同輸入形式換另一套模型。

它想解決的核心問題,是影片幾何估計常見的兩難:不是短片效果好但難以串流,就是能即時推理但長時間一致性不足。ViGeo 以同一個 feed-forward foundation model 統一 full-sequence reconstruction、streaming inference 與 long-video inference,論文指出關鍵在 dynamic chunking attention,讓模型可因應測試情境切換時間關注方式,而不用重新訓練。

另一個重要部分是 VideoLDCM,完整名稱是 VideoLDCM,負責 depth completion。它在這項工作中用作 data-refinement model,把稀疏或帶雜訊的深度觀測整理成較乾淨的 dense depth supervision,對訓練幾何模型有幫助,也解釋了為何這個項目不只看單幀品質,還強調跨影格穩定性。

  • 同時支援 offline、online、chunk 三種推理流程
  • 可由影片或單張影像估算 depth、3D points、normals 等結果
  • 以 dynamic chunking attention 兼顧串流與長影片處理
  • 結合 VideoLDCM 改善深度監督資料品質
  • 論文聲稱在多項 video geometry 任務達到 state-of-the-art
ModelDownloadDescription
ViGeoLINK用於深度、點、法線、姿態和置信度的主要視覺幾何模型
VideoLDCMLINK用於稀疏深度濾波、泊松補全和深度細化的資料細化模型

性能方面,論文描述它在 online、offline、long-video depth estimation、surface normal estimation、video point map estimation 都有很強表現,並以 public datasets 訓練。不過目前公開 checkpoint 亦已註明存在已知 loss implementation 問題,可能在 camera poses 視覺化與遠距區域出現輕微瑕疵,因此較適合先用來理解能力範圍,再決定是否放入要求很高的生產流程。

GitHub: https://github.com/aigc3d/ViGeo

項目: https://pkqbajng.github.io/ViGeo/

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 世界模型

EarlyTom 令影片理解模型跑得更快

EarlyTom 以免訓練方式減少影片推理時所需的視覺 token,重點是加快推理而盡量保住表現。對 Video-LLMs 使用場景尤其有參考價值。

earlytom logo

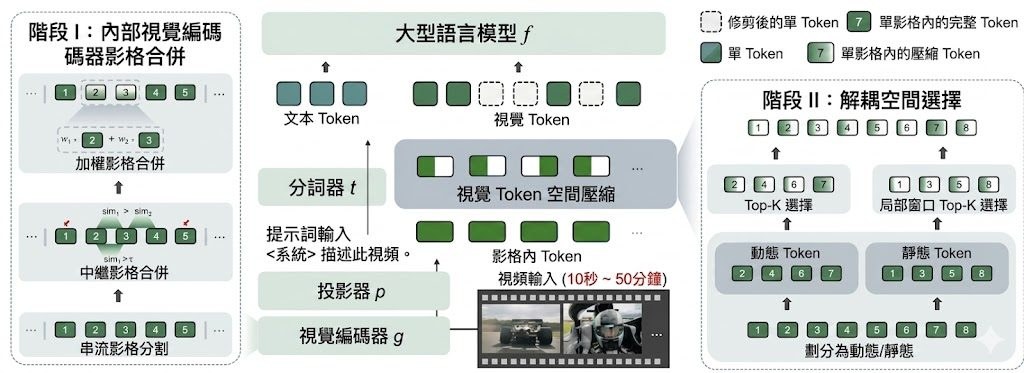
EarlyTom 是一個針對 Video Large Language Models(Video-LLMs)而設的 token 壓縮項目,目標很清晰:在不重新訓練模型的前提下,減少影片理解時要處理的視覺 token 數量。它主要處理推理速度慢、計算量高這個痛點,尤其是影片內容比圖片更長、更重,模型很容易在前段編碼就耗掉大量時間。

這個項目的核心想法,不是等資料全部進入模型後才壓縮,而是更早在 vision encoder 階段動手。EarlyTom 會利用早期 transformer layers 的 attention 訊號,先找出冗餘 token,再做裁剪;另有可選的 inner compression,會在 LLM backbone 指定層以 DPC-KNN 做 token 合併。這種早期壓縮方式,重點在於連 vision encoder 的負擔都一併減少。

使用上,項目是建基於 LLaVA-NeXT,並可包裝 LLaVA-OneVision 模型;程式層面是把已載入的模型再套用 EarlyTom。對已經在跑影片問答、影片描述或多模態理解流程的人來說,這代表可在原有模型管線上加入壓縮機制,而不一定要改動整個訓練流程。

  • 免訓練(training-free)壓縮,部署門檻相對較低
  • 分為 outer compression 與 optional 的 inner compression
  • 重點改善 Time-to-First-Token(TTFT)、throughput 與 FLOPs
  • 依賴早期 attention 訊號挑走冗餘視覺 token
  • 相關模型與框架包括 LLaVA-NeXT、LLaVA-OneVision、Qwen2

從公開資料看,作者以 lmms-eval 進行評測,並在論文內容提到會比較 MVBench、EgoSchema、LongVideoBench 與 VideoMME 等常見影片理解基準。結果描述顯示,它在維持接近 full-token 方法準確度的同時,TTFT 最多可降至 2.65×,亦有更高 throughput;不過不同模型大小、影片長度與硬件配置下,實際增益仍要分開看。

這個項目較適合已經使用 Video-LLMs 的研究者、工程團隊,或想在資源有限環境中提升影片理解效率的人。若你關心的是模型答得準之餘,也要更快開始輸出結果,EarlyTom 的價值就在於它把壓縮時機提早,直接針對最花時間的部分下手。

GitHub: https://github.com/viridisGreen/EarlyTom

項目: https://viridisgreen.github.io/EarlyTom/

Categories: 開源, 阿里巴巴, 視覺模型, 框架

Qwen-VLA 用單一模型打通機械人任務

Qwen-VLA把操作、導航與軌跡預測放入同一個模型。重點在跨機械人平台與跨場景泛化能力。

Hero image preview

Qwen-VLA 是一個把視覺、語言與動作整合起來的項目,目標是用同一套模型處理機械人操作、導航,以及軌跡預測。過往很多 embodied intelligence 系統都只針對單一任務或單一機械人設計,結果是能力分散,換場景、換任務或換機體後便難以沿用。

這個項目以 Qwen3.5 Vision-Language Model 為基礎,再加入 DiT-based action decoder,令模型不只看圖和理解文字,還能產生連續動作與軌跡。研究團隊亦加入 embodiment-aware prompt conditioning,用機械人專屬文字描述去標示當前機體與控制方式,讓同一模型可支援多種 robot embodiments。

核心概念是把不同類型資料一同訓練,包括 robotics manipulation trajectories、human egocentric demonstrations、synthetic simulation data、vision-and-language navigation data,以及 auxiliary vision-language data。對開發者來說,這代表項目不是只做問答或只做控制,而是把 manipulation、navigation 與 trajectory prediction 放進同一個 action-and-trajectory prediction 框架。

重點可先看以下幾項:
– 用單一 Vision-Language-Action Model 處理多類 embodied 任務
– 同時支援文字回應、動作生成與軌跡生成
– 透過 embodiment-aware prompt conditioning 適配不同機械人平台
– 強調 out-of-distribution generalization,涵蓋光線、背景、物件配置與機體變化
– 適合研究通用機械人控制、跨任務遷移與多平台部署的人員

論文列出 Qwen-VLA-Instruct 在多個基準上有不錯表現,包括 LIBERO 97.9%、Simpler-WidowX 73.7%、RoboTwin-Easy/Hard 86.1/87.2%、R2R 的 69.0% OSR、RxR 的 59.6% SR;在真實世界 ALOHA 實驗亦錄得 76.9% average OOD success,在 DOMINO dynamic manipulation 有 26.6% zero-shot success rate。若你關注的是一個可橫跨任務、環境與 robot embodiments 的通用型項目,展示了統一式 Vision-Language-Action Modeling 的清晰方向。

Paper: https://arxiv.org/pdf/2605.30280

Categories: 阿里巴巴, Agentic, 模型, 世界模型, 中國

CollectionLoRA:把多個效果 LoRA 濃縮成一個

把 50 甚至 180 個效果 LoRA 集中到單一 LoRA,減少部署成本,也降低多重 adapter 疊加帶來的干擾。

Repository image for Qwen-Applications/CollectionLoRA

CollectionLoRA 是一個針對 LoRA 管理成本而設的項目,核心做法是用 multi-teacher on-policy distillation,將多個效果 LoRAs 的概念,以及 few-step generation 能力,一次過蒸餾進單一 LoRA。對一般使用者來說,意思就是原本要為不同效果切換或串接多個 adapter,現在有機會改用一個整合版本處理,流程會更簡潔。

使用這個項目時,重點不是由零開始訓練,而是先按項目提供的 ckpt/ 結構放好權重,之後以 50_in_1/ 作推理用途。倉庫亦提供公開的 training and inference code,而 data/manga_tone/ 內有起步用的 teacher LoRA 和示範訓練資產,方便了解整個資料與模型配置方式。

它解決的問題相當明確:當效果 LoRA 數量愈來愈多,部署、切換與疊加都會變得麻煩,配合 acceleration modules 時,還可能出現互相干擾。CollectionLoRA 嘗試把「多效果」與「少步數生成」合併到同一個 LoRA,這比單純收藏大量 LoRA 更像是重新整理整個工作流。

項目公開的重點包括幾個方向:
– 可把 50→1,甚至 180→1 的效果教師整合到單一 LoRA
– 在 EffectBench 上,文中稱其於 8 NFE 下可取得較高 VSA 與較低 BCR
– 支援 zero-shot 的 A ⊕ B 組合效果,推理時可配對兩個已訓練教師,無需額外訓練
– 已開放 training and inference code,但 model weights 仍標示為未全面開放

這個項目較適合會接觸生成效果控制、需要管理大量 LoRA 的研究者與開發者,也適合想減少部署複雜度的團隊。若你關心的是把多種風格或效果整合成較易分發的模型形式,CollectionLoRA 展示的方向很有參考價值;不過現階段公開資訊主要集中在框架、指標與示範資產,完整權重供應情況仍要留意項目後續更新。

GitHub: https://github.com/Qwen-Applications/CollectionLoRA

Categories: 開源, 阿里巴巴, 視覺模型, 影像模型, 影像處理, 框架

TransitLM:點樣評估生成巴士地鐵路線

這項目不是用來規劃路線,而是專門檢查模型生成的路線是否合理。它把評分拆細,較易看清模型錯在邊一層。

Repository image for HotTricker/TransitLM

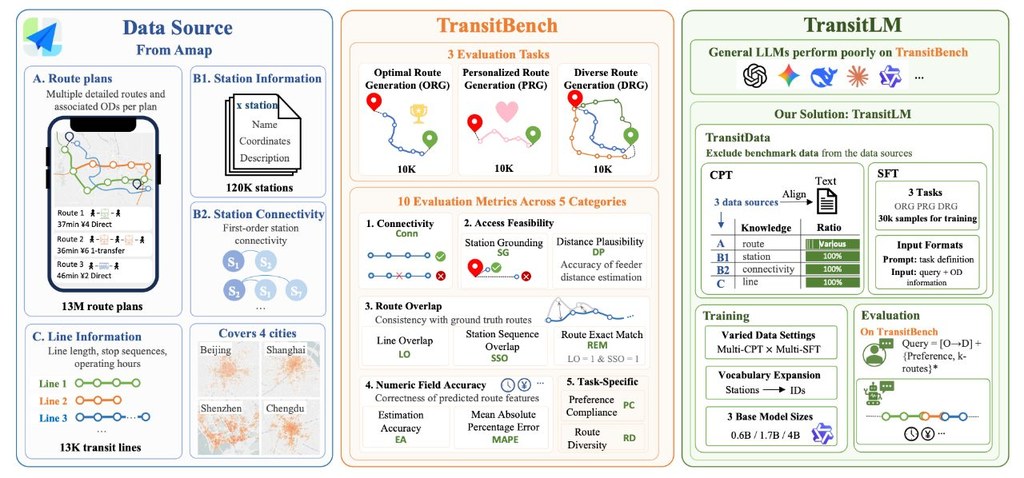
TransitLM 重點不是直接幫你找車程,而是提供一套評估流程,專門量度模型生成公共交通路線的表現。它配合同名論文與資料集使用,主要服務「不靠地圖引擎、直接由資料學出路線」這類研究方向。

項目已經附上示例 CSV,並按不同情境分成幾個評估腳本,包括單一路線、偏好路線、多路線多樣性,以及透過遠端 API 評估一般大語言模型輸出。因為只依賴 Python 標準函式庫,環境要求相對輕巧,想重現論文評估流程的人會較容易開始。

這個項目最值得留意的地方,是它不只給一個總分,而是把結果拆成多層來看,例如路線是否可達、站點是否對應得上、整體結構是否一致,以及時間、距離、票價估算是否可信。對比只看「答得似唔似」,這種分層做法更容易找出模型到底是認錯站、接錯線,還是只在數值估算上失準。

  • 支援四類評估情境,覆蓋論文基準與一般 LLM 輸出
  • 評分拆成多個維度,比單一總分更有診斷價值
  • 可檢查偏好是否符合,例如少轉車、避開地鐵等
  • 多路線模式會額外比較替代路線與多樣性
  • 安裝負擔低,適合重現與快速驗證

從論文資訊看,TransitLM 背後資料規模相當大,涵蓋超過 1,300 萬筆公共交通規劃紀錄、四個中國城市、120,845 個站與 13,666 條路線;相關研究亦提到模型可在沒有明確地圖對接下,學到站點對應與路線結構。不過這個儲存庫本身偏重「評估」而非「訓練」,所以較適合研究人員、做交通路線生成的模型開發者,或者想比較 GPT、Qwen 這類一般模型在路線任務上表現的人。

整體來看,TransitLM 的價值在於把一個很易流於主觀的任務,整理成可重現、可分解、可比較的評估項目。對非專業讀者來說,可以把它理解成一把較精細的尺:不是幫你直接畫路線,而是幫你判斷模型畫出來的路線,到底有幾可信。

GitHub: https://github.com/HotTricker/TransitLM

Paper: https://arxiv.org/pdf/2605.22355

Categories: 開源, 阿里巴巴, 框架, 中國, Dataset 數據集

Page 24 of 27
1 … 22 23 24 25 26 27