FashionChameleon 讓換衫影片更即時

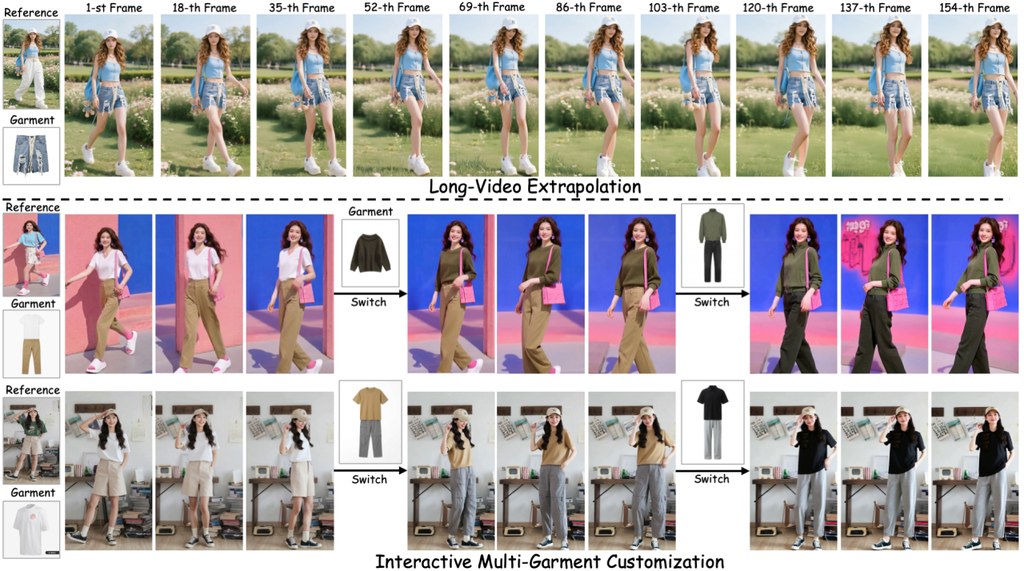
這個研究型專案主打即時換衫影片生成,重點是邊生成邊切換服飾,同時盡量保持動作連貫。

fashionchameleon

FashionChameleon 針對的是一個很實際的問題:想將人物影片中的服飾換款,但又不想等太耐,亦不想一換衫就令動作、姿勢或畫面穩定性明顯走樣。它把重點放在「生成途中仍可互動調整」,對電商展示、短片製作和虛擬試衫概念都幾有參考價值。

現階段較適合把它當成研究成果去了解,而不是即裝即用工具。公開資訊顯示,作者已提供論文和專案頁,但模型權重、前訓練與後訓練程式碼仍未完全釋出;想實際跟進,可先看示範頁面與技術報告,理解它點樣處理單件服飾影片資料,再留意後續更新。

它較特別的地方,在於不用依賴大量「同一人物不停換多套衫」的影片去訓練,改為先用單一參考圖與服飾圖建立學習方式,再透過串流式蒸餾提升長片段一致性。另一個亮點是生成期間可重整快取機制,令服飾切換更貼近即時互動,而不只是預先算好一條片。

重點可留意以下幾點:
– 主打人物服飾層面的影片客製化,而非單純換背景或整體風格
– 強調即時生成,論文提到單張 GPU 可達 23.8 FPS
– 目標是在換衫時保留動作連貫,減少前後畫面跳動感
– 訓練思路偏向用單件服飾資料學出可切換能力
– 現時較多是研究展示,部署門檻仍視乎後續釋出的程式與權重

相關模型方向可聯想到 image-to-video、人像影片生成、服飾替換與自回歸影片模型;文中亦明確圍繞 teacher model、streaming distillation 和 KV cache rescheduling 幾個核心設計。整體來說,FashionChameleon 最吸引之處不只是「識換衫」,而是朝住可互動、低延遲、長片仍較穩定這三件事同步推進,對需要即時預覽效果的應用尤其值得留意。

GitHub: https://github.com/quanjiansong/FashionChameleon

Paper: https://arxiv.org/pdf/2605.15824

Categories: 開源, 阿里巴巴, 視覺模型, 視頻模型

Orthrus如何令Qwen3生成更快

這個專案嘗試在不改變原本輸出品質下,加快大型語言模型生成速度。對想用Qwen3做推理的人尤其值得留意。

Orthrus logo

Orthrus 是一個圍繞 Qwen3 模型建立的生成框架,重點不是做全新聊天模型,而是想辦法令文字生成更快,同時保持與原本基礎模型一致的輸出分佈。對一般讀者來說,可以理解成它想保留傳統逐字生成的準確感,又借用擴散式並行生成的速度優勢。

這類工具主要針對大型模型生成時「要逐個字等」的樽頸。Orthrus 提出雙重架構做法,讓同一個模型同時具備兩種觀看方式,並強調結果是無損的,也就是目標並非用近似答案換速度;根據專案資料,生成可有最高約 7.8 倍加速。

如果你想上手,最直接方法不是自行訓練,而是先試用作者提供的模型檢查點,再用 Hugging Face 的常見載入流程做推理。現時公開型號包括 Orthrus-Qwen3-1.7B、Orthrus-Qwen3-4B 和 Orthrus-Qwen3-8B,分別對應 Qwen3 的 1.7B、4B 與 8B 基礎模型。

值得留意的是,它不是靠把整個模型重訓來換速度,而是只微調部分參數,基礎 LLM 保持凍結,同時兩種生成視角可共用同一套高保真 KV cache。對部署者來說,這代表它除了講求快,亦有意控制額外記憶體成本,這點對長輸出或高頻推理場景特別實際。

  • 以 Qwen3 為骨幹,現有 1.7B、4B、8B 幾個版本
  • 重點在提升生成吞吐,而非改變模型用途
  • 強調結果與原基礎模型保持一致,而非近似加速
  • 額外記憶體開銷較低,較適合推理部署評估
  • 對研究者、模型工程師及需要大量文字生成的團隊較有參考價值

整體來看,Orthrus 最吸引之處在於它把「快」與「不走樣」放在同一個方案內處理。若你正關注本地或伺服器端 LLM 推理效能,尤其已經在使用 Qwen3 生態,這個專案很適合作為實驗與比較基準;至於與 vLLM 或 SGLang 的更原生整合,則似乎仍在後續規劃中。

網址: https://github.com/chiennv2000/orthrus

Categories: 開源, 模型, 模型訓練, Qwen, 中國

PAE:令擴散模型更快收斂的潛在空間設計

PAE不是只追求重建清晰度,而是重新整理潛在空間本身。對想提升生成質素與訓練效率的人,這個方向值得留意。

pae teaser

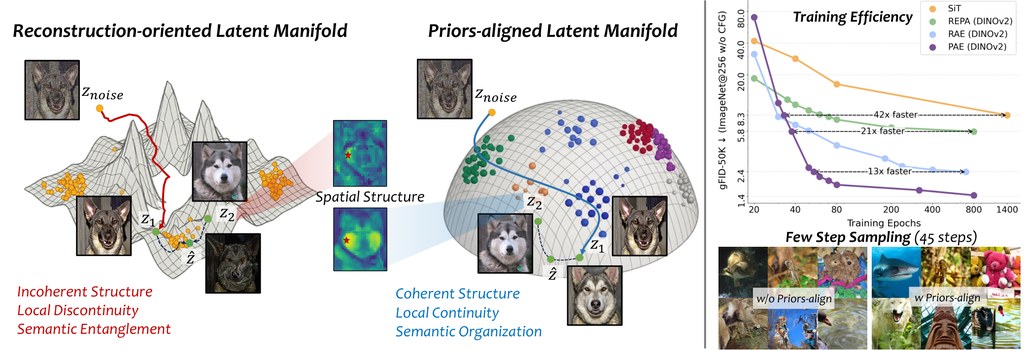
PAE 是一個為潛在擴散模型而設的自編碼器框架,重點不只是把圖片壓縮再還原,而是先把潛在空間整理成更適合擴散模型學習的形態。簡單講,它關心的不是「壓得靚唔靚」,而是「模型之後生圖時會唔會更順、更穩定」。

實際使用上,PAE 可理解為擴散模型前面的 tokenizer 或影像編碼模組:先把圖片轉成 latent,再交畀後續生成模型訓練。這種做法特別適合本身已在做 latent diffusion、但覺得收斂慢、訓練成本高,或者生成效果未夠穩定的研究與開發流程。

這個專案較有意思的地方,是它明確提出三個「對擴散友善」的潛在空間特質:空間結構一致性、局部流形連續性,以及全域語意組織。作者不是假設這些特質會自然出現,而是用三種 prior-alignment regularization 去主動約束,這比單靠重建誤差的傳統思路更進一步。

根據專案提供的結果,PAE 在 ImageNet 256×256 上做到 gFID 1.03,並且在相同 LightningDiT 設定下,收斂速度最高可比 RAE 快 13 倍。對非研究人員而言,這代表同樣資源下有機會更快見到可用成果;不過這些表現仍應視乎資料集、訓練設定與骨幹模型而定。

  • 核心定位:為 latent diffusion 準備更易學的潛在表示
  • 主要創新:把「擴散友善」拆成三個可優化的性質來訓練
  • 實際價值:有機會縮短訓練週期,提升生成質素與少步數採樣表現
  • 適合場景:影像生成研究、需要高效率訓練的生成系統、比較不同 tokenizer 設計
  • 可配骨幹:支援多種編碼器方向,包括 DINOv2、SigLIP2、DINOv3、MAE

如果你關心的是「如何令擴散模型學得更快,而唔係只換更大模型」,PAE 的切入點相當值得參考。它最適合有一定生成模型流程的人採用;對一般用家而言,未必是即裝即用工具,但作為下一代 latent tokenizer 的設計思路,含金量相當高。

Source: https://github.com/ZhengrongYue/PAE

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 模型訓練, 影像模型, 中國

Qwen3.6-Plus 專為 Agentic AI 設計的模型

Qwen3.6-Plus 顯著增強了模型的智能體(Agent)編程能力。無論是前端網頁開發,還是複雜的代碼倉庫級問題求解,Qwen3.6-Plus 均樹立了全新的業界標桿(SOTA)。此外,Qwen3.6-Plus 對世界的感知更加精准,多模態推理能力也更為敏銳。本次發佈直接回應了社區在 Qwen3.5-Plus 部署期間反饋的意見,為開發者生態提供了高度穩定可靠的基礎,帶來真正具有變革意義的“氛圍編程”(Vibe Coding)體驗。 官方已提供 OpenClaw 整合,編輯 ~/.openclaw/openclaw.json

Qwen3.6-Plus 顯著增強了模型的智能體(Agent)編程能力。無論是前端網頁開發,還是複雜的代碼倉庫級問題求解,Qwen3.6-Plus 均樹立了全新的業界標桿(SOTA)。此外,Qwen3.6-Plus 對世界的感知更加精准,多模態推理能力也更為敏銳。本次發佈直接回應了社區在 Qwen3.5-Plus 部署期間反饋的意見,為開發者生態提供了高度穩定可靠的基礎,帶來真正具有變革意義的“氛圍編程”(Vibe Coding)體驗。

官方已提供 OpenClaw 整合,編輯 ~/.openclaw/openclaw.json

{
  "models": {
    "mode": "merge",
    "providers": {
      "bailian": {
        "baseUrl": "https://dashscope.aliyuncs.com/compatible-mode/v1",
        "apiKey": "DASHSCOPE_API_KEY",
        "api": "openai-completions",
        "models": [
          {
            "id": "qwen3.6-plus",
            "name": "qwen3.6-plus",
            "reasoning": true,
            "input": ["text", "image"],
            "contextWindow": 1000000,
            "maxTokens": 65536
          }
        ]
      }
    }
  },
  "agents": {
    "defaults": {
      "model": {
        "primary": "bailian/qwen3.6-plus"
      },
      "models": {
        "bailian/qwen3.6-plus": {}
      }
    }
  }
}

Categories: 阿里巴巴, Agentic, Vibe Coding, OpenClaw, 中國

Qwen3.5-Omni 多模態模型

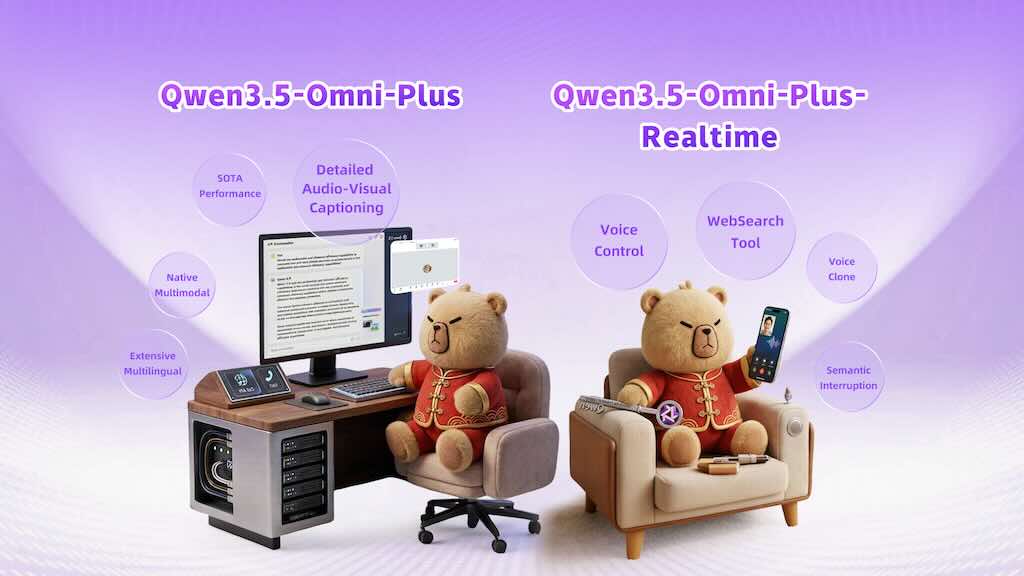
Qwen3.5-Omni 是 Qwen 最新一代全模態大模型,支持文本、圖片、音頻、音視頻理解。結構上,Qwen3.5-Omni 的 Thinker 與 Talker 均採用 Hybrid-Attention MoE 架構。Qwen3.5-Omni 系列包含 Plus、Flash、Light 三種尺寸的 Instruct 版本,支持 256k 長上下文,模型支持超過 10 小時的音頻輸入及超過 400 秒的 720P(1 FPS)音視頻輸入。模型在海量文本、視覺以及超過 1 億小時的音視頻數據上進行原生多模態預訓練,該模型展現出卓越的全模態感知與生成能力。相比 Qwen3-Omni,Qwen3.5-Omni 多語言能力大大增強,能夠支持 113 種語種和方言的語音識別和 36 種語種和方言的語音生成。目前可通過 Offline API 和 Realtime API 進行體驗。 Qwen3.5-Omni Thinker 通過 Vision Encoder 和 AuT 接受視覺和音頻信號輸入,音視頻信號通過 interleave 交織並搭配 TMRoPE 編碼位置信息。Thinker 負責處理全模態信號並輸出文本,Talker 負責接收來自 Thinker 的多模態輸入以及文本輸出,進行 […]

Qwen3.5-Omni 是 Qwen 最新一代全模態大模型,支持文本、圖片、音頻、音視頻理解。結構上,Qwen3.5-Omni 的 Thinker 與 Talker 均採用 Hybrid-Attention MoE 架構。Qwen3.5-Omni 系列包含 Plus、Flash、Light 三種尺寸的 Instruct 版本,支持 256k 長上下文,模型支持超過 10 小時的音頻輸入及超過 400 秒的 720P(1 FPS)音視頻輸入。模型在海量文本、視覺以及超過 1 億小時的音視頻數據上進行原生多模態預訓練,該模型展現出卓越的全模態感知與生成能力。相比 Qwen3-Omni,Qwen3.5-Omni 多語言能力大大增強,能夠支持 113 種語種和方言的語音識別和 36 種語種和方言的語音生成。目前可通過 Offline API 和 Realtime API 進行體驗。

Qwen3.5-Omni Thinker 通過 Vision Encoder 和 AuT 接受視覺和音頻信號輸入,音視頻信號通過 interleave 交織並搭配 TMRoPE 編碼位置信息。Thinker 負責處理全模態信號並輸出文本,Talker 負責接收來自 Thinker 的多模態輸入以及文本輸出,進行 contextual 語音生成,語音表徵通過 Qwen3-Omni 提出的 RVQ 編碼來替代繁重的 DiT 運算。由於 chunk-wise 的流式輸入設計和流式 Talker 設計,整個模型可以進行 realtime interaction。不同於上一代 Qwen3-Omni 的雙軌 Talker 輸入,Talker 在輸入的組織方式上採用了 ARIA(自適應速率交錯對齊,Adaptive Rate Interleave Alignment)來動態對齊文本與語音單元,然後進行交錯排布,以避免由於文本與語音 Token 編碼效率差異導致的語音不穩定性,如漏讀、誤讀或數字發音模糊等問題。

Categories: 阿里巴巴, 多模態模型, 中國

LumosX 精準個性化數字人

LumosX 是一個針對 個性化多主體視訊生成(personalized multi‑subject video generation)提出的框架,重點在: 簡單說:一樣可以做 text‑to‑video + ID conditioning,但對多個人物、每個人對應什麼屬性,控制得更精細、更一致「可控視訊生成」與「多主體個性化內容」場景,例如多角色劇本生成、廣告、虛擬試衣、多角色 VTuber 相容演出等。

LumosX 是一個針對 個性化多主體視訊生成(personalized multi‑subject video generation)提出的框架,重點在:

  • 讓每個「身份」(例如不同人物)和其對應的屬性(年齡、外貌、服飾、動作等)有明確、精準的對齊;
  • 用關係性注意力機制來強化「組內一致性」(同一組人物屬性一致)和「組間區分度」,減少多主體時的屬性糾纏(attribute entanglement)。

簡單說:一樣可以做 text‑to‑video + ID conditioning,但對多個人物、每個人對應什麼屬性,控制得更精細、更一致「可控視訊生成」與「多主體個性化內容」場景,例如多角色劇本生成、廣告、虛擬試衣、多角色 VTuber 相容演出等。

Categories: 開源, 阿里巴巴, 數字人, 視頻模型

Code2World 基於動作預測的 GUI 代理

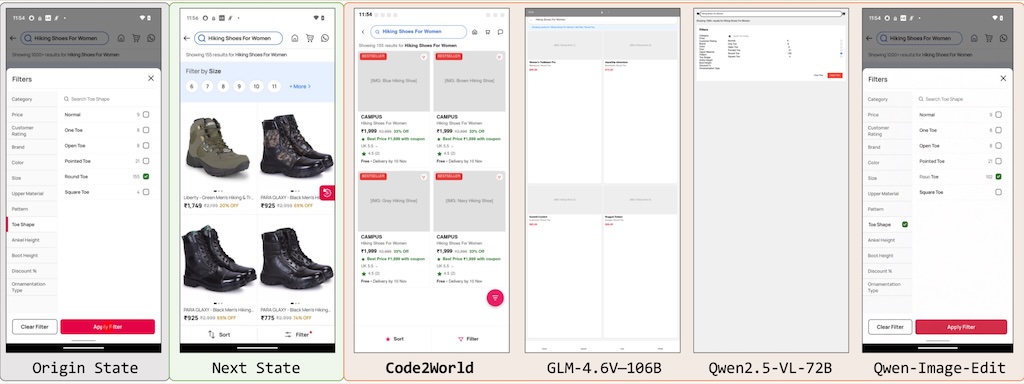
Code2World 本身不是一個「GUI 設計工具」,但它可以用在「優化 GUI 設計」的流程裡,特別是幫你 驗證設計是否好操作、是否容易出錯、是否符合使用者行為預期。Code2World 以靈活的方式顯著提升了下游導航的成功率,在 AndroidWorld 導航方面,其性能比 Gemini-2.5-Flash 提升了 9.5%。 它透過產生可渲染的程式碼來模擬下一個視覺狀態。實驗表明,Code2World-8B 在下一界面 UI 預測方面表現卓越,足以媲美 GPT-5 和 Gemini-3-Pro-Image 等競爭對手。(Huggingface 模型及數據集出現 404)(圖為預測介面的結果)

Code2World 本身不是一個「GUI 設計工具」,但它可以用在「優化 GUI 設計」的流程裡,特別是幫你 驗證設計是否好操作、是否容易出錯、是否符合使用者行為預期。Code2World 以靈活的方式顯著提升了下游導航的成功率,在 AndroidWorld 導航方面,其性能比 Gemini-2.5-Flash 提升了 9.5%。

它透過產生可渲染的程式碼來模擬下一個視覺狀態。實驗表明,Code2World-8B 在下一界面 UI 預測方面表現卓越,足以媲美 GPT-5 和 Gemini-3-Pro-Image 等競爭對手。(Huggingface 模型及數據集出現 404)(圖為預測介面的結果)

Categories: 開源, 阿里巴巴, Agentic, 模型, 編程

Qwen3‑TTS 開源語音合成

Qwen3‑TTS 由阿里雲的 Qwen 團隊開發的開源語音合成系列模型,專注於提供穩定、富有表現力,且能即時生成語音的功能。整個專案的核心目的在於讓開發者與使用者能夠自由設計語音、快速複製已有聲音,並且能根據指令調整語調、情感與說話速度。相較於市面上其他解決方案,Qwen3‑TTS 同時支援十種主要語言以及多種方言音型,涵蓋中文、英文、日文、韓文、德文、法文、俄文、葡文、西文、意譲等,能讓應用跨語系、跨文化的需求更容易實現。 在技術架構上,Qwen3‑TTS 研發了自己的 Qwen3‑TTS‑Tokeniser‑12Hz 編碼器,這個編碼器能把音訊壓縮成 12.5 Hz 的多本級碼,既保留語义內容,也捕捉細節的聲音特徵。這種設計讓模型在合成音訊時可以使用較輕量的因果卷積網路直接重建波形,降低了運算成本與延遲。相較於傳統的「語言模型+DiT」流程,Qwen3‑TTS 完全貫通端到端的離散多本碼結構,省去了資訊瓶頸與串聯錯誤的問題,提升了整體的生成效率與品質。 模型本身分為四個主要版本,分別是 1.7 B 以及 0.6 B 兩個大小的基礎模型、以及兩個具備語音設計與客製音色功能的變體。小型版(0.6 B)版的模型在三秒內即可完成從使用者提供的音檔進行快速複製,亦可作為微調(Fine‑Tuning)其他模型的起點;較大的 1.7 B 版則在保留上述功能的同時,提供更多語音樣式與更細膩的情感控制。所有模型都已發布在 GitHub 與 ModelScope 平台,並以 Apache‑2.0 授權,讓社群可自由使用、修改。 開發者只需要安裝 qwen‑tts 套件或使用 vLLM 等推理框架,就能自動下載對應的權重模型。若網路環境較為受限,官方提供了手動下載的指令,可讓使用者把模型權重下載到本機資料夾。更重要的是,Qwen3‑TTS 具備即時流式合成的能力,只要輸入一個字符,就能在 97 毫秒以內產出第一段語音,這使得它非常適合即時對話、虛擬助理或直播互動等需要低延遲的應用情境。模型同時支援多種語音控制方式,例如依照文字說明生成特定音色、根據自然語言描述調整語調與情感,甚至在同一段文字中混合多種音色,形成獨特的聲音組合。 總體而言,Qwen3‑TTS 不僅提供高品質的語音合成,更在多語系支援、流式生成、指令式語音控制與開源授權上提供了完整且可直接使用的解決方案。無論是想要在產品中加入自然的語音回覆、想要快速製作示範音檔、或是需要進行語音克隆與客製化設計的研究者,都能從這個開源項目中快速取得所需的工具與模型,並且能輕鬆將其整合到自己的開發流程中。

Qwen3‑TTS 由阿里雲的 Qwen 團隊開發的開源語音合成系列模型,專注於提供穩定、富有表現力,且能即時生成語音的功能。整個專案的核心目的在於讓開發者與使用者能夠自由設計語音、快速複製已有聲音,並且能根據指令調整語調、情感與說話速度。相較於市面上其他解決方案,Qwen3‑TTS 同時支援十種主要語言以及多種方言音型,涵蓋中文、英文、日文、韓文、德文、法文、俄文、葡文、西文、意譲等,能讓應用跨語系、跨文化的需求更容易實現。

在技術架構上,Qwen3‑TTS 研發了自己的 Qwen3‑TTS‑Tokeniser‑12Hz 編碼器,這個編碼器能把音訊壓縮成 12.5 Hz 的多本級碼,既保留語义內容,也捕捉細節的聲音特徵。這種設計讓模型在合成音訊時可以使用較輕量的因果卷積網路直接重建波形,降低了運算成本與延遲。相較於傳統的「語言模型+DiT」流程,Qwen3‑TTS 完全貫通端到端的離散多本碼結構,省去了資訊瓶頸與串聯錯誤的問題,提升了整體的生成效率與品質。
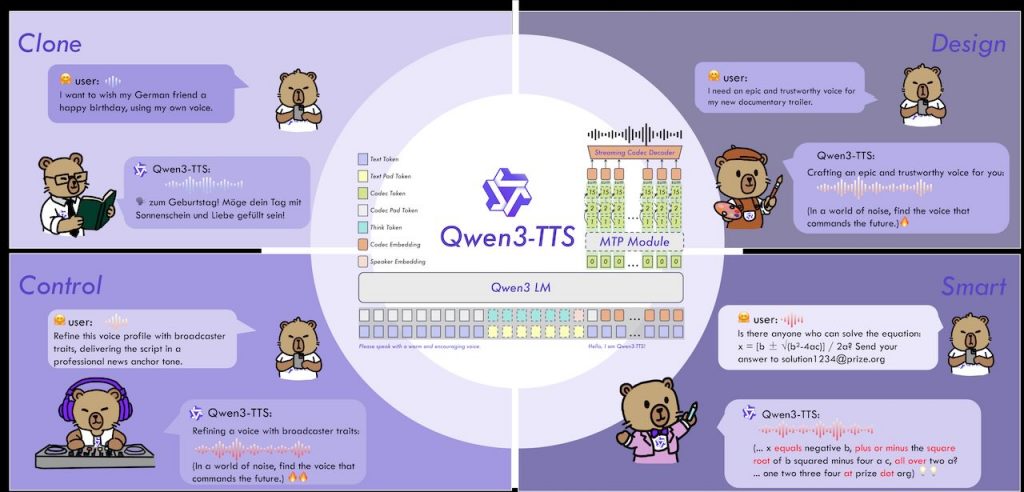
模型本身分為四個主要版本,分別是 1.7 B 以及 0.6 B 兩個大小的基礎模型、以及兩個具備語音設計與客製音色功能的變體。小型版(0.6 B)版的模型在三秒內即可完成從使用者提供的音檔進行快速複製,亦可作為微調(Fine‑Tuning)其他模型的起點;較大的 1.7 B 版則在保留上述功能的同時,提供更多語音樣式與更細膩的情感控制。所有模型都已發布在 GitHub 與 ModelScope 平台,並以 Apache‑2.0 授權,讓社群可自由使用、修改。

開發者只需要安裝 qwen‑tts 套件或使用 vLLM 等推理框架,就能自動下載對應的權重模型。若網路環境較為受限,官方提供了手動下載的指令,可讓使用者把模型權重下載到本機資料夾。更重要的是,Qwen3‑TTS 具備即時流式合成的能力,只要輸入一個字符,就能在 97 毫秒以內產出第一段語音,這使得它非常適合即時對話、虛擬助理或直播互動等需要低延遲的應用情境。模型同時支援多種語音控制方式,例如依照文字說明生成特定音色、根據自然語言描述調整語調與情感,甚至在同一段文字中混合多種音色,形成獨特的聲音組合。

總體而言,Qwen3‑TTS 不僅提供高品質的語音合成,更在多語系支援、流式生成、指令式語音控制與開源授權上提供了完整且可直接使用的解決方案。無論是想要在產品中加入自然的語音回覆、想要快速製作示範音檔、或是需要進行語音克隆與客製化設計的研究者,都能從這個開源項目中快速取得所需的工具與模型,並且能輕鬆將其整合到自己的開發流程中。
Categories: 開源, 阿里巴巴, Qwen, 語音


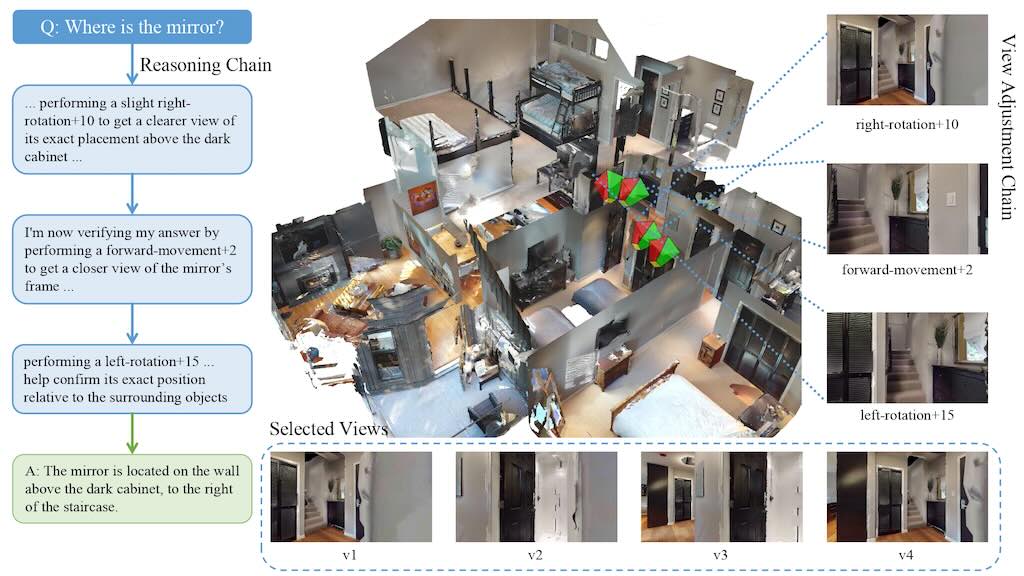
CoV 提升視覺語言的空間推理能力

CoV (Chain-of-View Prompting for Spatial Reasoning) 可以用於各種需要在複雜三維環境中進行精確空間理解的場景。例如 VR 和 AR,CoV 可以幫助系統更好地理解和響應用戶在虛擬環境中的查詢,提供更自然、更沉浸式的體驗。在自動駕駛領域,CoV 可以增強車輛對周圍環境的理解能力,提高其在複雜道路條件下的導航和決策能力。 CoV 提出一種創新方法,專門針對在三維環境中的具身問答(Embodied Question Answering, EQA)問題。傳統的視覺語言模型(Vision-Language Models, VLMs)受限於固定的輸入視角,這使得它們在推理過程中無法動態地獲取與問題相關的上下文信息,進而限制了複雜空間推理的能力。CoV 通過引入一種免訓練、僅在測試階段運行的框架來解決這一問題,該框架能夠讓 VLMs 變成主動的視角推理器。

CoV (Chain-of-View Prompting for Spatial Reasoning) 可以用於各種需要在複雜三維環境中進行精確空間理解的場景。例如 VR 和 AR,CoV 可以幫助系統更好地理解和響應用戶在虛擬環境中的查詢,提供更自然、更沉浸式的體驗。在自動駕駛領域,CoV 可以增強車輛對周圍環境的理解能力,提高其在複雜道路條件下的導航和決策能力。

CoV 提出一種創新方法,專門針對在三維環境中的具身問答(Embodied Question Answering, EQA)問題。傳統的視覺語言模型(Vision-Language Models, VLMs)受限於固定的輸入視角,這使得它們在推理過程中無法動態地獲取與問題相關的上下文信息,進而限制了複雜空間推理的能力。CoV 通過引入一種免訓練、僅在測試階段運行的框架來解決這一問題,該框架能夠讓 VLMs 變成主動的視角推理器。

Categories: 開源, 視覺模型, Qwen

Page 25 of 27
1 … 23 24 25 26 27