ProMSA 把 KB-VQA 變成會搜尋的代理

ProMSA不是普通問答模型,而是會逐步搜尋證據的KB-VQA研究項目。它用TN-GSPO訓練代理,重點在於搜尋節奏、模態切換與停止時機。

ProMSA overview

這是一個針對 Knowledge-Based Visual Question Answering(KB-VQA)的研究原型兼訓練項目。它要處理的問題,是模型不只要看懂圖片內容,還要連接外部知識來源例如 Wikipedia,先找對實體,再用足夠證據回答問題。

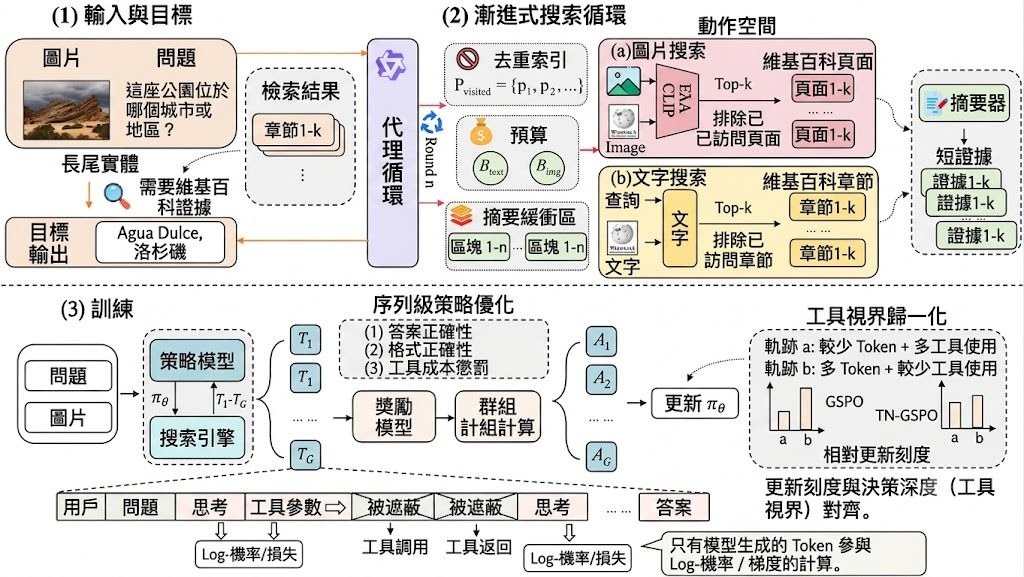
現有做法多數採用固定的 retrieve-then-generate 流程:先選好 retriever、設好 static top-k,再做一次檢索後直接生成答案。作者認為這種範式遇到 long-tail entities 很脆弱,第一步找錯就難以修正,也不擅長組出 multi-hop 證據鏈;所以 ProMSA 改成 progressive multimodal search agent,讓同一個 MLLM 逐輪決定用 image search、text search,還是 stop。

這個項目的取向很明確:它不是單純把檢索接到模型前面,而是把搜尋本身變成推理流程一部分。配合 de-duplication exclusion list、tool-call budget 同 reward penalty,它會避免重覆撈同一批內容,亦會在證據足夠時停手,減少無效工具呼叫;訓練上再用 TN-GSPO,而不是只靠 GRPO 或 vanilla GSPO,目標是令長度與工具步數不同的軌跡都能較穩定更新。

  • 支援 image search、text search、stop 三種動作
  • 針對錯誤首次檢索加入 failure recovery 與 multi-hop 搜尋
  • 採用 veRL 工具介面,包含 multi-turn rollout、reward 與 loss
  • policy backbone 包括 Qwen/Qwen2.5-VL-7B-Instruct、Qwen/Qwen3-VL-2B-Instruct、Qwen/Qwen3-VL-8B-Instruct

網頁 已交代 Installation、Data & Model Preparation、Service Architecture、Training 同 Evaluation,表示它不只是概念展示,而是有完整實驗流程的研究項目;不過部署時應預期需要 Python 3.10+、veRL、外部搜尋服務同相應資料準備。結果描述提到在 E-VQA 與 InfoSeek 對強 RAG 和 agent baselines 有一致提升,但目前提供的是研究報告式結論,較適合做 KB-VQA、multimodal agent、RAG policy 訓練的團隊參考,而不是即裝即用的通用產品。
項目主頁 · GitHub · Paper

Categories: 清華大學, Agentic, RAG, 視覺模型, 模型訓練, Qwen, Python, 中國

LLM 組合唔一定勝過最佳單模

呢個 Hugging Face Space重點唔係新模型,而係用統計上限分析多模型編排何時無明顯收益。

Og image

這是一個 Hugging Face Space,用來展示多個大型語言模型組合策略的分析結果,而不是可下載微調模型;頁面亦無提供 base model,因為它本身並非基於某個基礎模型微調而成。它主要回答一個很實際的問題:把多個 LLM 放入 routing、voting、cascade 或 mixture-of-agents(MoA)之後,是否真能穩定超越單一最佳模型。

核心結論圍繞 β = P(all wrong),即所有模型在同一題一起答錯的機率。文中指出,凡是輸出仍然只能選自成員模型答案的策略,理論上準確率上限就是 1 − β;常見的 pairwise error correlation ρ 即使相同,亦未必能反映 β,所以只看模型之間「錯得是否相似」並不足以估算可提升空間。

這個項目的價值,在於它把模型編排問題由「多加幾個模型會否更準」轉成「這些模型是否在不同題目上出錯」。作者用 67 個 frontier models、21 個供應商資料說明:就算是多樣化模型池,all-wrong tail 仍比單靠相關性模型估算更高;在 open-ended mathematics、execution-graded code 這類可檢查任務,多模型通常難以大幅勝過最強單模,除非有很強的 query-level routing signal。

  • 這不是生成模型權重頁,沒有參數規模、context length、GGUF、mmproj 或量化檔案清單
  • 不涉及 llama.cpp、Ollama、LM Studio 部署,亦無 Q4_K_M 一類量化建議
  • 方法重點是用 Clopper–Pearson bound 先估計 β 上限,再判斷是否值得訓練 router
  • 與 Self-MoA 類做法相比,低 ρ 且真正「錯題互補」的模型組合更有機會帶來收益

對技術決策者而言,這個 Space 更像一個模型編排可行性檢查工具。它提醒人不要把 orchestration 當成免費性能加成:當共同失敗率高,多模型系統增加的可能只是成本、延遲與系統複雜度,而非可觀準確率提升。

項目主頁 · Paper

Categories: Agentic, Qwen, OpenAI, DeepSeek, Gemini, 工具, LLaMa, Ollama, Anthropic

GauntletBench 評測框架點出 Agent 盲點

這是用來測試 agent 泛化能力的評測工具。它避開常見應用,專攻視覺密集又偏專業的網頁任務。

GauntletBench logo

GauntletBench 是一個極具挑戰性的基於 Web 的基準測試,用於衡量智能體系統在複雜、基於視覺的專業任務中的泛化能力。

GauntletBench 圍繞著五個鮮為人知的應用場景構建——視頻編輯器、工作流程構建器、3D 建模器、飛行分析器和電路設計器——評估了三個尚未充分探索的能力:時間感知、圖形理解和3D 推理。該基準測試涵蓋100 項人類可完成的任務、模組化的評估流程以及自動化的領域特定評分,揭示了前沿智能體與人類表現之間存在顯著差距:被評估的最強智能體的成功率僅為19.1%,而非專家人類標註者的成功率則超過80%,這表明當前的智能體在復雜的真實世界中仍可達到可靠的真實世界的性能水平。

現有 benchmark 多數放在熱門應用和較直接的任務,容易令新一代 agents 出現分數飽和,未必真能反映它們離真實工作有幾遠。GauntletBench 的取向剛好相反:刻意避開常見 app,改用 Circuit Designer、Flight Analyser、Video Editor、3D Modeller、Workflow Builder 五類較少被覆蓋的環境,重新把問題定義成「能否在不熟悉介面完成視覺密集工作」。

這個 GitHub 項目本身不是模型,而是跑評測的框架;README 已交代可按單一 task、整個 application,甚至用 JSON 批次執行實驗,也支援並行執行與 YAML task file。底層 agent run mechanics 直接沿用 REAL 的 browser harness 與 task loop,這個項目新增的重點則是 evaluation framework、batch runner、objective and LLM-as-a-judge evaluators,以及新的 task suites。

  • 100 個任務,每個應用 20 個,全部屬 vision-intensive tasks
  • 預設模型參數 可指定 --model,預設為 o3
  • 可擴充測試方式,支援 YAML 任務檔與 JSON 批量設定
  • 結果訊號清楚:最佳 agent 約 19.1% 至 20.9% success,非專業人類標註者超過 80% 至 90%

最值得留意的是它反映出一個很實際的落差:agent framework 普遍比單純 raw models 好,但整體距離人類仍然很遠;open-source models 甚至普遍低於 1%。Video Editor 屬較可處理的範圍,Circuit Designer 則接近「幾乎做不到」,所以這套工具特別適合研究 Agentic、Computer-use agents、網頁自動化與多模態能力的團隊,用來找出模型不是「答錯」,而是根本看不懂時間、圖形與空間結構的位置。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 模型, 多模態模型, Qwen, Gemini, Video, 框架, 香港, 工具, 3D, Anthropic

OpenBioRQ 用未解醫學問題測試 AI 代理

這不是一般醫學問答集,而是用未解研究問題檢驗 AI 代理找證據與引用是否可信。它更重視能否誠實保留不確定性。

Repository image for minstar/healthcare-research

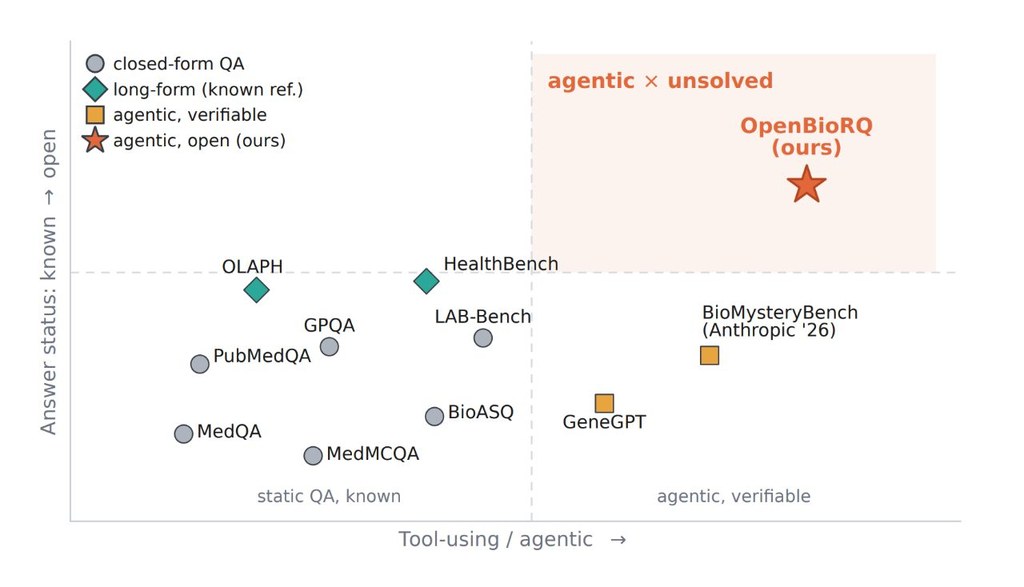
OpenBioRQ 是一個生物醫學基準資料集兼評測流程,聚焦於目前仍未解決的 biomedical / clinical research questions。它要解決的不是背答案能力,而是測試 LLMs 在 agentic tool use 情境下,能否自己找證據、正確引用文獻,並在沒有定論時保持 abstention。

現有 benchmark 多數採用固定答案 key 的問答範式,模型有機會靠記憶或線索反推標準答案,未必真的驗證過來源。OpenBioRQ 直接改用 retrieval-grounded openness:每條問題的 open_status 會用後續論文與 trial records 重新核對;難度也不是作者主觀標示,而是先讓強模型連工具一起跑,再用 pass/fail 結果界定哪些題目真的難。

項目的資料流程相當完整,從 crawl、extract、refine、dedup,到 status verification、contamination audit、agentic-eval 都有清楚分工。README 顯示它以 v3 的 12,553 題為基礎,另有 frozen core 作主要評測集;refine 步驟亦把問題整理成較自足的表述,自含性由 51.6% 提升到 85.4%,這對模型和人工評審都重要。

它和同類做法最大的分別,是把「引用可打開」與「引用真的支持答案」分開看。項目指出 agent citations 超過 99% 可以解析,但約 15.9% 其實連到錯誤論文;同時最難題組出現 agentic collapse,部分模型就算關掉工具,分數變化也不大,反映工具調用未必自然轉化成更好推理。

  • 類型定位:屬於基準資料集加評測 pipeline,不是臨床決策系統
  • 主要價值:檢查 evidence retrieval、faithful citation 與 abstention,而非考模型背誦
  • 評測設計:用 per-question checklist rubrics 固定評分,inter-judge agreement 由 Spearman 0.35 升到 0.82
  • 資料可靠性:core 657 與 expand 483 均報告 contamination hard 0%
  • 相關模型:Google、Anthropic、OpenAI 三條獨立 lineage,以及 README 提到的 GLM-5.1、MiniLM-L6

受惠最大的會是做醫療研究助理、文獻檢索代理、醫學 AI 評測的團隊,而不是想直接拿去做診斷的機構。它目前更像一個研究基建項目:幫人看清楚模型在高不確定、無標準答案場景下,究竟是有能力找證據,還是只是在生成看似合理的回答。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, MCP, Qwen, Google, OpenAI, DeepSeek, Gemini, Medical醫學, Anthropic, Dataset 數據集

Qwythos-9B GGUF 技術拆解

這是 Qwythos-9B-Claude-Mythos-5-1M 的 GGUF 量化版,主打 1M context、推理與工具調用。頁面亦交代 v2 檔案更新與 MTP 用法。

Og image

這個模型之所以值得注意,主要是因為它把 推理能力、超長上下文、以及本地部署友好性 結合在一個 9B 級別的模型裡。它是基於 Qwen3.5-9B 的全參數推理模型,並用 5 億多條 Claude Mythos / Claude Fable traces 做後訓練,還支援 1M context、vision 和 function calling 。

Hugging Face empero-ai/Qwythos-9B-Claude-Mythos-5-1M 的 GGUF 量化版本屬於 quantized 形式,而非原始訓練權重。它的主要用途是在 llama.cpp、Ollama、LM Studio 等 GGUF 執行環境中部署一個支援推理、視覺輸入、function calling 與長上下文的 9B 模型;其表現超越 base Qwen3.5-9B,但這一層關係屬於上游模型說明。

Qwythos-9B 是 full-parameter reasoning model,經過超過 5 億 tokens 的 Claude Mythos / Claude Fable traces 後訓練,並使用 Empero AI 內部 rethink 工具生成 chain-of-thought。能力上支援 1,048,576 tokens(1M context),透過 YaRN rope-scaling 預設開啟;同時標示為 image-text-to-text、multimodal、vision、agentic,表示它不只是文字聊天模型。

v2 已要求重新下載,原因包括 tokenizer metadata 對 Qwen3.5 GGUF runtimes 的修正、chat template 更新,以及新增 -MTP- 版本。已列出的一般版本包括:Qwythos-9B-Claude-Mythos-5-1M-Q4_K_M.gguf(5.24 GiB,官方建議預設)、Q5_K_M(6.02 GiB)、Q6_K(6.85 GiB)、Q8_0(8.87 GiB)與 BF16(16.69 GiB);頁面亦提到 vision projector smoke-tested,但截取內容未見 mmproj 檔名。

  • Q4_K_M 是最適合起步的量化級別,容量較低,而且頁面直接標成 recommended default
  • Q5_K_M / Q6_K 較適合想提高品質、又想控制記憶體佔用的部署
  • Q8_0 接近 near-lossless,較適合重視輸出穩定度的情境
  • -MTP- 檔案是為 llama.cpp MTP draft speculation 準備,一般相容性則以普通檔名版本較穩陣

與一般只做指令微調的同類模型相比,這個項目強調三點:一是 1M context 已預設可用,二是 native function calling 依照 Qwen3.5 spec,三是 v2 連 chat template 都針對 tool calling 與 OpenCode-style agent loops 修正。限制亦很清楚:完整訓練細節與評測數字需要回到 base model card 查看,而這個頁面主要是量化分發頁;使用時亦要留意舊版 GGUF 檔名已被替換,否則 chat template 與 runtime 相容性可能受影響。

項目主頁

Categories: 開源, Agentic, 模型, 多模態模型, Qwen, Image, Anthropic

Robust-TO:更穩陣的影片理解代理框架

Robust-TO 針對 Video-LLMs 在受干擾影片中的誤判問題,用信心分數協調工具與證據。重點不只準確率,還包括出錯時能否有節制地退化。

Repository image for ROVA-V2/Robust-TO

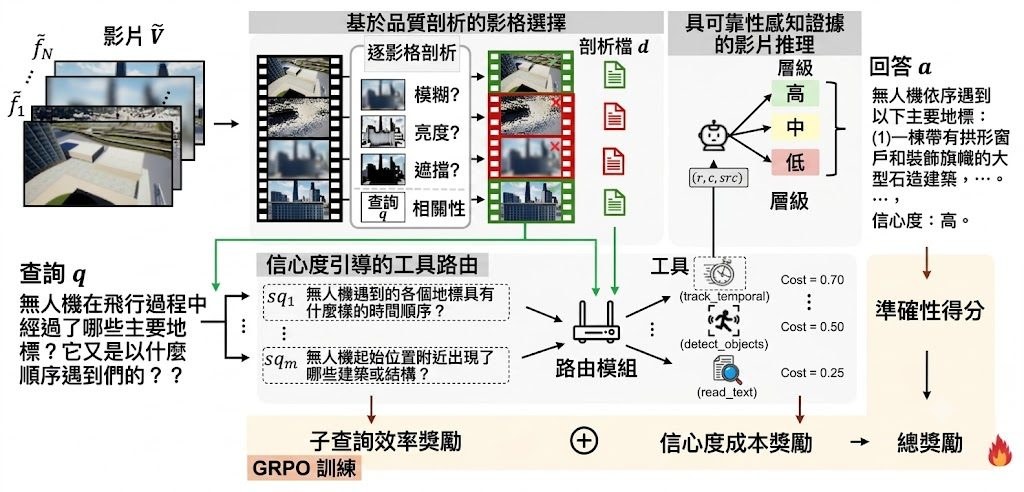
Robust-TO 是一個面向影片理解的 agentic framework 研究原型。它主要解決 Video-LLMs 在模糊、過暗、遮擋等干擾下,仍然盲目相信每一格畫面,導致答案與自信程度脫節的 Blind Trust Problem。

現有做法常把所有影格近乎同等對待,再交由單一模型或固定流程推理;作者認為這種範式忽略了畫面可靠度,所以提出 Confidence-Aware Tool Orchestration。它先用不需額外參數的 profiler 為每格評估 blur、brightness、occlusion,只保留較可靠片段,再把問題拆成子查詢,交由 track_temporal、detect_objects、read_text 等工具處理,最後用 High / Mid / Low 三層證據整合答案。

這個項目最值得留意的,不是單靠更大模型硬推結果,而是把 (result, confidence, source) 當成統一介面,連工具成本與可靠度一併納入。取捨也很明顯:流程比直接問一個 Video-LLM 更複雜,但換來對受污染影片更穩定的表現,而且官方指出在乾淨輸入上延遲開銷低於 5%。

  • 平均準確率比最強開源基線高 +10.6
  • clean-to-corrupted accuracy drop 最小,重點在抗干擾而非只看乾淨數據
  • 使用 GRPO 訓練 policy,獎勵同時考慮正確性、證據可靠度與計算成本
  • 相關組件與模型角色包括 profiler、Router,以及工具如 track_temporal、detect_objects、read_text

目前較適合把它理解為方法框架與研究結果,而不是立即可部署的成品。較受用的會是做 Video-LLMs、Computer-use agents、CUAs 式多工具協作、影片問答或魯棒性評測的研究團隊,特別是想把「模型知道自己何時不可靠」納入系統設計的人。

GitHub

項目主頁

Paper

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Video, 框架

ViQ 想把影像變成更懂語意的離散碼

ViQ 是把影像量化成離散表示的研究框架,目標是在語意理解與細節保留之間取得平衡。它也支援任意解析度輸入,對多模態訓練效率有明顯吸引力。

hunyuan logo

ViQ 是一個視覺量化表示研究框架,也是把影像轉成離散 codes 的模型方法。它要解決的問題,是讓圖片像文字 token 一樣可交給多模態大模型處理,同時盡量不要在量化過程丟失太多語意與畫面細節。

現有做法常見兩條路:一類偏重重建,還原畫面能力較好,但語意資訊不足;另一類依賴 contrastive vision-language learning 的連續特徵,語意較強,卻不容易直接變成高品質離散表示。ViQ 的切入點是先做 Text-Aligned Pre-training,再做量化學習,把「先對齊語言語意、後逐步離散化」拆成清楚兩段。

它的核心設計有幾個辨識度很高的部件:以 pretrained language model 監督視覺編碼器、用 resized positional embedding 與 native patchify 支援 any-resolution input、再用 Proximal Representation Learning 配合 L∞-norm 約束,把特徵逐步推近量化錨點,最後交給 position-aware、head-wise FSQ(Finite Scalar Quantization)處理。論文亦提到基座可接 SigLIP2 vision tower、Qwen2.5 backbone,並透過 LoRA 等輕量組件訓練量化部分,而不是全面微調整個系統。

  • 支援任意解析度輸入,不用被固定尺寸綁死
  • 目標不是只重建圖片,而是兼顧語意理解與細節
  • 多模態訓練可直接吃離散視覺 codes,論文稱效率可提升約 20% 至 70%
  • 已公開訓練與推論程式,並提供 HuggingFace 權重

從部署與測試角度看,這個 GitHub 儲存庫較適合當研究實作與模型驗證項目來理解:可先用已公開權重跑 inference,觀察影像如何被編成離散 codes,再進一步重現單階段訓練示例,之後才嘗試論文中的兩階段 recipe。較受惠的會是做 MLLM、視覺 tokenization、影像重建或訓練加速的團隊;限制則是概念與訓練流程都不算輕,重點較偏研究價值,未必是即裝即用的通用工具。

GitHub: https://github.com/yuxumin/ViQ

Paper: https://arxiv.org/pdf/2606.27313

Categories: 開源, 清華大學, 騰訊, Embedding, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架

TryOnCrafter:首個鏡頭可控的影片虛擬試穿框架

TryOnCrafter 是首個支援鏡頭軌跡控制的影片虛擬試穿框架,以 4D 代理模型分離人物與背景,實現任意視角的試穿效果。

TryOnCrafter teaser

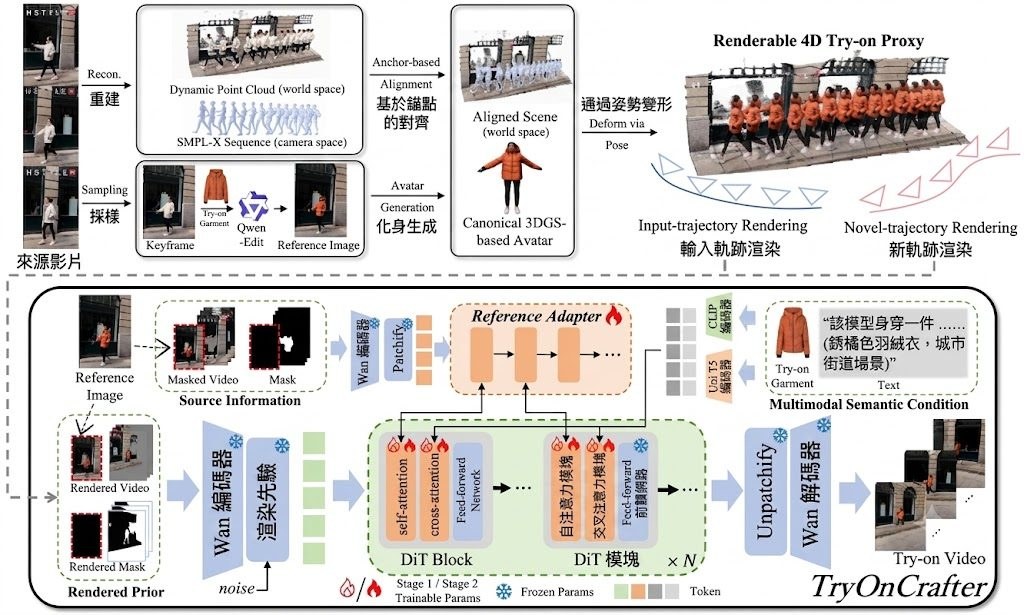
TryOnCrafter 是一個基於 DiT(Diffusion Transformer)的虛擬試穿影片框架,專門處理「鏡頭可控影片虛擬試穿」(Camera-controllable Video Virtual Try-on, CaM-VVT)這個新任務。它的主要用途是讓使用者能夠在指定鏡頭軌跡(例如推近、傾斜、環繞)的情況下,生成穿著指定服裝的人物影片。

傳統的影片虛擬試穿只能沿著原始影片的鏡頭路徑生成結果,無法讓使用者自由改變視角。TryOnCrafter 的做法是引入一個「可渲染的 4D 試穿代理」(Renderable 4D Try-on Proxy),先把 2D 試穿結果提煉成一個基於 3D Gaussian Splatting(3DGS)的穿衣化身,再用 SMPL-X 序列驅動動作,最後把這個化身對齊到重建的背景點雲中。這個代理模型把人物與環境分離開來,提供穩定的幾何骨架,讓後續的影片生成能夠在任意鏡頭下保持結構一致。

在生成階段,框架採用 Proxy-Anchored Video DiT,把代理模型渲染出來的多層資訊(包括渲染先驗、參考特徵、服裝語意提示)作為幾何錨點,確保最終影片在指定軌跡下保持物理合理的形變與外觀。這種設計同時支援多項延伸應用,包括人物重新定位、子彈時間效果,以及 360 度環繞檢視。

團隊建立了 CaM-VVTBench 評測基準,結果顯示 TryOnCrafter 在結構一致性與服裝身份保留方面,明顯優於現有方法。這個框架較適合需要展示服裝 3D 效果的研究團隊、電商內容製作,以及對鏡頭語言有要求的多媒體創作場景。

重點摘要

  • 首個鏡頭可控試穿框架:突破傳統 VVT 只能被動沿用原片鏡頭的限制,支援使用者自訂鏡頭軌跡。
  • 4D 試穿代理模型:以 3DGS 化身 + SMPL-X 動作序列,把人物與背景解耦,提供密集幾何引導。
  • Proxy-Anchored Video DiT:以代理渲染結果作為幾何錨點,確保任意視角下的結構與服裝一致性。
  • 多元延伸應用:支援人物重定位、子彈時間、360 度環繞等下游編輯。
  • 新基準 CaM-VVTBench:團隊建立的專用評測集,在結構一致性與服裝身份保留上明顯領先既有方法。

模型與源碼說明:原始資料為項目主頁,未提供具體的源碼下載連結、安裝步驟或模型權重取得方式。

項目主頁: https://sunhao242.github.io/TryOnCrafter_web.github.io/

Paper: https://arxiv.org/pdf/2606.26092

Categories: 開源, 阿里巴巴, AI productions, RAG, 數字人, 模型, 視覺模型, 視頻模型, Video, 影像模型, 影像處理, 框架

Wan Streamer:即時生成影音互動模型

阿里推出的 Wan Streamer v0.1,以單一 Transformer 同時處理聽、說、看、生成,實現亞秒級全雙工音視頻互動。

Wan Streamer framework

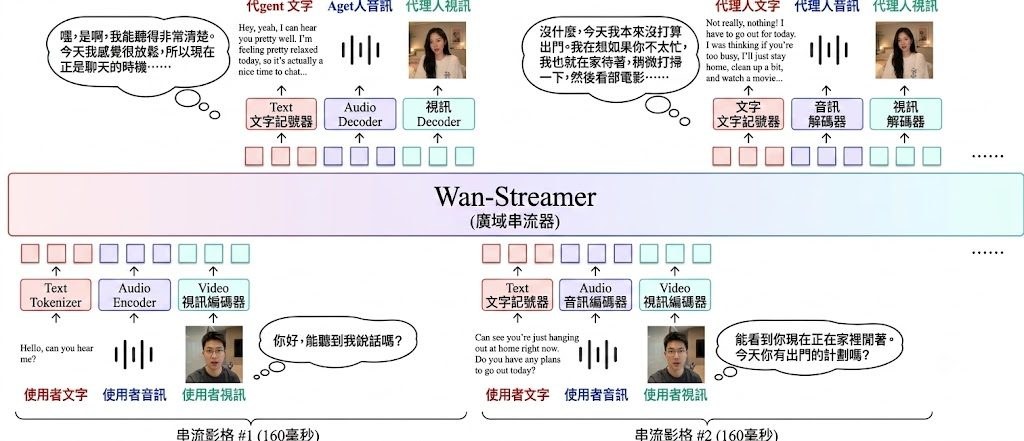
Wan Streamer v0.1 是一款由阿里巴巴(通義萬相/Wan 團隊)開發的原生流式端到端基礎模型,專為即時、低延遲、全雙工的音視頻互動而設計。它把語言、音訊、影像同時作為輸入與輸出,全部整合在單一 Transformer 之中,並以 block-causal attention 協調增量式生成。

現有即時互動系統普遍存在的延遲與不同步難題。純語音方案雖然回應快,但沒有可見的影像輸出;音視頻方案則多由 ASR、語言模型、TTS、動畫模組拼接而成,每個邊界都會疊加延遲,而且很少有系統公開端到端時延數字。Wan Streamer 把整個流程重新設計為可流式架構,包括因果編解碼器、block-causal attention、低延遲多模態 token 排程,在 25 fps 下最短流式單元可達 160 毫秒。

與常見做法的最大差異在於「端到端」與「同步影音輸出」。模型側延遲約 200 毫秒,加入 350 毫秒雙向網絡延遲後,總互動延遲約 550 毫秒,可支援亞秒級全雙工通訊。同時輸出語音與影片內容,而非分別由不同模組拼接,這是它最值得留意的特點。模型覆蓋聽、看、思考、說話、生成影像回應五種能力,適用於需要即時數字人、互動助理、虛擬陪伴等低延遲場景。

重點摘要:

  • 由阿里 Wan/通義萬相團隊研發,定位為即時互動基礎模型
  • 單一 Transformer 同時處理語音、影像、文字輸入與輸出
  • 模型側延遲約 200 毫秒,總互動延遲約 550 毫秒
  • 支援 25 fps 串流,最短流式單元 160 毫秒
  • 與拼接式方案相比,延遲更低且影音輸出真正同步

項目主頁: https://wan-streamer.com/

Categories: 阿里巴巴, Agentic, 數字人, 模型, 多模態模型, 視頻模型, 語音

EventVLA:長時序機器人操作加入事件記憶機制

EventVLA 是一個視覺語言動作框架,透過事件驅動的關鍵幀記憶機制,讓機器人在長時序任務中能回溯早期視覺證據,提升操作準確度。

EventVLA Overview

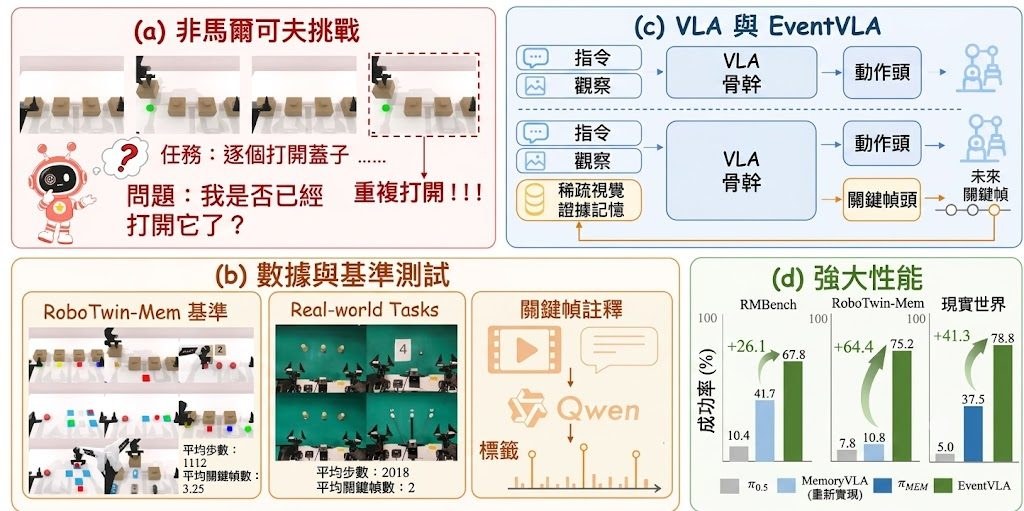
EventVLA 是一個由中國科學技術大學、上海人工智能實驗室、上海交通大學、大連理工大學、香港大學、清華大學、北京大學及華為等團隊共同開發的視覺語言動作(Vision-Language-Action, VLA)框架,專門針對長時序機器人操作任務設計。它解決的核心問題是:當機器人需要執行跨越許多步驟的任務時,往往必須回想起數十步之前出現過的視覺線索,而傳統 VLA 政策通常只依賴壓縮後的隱狀態,容易遺失早期關鍵畫面。EventVLA 的做法是引入事件驅動的視覺證據記憶(event-driven visual evidence memory),在執行過程中偵測與任務相關的事件,把對應的關鍵幀以原始影像形式存入記憶體,並在後續動作預測時重新取用這些畫面作為參考。

這個項目同時發佈了 RoboTwin-MeM 基準測試,這是建基於 RoboTwin 2.0 的記憶依賴型操作評測環境,包含八個需要長時序記憶的任務,例如依序拾取物件、按照紙上指示重複放下積木、依指示重現路線等。與同類 VLA 框架相比,EventVLA 的差異在於它不只壓縮隱狀態,而是保留原始關鍵幀影像作為可回溯的視覺證據,這在需要精確回憶早期空間配置的任務上特別有用。

部署與測試方式

  • 建議建立兩個 conda 環境:一個用於 RoboTwin-MeM 模擬,另一個用於 EventVLA 模型訓練與推論。
  • 從 Hugging Face 下載對應的 checkpoint(RoboTwin-MeM 或 RMBench 版本),搭配相應的評測腳本即可在模擬環境中重現結果。
  • 數據集同時提供 HDF5 軌跡格式與 LeRobot 2.1 訓練格式,方便不同訓練流程直接取用。
  • 目前程式碼已支援模擬訓練與評估,真實機器人推論與微調模型仍在開發中。

重點摘要

  • 核心機制:事件驅動的關鍵幀記憶,以原始影像儲存視覺證據而非僅壓縮隱狀態。
  • 配套基準:RoboTwin-MeM 包含八個長時序記憶依賴任務。
  • 目前狀態:模擬環境訓練與評估已開源,真實世界部署尚未釋出。
  • 適用場景:需要回溯早期視覺線索的多步驟機器人操作任務。

從已釋出的資源來看,研究人員與機器人團隊可直接透過 Hugging Face 上的 checkpoint 與 RoboTwin-MeM 數據集進行基準測試與模型微調,評估記憶機制對長時序任務表現的影響。

GitHub: https://github.com/InternRobotics/EventVLA

項目主頁: https://ganlin-yang.github.io/EventVLA.github.io/

模型: https://huggingface.co/ganlinyang/EventVLA/tree/main

Categories: 開源, 香港大學, 北京大學, 清華大學, 上海人工智慧實驗室, 華為, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, Qwen, Robotic, 框架, 香港, 深度學習, 中國

Page 21 of 27
1 … 19 20 21 22 23 … 27