一張平面圖變出 3D 房間?看懂 Code-as-Room

Code-as-Room 嘗試把單張俯視圖轉成可執行的 Blender 場景程式。概念清晰,特別適合關注 3D 自動生成的人留意。

Code-as-Room teaser

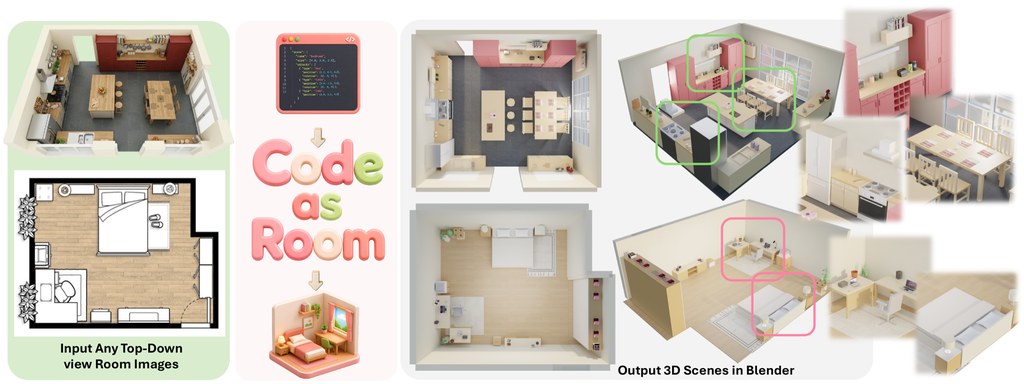
Code-as-Room 想處理的核心問題很直接:只靠一張房間俯視圖,怎樣較有系統地重建出可用的 3D 室內場景。它不是單純輸出一張效果圖,而是進一步產生 Blender 可執行程式碼,連同幾何、材質和燈光一併描述,方向相當實際。

現時公開資訊顯示,這個框架以多模態大型模型作為核心,並採用分階段流程,先理解房內物件與相對位置,再把結果整理成結構化程式表示。這種做法的特別之處,在於把「看圖生成」和「可重現的 3D 腳本」接起來,對後續修改、除錯和重用都更有幫助。

實際使用層面上,現時程式碼尚未正式釋出,所以比較適合先把它當成研究方向觀察。已經使用 Blender、關注室內建模、自動生成內容,或者想研究 AI 代理如何拆解複雜空間任務的人,可以先看論文與示例頁面,理解它如何由影像分析一路走到場景合成。

  • 由單張俯視圖推斷房間內物件與空間關係
  • 輸出重點不是圖片,而是 Blender 可執行程式碼
  • 採用多階段流程,處理幾何、材質與燈光
  • 適合 3D 內容生成、室內設計研究與代理式 AI 工作流

從相關技術脈絡看,它屬於 MLLM、agentic framework、scene understanding、code synthesis 與 Blender-based 3D generation 的交界。若之後開源內容完整,這類方法有機會成為由 2D 圖像快速建立可編輯 3D 房間的一種新工具;不過在未正式釋出前,效果細節與部署門檻仍要保守看待。
GitHub: https://github.com/YxuanAr/Code-as-Room

Paper: https://arxiv.org/pdf/2605.18451

Categories: 開源, 上海人工智慧實驗室

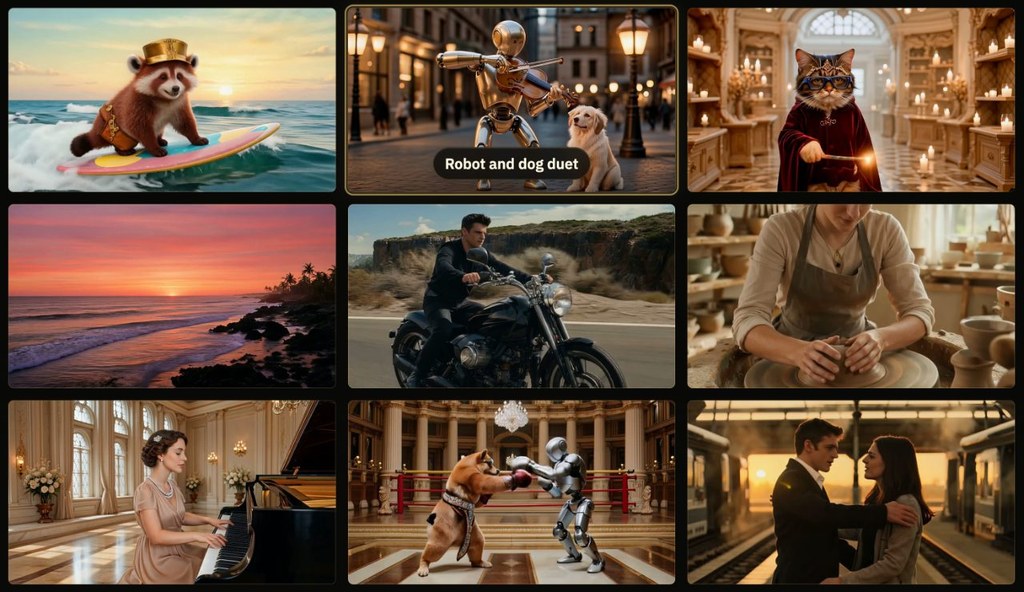
Lance:一個模型包辦圖像與影片

Lance 把理解、生成與編輯放進同一個多模態框架。對想同時處理圖片與影片的人來說,方向相當清晰。

Lance logo

Lance 是 ByteDance 推出的 3B 級多模態模型,重點不只是「識圖」,而是把圖片與影片的理解、生成、編輯放在同一套框架內處理。對一般讀者來說,最易明白的價值是:同一個專案可應付多種視覺工作,不用為每個任務分開找不同模型。

Lance 可處理的任務包括文字生成圖片、文字生成影片、圖片編輯、影片編輯,以及由圖片或影片輸出文字說明。環境方面需要 Python 3.10+、CUDA 12.4+,推理亦要至少 40GB VRAM 的 GPU,較適合有工作站或伺服器資源的團隊先做測試,再按任務修改預設參數與樣本配置。

它較有意思的地方,在於用 3B active parameters 去覆蓋多種視覺任務,並強調由零開始訓練,加上分階段的多任務訓練方法。這代表它的設計方向不是只追單一指標,而是希望不同任務之間互相帶動,令圖片與影片能力更集中在同一模型內。

  • 支援的任務範圍廣:t2i、t2v、image edit、video edit、x2t image、x2t video
  • 模型規模屬 3B,但官方稱在多項圖片與影片基準上表現不俗
  • 重點是統一框架,減少多模型切換的複雜度
  • 推理硬件門檻不低,較適合研究、內容工具開發及企業試驗

合適視覺 AI 研究、內容製作流程整合、需要同時處理圖像與短片的原型系統。相關模型方向可留意文字轉圖片、文字轉影片、影像編輯、影片編輯,以及視覺轉文字這幾類;Lance 的特點正是把這些能力盡量收攏到同一個模型體系之中。

GitHub: https://github.com/bytedance/Lance

Paper: https://arxiv.org/pdf/2605.18678

Categories: 開源, 字節跳動, 影像模型, 影像處理

LongLive:長片段影片生成再快一步

LongLive 專注解決長影片生成的速度與記憶體壓力,重點放在更長、更連貫的輸出流程。它同時照顧訓練與推理效率,方向相當清晰。

LongLive2.0 logo

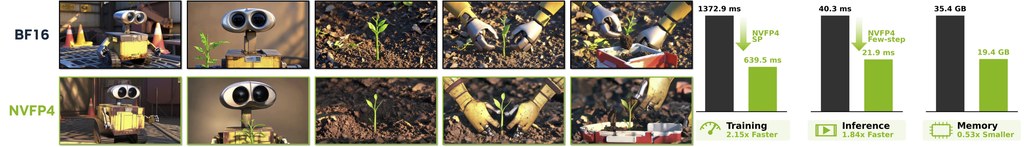
LongLive 係 NVIDIA NVLabs 針對長影片生成提出的基礎設施,核心目標唔係單純「整到片」,而係令模型喺處理長時間、多鏡頭內容時,冇咁易被記憶體同速度拖慢。由 1.0 強調即時互動式生成,到 2.0 加入 NVFP4 平行化設計,重點已經擴展到訓練、蒸餾同推理全流程。

實際使用時,較自然嘅路線係先睇示範頁同文件,了解佢點樣接收連續提示詞,再按需要選擇 BF16 或 NVFP4 模型版本。現有公開模型包括 LongLive-2.0-5B、LongLive-2.0-5B-NVFP4-S4,而較早期分支亦有 LongLive-1.3B,方便分別比較畫質、速度同硬件需求。

呢個專案最值得留意嘅地方,在於佢唔只優化生成結果,仲直接處理長影片常見樽頸,例如 KV cache 佔用、跨卡通訊、以及多鏡頭自回歸生成時嘅效率問題。資料顯示,2.0 版本支援多鏡頭或單鏡頭訓練、序列平行推理、非同步解碼,同時可用較低精度格式減少記憶體開銷;論文亦提到訓練與推理速度都有明顯提升,但實際表現仍要視乎 GPU 架構而定。

  • 支援長影片、多鏡頭連續生成,方向比一般短片生成更明確
  • 提供 BF16 同 NVFP4 版本,方便按硬件取捨
  • 針對訓練與推理一齊優化,唔係只顧其中一端
  • 包含序列平行、KV cache 量化、非同步解碼等工程設計
  • 適合研究人員、影片生成開發者,同埋需要評估部署效率嘅團隊

整體來講,LongLive 比較似一個面向進階影片生成工作流嘅「引擎室升級」,特別適合關注長片段敘事、互動式生成,或者想研究多鏡頭影片模型點樣落地嘅人。對一般讀者而言,最容易理解嘅價值就係:佢嘗試用更慳資源、更快嘅方式,令 AI 生成長影片唔再只停留喺概念展示。

GitHub: https://github.com/NVlabs/LongLive

Paper: https://arxiv.org/pdf/2605.18739

Categories: 開源, NVIDIA, 影像模型

CM-EVS:用更少視角看完整個場景

CM-EVS 用較少全景畫面覆蓋更多室內場景,重點在挑選視角而非盲目多拍。對做 3D 資料整理的人特別實用。

Repository image for Strange-animalss/CM-EVS

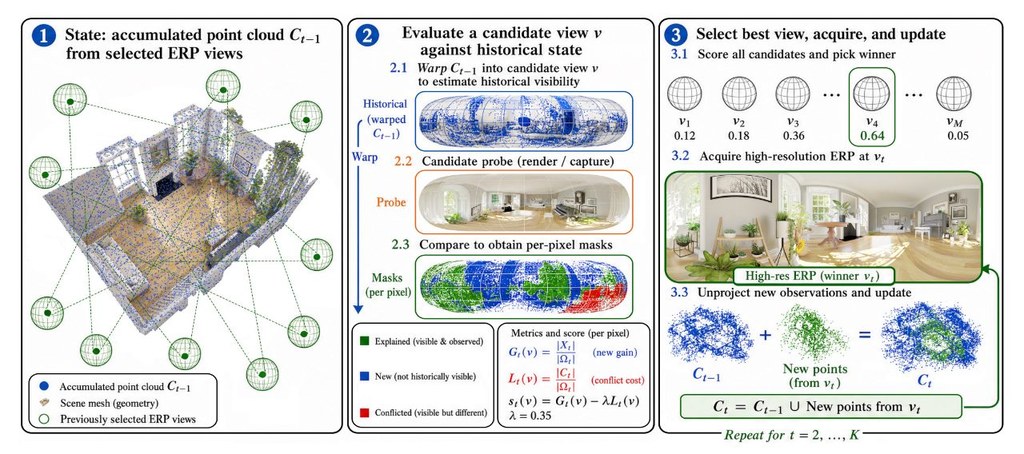
CM-EVS 係一個為 3D 場景整理全景 RGB、深度同姿態資料嘅流程工具,重點唔係不停輸出更多畫面,而係用較少但更有代表性嘅視角,盡量覆蓋完整場景。對需要建立訓練資料、檢查場景覆蓋度,或者整理室內空間視圖嘅工作,方向相當清晰。

實際使用時,較穩陣嘅做法係先由 Blender 室內場景路線開始,之後再按需要接 HM3D、一般 GLB 或 ScanNet++ PLY 這類來源。流程大致分成三步:先產生候選視角,再從中揀選衝突較低嘅視角組合,最後輸出已選畫面與相關記錄,方便重現結果同做後續核對。

呢個專案特別之處,在於佢唔單止計算「邊個視角睇到最多」,仲會考慮視角之間是否過分重疊,避免揀出一堆內容相似嘅畫面。對建立稀疏但有效嘅資料集尤其重要,因為畫面數量少啲,後續儲存、檢查同訓練成本通常都更易控制。

  • 支援統一資料格式,涵蓋 ERP RGB、range-depth 同 pose
  • 可處理多種來源,包括 Blender、HM3D/GLB、ScanNet++/PLY
  • 會輸出候選視角、逐步紀錄同已選結果,方便重做與比對
  • 核心模組拆分得較細,例如投影、深度與變形部分可獨立替換

適合對象包括做 3D 視覺、機械人感知、場景重建,或者要整理研究資料集嘅團隊。文中提到嘅相關資料來源與場景類型,主要有 Blender indoor、HM3D、generic GLB、ScanNet++,亦提及可延伸到戶外來源;不過從公開資訊睇,Blender 室內路線仍然係最建議先試嘅入口。

GitHub: https://github.com/Strange-animalss/CM-EVS

Paper: https://arxiv.org/pdf/2605.15597

Categories: 開源, 香港科技大學, 影像處理, 中國

Flash-GRPO:影片生成訓練再提速

這個專案聚焦影片擴散模型對齊訓練,用更省資源的方法換來更快效率。對研究型團隊尤其值得留意。

LOGO

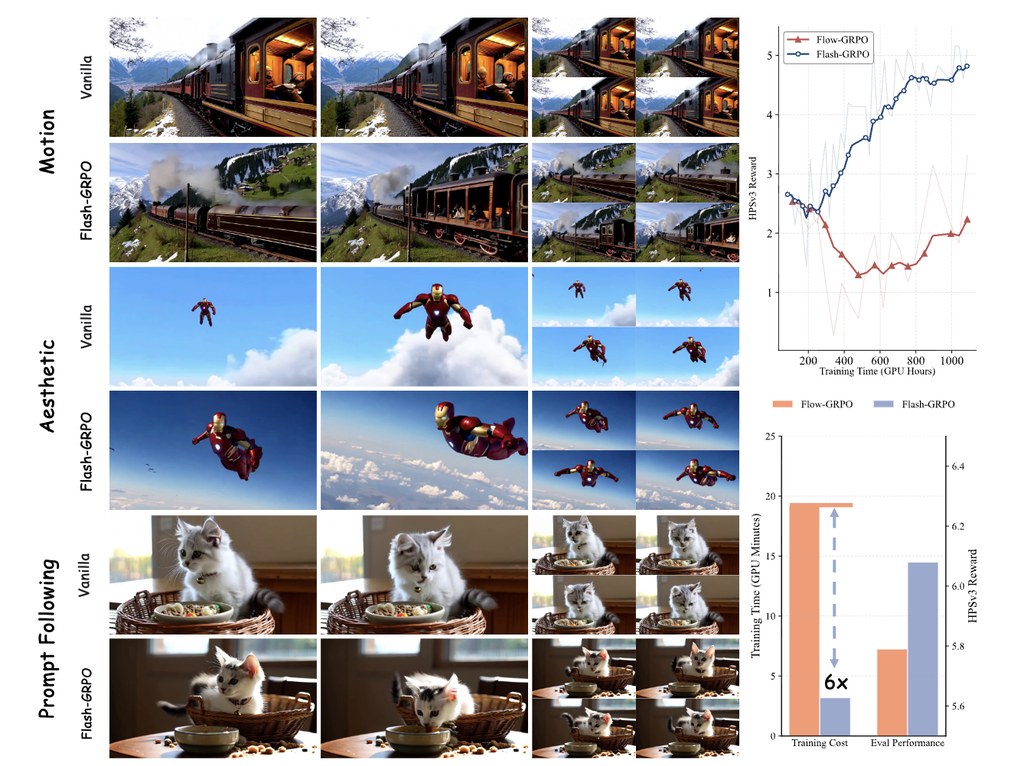
Flash-GRPO 針對的是影片生成模型訓練中一個很實際的難題:要令模型更貼近人類偏好或評分標準,傳統做法往往要走完整訓練軌跡,計算量高、時間長,對硬件要求亦相當重。這個專案提出單步式優化框架,重點是用較低運算預算,換取更有效率的對齊效果。

從公開資料來看,它主要面向影片擴散模型,並配合獎勵模型一同使用。實際動手時,需要先準備基礎模型 Wan2.1-1.3B,以及 README 提到的 HPSv3 獎勵模型,再按專案提供的訓練流程啟動;現階段較適合已熟悉 Python、分散式訓練和 GPU 環境的人直接試跑。

這個方法較有意思的地方,在於它不只是「少做步驟」,而是嘗試處理時間步之間訓練訊號不穩定的問題。README 提到兩個核心設計:一個是維持同一提示詞在時間上的一致性分組,另一個是修正不同時間步梯度尺度不一致的情況,目標是令訓練更穩定,也更容易比較模型表現。

  • 主打影片擴散模型的對齊訓練,而非一般文字模型微調
  • 強調單步式策略優化,方向上比完整軌跡訓練更省資源
  • 已在 1.3B 到 14B 規模模型做實驗驗證
  • 相關基礎組件,包括 Wan2.1-1.3B 與 HPSv3

整體來說,Flash-GRPO 比較適合做生成式 AI 研究、影片模型訓練優化,或想評估低成本對齊方案的團隊。對一般用家而言,它不是即裝即用的成品;但對需要在有限 GPU 預算下提升訓練效率的人,這個專案展示了一條相當值得關注的技術路線。

GitHub: https://github.com/Shredded-Pork/Flash-GRPO

Paper: https://arxiv.org/pdf/2605.15980

Categories: 開源, 清華大學, 影像模型, 中國

EffOPD:助訓練模型流程更精明

EffOPD聚焦優化模型訓練中的測試與搜尋流程。對研究型開發者來說,這是一個偏實驗導向、但方向清晰的專案。

Repository image for caiyuchen-ustc/EffOPD

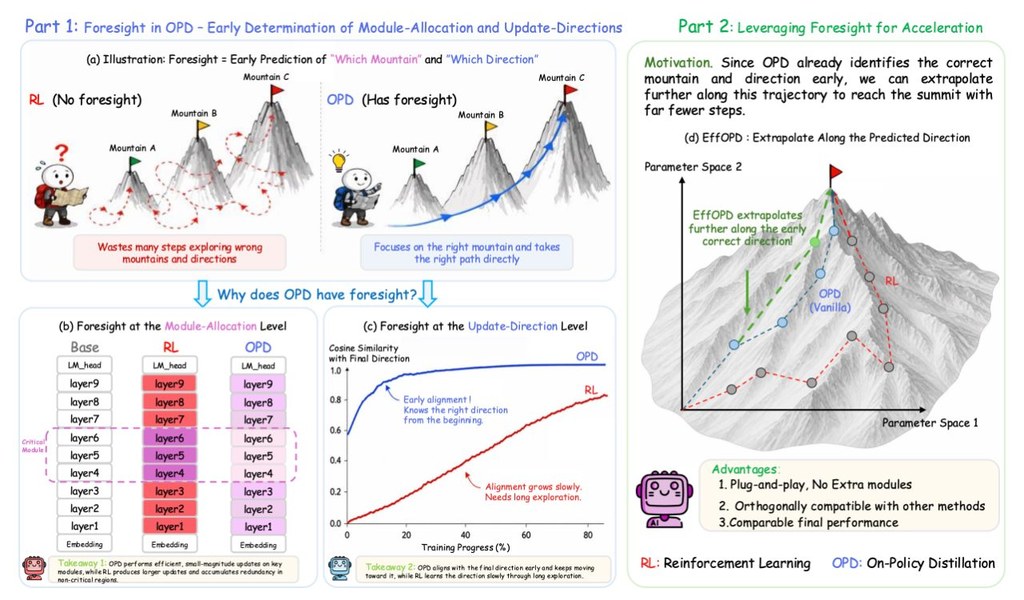
EffOPD 是一個圍繞模型訓練流程改良的研究實作,重點不在做一個全新聊天產品,而是在訓練途中更有效率地挑選值得評估的候選參數。從儲存庫資訊可見,它建基於 verl 與 GOPD,並調整訓練器與工作流程相關檔案,屬於偏底層的優化工具。

實際使用時,做法是沿用原本 OPD 的訓練流程,再加入迭代測試相關設定,並準備一份 parquet 格式的輕量驗證資料。這種安排的意思很直接:模型訓練到某些檢查點時,系統會額外評估幾個外推候選,而不是每次都用完整驗證流程,從而加快判斷。

專案想解決的,是大模型強化學習或蒸餾訓練中,評估成本高、嘗試路線多的問題。它較特別的地方,在於把「外推搜尋」和「即時輕量驗證」結合,讓訓練期間可以更早篩走不理想方向;儲存庫亦提到可設定每次最多測試 5 個候選,反映它著重效率與可控性之間的平衡。

  • 建基於 verl 與 GOPD,較適合已有相關訓練基礎的人
  • 透過啟用迭代測試,在訓練中加入外推式候選搜尋
  • 使用 parquet 驗證檔建立輕量驗證集,減少即時評估負擔
  • 可調整每個檢查點評估的候選數量,預設實驗值為 5

適合主要作為研究實驗、訓練流程調校,以及想比較不同訓練決策成本的人。相關脈絡上,儲存庫明確提到 OPD、GOPD 和 EffOPD,而論文方向亦圍繞大型語言模型的強化學習動態與 on-policy distillation;對一般用家未必即插即用,但對做模型訓練研究的人有參考價值。

GitHub: https://github.com/caiyuchen-ustc/EffOPD

Paper: https://arxiv.org/pdf/2605.11739

Categories: 開源, 香港科技大學, 騰訊, 模型訓練

InsightTok:令生圖文字人臉更清晰

這個專案專注改善生成圖片中最易失真的文字與人臉細節。對已有自回歸生圖流程的人來說,特別有參考價值。

Method

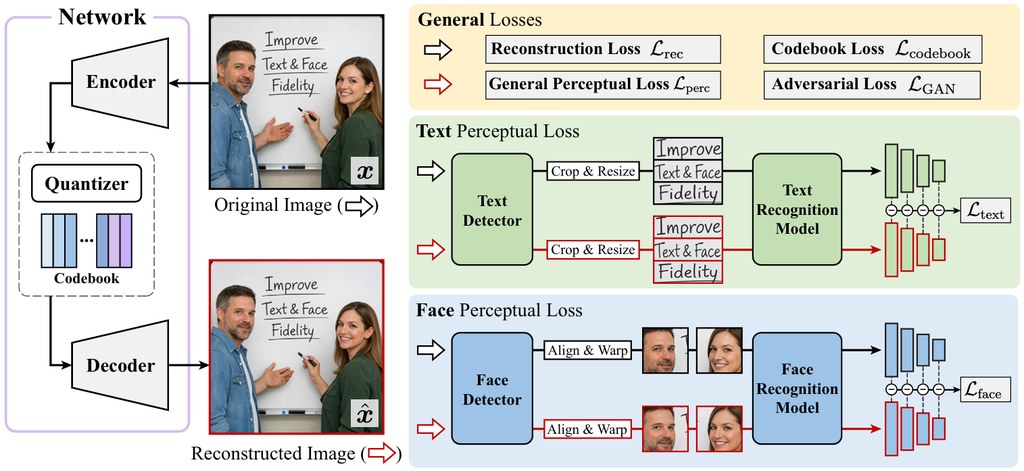
生成圖片時,最常令人出戲的往往不是背景,而是招牌上的字、海報上的字句,或者人臉五官的細節。InsightTok 針對的正正是這兩個難位:它不是直接改整個生圖模型,而是先改善圖片被「拆解成代碼」的方式,讓後續生成時更易保留重要內容。

實際使用上,這類專案較適合已經在做文字生成圖片、研究離散視覺 tokenization,或使用自回歸圖像生成流程的開發者與研究者。重點在於把原有流程中的視覺 tokenizer 換成 InsightTok 這一類方案,後面的生成模型理論上毋須大改,對現有管線算是較容易接入。

它的特別之處,在於沒有只用一般重建目標,而是更有意識地照顧局部而且重要的內容,例如文字區域與人臉區域。根據儲存庫提供的說明,它在相同壓縮率下,能做到更好的文字與人臉重建,同時只用 16× downsampling 和 16,384 個條目的 codebook,額外訓練成本亦相對有限。

  • 主要改善圖片中的文字可讀性與人臉細節還原
  • 可兼容標準自回歸圖像生成流程,毋須連下游模型一併重寫
  • 在相同壓縮條件下,重建效果主打更清晰、更忠於原圖
  • 設計上延續 VQGAN 風格 tokenizer 思路,但加強重點區域 supervision
  • 相關脈絡包括離散視覺 tokenizer、VQGAN 風格方法,以及文字生成圖片模型

整體來看,InsightTok 吸引之處不在花巧功能,而在於它抓到生圖最常被批評的痛點,再用相對務實的方法補強。對一般讀者來說,可以把它理解成一個「令 AI 更識得保住字同樣貌」的底層零件;對技術團隊而言,它較像是一個可直接提升畫面可用性的基礎組件。

GitHub: https://github.com/LeapLabTHU/InsightTok

Paper: https://arxiv.org/pdf/2605.14333

Categories: 開源, 清華大學, 視覺模型, 視頻模型, 微軟, 中國

FashionChameleon 讓換衫影片更即時

這個研究型專案主打即時換衫影片生成,重點是邊生成邊切換服飾,同時盡量保持動作連貫。

fashionchameleon

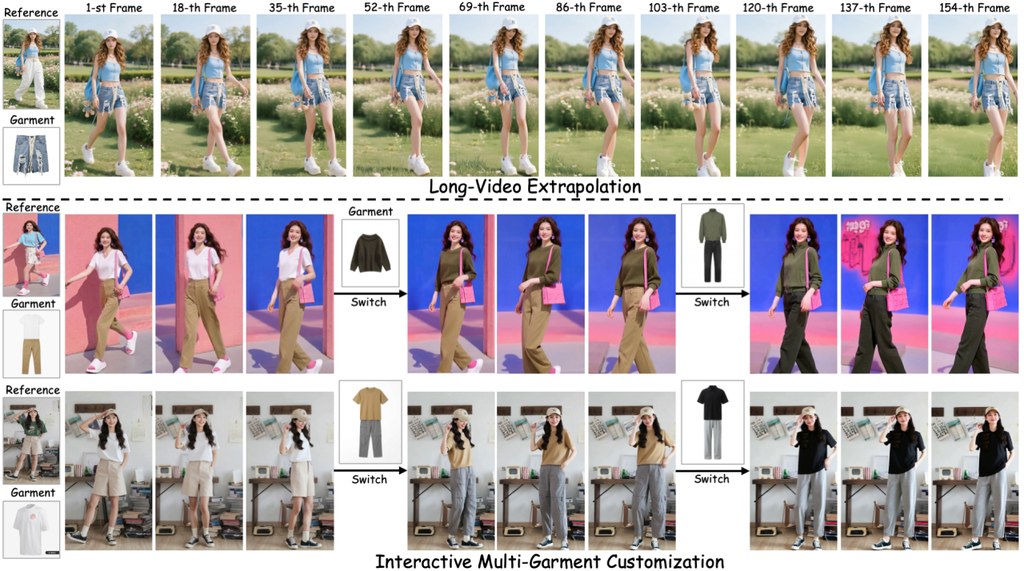
FashionChameleon 針對的是一個很實際的問題:想將人物影片中的服飾換款,但又不想等太耐,亦不想一換衫就令動作、姿勢或畫面穩定性明顯走樣。它把重點放在「生成途中仍可互動調整」,對電商展示、短片製作和虛擬試衫概念都幾有參考價值。

現階段較適合把它當成研究成果去了解,而不是即裝即用工具。公開資訊顯示,作者已提供論文和專案頁,但模型權重、前訓練與後訓練程式碼仍未完全釋出;想實際跟進,可先看示範頁面與技術報告,理解它點樣處理單件服飾影片資料,再留意後續更新。

它較特別的地方,在於不用依賴大量「同一人物不停換多套衫」的影片去訓練,改為先用單一參考圖與服飾圖建立學習方式,再透過串流式蒸餾提升長片段一致性。另一個亮點是生成期間可重整快取機制,令服飾切換更貼近即時互動,而不只是預先算好一條片。

重點可留意以下幾點:
– 主打人物服飾層面的影片客製化,而非單純換背景或整體風格
– 強調即時生成,論文提到單張 GPU 可達 23.8 FPS
– 目標是在換衫時保留動作連貫,減少前後畫面跳動感
– 訓練思路偏向用單件服飾資料學出可切換能力
– 現時較多是研究展示,部署門檻仍視乎後續釋出的程式與權重

相關模型方向可聯想到 image-to-video、人像影片生成、服飾替換與自回歸影片模型;文中亦明確圍繞 teacher model、streaming distillation 和 KV cache rescheduling 幾個核心設計。整體來說,FashionChameleon 最吸引之處不只是「識換衫」,而是朝住可互動、低延遲、長片仍較穩定這三件事同步推進,對需要即時預覽效果的應用尤其值得留意。

GitHub: https://github.com/quanjiansong/FashionChameleon

Paper: https://arxiv.org/pdf/2605.15824

Categories: 開源, 阿里巴巴, 視覺模型, 視頻模型

YingMusic-Singer 改歌詞也不用重唱

你可以把它理解成一個把歌詞、旋律和歌聲編輯放在同一條流程的框架,適合處理需要快速改詞、改旋律的歌聲生成工作。免手工對齊與零樣本能力,但 beta 版已停用,現時要改用 beta 分支。

pipeline

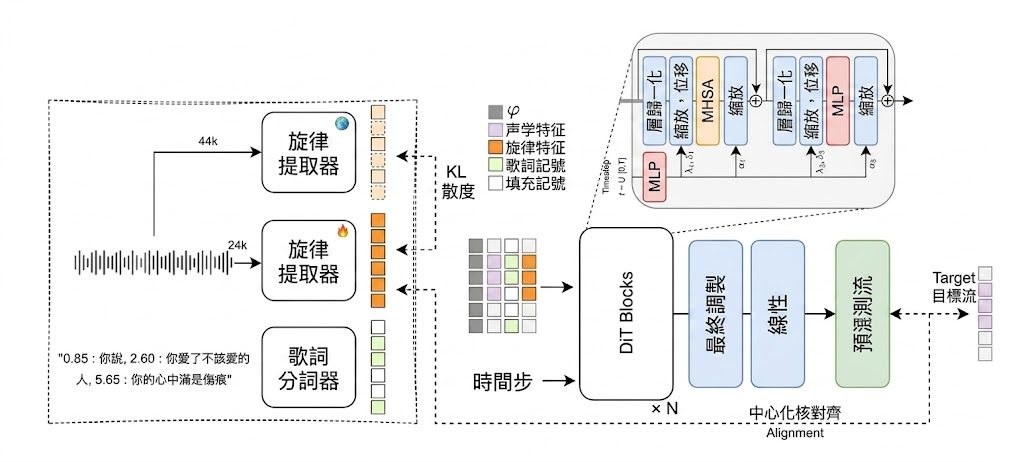
YingMusic-Singer 是一個 Zero-shot Singing Voice Synthesis (SVS) 與編輯框架,目標是解決歌聲合成裡最麻煩的對齊和標註成本。它把「用參考旋律生成新歌詞」和「直接改寫既有歌聲」放在同一套流程內,對要做快速原型、音樂內容改稿、或批量製作不同版本歌聲的團隊特別有吸引力。

它的核心做法是 Annotation-free Melody Guidance,不用再依賴昂貴的 phoneme-level alignment,亦不需要人工補 MIDI 標註。使用時可以餵入參考音訊,讓系統自動抽旋律;亦可以直接輸入 MIDI,令旋律來源更彈性。令它比傳統要逐句對齊的做法輕身很多,但也意味著成品質素會更依賴參考旋律本身是否清晰。

  • 支援 zero-shot 合成與編輯,兩種流程放在同一個框架內
  • 可由參考音訊自動抽旋律,亦可直接用 MIDI
  • 不需要針對目標聲線再做微調
  • beta 版已停用,現時要改用 beta 分支

技術上,它採用 Diffusion Transformer (DiT) 式生成模型,再配合預訓練旋律抽取模組,由參考音訊導出 MIDI 資訊,然後再做受控生成。加入 Flow-GRPO reinforcement learning 去改善發音清晰度、旋律準確度和音樂性,但現有公開資料未見完整量化表格。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 語音, 聲效, 音樂

CiteVQA

答啱問題未必代表可信。CiteVQA專門檢查模型有冇引用到真正證據位置。

CiteVQA overview

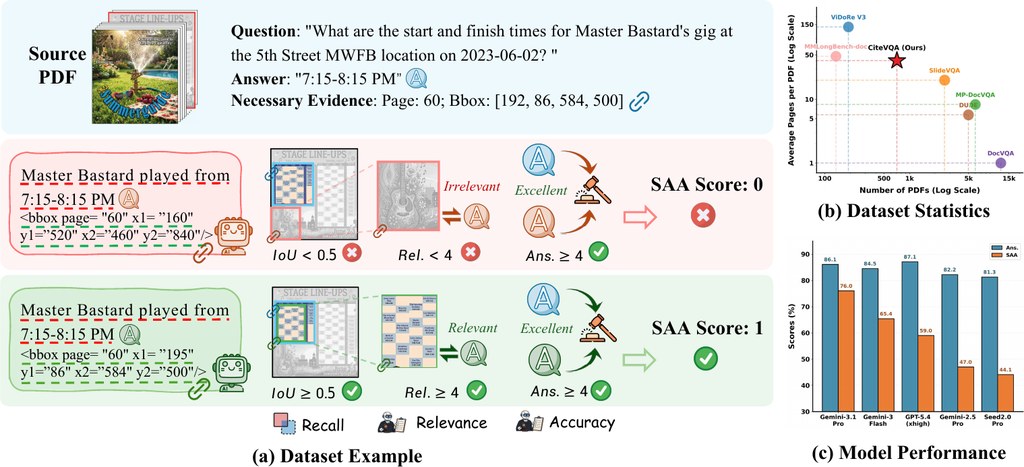
做文件問答評測時,很多工具只睇最後答案啱唔啱,但現實上,尤其是合約、財務報告、醫療文件呢類長篇 PDF,真正重要的是「答案來自邊一頁、邊一段、邊個區塊」。CiteVQA 針對的正正是這個缺口:它不只要求系統回答問題,仲要指出支撐答案的文件位置,而且細到元素層級,例如頁碼同區域框選。對想評估文件 AI 是否可靠的人來講,這比單純比拼答題分數實用得多。

實際使用上,這個專案較適合作為評測基準,而唔係一般用家即開即用的聊天工具。研究團隊、產品開發者或企業內部做文件自動化測試時,可以先取得資料集,再用自己的多模態模型跑推論,之後交畀評估程式比對答案與引用位置是否同樣正確。資料涵蓋英文與中文文件,來自 711 份 PDF、共 1,897 條問題,平均每份文件超過 40 頁,亦分成單一文件問答,以及要在多份文件中找答案的情境,難度相當貼近真實工作流程。

這個專案最值得留意的地方,是它把「答對」與「引對證據」綁埋一齊計分。核心指標 SAA 只有在答案正確,而且引用區域同標準證據對得上時先會得分,能更直接揭示模型有冇出現「講得似乎合理,但引用錯地方」的情況。根據公開結果,即使是表現較強的模型,答案分數與這種嚴格分數之間仍有明顯差距,反映現時不少系統其實未真正做到可追溯。這一點對高風險場景尤其重要,因為用戶要的不只是結論,仲要查得到根據。

重點可簡單整理成以下幾點:
– 不只評分答案,亦檢查引用證據是否真係來自正確頁面與區域
– 文件夠長亦夠真實,涵蓋 7 個大類領域、30 個細分類,並支援中英文
– 場景設計多樣,包括單文件、多文件但只有一份正確來源,以及多份來源都可能成立
– 適合測試文件型多模態模型,特別係要處理 PDF 版面、圖文混合與跨頁搜尋的系統
– 可用來比較模型可靠度,而唔係只比較誰的答案最似正解

從模型觀察角度看,這個基準亦提供了不錯的參考名單。公開結果提到的相關模型包括 Gemini-3.1-Pro-Preview、Gemini-3-Flash-Preview、GPT-5.4、Gemini-2.5-Pro、Seed2.0-Pro、GPT-5.2、Qwen3.6-Plus、GLM-5V-Turbo、Qwen3-VL-235B-A22B、Gemma-4-31B、Kimi-K2.5、Qwen3.5-397B-A17B 等。由這些結果可見,封閉模型在整體表現上暫時較領先,但開源模型同樣能作為對照組,方便團隊用統一方式測試自家方案。對要建立文件審核、知識搜尋、報告核對、法規查證流程的人來說,CiteVQA 的價值不在於幫你直接產生答案,而在於幫你分辨:哪個模型,才真係值得信。

GitHub: https://github.com/opendatalab/CiteVQA

Paper: https://arxiv.org/pdf/2605.12882

Categories: 開源, 上海人工智慧實驗室, Agentic, 中國

Page 89 of 118
1 … 87 88 89 90 91 … 118