CantoneseChat:會聽聲調語氣的粵語聊天 App

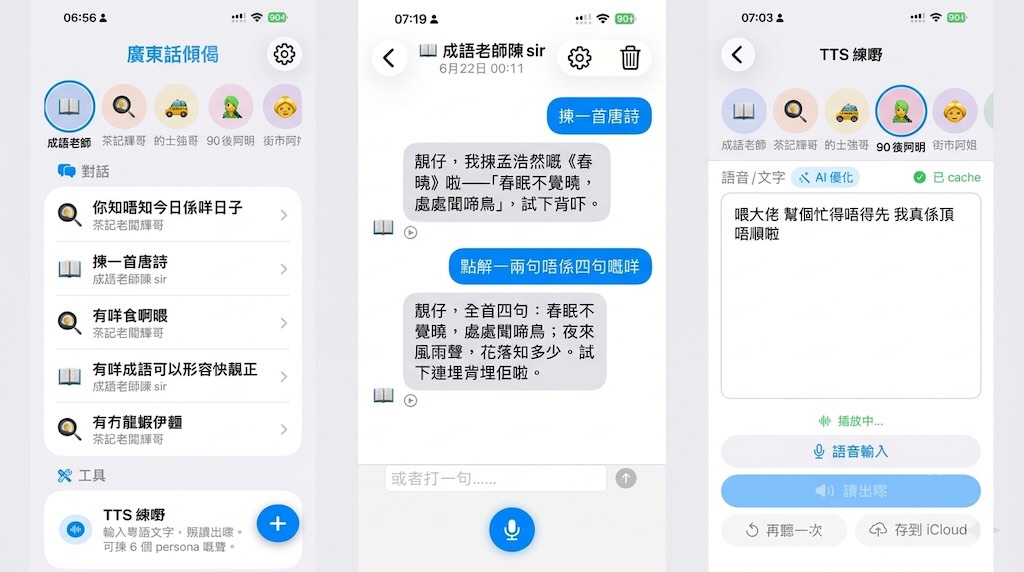
一個針對粵語互動而做的 iOS 項目,把語音辨識、語氣調整同 TTS 串成完整對話流程。重點不只在聊天,而是回應更貼近香港人口吻。

Cantonese Chat iOS app demo — Home / Chat / TTS Lab

CantoneseChat 是一個 iOS 粵語語音聊天工具項目,核心目標不是做通用聊天介面,而是把 iPhone 收音、on-device 粵語 STT、MiniMax cloud 的 LLM + TTS,以及 persona 語氣控制接成一條完整流程。它實際解決的問題,是一般語音助手識到字,但未必講得似香港人,亦未必會按說話者特徵調整語氣。

這個項目最值得留意的地方,是它會先用 AVAudioEngine 收音,再把音訊 downsample 去 16kHz,用 autocorrelation 估 pitch,推斷 VoiceTypeGenderAgeGroup,之後把結果注入 LLM system prompt。這種做法不是高精度聲紋身份辨識,而是偏向 heuristic 的語氣適配,所以速度會較直接,代價是分類準確度很受環境噪音、聲線變化同 pitch 規則影響。

安裝與理解方式也算清晰:它是 iPhone 真機導向的 iOS App,因為核心功能依賴 mic、AVAudioEngine、本機語音輸入同雲端模型串接,單看資料已可判斷模擬器未必能完整反映效果。測試時應分開看幾部分:persona 對話是否有語氣差異、TTS Lab 經 AI 粵語優化後是否更口語、pronunciation_overrides.txt 能否修正讀音,以及 iCloud export 有沒有順利保存音頻。

  • 支援 6 個 persona,適合示範同比較不同說話風格
  • 用 pitch heuristic 分類 VoiceType,再推斷 GenderAgeGroup
  • 整合 on-device 粵語 STT、MiniMax cloud 的 LLM + TTS
  • 提供 pronunciation_overrides.txt 修正粵語讀音
  • 可將生成音頻匯出到 iCloud Drive

適合想做香港市場語音互動介面,例如客服示範、教育對話、角色語音內容,或者想研究粵語人機互動體驗的小團隊。若你重視可控語氣、多 persona 展示同本地口語感,它有明確方向;若你追求嚴格年齡性別判斷,這套規則式分類就應視為體驗輔助,而不是可靠的人口統計模型。

相關模型與模組包括 MiniMax cloud 的 LLMTTS、iOS on-device 粵語 STT,以及項目內以 pitch 為基礎的 VoiceType 分類流程。公開資訊未見標準基準測試或 OSWorld 這類評測結果,所以較合理的判斷方式,是把它看成一個完成度不錯、偏產品原型取向的粵語語音互動項目。
GitHub: https://github.com/elbartohub/CantoneseChat

Categories: 開源, 文字轉語音, Audio, 香港, 語音, 蘋果, MiniMax, 廣東話

PhysiFormer 用座標預測物理運動

這是個用世界座標模擬3D物體運動的擴散模型。它把剛體、彈性體與多物件互動放進同一個生成框架。

Og image

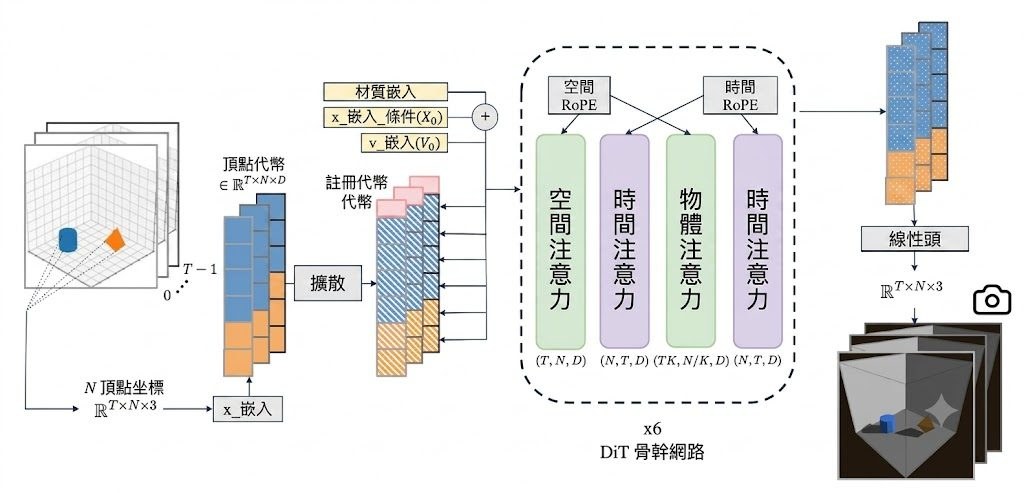
PhysiFormer 是一個 diffusion transformer 模型,用世界座標中的 3D mesh 直接模擬物體運動。它要處理的是在已知初始頂點位置、速度與材質條件下,生成之後一段時間內合理可信的 4D 動態軌跡。

它和常見 video world models 的分別,在於不是在視角相關的像素空間推測畫面變化,而是直接預測 world coordinates 裡的 vertex trajectories。論文指出,這個做法不依賴手動指定的模擬結構、shape latent,亦不需要明確加入 rigid-transform prediction 一類限制,改用單一步驟的去噪擴散過程學習完整時域軌跡。

模型同時支援 rigid 與 elastic 物件,亦能處理 mixed-material dynamics、碰撞,以及靜止與移動中的多個物件。為了提升效率,PhysiFormer 採用在時間、空間與物件三個維度分解的 attention,令多物件推理保留 permutation-invariant 特性,毋須額外手動編碼物件身份。

  • 3D coordinate diffusion 建模,重點是視角無關而且幾何結構清晰
  • 用超過 100k simulated trajectories 訓練,覆蓋多種剛體與彈性體運動
  • 可生成多個合理未來,而非只輸出單一路徑,適合存在未觀察不確定性的情境
  • 它在 trajectory accuracy、rigidity preservation 與 momentum-based physical consistency 上明顯優於 autoregressive baselines

這類項目較適合 robotics、graphics、physical design,以及需要幾何感知 world modelling 的工作流。現有資料顯示它對未見過的真實幾何形狀、更大的物件數量,以及混合材質場景有一定泛化能力,但內容主要來自模擬資料與論文結果,真實部署表現仍要配合具體場景再驗證。

項目主頁: https://yimingc9.github.io/physiformer/

Paper: https://arxiv.org/pdf/2606.27364

Categories: 開源, 模型, 世界模型, 模型訓練, Video, Robotic, 框架, Vibe Coding, Content Creator, 3D, 深度學習

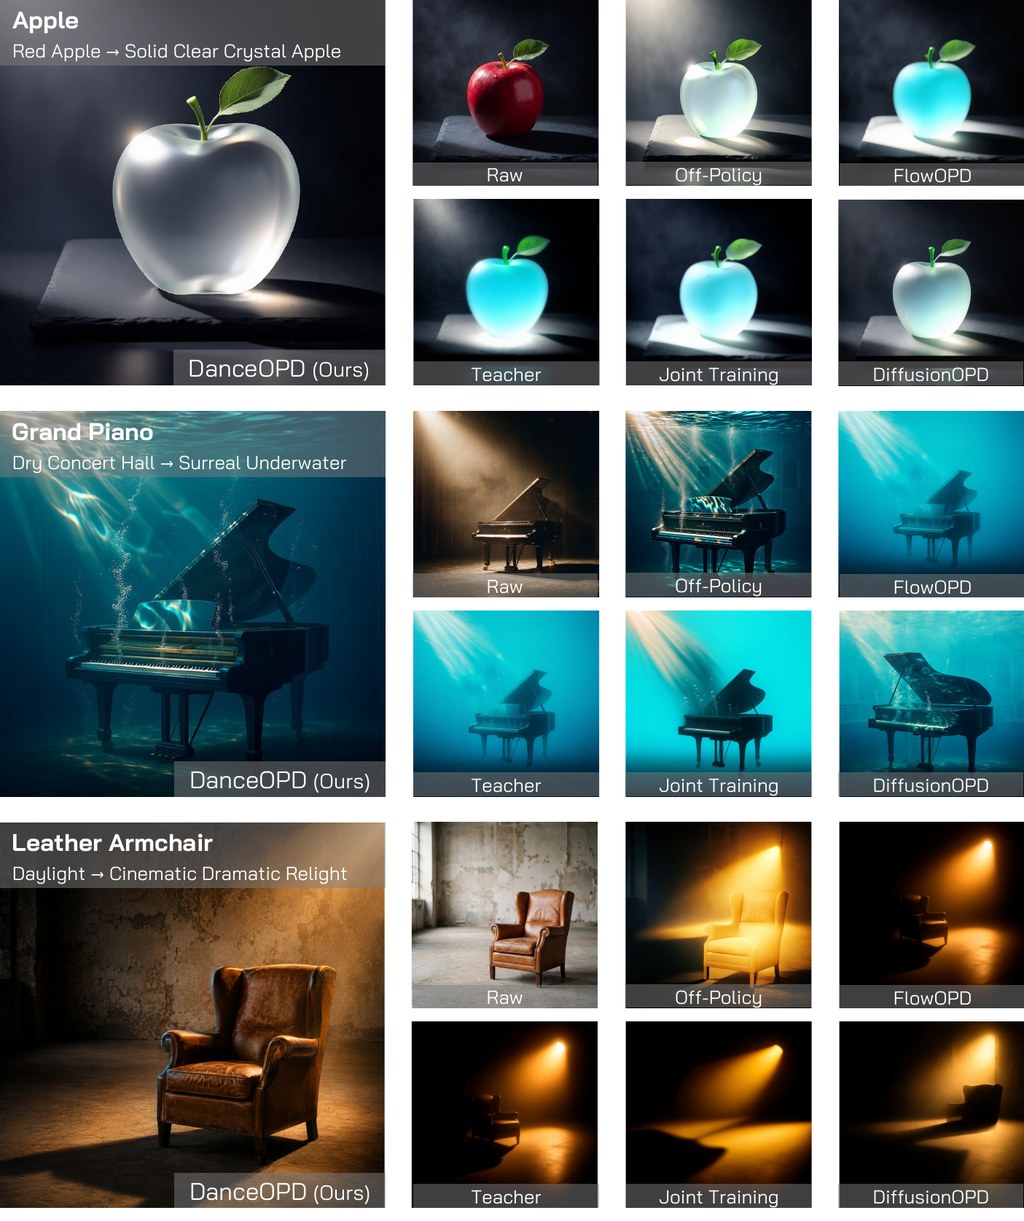
DanceOPD:多能力影像生成的場景蒸餾框架

DanceOPD 提出 on-policy 生成場景蒸餾方法,將不同影像能力整合到單一模型,同時保持 T2I 與編輯表現。

ByteDance Seed

DanceOPD 是一個針對 flow-matching 模型設計的 on-policy 生成場景蒸餾框架,目標是讓單一影像生成模型同時具備文字生成影像(T2I)、局部編輯與全域編輯等多種能力。核心做法是將每個來源能力視為一個速度場(velocity field),然後在學生模型自己產生的 on-policy 狀態上查詢這個場景,再以簡單的速度 MSE 損失進行訓練。

這套方法最值得留意的差異在於 hard-routed 設計:每個樣本只被路由到一個被選中的能力場,並且只查詢一個低噪聲的語義側狀態(semantic query),避免了對多個來源場景做平均而模糊語義身份的問題。同一套框架也能吸收 operator-defined fields,例如 classifier-free guidance,讓引導機制自然融入訓練。

在評估方面,DanceOPD 報告了多項指標,包含 GEditBench-avg 在 T2I + Edit Composition 上達到 5.347、GenEval Overall 達到 0.849 同時保持 T2I 表現,以及 Local + Global Edit Composition 的 5.498、CFG 吸收診斷中 5.833 的最佳值。

這項工作適合關注多能力影像生成整合、蒸餾方法以及 flow-matching 模型研究的開發者與研究者。由於 Code 標示為「Soon」,目前尚未提供源碼或模型下載,因此暫無可對應的安裝或使用步驟可分享。

主要重點:

  • 核心定位:flow-matching 模型的 on-policy 生成場景蒸餾框架
  • 方法差異:hard routing 單一能力場景加單一低噪聲語義查詢,避免場景平均造成的語義模糊
  • 支援能力:T2I、局部編輯、全域編輯,並能吸收 classifier-free guidance 等 operator-defined fields
  • 評估數字:GenEval 0.849、GEditBench T2I+Edit 5.347、Local+Global 5.498
  • 現有狀態:論文可在 arXiv 瀏覽,原始碼尚未公開

項目主頁: https://danceopd.github.io/

Paper: https://arxiv.org/pdf/2606.27377

Categories: 開源, 字節跳動, 模型, 模型訓練, Image, 影像模型, txt2img, 框架, 教學, Content Creator, 深度學習

ShutterMuse:拍照當下即時引導構圖與姿勢的多模態模型

ShutterMuse 是統一多模態大型語言模型,針對拍照瞬間提供構圖決策與人物姿勢推薦,並隨附 CaptureGuide 資料集與評測基準。

ShutterMuse logo

ShutterMuse 是一個統一的多模態大型語言模型(MLLM),專門用於拍照瞬間的攝影引導,解決「按下快門前該怎麼構圖、被攝者該擺什麼姿勢」這個長期被忽略的問題。傳統做法多以「事後美學裁剪」為主,只評估模型能否從既有照片中挑出最佳裁切區域,卻沒有涵蓋拍攝當下的構圖決策,更完全不處理被攝者的姿勢推薦;通用型 MLLM 雖然能給出構圖建議,卻難以精準定位需要調整的區域,而專門的美學裁剪模型雖然定位能力強,卻只能處理裁切這一項任務,兩者皆無法提供結構化、可即時執行的姿勢指引。ShutterMuse 透過同時輸出「保留/微調/重拍」三類構圖決策,搭配 COCO-17 關鍵點與可見度資訊的姿勢骨架,把拍攝引導整合成單一模型。

CaptureGuide-BenchCaptureGuide-Dataset 是這個項目的兩大支柱:前者涵蓋構圖決策/微調與姿勢推薦兩類互補任務,後者包含約 13 萬筆樣本,附帶文字推理與結構化視覺標註,供監督式微調與強化學習微調使用。從評測結果來看,ShutterMuse 在攝影師端引導的 IoU 達到 74.30、BDE 降至 0.054、MLLM-Score 為 0.64,皆優於 Gemini-3.0-Pro、GPT-5.5 與 Venus 等對照組;在被攝者端姿勢推薦方面,平均分數與互動性指標亦具競爭力,且推論時間與 token 消耗明顯低於 Nano-Banana-Pro 與 GPT-Image-2。

這個項目由復旦大學與 StepFun 共同開發,模型權重、評測腳本與範例已於 Hugging Face 與 GitHub 同步釋出。原始資料提供了模型下載連結與項目頁面的示範影片,部署細節需參考項目頁面或模型卡片的後續說明。

重點摘要

  • 統一處理構圖決策(保留/微調/重拍)與姿勢推薦兩類拍攝引導任務
  • 隨附 CaptureGuide-Dataset(13 萬樣本)與 CaptureGuide-Bench 兩項資源
  • 在 CaptureGuide-Bench 多項指標上超越 Gemini-3.0-Pro、GPT-5.5 與 Venus
  • 姿勢推薦推論成本低於 Nano-Banana-Pro 與 GPT-Image-2
  • 適合攝影教學、智慧相機助理、AR 拍攝引導等需要即時回饋的場景

對攝影 App 開發者、相機廠商研究團隊,或任何想把「構圖教練」與「姿勢教練」整合進拍攝流程的產品而言,ShutterMuse 提供了一個可直接微調與評測的起點;至於一般使用者,則可先透過 Hugging Face 上的模型權重與項目頁面示範影片了解其能力,再依官方後續釋出的腳本進行本地部署。

GitHub: https://github.com/lijayuTnT/ShutterMuse

項目主頁: https://lijayutnt.github.io/ShutterMuse/

模型: https://huggingface.co/ShutterMuse/ShutterMuse

Categories: 開源, 模型, 視覺模型, OpenAI, Image, 影像處理, 教學, 工具, Dataset 數據集

UnityShots:多鏡頭影音生成的記憶驅動新方案

由快手 Kling Team(快手) 與學界合作推出,UnityShots 把單鏡頭擴散模型改造成可保持人物、場景與聲音一致的多鏡頭敘事系統,並釋出 200 段基準測試集。

UnityShots Logo

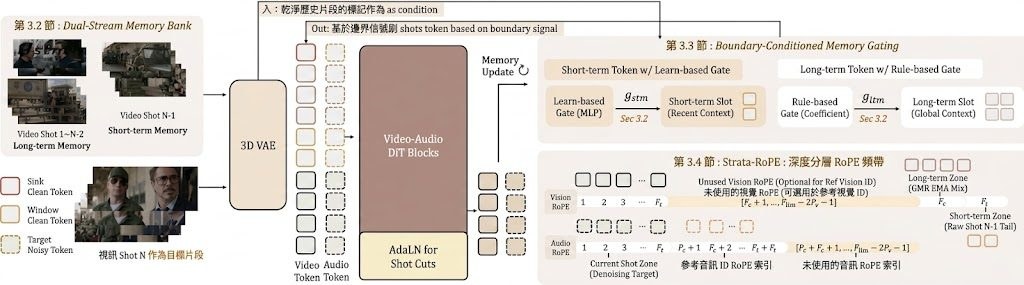
UnityShots 是一個研究性質的多鏡頭影音生成框架,核心任務是解決現有方法在長序列多鏡頭影片中難以維持人物、場景與聲音一致性的問題。它基於已有的單鏡頭影音擴散模型 LTX-2.3(22B 參數)建構,從一段結構化提示詞直接生成 3 至 9 個鏡頭的連續 .mp4 影片,確保角色容貌、場景光影與配音語音在各鏡頭間保持連貫。

現有做法通常依賴三種路線:端到端訓練固定長度序列但難以擴展、以記憶庫逐鏡頭生成但容量隨鏡頭數線性膨脹,或用大型語言模型規劃器調度預訓練生成器而缺乏多鏡頭感知骨幹。UnityShots 的切入點是引入邊界感知門控(Boundary-Aware Gating)與雙槽記憶機制:影片流維持兩個固定大小記憶槽,長期記憶(LTM)錨定開場鏡頭,短期記憶(STM)保留前一鏡頭尾部,兩者在每次剪接時由門控網路更新;音訊流則在每個鏡頭注入參考說話者 token,避免滑動音訊庫的負擔。另一個辨識度高的設計是透過 AdaLN 學習離散剪接類型先驗(cut-type prior),讓使用者可在推論階段調整轉場強度。

以下為重點摘要:

  • 類型:多鏡頭影音生成研究框架,附帶資料集與基準測試。
  • 核心差異:用固定大小雙記憶槽取代線性增長的記憶庫,並加入參考語者 token 維持聲音一致性。
  • 控制能力:剪接類型先驗成為推論時可調旋鈕,使用者可指定轉場強弱。
  • 相關模型:以 LTX-2.3 22B 為基座,整合 AdaLN 門控機制。
  • 資料集:釋出 UnityShotsBench,涵蓋六大文化區域、13 種語言的 200 段多鏡頭序列。

現有評估涵蓋 I2V、T2V、R2V 三種條件模式,UnityShots 在跨鏡頭一致性與音畫品質上與開源及閉源基準相當。對從事多鏡頭敘事、短影音自動化或數位人內容生成的團隊而言,這套框架提供了較完整的記憶與控制設計思路。原始資料庫明確指出,檢查點、訓練程式碼與代理系統尚未釋出,因此目前無法從儲存庫直接取得安裝指令或模型權重;讀者若有興趣部署,需等待官方後續發布。資料集本身可從 Hugging Face 的 KlingTeam/UnityShotsBench 下載,供研究者評測自家模型。授權為 CC BY-NC 4.0,僅限非商業學術用途。

GitHub: https://github.com/JIA-Lab-research/UnityShots

項目主頁: https://jackailab.github.io/Projects/UnityShots/

Paper: https://arxiv.org/pdf/2606.21661

Categories: 開源, 香港中文大學, 香港科技大學, 清華大學, 字節跳動, 數字人, 模型, 視頻模型, Video, 提示詞, 框架, 香港, , 語音, LTX

TryOnCrafter:首個鏡頭可控的影片虛擬試穿框架

TryOnCrafter 是首個支援鏡頭軌跡控制的影片虛擬試穿框架,以 4D 代理模型分離人物與背景,實現任意視角的試穿效果。

TryOnCrafter teaser

TryOnCrafter 是一個基於 DiT(Diffusion Transformer)的虛擬試穿影片框架,專門處理「鏡頭可控影片虛擬試穿」(Camera-controllable Video Virtual Try-on, CaM-VVT)這個新任務。它的主要用途是讓使用者能夠在指定鏡頭軌跡(例如推近、傾斜、環繞)的情況下,生成穿著指定服裝的人物影片。

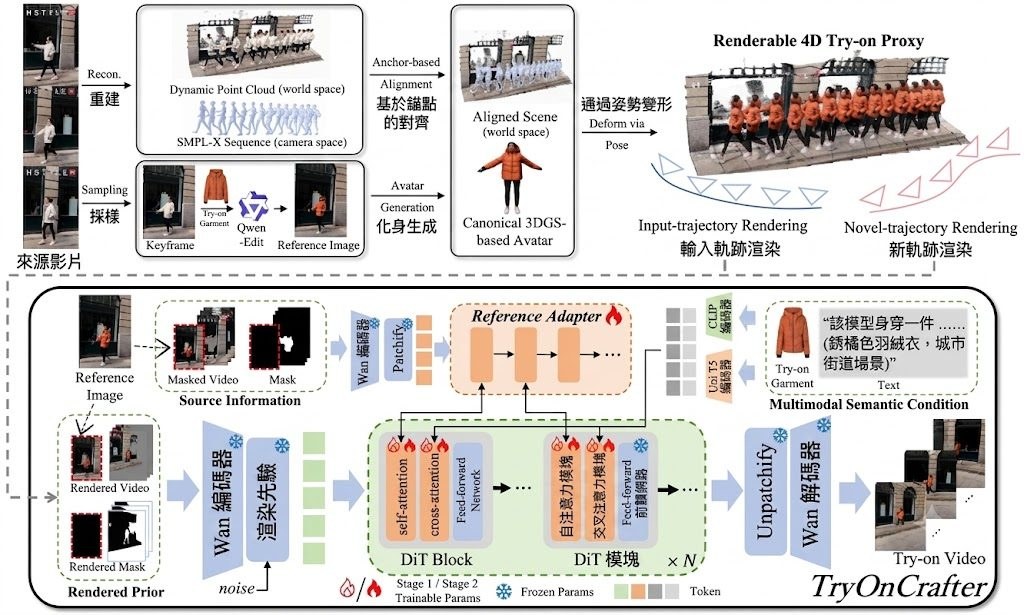
傳統的影片虛擬試穿只能沿著原始影片的鏡頭路徑生成結果,無法讓使用者自由改變視角。TryOnCrafter 的做法是引入一個「可渲染的 4D 試穿代理」(Renderable 4D Try-on Proxy),先把 2D 試穿結果提煉成一個基於 3D Gaussian Splatting(3DGS)的穿衣化身,再用 SMPL-X 序列驅動動作,最後把這個化身對齊到重建的背景點雲中。這個代理模型把人物與環境分離開來,提供穩定的幾何骨架,讓後續的影片生成能夠在任意鏡頭下保持結構一致。

在生成階段,框架採用 Proxy-Anchored Video DiT,把代理模型渲染出來的多層資訊(包括渲染先驗、參考特徵、服裝語意提示)作為幾何錨點,確保最終影片在指定軌跡下保持物理合理的形變與外觀。這種設計同時支援多項延伸應用,包括人物重新定位、子彈時間效果,以及 360 度環繞檢視。

團隊建立了 CaM-VVTBench 評測基準,結果顯示 TryOnCrafter 在結構一致性與服裝身份保留方面,明顯優於現有方法。這個框架較適合需要展示服裝 3D 效果的研究團隊、電商內容製作,以及對鏡頭語言有要求的多媒體創作場景。

重點摘要

  • 首個鏡頭可控試穿框架:突破傳統 VVT 只能被動沿用原片鏡頭的限制,支援使用者自訂鏡頭軌跡。
  • 4D 試穿代理模型:以 3DGS 化身 + SMPL-X 動作序列,把人物與背景解耦,提供密集幾何引導。
  • Proxy-Anchored Video DiT:以代理渲染結果作為幾何錨點,確保任意視角下的結構與服裝一致性。
  • 多元延伸應用:支援人物重定位、子彈時間、360 度環繞等下游編輯。
  • 新基準 CaM-VVTBench:團隊建立的專用評測集,在結構一致性與服裝身份保留上明顯領先既有方法。

模型與源碼說明:原始資料為項目主頁,未提供具體的源碼下載連結、安裝步驟或模型權重取得方式。

項目主頁: https://sunhao242.github.io/TryOnCrafter_web.github.io/

Paper: https://arxiv.org/pdf/2606.26092

Categories: 開源, 阿里巴巴, AI productions, RAG, 數字人, 模型, 視覺模型, 視頻模型, Video, 影像模型, 影像處理, 框架

多模態程式碼生成論文整理:視覺輸入如何改變寫程式

一份聚焦於「看圖寫程式」的論文清單,涵蓋 UI、圖表、SVG、CAD 等多模態程式碼生成的研究與基準。

mllm code logo

Awesome-Multimodal-LLM-for-Code 是一份論文整理型資源庫(paper list / survey collection),專門蒐集「多模態大型語言模型(Multimodal LLM, MLLM)用於程式碼生成」相關的研究論文、基準測試與評估方法,核心任務是把「視覺輸入」與「程式碼輸出」串接起來,例如把 UI 截圖、圖表、SVG 向量圖、CAD 草圖轉成可執行的程式碼。

傳統的 text-to-code 研究主要處理純文字描述生成程式碼,但很多真實任務的意圖是透過圖片、影片或互動畫面來表達的,純文字範式無法處理版面配置、視覺語意與互動行為等約束。這個資源庫把研究切成清楚的子題,包括 Web/Mobile UI 程式碼生成、科學圖表程式碼生成、視覺豐富的程式設計題、SVG 生成、簡報生成、UML、CAD、海報、3D 點雲、遊戲程式碼,以及程式修復等,方便研究者按場景查找對應論文。

與一般 Awesome 列表相比,這份資源的差異在於聚焦於「視覺證據如何影響程式正確性」,並收錄了 Design2Code、ChartMimic、Chart2Code、StarVector、PPTAgent、ScienceAgentBench 等具代表性的基準測試與模型。從支援資料可以看到,附帶的 survey 論文進一步把領域分成 GUI、科學視覺化、結構化圖形與前沿任務四大類,並指出視覺相似度不足以評估正確性,還需要語意、互動與領域約束的證據。

前端工程師、資料視覺化研究者、AI 程式碼助手開發者,以及做 benchmark 設計的人特別有用,能快速掌握 MLLM 在程式碼任務上的最新進展與評測方法。

重點摘要:

  • 屬於論文整理資源庫,聚焦多模態程式碼生成
  • 涵蓋 UI、圖表、SVG、CAD、簡報、3D 等十多個子題
  • 收錄 Design2Code、ChartMimic、ScienceAgentBench 等基準
  • 強調視覺相似度不足以評估程式正確性
  • 原始資料未提供安裝或部署方式,僅供論文索引與閱讀

GitHub: https://github.com/xjywhu/Awesome-Multimodal-LLM-for-Code

Categories: 開源, 香港中文大學, 香港大學, 南京大學, 香港, 編程, 中國

DomainShuttle 開源:把主角穿梭到任何風格的影片

香港科技大學 C4G 團隊發表 DomainShuttle,以 14B 參數規模實作跨域主體一致性影片生成,並釋出權重與推理代碼。

teaser

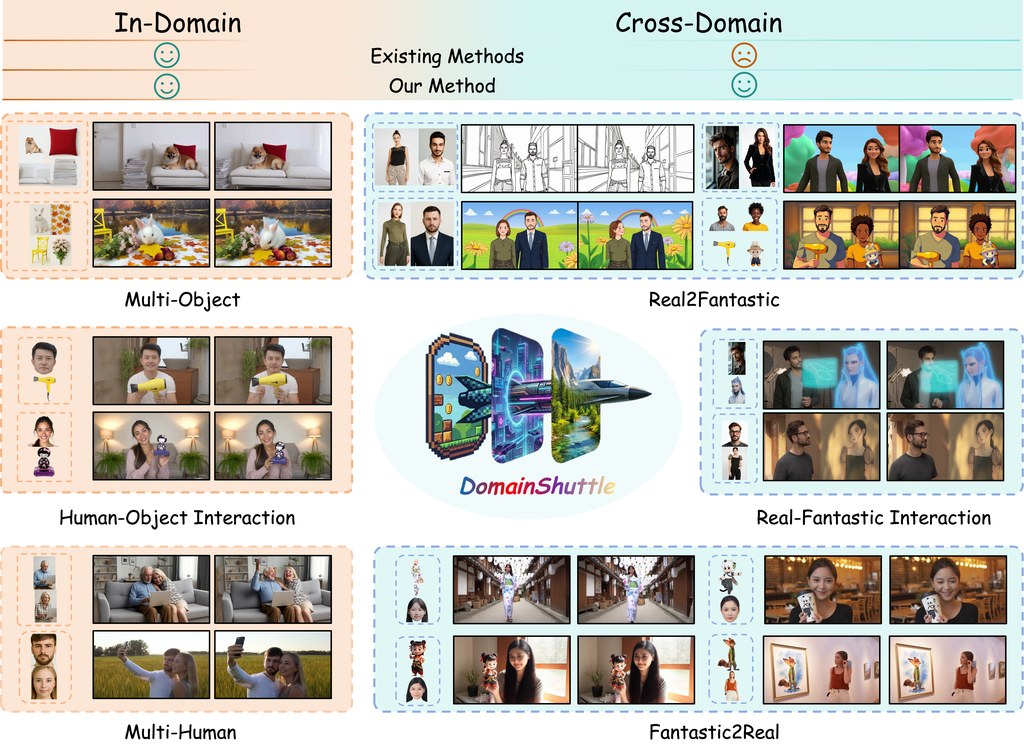
DomainShuttle 是一個以 Wan2.2-T2V-A14B 為基底的 subject-driven text-to-video(主體驅動文字轉影片)框架,目標是讓用戶提供一張參考圖後,能在不同視覺風格與場景中維持同一角色的身份一致性。過去的 subject-driven 方法多在 in-domain(與訓練資料同域)下能保留主體細節,但一旦跨域到風格差異大的場景,主體往往走樣或失去身份特徵;DomainShuttle 把參考特徵與影片特徵解耦,並引入 domain attribute 建模與 intrinsic subject representation,試圖兼顧 in-domain fidelity 與 cross-domain editability。

開發團隊來自香港科技大學 C4G 實驗室,作者群包括 Nan Chen、Yiyang Cai、Rongchang Xie、Junwen Pan、Cheng Chen、Weinan Jia、Zhuowei Chen、Wen Zhou(項目負責人)、Zhenbang Sun 以及通訊作者 Wenhan Luo。等貢獻作者共同發表技術報告,並同時釋出 14B 規模的非官方權重與推理代碼。

先以 conda 建立 Python 3.10 環境並安裝 PyTorch 2.5.1(CUDA 12.4),接著執行 build_env_conda.sh。模型準備分兩步:先用 huggingface-cli 下載 Wan-AI 的 Wan2.2-T2V-A14B 作為基底模型,再下載 CNcreator0331/DomainShuttle_weight,最後將 VAE、configuration.json 等檔案移入指定的 ./models/Diffusion_Transformers/Wan2.2-DomainShuttle-A14B/ 目錄。原始資料未提供完整推論指令片段,相關細節需參考技術報告與項目頁面的後續說明。

從示範結果看,DomainShuttle 能在寫實人物、動漫風、Ghibli 風、3D 動畫風等不同域之間切換,同時保留臉部與服飾特徵,跨域 personalisation 效果明顯。適合短片創作、角色 IP 化、廣告分鏡與動畫預覽等需要「同一角色穿梭多場景」的團隊。需注意目前釋出的是非官方實作,且依賴 14B 規模的基座模型,部署對顯存要求較高。

重點摘要:

  • 類型:subject-driven text-to-video 框架,建基於 Wan2.2-T2V-A14B
  • 開發團隊:香港科技大學 C4G 實驗室,Wen Luo 為通訊作者
  • 核心設計:解耦參考與影片特徵、加入 domain attribute 與 intrinsic subject representation
  • 與同類差異:強調 cross-domain editability,補足過往方法跨域走樣的缺陷
  • 資源:已釋出 14B 權重、技術報告與推理代碼,需 CUDA 12.4 環境

GitHub: https://github.com/HKUST-C4G/DomainShuttle

項目主頁: https://cn-makers.github.io/DomainShuttle/

模型: https://huggingface.co/CNcreator0331/DomainShuttle_weight

Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Stable Diffusion, Video, 框架, 香港, Content Creator, IDE, 3D, Python NLP, Python, 動畫

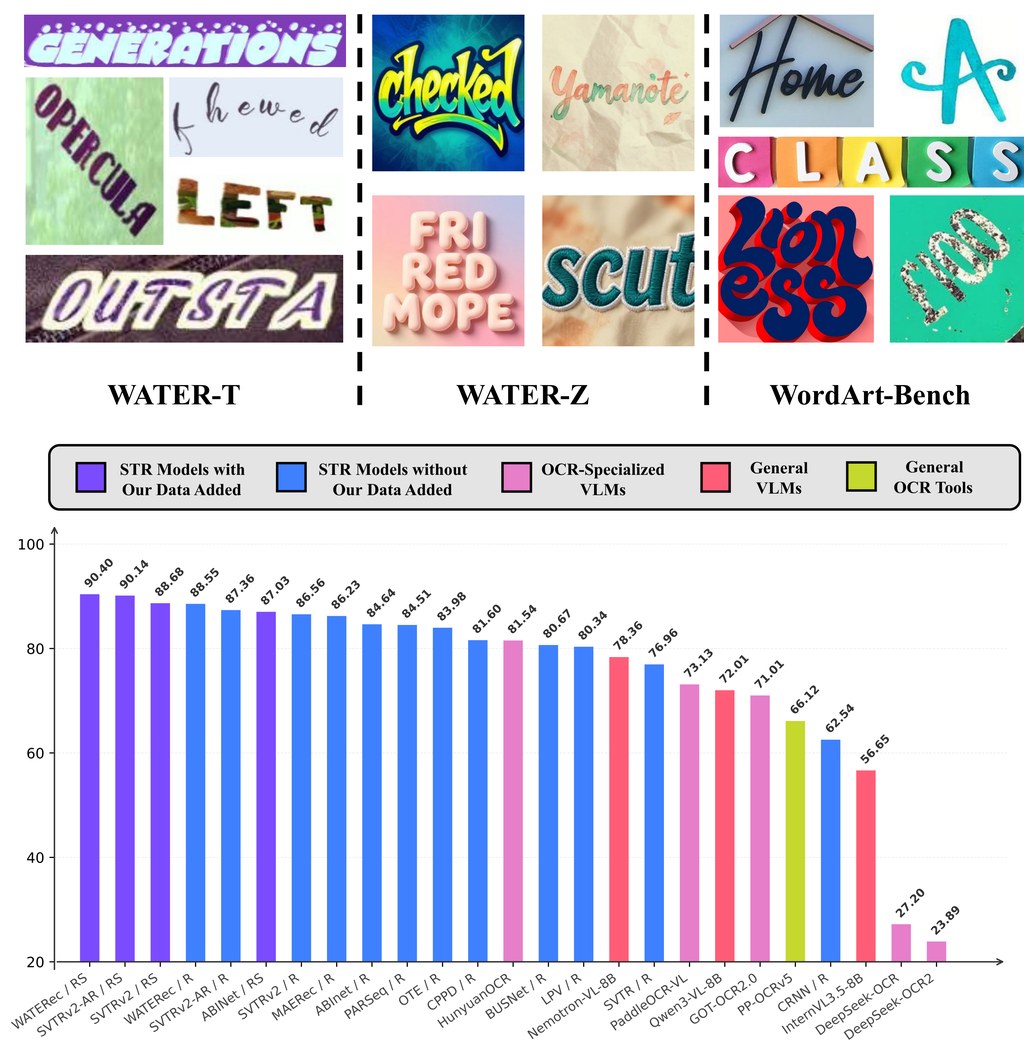
WATER:WordArt 場景文字識別新突破

復旦大學與騰訊 WeChat Vision 團隊推出 WATER 項目,從數據與模型兩端突破藝術文字識別瓶頸,於 WordArt-Bench 創下 90.40% 準確率。

overview

這是一個由復旦大學(上海多模態具身 AI 重點實驗室)與騰訊 WeChat Vision 聯合發佈的研究項目(屬於數據集+模型基準組合),同時收錄於 ECCV 2026。針對 WordArt-oriented scene TExt Recognition(WATER)這項任務,原有 STR 數據集與方法普遍圍繞「規則場景文字」與「固定模板輸入」建構,難以應對 WordArt 高度自訂的字體、紋理與版面,因此表現受限。WATER 從兩端突破:數據方面構建 2M 規模合成數據集 WATER-S,模型方面提出支援任意形狀輸入的 STR 基線 WATERec。

WATER-S 數據集設計包含兩個互補子集:WATER-T(1M)由 SynthWordArt 渲染引擎透過 11,250 款藝術字體生成,提供高可控的精準合成樣本;WATER-Z(1M)則結合 Qwen3-VL 提示詞挖掘與 Z-Image 影像合成,覆蓋更真實且多元的場景。再搭配 WATER-R(3.2M,整理自 Union14M-L、WordArt、WAS-R 並去重)作為真實訓練集,整體數據規模較既有藝術文字數據提升數百倍。

WATERec 模型架構採用類似 NaViT 的編碼器搭配 RoPE,支援任意形狀輸入,再以自回歸解碼器處理複雜版面,從結構上打破固定模板 STR 的瓶頸。在 WordArt-Bench 上以 90.40% 準確率成為首個突破 90% 的結果,大幅超越 HunyuanOCR(81.54%)及其他通用或 OCR 專用視覺語言模型。

使用方法需配合外部資源:WATERec 訓練與推理程式碼位於 OpenOCR-WATERec 倉庫;模型權重、數據集(包含 WordArt-Bench)、273K 條 WATER-Z 提示詞模板與 112K 款藝術字體皆託管於 HuggingFace。複製本倉庫後,可透過 SynthWordArt/ 目錄取得 WATER-T 渲染流程,prompts/ 目錄提供 caption_mining.py 與 fewshot_expansion.py 兩階段提示詞挖掘,Z-Image/gen_zimage.py 支援多 GPU 並行生成,eval_vlm/ 則整合 Qwen3-VL-8B、InternVL3.5-8B、GOT-OCR2.0、DeepSeek-OCR-2、PaddleOCR-VL、PP-OCRv5、HunyuanOCR、Nemotron-VL-8B 等基線評測腳本。

重點摘要:
– 復旦大學與騰訊 WeChat Vision 團隊合作,獲 ECCV 2026 收錄
– WATER-S 含 WATER-T(字體渲染)與 WATER-Z(VLM + 影像合成)兩條合成路徑
– WATERec 以任意形狀編碼器 + 自回歸解碼器突破固定模板限制
– WordArt-Bench 90.40% 為首次突破九成,超越 HunyuanOCR 等專用 VLM
– 所有模型、數據、字體與提示詞均開源於 HuggingFace

從評估對照來看,不論是通用 VLM、OCR 專用 VLM 或一般 OCR 工具,在 WordArt-Bench 上皆明顯落後於 WATERec,反映藝術文字仍是當前多模態模型的弱項。對從事海報辨識、品牌素材處理、廣告設計自動化,以及需要處理高度風格化文字的團隊而言,這套數據+模型組合是目前少數針對該場景強化的開源方案。

GitHub: https://github.com/YesianRohn/WATER

模型: https://huggingface.co/Yesianrohn/WATERec-Models

Categories: 開源, 北京大學, 騰訊, 模型, 視覺模型, 多模態模型, DeepSeek, Image, 深度學習, 中國, Dataset 數據集

Semantic Browsing:用樹狀圖掌控 AI 生圖的多樣性

Tel Aviv 大學團隊提出 Semantic Browsing,以多智能體流程把單一文字提示展開成可瀏覽的語意樹,讓圖像生成的多樣性變得可控且可解讀。

Og image

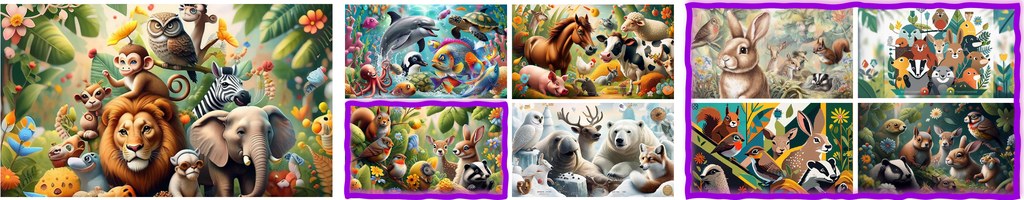
Semantic Browsing 是一篇發表於 ECCV 2026 的學術項目,由 Tel Aviv University 的 Sara Dorfman、Maya Vishnevsky、Omer Dahary、Or Patashnik 與 Daniel Cohen-Or 共同開發。它針對文字生成圖像模型在重複取樣時容易「語意塌縮」、產出過於雷同的問題,提出一套可控多樣性的工作流程。

這套方法的核心做法,是把多樣性從像素層級搬到文字層級。系統會先用多智能體(multi-agent)流程把使用者的提示擴寫成結構化的場景 JSON,記錄物件、屬性、互動與整體場景設定,再從中找出提示中未明確指定、但合理的變化軸心。每一次分支都對應一個明確的語意決定,例如角色、構圖或風格的差異,最終形成一棵可瀏覽的場景樹。

與一般常見做法相比,這個項目最值得留意的差異在於:變化不是來自隨機噪聲,而是來自可解讀的語意約束。樹狀結構讓使用者可以沿著特定分支往下探索,同時保留先前已固定的條件,方便在設計空間中做有意識的導覽。

重點摘要:

  • 開發團隊:Tel Aviv University 的 Sara Dorfman、Maya Vishnevsky、Omer Dahary、Or Patashnik 與 Daniel Cohen-Or。
  • 核心方法:以多智能體流程把提示展開為結構化 JSON 場景樹。
  • 可控多樣性:每個分支對應一個明確的語意決定,而非隨機變化。
  • 適用情境:概念設計、視覺探索、需要比較多個語意詮釋的創作流程。
  • 目前狀態:程式碼尚未公開,僅釋出 arXiv 論文與項目頁。

使用方法詳細教學:

  1. 準備提示:先寫好一段文字提示,例如「A poster featuring animals」,提示中可以刻意留白部分細節,讓系統有空間展開變化。
  2. 進入項目頁:前往 Semantic Browsing 的官方網頁(saradorfman1.github.io/SemanticBrowsing-webpage/),等待互動介面載入。
  3. 送出提示並生成根節點:系統會先推論出一個初始場景詮釋,作為場景樹的根節點。
  4. 瀏覽與選擇變化軸心:介面會列出可變化的語意面向,例如角色、構圖、風格等,每個面向都會顯示目前值與替代選項。
  5. 展開分支:選定一個面向並挑選替代值後,系統會呼叫多智能體流程,在保留先前約束的前提下產生新的子節點與對應圖像。
  6. 沿著分支深入探索:可以重複步驟四與五,沿著感興趣的路徑繼續往下展開,逐步建立一棵專屬的設計樹。
  7. 匯出或記錄結果:若需要保留特定分支,可記下該節點的場景 JSON 或截圖,作為後續迭代或團隊溝通的依據。

由於程式碼尚未釋出,目前只能透過項目頁的示範介面體驗流程;待官方開源後,便能整合進 ComfyUI、Stable Diffusion 等本地生圖工作流。對於從事概念設計、視覺探索,或需要比較多個語意詮釋的創作者與研究人員來說,這套方法提供了一條比隨機抽樣更可控的探索路徑。

項目主頁: https://saradorfman1.github.io/SemanticBrowsing-webpage/

Paper: https://arxiv.org/pdf/2606.23679

Categories: 開源, ComfyUI, Agentic, 模型, 視覺模型, Stable Diffusion, Image, 影像處理, 教學

Page 43 of 91
1 41 42 43 44 45 91