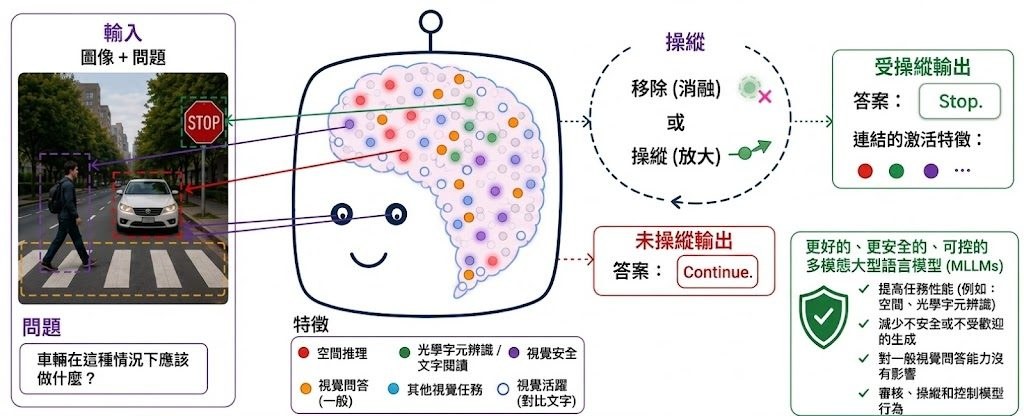
MMDiff(Multimodal Model Diffing)係一套研究型方法,處理嘅問題唔係再訓練模型,而係先睇清楚多模態大型語言模型(Multimodal Large Language Models, MLLMs)入面邊啲特徵因為視覺訓練而改變,再將呢啲特徵移除或引導。對要做審核、除錯、對齊行為嘅團隊,呢種做法比單靠黑盒輸出更實用。
研究人員可先下載 HuggingFace 資料集,按 text 或 omni 軌道接入自己的記憶模型,再利用網站和 Dataset Explorer 檢查案例。適合開發 mobile agents、personalized assistant、長期 RAG 或 multimodal memory 的團隊;涉及健康紀錄、家庭相片等私人內容時,仍要自行確認資料授權、匿名化和端側部署要求。