OneStreamer 讓串流影片懂得記憶與適時回應

影片畫面離開視窗後,OneStreamer 仍可保留具時間線索的證據,並自行判斷何時已有足夠資訊回應問題。

OneStreamer

直播影片一閃即逝,畫面離開模型的視覺視窗後,之後的提問仍可能需要引用那些細節。OneStreamer 屬於串流影片大型語言模型,處理的正是記錄證據、理解新畫面,以及在資料足夠時主動回應之間的取捨。

它以 Qwen3-VL-4B-Instruct 為基礎,OneStreamer-4B 透過 Proactive Hierarchical Caption Memory(PHCM)保存局部細節和已完成事件摘要,再配合近期畫面作答,減少重看歷史影片特徵的需要。Proactive State Transition Learning(PSTL)則保留輸出錨點,挑選具代表性的狀態變化與持續狀態,只有 27.5% 標註狀態 tokens 需要監督。

你可從 Hugging Face 取得 OneStreamer-4B 模型及 OneStreamer-1M 數據集,配合串流影片、問答或字幕資料測試;儲存庫目前提供模型、數據集和示範頁面,但完整推理指令未在提供內容中列出,因此部署前仍需確認執行框架、硬件需求和輸入格式。OneStreamer-1M 合併串流字幕、串流 QA 及整理後的開源資料,共有 1.16M 筆互動記錄。

八項涵蓋線上感知、記憶和主動回應的基準測試中,OneStreamer-4B 在比較方法中取得最高的整體結果;這對需要持續觀看教學、監控或家庭影片的團隊較有參考價值,但生成式記憶仍可能受字幕品質、延遲和錯誤累積影響。

  • PHCM 同時保留局部細節與完成事件摘要
  • PSTL 針對回應時機和重複等待狀態作訓練
  • 模型、數據集及示範頁面均已公開
  • 八項基準測試涵蓋感知、記憶與主動回應
  • 適合研究串流影片理解及長時間上下文的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 南京大學, AI productions, 模型, 視覺模型, 模型訓練, Qwen, Video, 框架, 教學, 庫, Dataset 數據集

WorldLine 讓機械人先看見動作後果

WorldLine 把機械人動作轉成影像及空間訊號,預測場景如何變化,再協助評估策略及規劃操作。

Repository image for Zhengsh123/WorldLine

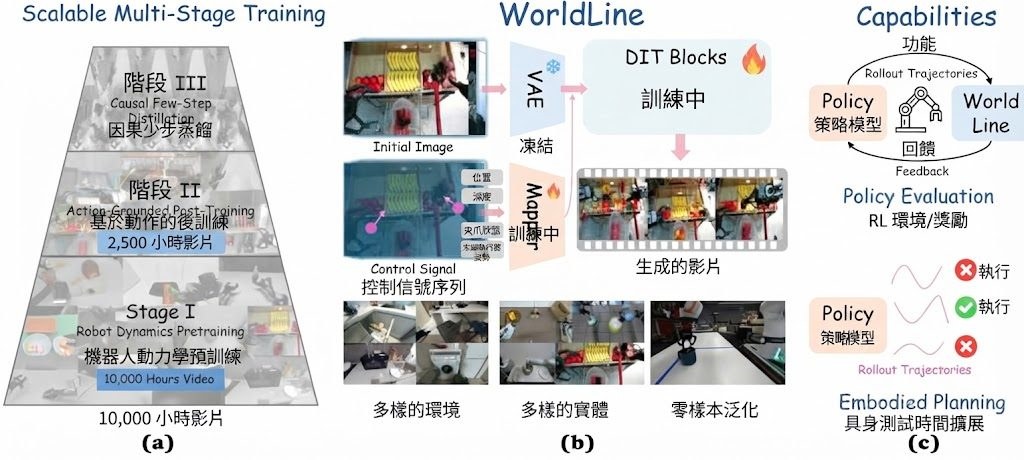
機械人要搬動物件前,WorldLine 可以先在視覺模擬中預測動作會如何改變場景,減少每次都依賴實體試錯。它屬於面向機械人操作的世界模型及視覺模擬器,處理的是「控制指令如何造成可觀察結果」這個核心問題,而不是按照任務文字生成畫面。

WorldLine 先用超過10,000小時的無動作標註機械人影片學習機械人與物件的互動,再把末端執行器的位置、深度、方向及夾爪狀態投影到經校準的相機視角。這些 image-space actions 成為不同機械人之間的共同介面;另外超過2,000小時、涵蓋10多種 embodiments 的動作軌跡,負責把通用 dynamics 對應到個別控制方式。

WorldLine 把 action grounding 分開處理,較有利於跨機械人及跨鏡頭遷移,代價是需要校準相機、動作軌跡及失敗案例。模型以 block-autoregressive 方式因果 rollout,每個區塊用四步 denoising 生成,兼顧互動速度與預測細節,但不代表能取代真實環境驗證。

  • 用於 policy evaluation、embodied planning 及實體操作前的預測
  • 以 image-space action 統一不同機械人的視覺控制介面
  • 透過 multi-view、failure-enriched training 及 relational regularization 強化互動敏感度
  • 以 few-step distillation 減少 rollout 所需計算

研究團隊包括香港科技大學、Joy Future Academy、北京大學及香港中文大學。較適合研究機械人學習、視覺規劃及模擬器的團隊先按程式碼建立推理環境,再以不同 camera view、embodiment 和失敗動作測試預測穩定性;需要即時控制的人員則應同時量度延遲、動作偏差及真實機械人的遷移落差。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港科技大學, 北京大學, AI productions, 模型, 視覺模型, 世界模型, 模型訓練, Video, Image, 香港, Dataset 數據集

OmniEcho:讓智能體真正「聽聲辨位」的全方位音視覺模型

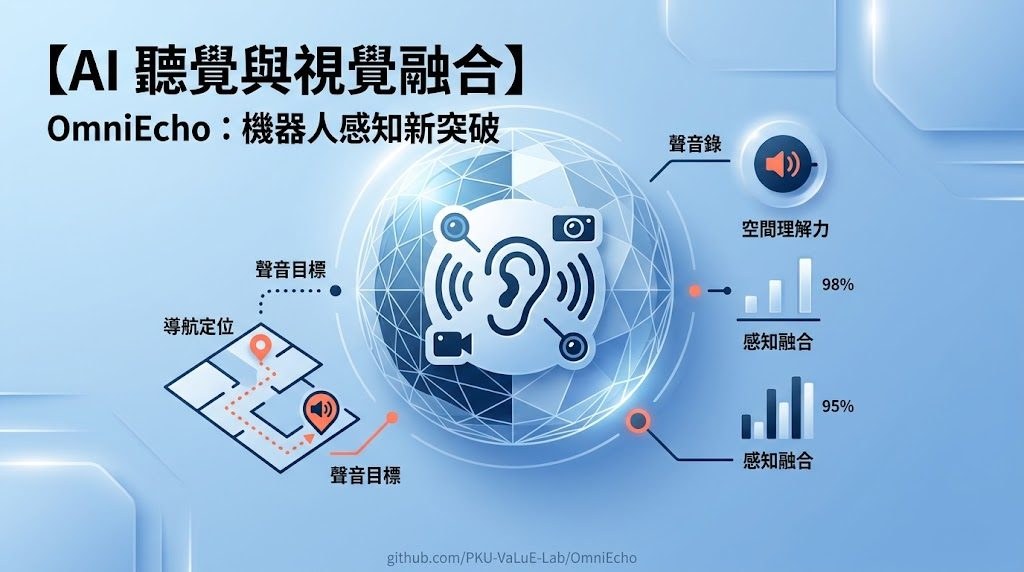
聲音從哪個方向來、距離多遠,是人類憑本能就能判斷的事,對機器人卻是一道難題。OmniEcho 把一階 Ambisonics 空間音訊、視覺與語言整合到同一個智能體,專門研究這類空間感知與聲源導航。

Repository image for PKU-VaLuE-Lab/OmniEcho

OmniEcho 是一個面向 embodied agent 的音視覺空間感知項目,由北京大學 PKU-VaLuE-Lab 開源。它要解決的問題很直觀:當一個智能體同時聽到聲音、看到畫面,它能否判斷聲源在哪個方向、距離多遠,並進一步循聲走去?這件事對人類毫不費力,但要讓 AI 真正做到,過去並不容易。

項目同時提供三樣東西:統一基準 OmniEchoBench、可控的空間音訊渲染管線,以及基於 Qwen3-Omni 改進的 OmniEcho 模型。後者最關鍵的設計,是在 Qwen3-Omni 既有語意音訊通路之外,加掛一個專門處理 FOA(一階 Ambisonics)空間資訊的編碼器,讓模型同時理解「聽到什麼」和「聲音從哪來」。

基準涵蓋六類任務,合共 197 個真實音視覺場景、2,972 條 QA 與 900 條導航樣本,全部由人工核對標註。OmniEcho 在空間音視覺感知上達到 state-of-the-art,而循聲導航的表現已經逼近傳統「靠文字指示」的視覺語言導航。不過細粒度的方位判定與距離估計,仍被作者列為尚未解決的難題。

對做機器人導航、音視覺融合研究,或需要智能體在真實場景中聽聲定位的團隊,這套項目提供了一個可以直接拿來跑評測、訓練、再挑戰的起點。原文並未附上完整的安裝或下載流程,相關代碼與模型權重目前標示為即將釋出。

重點摘要

  • 空間音訊加視覺語言:以 FOA 為輸入,與視覺、語言一起餵進 omni-modal agent。
  • 雙編碼器設計:在 Qwen3-Omni 之上新增 FOA 空間編碼器,保留原有語意音訊能力。
  • 真實世界基準 OmniEchoBench:六類任務、近 3,000 條 QA 與 900 條導航樣本,人工核對。
  • 循聲導航貼近文字導航:在 Nav 任務上接近傳統 VLN 水平,但方位與距離仍偏弱。
  • 代碼與權重待發佈: 標示 Coming Soon,暫無公開安裝步驟。

GitHub

Categories: 開源, 北京大學, Agentic, 模型, 視覺模型, 模型訓練, Qwen, VLA, Audio

LensVLM 用壓縮頁面減少長文閱讀成本

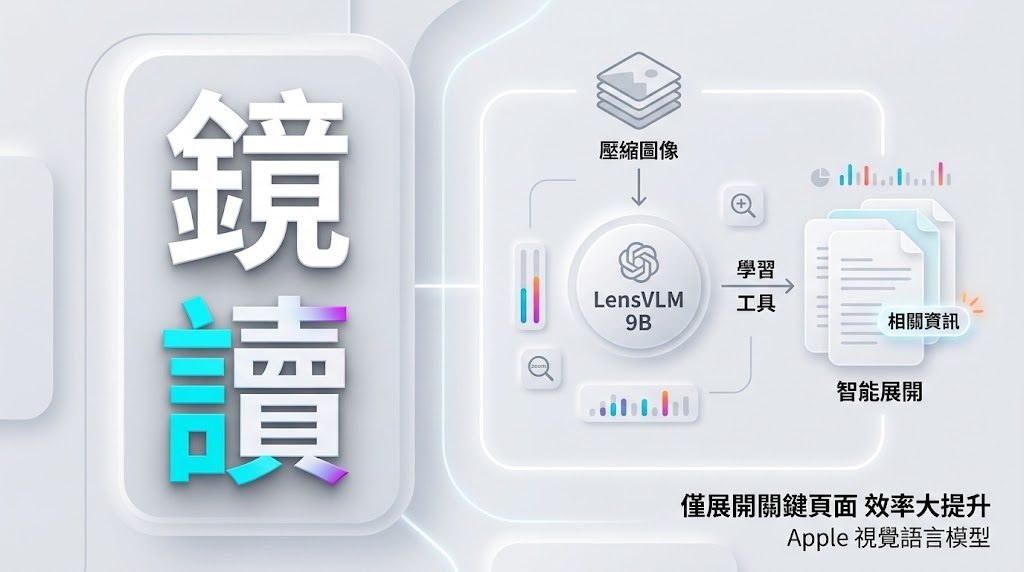
LensVLM先掃描低成本頁面圖,再只讀取與問題相關的完整頁面,將長文件問答的視覺輸入壓縮成按需取用。

Repository image for apple-aiml-research/ml-lensvlm

面對多頁文件問答,LensVLM不必一開始把每頁完整內容送入模型,而是先以壓縮頁面圖定位線索,再讀取相關頁面的全文。這個項目屬於多模態 Vision Language Model(VLM),實際處理的是長文件輸入過大、文字內容難以一次放入上下文的問題。

LensVLM是經微調的 Qwen3.5-9B,配合學習得到的 read_page 工具,讓模型在掃描頁面縮圖後按需擴展內容。示範包括模型檢查15頁文件,只讀取第10頁,經兩輪互動便由人物資料連結到答案;壓縮比例可選5x、10x或15x,取捨是壓縮越高,初步掃描成本較低,但頁面細節亦可能減少。

  • 先處理壓縮頁面圖,再按問題讀取完整頁面
  • 支援自訂文字文件及 HuggingFace 評估數據準備
  • 輸出頁面圖與結果檔案,方便檢查推理軌跡
  • 適合長報告、資料集問答及文件檢索測試

項目提供 requirements 安裝方式、示範流程及自訂文件參數,結果會寫入指定輸出目錄;原始資料沒有交代硬件要求、推理速度或記憶體消耗。提供的示例能說明工作流程,但未有完整準確率、延遲或與其他長文件 VLM 的量化比較,因此較適合作為研究原型和評估基礎,而非已證實在所有文件類型上都更快或更準的方案。

需要處理大量頁面、又希望控制視覺 token 成本的研究者和工程團隊,較容易從這種按需展開機制受益。文件版面複雜、關鍵答案分散,或問題需要跨頁整合時,仍要留意壓縮圖能否保留足夠線索,以及 read_page 讀取到的文字是否完整。

GitHub · 模型

Categories: 開源, 視覺模型, Qwen, 蘋果

Spatial-Interactor 讓視覺模型學懂行動後的空間變化

Spatial-Interactor 把空間推理由靜態辨識推向連續互動,處理物件、視角與長距離軌跡的變化。

Spatial-Interactor icon

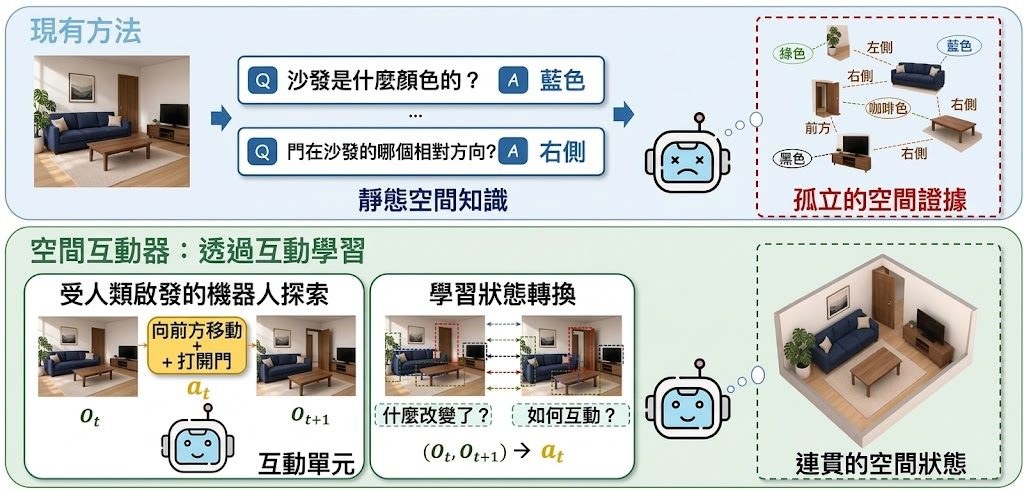
當畫面中的物件被打開、移動,或者代理人在場景中轉身前進,答案不再只是辨認位置,而是要推斷每一步行動帶來的改變。Spatial-Interactor 屬於視覺語言模型的訓練項目,針對模型難以理解狀態轉移及連續空間軌跡的問題,從可觀察的物理互動記錄建立訓練訊號。

項目把能力分成三層:L1 處理視點大致固定時的物件與世界狀態變化;L2 推理代理人移動造成的自身視角變化;L3 將連續的局部轉移整合成完整、長距離的互動軌跡。LSI-108K 以互動記錄、幾何軌跡、狀態及姿態資料產生可驗證的問答目標,令訓練內容不只停留在單張影像的空間關係。

訓練先以 supervised fine-tuning (SFT) 學習 L1 及 L2 的局部轉移,再利用 On-Policy Distillation (OPD) 整合長軌跡中的連續證據。推理時模型只接收原始視覺輸入與問題,毋須依賴額外提供的中間狀態;這有助於測試模型能否自行重建互動過程,但也代表長距離推理仍會受視覺理解及累積誤差影響。

項目涵蓋四個 vision-language models,並以狀態轉移診斷、打亂影格後的時間敏感度,以及局部與長軌跡推理結果作分析。較適合研究視覺代理人、機械人感知、具身 AI 及需要理解動作後果的場景;GitHub 資訊提供程式碼、模型與資料的連結,但未交代完整安裝及測試流程,不能單憑頁面內容判定下載後即可直接運行。

  • L1 分析外界物件及場景的狀態轉變
  • L2 把 ego-motion 對觀察結果的影響納入推理
  • L3 將多個局部轉移串連成完整軌跡
  • SFT 負責局部學習,OPD 負責長距離整合
  • 模型只需原始視覺輸入與問題作推理

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 模型訓練, Image, Robotic

Mira-Scene 單張圖片重建可編輯 3D 場景,讓畫面變成可拆解空間

Mira-Scene 將單張圖片拆成物件、深度與環境,再組合成可編輯 3D 場景,降低由 2D 畫面建立空間內容的門檻。

Mira-Scene teaser

由一張圖片開始,Mira-Scene 能分辨場景內的物件、估算深度,再為各物件建立網格並組合成可編輯 3D 場景。它屬於單圖 3D 場景重建模型與推理項目,處理的是影像缺乏空間結構、物件難以獨立編輯的問題,適合概念設計、虛擬場景和後續模擬工作。

完整流程包括互動式 instance segmentation、monocular depth estimation、canonical coordinate map(CCM)、voxel prediction、逐物件 mesh generation、支援物件接觸關係的 scene assembly,以及 environment-map generation。Hugging Face 提供的 CCM diffusion checkpoint 只負責其中一個階段,並不是可直接輸出 GLB 的獨立 image-to-3D 模型;分割遮罩、mesh backend 和場景組裝階段仍要配合使用。

Mira-Scene 採用分階段推理,支援中斷後繼續執行、多個深度及網格後端,亦可按個案分配多張 GPU。使用者可依照中文 inference、visualization 和 evaluation 指南準備輸入圖片及遮罩,再檢視各階段產物;訓練程式碼和示例訓練數據仍列在待辦事項,研究用途以外需要自行處理環境和模型資源。

• 單張圖片重建可拆解的 3D 場景
• 以 CCM 和稀疏 voxel 表示物件空間結構
• 對比 SAM3D,3D-IoU 為 0.727,較 0.520 高
• 部分指標領先,但 EMD 略遜於 SAM3D
• 開源推理流程完整,訓練部分尚未公開

評測表中,Mira-Scene 使用 80k 規模、全自動流程的數據,CD、FS@0.1、3D-IoU、ICP-Rot、2D-IoU 和 ADD-S 均優於 SAM3D;EMD 則為 0.169,稍高於對方的 0.163。這反映它在整體形狀、投影對齊和姿態誤差上具競爭力,但不能把單一圖片重建視為完整真實世界掃描,遮擋、不可見背面和網格後端仍會影響結果。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 影像處理, 3D, 蘋果

Grounded-Action-Model:讓機械人先理解物件位置,再決定如何動作

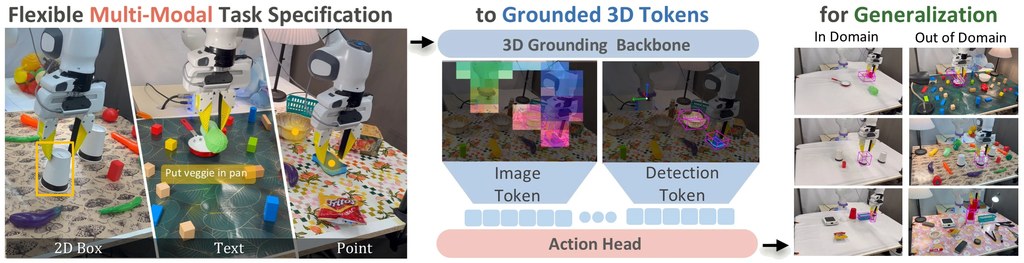
Grounded Action Model 把語言、點和框選提示轉成同一套 3D 物件表示,提升機械臂面對場景變化時的穩定性。

A language instruction, a 2D point or a 2D box is resolved by a pretrained 3D grounding model into image tokens and dete

面對物件被移位、場景重新排列,機械臂未必只需要更長的指令,而是要準確知道目標在哪裏。Grounded Action Model(GAM)屬於機械人基礎模型,透過 3D grounding 將語言、2D 點或 2D 框選轉成同一套以物件為中心的觀察,再預測連續動作。

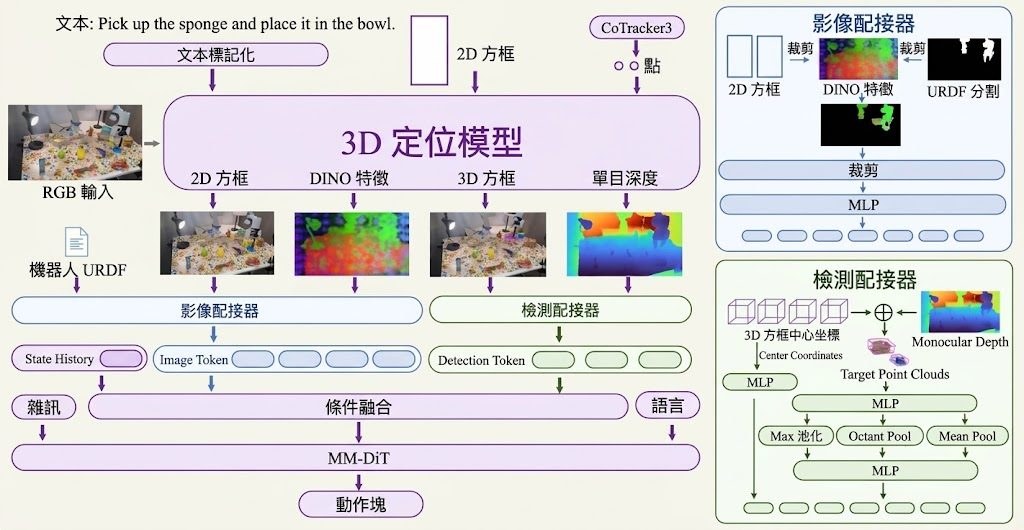
GAM 使用凍結的 promptable 3D detector,提取目標物件的視覺特徵和 metric geometry,並與機械人狀態歷史交給 multi-stream transformer,輸出 action chunks。相較於由 Vision-Language-Action Models(VLAs)或 World-Action Models(WAMs)從示範中隱性學習位置關係,GAM 把 3D 位置直接放進控制流程,也可由高層 planner 透過不同提示方式控制,支援較長流程和需要記憶的操作。

A language instruction, a 2D point or a 2D box is resolved by a pretrained 3D grounding model into image tokens and dete

目前可參考的結果包括:
– RoboTwin 2.0 的 50 項任務平均成功率為 55.3%,場景隨機化時為 47.6%。
– LIBERO-PRO 的 16 種擾動設定平均成功率為 61%,目標重新放置時改善較明顯。
– 雙臂 YAM 面對視覺變化仍成功 17/20 次;Franka 配合 Molmo2 planner,長流程任務的 OOD step completion 為 49.8%。

Grounded-Action-Model 適合研究機械人操作、視覺變化和高低層控制協作的團隊,但目前 GitHub 仍只有論文與項目頁面,training and inference code、pretrained checkpoints 及 real-robot setup 尚待公開,因此暫時不能按儲存庫直接安裝或重現結果。數據主要來自指定基準和兩款機械人,能否延伸到其他硬件與未見過的操作,仍要等待程式碼及更多測試。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, 微軟, VLA, World-Action Model, Robotic, 3D, 庫

RecreationWorld:從操作到重建軟件介面

代理不只觀察介面,還要自行寫程式、啟動成品及核對結果,測試由操作走向完整交付。

RecreationWorld logo

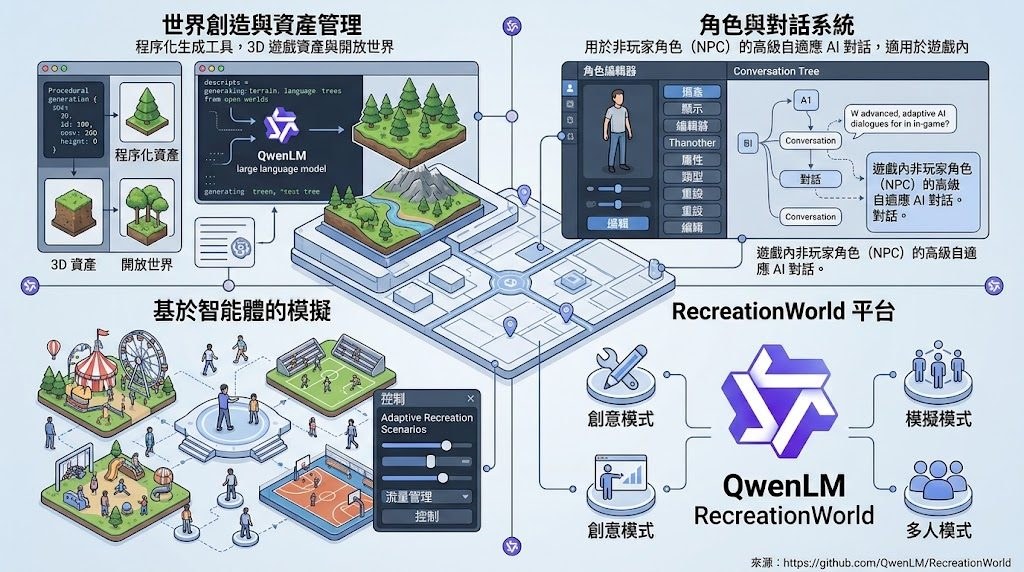
給代理一個正在運行的參考程式,它要邊操作、邊寫程式,再自行啟動及檢查成品。RecreationWorld 是研究混合式電腦操作代理(hybrid computer-use agents)的五平台框架,處理代理能否按可見行為重建軟件的問題。

它把參考程式當作可執行判準,讓代理反覆進行探索、實作與驗證,而非依固定階段完成任務。最終評分看功能與畫面是否吻合,不要求源碼、語言或架構相同,保留了實作自由。

  • 涵蓋 Ubuntu、macOS、Windows、Android 與 Web
  • RecreationBench 提供 250 個未公開於訓練流程的應用任務
  • 同時採用程式化檢查與視覺模型(Vision-Language Model,VLM)評分
  • 可比較完成度、接近滿分的應用比例及每項任務成本

已列出的結果中,GPT-6 Astra 平均 58.06%,領先 Claude Opus 5 的 44.16%,但估算成本達每項任務 115.80 美元;較便宜的模型則要接受明顯分數差距。這反映長時間探索、編碼與視覺核對仍然昂貴,而且只有少量應用能達到完整功能分數。

開發代理、GUI 自動化或程式生成系統的團隊,可下載 RecreationBench 資料集並依儲存庫的 Quickstart 配置環境;自行託管模型的正式評估需要聯絡團隊。它較適合作研究與模型比較,未見足夠資料證明可直接充當一般軟件重建服務。

項目主頁 · GitHub · 數據集

Categories: 開源, 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架, Mac, Linux, 庫, Dataset 數據集

MiniMax-H3-Reason:多模態仍未帶來物理推理穩定答案

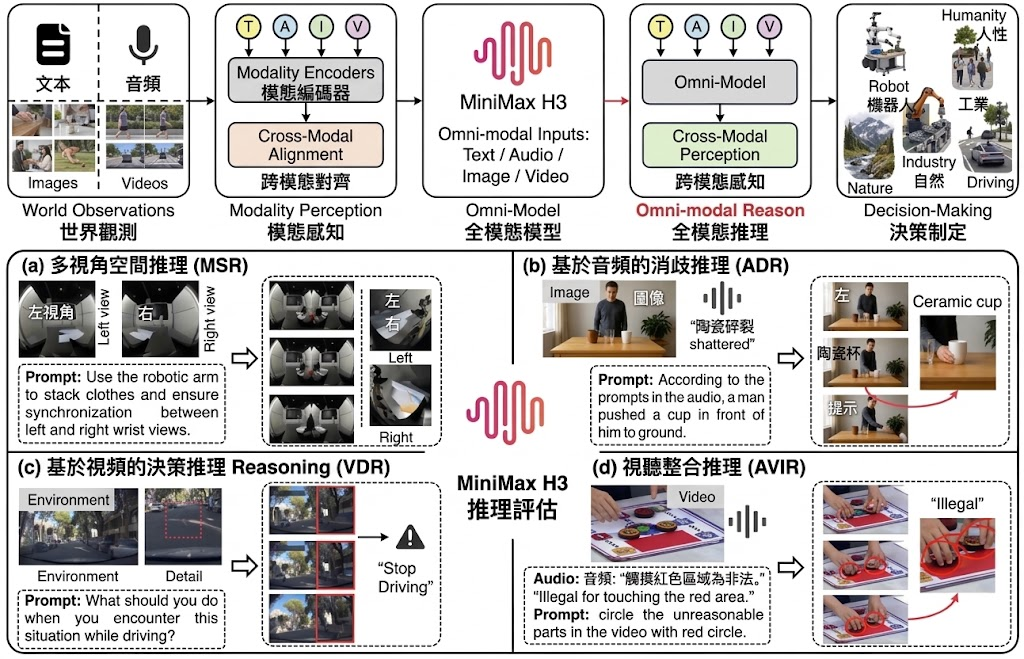
這份評估刻意把任務資訊藏在圖像、音訊和影片裡,逼模型從片段線索拼出合理結果。MiniMax-H3 在 517 個案例中只得 41.97% 成功率,顯示多模態整合仍是關卡。

面對一段被刻意刪去關鍵資訊的指令,模型要靠圖像、聲音或前段影片這些「不在文字裡」的線索去補完事件,這正是這個評估項目想驗證的能力。它屬於研究類型的基準測試(Benchmark),專門設計來測 omni-modal 生成模型在物理世界推理上的表現,而不是單純比較畫質或動作流暢度。

整個框架圍繞四個場景展開:MSR 多視角空間推理、ADR 聲音消歧推理、VDR 影片決策推理,以及把聲音與影片約束結合的場景。每個場景都要求模型在 200 張圖、146 段聲音、影片前段等不完整輸入下,推斷出合理後續,並由專家判斷生成結果是否真的滿足語意要求,而非只追求像素相似。

MiniMax-H3 在這 517 個案例中整體成功率為 41.97%,差距明顯落在不同場景之間:影片決策推理最高,達 56.00%;聲音消歧推理最弱,只有 27.40%。這個落差直接說明,當聲音要承擔解開視覺模糊的責任時,模型很容易抓錯重點;反之,延續已觀察到的動態相對容易,因為線索更密集、更接近訓練分佈。

對做影片生成、世界模型或多模態整合的團隊來說,這套測試比起傳統 FID 或描述相似度更能反映真實瓶頸。它告訴我們,「支援多模態輸入」和「能可靠完成任務」之間仍有很大距離,尤其在聲音與畫面的細節對齊上。開發者可以用它找出弱項,研究者則能以此為基準,比較下一代模型是否真的在「聽懂並接住物理世界」這件事上有所進步。

重點摘要:

  • 任務描述刻意不完整,逼模型從圖像、音訊或影片中補回缺失資訊
  • 四個場景涵蓋空間、聲音、時間與音畫對齊四類物理推理
  • MiniMax-H3 整體成功率 41.97%,影片延續最易、聲音消歧最難
  • 由專家判斷生成結果是否滿足語意,而非僅看畫面或動作
  • 對開發 omni-modal 影片生成與世界模型的團隊,是更貼近實戰的評估方式

GitHub

Categories: 開源, AI productions, 視覺模型, 多模態模型, 框架, MiniMax

GPT-Policy 把 VLM 變現場教練

GPT-Policy 讓固定的視覺語言模型在現場讀懂示範影片、目標圖與互動回饋,直接輸出可執行的機械臂動作,省去微調與重訓成本。

GPT-Policy wordmark

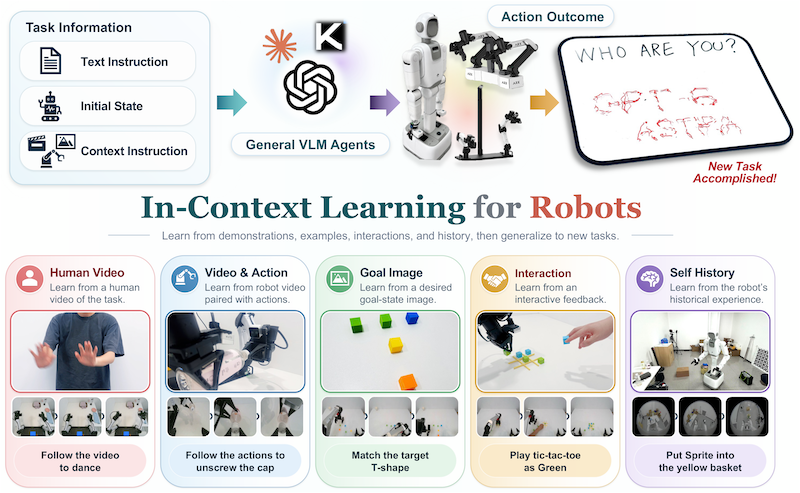
機械臂要適應新任務,傳統做法往往是收集大量數據再微調模型,成本高且迭代慢。GPT-Policy 走另一條路:保留一個固定的視覺語言模型(VLM)作為決策核心,現場把任務指令、示範影片、目標圖像、過往觀察與執行回饋打包成單一輸入,讓模型一次輸出一個結構化動作請求,再交給專屬的硬件適配器(adapter)驗證並執行。

的關鍵在於「context compiler」與「constrained controller」的分工。前者負責保留示範中與任務相關的視覺轉折,後者則檢查動作是否安全、可執行,並回報結果給 VLM 進入下一輪決策,整個過程沒有梯度更新,也不需要為新任務調整參數。對於 ARX X5 與 I2RT/YAM 兩款機械臂平台,項目已提供對應的適配器,支援笛卡兒目標、waypoint 序列、順序 IK 檢查、夾爪控制,以及 append-only 的運行記錄,方便日後追溯。

從結果來看,團隊在真實機械臂試驗中發現,即使只有人類影片而無機械臂動作標記,GPT-Policy 仍能改善任務完成率;若加上對齊的動作參考,表現會進一步提升,尤其在接觸敏感的任務上更明顯。對比同類做法,GPT-Policy 沒有走端到端策略網絡的路線,而是把通用 VLM 的推理能力當作即插即用的策略模組,取捨是更依賴適配器與閉環回饋的工程品質。

適合使用的場景包括:研究 VLM 與機器人結合的團隊、需要快速讓機械臂適應新任務示範的實驗室,以及想評估「不重訓」路線可行性的工程團隊。目前的限制在於硬件覆蓋仍集中在兩款臂,且效能高度取決於上下文編譯器能否保留關鍵視覺資訊。

重點摘要:

  • 固定 VLM 即決策核心:不微調、不重訓,靠現場上下文即時生成動作
  • context compiler + controller 雙層架構:前者保留任務相關視覺轉折,後者驗證並執行
  • 支援 ARX X5 與 I2RT/YAM:提供笛卡兒目標、IK 檢查、夾爪控制等適配器
  • 人類影片已能改善任務成功率:對齊動作參考後表現更穩,尤其接觸敏感任務
  • 定位為研究框架:適合探索通用模型在實體機器人上的即時學習能力

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, Video, Image, 影像處理, Robotic, 框架, 安全

Page 3 of 23
1 2 3 4 5 … 23