OneSearch-VL:多模體視覺 deep research agent

由單張相片到影片片段,OneSearch-VL 會找出視覺線索、搜尋外部資料,再把證據串成可核對的答案。

OneSearch-VL

由一張相片、相片集合到影片片段,OneSearch-VL 會先定位視覺線索,再檢索外部知識,將相關證據組合成答案。它屬於多模態 deep research agent,處理的是影像內容理解與資料查證之間難以銜接的工作。

核心是 Visually Grounded Evidence Graph(VGEG),把視覺錨點、來源支持的事實和產生答案所需的操作連在一起。VGEG 亦支援資料建立及驗證;Evidence-aware Visual-Grounded Rubric reward(EVGR)則在強化學習中監督證據是否可追溯,以及答案有沒有真正對應影像內容。
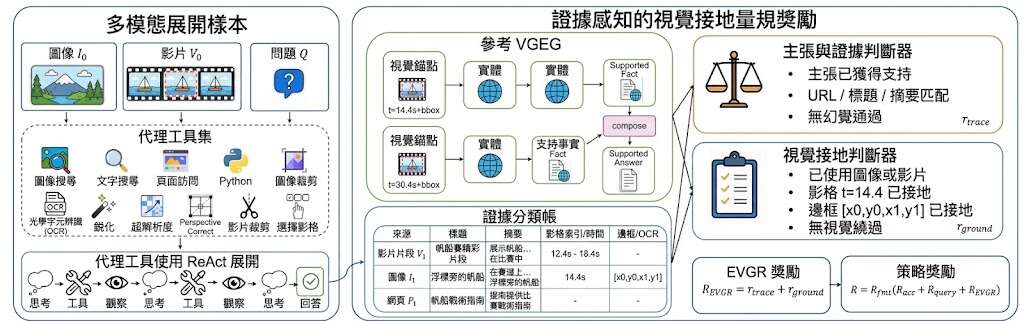
項目提供 OneSearch-MI-Bench 和 OneSearch-Video-Bench,分別面向多圖及影片研究能力。輸入資料未列出具體分數或模型名稱,因此不能把它描述成已全面勝過其他視覺研究方案;它較適合用作研究原型、訓練資料管線和 agentic workflow 的基礎。

OneSearch-VL 包含 Agentic SFT、Agentic RL、推理及評估相關目錄,並標示 Python 3.11+;先準備模型、資料集和外部工具,再執行訓練或評估流程。對需要查核圖片來源、比較多張圖片,或從影片整理證據的研究團隊,這種統一處理方式較容易整合到既有工作流,但部署成本和工具依賴仍要自行確認。

• 同時支援單圖、多圖集合及影片
• 以 VGEG 統一視覺線索與外部證據
• EVGR 強調證據可追溯及視覺對齊
• 提供多圖與影片專用 benchmark
• 支援 SFT、RL、推理和評估流程
GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Video, Image, 工具, Python, 庫, Dataset 數據集, 強化學習

Compo:以 Spatial Canvas 編排海報中的文字、人物與圖像

Compo 讓你用畫布安排文字、人物與圖像位置,再交由模型生成海報,減少只靠文字描述構圖的反覆試錯。

Compo Teaser

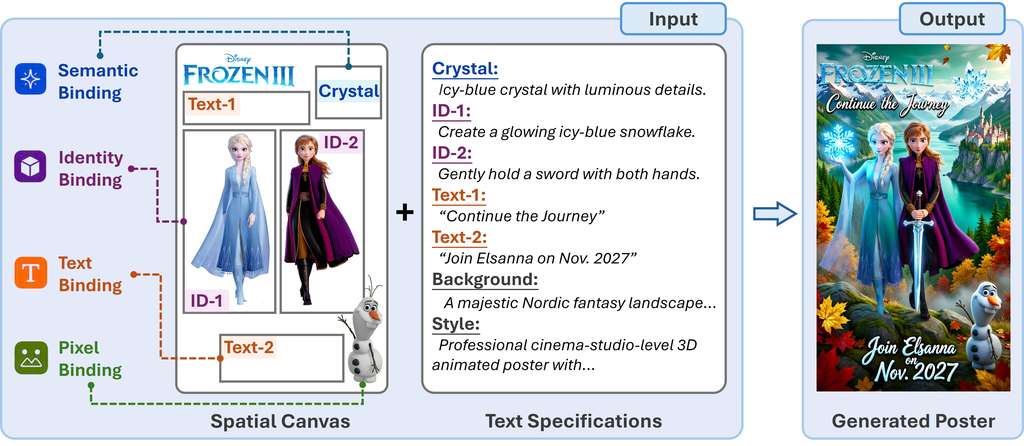
海報生成最難控制的往往不是主題,而是文字、人物和裝飾元素應該放在哪裏。Compo 屬於海報生成模型及介面項目,將 Spatial Canvas Interface 與 Text Specifications 結合,讓使用者直接在畫面中表達二維構圖意圖。

Spatial Canvas 支援四種綁定方式:Semantic Binding 指定文字概念及目標區域,Identity Binding 以參考圖保留視覺身份,Text Binding 同時交代準確字句與位置,Pixel Binding 則放入需要保留的像素內容。Bounding boxes、參考圖片和文字識別資料會一併渲染到畫布,形成模型接收的統一影像輸入。

  • 以畫布補足單靠文字提示難以交代的空間關係
  • Compo 由預訓練 image editing model 改編而成,毋須另建 task-specific architecture
  • 支援 direct inference,也支援 agentic mode 自動規劃畫布
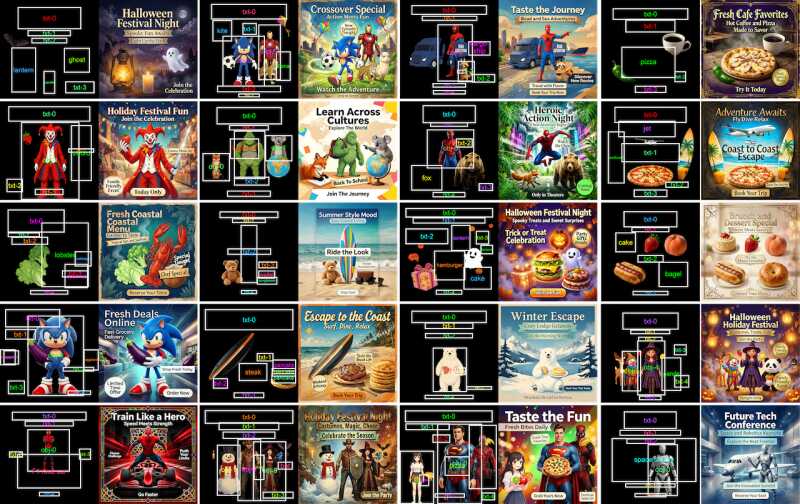
  • 可用於海報、宣傳圖及需要精確排版的視覺內容

Compo 的模型改編重點,是令現有 image editing model 理解不同綁定方式及其組合,而不是從零訓練專用 poster generator。項目亦建立自動產生監督數據的流程,協助模型學習各類 Spatial Canvas 輸入;這比純文字提示更容易控制位置,但使用者仍要準備畫布內容,agentic mode 的自動規劃亦未必取代人工微調。

適合研究人員、設計工具開發者和需要批量製作宣傳海報的內容團隊作為試驗起點,而非直接視作成熟的製作平台。

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 模型, 視覺模型, 模型訓練, 微軟, Image, 影像處理, 香港, 工具, 中國, Dataset 數據集

VibeEdit:以畫布指令精準指定影像編輯位置

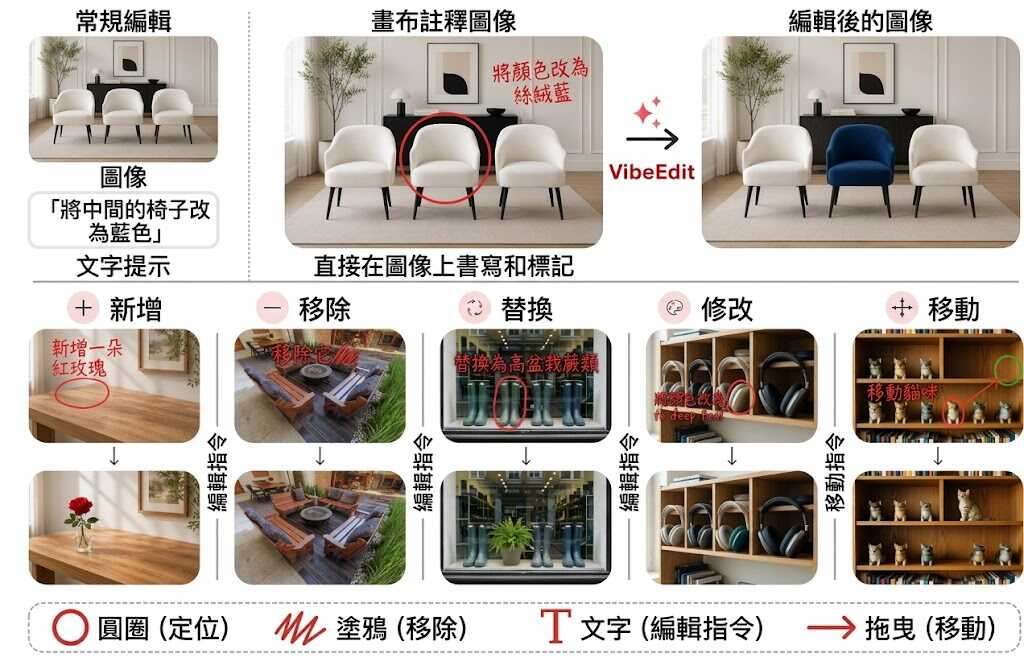
圈選、畫線或拖動就能指定修圖位置,VibeEdit 以空間標記處理相似物件難以辨認的問題。

VibeEdit enables image editing with canvas instructions, including circles, scribbles, short notes and drag gestures.

圈選物件、畫幾筆線,或在圖片上拖動指定位置,再補上一句短註記,便能要求模型新增、移除、替換、改變屬性或移動內容。VibeEdit 屬於影像編輯模型,處理的是文字提示難以準確指出相似物件和局部區域的問題。

它採用 Qwen-Image-Edit,以 layer-decoupled conditioning 分開編碼原圖與 canvas instruction,再配合 region-weighted supervised fine-tuning,以及 rubric-guided reinforcement learning(RL)改善局部修改、指令完成度和未編輯區域的保留。訓練資料包含 155 萬組 source–target edit pairs、物件遮罩和結構化編輯描述,畫布指令則由這些資料生成。

  • 支援新增、移除、替換、屬性修改及移動物件
  • 不要求獨立文字提示,空間標記直接表達目標位置
  • 以 419 個人工整理案例測試相似物件選取能力
  • VLM(Vision-Language Model)評分為 79.9,outside-region PSNR 為 32.8 dB
  • 對比 FireRed 的 67.4 分及 24.0 dB,局部編輯和區域保留均較佳

對需要精準修圖的設計、內容製作和研究團隊,畫布指令比長篇描述更容易表達「改哪一件」;但模型仍屬研究項目,程式碼標示為 Coming soon,暫時不能按儲存庫直接安裝或自行重現。評測規模亦只有 419 個案例,結果未必涵蓋所有圖片類型和複雜編輯情境。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, Image, 庫, 強化學習

UniWAM 把理解、預測與機械人動作合而為一

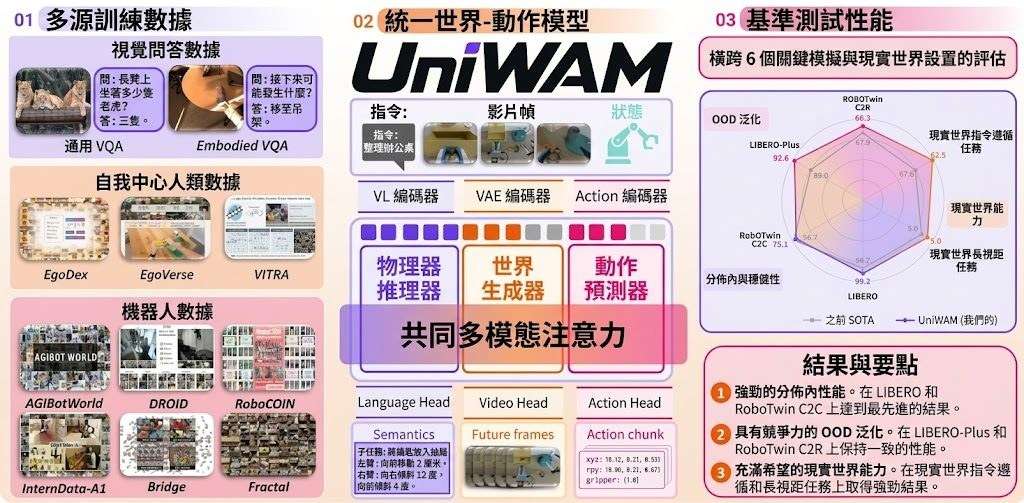
UniWAM 以 8B 參數模型整合語意理解、視覺預測和動作生成,瞄準機械人操作中理解與執行脫節的問題。

UniWAM teaser

面對需要理解指令、預測環境變化再控制機械人的任務,UniWAM 將三個步驟放進同一個 8B-parameter 模型,屬於結合世界模型與 Vision-Language-Action(VLA)的開源研究項目。它以 Mixture-of-Transformers(MoT)連接 physical reasoner、world generator 和 action predictor,讓三者透過 joint multimodal attention 交換資訊。

模型不只依賴機械人示範,預訓練亦混合 human egocentric data、robot data 及 visual question answering(VQA)資料,並把低層動作轉成自然語言,改善視覺語言能力與實體操作之間的銜接。Post-training 再加入 future visual noise augmentation,配合 history-conditioned flow matching,以較少 denoising steps 生成動作。

  • 整合範圍: 同時處理 physical reasoning、視覺生成與動作預測
  • 訓練訊號: 結合機械人、第一身人類視角及 VQA 資料
  • 效率設計: 用動作歷史初始化生成流程,減少 denoising steps
  • 硬件成本: RoboTwin 2.0 post-training 曾以 8 張 NVIDIA H100 GPU 執行 10 小時

GitHub 儲存庫提供 models/、train/ 和 utils/ 等模型與訓練程式,並附有 RoboTwin 2.0、LIBERO 及 LIBERO-plus 的資料處理和評估工具。Python 3.10、CUDA 兼容的 PyTorch 環境較適合測試,使用者可先以模擬器資料和配置檔驗證訓練或推理流程。

項目首頁宣稱 UniWAM 在 in-distribution、robustness、generalization 及 instruction following 等多項評估取得 SOTA,但儲存庫提供的資訊未列出完整分數和比較表。Bridge、DROID、Fractal 以及 real-world inference 明確不在今次發布範圍內,因此它較適合研究團隊測試統一式機械人模型,而不是即時接駁真實機械人的現成方案。

項目主頁 · GitHub · 項目

Categories: 開源, 香港科技大學, 北京大學, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, NVIDIA, VLA, Robotic, 香港, 工具, Python, 庫, Dataset 數據集

VIEScore2 讓影像評分不再只剩一個分數

VIEScore2 同時評估影像質素、語意一致性與缺陷位置,將難以解讀的分數轉成可追蹤的修改方向。

teaser

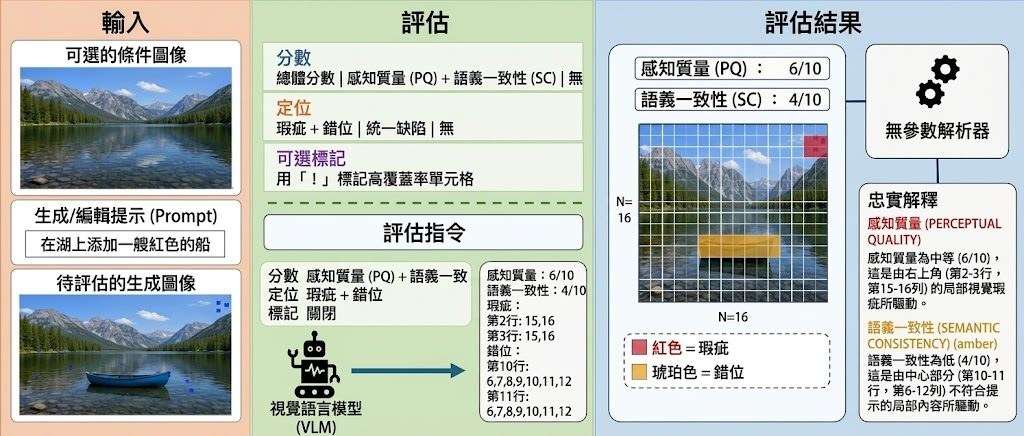
評估 AI 生成或編輯影像時,單一分數往往只能告訴你好不好,卻說不出問題在哪裏。VIEScore2 屬於影像評估模型,處理生成圖、編輯圖、提示詞及可選的條件影像,並在一次模型運算中輸出質素、語意一致性和缺陷位置。

Qwen3-VL-8B 經微調後,以自回歸方式同時預測 perceptual-quality(PQ)、semantic-consistency(SC)及 16×16 defect grid;artifact 和 misalign 兩個通道可分開標示視覺瑕疵與語意錯位。參數免訓練的 parser 再把網格結果穩定轉成文字解釋,避免說明內容與定位結果互相矛盾。

相比只輸出總分的評估器,VIEScore2 提供較具操作性的空間線索;相比通用 VLM,模型則專注於影像評分和缺陷定位,代價是網格以 16×16 單元表達,細節精度有限。訓練資料把 ImagenWorld、RichHF-18K、PAL4VST、COCO 的遮罩或熱圖,以及 EvalMuse-40K 的分數資料統一成同一格式,再以 SFT 和 GRPO 配合 cell-level Dice、分數準確度及格式有效性獎勵訓練。

GitHub 儲存庫提供評估協議、資料 manifests、外部測試集轉換器,以及 run_eval.py;可使用本地 checkpoint,亦支援 OpenAI、Gemini 和 Anthropic API backend。主要套件包括 AbHuman、AGIQA-3K、EvalMuse、PAL4VST 等評估集,適合研究影像生成模型、建立自動質量檢查流程,或分析編輯結果的錯誤位置。

  • 評分更完整:同時輸出 PQ、SC、缺陷網格及文字解釋。
  • 結果較接近人評:主要測試集 overall-score SRCC 為 0.601,最佳 VLM baseline 為 0.491。
  • 定位能力具競爭力:6 個定位基準中有 3 個取得最高 grid IoU,5 個進入前三。
  • 限制清晰:網格定位仍屬區域級提示,並需要按儲存庫協議整理資料與輸入格式。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, API, Image, 提示詞, 庫, Anthropic

MiniCorp 以模擬企業填補 AGI 代理數據缺口

企業代理要學識做決策,欠缺的往往不是模型,而是真實、連續又可重演的商業數據。MiniCorp 嘗試用虛擬公司補上這個缺口。

The MiniCorp simulation core

企業代理要處理日常工作、作出商業決策,卻難以取得足夠真實而且可長期追蹤的企業資料。MiniCorp 以 Office Simulators for Enterprise AGI 為核心,建立可讓 autonomous enterprise agents 運作的高擬真虛擬公司環境,藉此研究 AI 管理企業的方式。

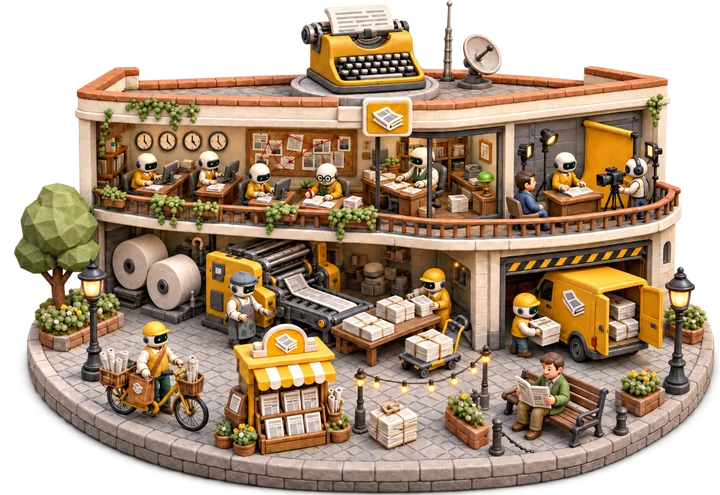
這些模擬公司涵蓋醫院、航空公司、對沖基金、報紙、電子商貿及高科技企業等場景。代理可以在連續運作的環境中執行工作,研究團隊亦能生成 longitudinal enterprise data,以及比較不同決策後果的 counterfactual enterprise data,減少依賴受私隱限制、價格昂貴或需要專家標註的真實企業檔案。

MiniCorp 處理虛擬企業讓研究者重播情境、改變決策條件,再觀察代理長期表現,適合用於訓練、測試及分析企業級 AI agent。

目前項目提供研究資料、GitHub、arXiv 及 Hugging Face 入口,互動示範仍標示為準備中。使用者可先把它理解成研究企業代理的模擬場,而不是可直接接管真實公司的現成產品。

  • 建立醫院、航空、金融及電子商貿等企業場景
  • 產生可長期追蹤的企業運作數據
  • 支援反事實決策比較與代理研究
  • 針對企業級 autonomous agents 的訓練和測試
  • 互動 Demo 尚未正式推出

項目主頁

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, World-Action Model, Robotic, 安全, AGI

Building Rome 單張相片重建完整 3D 場景

只用一張相片,Building Rome 便嘗試補全鏡頭外的建築與室內結構,生成可探索的 3D 場景網格。連看不見的空間也能生成。

Og image

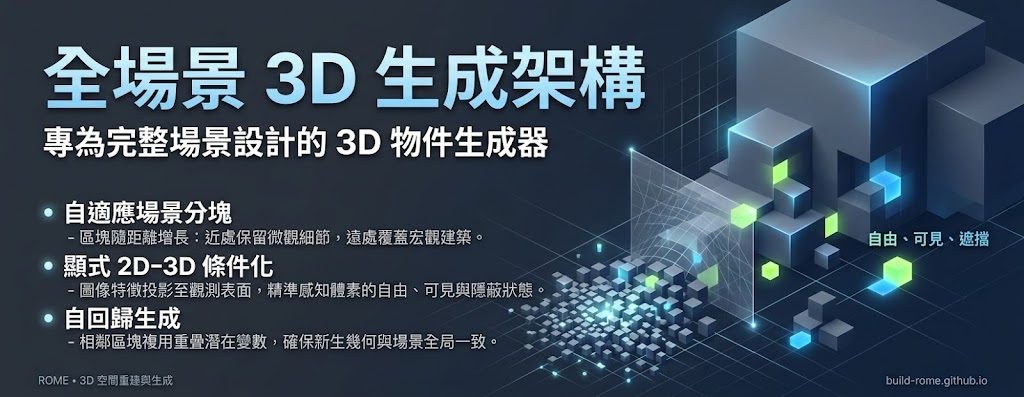
只得一張相片,Building Rome 便嘗試補全鏡頭未拍到的空間,生成室內、戶外及大型環境的完整 3D scene mesh。這個單影像 3D 場景重建項目,處理的是照片只提供單一視角、遠近物件細節不一致,以及隱藏幾何無法直接觀察的問題。

方法把場景切成會隨距離變化的 adaptive chunks:近處使用較細區塊保留細節,遠處則用較大區塊涵蓋建築。影像特徵會投射到已觀察到的表面,而每個 voxel 亦會標示空置、可見或隱藏狀態;生成鄰近區塊時重用重疊 latent,令新加入的幾何結構較能保持連貫。

讀者可以透過互動檢視重建結果,透過拖曳旋轉、滾輪縮放及 WASD、Q、E 移動,亦可選取兩點量度距離。網頁展示用 mesh 為方便瀏覽而簡化至約 1.5M faces,論文圖像及影片則採用完整解析度,因此兩者的視覺細節不應直接視為相同。

  • 單張相片重建室內、戶外及大型場景
  • 以 adaptive chunks 處理不同距離的細節
  • 透過 2D&3D conditioning 推斷可見與隱藏幾何
  • 以 autoregressive generation 延續相鄰區塊的一致性
  • Code 標示為即將提供,現時可先透過互動網頁查看結果

項目由 Applied Intuition 聯同 Purdue University、UIUC 及 UC Berkeley 研究人員完成,並以 World Tracing、GenRecon、VolFill 及 Lyra 2.0 等方法作比較。對需要由照片建立可探索環境、進行空間分析或製作 3D 內容的人,這種由單一視角推算完整場景的做法提供了另一條工作流程,但隱藏區域屬於模型生成,不能當作相片直接觀察所得的精確測量。

項目主頁 · 項目

Categories: 開源, AI productions, 模型, 視覺模型, Video, Image, 3D, Anthropic

DistScene 從圖片生成可供導航模擬的 3D 場景

生成物件之外,DistScene 也建立周邊環境,讓圖片轉成的 3D 場景可直接匯入導航模擬器。

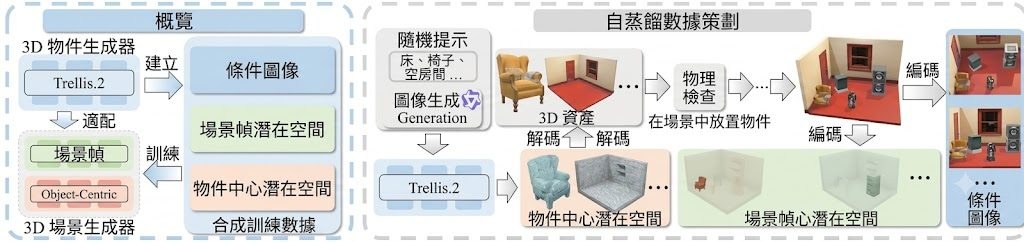
DistScene self-distilled data curation: Trellis.2 generates objects and environments, physics checks guide scene assembly, and rendering provides conditioning images.

把圖片轉成可供導航模擬的 3D 空間,需要同時建立物件與周邊環境。DistScene 這個 3D 場景生成研究項目,讓兩者在同一場景中生成,再逐件細化物件。

其 Object-to-Scene Distillation 方法以 Trellis.2 生成訓練素材:先由視覺語言模型(Vision-Language Model,VLM)描述物件與環境,再生成輸入圖片及 3D 資產,組合時加入物理檢查。

生成流程採用 Unified Scene Representation,先在共用 scene frame 內完成 sparse structure generation 與 geometry-latent generation,再把物件轉到 local voxel support,結合場景資訊細化後放回原位。

  • 同時生成環境及可分開處理的物件。
  • 場景可直接匯入導航模擬器。
  • 互動預覽經壓縮,約為原始結果的 10%。

導航模擬是已展示的用途,但程式碼、Checkpoint 及 Dataset 仍標示即將公開;目前未提供量化性能或對比結果,重現效果仍有待驗證。

項目主頁

Categories: 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, 3D, Dataset 數據集

MotorMind-Code:通用視覺語言模型零樣本操控機械人

MotorMind 讓通用視覺語言模型透過中階動作控制機械人,並用即時回饋檢查進度、修正失誤。它在模擬環境和真實機械人上測試,毋須針對任務訓練策略。

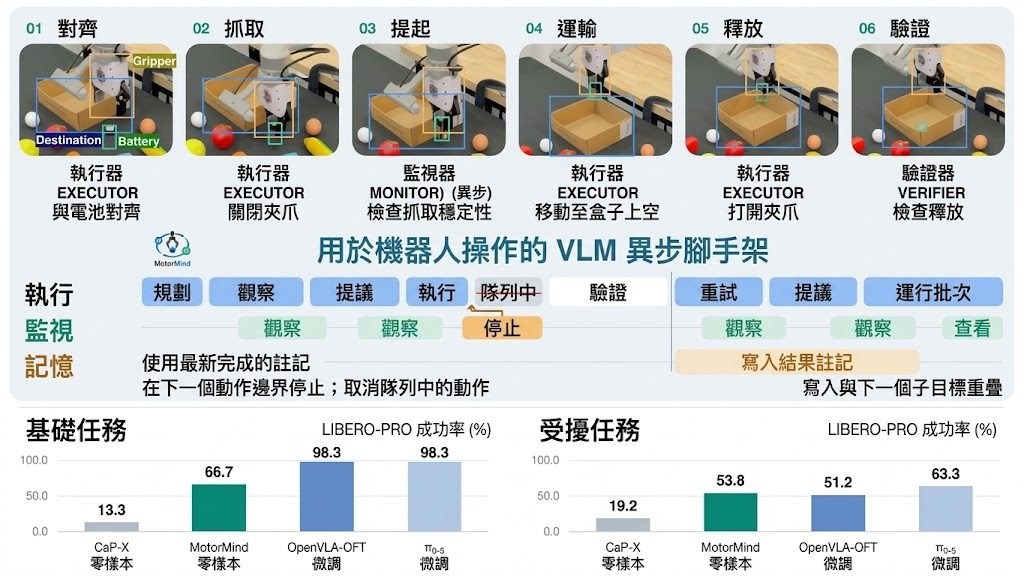
MotorMind overview: robot execution frames, asynchronous monitoring, and manipulation results

要令機械人按指示完成操作,模型不只要看懂畫面,還要判斷下一步、確認動作有否奏效。MotorMind 是一個機械人操控研究項目,讓凍結的通用視覺語言模型(Vision-Language Model,VLM)提出中階動作,再由執行框架把決策交給機械人,並以量度到的回饋檢查結果;過程不需針對特定任務訓練策略。

模型不會一次過決定整個操作流程。MotorMind 會並行監察機械人執行情況,確認子目標是否完成;若觀察到的結果不符預期,便可修正動作、恢復執行或重新規劃。這種做法把 VLM 的推理與機械人控制接起來,但不依賴專用動作專家、技能 API 或動作規劃工具。

項目在 LIBERO-PRO 模擬環境及 xArm6 真實機械人上測試,亦以 240 條視覺問題評估模型選擇動作、判斷進度和確認子目標完成的能力。評估結果指出,動作選擇是各模型較難處理的部分;因此,即使加入持續監察與結果核實,也不能視為每次都能正確控制機械人。

現時 GitHub 儲存庫尚未提供程式碼或執行指引,項目預告會在 10 月 15 日前發布程式碼。目前可先參考研究介紹及其模擬、真機測試結果,待程式碼和設定方法公開後,才適合自行重現或接駁機械人。

  • 不需為特定操作訓練專用策略,改以通用 VLM 提出中階動作。
  • 執行期間持續核對觀察結果,支援修正、恢復及重新規劃。
  • 測試涵蓋 LIBERO-PRO 模擬環境與 xArm6 真實機械人。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, API, Robotic, 框架, 工具, 庫, Skill 技能

GTR 以循環架構壓低高解像度視覺推理成本

GTR 以無 softmax 的循環式視覺骨幹處理多種密集預測,在速度與精度之間尋找更實用的平衡。

teaser

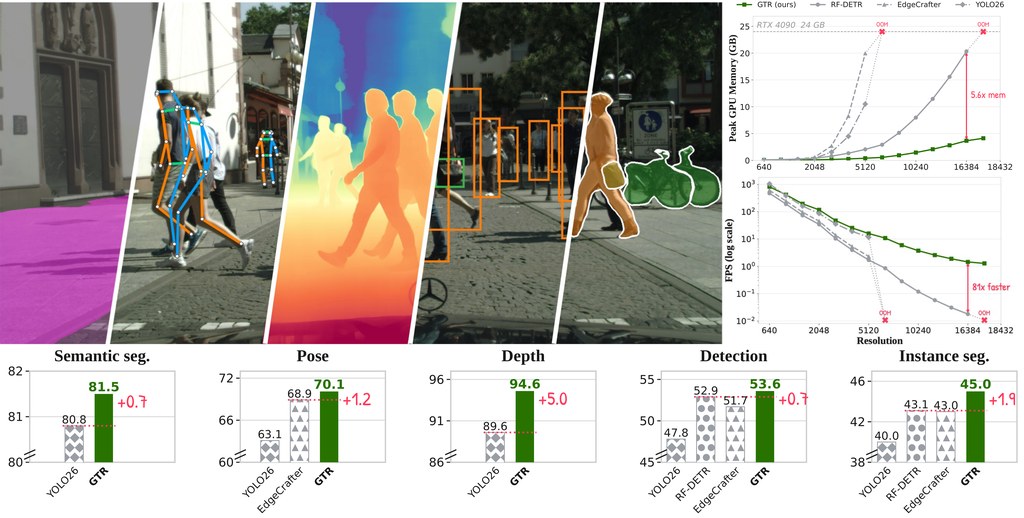
高解像度影像令全域 softmax attention 的計算量隨 token 數量平方增加,GTR 以無 softmax 的循環式視覺骨幹處理這個瓶頸,支援物件偵測、分割、姿態、深度及定向偵測。它屬於視覺模型,實際解決同一組影像特徵如何兼顧多種密集預測任務與推理速度。

GTR 由 12 層 Gated Linear Attention(GLA)組成,每層輪換二維掃描方向,再配合加入 3×3 depthwise convolution 的 Spatial SwiGLU,補足鄰近 patch token 的局部資訊。模型以 stride-16 單尺度特徵圖運作,並透過輕量三尺度 projector 和 query-based head 輸出不同任務所需結果。

  • 以單次平方 L2 loss,將學生模型最終 patch token 對齊 detection-specialized DINOv3 teacher
  • 同一個 GTR backbone 支援六類密集預測任務
  • RTX 4090、FP16、batch 1 下,GTR-L 達到 58.9 COCO box AP,median forward pass 為 1.908 ms
  • 提供 chunkwise CUDA operator,亦支援 TensorRT 部署到 DRIVE AGX Thor

倉庫包含環境準備、資料處理、訓練、評估、推理及 TensorRT 部署流程,適合研究高效視覺骨幹、車載感知或需要多任務共用模型的團隊。代價是 CUDA 專用算子及編譯流程提高了硬件依賴;官方延遲數字來自 RTX 4090 或 DRIVE AGX Thor 的特定設定,換用其他裝置時仍需重新量度。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 香港, 庫

Page 2 of 23
1 2 3 4 … 23