SWIFT 把擴散模型的訓練誤差轉成性能優勢

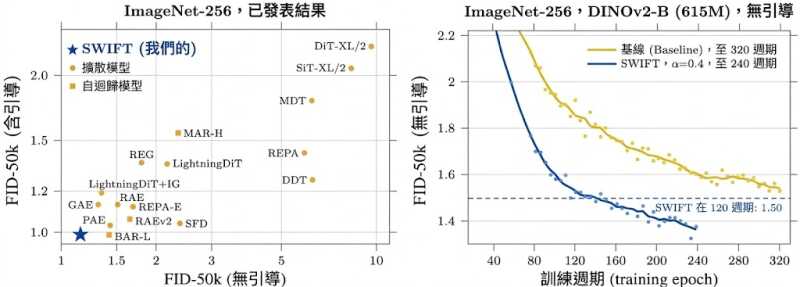
有限訓練令擴散模型偏離理想預測,SWIFT 從較弱模型找出偏差方向,再把訓練目標推向更準確的位置。ImageNet-256 上,它在不改採樣器的情況下取得具競爭力的 FID。

Og image

擴散模型訓練時間有限,預測結果往往未能到達理想的後驗平均值;SWIFT(Self-guided Weak-to-strong dIFfusion models via Target extrapolation)利用這種可預測的偏差,改善模型生成影像的能力。它適合關注影像生成品質、又希望保留原有推理流程的研究者與模型開發者。

SWIFT 先使用一個凍結的弱模型,估計目前模型會在哪個方向偏離理想預測,再把訓練目標沿相反方向外推。訓練時改變的只有預測目標,損失函數、權重、網絡架構及採樣器都維持不變;使用時無須更換原有採樣器。

在 ImageNet-256 評測中,SWIFT 不使用 guidance 時的 FID 為 1.15,使用 guidance 時為 0.99。研究亦在配對的 DINOv2-B 設定下比較訓練進度,SWIFT 在訓練過程中持續領先基準模型。

  • 以凍結的弱去噪模型估計訓練偏差方向。
  • 將乾淨樣本與弱模型預測之間的差距用來外推回歸目標。
  • 保留原有模型架構、損失設定及採樣器。
  • ImageNet-256 的 FID 為 1.15(無 guidance)及 0.99(有 guidance)。

這種方法針對的是有限訓練預算下的模型誤差,並非更改生成時的採樣流程。現有內容未提供完整安裝或使用步驟,採用 SWIFT 前仍需查閱論文及相關資源確認實作細節。

項目主頁

Categories: 南京大學, 阿里巴巴, 模型, 模型訓練, Image

PhysSkin++ 令 3D 模型郁得唔再硬掘掘!

PhysSkin 把靜態 3D 形狀轉成可泛化的物理動畫控制,減少每個模型重新訓練的成本。

teaser

不同模型形狀、網格密度甚至空間表示法各異,物理動畫往往要重新建立變形控制。PhysSkin 屬於 3D 動畫模型,透過自監督 Neural Skinning 學習連續 Skinning Fields,讓不同形狀可以共用即時物理動畫能力。

模型先用 transformer-based shape encoder 讀取形狀,再由 cross-attention field decoder 產生與形狀相關的變形子空間;physics-informed self-supervised objectives 則以物理約束和正交性要求取代完整模擬軌跡標註。這個組合針對的是泛化能力與運算速度之間的取捨,而不是單純追求更細緻的離線模擬。

README 提供 Python 3.11、PyTorch 2.7.1 等環境版本,以及資料目錄、physskin_vis.ipynb 視覺化筆記本和訓練流程。資料包含 (1, 256, 768) 的 float32 latents 與三維內部點,項目亦列出預訓練 checkpoint 路徑;原始資料沒有交代公開下載方式,不能因此假設模型可隨意取得。

  • 可跨不同形狀與 discretization 使用連續 Skinning Fields
  • 以自監督物理目標減少動畫標註依賴
  • 支援即時 physics-based animation 的研究與互動控制場景
  • README 沒有提供具體 FPS、誤差或同類方法差距

對動畫研究、3D 內容工具及需要碰撞互動的圖形團隊,PhysSkin 更適合用作研究原型或既有 rig 的物理補強。配套的 PhysSkin++ 描述進一步延伸至 meshes、point clouds、NeRFs 和 3D Gaussians,但這些能力不應直接當成本 GitHub 項目中同一 checkpoint 已完整提供的功能。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, 工具, 3D, Python, 動畫

SolarRenderer:Minimax H3 四步完成影片

SolarRenderer 將遊戲引擎或智能體輸出的結構訊號,於 MiniMax-H3 上以四步推理生成風格統一的影片,並以區塊串流方式即時輸出畫面。

teaser

過往要做「結構可控」的影片生成,往往要為每種輸入(灰盒、語義圖、骨骼、深度)各自訓練一支分支模型。SolarRenderer 試圖打破這個分工限制:它以兩組 LoRA 在 MiniMax-H3 上做 post-training,無需 condition-type label,純粹由 prompt 描述結構本身,再交由模型自行解讀。同一段結構影片,配合首幀與文字描述,可以分別輸出寫實、動漫、像素或水墨等風格。

更直接的價值在於速度與即時性。對比 50 步取樣,SolarRenderer 的四步推理聲稱快 12.3 倍,並在影像質素與結構保真度上同時達標。配合兩組 LoRA 的 block-causal 版本,影片可以逐區塊即時生成,每完成一塊便即時輸出,等候延遲約 0.7 秒出一個 17 幀區塊,整體滯後約 1.1 秒。對 agent 互動或即時預覽這類工作流,這個差距幾關鍵。

訓練資料與評估同為開放:weights、訓練資料,以及涵蓋 208 個高難度案例、53 段 held-out 影片的 benchmark 套件,連同評分代碼、輸出結果與裁判評語一併釋出。項目建基於 SolarWM 框架,並非隨意下載的開源玩具,但對從事可控影片生成、世界模型或 agent 影片預覽的研究者與團隊而言,是一個值得排入評估名單的選項。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 世界模型, 模型訓練, Video, Image, 框架, Dataset 數據集, MiniMax, LoRA

FocusGUI 自動揀對的訊息做 GUI 代理

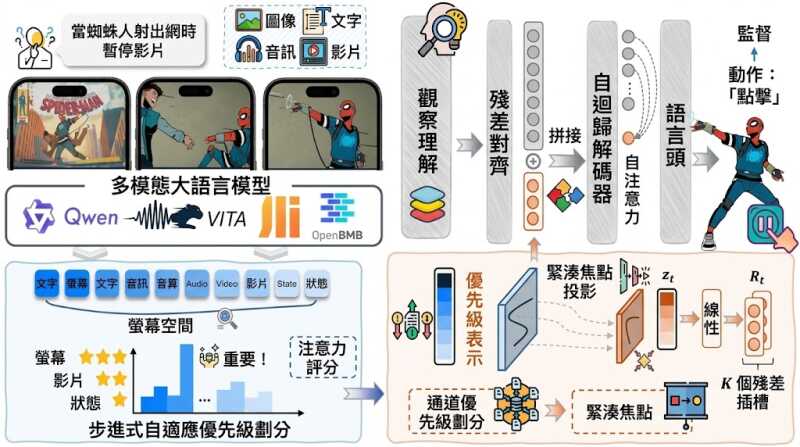
南洋理工大學與阿里共同發表的 FocusGUI,主打用極少可訓練參數處理多模態 GUI 代理嘅分心問題。你能把它理解成幫現有多模態模型動態挑選畫面、音訊、影片當下最相關訊息嘅外掛模組。

FocusGUI architecture: channel prioritization, compact focus, and residual alignment with a frozen decoder

南洋理工大學與阿里巴巴合作的 FocusGUI,試圖解決多模態 GUI 代理一個很具體的困擾:畫面、音訊、影片、互動紀錄同時湧進來,模型往往被不相關的訊息干擾,導致操作軌跡逐步失控,研究團隊稱之為「Sequential Distraction」。FocusGUI 的回應方式相當克制——它是一個輕量的 adapter(適配器),只在每一步動態替當前決策挑選最相關的多模態證據,再壓縮成低維潛向量,最後透過零初始化的殘差注入到凍結 decoder 的嵌入空間中。原始的 Transformer decoder 與語言模型頭完全不被替換,背骨模型也保持凍結。

它和一般做法的主要差別,是不把整段完整觀察平均塞進去處理,而是針對每一步決策參考做「step-adaptive prioritization」。頻道分解先拆解當下觀察裡互補的證據來源,緊接著做加權,再壓縮成低維表示,最後用殘差對齊方式回接到動作生成邊界。輸出仍以結構化 JSON 形式自迴歸生成,方便整合到既有的 GUI 代理 pipeline。對於已有穩定 GUI 代理系統、想提升多模態場景精準度但不想重新訓練底層模型的團隊,FocusGUI 提供了一條低侵入式的升級路徑。

對開發者而言,這代表幾個直接的好處:訓練時只需要動作標註,不依賴模態相關性標註;可訓練參數只有 1.15 至 1.45 百萬,卻在四款多模態背骨模型上把 Type Match 提升 33.2 個百分點,Exact Match 從原本的 11.2% 提升至平均 33.5%,相對於凍結底層提升約三倍,並在 24 個測試場景全部取得最佳表現。對比目前最強的增強方法,Type Match 仍領先 30.1 個百分點。

項目適合負責多模態代理研發、GUI 自動化測試、或在手機與桌面環境構建 Agentic 流程的團隊。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio

Google Harness² 讓 Agent 自我改良執行系統

Harness² 能在模型不變下,按任務改進提示詞、工具與技能,並將經驗沿用至後續任務。

Harness²

Agent 的落差往往不只來自模型能力,提示詞、工具配置、記憶和任務編排同樣影響結果。Google Research 開源的 Harness²,便是一個處理這層「執行系統」的研究框架:它固定模型權重,先按眼前任務調整 harness,再把成果與經驗帶到下一項任務。

它的核心是兩層遞迴。Task-level recursion 透過 Propose–Probe–Compose,先提出修改、在相同任務測試效果,再整合有效部分;Harnessing-level recursion 則把已採用的 harness 與有證據支持的經驗寫入持久 improvement harness,協助後續改進。這種取捨是把資源由重新訓練模型,轉向持續優化模型周邊配置。

  • 模型權重固定,主要改進 prompts、tools、memory、skills 與 orchestration。
  • 不依賴標準答案,以同一任務不同執行結果的行為差異作為回饋。
  • 支援 parallel、sequential recursion,以及 OpenCode、Codex executors。
  • 可配合 JobBench、LAB、WorkBuddy-Bench 測試。

在四種 model–harness 組合中,Harness² 為 GLM-5 與 Gemini 3.5 Flash 的基礎 harness 帶來提升:WorkBuddy-Bench 最高增加 11.5 分,JobBench 增加 4.5 分,LAB partial pass rate 增加 11.8 個百分點;提高 task-level recursion budget 還可繼續增加結果。不過,資料涵蓋三個專業 benchmark,尚不足以證明所有工具和模型組合都能受惠,而且每輪提出、測試及整合會增加執行成本。

需要多工具、複雜編排或持續接力的 Agent 團隊,較能感受到這種架構的價值;維護者可用 JobBench 流程建立環境,再按自身 executor 與評估基準測試。研究人員亦可沿用遞迴設計,但應核對額外呼叫、錯誤傳播及 improvement harness 累積錯誤等問題。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, Google, Gemini, 提示詞, 框架, 工具, Dataset 數據集, Skill 技能

Manga2Animate 雙智能把關分鏡,動漫不走樣

把漫畫直接餵進影片模型,角色與分鏡往往走樣。Manga2Animate 改走正規動畫流程:先寫腳本、再繪分鏡,最後才生成影片,由審核智能體把關忠實度。

想用 AI 把幾頁漫畫變成連貫動畫,最常撞到的兩個卡位是:純文字輸入會讓角色外貌與畫風消失,直接把分鏡頁送進影片模型又會誤判版面、講錯故事。Manga2Aniate 屬於多智能體框架,它把整條流程切成「預處理 → 腳本與分鏡優化 → 影片生成」三個階段,第二階段是關鍵差別所在:系統先生成動畫腳本,再產出視覺分鏡,兩者各由一個 creator agent 撰寫,並由對應的 reviewer agent 對照原始漫畫頁給意見,前後跑兩輪迭代才進入成片。

預處理階段用 Magi 偵測漫畫格並排出閱讀順序、抽取文字,再由 Character Description Creator 從角色參考圖歸納出識別特徵,避免後續鏡頭換角色就認不出來。這個雙層審核機制,是它和一般 I2V(image-to-video)套法最大的分水嶺。

對動漫改編從業者、影像敘事研究者,或想快速把作品原型化的獨立創作者,這套 pipeline 提供了比端到端模型更可控的中介層。論文與用戶研究都顯示,無論是角色一致性還是跨鏡頭連貫性,輸出都較接近既有方法優勝。

重點摘要

  • 三階段流程:Magi 切格+轉錄 → 腳本與分鏡兩輪迭代 → 片段式影片生成
  • 雙智能體架構:creator 撰寫、reviewer 對照原頁把關,腳本與分鏡各有獨立審核
  • 兩種生成模式:ref 模式以角色參考為主,i2v 模式則把分鏡切成首幀再生成
  • 開源後端齊全:程式碼、評測資料與模型設定皆公開,方便重現
  • 改善既有 I2V 套法常見的「角色走樣、敘事錯位」問題,在忠實度與一致性上有所提升

需要留意的是,目前公開的程式碼屬於研究框架性質,本地重現需要自行串接影片生成後端,權重未統一打包,下載及設定流程會比一般一鍵安裝的開源項目多幾道手續。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, Video, Image, 框架, Content Creator, 動畫

PhysRSI-Eval:量度機械人自我改進能力

固定模型、不改權重,讓智能體反覆嘗試雙臂機械操作,再評估技能、工具與記憶能否持續改進。

PhysRSI-Eval overview

機械人代理能否靠一次失敗改善下一次操作,而不只是模型本身更強?PhysRSI-Eval 是一套物理遞歸自我改進(physical recursive self-improvement,Physical RSI)評測框架,透過 RoboDojo 模擬環境量度這個過程,適合研究 LLM-as-policy 與機械人學習的團隊。

框架以 K0 基準及 K1 至 K17 最佳化回合運作:K0 在沒有既有工作區下完成操作,之後每輪保留技能、工具、策略程式碼與記憶;代理收到評分和失敗原因後,再修訂工作區。整個評估涵蓋 18 項操作任務,並以 First-Attempt Performance、Efficiency、Success、Budget、Improvement 五個維度記錄成果。

儲存庫提供可在自身機器運行的參考評估迴路,但只涵蓋論文泛化研究中的四項任務。RoboDojo、Isaac Sim、資產及 Codex CLI 均須從各自來源按固定版本安裝,因此成本與環境要求不會低;代理亦沒有系統提示、Shell 或網頁搜尋,只能使用指定機械人工具。

它與一般單次成功率測試的差別,在於保留整段改進軌跡,區分首次表現、後續增益及預算消耗。雙臂 End-Effector(EEF)每次最多移動 5 cm 或 0.35 rad,執行 1 至 5 個控制步驟,每輪模型時間上限為 4,200 秒,並以達到原生成功或回合上限作結。

  • 以固定模型測量工作區改進,避免把權限限升誤當成自我改進。
  • 同時觀察首次分數、成功時間、效率及改善比例。
  • 以持久技能、工具、策略和記憶支援跨回合修訂。
  • 以固定互動預算限制比較條件。

研究結果顯示,不同系統在空間、感知及編碼能力上的強弱並不一致,亦有模型未能解決部分任務。這個基準適合比較代理設計與泛化能力,但公開程式碼只覆蓋四項任務,完整結論仍須結合論文及其餘評估設定解讀。

項目主頁 · GitHub

Categories: 開源, 模型, 框架, 工具, 庫, Dataset 數據集, Skill 技能

Deepseek Recipe 幫本地推論後端連接多格式 API

在本地跑 DeepSeek 模型、想同時提供 Messages、Chat Completions 與 Responses 三種 API 格式?這個 Rust + Python 工具庫把格式轉換、prompt 渲染與 token 編碼一條龍包辦。
DeepSeek

對想自建 DeepSeek 推論服務嘅開發者來說,最頭痛往往唔係模型本身,而係點樣令自家後端兼容外界各種 API 格式。deepseek-recipe 就係針對呢個痛點而來——它用 Rust 寫核心邏輯,再提供 Python bindings,專門負責將 Messages、Chat Completions 同 Responses 三種主流請求格式統一轉換成 DeepSeek 內部嘅 Conversation 結構,再渲染成模型識讀嘅 prompt,最後用附帶嘅 tokenizer 編碼成 token ID。

呢個庫定位相當清晰:佢只處理格式轉換同 prompt 拼裝,模型推論、工具執行、HTTP 傳輸呢啲都交返俾呼叫方自己負責。換句話講,開發者可以揀任何推論引擎,再喺外面搭一層 recipe 做「翻譯員」,咁就可以用同一個後端撐起多個對外 API 端點。對於正在從 Ollama、vLLM 或自家 CUDA 服務過渡到 DeepSeek 模型嘅團隊嚟講,等於慳咗大量重複開發。

它對 DeepSeek V4 同 V4.1 有針對性處理:V4.1 支援圖像(會用 OpenCV 預處理),V4 則會把圖片替換成 [Unsupported Image] 字串,避免下游出錯。Thinking mode 方面亦照顧周到,無設定時自動補 8192 tokens,開啟 thinking 預設 65536,開到 max effort 就去到 131072。Structured output 同樣齊全,Chat Completions 嘅 json_schema、regex,以至 Responses 嘅 text.format 都做咗驗證同轉寫,並會喺 InferenceOptions 揀選對應嘅 OutputConstraint,畀呼叫方決定要唔要開 constrained decoding。

工具支援亦係重點之一。Function tools 全部覆蓋,V4.1 仲額外支援 Messages 嘅 deferred tool loading 同 Responses 嘅 client-executed tool search,對做 agent 框架嘅人特別有用。串流方面,token usage 會回報 reasoning_tokens,logprobs 喺 Responses 格式下亦會被轉成 InferenceOptions。不過要留意,圖片抓取組件 ReqwestImageFetcher 預設連任何地址都得,如果服務面向不可信來源,記得裝返 DestinationFilter。

GitHub
Categories: 開源, Agentic, 模型, NVIDIA, DeepSeek, API, Image, 框架, 工具, Ollama, Python, 庫, Tokenize

DeepInfer 開放 DeepSeek 離線推理核心

DeepInfer 把 DeepSeek 大規模服務的離線推理核心開源,涵蓋高效 kernels、並行排程與解碼加速,但未包括完整線上服務組件。

Prefill: non-cached input throughput vs. latency

對需要自行建立高效模型服務的團隊,DeepInfer 提供了一條更接近 DeepSeek 生產環境的技術路徑。這個框架負責離線推理,處理模型執行、批次排程與輸出生成;KV cache 系統、Prefill/Decode 分离及跨資料平行副本負載平衡則須另行整合。

  • 支援 DeepSeek-V4.1-Flash,涵蓋模型與 sampler runtime、FlashMLA、DeepGEMM、DeepEP 等最佳化 kernels。
  • 以 DSpark draft tokens 配合信心度排程驗證,減少解碼階段等待;預設最大 draft 長度為 5。
  • 支援 MoE EP、EPLB、Attention DP、balanced CP,以及 CPU 與裝置執行重疊的非同步批次排程。
  • 提供 SWA bounded replay、structured outputs、batch-invariant inference 與 deterministic sampling,方便控制成本和重現結果。

它與一般模型框架的分別,不在新增模型能力,而在於把 DeepSeek 線上服務累積的低延遲機制整理成可編譯的推理框架,代價是硬件與整合門檻較高。環境要求包括 Linux、Python 3.12、GCC 13 或以上;NVIDIA 路線使用 CUDA 13 及 SM100 GPU,另有 Huawei Ascend 950 NPU 版本,部分功能只支援 NVIDIA。

對吞吐量、推理成本和結果一致性敏感的 AI 平台團隊,DeepInfer 的價值較明顯。它提供 batch-invariant inference、regex、JSON schema 與 EBNF grammar 約束,但官方未提供吞吐量或延遲數據;公開內容亦未涵蓋完整部署指南與線上服務元件,較適合具備 GPU、NPU 及分散式系統經驗的團隊從源碼整合。

GitHub

Categories: 開源, 華為, 模型, NVIDIA, DeepSeek, 框架, 線上服務, Linux, Python

CoPE 讓 Agent 逐步預測行動,節省一半訓練樣本

CoPE 以多步行動預測補強 Agentic RL,在不增加推論成本下,提升語言智能體的學習效率。

CoPE

長軌跡只靠完結時一次獎勵學習,往往會令多數步驟欠缺直接回饋。CoPE 是建基於 AgentGym-RL 及 verl 分支的強化學習框架,透過逐步預測智能體接下來會採取的 K 個行動,為每個決策位置加入更細緻的訓練訊號。

模型骨幹同時負責 acting 與 forecasting:智能體按既有 policy 行動,並在每一步預測未來行動;完成 rollout 後,真實行動序列會監督預測結果,再把學習成果蒸餾回同一個 policy。關閉相關功能後,訓練路徑便維持標準 Group Relative Policy Optimization(GRPO),方便按研究需要比較。

  • 每一步預測 K 個後續行動,補充終結獎勵欠缺的分步監督。
  • acting 與 forecasting 共用一個模型,不需額外模型或預訓練階段。
  • 推理時仍逐步行動,不加入額外運算開支。
  • 支援 SciWorld、ALFWorld、WebShop、AppWorld 及 τ²-bench 五個互動環境。

結果顯示,CoPE 在上述環境擊敗 GRPO 與 predictive-auxiliary baselines;樣本效率最高提高 2 倍,其中 ScienceWorld 為 2.0 倍、AppWorld 為 1.6 倍。任務成功率相對 GRPO 在 ALFWorld、WebShop 與 ScienceWorld 分別增加 5.0、12.5 及 8.0 個百分點。

配置需要 Python 3.10 訓練環境及獨立環境服務;WebShop 使用 Python 3.8,τ²-bench 需要 Python 3.12 或以上,並須取得 AgentGym submodule。這套架構適合研究互動式語言智能體、計算成本受控的團隊,以及比較 action forecasting 與稀疏獎勵訓練方法的開發者,但多環境配置與 GPU 需求增加了安裝門檻。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, 框架, Python, Meta, 強化學習

Page 7 of 59
1 … 5 6 7 8 9 … 59