ConCor-1:一句標註都唔使畀,自動搵出圖文對應

ConCor-1 將視覺語言定位反轉成雙向概念對應,唔使預先指明想搵乜字句,畀一張圖同一段文字就會自動判定邊啲文字對應邊個物件。

Bidirectional concept correspondence: a caption, a referring expression and a category list all produce the same output

以往做視覺語言定位,多數流程都要你先講明想搵邊句字,模型再喺圖入面指出對應區域。ConCor-1 索性反轉呢個做法:畀一張圖同一段文字,無論係完整描述、指代表達,定係一列類別名,模型都會自己判斷邊段文字同圖入面邊個物件對得上,然後一次過畀齊文字遮罩、實例遮罩同對應分數。研究團隊由華盛頓大學、Allen Institute for AI 同 Meta FAIR 組成,模型基於預訓練視覺語言模型,再加上一組可學習嘅 bridge tokens 嚟代表候選對應。

呢種設計最大嘅實用價值,係省卻前置標註嘅工序。當你手上得一段長 caption 或者一大串類別名,傳統方法往往要逐句拆開再分批餵入,ConCor-1 直接當作一次對應預測處理,文字分割、影像分割、跨模態對齊三件事一齊做。佢將 phrase grounding、referring expression 同 open-vocabulary detection 收納成同一格式,等訓練同評測可以用統一數據集比較。

ConCor-1 喺長 caption 數據集上將 correspondence F1 提升 48%,喺零樣本 LVIS、即用大類別清單當文字輸入嘅場景亦提升 29%。Hugging Face 上已有模型權重、數據、Space Demo,源代碼以 Apache 2.0 發佈。對做細粒度理解、自動化標註,或者想整合長描述入視覺流程嘅團隊,呢個框架值得留意;想自行重現訓練嘅人就要再等等,現階段主要提供推論程式碼同評測即將推出。

重點摘要

  • 雙向概念對應:毋須預先指明文字,直接輸出文字遮罩、實例遮罩同對應分數
  • 統一格式:將 phrase grounding、referring expression、open-vocabulary detection 收成單一預測任務
  • 基於 bridge tokens:喺預訓練視覺語言模型上加可學習 token 代表候選對應
  • 顯著提升:長 caption F1 提升 48%,零樣本 LVIS F1 提升 29%
  • 開源配套:模型權重、數據、Space Demo 同推論程式碼已於 Hugging Face 同 GitHub 公開

適合需要從圖文配對中抽取結構化對應、做自動化標註、或研究視覺語言定位框架嘅讀者。ConCor-1 將文字分割、影像分割同跨模態對齊壓成單一任務,特別適合處理長描述或大類別清單等場景。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 多模態模型, Meta, Dataset 數據集

Meta Muse Glimmer:為本地多模態代理而生

Muse Glimmer 30B 針對本地部署而設,把圖文理解和代理式操作放在同一個模型裡。它同時提供 BF16、GGUF 與 ExecuTorch 版本,方便不同裝置取用。

Meta

Muse Glimmer 30B 屬於多模態 agentic model,重點放在本地部署時的可用性。對需要在自己裝置上處理圖文輸入、又想保留代理式工作流的用戶來說,這種設計比只提供單一格式的模型更實用,因為可以按硬件環境選擇合適版本。

Meta 這次一口氣放出多種包裝,包括 BF16 權重、GGUF k-quants、ExecuTorch builds,還有一個較細的 assistant 版本。這代表它不是只面向單一推理環境,而是嘗試覆蓋桌面、本地推理引擎,以及流動裝置部署等不同需求。

從現有資訊看,Muse Glimmer 的核心價值在於把多模態能力和本地執行的彈性結合起來。GGUF 版本方便在本地執行推理,ExecuTorch 版本則指向更輕量的裝置端部署;對想控制資料流向、減少依賴雲端服務的工作流,會更有吸引力。

  • 支援多模態輸入,適合圖文混合任務
  • 針對 local deployment 設計,部署選擇較多
  • 提供 BF16、GGUF k-quants、ExecuTorch 等不同格式
  • 有 30B 主模型與較小的 3B assistant 版本
  • 適合需要本地推理、裝置端或代理式工作流的場景

現時公開資料較集中在模型包裝與部署形式。就定位而言,它更像是一個面向實用部署的多模態模型系列,而不是只靠單一規格吸引注意的發佈。

項目主頁 · 模型

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, API, Image, LLaMa, 安全, Meta

VocalRender 用樂譜直接生成人聲歌唱

寫歌唔再要逐音節對時長。VocalRender用歌詞、MIDI同節奏,直接把譜面轉成更自然的歌聲。

Comparison of duration-based, reference-based, and the proposed score-native singing voice synthesis inputs

寫旋律同填詞的人,最在意往往唔係逐個 phoneme 對時間,而係輸入一份像作曲流程會用到的譜面後,能否聽到有表情、會跟拍子走、又唔會太死板的人聲。VocalRender就瞄準呢個位置:它屬於 singing voice synthesis(SVS)模型,處理的是把歌詞、MIDI pitches、note values 同全域 tempo,連同一段提示音色片段,直接渲染成 48 kHz 歌唱音訊。

它和常見 duration-based SVS 或 reference-based 系統的分野相當明確。前者通常要為每個字或 phoneme 準備精確時長,後者又依賴 time-aligned audio 或 F0 curve;VocalRender改為讀 composer-oriented symbolic scores,讓模型自己在跟譜之下安排較自然的 timing 與 expressive deviations。對作曲、demo 製作、旋律草稿驗證,這種做法比硬性對齊更貼近創作流程。

技術路線亦有清楚取捨。它先用 interleaved lyric-note representation 保留字詞與音符對應,連 melisma 這類一個音節跨多個音都能明確表示;再由 Audio VAE 壓成 continuous acoustic latents,保住 pitch、timbre 同 articulation 細節,之後交給 autoregressive diffusion 建模,其中 AR Transformer負責較整體的 prosody sketch 與長度預測,LocDiT再補回高保真局部聲學內容。

  • 支援資料前處理、訓練同推理,屬於可重現研究流程的最小開源版本
  • 可配合 Hugging Face 模型、CrawlSinger-OS 資料集同官方 Audio Demo 一齊理解效果
  • 輸入核心是 word / pitch / note interleaved score prompt,而唔係逐 phoneme 時長標註
  • 評估線索包括 SingMOS 與 AES,當中 AES 會看 content enjoyment(CE)同 production quality(PQ)

部署時要準備提示音色片段,亦要理解它重視的是「按譜生成有表情歌聲」,不是完全取代後期混音或商業級歌手複製。對需要快速聽到作曲結果、又唔想先做大量時間對齊標註的團隊,VocalRender的價值相當直接,限制亦同樣清楚:它把創作入口大幅簡化,但音色條件、資料品質同最終審美仍然會左右成品。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Audio, 語音

RVC WebUI:低門檻變聲框架的實用與代價

這個語音音色轉換框架把訓練、推理和即時變聲放進同一個網頁介面,重點是讓少量語音資料也能做出可用效果。它的強項在於速度、易用性和模型融合,代價是硬件與延遲條件仍會影響體驗。

Repository image for RVC-Project/Retrieval-based-Voice-Conversion-WebUI

RVC(Retrieval-based Voice Conversion)WebUI 把語音音色轉換、變聲推理和即時變聲收進同一套 Web 介面,適合要快速做 AI 歌聲、配音修音或聲音風格替換的人。它不是單純展示效果,而是把訓練、檢測、推理和即時輸出串成一條可操作流程,降低了進入門檻。

這個項目主打少量資料也能訓練出可用模型,官方建議至少準備 10 分鐘低底噪語音。它採用 top1 檢索去替換輸入特徵,減少音色洩漏,並用 InterSpeech2023-RMVPE 做人聲基頻提取,處理哑音問題時速度快、資源占用也較小。

支援 Python 3.12 x64;Ubuntu 24.04、Windows 與 Linux 都有對應路徑,A 卡和 I 卡則走 CPU 依賴方案,Windows 亦可用 DirectML。即時變聲延遲官方標示可達端到端 170ms,配合 ASIO 輸入輸出設備時可進一步降到 90ms,但對硬件驅動支援要求較高。

  • 可用少量語音資料訓練,門檻比傳統聲音模型低
  • WebUI 同時覆蓋訓練、推理與即時變聲
  • ckpt-merge 允許用模型融合去調整音色
  • 可接入 pymss/MSST 分離人聲與伴奏
  • 更適合配音、歌聲轉換、直播變聲與聲音原型測試

GitHub

Categories: 開源, 數字人, 模型, Linux, Python, 語音, 中國

LFM2.5-2.6B:細模型做得到本地 Agent

LiquidAI 把 2.6B 模型做成可離線執行的 Agent 核心,重點是工具調用同多步任務。它更像一個為裝置端而設的工作模型,而唔係只追求聊天流暢度。

Og image

LFM2.5-2.6B 屬於經過後訓練的語言模型,基礎模型是 LFM2.5-2.6B,並非頁面再細分成其他來源模型。它的定位很清楚:在筆電、手機呢類裝置上處理工具調用、網頁搜尋同多步工作流程,盡量將推理留喺本地,減少資料外傳同雲端成本。

模型先經過約 34T tokens 的 pre-training,再用 mid-training 將上下文擴到 128K。之後以四階段後訓練把 base model 變成 agent,包括兩輪 SFT、按領域訓練 teacher、MOPD(Multi-domain on-policy distillation)同 Agentic RL(Agentic Reinforcement Learning)。頁面亦提到它在常見 agentic harness 內做過強化學習,目的係提升同工具框架的兼容度。

重點放在 GGUF 格式、mmproj 及量化版本,但目前提供的內容未列出完整檔名與各自大小,所以無法可靠列出每個檔案細節。作者建議由 Q4_K_M 作為起點,再按記憶體同速度需求向上或向下選擇;頁面同時指出它可以配合 llama.cppOllamaLM Studio 使用。

它在 Apple M5 Max 可達 220 tok/s,在 AMD Ryzen CPU 上可達 113 tok/s,而且記憶體需求低於 2.5 GB。不過,模型亦有清楚限制:它主要強在 agent 任務同工具使用,並唔代表所有通用推理場景都會贏過更大的模型;進階用法可配合 MTP draft speculation,但頁面未提供足夠細節去判斷其實際收益幅度。

  • 約 34T tokens 預訓練,後續再做 agent 導向微調
  • 上下文窗擴到 128K,適合較長任務鏈
  • Q4_K_M 可作為量化起點,兼顧體積同速度
  • 支援 llama.cppOllamaLM Studio
  • 設計重點係本地工具調用、多步 workflow,同私隱優先

項目主頁 · 模型

Categories: 模型, 教學, Mac, LLaMa, Ollama

DeepVoyager-VL 把視覺線索放回搜尋流程中

DeepVoyager-VL不只是睇圖再答題,而係會用新取得嘅視覺證據決定下一步搜尋。對長流程多模態檢索項目而言,呢個改動幾關鍵。

Comparison of multimodal search data synthesis paradigms

當一個多模態 agent 要連續查多步資訊,最易失準嘅位置往往唔係答題,而係中途搵錯線索。DeepVoyager-VL處理嘅正正係呢個問題:佢屬於長流程多模態 deep-search 框架,讓新取得嘅圖片證據直接影響下一輪檢索,而唔係只喺輸入開頭或答案結尾先用到視覺資訊。

呢種做法令佢同一般把視覺訊息包裝成前置條件嘅方法有明顯分別。DeepVoyager-VL背後用 EventVoyage-VL 生成帶有中間視覺依賴嘅長流程問題,再用整理過嘅 trajectories 做 Supervised Fine-Tuning(SFT),而唔加額外 reinforcement learning 階段;取捨好清楚,訓練流程較可重現,但效果仍然要靠資料合成質素同軌跡篩選撐住。

倉庫而家已經放出 paper、project page,同可重現嘅 Megatron SFT training bundle,亦提供 DeepVoyager-VL-8B 同 DeepVoyager-VL-30B-A3B 模型,以及 EventVoyage-VL dataset。想理解點樣驗證,最直接係沿住現成模型、資料集同訓練 bundle 睇完整流程;README 亦提到 SWIFT RUNTIME=bundled 會使用儲存庫內嘅 source trees,定位上比較接近研究與訓練復現項目,而唔係即開即用嘅消費級產品。

  • 核心改動:把 vision in the loop 放入搜尋中段,圖片可按需要先載入或裁切
  • 資料來源:EventVoyage-VL 先做 structure-before-language synthesis,再抽出可監督軌跡
  • 訓練路線:以 supervised-only 為主,冇再疊 reinforcement learning 階段
  • 結果:8B 同 30B-A3B 平均分別為 54.8 同 58.6,並在十個 benchmark 入面分別拿下八個同九個最佳成績

分數本身已經講到定位:DeepVoyager-VL不只是追求更大模型,而係想改善「見到新圖之後,下一步應該搵乜」呢個決策環節。較受益嘅會係做多步檢索、多模態問答、研究型 agent pipeline 嘅團隊;要留意嘅限制亦同樣直接,成效高度依賴合成資料點樣把中途視覺依賴編排得夠真實,離開相關 benchmark 之後,泛化深度仲要靠後續驗證。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 北京大學, 華為, Agentic, 模型, 多模態模型, 模型訓練, 框架, Dataset 數據集

UEmbed:單一模型同時做稠密與稀疏檢索

UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,令稠密向量與稀疏詞彙向量可以一併輸出。對要做多模態搜尋或檢索增強生成的團隊,這種設計可減少來回切換模型。

Repository image for Alibaba-NLP/UEmbed

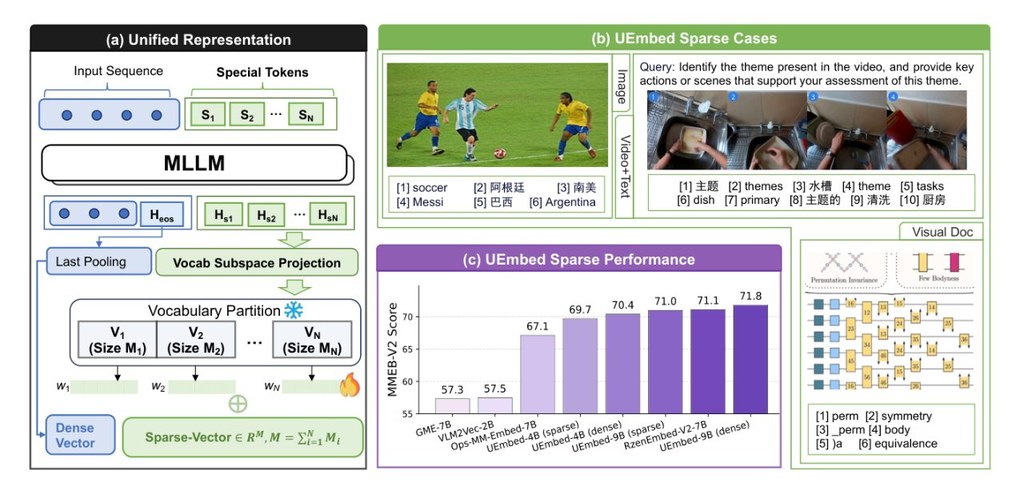
UEmbed 把文字、圖片、影片都放進同一套 embedding 流程,它走的是多模態 embedding 模型路線,重點是把 dense 向量和 SPLADE-style sparse lexical 向量放在同一個 causal forward pass 內處理,方便直接做檢索、多模態搜尋和 visual-document retrieval。它不是只做文字匹配,而是把文字、圖片、影片與混合輸入統一到同一套表示空間。

直接取用 Hugging Face 上的 2B、4B、9B 權重,再按輸入格式送入不同媒體內容,檢查 dense 與 sparse 輸出是否符合預期。若要部署到搜尋系統,dense 部分可接向量檢索,sparse 部分可接倒排索引,兩條路可以同時保留。

它和傳統 learned sparse retriever 最大分別,在於保留 decoder-only multimodal backbone,並用 16 個 learnable special tokens 分攤稀疏詞彙空間,避開單一 token 的表達瓶頸。訓練時同時優化 dense InfoNCE、sparse InfoNCE 和 FLOPS regularization,取捨是結構較巧,但推理時可以用同一個模型兼顧語義召回與詞彙可解釋性。

效能方面,UEmbed-9B 在 MMEB-v2 取得 71.8(dense)與 71.0(sparse),並在公開數據訓練條件下做出很強的稀疏檢索表現;在 BEIR 上亦保持競爭力。對做搜尋、RAG、跨媒體內容索引,或者要把文字與圖像一齊納入檢索的團隊,這套做法會較有吸引力。

  • 同一個模型同時輸出 dense 與 sparse 表示
  • 支援文字、圖片、影片與混合輸入
  • 稀疏輸出可直接對接倒排索引,較易解釋
  • 以 Qwen3.5 multimodal backbone 為基礎,並用公開資料訓練
  • 2B、4B、9B 三個規模可選

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, RAG, Embedding, 模型, 多模態模型, Qwen, Image

Context Scaling 把文生圖提示詞帶到結構化階段

寫得更長未必更準,關鍵反而是提示詞有幾多可對應畫面的結構資訊。Context Scaling 把這件事量化,連帶改寫文生圖訓練與編輯流程。

Text prompt scaling law overview

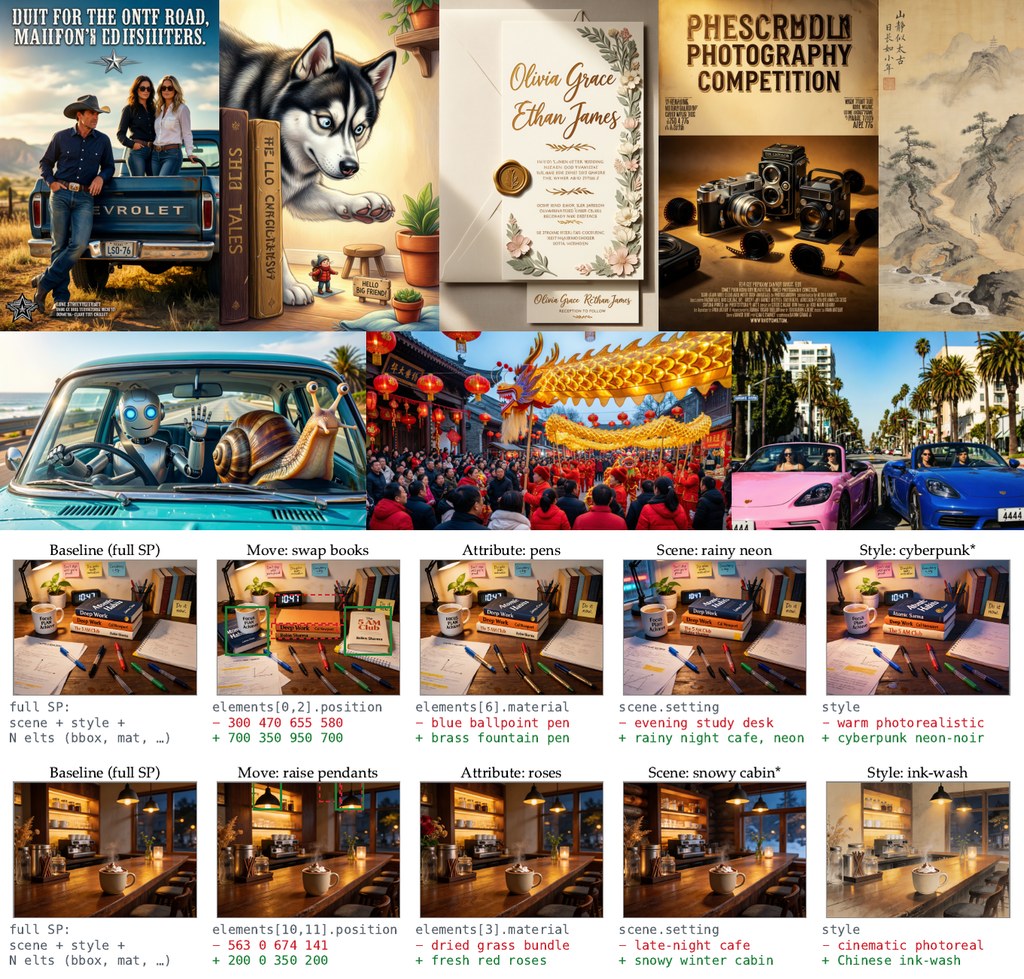
文生圖卡住的位置,很多時不是模型不夠大,而是提示詞交代得唔夠可計算。Context Scaling 聚焦影像生成中的文字條件 scaling law,屬於一個結合研究、模型與工作流程設計的項目,處理的是提示詞怎樣更有效描述構圖、屬性同空間關係,令 diffusion model 更容易學到、亦更容易按要求生成。

它最值得留意的判斷,是 caption 長度本身跟效果關係唔算緊密,反而 structured language 的資訊量更重要。團隊用兩個指標去量度這件事:white-box likelihood metric 的 GPG,同 black-box attribute metric 的 ED;受控訓練結果顯示,converged diffusion loss 會隨 GPG 近線性下降,亦會跟 ED 呈 power law 關係。

Context Scaling: Scaling Properties of Text Conditioning in Visual Generation

這個方向不只停留在分析。項目把 Structured prompts(SP)做成帶 semantic 與 geometric fields 的 JSON schema,再配合 trainable LLM prompter + captioner,將用戶要求或者輸入圖片轉成更有結構的描述;zero-shot structured editing 亦因此變得可行,因為每個可編輯因素都被拆成命名欄位,改其中一部分時,其他構圖元素較容易保留。

  • 重點不在提示詞有幾長,而在畫面資訊有幾可對齊
  • GPG 與 ED 為提示詞資訊量提供兩種量化方法
  • Structured prompts(SP)直接補強 compositional、reasoning、world-knowledge 類生成
  • prompter 經 supervised fine-tuning、cold-start、verifier-gated on-policy distillation 訓練
  • 已公開 Code、Models 與 Demo,理解路線可先看 project page,再到 Hugging Face collection

跟同類做法相比,它的取捨相當清楚:不是單靠更大模型或更長自然語言描述去碰運氣,而是先提升 captions 對影像的可監督性,再訓練 prompter 去穩定產生這類結構。官方說法指出,系統在多個 compositional、reasoning 與 world-knowledge benchmark 上超越全部已評測 open-weight models,並在多數評測追平或超過最強 closed-weight models;不過公開資訊仍以研究結果為主,部署細節與完整安裝流程未算多,現階段較適合做方法研究、提示詞工程、影像編輯流程設計,以及評估下一代文生圖介面的團隊參考。

項目主頁 · GitHub · 模型

Categories: 開源, 字節跳動, 模型, 模型訓練, Qwen, 影像模型, txt2img, Dataset 數據集

DeepSeek-V4-Flash-0731:輕量化 Agent 模型追上大模型

想要較少啟動參數,又保留強 Agent 表現,DeepSeek-V4-Flash-0731 就係呢類取向。它把重點放在工具調用、編碼同自動化任務,速度與能力之間取得幾實際的平衡。

Og image

要兼顧回應速度、部署成本同 Agentic 能力,DeepSeek-V4-Flash-0731 走的是「較少啟動參數換取高效任務表現」的路線。頁面已清楚寫明它與 DeepSeek-V4-Flash-DSpark 採用相同模型結構,並且附帶 speculative decoding module,所以它不只是一般聊天模型,而是明顯朝工具使用、自動化操作與程式任務優化的版本。

它屬於 DeepSeek-V4-Flash 官方正式發布版,取代 preview 版本,並強調 agentic capabilities 有明顯提升。模型卡同時指出它的模型結構與 DeepSeek-V4-Flash-DSpark 一致,代表推理流程很可能圍繞主模型加速草稿模組來設計。

效能數字是最值得留意的部分。它在 Terminal Bench 2.1、NL2Repo、Cybergym、DeepSWE、Toolathlon-Verified、Agents’ Last Exam、AutomationBench Public 等基準上,普遍明顯高於 DeepSeek-V4-Flash(Preview),部分項目亦超過 DeepSeek-V4-Pro(Preview)。這種進步集中在 terminal 操作、程式庫理解、資安演練、軟件修復同工具鏈任務,反映它更像為 Computer-use agents、程式代理與自動化流程而調整,而不只是追求一般問答分數。

  • 與 DeepSeek-V4-Flash-DSpark 同結構,並附帶 speculative decoding module
  • 官方正式版取代 preview,重點提升 agentic capabilities
  • 多個 Agent/編碼基準明顯優於 DeepSeek-V4-Flash(Preview)
  • 啟動參數較少,但表現可與部分強勢閉源模型接近

部署資訊方面,內容只提供一則討論帖,提到可用兩台 DGX Spark 配合 ghcr.io/bjk110/vllm-spark:unholy-fusion-prod-ready 作最少設定部署;但模型頁面片段未列出上下文長度、GGUF 格式量化檔、mmproj、檔案大小、chat template 注意事項或 v2 檔名變更,因此不能推斷 llama.cpp、Ollama、LM Studio 的支援細節,也不能提供 Q4_K_M 一類量化建議。現有資料較適合把它理解成一個偏向高效率 Agent 任務的 DeepSeek 模型發布,而不是本地 GGUF 部署導向的模型。

模型

Categories: 開源, Agentic, 模型, DeepSeek, LLaMa, Ollama

OpenRSI 實現 AI 可控的自我進化流程

OpenRSI唔只放出模型,而係連訓練、任務、搜尋流程一併公開。對想研究 AI4AI 同 Machine Learning Engineering 的團隊來說,它更像一套可重跑的實驗場。

OpenRSI by Frontis

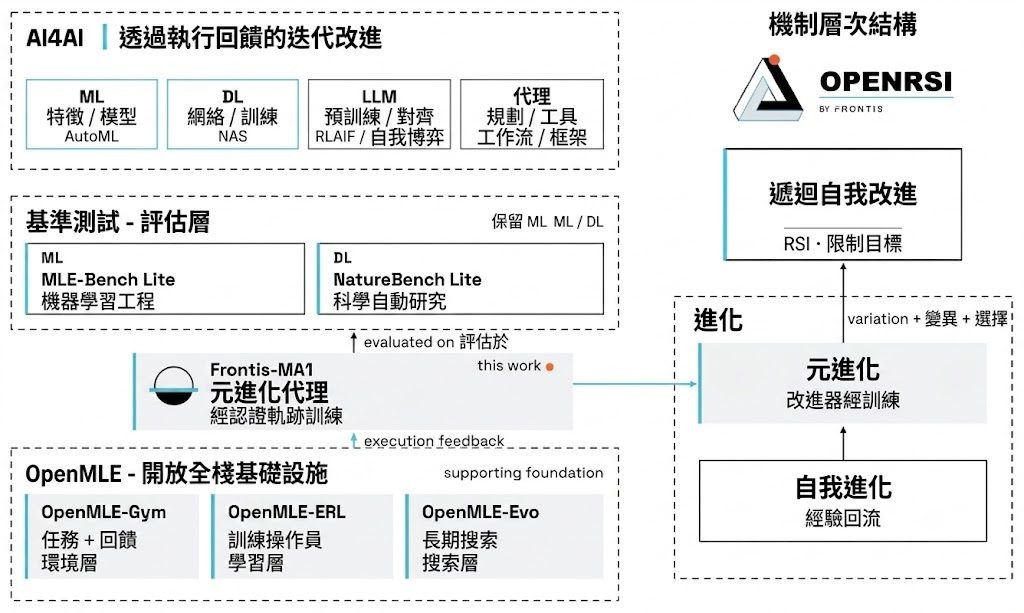
OpenRSI(Recursive Self-Improvement) 唔係單獨放出一個模型,而係把「AI improving AI」拆成可以執行、量度同重現的整套機械學習工程流程。它屬於開源研究框架加模型組合,核心想處理的是:點樣令 AI 不只寫程式,而係能夠持續改良建立 AI 的方法本身。

OpenRSI 由 OpenMLE 同 Frontis-MA1 連動組成。OpenMLE 負責提供可驗證任務環境、執行回饋、RL 與 evolutionary search;Frontis-MA1 則是一個 post-trained AI4AI model,圍繞 Draft、Improve、Debug、Crossover 四種程式演化操作運作,將訓練到的能力接到長步驟搜尋流程之中。呢種做法的取捨很明顯:它追求可重跑與可評測,所以系統較完整,也比只放模型權重的項目更講究環境與任務設計。

項目較適合研究 Agentic workflow、Machine Learning Engineering、自動化實驗搜尋,或者想分析 execution-grounded learning 點樣落地的團隊。資料已列出 Hugging Face 模型、GGUF 衍生版本、Tasks 同 SFT traces,亦有專屬 project page;但目前公開資訊著重系統構成與結果展示,README 摘錄未完整交代詳細安裝步驟,部署前仍要配合原始倉庫與外部連結自行核對。

  • OpenMLE 提供 gym、RL、Evo 等完整堆疊,不只是一組 benchmark
  • Frontis-MA1 把 operator learning 同 long-horizon search 接埋,重點在可執行研究循環
  • 公開內容包括模型、任務資料集、SFT traces,同時照顧訓練與評測重現
  • 提供 GGUF 格式在本地執行推理 的衍生版本,方便不同部署路線

效能方面,項目頁面列出 Frontis-MA1 在 MLE-Bench Lite 由 39.39 提升到 71.21,設定為每個 task 12 小時、單張 RTX 4090 並限制 12 GB VRAM,成績高於 GPT-5.5 + Codex。呢個結果反映它強項在於把執行回饋、後訓練同演化搜尋接成一個閉環;不過現階段它仍主要面向 Machine Learning Engineering,較像一個為 RSI 研究而建的開放實驗平台,而唔係通用型開發工具。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, 模型, Dataset 數據集

Page 8 of 37
1 6 7 8 9 10 37