UI-Venus:多平台介面的高性能代理

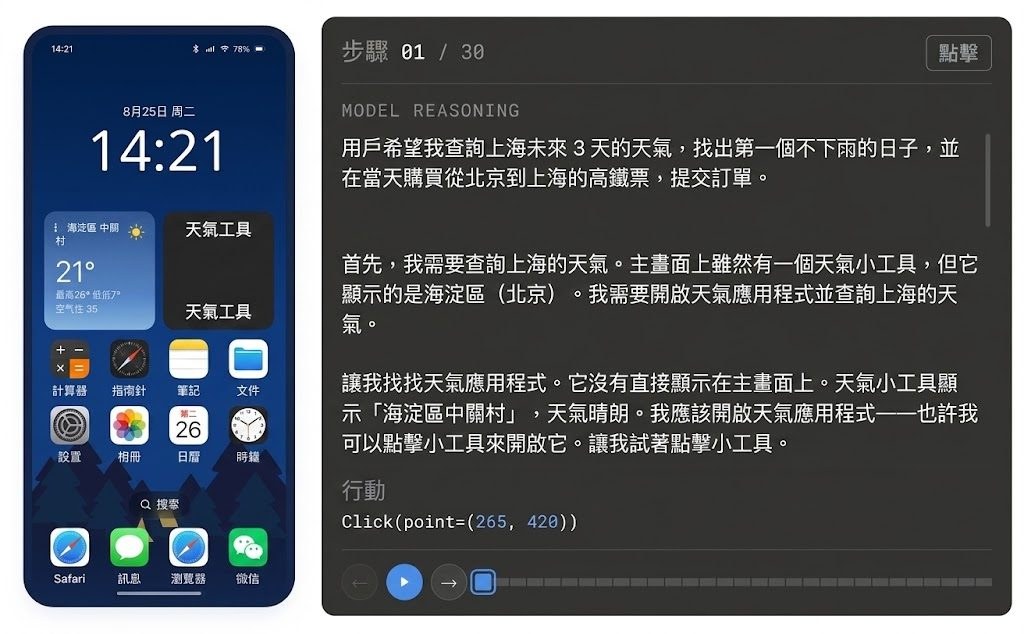
UI-Venus 是一個針對手機、桌面和網頁介面的 GUI agent,重點處理視覺定位與互動導航。它用 35 萬筆專業標註資料和 RFT 提升長流程操作與跨平台泛化。

UI-Venus Performance Across Datasets

UI-Venus 是一個 GUI agent,直接面向手機、桌面和網頁介面,目標是解決看得懂畫面、點得準位置、又能沿著多步驟流程完成任務這幾個卡位。它把 Reinforcement Fine-Tuning(RFT)放進訓練流程,令動作預測不只是識判斷,仲可以連住環境回饋去修正下一步。

項目提供 7B 同 72B 兩個 checkpoint,亦交代咗評估流程同推理腳本,方便按截圖、標註檔同模型路徑去做測試。不過原始資料未提供完整安裝細節同實際部署步驟,較合理的理解係先用它的推理與評估流程驗證在 ScreenSpot-Pro、OS-World-G、AndroidWorld 等基準上的行為。

它的賣點不只是識辨認介面元件,而係把 credit assignment 放到長鏈路任務入面處理,令代理在連續操作時較易對齊目標。官方聲稱它在 AndroidWorld、ScreenSpot-v2、UI-Vision 同相關跨平台基準有競爭力,對需要自動化操作、界面導航同複雜任務拆解嘅團隊會較有吸引力。

  • 針對 GUI 理解同 action prediction,覆蓋 mobile、desktop、web 三類場景
  • 以 350K 高質量、專業標註樣本訓練,並加入 RFT
  • 提供 7B 與 72B checkpoint,以及評估和推理腳本
  • 強調長流程任務的 credit assignment,適合多步驟互動工作
  • 基準表現覆蓋 AndroidWorld、ScreenSpot-Pro、OS-World-G 等項目

對要做介面代理、手機自動化、網頁操作或桌面工作流整合的團隊,UI-Venus 比較像一個可以直接拿去評估能力邊界的基礎模型。它的限制亦清楚:原始資料未交代完整安裝與落地流程,實際接入時仍要按你手上的環境、介面類型同任務難度再做驗證。
項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, UI/UX

Breeze TTS 2 即時語音生成

Breeze TTS 2 主打即時語音互動,兼顧聲線設計、聲線模仿與低延遲串流。它把自然語言指令和參考音訊結合起來,令語音生成更靈活。

Og image

Breeze TTS 2 屬於 text-to-speech(TTS)模型,核心目標是把即時語音互動做得更自然,並同時處理聲線模仿、聲線設計和語氣控制。它基於自然語言指令,既可以用參考音訊去保留聲線特徵,也可以不靠參考音訊直接設計聲音,這令使用場景比一般單一路徑的 TTS 更廣。

模型權重只限研究與非商業用途,而原始程式碼則採用 Apache 2.0,這表示權重與程式碼的授權條款並不相同。

Breeze TTS 2 支援 Voice Clone、Voice Design、Voice Direction,同時提供 Vocal Events,讓使用者可在文字中加入 (laugh)(cough) 之類的表現指令。頁面亦強調它有 ultra-low-latency streaming,適合需要即時回應的對話式語音互動。

重點主要集中在功能和評測定位,沒有提供 GGUF 檔案、mmproj、量化版本、檔案大小,亦未提到 llama.cpp、Ollama 或 LM Studio。只見到它在 Artificial Analysis TTS leaderboard 排名第一,並聲稱表現超越部分閉源前沿系統;但由於頁面未展示完整測試細節,較適合把它視為一個以互動延遲、可控性和聲線表現力作賣點的語音模型。

  • 支援參考音訊模仿,也支援純文字描述生成新聲線
  • 可以用文字內嵌事件控制笑聲、咳嗽等表現細節
  • 主打低延遲串流,適合即時語音互動
  • 權重屬研究與非商業用途,授權限制要先看清
  • 頁面未提供量化、GGUF 或本地推論框架資訊

模型

Categories: 開源, 文字轉語音, 模型, 語音

ReFlowSET 影像翻譯模型,衛星影像新標準

ReFlowSET瞄準 SAR 影像難讀這個老問題,唔再沿用 latent diffusion model 的天花板。它用高保真 latent 空間配合 flow matching,換來更快取樣同更穩定畫質。

Repository image for KAIST-VICLab/ReFlowSET

落雨、夜晚甚至雲層遮擋時,Synthetic Aperture Radar(SAR)仍然影到地表,但訊號雜訊同幾何外觀都令判讀門檻偏高。ReFlowSET 屬於影像翻譯模型項目,處理的是 SAR-to-EO image translation:把 SAR 影像轉成較接近光學 Earth Observation(EO)影像的表達,方便人看,也方便接到後續視覺流程。

它沒有沿用常見的 latent diffusion model 微調路線,而是保留凍結的 FLUX.2 autoencoder,改用從零開始訓練的 conditional flow-matching transformer。這個選擇直接避開舊方法受限於原有 autoencoder 重建上限的問題,同時把生成放進較高保真的 latent space 內處理;代價是主體模型仍然相當大,DiT 達 509M 參數,訓練門檻不算低。

訓練時,模型會根據 SAR latent 去預測由隨機噪聲走向 EO latent 的線性 flow velocity,並加入 representation alignment,將中途特徵對齊到凍結的 DINOv3 ViT-L/16 teacher。呢個 teacher 同 REPA projector 只在訓練期間使用,推理時會移除,所以正式生成流程比訓練結構簡潔,亦解釋到它點樣兼顧語義對齊同推理效率。

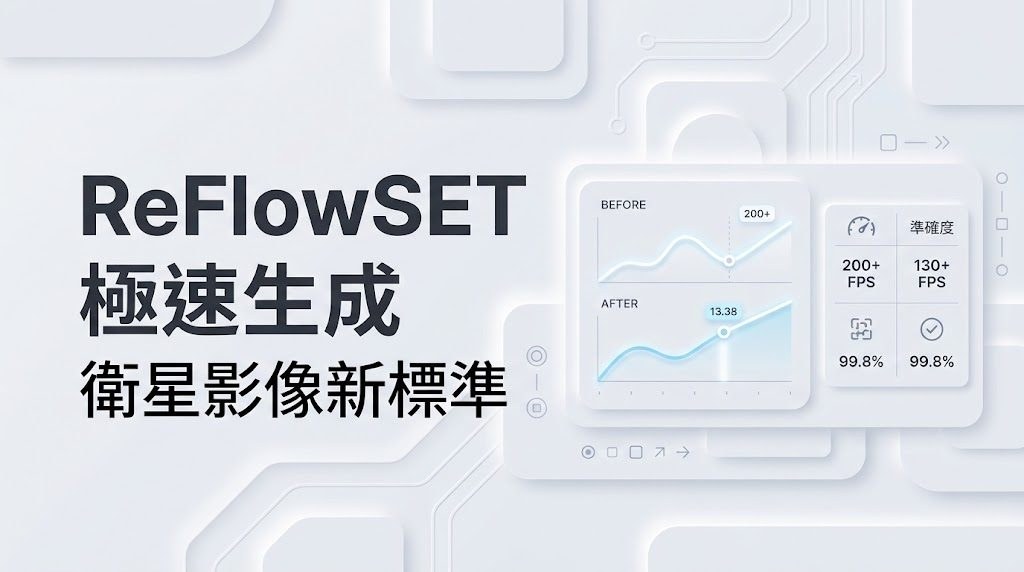
項目在 QXS-SAROPT 與 SAR2Opt 上,團隊把十五種早前方法放到同一 protocol 同 evaluator 之下重訓比較,ReFlowSET 取得兩個資料集最佳 DISTS,並在 SAR2Opt 拿到最佳 FID 與 LPIPS。它亦提供四步取樣設定,速度約比五十步版本快 11 倍,較適合想測試 SAR 轉光學可視化、遙感分析前處理,或研究生成品質與延遲取捨的團隊。

  • 以 frozen FLUX.2 autoencoder 加 conditional flow-matching transformer 重建 SAR-to-EO 流程
  • 用 DINOv3 ViT-L/16 做 representation alignment,但 teacher 不會帶入推理
  • 在 QXS-SAROPT 與 SAR2Opt 拿到最佳 DISTS,SAR2Opt 亦有最佳 FID 與 LPIPS
  • 四步取樣版本大幅縮短生成時間,適合做速度與畫質折衷測試
  • 已公開 PyTorch 實作、論文預印本與預訓練模型,較適合研究型團隊直接驗證

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Image, Python, Dataset 數據集

CogEvol-4B 離線模型在手機筆電直接生成完整互動課程

CogEvol-4B 把一句課程大綱變成結構化投影片 JSON 加可獨立運行的互動 HTML,全程在筆電離線完成,無需 API 或雲端。

BF16 slide render

一般提到 AI 自動生成教材,多半還是要連雲端 API 才能輸出 HTML,但 CogEvol-4B 的做法是把整個流程壓進一個 2.4 GB 的 Q4_K_M GGUF 檔案。它以 Qwen3.5-4B 混合架構(48 層 GDN 線性注意力 + 16 層全注意力)為底,經過五萬多筆生產驗證樣本的 SFT,再做投影片 RL 與 HTML RL 兩階段強化,結果是單次前向傳遞就能同時吐出結構化投影片和自包含的互動式 HTML,不需要任何外部依賴。

在 MacBook Pro M2 Pro 16 GB 上,模型跑出約 33 tok/s 生成、470 tok/s prefill,整份互動課程約六分鐘完成。對教師、培訓設計師或自學者而言,這意味著斷網也能把一行大綱擴展成可互動的學習素材,不用排隊等雲端,亦沒有 API 成本。

項目可整合 OpenMAIC 與評測工具,權重放在 HuggingFace,並已整合到開源平台 OpenMAIC,透過 .env.local 切換本地 provider,再加上一個 runtime brief expander 補丁即可在斷網環境下渲染所有 widget。

重點摘要:

  • 離線可用:模型、應用、素材全部本地,關 WiFi 仍能完整跑
  • 極輕量部署:單一 2.4 GB GGUF 檔,Apple Silicon、CUDA、CPU 皆可
  • 一鍵生成:一句大綱直接變投影片 JSON 加可互動 HTML,無需 agent loop
  • OpenMAIC 原生整合:本地 provider 設定加上補丁,斷網渲染 widget
  • 雙重授權:程式碼 MIT、權重 Apache 2.0,可商用且易於二次開發

項目主頁 · GitHub模型

Categories: 開源, Agentic, 模型, Qwen

Code as World: 用於物理推理的智能體

它把物理世界拆成可執行的程式表示,再用代理式流程反覆驗證與修正。你可以把它理解成一套把影像觀察轉成可推演世界模型的方法。

MirroS logo

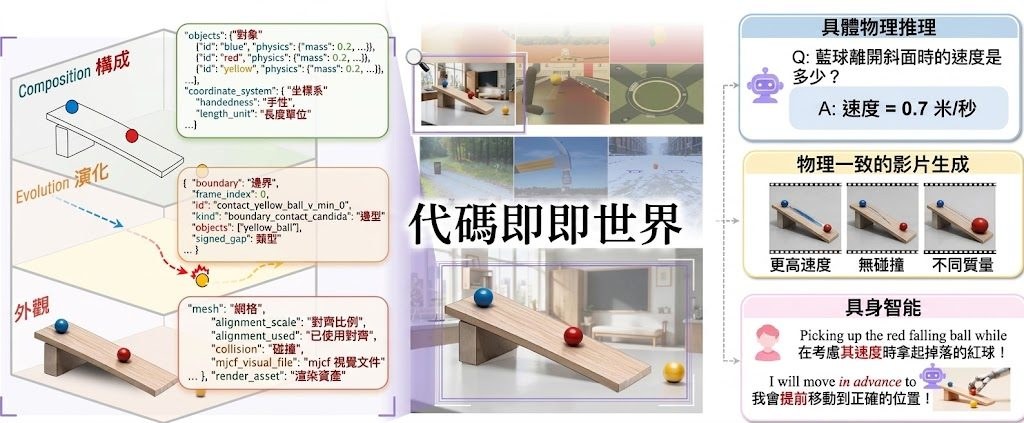
Code-as-World 是一個面向物理推理的研究項目,核心做法不是直接死記像素,而是把世界整理成可執行的程式表示。這樣做的目的很直接:讓模型不只看見畫面,還能整理出物件、狀態、動態規則與彼此關係,方便後續推演和檢查。

它的做法帶有明顯的工具與模型結合味道,提供 Code-as-World-VL-4BCode-as-World-VL-9B 的本地推理與 QuantiPhy 評估。倉庫也提到可用 Python 3.10 或 3.11 在 CUDA 主機上安裝,代表它比較像研究團隊可重現實驗與推理流程的發佈形式,而不是單純示範頁。

和一般只靠像素特徵做判斷的做法相比,這個項目更著重可執行、可驗證、可調整的世界表示。代價是系統會更複雜,因為它要同時處理抽象、組合、模擬與一致性檢查,但換來的是更適合做反事實推演、診斷與物理場景理解。

  • 把物理世界表成程式,方便模擬和驗證
  • 支援本地推理與 QuantiPhy 評估
  • 4B、9B 版本已釋出,方便比較尺度效應
  • 適合做物理推理、世界模型與多模態研究
  • 量化結果顯示,較大模型的平均 MRA 有提升

對做多模態模型、世界模型、機械推理或具身智能的團隊,這類方法會比較有吸引力,因為它把感知和可執行結構連起來。若工作重點是要從影片或觀測中抽出可重用的物理表示,而不是只做單次辨識,這個項目提供了一條相當具辨識度的路線。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 世界模型, NVIDIA, Dataset 數據集

GLM-5.3 開放權重,卻為大型雲端供應商設門檻

GLM-5.3 (753B 參數),已在 Hugging Face 發佈權重,但新授權條款不再採用 MIT,並要求大型提供商接受安全審查。

Og image

想自行下載模型權重、在本地或私有環境運行 GLM-5.3 753B 參數的團隊,現在多了一項不能忽略的授權考量。Z.ai 已把 GLM-5.3 上載到 Hugging Face,讓研究者和開發者取得模型權重,但同時撤下過往的 MIT license。

這個安排令「開放權重」與「完全不設限制的開源授權」出現清楚分別。模型檔案可以取得,不代表所有公司都能按照相同條件提供服務;收入超過 100 億美元的提供商,需要先接受安全審查,條款明顯針對大型雲端及 AI 服務供應商。

對小型團隊、研究人員和需要控制資料流向的企業,GLM-5.3 的權重仍可能方便本地推理、模型整合及內部測試。不過,將模型包裝成公開 API、雲端推理服務或大規模商業產品前,必須先核對新 license 的適用範圍和審查要求。

  • 權重已放上 Hugging Face,降低取得模型的門檻
  • GLM-5.3 不再使用 MIT license
  • 開放權重不等於不受授權條款限制
  • 收入超過 100 億美元的提供商須接受安全審查
  • 商業服務和大規模分發需要額外檢查合規要求

模型

Categories: 開源, 模型, 中國

Breeze TTS 2:低延遲語音生成再推一級

Breeze TTS 2 把即時語音互動、聲線設計同語氣控制放埋一齊,主打低延遲同高可塑性。它較適合要做配音、語音代理或互動內容嘅團隊。

BreezeBlue

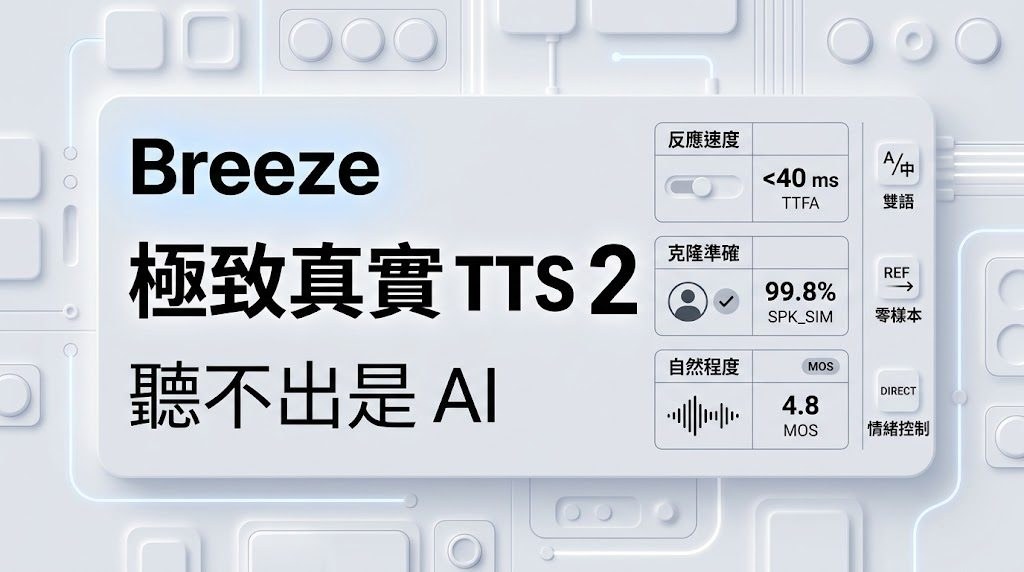
Breeze TTS 2 係一個文字轉語音(text-to-speech, TTS)模型,重點唔止係把文字讀出,而係處理即時互動入面最難平衡嘅兩件事:聲音要自然,回應又要夠快。佢支援 Voice Clone、Voice Design 同 Voice Direction,代表可以由參考錄音複製聲線,亦可以純靠自然語言描述去設計新聲線,再按指令調整語氣、節奏同表達。

對內容製作、語音代理、遊戲角色配音同多語言產品來講,呢種做法比單純 TTS 更有彈性。文本內仲可以插入 Vocal Events,例如笑聲、咳嗽、清嗓子呢類表情提示,令生成聲音更接近真人演繹,而唔係只係平鋪直敘讀稿。

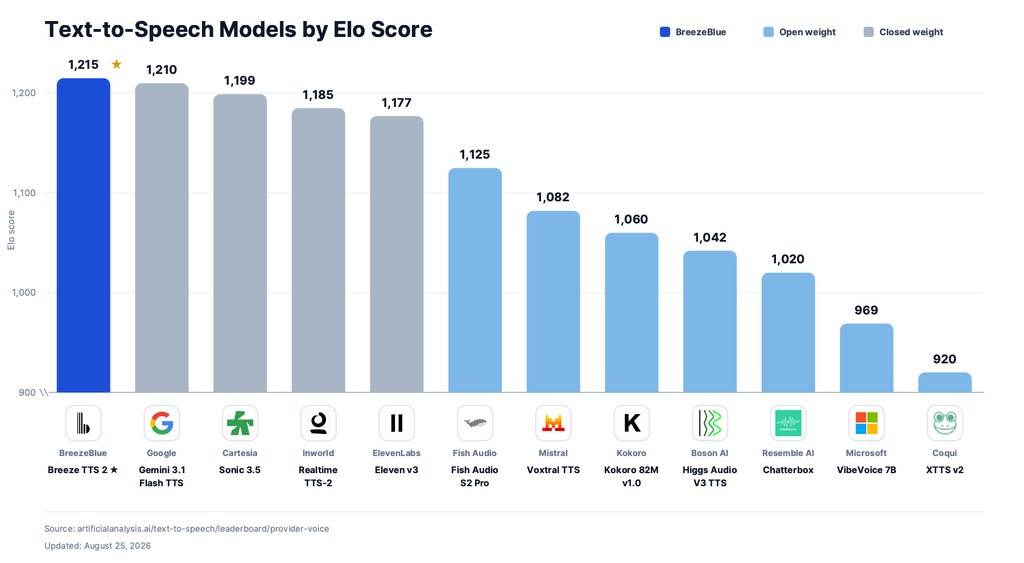
項目資料顯示,佢喺 Artificial Analysis TTS leaderboard 排名第一嘅 open-weight 模型,亦聲稱喺部分測試中超越商業系統。低延遲係另一個賣點:warming 後喺 NVIDIA H100 可做到少於 40 ms 的 time to first audio,RTF 約 0.32,適合即時對話場景。

不過,repo 同時寫明模型權重、衍生模型同 self-hosted outputs 只限研究同非商業用途,呢點對想直接落地嘅團隊影響好大。代碼層面提供 PyTorch inference code,但原始資料未交代完整安裝流程或部署細節,較合理嘅理解方式係先把佢視為一個面向研究與產品原型驗證的高性能 TTS 模型。

  • 支援參考錄音複製聲線,亦支援純文字描述設計新聲線
  • 可以用指令調整語氣、情緒、語速同演繹方式
  • 低延遲串流適合即時語音互動同 voice agent
  • 在 open-weight TTS 基準中聲稱領先,但授權限制較嚴
  • 適合配音、互動內容、多語言語音產品同研究團隊

項目主頁 · GitHub · 模型

Categories: 開源, 文字轉語音, Agentic, 模型, NVIDIA, Audio, Clone, Python, 語音, Dataset 數據集

WeMM-Embedding:對齊文字、圖片、影片的多模態檢索

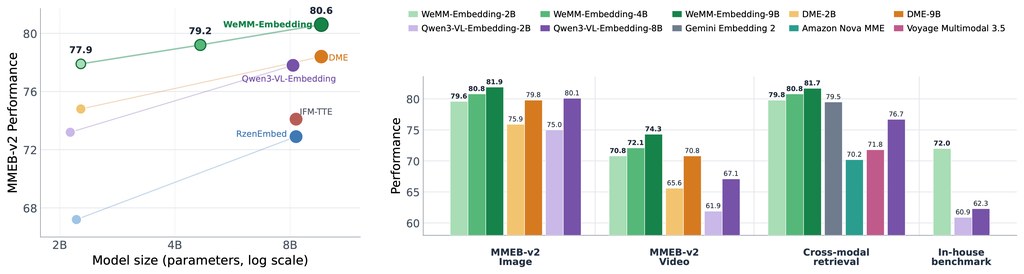
騰訊微信視覺團隊把文字、圖片、影片、視覺文件等多種輸入收進同一個嵌入空間,推出涵蓋 2B/4B/9B 三個尺寸的 WeMM-Embedding 系列,主打檢索與多模態理解一條龍。

WeMM-Embedding Performance Overview

把文字、圖片、短影片、文件截圖一次過丟進同一個嵌入空間做檢索,一直是多模態團隊頭痛的工程難題。WeMM-Embedding 系列由騰訊微信視覺團隊開源,正是針對這個場景而來:三個規模(2B/4B/9B)都用同一套介面,輸出可直接比對的向量,免卻多模型串接的麻煩。

向量從模型最後一層的 <embedding> token 位置取出,再做 L2 正規化,方便直接接入既有向量資料庫。對想做跨模態檢索或 RAG 的團隊而言,這類統一模型比起同時維護 CLIP 系、BGE 系、影片模型幾套 pipeline,部署成本明顯較低。

官方推薦 transformers==5.2.0 以保證預處理一致性,亦支援 SentenceTransformer 直接載入 Hugging Face 模型 ID。比較有彈性的是 Matryoshka Representation Learning(MRL):例如 9B 版本支援 64 到 4096 多段維度,開發階段可以用低維度快速迭代,再逐步切到高維度;2B 與 4B 版同樣提供 64 至 2048 左右的選項。已驗證 vLLM 0.27.0 與 SGLang 0.5.9 兩套推理引擎,兩者都以 pooling runner 啟動,搭配專屬的 chat template 即可提供 embedding 服務。

與同類開源嵌入模型相比,WeMM-Embedding 強調「影片與視覺文件也在同一個向量空間」,而不是只覆蓋到圖文。短影片摘要、PDF 截圖理解、社交媒體(X Demo)多模態內容推薦等場景,會比純圖文模型更貼地。音訊輸入目前不在支援範圍內,是規劃時要留意的限制。受惠對象包括做多模態 RAG、跨模態檢索、商品搜尋及內容審核的中小團隊,因為他們通常缺乏同時訓練多個專門模型的資源。

重點:

  • 統一嵌入空間:文字、圖片、影片、視覺文件、交錯輸入共用同一向量表示,免除多模型串接。
  • 三種規模:2B、4B、9B 同步開源,可在準確度與成本之間靈活取捨。
  • Matryoshka 維度彈性:支援 64 至 4096 多段可選維度,平衡儲存與效果。
  • 生態友善:兼容 transformersSentenceTransformer,並已驗證 vLLM 與 SGLang 部署。
  • 目前限制:音訊輸入未支援,預處理對 Transformers 版本敏感,需固定在 5.2.0。

GitHub · 模型

Categories: 開源, 騰訊, AI productions, RAG, Embedding, 模型, Video, Image, Dataset 數據集

Ox Alpha 百萬 Token 上下文免費試用

Z.ai 最新模型 Ox Alpha 提供 1M-token context window,讓大型程式碼庫、圖像與影片可在同一個推理流程中處理。

Og image

面對大型程式碼庫、長篇規格文件或連續多步工作,Ox Alpha reasoning model(推理模型)可把最多 1M-token context window 的內容放在同一個脈絡中處理,減少反覆切分資料或遺失前文。它亦支援文字、圖像和影片輸入,適合除錯、重構及分析截圖或介面流程。

Ox Alpha 會先規劃和自我檢查,再產生答案,並以 visible thinking 展示推理過程。模型同時提供原生 tool calling、tool_choice,以及配合 response_format 的結構化 JSON 輸出,方便用於長時間運行的 agentic 工作流程。

網站列出的獨立測試涵蓋 10 項真實編程任務,Ox Alpha 完成 8 項,得分 80%;同一比較中,Fable 為 65%,GLM-5 為 62%,GPT-5 和 Grok 4 均為 52%。樣本只有 10 項任務,結果較適合作為參考,未足以代表所有編程場景。

• 1M-token context window,最高 131K tokens 輸出
• 支援文字、圖像和影片三種輸入
• 適合大型程式碼庫的 debugging 和 refactoring
• 原生 tool calling 與結構化輸出
• 免費試用、毋須登入,網站表示不會把聊天儲存在伺服器

項目主頁

Categories: Agentic, 模型, 多模態模型, Video, Image, 軟件, Python, 編程, 免費試用, UI/UX

JIT-Agent:讓模型即時寫出專屬代理框架

JIT-Agent-27B會按任務即時組合可執行的代理框架,令同一個 Agentic LLM 更貼近研究、辦公及規劃工作。

JIT-Agent

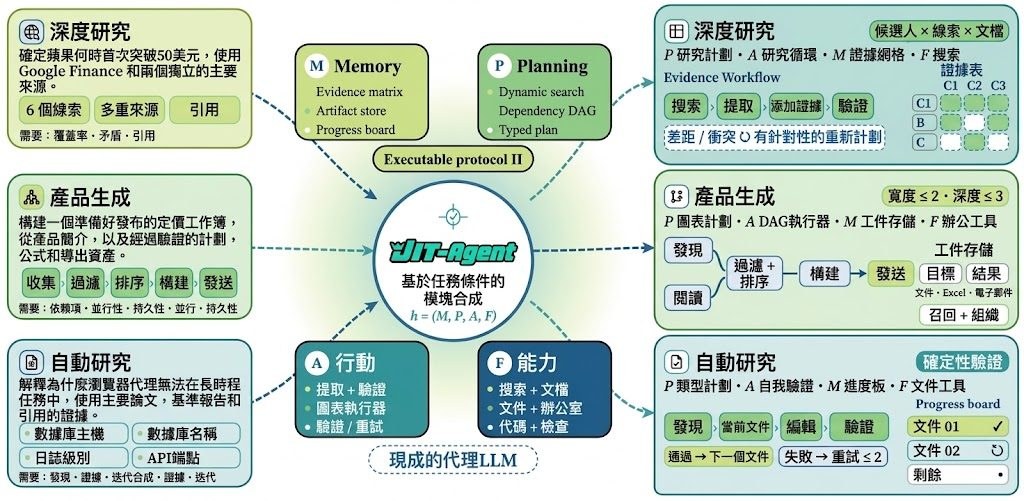
面對深度研究、日常工作或工作區操作等不同任務,固定不變的代理框架未必能有效轉用。JIT-Agent 屬於一個 meta-agent 模型項目,接收任務規格、協議、工具及技能註冊表,再為現成的 agentic LLM 生成特定任務的可執行 harness,處理代理流程難以適配的問題。

JIT-Agent-27B 並非直接取代底層模型,而是負責組合包裝模型的工作方式。每個 harness 由 memory、planning、action 及 capability orchestration 四個模組組成,並透過 HarnessFactory 的共享介面輸出結構化程式碼,避免每次都由模型自由撰寫整套代理程式。

  • 按任務生成不同的記憶、規劃和行動流程
  • 可包裝不同的 off-the-shelf agentic LLM
  • 測試期間會根據 trace 與 feedback 修訂 harness
  • 生成器保持 frozen,改進內容寫入 harness archive
  • 涵蓋研究、辦公、規劃及 workspace 類代理基準

同類方案通常先準備一個通用 scaffold,再期待它在不同任務中轉移;JIT-Agent 將可轉移的能力放在 harness 生成與演化,而不是只依賴 base model 擴大。代價是系統需要任務規格、工具註冊表、過往 harness 及測試回饋,生成品質亦會受這些輸入影響。

JIT-Agent 把 jit/、scripts/、harness_factory/、benchmark/ 及 dataset/ 分開,涵蓋生成與修復提示、代理核心、評估器和基準適配器。 JIT-Agent-27B 在九個代理基準中領先八個。適合研究代理架構、需要為多類工作測試流程的團隊,以及想比較「擴大底層模型」與「改進 harness」效果的人員。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 框架, 編程, Dataset 數據集

Page 5 of 37
1 3 4 5 6 7 37