Headroom:幫 AI agent 壓縮上下文

這個項目專注減少 AI agent 的 token 消耗,同時盡量保留答案品質。它適合想降低成本、加快回應的開發團隊。

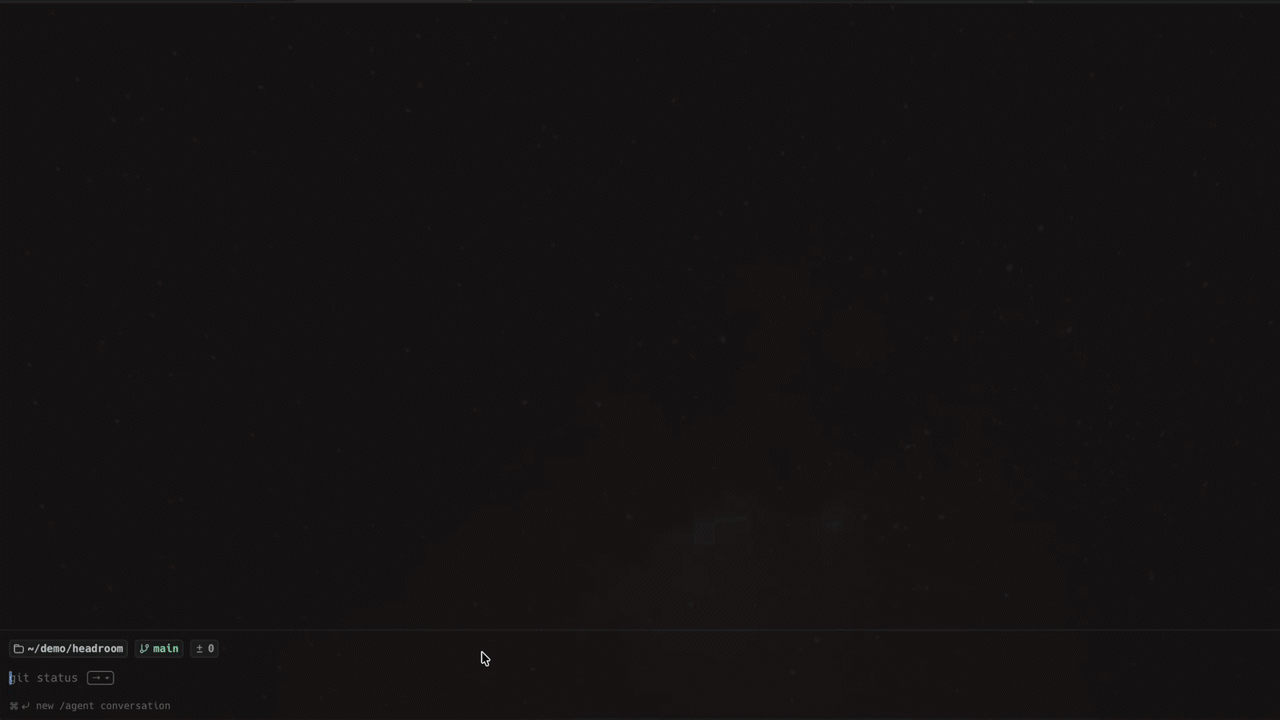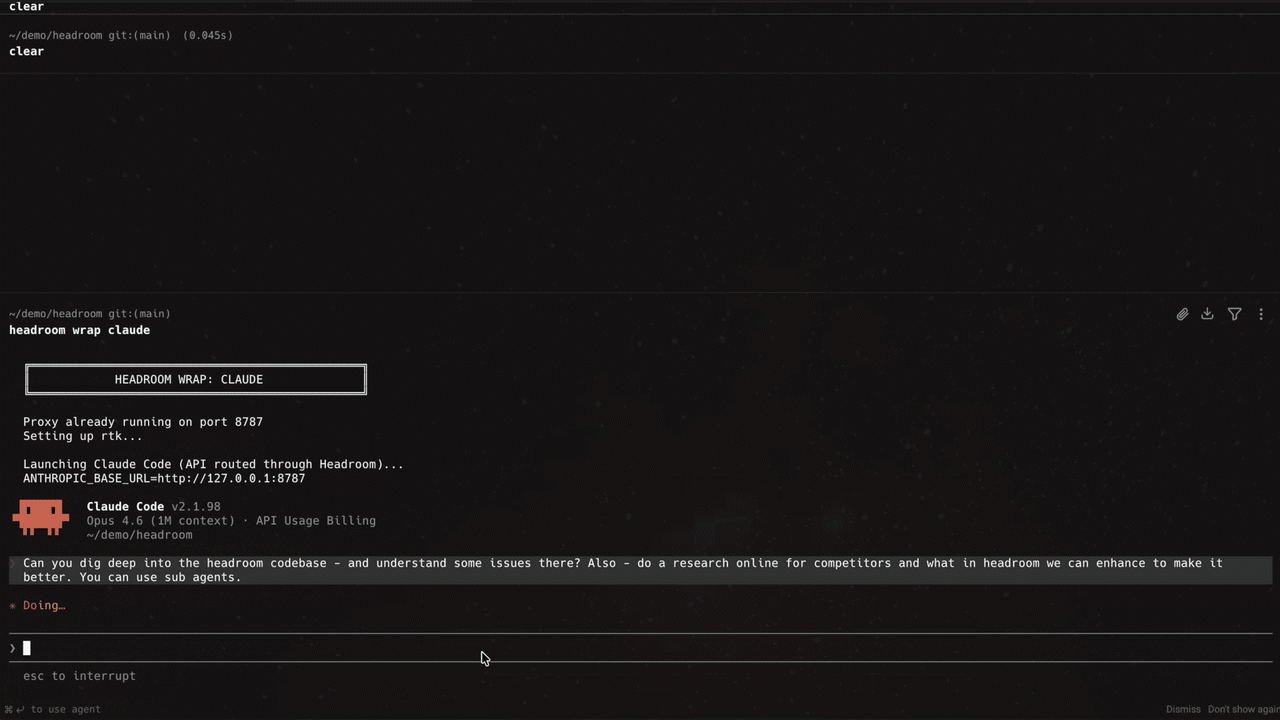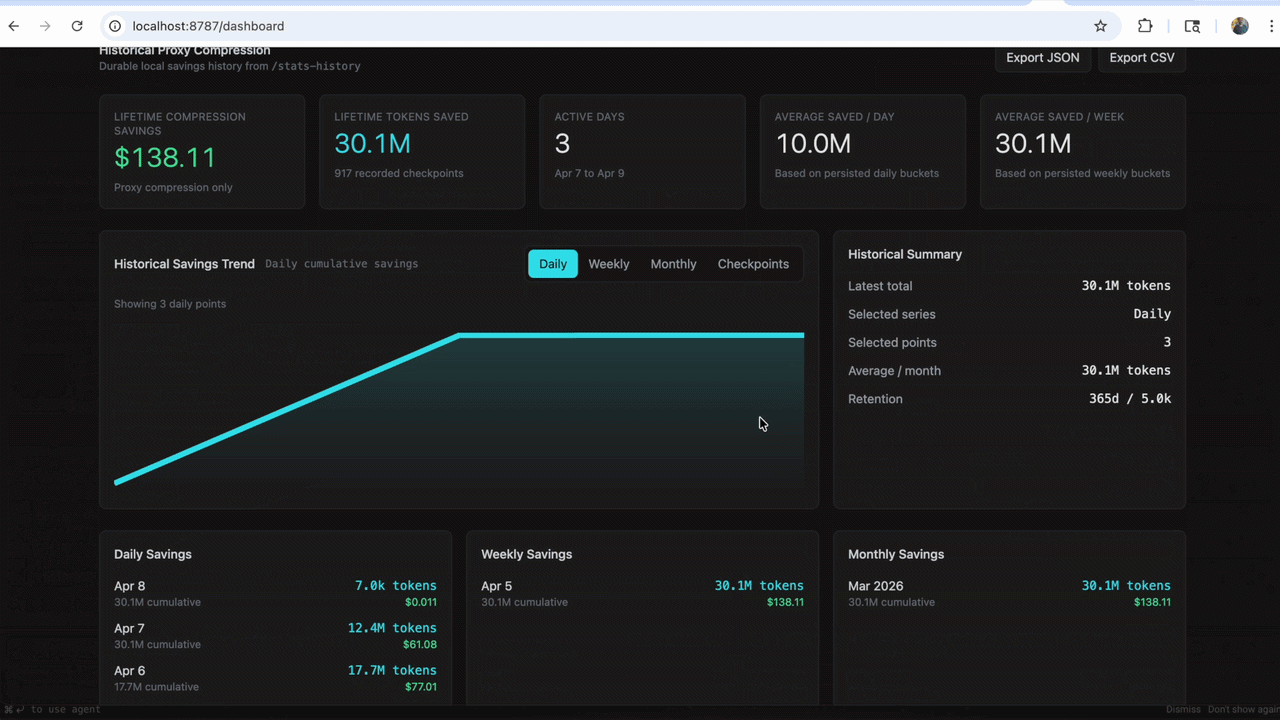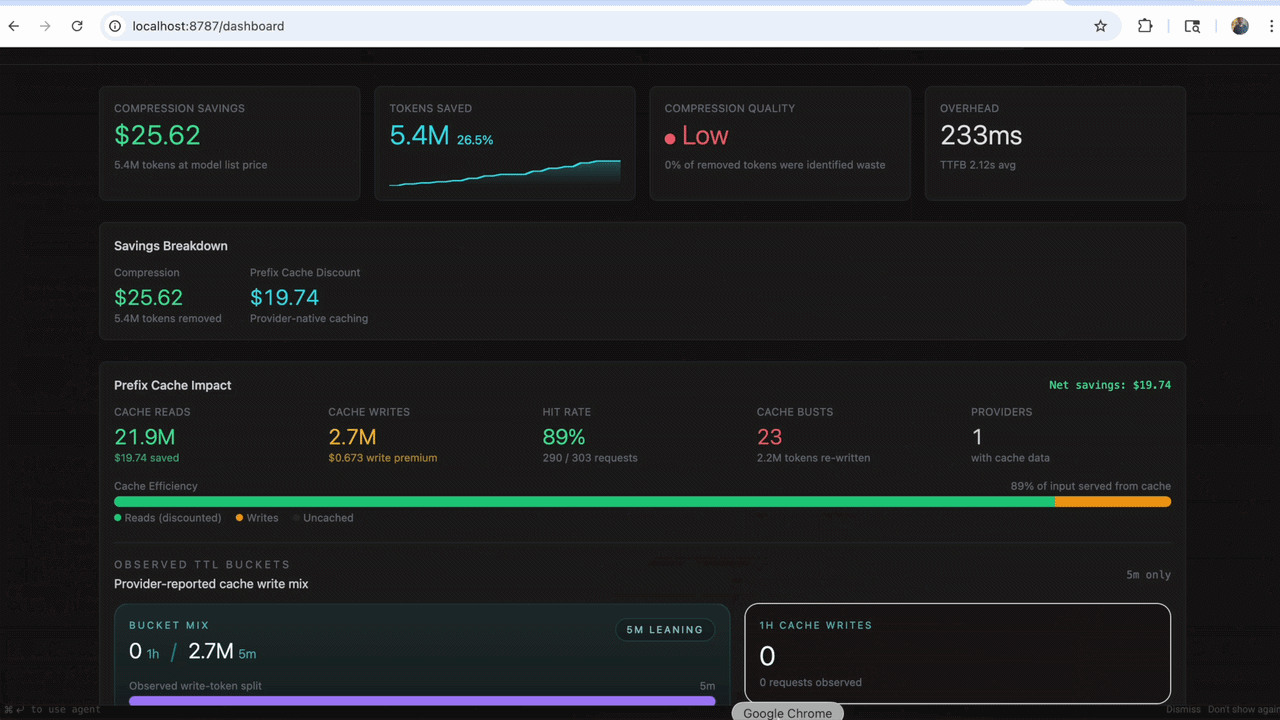
Headroom in action

Headroom 是一個給 AI agents 與 LLM 應用使用的庫兼代理工具,核心角色是把送進模型前的上下文做壓縮。它主要解決長對話、工具輸出、日誌、RAG 片段與檔案內容太長,令 token 成本、延遲與上下文容量很快爆滿的問題。

這個項目不只提供 Python 與 TypeScript 內嵌式 compress(messages) 用法,亦提供 proxy 模式與 MCP server,代表它可以直接插入現有流程,未必需要大改程式。README 提到 zero code changes 的代理方式,對已有多語言系統的團隊尤其實用;另外它走 local-first 與 reversible 路線,取向明顯是先保留可控性,再追求節省 token。

和一般只縮短輸入文字的做法相比,Headroom 的差異在於它同時處理模型輸出,會減少重複客套、重述程式碼,以及在例行步驟略過過深的「thinking」。這種取捨有助壓低來回 token,但也代表較依賴它對內容重要性的判斷;對需要完整推理痕跡或逐字保留輸出的流程,部署前應先做回歸測試。

結果列出的數字是 60–95% fewer tokens,示例亦有 10,144 壓到 1,260 tokens,同時保留相同問題結論;不過這些結果較適合視為官方展示,具體效果仍會受任務類型影響。較容易受益的情境包括多步驟 agent、跨工具調用、RAG 對話系統,以及 Claude、Codex、Gemini 之間需要共享記憶的團隊協作流程。

  • 支援 Library、Proxy、MCP server 三種接入方式
  • 可壓縮對話、工具輸出、logs、RAG chunks 與檔案內容
  • 提供 cross-agent memory,支援 Claude、Codex、Gemini 共用與去重
  • headroom learn 會整理失敗 session,寫入 CLAUDE.local.md、CLAUDE.md、AGENTS.md 或 GEMINI.md
  • 相關模型包括 Kompress-v2-base,而整體定位較接近 agent 基礎設施,不是單一聊天模型

整體來看,Headroom 最有價值的地方不在於再做一個包裝 LLM 的介面,而是把「上下文壓縮」獨立成基礎層。對經常被 token 成本、上下文長度與 agent 記憶雜訊拖慢的項目,它屬於值得優先測試的一類工具。
GitHub

Categories: 開源, Agentic, RAG, MCP, 模型, Gemini, Python, 庫, 編程, Anthropic

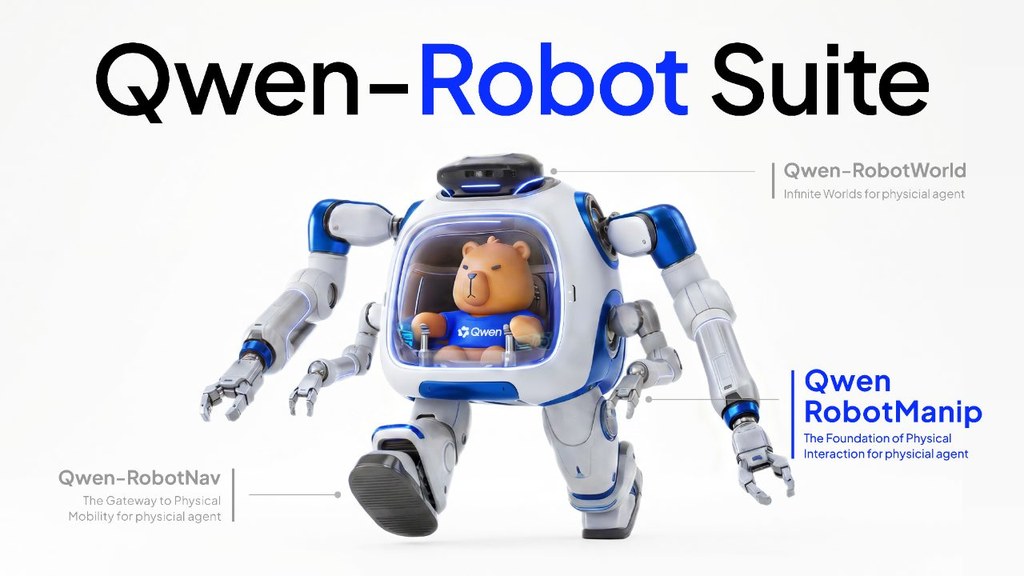
Qwen-RobotManip 如何把機械臂訓練推向通用化

這是一個面向機械人操作的 Vision-Language-Action 基礎模型。它嘗試用統一對齊與大規模資料訓練,提升跨場景與跨機械平台泛化能力。

Og image

這是一個機械人操作模型,名為 Qwen-RobotManip,屬於建基於 Qwen-VL 的 Vision-Language-Action foundation model。它主要處理機械臂操作資料分散、昂貴而且難以統一訓練的問題,目標是讓模型在未見過的任務、場景與機械平台上仍能保持可用表現。

它的核心做法,是把操作學習中的表徵、動作與行為三個層面放進同一套 alignment framework。研究團隊同時建立 human-to-robot synthesis pipeline,將第一身手部示範影片轉成 15 個平台可用的 robot trajectories,再配合多來源資料整理流程,整合真實機械人、合成資料與人類示範影片,形成約 38,100 小時 pretraining corpus。

和常見只集中單一機械平台、單一資料來源,或偏重分佈內表現的做法相比,Qwen-RobotManip 更著重 genuine generalization。評估上亦沒有停留在一般 benchmark,而是加入多個 OOD 設定,包括 RoboCasa365、LIBERO-Plus、EBench、RoboTwin-Clean2Rand、RoboTwin-IF 與 RoboTwin-XE,用來檢查指令跟隨、擾動穩健性、錯誤恢復,以及 cross-embodiment knowledge transfer。

重點可整理為:
– 建基於 Qwen-VL,面向 robotic manipulation 的通用基礎模型
– 以 unified alignment framework 整合 heterogeneous manipulation data
– 使用 human-to-robot synthesis pipeline,覆蓋 15 個機械平台
– 只依靠 open-source robotic manipulation datasets 與 human demonstration videos,未提及私有資料收集
– 在多個 OOD 評測中優於過往 state-of-the-art models,包括 π0.5,並在 RoboChallenge 排名第一

這個項目較適合關注 robotic manipulation、VLA、跨機械平台遷移與機械人資料擴展流程的人閱讀。現有資料顯示,它不單是再加大訓練規模,而是先解決資料對齊問題,令擴充規模之後的訓練信號不會互相衝突,這也是它能在真實機械平台驗證泛化能力的關鍵。

項目主頁 · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, VLA, Robotic, 框架

ConvFill:即時語音代理的雙模型方案

ConvFill 用本地小模型先開口,再由雲端大模型補上答案。它想解決語音代理常見的「快但唔夠準,準但唔夠快」拉扯。

Teaser

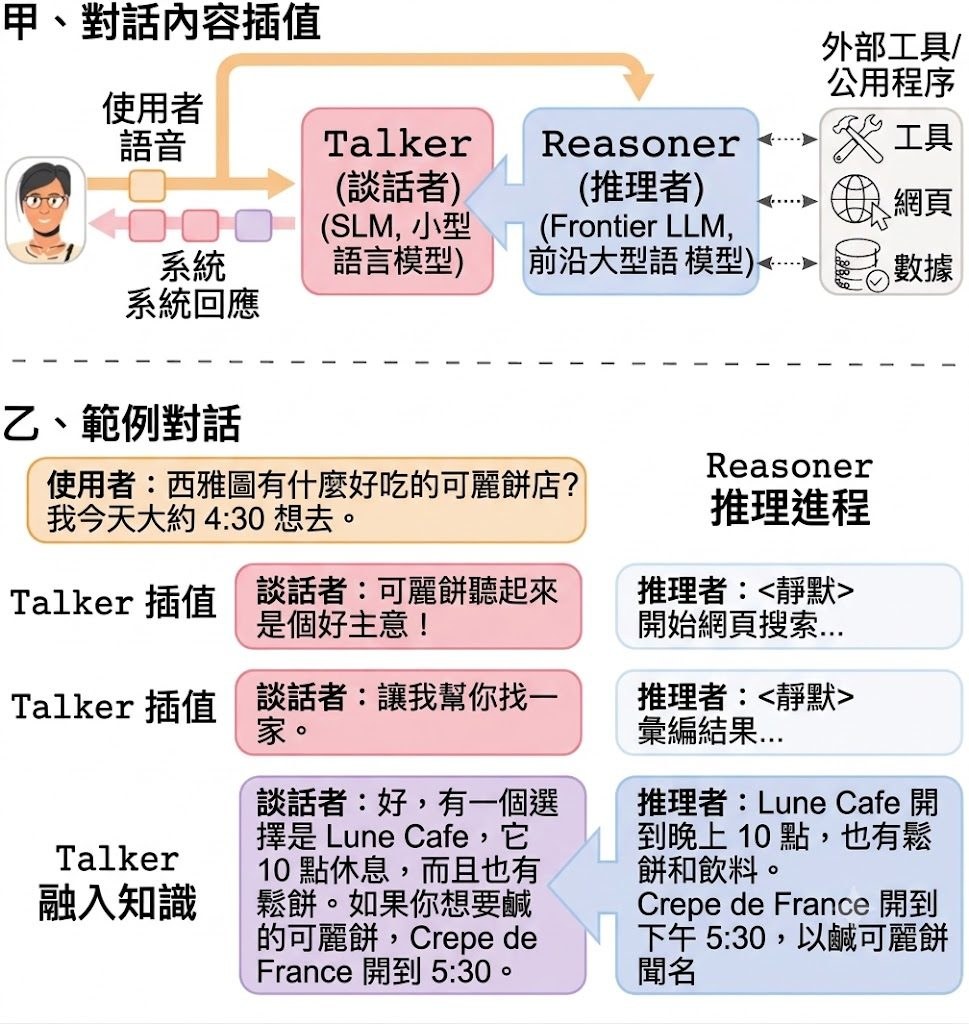
ConvFill 是一個用來建立語音代理的開源系統與研究原型。能夠實現即時回應和準確回答——這兩個目標通常難以兼顧。它將本地運行的小型快速語言模型與在後台進行繁重推理的大型雲端模型相結合,使代理能夠立即開始對話,並在資訊可用時自動填充合理的答案。此程式碼庫包含完整的系統、一個即時語音演示、七個即用型模型以及訓練您自己的模型所需的一切資源。

現有做法通常要麼直接等大型模型完整生成,回應較慢;要麼改用較小模型追求低延遲,但複雜查詢、文件搜尋同工具調用能力會明顯下降。ConvFill 提出 conversational infill 這個新任務,將 Talker 與 Reasoner 分工:Talker 先即時說話,Reasoner 在背景處理慢工序,再把精簡知識流式交回 Talker 融入回答。

ConvFill 不是單純做語音介面,而是重新安排推理時序。Talker 可用 135M 到 1.7B 參數的小模型,在手提電腦或手機本地運行;Reasoner 則可接 Claude、GPT 或 Gemini。儲存庫已提供 live voice demo、七個現成模型,以及訓練自家 Talker 所需內容,理解上可視為「本地即時對話層 + 雲端能力層」的組合。

  • 內置七個已微調 Talker,涵蓋 Qwen、Llama、Gemma、SmolLM 家族
  • 配套 ConvFill dataset,含 290,571 個經驗證訓練樣本,覆蓋六個領域
  • Reasoner 可替換為 Claude、OpenAI 或 Gemini,毋須為更換 Reasoner 重新訓練
  • 論文指出系統可維持 millisecond-level time-to-first-response,準確度與對應 frontier Reasoner 的差距縮至 6.3% 內

受益最明顯的,會是想做客服、助理、查詢式語音介面或需要邊說邊找資料的團隊。它未必適合完全離線、又要求深度推理的場景,因為關鍵能力仍依賴雲端 Reasoner;但對希望保留本地回應速度,同時接入大模型能力的項目,這套設計比單模型方案更有工程上的彈性。

GitHub · Paper

Categories: 開源, 模型, Qwen, OpenAI, Gemini, LLaMa, 語音, Anthropic, 蘋果, Dataset 數據集

PhysisForcing 提升機械人世界模擬可靠性

這是一個強化影片生成物理一致性的訓練框架,用來改善機械人操作模擬的可信度。

Teaser Figure

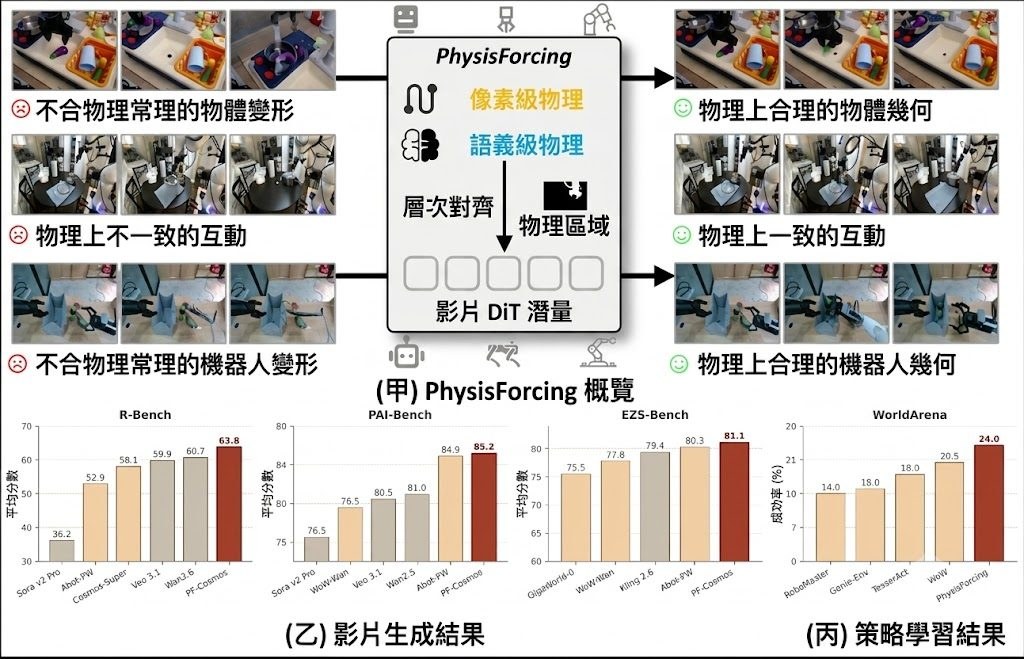
這是一個用於機械人操作的世界模擬訓練框架,名為 PhysisForcing。它主要解決影片生成模型在模擬抓取、推動與物件互動時,常出現動作軌跡不連續、物件變形和互動不合物理規律的問題。

PhysisForcing 的做法不是單靠生成更像真的畫面,而是把訓練重點放在與物理相關的區域,並同時加入像素層與語意層兩種約束。像素層的 trajectory alignment loss 會用參考點軌跡監督 DiT features,語意層的 relational alignment loss 則利用凍結的影片理解編碼器,對齊區域之間的互動關係,令機械臂與物件之間的時空關聯更穩定。

和一般通用影片生成模型,或只針對機械人資料做微調的方法相比,這個框架更集中處理「物理合理性」而非單純畫面觀感。它可套用在標準 diffusion video backbones 之上,已展示於 Wan2.2-I2V-A14B 與 Cosmos3-Nano 這兩個基礎模型。

  • 核心重點是分層物理對齊:同時改善運動一致性與互動關係一致性
  • 適合用於 embodied world simulation、robotic manipulation 與下游動作規劃
  • 在 R-Bench、PAI-Bench、EZS-Bench 都較強基線有提升
  • R-Bench 上,Wan2.2-I2V-A14B 提升 +22.3%,Cosmos3-Nano 提升 +9.2%
  • 納入 WorldArena action-planner protocol 後,closed-loop success rate 由 16.0% 升至 24.0%

這項工作對需要用影片模型做機械人訓練、模擬驗證或策略學習的人較有參考價值,因為它不只改善生成片段的外觀,亦提升作為 world model 的可用性。現有資料顯示,物理對齊後的影片表徵亦能帶動下游 policy success,說明這類方法不只是視覺修飾,而是直接影響機械人操作結果。

項目主頁 · Paper

Categories: 開源, 北京大學, 模型, 視頻模型, 世界模型, 模型訓練, NVIDIA, Video, Robotic, 框架

EO-WM:把衛星影像預報變成天氣驅動的世界模型

EO-WM 以物理引導的潛在影片擴散架構預測未來衛星觀測,並針對極端天氣下植被退化與天氣響應準確度提出全新基準。

EO-WM overview

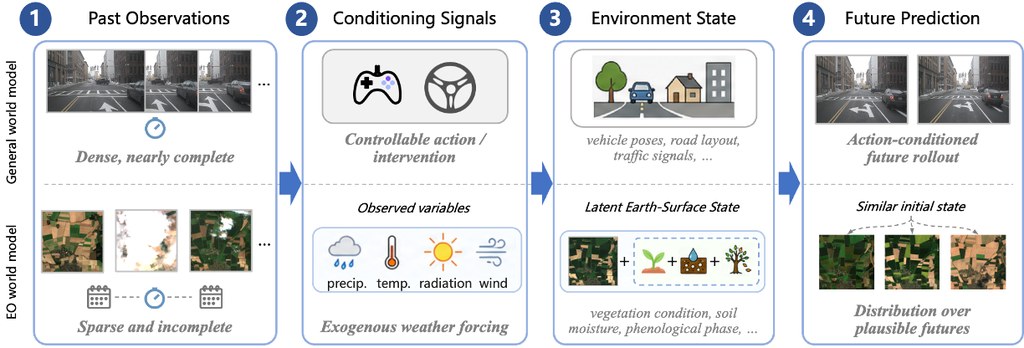
這是一個結合物理知識的影片擴散世界模型(EO-WM),專門用於多光譜衛星影像的概率預測。整體目標是把地球觀測(Earth Observation, EO)預報重新定位為「部分可觀察、天氣驅動的世界建模」任務,在稀疏衛星上下文與未來氣象條件下預測地表動態,並支援災害監測、作物產量預估及植被變化追蹤等下游應用。

過去的 EO 預測方法分為兩類:決定式模型把不確定性壓縮成單一未來影像,擴散式方法則往往把天氣變量當成籠統的條件輸入。這兩種做法都難以正確反映「氣象條件如何改變地表狀態」這個核心問題,而且現有 benchmark 多聚焦於像素重建準確度,未能衡量模型在改變天氣條件時是否會產生方向正確的響應。EO-WM 為了解決這個落差,引入一個 EO 專屬 VAE 把稀疏衛星觀測編碼為潛在影片 token,再用擴散 Transformer(diffusion transformer)經由獨立條件路徑同時處理三種信號:氣候基線(climatological baseline)、天氣異常(weather anomaly)與累積物理壓力(cumulative stress),並持續將空間上下文重新注入影片 token 流。

在評測方面,作者提出兩個以 EarthNet2021 為基礎的診斷式 benchmark:Extreme Summer Benchmark 衡量極端熱浪與乾旱下植被退化的嚴重程度感知能力,引入 TN-MAE 與 Drop Amplitude Error;Seasonal Matched-Pair Benchmark 則衡量當天氣條件改變時預測方向與幅度是否正確,以 Divergence Reproduction Ratio、Directional Hit Rate 與 Paired Divergence Correlation 為指標。報告結果顯示 NDVI 下降幅度的預測誤差相對減少 5.63%,方向命中率相對提升 7.80%,同時在像素級 ENS、P-MAE、N-MAE 等指標上仍具競爭力。

這個項目對遙感研究者、農業監測團隊及氣候風險分析團隊特別有價值,因為它同時提供模型與基準資料,讓外界可在統一的評測框架下比較不同方法的天氣響應能力。從工程角度來看,架構設計強調物理分離條件與空間重注入,而非單純堆疊參數,這種取捨有助於提高極端情境下的可解釋性。需留意的是,目前 GitHub 倉庫主要釋出 benchmark CSV 與 Earthformer 參考評測腳本,模型權重與完整訓練流程屬於配套資源,重現完整結果仍需自行準備 EarthNet2021 的 extreme 與 seasonal 切分資料。

重點摘要:

  • 重新定義 EO 預報範式:把衛星影像預測視為天氣驅動的世界建模,而非純粹的影像重建。
  • 物理分離條件:天氣信號被拆分為基線、異常與累積壓力三條獨立條件路徑。
  • 診斷式 benchmark:Extreme Summer 與 Seasonal Matched-Pair 兩個基準專門檢驗模型在天氣改變下的響應正確性。
  • 可量化的天氣敏感度:NDVI 下降誤差降低 5.63%,方向命中率提升 7.80%,標準指標仍具競爭力。
  • 目前釋出內容:以 benchmark CSV 與評測腳本為主,完整訓練流程需搭配 EarthNet2021 資料集。

GitHub · Paper

Categories: 開源, 香港大學, 香港理工大學, 模型, 世界模型, Stable Diffusion, 框架, 香港, 庫, 深度學習

LISA:讓 ControlNet 訓練快 2.78 倍的正則化方法

香港科技大學團隊提出的 LISA 正則化技術,能在不增加推理成本的前提下,加速視覺條件可控生成模型的訓練並提升生成品質。

Arxiv

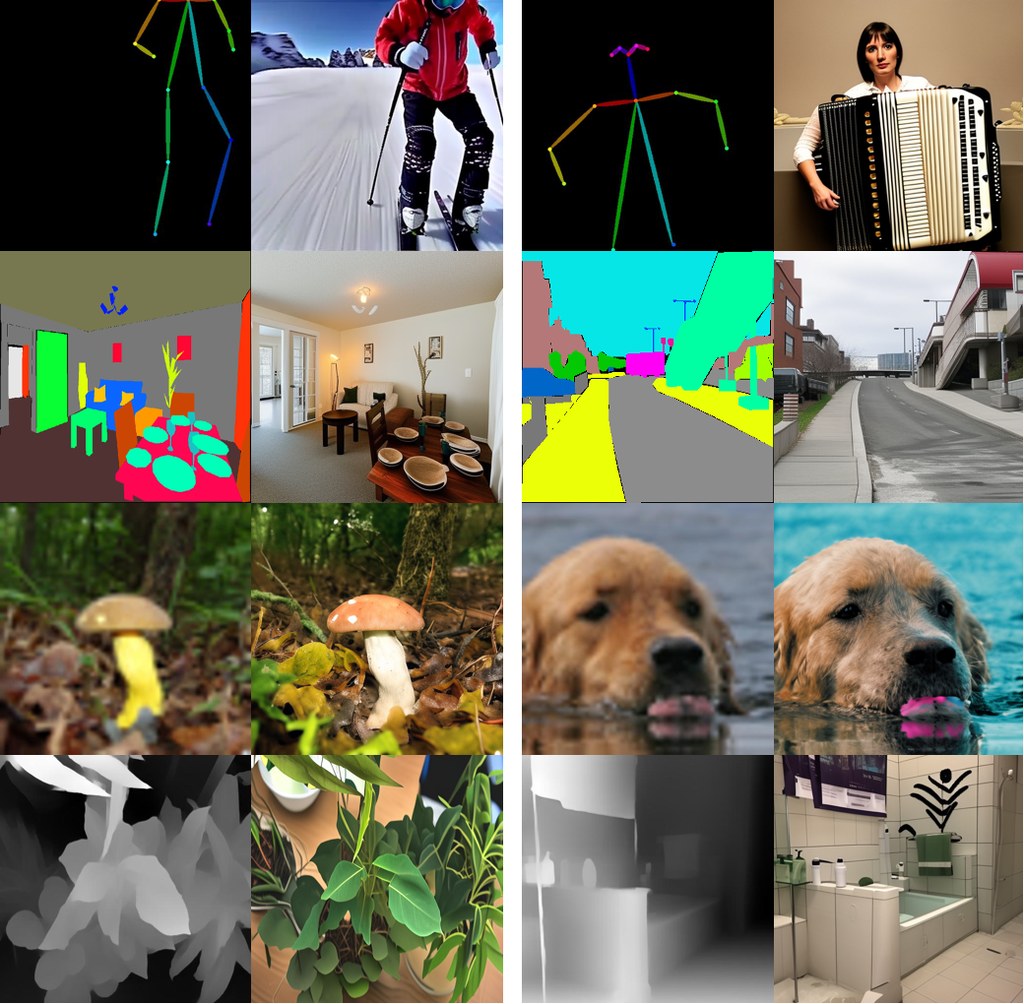
LISA(Likelihood Score Alignment)是一種訓練正則化方法,專門用於加速視覺條件可控生成模型(例如 ControlNet)的訓練過程,同時提升最終生成結果在感知品質與條件遵循度上的表現。

現有做法普遍採用「雙分支範式」(dual-branch paradigm):訓練一個側網絡(side network)來編碼視覺條件,再將其中間層特徵融合到凍結的預訓練主網絡中。這個範式雖然效果顯著,但側分支的角色定位與訓練效率長期未被深入研究。LISA 從基於分數的生成建模(score-based generative modeling)角度重新審視這個範式:主網絡負責提供先驗的無條件分數(unconditional score),側網絡則透過隱式方式貢獻似然分數(likelihood score)。

LISA 的核心做法是從側網絡的指定層提取特徵,透過一個輕量級解碼器(decoder)將其投影到分數潛在空間(score latent space),然後計算解碼器輸出與近似似然分數目標之間的距離,作為額外的正則化損失(regularization loss)。這個設計讓側網絡的特徵在條件建模中更加解耦(disentangled),且推理階段無需任何額外計算。

根據論文實驗結果,LISA 在多種圖像與影片任務、不同網絡架構(UNet/DiT)以及擴散與流匹配模型上均表現穩定,能夠實現超過 2.78 倍的訓練收斂加速(例如在 ControlNet 上),同時帶來可忽略的額外訓練成本與零推理成本。

這項技術特別適合需要快速迭代 ControlNet 或類似條件控制模型的團隊,例如從事姿態引導圖像生成、組合條件生成或可控影片生成的研究人員與開發者。

重點摘要:

  • 方法類型:訓練正則化技術,適用於雙分支視覺條件可控生成框架
  • 核心創新:將側網絡特徵對齊近似似然分數目標,取代純粹依賴擴散損失的訓練方式
  • 訓練效率:在 ControlNet 等場景實現超過 2.78 倍的收斂加速
  • 推理成本:零額外推理開銷,解碼器僅在訓練階段使用
  • 適用範圍:圖像與影片生成任務,兼容 UNet 與 DiT 架構,支援擴散與流匹配模型

GitHub · Paper

Categories: 開源, 香港科技大學, 華為, 模型, 視覺模型, 模型訓練, 框架, 香港, IDE, 深度學習

GauntletBench 評測框架點出 Agent 盲點

這是用來測試 agent 泛化能力的評測工具。它避開常見應用,專攻視覺密集又偏專業的網頁任務。

GauntletBench logo

GauntletBench 是一個極具挑戰性的基於 Web 的基準測試,用於衡量智能體系統在複雜、基於視覺的專業任務中的泛化能力。

GauntletBench 圍繞著五個鮮為人知的應用場景構建——視頻編輯器、工作流程構建器、3D 建模器、飛行分析器和電路設計器——評估了三個尚未充分探索的能力:時間感知、圖形理解和3D 推理。該基準測試涵蓋100 項人類可完成的任務、模組化的評估流程以及自動化的領域特定評分,揭示了前沿智能體與人類表現之間存在顯著差距:被評估的最強智能體的成功率僅為19.1%,而非專家人類標註者的成功率則超過80%,這表明當前的智能體在復雜的真實世界中仍可達到可靠的真實世界的性能水平。

現有 benchmark 多數放在熱門應用和較直接的任務,容易令新一代 agents 出現分數飽和,未必真能反映它們離真實工作有幾遠。GauntletBench 的取向剛好相反:刻意避開常見 app,改用 Circuit Designer、Flight Analyser、Video Editor、3D Modeller、Workflow Builder 五類較少被覆蓋的環境,重新把問題定義成「能否在不熟悉介面完成視覺密集工作」。

這個 GitHub 項目本身不是模型,而是跑評測的框架;README 已交代可按單一 task、整個 application,甚至用 JSON 批次執行實驗,也支援並行執行與 YAML task file。底層 agent run mechanics 直接沿用 REAL 的 browser harness 與 task loop,這個項目新增的重點則是 evaluation framework、batch runner、objective and LLM-as-a-judge evaluators,以及新的 task suites。

  • 100 個任務,每個應用 20 個,全部屬 vision-intensive tasks
  • 預設模型參數 可指定 --model,預設為 o3
  • 可擴充測試方式,支援 YAML 任務檔與 JSON 批量設定
  • 結果訊號清楚:最佳 agent 約 19.1% 至 20.9% success,非專業人類標註者超過 80% 至 90%

最值得留意的是它反映出一個很實際的落差:agent framework 普遍比單純 raw models 好,但整體距離人類仍然很遠;open-source models 甚至普遍低於 1%。Video Editor 屬較可處理的範圍,Circuit Designer 則接近「幾乎做不到」,所以這套工具特別適合研究 Agentic、Computer-use agents、網頁自動化與多模態能力的團隊,用來找出模型不是「答錯」,而是根本看不懂時間、圖形與空間結構的位置。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 模型, 多模態模型, Qwen, Gemini, Video, 框架, 香港, 工具, 3D, Anthropic

MMBench2 點樣預測 World Model 幻覺

MMBench2唔只係資料集,亦連同模型、評測同互動介面一齊公開。重點在於預測同減少 World Models 出現 hallucination。

walker run

MMBench2 是一個圍繞 large generative world models 的研究型基準與開源項目,結合資料集、模型、訓練與評測程式。它主要處理 World Models 在生成未來軌跡時出現 hallucination 的問題,也就是畫面看似合理,但已經偏離真實動態與動作條件。

現有做法多數集中在把 world model 做得更大,或沿用固定的 open-loop rollout 範式觀察生成效果;作者認為這樣很難直接找出模型何時開始失真。這個項目改以「可預測、可預防」為核心,提出三種 runtime hallucination predictors:tokenizer round-trip residual、flow instability、inter-seed denoising variance,並配合 motion-normalized 版本做即時監測。

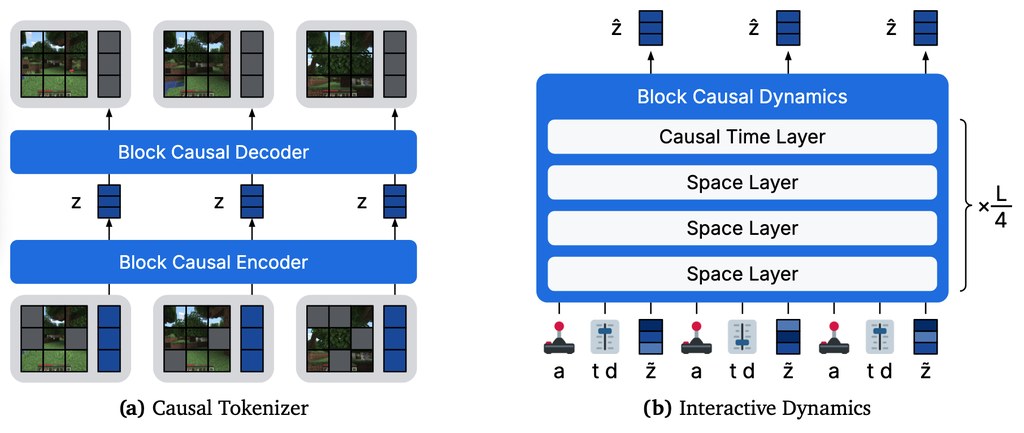
模型設計大致跟隨 Dreamer 4 路線,但重點不只在架構本身,而是把 coverage-aware training 與 targeted data collection 放入同一套流程。作者把 hallucination 視為 data coverage 問題,因此會重抽樣 under-represented 的 state-action space,亦會用 predictors 當 curiosity reward 做 closed-loop online data collection,這比單純加大模型更有方向性。

部署理解上,這個項目已提供互動式網頁介面,可在 CUDA GPU 上直接啟動,並用 live simulators 種出 rollout,連完整資料集都唔一定要先下載。官方亦公開 350M-parameter pretrained 與 finetuned world models,以及 427 小時、涵蓋 210 個 continuous control tasks、10 個 domain 的 MMBench2 dataset,方便研究團隊重做訓練、比較不同變體,或者先用 checkpoint 檢查 hallucination predictor 的表現。

  • 項目性質:研究型 benchmark 加工具鏈,不只是單一模型
  • 核心差異:把 hallucination 當成 coverage 問題,而非單靠更大模型硬推
  • 可測內容:即時 predictor 疊圖、不同模型變體、互動 rollout 對照
  • 相關模型:base、coverage_aware、combined 三類變體,以及 350M-parameter world models
  • 適合情境:world modeling、planning、policy learning、模型安全檢查

這個項目較適合研究 world models、Robotic 控制、模型可靠性與安全的團隊閱讀和試驗。它未必是一般開發者即裝即用的應用工具,但作為 benchmark、分析框架與資料基礎設施,辨識 hallucination 成因與改善方向都相當清楚。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 世界模型, 模型訓練, Robotic, 框架, 安全, Dataset 數據集

Qwythos-9B GGUF 技術拆解

這是 Qwythos-9B-Claude-Mythos-5-1M 的 GGUF 量化版,主打 1M context、推理與工具調用。頁面亦交代 v2 檔案更新與 MTP 用法。

Og image

這個模型之所以值得注意,主要是因為它把 推理能力、超長上下文、以及本地部署友好性 結合在一個 9B 級別的模型裡。它是基於 Qwen3.5-9B 的全參數推理模型,並用 5 億多條 Claude Mythos / Claude Fable traces 做後訓練,還支援 1M context、vision 和 function calling 。

Hugging Face empero-ai/Qwythos-9B-Claude-Mythos-5-1M 的 GGUF 量化版本屬於 quantized 形式,而非原始訓練權重。它的主要用途是在 llama.cpp、Ollama、LM Studio 等 GGUF 執行環境中部署一個支援推理、視覺輸入、function calling 與長上下文的 9B 模型;其表現超越 base Qwen3.5-9B,但這一層關係屬於上游模型說明。

Qwythos-9B 是 full-parameter reasoning model,經過超過 5 億 tokens 的 Claude Mythos / Claude Fable traces 後訓練,並使用 Empero AI 內部 rethink 工具生成 chain-of-thought。能力上支援 1,048,576 tokens(1M context),透過 YaRN rope-scaling 預設開啟;同時標示為 image-text-to-text、multimodal、vision、agentic,表示它不只是文字聊天模型。

v2 已要求重新下載,原因包括 tokenizer metadata 對 Qwen3.5 GGUF runtimes 的修正、chat template 更新,以及新增 -MTP- 版本。已列出的一般版本包括:Qwythos-9B-Claude-Mythos-5-1M-Q4_K_M.gguf(5.24 GiB,官方建議預設)、Q5_K_M(6.02 GiB)、Q6_K(6.85 GiB)、Q8_0(8.87 GiB)與 BF16(16.69 GiB);頁面亦提到 vision projector smoke-tested,但截取內容未見 mmproj 檔名。

  • Q4_K_M 是最適合起步的量化級別,容量較低,而且頁面直接標成 recommended default
  • Q5_K_M / Q6_K 較適合想提高品質、又想控制記憶體佔用的部署
  • Q8_0 接近 near-lossless,較適合重視輸出穩定度的情境
  • -MTP- 檔案是為 llama.cpp MTP draft speculation 準備,一般相容性則以普通檔名版本較穩陣

與一般只做指令微調的同類模型相比,這個項目強調三點:一是 1M context 已預設可用,二是 native function calling 依照 Qwen3.5 spec,三是 v2 連 chat template 都針對 tool calling 與 OpenCode-style agent loops 修正。限制亦很清楚:完整訓練細節與評測數字需要回到 base model card 查看,而這個頁面主要是量化分發頁;使用時亦要留意舊版 GGUF 檔名已被替換,否則 chat template 與 runtime 相容性可能受影響。

項目主頁

Categories: 開源, Agentic, 模型, 多模態模型, Qwen, Image, Anthropic

Robust-TO:更穩陣的影片理解代理框架

Robust-TO 針對 Video-LLMs 在受干擾影片中的誤判問題,用信心分數協調工具與證據。重點不只準確率,還包括出錯時能否有節制地退化。

Repository image for ROVA-V2/Robust-TO

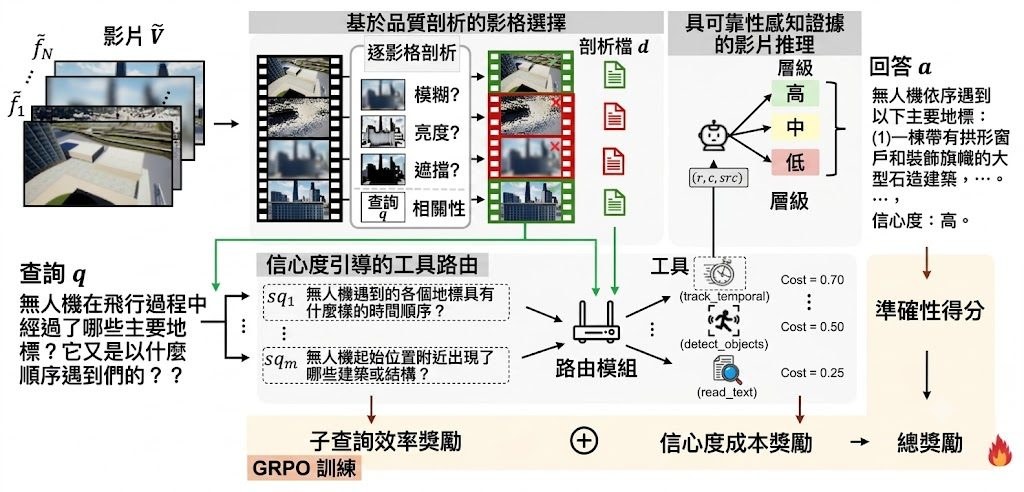
Robust-TO 是一個面向影片理解的 agentic framework 研究原型。它主要解決 Video-LLMs 在模糊、過暗、遮擋等干擾下,仍然盲目相信每一格畫面,導致答案與自信程度脫節的 Blind Trust Problem。

現有做法常把所有影格近乎同等對待,再交由單一模型或固定流程推理;作者認為這種範式忽略了畫面可靠度,所以提出 Confidence-Aware Tool Orchestration。它先用不需額外參數的 profiler 為每格評估 blur、brightness、occlusion,只保留較可靠片段,再把問題拆成子查詢,交由 track_temporal、detect_objects、read_text 等工具處理,最後用 High / Mid / Low 三層證據整合答案。

這個項目最值得留意的,不是單靠更大模型硬推結果,而是把 (result, confidence, source) 當成統一介面,連工具成本與可靠度一併納入。取捨也很明顯:流程比直接問一個 Video-LLM 更複雜,但換來對受污染影片更穩定的表現,而且官方指出在乾淨輸入上延遲開銷低於 5%。

  • 平均準確率比最強開源基線高 +10.6
  • clean-to-corrupted accuracy drop 最小,重點在抗干擾而非只看乾淨數據
  • 使用 GRPO 訓練 policy,獎勵同時考慮正確性、證據可靠度與計算成本
  • 相關組件與模型角色包括 profiler、Router,以及工具如 track_temporal、detect_objects、read_text

目前較適合把它理解為方法框架與研究結果,而不是立即可部署的成品。較受用的會是做 Video-LLMs、Computer-use agents、CUAs 式多工具協作、影片問答或魯棒性評測的研究團隊,特別是想把「模型知道自己何時不可靠」納入系統設計的人。

GitHub

項目主頁

Paper

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Video, 框架

Page 36 of 59
1 … 34 35 36 37 38 … 59