騰訊 Hy3 295B 參數 MoE 開源新模型

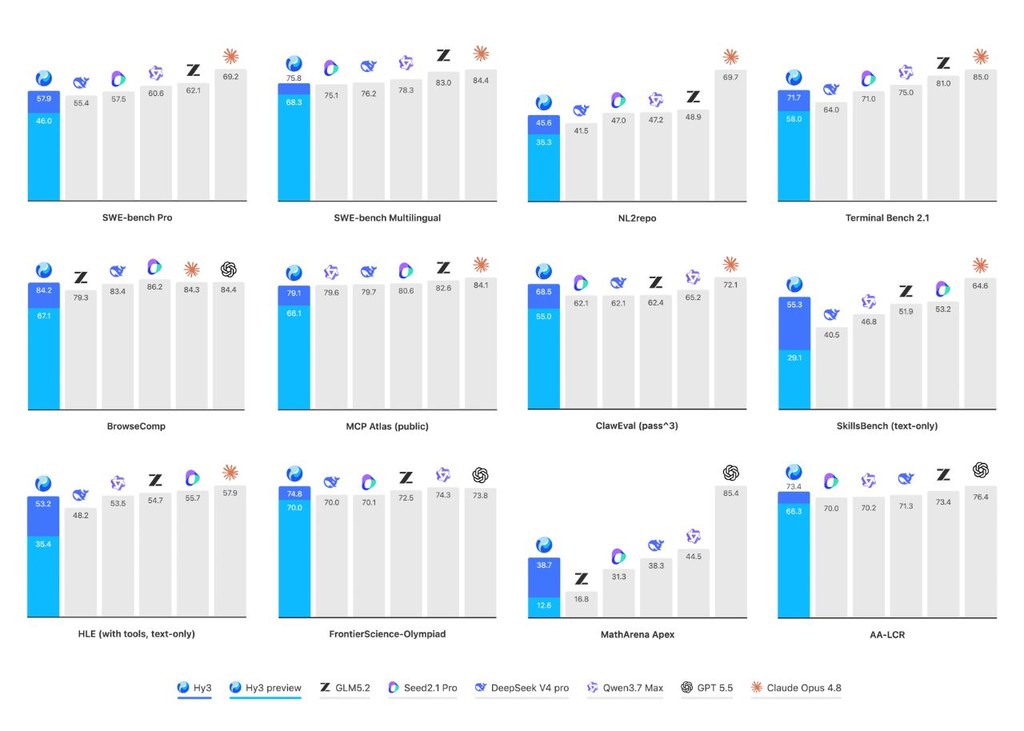
騰訊混元團隊推出 295B 參數 MoE 語言模型 Hy3,支援 256K 上下文,主打 Agent 能力與高效推理。

Og image

Hy3 是由騰訊混元(Tencent Hy)團隊開發的大型語言模型,屬於 Mixture-of-Experts(MoE)混合專家架構,總參數量達 295B,每次推理僅啟用 21B 活躍參數,並額外配備 3.8B 嘅 Multi-Token Prediction(MTP)層參數。此模型基於 Hy3 Preview 進行後訓練擴展,從 50 多個產品團隊收集意見後,以更高品質數據及更大規模強化學習(RL)完成優化。頁面未明確標示 Hy3 係基於邊個外部基礎模型(base model)進行微調,但模型採用原生 MoE 設計,整體架構並非由其他既有模型衍生。

Hy3 共有 80 層非 MTP 主體層加 1 層 MTP 層,採用 GQA 注意力機制(64 個查詢頭、8 個 KV 頭,head dim 128),隱藏維度為 4096,中間層維度 13312,上下文長度支援 256K token,詞表大小為 120832。MoE 部分配置 192 個專家,每次推理啟用 top-8 專家,目前僅提供 BF16 精度版本。

Hy3 官方推薦使用 vLLM 及 SGLang 兩種高效推論框架,頁面亦提供針對兩者嘅部署指南及 finetuning 流程。由於模型體積龐大,即使只有 21B 活躍參數,完整 BF16 權重對消費級 GPU 而言仍然極具挑戰性,需要多張高階加速器才能承載。

Tencent Hy3 (Fully Tested) + Fully Free API: BEATS GLM-5.2?

值得留意嘅係,Hy3 配備 MTP 層參數,可配合 speculative decoding 等加速技術提升 token 生成效率,呢類進階功能適合追求低延遲嘅應用場景。

  • 模型類型:295B 參數 MoE 語言模型,每次啟用 21B 參數
  • 上下文長度:256K token,詞表 120832
  • 精度支援:目前僅提供 BF16 版本,未見 GGUF 或 AWQ 等量化檔案
  • 部署框架:官方推薦 vLLM 與 SGLang
  • 核心強項:Agent 能力、推理表現,以及 MTP speculative decoding 加速潛力
項目主頁

Categories: 開源, 騰訊, 模型

TasteGap:量度人類與 LLM 的 Research Taste

這是一套研究構思評測工具,用來比較人類與 LLM 想法分佈有幾唔同。它唔係只看新穎度,而是追蹤研究口味偏向。

Repository image for ziyuuc/TasteGap

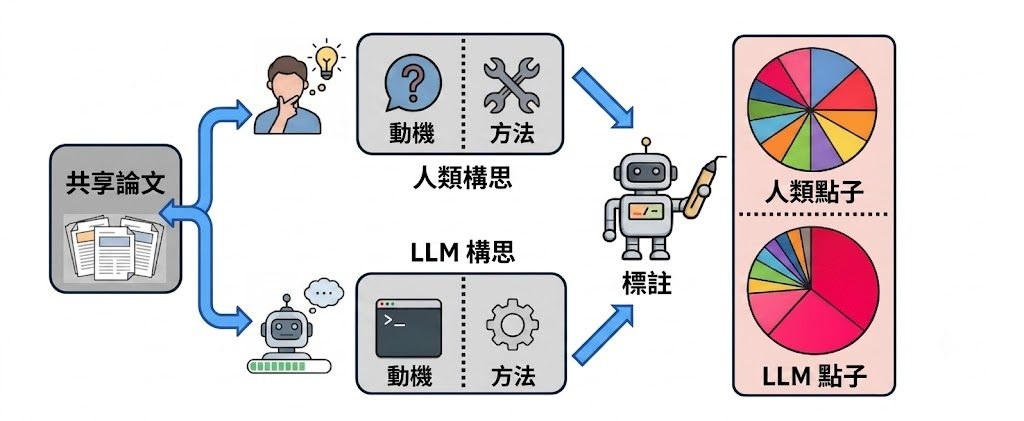
TasteGap 是一個研究評測工具與研究原型,核心工作是比較人類研究者與 Large Language Models(LLMs)生成研究構思之間的差距。它並非處理單篇提案好唔好,而是同一批文獻背景下,人類與模型會傾向提出邊類動機、邊類方法,從而量度所謂 research taste。

現有做法多數用 novelty、feasibility 或專家偏好去評分單個 idea,作者認為呢種固定範式只能判斷「像不像好主意」,但未必見到分佈偏差。TasteGap 改用 shared literature context:先從高質論文反推一組可能啟發該論文的 related works,再要求 LLM 從相同材料生成新 idea,之後用 two-axis research-taste taxonomy,分別標註 motivation 同 method,對比 human ideas 與 LLM ideas 的整體分佈。

GitHub 儲存庫目前提供 evaluation code,而唔係完整訓練框架。安裝理解上相當直接:準備 Python 依賴、設定 config.json 內的 generation 與 labeling 模型、填入 OpenAI 或兼容 API 端點,再用 JSONL 輸入跑 generate_ideas.py 同 label_research_taste.py;要重現完整資料,則需另外下載 Hugging Face 上的 IdeaSeed。輸入記錄包含 paper title、URL、domain、related works,以及人類參考 proposal 的 motivation 同 method,代表這個項目設計重點是可重跑比較,而唔係單次展示結果。

作者提出的主要判斷幾清楚:不同 LLM 生成的 idea sets 都出現一致 distributional gap。LLM ideas 較集中在 bridge-like opportunities 同 synthesis methods,人類論文參考分佈就覆蓋更廣,表示模型可以提出合理點子,但研究取向仍然較窄,亦有系統性偏移。

  • 不是一般 brainstorming 工具,而是用來量度 ideation 分佈差異的評測項目
  • 保留 human ideation 與 LLM ideation 在相同文獻脈絡下的可比較性
  • 研究口味以 motivation 與 method 兩條軸線標註,分析角度比單純打分更細
  • GitHub 內容偏向生成與標註流程,完整資料需配合 IdeaSeed dataset
  • 適合做 AI for science、LLM ideation、科研流程研究的團隊作內部基準

TasteGap 沒有綁定相關模型,只要求在 generation 與 labeling 填入可用模型,並支援 OpenAI-compatible endpoint。這種設計方便團隊橫向比較不同 LLM,但現階段儲存庫未提供完整效能表或基準腳本整理頁,因此不算是交付即用型產品。

GitHub · Paper

Categories: 開源, 模型, OpenAI, Gemini, API, 工具, Python, Anthropic, Dataset 數據集

VLA-Corrector 補救機械人動作失誤

這是一個為 Vision-Language-Action 政策加入即時修正能力的推理框架。重點不在重訓模型,而是在偏差出現時及時截斷舊動作。

VLA-Corrector logo

VLA-Corrector 是一個面向 Vision-Language-Action(VLA)政策的輕量推理框架。它用來處理由 action chunking 帶來的開環盲點:環境已經變了,機械人卻仍照住排隊中的舊動作繼續做。

它的做法不是改寫整個 VLA 模型,而是把 backbone 凍結,再外掛一個 latent dynamics corrector。系統先用 Latent-space Vision Monitor(LVM)監察預測中的視覺特徵變化,當觀察到的畫面持續偏離預測,就會截斷過時動作,並透過 Online Gradient Guidance(OGG)重新規劃下一步。

這種取向與每一步都重算一次動作的 closed-loop 方法不同,重點是保留長 action horizon 的效率,同時在偏差累積時才介入。代價是它依賴 latent mismatch 偵測是否可靠,較像在效率與反應速度之間取平衡,而不是追求全程最敏捷控制。

  • 項目定位:屬於機械人控制推理框架,針對 action-chunked VLA policies 的修正與重規劃。
  • 部署理解:現有資訊顯示它應接在既有 VLA policy 後面運作,較像推理期增強模組,不是獨立基礎模型。
  • 適合場景:接觸密集 manipulation、抽屜對位、抓放物件這類容易受干擾的任務較能受益。
  • 核心組件:Latent-space Vision Monitor(LVM)負責偵測偏差,Online Gradient Guidance(OGG)負責觸發後的修正重規劃。

公開資料提到 real-robot demonstrations,例如抽屜對位與把積木放入不同碗中,並展示人在執行途中施加干擾後的恢復能力。不過 README 片段未列出完整數字指標、安裝步驟或支援哪些 VLA backbone,因此較合理的理解是:這是一個研究原型,已清楚展示方法與效果,但整合到不同機械人堆疊前,仍需自行確認相容性與評測流程。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 多模態模型, VLA, Robotic

Supra-Router-51M:AI 嘅智能分流

51.7M 參數嘅微型路由模型,自動判斷請求該交由本地小型模型定雲端大型模型處理。

Og image

Supra-Router-51M 係一個基於 SupraLabs/Supra-1.5-50M-Base-exp 基礎模型微調而成嘅小型語言模型(SLM),定位係多模型生態系統嘅邊緣路由閘道。佢嘅主要用途係分析用戶輸入嘅提示詞,判斷該請求適合由本地小型模型處理,定係需要轉交雲端大型模型,從而優化整體運算資源分配。

模型採用 Multi-Task Sequence Generation(多任務序列生成)嘅方法,唔係單純做二元分類。佢會先輸出一連串結構化資訊,包括語義領域(Domain)、複雜度評分(Complexity 1-5)、數學需求(Math)、程式碼需求(Code),最後先輸出路由決定(Route)。呢種設計令模型喺做最終判斷前,先建立內部特徵激活圖,避免細模型容易出現嘅權重崩塌問題。

訓練方面使用咗 SupraLabs/Prompt-Routing-Dataset 數據集(992 筆樣本),訓練 5 個 Epoch,但喺 Epoch 3(eval_loss 為 0.1342)已達到峰值後就回退保存,避免後段過度擬合。支援序列長度達 3840 tokens,使用 bfloat16 精度,喺 CPU/GPU 都能做到次毫秒級推論速度。推論時必須用 greedy decoding(do_sample=False)以確保決策穩定性。

使用時需要將用戶查詢包裝喺特定格式(Task: [Prompt] Analysis:)入面,模型會輸出 pipe-separated 嘅結構化字串,包含完整嘅提示詞遙測資訊。配合 FastAPI 等閘道框架就可以部署成生產環境嘅自動分流系統。

由於模型只有 51.7M 參數,運行門檻極低,適合邊緣裝置同需要即時決策嘅場景,但佢嘅路由準繩度仍然受制於訓練數據集規模較細呢個限制。

重點摘要:
– 基於 SupraLabs/Supra-1.5-50M-Base-exp 微調,僅 51.7M 參數
– 採用多任務序列生成架構,先分析提示詞特徵再決定路由
– 訓練數據集 992 筆,3840 tokens 序列長度,次毫秒級推論
– 支援 FastAPI 閘道部署,需使用 greedy decoding 確保穩定
– 適合邊緣裝置資源調度,限制係訓練數據規模較小

項目主頁

Categories: 開源, 模型, 框架, LLaMa, Dataset 數據集

LiveEdit:串流影片編輯走向即時化

LiveEdit 把文字指令變成串流影片編輯,重點放在速度與畫面穩定。它嘗試兼顧即時反應,以及背景與非編輯區域的保留。

Image 1

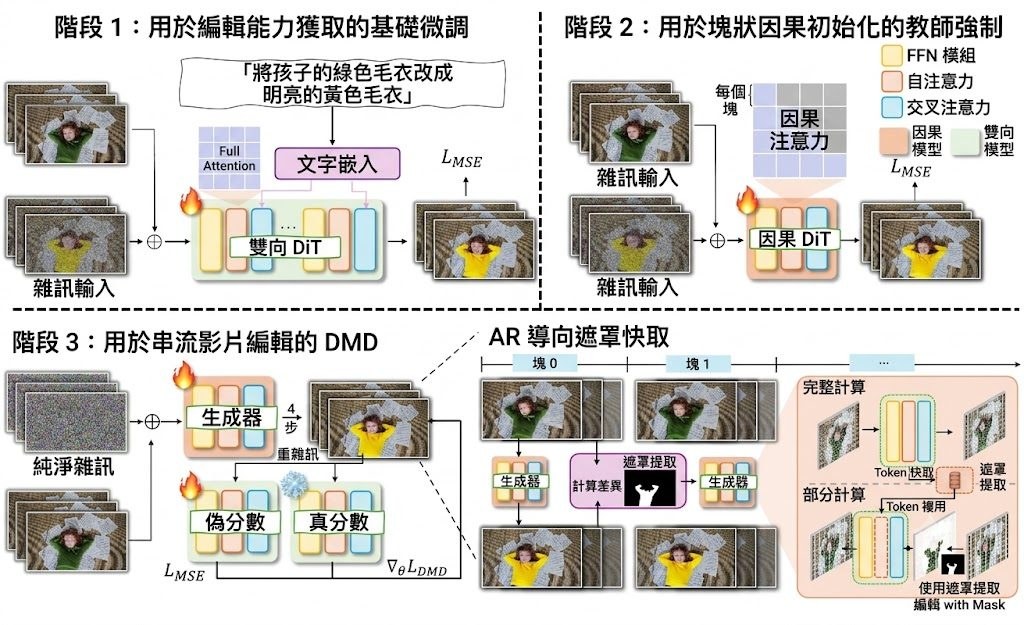
LiveEdit 是一個 diffusion-based streaming video editing 系統,屬於影片編輯模型與方法項目。它的核心任務是根據來源影片加上文字指令,逐段完成 causal chunk-by-chunk editing,並盡量保留背景與沒有修改的區域。

這個項目不是追求離線影片慢慢算到最靚,而是針對接近即時的串流編輯。它建基於 Wan2.1 和 Self-Forcing codebase,並用 three-stage distillation,把雙向編輯 teacher 的能力轉移到串流 student,再配合 AR-oriented Mask Cache 減少重複運算,換來較低延遲。

部署與測試資訊算是完整,提供 inference scripts、training code、checkpoint instructions,也講明建議在 Linux 配合 NVIDIA GPUs 執行;單 GPU 可做 inference,多 GPU torchrun 主要用於訓練。輸入方式是準備一個 JSON,填入 source video 路徑和 instruction,然後配合已釋出的權重與 Wan2.1 base model 進行推理。

有一個相當關鍵的參考值:項目頁列出 12.66 FPS,並表示透過 4-step distilled diffusion generation 達成 real-time streaming inference。這個成績對互動式影片編輯很重要,不過公開資訊未見更完整的硬件條件、顯存需求或不同解析度下的比較,因此判斷效能時仍要保留一點。

  • 重點不是一般文字生片,而是保留原片內容的串流影片編輯
  • 主要技術包括 three-stage distillation、Causal DiT、AR-oriented Mask Cache
  • 已公開 inference 與 training 程式碼,也提供 Hugging Face checkpoint 指引
  • 已知較適合 Linux、NVIDIA GPU 環境,研究團隊或影像生成工程師較易受益
  • 相關模型與基礎包括 Wan2.1-T2V-1.3B、bidirectional editing teacher、streaming student

整體來看,LiveEdit 的價值在於把 streaming video editing 做得更接近可互動系統,而不只是展示級效果。它較適合研究即時影片編輯、互動內容製作、直播視覺處理或需要低延遲生成的團隊;一般用家若想直接在圖形介面一鍵開用,現有資料未提供管理後台整合、免手動設定流程,仍然比較像面向研究與開發者的項目。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, 視覺模型, 視頻模型, NVIDIA, Video, 框架, Linux, 蘋果

oMLX:把 Mac 變成本地 LLM 控制台

oMLX 針對 Mac 本地 LLM 部署而設,重點不是模型本身,而是讓快取、載入與切換更省心。

oMLX

oMLX 是一個針對 Apple Silicon 的本地 LLM 推理工具,也是帶有圖形介面與 CLI 的伺服器管理項目。它主要解決的不是「能不能跑模型」,而是怎樣在 Mac 上較穩定地管理多個模型、保留 KV cache,並減少重複計算帶來的等待時間。

這個項目的取向很明確:用選單列介面處理常見操作,再配合終端機與 Apple Shortcuts 控制同一個服務。安裝路線亦相當直接,macOS 用戶可透過 .dmg 安裝,另有 Homebrew 方式;日志位置、背景服務與 CLI shim 都已交代,對需要長時間開著本地模型的人較友善。

Finally, The CORRECT Way to Run Local AI on a Mac

它和一般本地 LLM server 的差異,在於分層 KV cache 設計。oMLX 把常用內容留在 RAM 的 hot tier,不夠位時再轉去 SSD 的 cold tier,並以 safetensors 格式保存;即使伺服器重啟,遇到相同前綴內容仍可重用快取,這對長對話、編程輔助和工具調用尤其有價值。

只需點擊一下,即可直接從管理面板設定 OpenClaw、OpenCode、Codex、Hermes Agent、Copilot 和 Pi。無需手動編輯配置。

  • 支援 hot tier(RAM)與 cold tier(SSD)分層快取
  • 可自動以 LRU 方式卸載較少使用的模型
  • 管理介面可手動 load/unload 模型
  • 提供選單列操作、CLI 與 Apple Shortcuts 整合
  • 適合需要長上下文與多模型切換的 Mac 工作流程

現有資訊提到 continuous batching、context limits 與基準測試頁面,但 README 片段未列出具體數字,所以性能判斷宜保持審慎。可確定的是,它較適合在本地做持續開發、配合 Claude Code 一類工具,並集中管理「常駐小模型+按需切換大模型」的團隊或個人環境;相關模型方面,內容明確提到 everyday models、heavier models,以及可選的 GLM-5.2、MiniMax M3 原生 custom kernels 支援。

GitHub

Categories: 開源, Agentic, 模型, 框架, Mac, 蘋果

MRPO:醫療多模態推理訓練新路線

MRPO 不是再追最終答案分數,而是直接修補推理中途出錯的位置。醫療 VQA 表現因此更穩,也更有可遷移性。

alt text

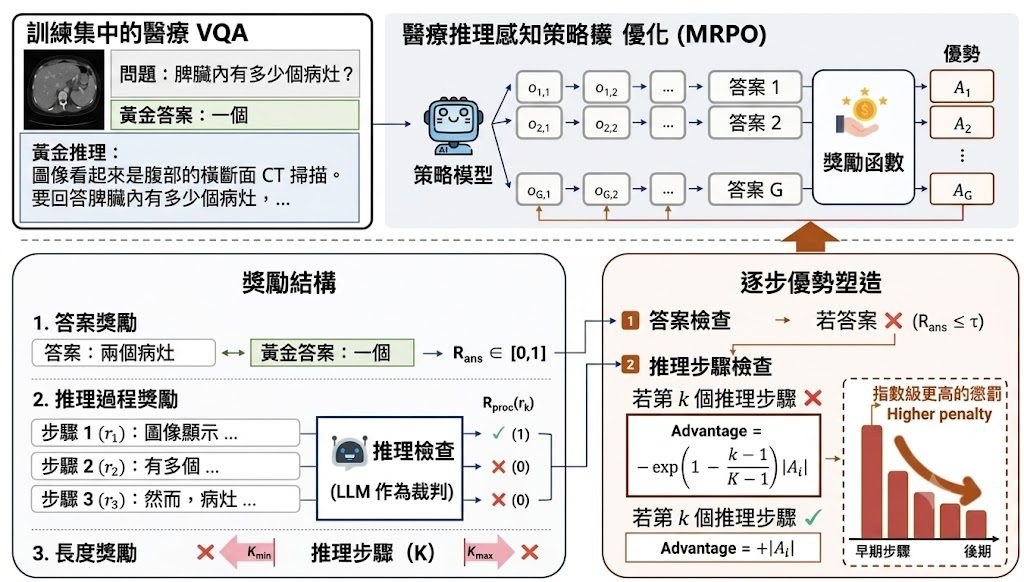
MRPO 是一個用於醫療多模態推理的強化學習框架(reinforcement learning framework)。它要解決的問題不是單純答對與否,而是醫療 VQA 過程中推理鏈一早出錯,之後一路連鎖失誤,令最後答案偏離。

現有 post-training 做法多數偏向 outcome-centric,主要看 final answer correctness 或 sequence-level preferences。作者認為這種範式的問題是 sparse credit assignment,模型知道答錯,卻未必知道究竟由哪一步開始失準;MRPO 因而改寫 GRPO-style advantages,結合 answer-level reward 與 step-wise process rewards,並在最終答案錯誤時,對較早出現的 invalid steps 給予更大懲罰。

這個設計的取向很明確:它不是只罰錯答案,而是重新分配學習訊號,優先修正最早發生的推理錯誤,避免 failure cascades 擴大。README 提到,MRPO 在三個 multimodal LLM backbones 上都優於 standard GRPO 與另一個近期 RL baseline;在 Qwen3-VL-8B-Instruct 上,更以只用 13K training samples 超過較大的醫療 MLLMs,例如 HuatuoGPT-Vision-34B,分數高出 2.79。

  • 核心方法:以 answer-level reward 加 step-wise process rewards 重整 GRPO-style advantages
  • 主要差異:重點放在 first failure,而不是只看最後有冇答中
  • 已公布內容:完整 reinforcement learning recipe、code、datasets 同 infrastructure
  • 可重現方式:項目提供環境腳本、資料下載與前處理流程,訓練資料包含 image、problem、solution 欄位
  • 相關模型:Qwen3-VL-8B-Instruct、HuatuoGPT-Vision-34B,以及 README 提及的另外兩個 multimodal LLM backbones

量化結果最值得留意的是推理質素分析。MRPO 將 early-stage reasoning failures 由 64.0% 降到 13.0%,反映它不只是把答案分數推高,而是令中途推理較少一開始就偏離;這對醫療影像問答尤其重要,因為錯誤往往不是出在最後一句,而是前面觀察與判斷已經失焦。

這個項目較適合研究醫療 AI、醫療影像問答、multimodal reasoning post-training 的團隊參考,也適合想比較 RL 訓練配方差異的人閱讀與重現。它現階段更接近研究原型與訓練方法展示,不是即裝即用的臨床產品;重點價值在於,它把「模型哪一步開始諗錯」正式納入訓練訊號,為醫療 MLLMs 提供一條比只看最終答案更細緻的優化方向。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, OpenAI, DeepSeek, Image, 框架, Medical醫學

TAP:先學動作,再學指令的 VLA 路線

這是一個針對 Vision-Language-Action 模型訓練瓶頸提出的新框架。它用較少專家示範,換取接近大型資料訓練的操作能力。

TAP Framework Overview

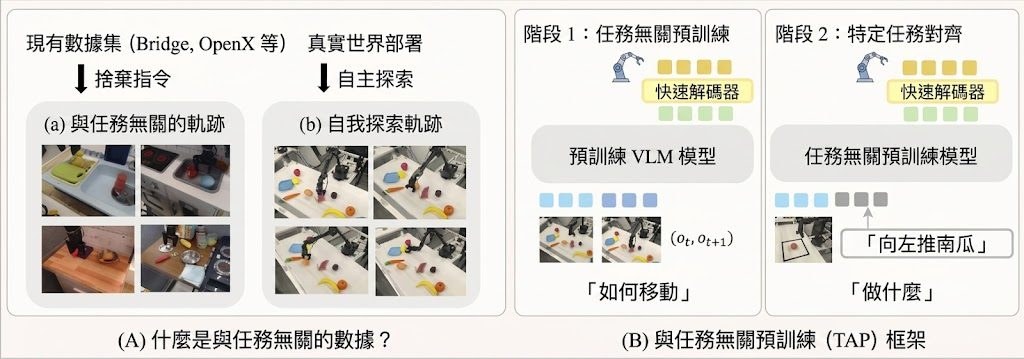
TAP(Task-Agnostic-Pretrain) 是一個 Vision-Language-Action(VLA)模型訓練框架,屬於研究原型兼訓練方法。它要處理的核心問題,是 VLA 長期依賴大量 expert demonstrations,導致機械操作能力難以用較低成本擴展。

現有做法多數直接把「how to move」與「what to do」一齊學,通常需要 observation、instruction、action 這類完整示範資料;作者認為這種固定範式混淆了 physical competence 與 semantic alignment 兩個目標,結果是語言標註被過度用喺本來可以自我監督學習的動作能力上。Task-Agnostic Pretraining(TAP)因此改成兩階段:先用無標註互動資料透過 self-supervised Inverse Dynamics 學 transferable motor priors,再用少量 expert demonstrations 做 task-specific alignment。

這種取向同標準 behavior cloning、以大量網路或專家軌跡堆出來的 VLA 路線唔同。TAP 的取捨很明確:它未必追求一次過把語義和動作全學齊,而是先把可遷移的「點樣郁」拆出來,換來更低標註成本,同時提高對背景、視角變化的穩定度;代價是整個方法仍然要靠第二階段示範去把語言指令對齊到具體任務。

項目已經交代了測試方式:這不是即裝即用應用程式,而是要跟住論文設定,載入 HuggingFace 提供的模型,重現兩階段訓練,再用 SIMPLER benchmark 與真實 WidowX-250s 場景驗證。數字上,TAP-20k 在 SIMPLER 的 Avg-All 為 33.32%,高過 Standard BC 的 23.15%;真實環境中只用 200 個 expert demos,面對 background texture shift 仍有 45% success,viewpoint variation 亦有 20%,而部分 baseline 會跌到 0%。

  • 用 self-supervised Inverse Dynamics 先學動作先驗,減少對語言標註依賴
  • 以約 30 小時 autonomous play 加少量 expert demonstrations,對比 1M+ expert trajectories 路線更慳資料
  • 在 SIMPLER benchmark 勝過 Standard BC,接近或超過部分現有 VLA 模型
  • 對 visual distractors、background texture shift、viewpoint variation 的抗干擾能力較強
  • 相關模型包括 RT-1-X、OpenVLA、Nora、Octo,以及 README 提到的 TAP-20k

項目較適合做 Embodied AI、robot learning、VLA 訓練流程研究的團隊參考,尤其係想用學術規模算力驗證新訓練路線的人。它現階段更像一套值得跟進的方法論,而唔係面向一般用戶的完成品工具。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, Robotic, 教學, Clone, Dataset 數據集

Higgs TTS 3:4B 多語語音生成模型

這是一個主打對話語音生成的 4B TTS 模型,支援 100+ 語言與 zero-shot voice cloning。並提供清楚架構與限制,但未見 GGUF 量化檔。

Og image

這是一個文字轉語音模型 Higgs TTS 3 4B;暫沒有標明它是基於哪個 base model 微調而成。它主要用來把模型回應轉成更接近對話風格的語音,而不只是朗讀文字,並支援 zero-shot voice cloning、情緒、語氣、停頓同 sound effects 控制。

模型核心是約 4B 參數的 autoregressive decoder,規格包括 36 layers、hidden size 2560,以及 GQA 32/8。音訊端先由 Higgs Tokenizer 編碼成 8 個 codebooks、25 fps 的 audio tokens,再透過 delay pattern、multi-codebook fused embedding 同 multi-codebook fused head 處理,最後還原成 24 kHz waveform;這種設計重點在於同時建模文字與音訊 token,讓語音表達更連續。

訓練序列長度為 8,192 tokens,對長句、多輪語音回應會有幫助。語言覆蓋超過 100 種,並提到 102 種語言做到單位數 WER/CER,其中 85 種達到低於 5 的水準,代表它不只追求可讀性,亦重視跨語言穩定度。

  • 定位清楚:偏向 voice chat 與 expressive conversational speech,而非單純 TTS 朗讀器。
  • 控制能力完整:可直接控制 emotion、style、prosody、pauses 與 sound effects。
  • 多語能力強:支援 100+ 語言,102 種語言有公開 WER/CER 描述。
  • 授權限制明確:只開放 research and non-commercial use,商業用途需另取授權。

模型未提供 GGUF 格式、量化級別、檔案大小、mmproj、llama.cpp、Ollama 或 LM Studio 支援資訊,也未見 v2 檔名變更、chat template 注意事項與 MTP draft speculation 相關內容;這些多數屬於 LLM 或多模態推理頁面常見資訊,並非此 TTS 頁面的重點。使用上更值得留意的是授權條款與風險限制,包括未經同意的 voice cloning、冒充、詐騙、選舉誤導與生物識別監控都被禁止。

項目主頁 · 模型

Categories: 開源, 文字轉語音, 模型, Audio, Clone, 語音

ABot-M0 用 600 萬軌跡訓練機械人操作

ABot-M0 是面向機械人操作的 VLA foundation model,結合大型資料與新動作學習方法。它重點解決機械人資料分散、控制不穩定和跨任務泛化問題。

ABot-M0 model overview

這是一個面向機械人操作的 Vision-Language-Action(VLA)foundation model,名為 ABot-M0。它主要用來讓機械人根據視覺與指令完成操作任務,並處理資料分散、動作表示不一致,以及控制模型訓練效率偏低的問題。

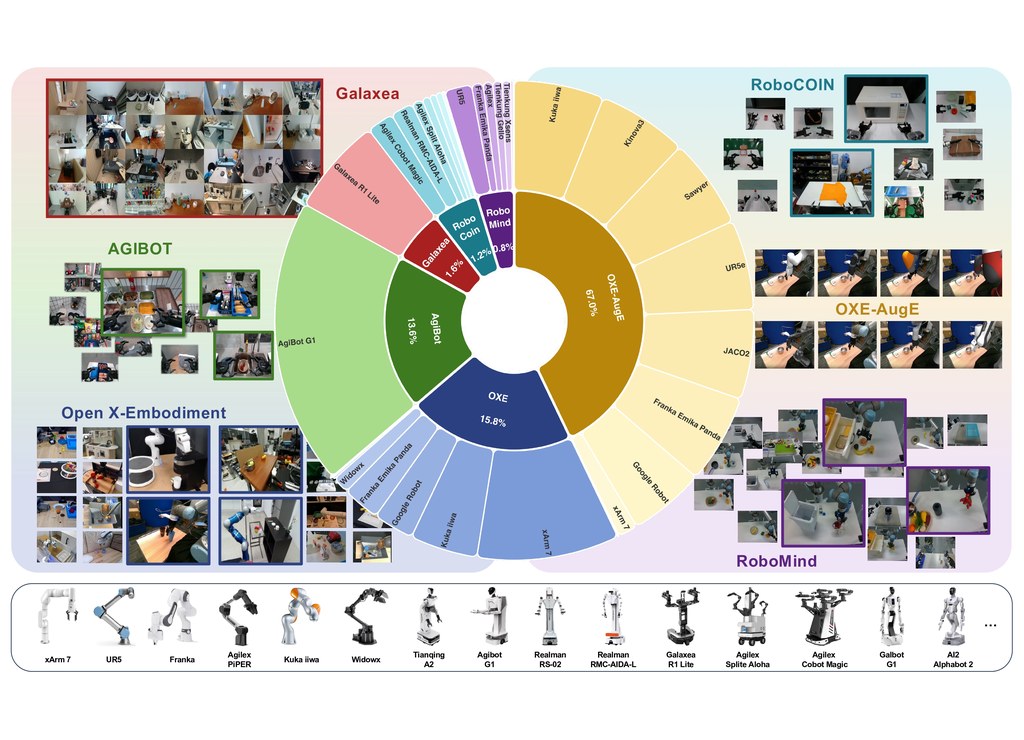
ABot-M0 的基礎來自 UniACT-dataset。這個資料集整合 6 個公開資料來源,包含 OXE、OXE-AugE 與 AgiBot-Beta,合共超過 600 萬條 trajectories、9,500 小時以上互動資料,並覆蓋 20 多種機械人形態;資料亦經過清理、標準化與統一,將動作轉成 end-effector 座標系中的 delta actions,旋轉則採用較穩定的 rotation vector 表示。

它和常見 diffusion 式控制方法的主要差異,在於採用 Action Manifold Learning(AML)。一般 diffusion model 多數學習預測 noise,ABot-M0 則直接做 Direct Action Prediction(a-prediction),輸出乾淨的動作序列;這種做法把學習重點由「擬合噪聲」轉成「投影到可行動作流形」,理論上更有效率,也更有助提升解碼速度與 policy stability。

另一個實用方向是模組化 3D perception。ABot-M0 支援 plug-and-play 模組去加強 3D 空間理解,對涉及精準位置、姿態與複雜操作步驟的任務會更有幫助;同時,它亦用「pad-to-dual」策略統一 single-arm 與 dual-arm 任務,令同一模型可覆蓋更廣的操作場景。

  • 整合超過 600 萬條 trajectories,資料規模相當大
  • 以 UniACT-dataset 統一不同來源與不同機械人表示方式
  • 採用 Action Manifold Learning(AML),直接預測動作而非噪聲
  • 支援 plug-and-play 3D perception 模組,提升複雜任務精度
  • 適合關注 robotic manipulation、VLA 與通用機械人控制的讀者

現有資料重點放在方法設計與資料規模,具體基準分數與完整比較結果在這份內容中未完全展開。即使如此,ABot-M0 已清楚展示一條很具代表性的路線:先用大規模統一資料打底,再用更貼近可行動作結構的學習方式,提升機械人操作模型的泛化與穩定性。

項目主頁

Categories: 開源, 模型, 視覺模型, 多模態模型, VLA, Robotic, 3D, Dataset 數據集

Page 35 of 59
1 … 33 34 35 36 37 … 59