SciReasoner 想把科學推理拉回結構本身

做蛋白質、分子同材料推理,只靠文字序列往往唔夠。SciReasoner把3D結構直接變成可推理證據,重點是答案背後的科學線索都盡量保留。

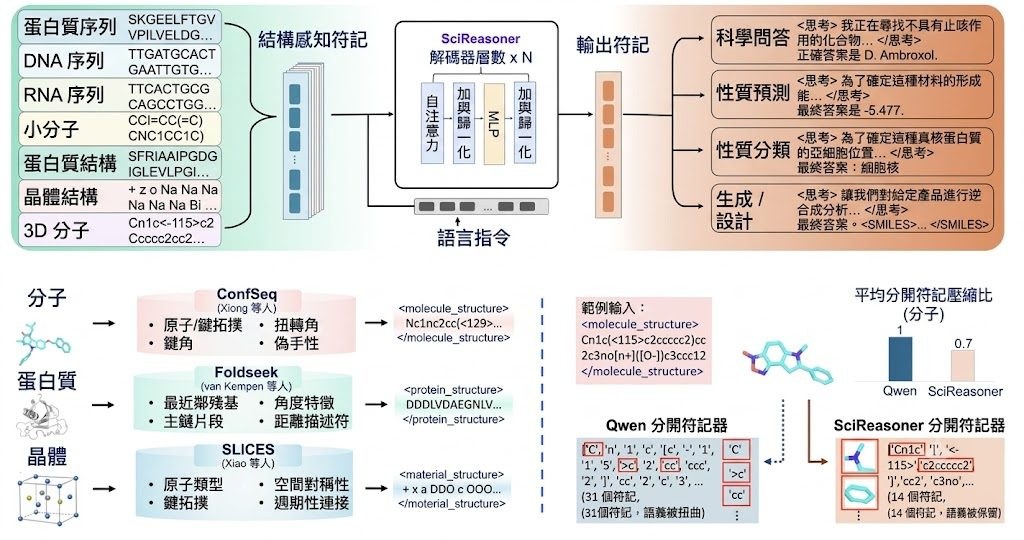
SciReasoner architecture overview

只看文字去判斷蛋白質功能、分子反應性或材料性質,經常會漏掉真正關鍵的空間結構。SciReasoner屬於多模態 scientific foundation model,針對的正是這個落差:把 protein structures、3D molecules、crystals、sequences、formulas 同 text 轉成可對照的 structure-aware evidence tokens,再用來做 scientific QA、prediction、classification 同 generation/design。

與科學資料先「文字化」再交畀大型語言模型處理的做法不同。作者明確押注 native structural reasoning,保留 Foldseek 3Di、ConfSeq、SLICES 呢類結構編碼,令模型唔係淨係讀描述,而係可以沿住 residues、fragments、conformers 甚至晶體配位環境去推理;官網展示的 traces 亦反映出,項目希望連推理路徑都可以檢查,而唔只係輸出答案。

GitHub 上的 models 同 demo 仍標示為 coming soon。換句話說,眼前較合理的理解方式係先把它當成研究型項目:閱讀 benchmark、看案例 traces,判斷它是否適合生物資訊、化學資訊或材料 AI 團隊之後的評測與整合方向,而唔係即刻下載部署到生產流程。

  • 在 86 個評測任務入面,67 個做到 state-of-the-art,對比 generalist LLM baselines 有 75 個任務表現最好
  • 與已發表的 specialist 方法相比,在 33 組比較入面有 26 組持平或更好
  • 範圍唔只化學,亦覆蓋 proteins、DNA/RNA、small molecules、3D molecular structures 同 inorganic crystals
  • traces 可檢查,雙盲專家評分中,與 DeepSeek-V4-Pro 相比有 98% 判斷屬 preferred 或 comparable

相關模型方面,SciReasoner以 Qwen3-14B 初始化,再對齊 domain-native structural vocabularies。對需要跨蛋白質、核酸、分子同材料做統一推理介面的團隊,呢個方向幾有吸引力;限制同樣明顯,因為公開模型與可直接測試的 demo 尚未提供,現階段更適合當成值得追蹤的研究項目,而唔係可即用工具。
項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 南京大學, 模型, 多模態模型, Qwen, DeepSeek, 香港, Medical醫學, 3D, 中國, Dataset 數據集

LingBot-World 2.0 把互動世界拉長

想像一個會持續生成、又跟得上操作節奏的互動世界模型。LingBot-World 2.0吸引人的地方,在於它同時追求連續性、速度與可玩性。

teaser

最值得留意的,不是單純生成影片,而是它嘗試把世界模型做成可持續互動的系統:畫面不只要動,還要在長時間互動下維持一致,並且跟得上即時操作。LingBot-World 2.0,也叫 LingBot-World-Infinity,定位上屬於模型項目,處理的是互動式世界生成容易愈玩愈散、反應又唔夠快的問題。

同類做法很多時偏向短片段展示,或者重視視覺效果多於操作連續性;這個版本反而把焦點放在「interaction horizon」拉長,同時保住輸出穩定度。它亦加入 agentic harness,由 pilot agent 規劃角色行為、director agent 補出新環境元素,方向上更接近可演進的遊戲式世界,而唔只係被動播放內容。

現階段最容易理解的試法,是先經 Reactor 的 Web 版本或 LingGuang 的流動平台體驗即時版;README 亦提供 Hugging Face 與 ModelScope 上的模型頁面。官方說明指出,平台版本方便試玩,但完整能力仍以官方設置為準,換句話說,公開體驗較適合感受互動節奏,未必等同完整表現。

  • 支援長時間互動,主打 unbounded interaction horizon
  • 提供即時變體,官方稱可驅動 720p、60 fps 影片串流
  • 動作與事件更豐富,包括攻擊、射箭、施法、射擊等互動
  • 以 pilot agent 與 director agent 分工,推進角色與場景演化

現有資料未見完整基準表或系統化對比結果,性能描述主要來自項目方公開說明,所以較適合把它視為一個展示取向鮮明的前沿模型。相關模型目前可見的是 lingbot-world-v2-14b-causal-fast;而從 Robbyant 整體路線來看,它亦與 LingBot-Vision、LingBot-Depth、LingBot-VLA、LingBot-Video 等項目一起指向 embodied AI 與世界模型的長線布局。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 多模態模型, 世界模型, Video, VLA

DeepSeek-V4-Flash 本地 GGUF 版

想喺本地跑 DeepSeek-V4-Flash,重點唔只係能否啟動,仲要留意量化後準確度、記憶體門檻同對話模板是否貼近官方表現。呢個版本主打用 GGUF 格式換取更易部署,但硬件要求仍然偏高。

Og image

最值得先講的是,它明確基於 deepseek-ai/DeepSeek-V4-Flash 製作,屬於面向本地部署的 GGUF 量化版本,處理的是大型語言模型喺本機執行時常見的記憶體壓力與部署門檻。頁面同時提醒要配合最新版本的 llama.cpp 或 Unsloth Studio,否則 DeepSeek-V4 可能無法正確運行,代表它對推論框架版本有一定依賴。

Unsloth 把焦點放喺量化後仍盡量保持原模型表現,並提到改良了 DeepSeek-V4 的 chat jinja template,經過超過 4000 段對話測試後,效果與官方 baseline 等效。對使用者來說,呢點比單看可唔可以載入更重要,因為同一個模型換咗模板後,回答風格、工具調用格式甚至思考開關行為都可能出現明顯差異。

檔案資訊方面,頁面清楚列出 UD-Q8_K_XL 屬於 full precision lossless 的建議選項,大小約 162GB,而且只比 Q4 的 UD-Q4_K_XL 大 7GB。描述亦提到 3-bit 可喺 110GB Mac、RAM 或 VRAM 配置運行,full precision lossless 則需要大約 168GB RAM;不過目前提供內容未見完整 GGUF 檔名清單、各量化級別大小、mmproj 附加檔案或上下文長度細節,因此無法逐一確認。

  • 已確認 base model 是 deepseek-ai/DeepSeek-V4-Flash
  • 建議使用最新 llama.cpp 或 Unsloth Studio
  • UD-Q8_K_XL 約 162GB,主打 lossless
  • 3-bit 版本可面向約 110GB 記憶體配置
  • chat template 經 4000+ 對話測試,目標貼近官方 baseline

同類模型比較上,呢個項目的差異不在重新訓練,而在於 GGUF 量化封裝、Unsloth Dynamic 2.0 量化方法,以及對 DeepSeek-V4 對話模板的修正。頁面提到 Unsloth Dynamic 2.0 準確度優於其他主流 quants,但未附上完整對比分數; v2 更新內容、檔名變更、MTP draft speculation 支援、Ollama 與 LM Studio 的具體載入方式,現有資料只足以確認支援方向,未足以逐項下定論。

項目主頁 · 模型

Categories: 開源, 模型, DeepSeek, Mac, Ollama

[技術文章] Gemma 4:更快更慳算力的多模態開放模型

Gemma 4 想解決的,不只是模型夠唔夠大,而是點樣同時兼顧推理、多模態同部署效率。你可以把它理解成一組更貼近開發與裝置落地需要的 Gemma 新世代模型。

Hero image preview

Google 正式發佈 Gemma 4 技術報告文章:

當模型要同時處理文字、圖片同音訊,常見做法多數靠獨立 encoder 加上大型語言模型組合;能力雖然完整,但記憶體佔用、推理速度同長上下文成本都容易變重。Gemma 4 Technical Report 針對的正是呢個矛盾:唔只追求更強表現,亦想把多模態理解、推理能力同計算效率放到同一條路線上處理。

Gemma 4 屬於 open-weight、natively multimodal language models,涵蓋 dense 同 Mixture-of-Experts(MoE)架構,規模由 2.3B 到 31B。報告最值得留意的對比,在於作者唔再只沿用「更大模型加外掛模組」呢種固定範式,而是加入 thinking mode,令模型先產生 reasoning trace 再回答;同時用長上下文優化、KV cache sharing,以及在 12B 版本引入 unified, encoder-free architecture,把 raw audio 同 image patches 直接投影到 LLM embedding space。

呢種設計帶來的好處幾實際:一方面,長上下文下的記憶體壓力有機會減輕,報告提到 global KV cache footprint 最多可減 37.5%;另一方面,模型亦提供用 quantization-aware training(QAT)訓練的量化版本,盡量在不明顯犧牲品質下減少參數記憶體佔用同延遲。另有 autoregressive multi-token prediction(MTP)drafter head,配合 speculative decoding 提升解碼速度。

  • 支援文字、圖片、音訊,多個型號覆蓋不同硬件需求
  • 以 thinking mode 加強數學、編程等重推理任務
  • 透過 p-RoPE、KV cache sharing 等方法改善長上下文效率
  • 12B 型號採用 encoder-free 路線,減少獨立 encoder 帶來的記憶體碎片化

性能方面,報告指 Gemma 4 在 STEM、多模態同長上下文 benchmark 有明顯進步,亦在 Arena 等 human-rated tasks 接近更大型的 frontier open models。原始資料未提供安裝步驟或完整使用流程,但已清楚交代模型系列的核心取向:用較可控的成本,換取更接近前沿水準的多模態推理能力,並以 Apache 2.0 授權開放。

Paper

Categories: Embedding, 模型, 多模態模型, 模型訓練, Google, Gemini, Image, Audio, Dataset 數據集

SenseNova-Vision 把視覺任務收進同一模型

同一個模型同時處理框、點、OCR、分割同深度圖,SenseNova-Vision想解決的正是視覺流程太分散的老問題。你可以把它理解成一個用生成方式統一多種電腦視覺輸出的模型項目。

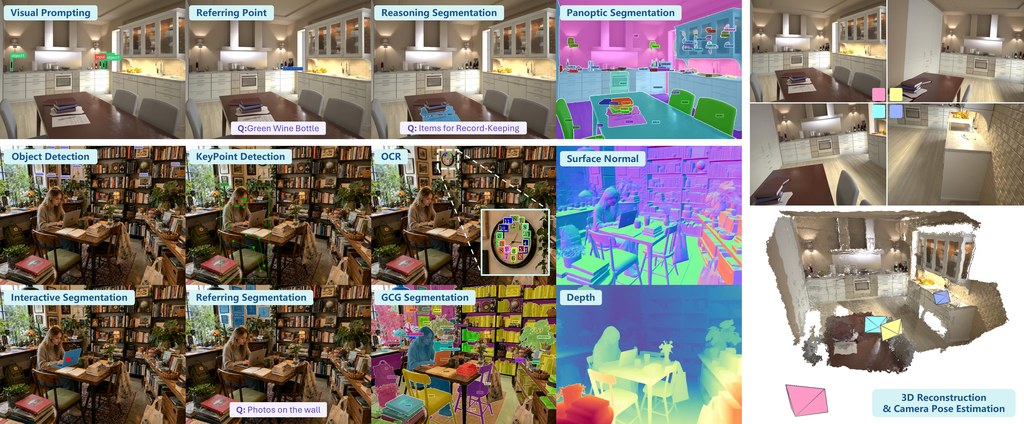
SenseNova-Vision handles diverse vision tasks in a unified model

做視覺項目最麻煩的,往往不是單一任務做不到,而是偵測、OCR、分割、深度估計同多視角幾何各有各套輸出格式。SenseNova-Vision把這些工作收斂到 unified multimodal model(UMM)的生成介面之內,屬於多模態模型項目,重點是用自然語言指令加可選視覺提示,統一處理結構化理解與密集預測。

它的取向幾明確:不再為每類視覺任務各自設計頭部與輸出器,而是把 boxes、points、OCR strings、keypoints、camera parameters 交由文字生成,把 segmentation masks、depth maps、surface normals、multi-view point maps 交由影像生成,亦支援文字加影像混合回應。這種做法的好處是工作流一致,代價則是推理解碼與評測轉換要做得夠穩,否則通用性未必等於每一項都最強。

目前公開內容包括推理程式、模型權重 SenseNova-Vision-7B-MoT、資料集 SenseNova-Vision-Corpus-50M,以及可試用的 Demo。要理解它點樣測試,最直接是先用 Demo 看同一張圖在不同指令下可否輸出可解碼結果,再配合倉庫的 Evaluation Guide 對標準 benchmark 檢查文字、影像或混合輸出的還原能力。

  • 同一模型覆蓋 結構化視覺理解、分割、dense geometric prediction 與 multi-view visual geometry
  • 輸出形式統一:文字、影像、混合文字影像都可作為回應
  • 已公開資源完整:inference code、SenseNova-Vision-7B-MoT、SenseNova-Vision-Corpus-50M、Demo
  • 適合場景明確:研究團隊、視覺產品原型、要整合多任務流程的工程工作

這個項目最適合不想為每個任務維護一套模型堆疊的團隊,尤其是同時要做偵測、文字辨識、分割與幾何估計的組合型流程。現有資料指出它在多類視覺任務上有不錯結果,但倉庫摘要未列出完整數字;現階段更值得留意的,是它用可解碼生成格式統一 benchmark 輸出的能力,這比單看某一項分數更能反映其定位。

GitHub · 模型

Categories: 開源, 模型, 多模態模型, Image, 影像處理, 香港, Dataset 數據集

SIEVE 點樣揀出更值錢的機械人示範數據

示範數據愈多,未必代表 VLA 訓練效果愈好。SIEVE 想做的,是先拆開動作結構,再挑出更值得保留的片段與軌跡。

Repository image for ChangtiWu/SIEVE

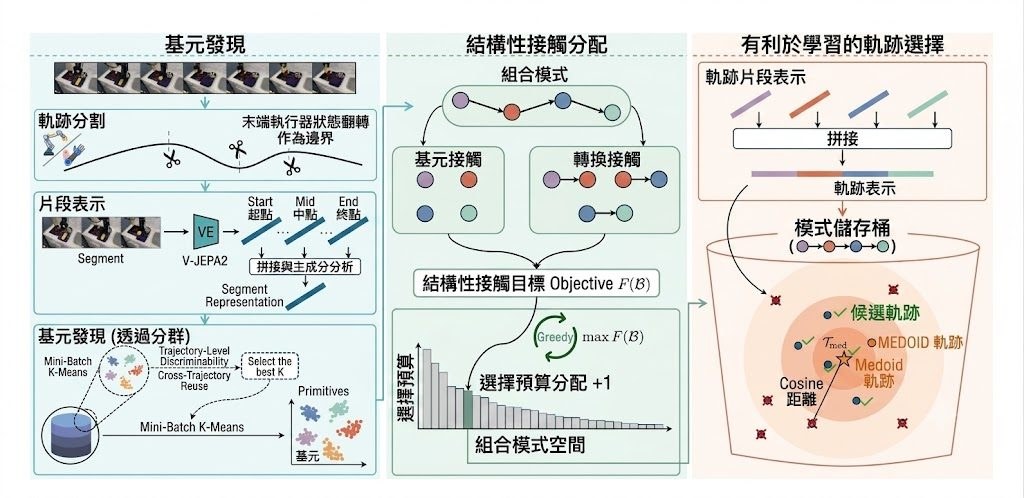
機械人示範資料最常見的問題,不是數量不夠,而是重複、嘈雜,甚至長段任務其實只是不斷重演相似動作。SIEVE 屬於一個面向 imitation learning 的資料篩選工具,同時帶有研究方法性質,重點不是逐條 trajectory 粗略評分,也不是只看 state-action,而是把長任務拆成可重用的 visuo-motor primitives 與 transition interfaces,再決定哪些 episode 更值得留下來訓練 VLA 模型。

它批評的舊範式相當明確:現有 data selection 方法多數只在 trajectory level 或 state-action level 做判斷,因而忽略長時序行為內部可重用的結構。SIEVE 的做法是先用 end-effector pose 與控制訊號做 segmentation,再抽取 V-JEPA 特徵、用 PCA 壓到預設 256 維、以 MiniBatchKMeans 找出 primitive pattern,之後按 cluster-sequence pattern 做兩階段 episode selection,最後可以匯出回 LeRobot 格式,方便直接接回原本訓練流程。

這種取向的好處,在於它不是單純挑「最好」或「最乾淨」的示範,而是優先保留結構覆蓋度與可重用性。論文提供的訊息亦相當直接:SIEVE 在多個 datasets、benchmarks 與 VLA models 上,都比競爭性的 baseline 更穩定,甚至在只用 50% demonstrations 和 50% training steps 的情況下,表現可以超過 full-data training。當然,這也代表它較適合已有一定規模示範資料、並且願意先跑一輪離線整理流程的團隊,而不是追求即插即用的小型腳本。

  • 以 LeRobot v2 資料根目錄作輸入,支援單一或多個 dataset
  • 流程由 segmentation、feature extraction、dimensionality reduction、clustering、selection 組成
  • 特徵抽取依賴 V-JEPA,輸出中間結果到 Zarr,再匯出選中的 LeRobot episodes
  • 核心差異是按 reusable structure 揀數據,不是只按整條 trajectory 或逐步 state-action 打分

部署理解上,這個項目更像一條可重複執行的離線資料處理 pipeline,而不是一個直接提供推理服務的套件。適合用來整理大型 robot demonstration corpus、為 VLA imitation learning 減少冗餘訓練樣本;相關模型與技術脈絡包括 Vision-Language-Action (VLA) models、V-JEPA,以及輸出端相容的 LeRobot。

GitHub · Paper

Categories: 開源, 香港科技大學, 模型, 視覺模型, 多模態模型, 模型訓練, VLA, 影像處理, Robotic, 香港, 中國, Dataset 數據集

Light-Omni 想把長影片 Agent 變得更快

面對長影片互動,Light-Omni唔再靠一輪輪搜尋同推理。它把記憶、檢索同回應壓縮成較輕量流程,重點放在速度同連續互動。

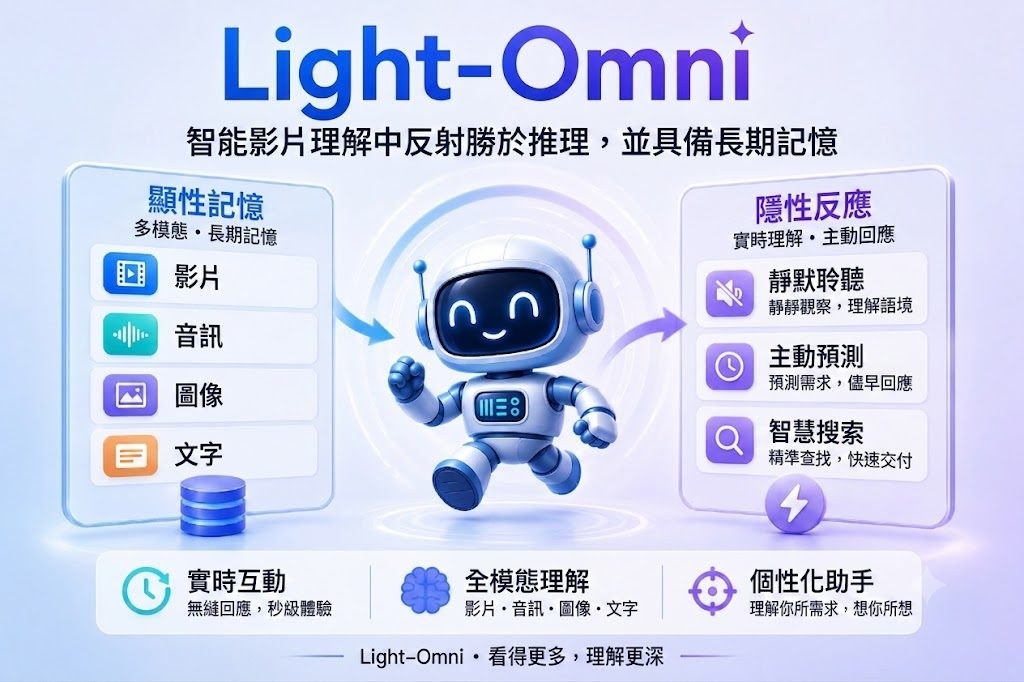
Light-Omni

長影片互動最易卡住的位,不是模型看不懂,而是每次都要重新搜尋線索、反覆推理,回應自然會慢。Light-Omni把這件事改寫成一個Agentic video understanding研究項目:用長期多模態記憶處理視覺、語音與文字串流,目標是讓代理在連續對話中更快決定要直接回答、提取記憶,還是補足證據。

現有做法常採用作者所說的 detective-style iterative reasoning,一邊規劃、一邊搜尋、一邊聚合證據;好處是步驟清楚,代價是延遲高、計算開銷大。Light-Omni提出 reflexive video understanding,核心不是拉長 reasoning loop,而是以單次 forward pass 產生全域脈絡與 retrieval embeddings,再配合 Generation Adapter、Memory Adapter、Reaction Adapter 三個模組,分別負責回應、長期記憶整理,以及預測何時檢索。

這個取向的價值很直接:它不是追求最繁複的推理鏈,而是優先解決互動代理在長影片場景的反應速度。項目建基於 Qwen2.5-Omni,示範則用 Qwen3-Omni-30B-A3B-Instruct;記憶設計包含 identity profiles、semantic memory、episodic memory,並加入 sleep-time memory consolidation,把較長時段的觀察壓成緊湊全域狀態,同時保留近期細節。

  • 相比 M3-Agent,平均準確率提升 2.4%
  • 速度達 12.1x,加強長影片互動的即時性
  • GPU 記憶體效率提升 2.6x,較適合資源有限的部署
  • 倉庫附有 eval.py、Flask/Socket.IO demo、Hugging Face 模型與訓練資料

想驗證這個項目,現時可沿三條路理解:先看 web demo 感受反應方式,再用倉庫內的 eval.py 配合 logs/ 檢查長影片 benchmark 結果,最後參考 thirdparty/ 內已修補的 transformers 與 ms-swift 組件做訓練或推理環境配置。較受用的讀者會是做多模態代理、長影片理解、記憶檢索,或者需要低延遲互動系統的研究團隊;它仍屬研究原型,效能數字主要來自項目提供的 benchmark 與示範,部署前仍要按自己的影片長度、硬件條件與任務形式再核實。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, Embedding, 模型, 多模態模型, Video, Dataset 數據集

PixWorld 把 3D 重建與生成收在同一路線

想由幾張視角圖重建場景,或者直接做 text→3D、image→3D,PixWorld 把兩條路合併成同一個模型。它的吸引力不只在速度,亦在於訓練目標更貼近 3D 場景本身。

PixWorld teaser

做 3D 場景時,很多方法會把重建同生成分開處理,PixWorld 就反其道而行,把兩者收進同一個開源框架式研究項目:同一個 end-to-end pixel-space diffusion model,同一趟 forward pass,同時兼顧 reconstruction 同 generation。對想比較 text→3D、image→3D 同多視角重建流程的人來說,這種設計最大意義在於少一層轉換,也少一套彼此割裂的模型心智負擔。

它批評的舊範式很明確:不少做法先進 latent space,要經過 VAE/RAE,再由 3D decoder 還原成 3D 表示;PixWorld 則直接在 rendered multi-view images 上施加 pixel-space flow-matching loss,令優化目標更貼近 3D scene fidelity,而唔係先對準中介 latent target。作者再加上一個 geometry perception loss,借助 frozen 3D foundation model 的 π³ / VGGT feature space,補回純 2D photometric loss 同 perceptual loss 對 3D 結構監督不足的問題。

它會把 posed multi-view inputs 分成 clean views 同 noisy views:前者走 reconstruction,後者走 generation,並由 two-stream diffusion transformer 處理,最後解碼成 pixel-aligned 3D Gaussian representation。這個取向的好處,是把 3D reconstruction、text→3D 同 image→3D 放到同一個表示與訓練框架;代價則是項目目前仍偏研究原型,README 已提到 cleaned RealEstate10K、DL3DV、ACID datasets 以及 PixWorld-480P-4steps distilled weights 與 inference code 尚未完整釋出。

  • 類型定位:屬於模型導向的開源項目,處理 3D scene generation 與 reconstruction 分裂成兩套流程的問題。
  • 主要差異:直接在 pixel space 訓練,避開 VAE/RAE 中介表示,並加入 geometry-aware 監督。
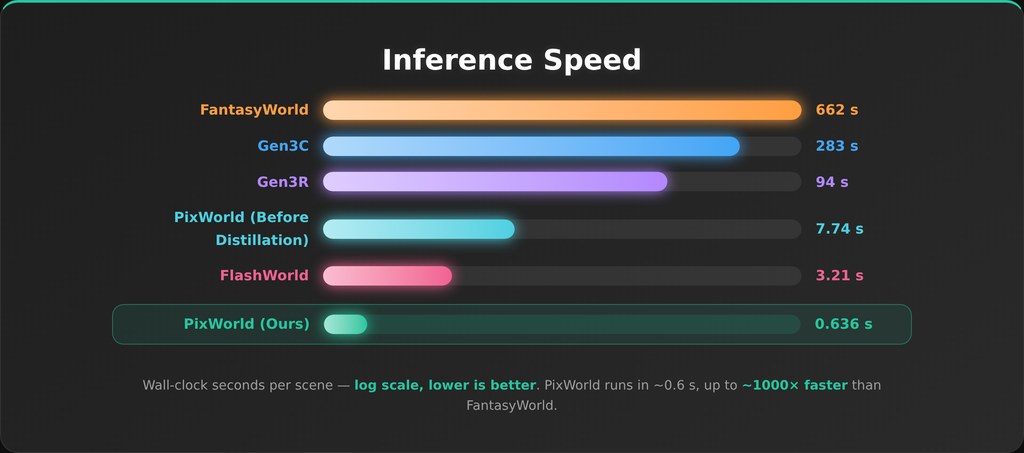
  • 已知表現:distilled 4-step 版本每個 scene 約 0.6 秒,官方稱相對 diffusion-based world generators 峰值可達約 1000× 加速。
  • 重建指標:提供 71.04 WorldScore average,以及 RealEstate10K 4-view reconstruction 的 26.21 dB PSNR。
  • 相關模型與模組:two-stream diffusion transformer、pixel-aligned 3D Gaussian、frozen 3D foundation model π³ / VGGT。

現階段較適合研究 3D world generation、3D Gaussian Splatting、multi-view reconstruction 的團隊先用來判斷方法價值,而唔係即刻當成完整生產工具部署。可惜目前公開資訊仍以論文、示範頁與方法介紹為主,未見完整安裝、評測腳本與權重發布,因此較合理的理解方式,是把 PixWorld 視為一條很有方向感的新路線:它不只是追求更快,還試圖重新定義 3D 生成與重建應該共用同一套訓練目標。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 模型訓練, Image, 3D

LingBot-Vision 補強密集空間感知

想做深度估計或語意分割,但又唔想每個下游任務都重訓視覺編碼器,LingBot-Vision正是針對這個卡位而來。它把邊界、形狀同語意區域一併學好,重點放在更可靠的空間特徵。

Boundary-centric masked modeling

做深度估計、語意分割或者影片物件分割時,最麻煩往往唔係有冇大模型,而是編碼器抽出的特徵夠唔夠貼近物件輪廓。LingBot-Vision屬於模型,更準確地說是自監督預訓練的 Vision Transformer 視覺骨幹,處理的是密集空間感知裏面「語意有了,但邊界唔夠準」這個老問題。

它的取向幾明確:唔係一味追求分類式語意表示,而是用 masked boundary modeling 去逼模型同時保留空間結構與語意訊息。凍結後的 patch tokens 已經可以直接支援輕量 readout,涵蓋 depth estimation、semantic segmentation、video object segmentation,亦作為 LingBot-Depth 2.0 的 visual encoder 初始化,這種設計比起只偏重全局語意的 ViT 骨幹,更適合需要逐像素判斷的工作流。

這個項目較接近「取用預訓練骨幹再接下游任務」的用法,而唔係即裝即用的完整應用。模型已放到 Hugging Face 與 ModelScope,較合理的理解方式,是把不同尺寸的 LingBot-Vision 權重接入現有 dense prediction pipeline,先測 frozen features 的表現,再決定需唔需要額外微調。

  • 重點不在生成內容,而在提高 dense spatial perception 的特徵品質
  • 已公開多個相關模型:ViT-S/16、ViT-Base、ViT-L/16,以至 1.1B 參數的 ViT-g/16
  • 支援的方向包括 depth estimation、semantic segmentation、video object segmentation、depth completion
  • 與同類做法相比,更重視 boundary-faithful features,而唔係只強化高層語意表示

受益最大的會是做機械人視覺、3D 感知、影像理解基建的團隊,尤其當你手上已有 segmentation 或 depth 項目,只差一個更穩定的 encoder。性能方面,README 用「substantial performance gains」形容 LingBot-Depth 2.0 在換上 LingBot-Vision 編碼器後的提升,但公開內容未列出完整基準數字,所以現階段較值得先留意其特徵可遷移性,以及在邊界敏感任務上的潛力。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, Video, VLA, 影像處理, Robotic, 3D

GigaWorld-1:機械人世界模型開源路線圖

GigaWorld-1 不只是模型,亦是一套圍繞機械人世界模型的訓練與推理流程。它的重點是用模擬 rollout 協助評估 robot policy。

GigaWorld-1 Teaser

GigaWorld-1 是一個面向 robot world models 的開源工具鏈與研究原型。它主要用來訓練、推理、處理資料,並把世界模型當成 robot policy evaluation 的替代評估器,減少每次都要落真機做 rollout 的成本。

現有做法通常依賴真實機械人測試,或者用偏重短片畫質的 video world models 觀察結果;作者認為這種範式未必足夠反映 policy 是否可靠,因為短期視覺真實感不等於長時序、動作一致的 rollout 準確度。這個項目連同 WMBench 一齊提出較清晰的評測框架,重點放在 long-horizon、action-faithful rollout consistency,而不是只看畫面似唔似真。

和一般只放模型權重的 GitHub 項目相比,GigaWorld-1 較完整地公開了訓練、inference、資料處理、checkpoint conversion 及 LoRA merge 流程,取向明顯偏向可重現與可擴充。基礎模型亦不是由零開始孤立建立,而是結合 Wan、Diffusers、Helios、Genesis 等元件,反映它更像一條可調整的工作流程,而不只是單一模型展示。

  • 重點不在短期畫面好看,而在 rollout 是否長時間維持動作一致性
  • 提供 training、inference、data processing、checkpoint conversion、LoRA merge 等完整流程
  • 相關模型與元件包括 Wan、Diffusers、Helios、Genesis
  • 配套有 ToyDataset、CVPR 2026 WorldModel Track Dataset 與 WMBench benchmark

部署思路相對明確:環境以 Python 3.10+、PyTorch 2.x、Linux 為主,再按 README 準備資料、模型與推理流程;需要下載模型或資料時,亦已有獨立工具說明。硬件需求未算輕量,但首頁提到 1.3B / 5B 變體與低於 24GB 記憶體的生成設定,代表它並非只面向超大規模研究機構。

較適合受益的群體,是做 embodied AI、robotics、world model research 的團隊,以及想建立 policy evaluator 管線的人。現有資訊顯示它背後有 12,000+ 小時訓練影片、324,000+ 模擬 rollout 配對真機執行,以及 7 類 video world models、4 種 action representations 的比較;這些數字未必等於任何場景都會即插即用,但足以說明它的價值在於提供一套有 benchmark 支撐的評估方法,而不只是再多一個生成模型。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 世界模型, 模型訓練, Video, VLA, Robotic, 框架, Linux, Python, Dataset 數據集

Page 34 of 59
1 … 32 33 34 35 36 … 59