Kimi K3 編程實測:能否撐起複雜項目

Kimi K3 這次被放到 Claude Code 之中做高難度編程實測,重點看它能否獨立處理 App、遊戲和前端項目。測試關心的不是宣傳數字,而是它在長上下文與複雜任務中的穩定度。

Og image

Kimi K3 的焦點落在編程能力,而不是單純講參數規模。這次實測把它放進 Claude Code,直接看它能否應付從零開發原生 macOS 和 iOS App、2D 與 3D 遊戲,以及較複雜的前端工作流。這類測試最有價值的地方,是能看出模型在長上下文、多步驟修改和除錯時,能否保持一致性。

和一般只看跑分或簡單問答的展示相比,這種做法更接近真實使用情境。開發者在意的通常不是模型會不會背答案,而是它能否理解已有程式結構、持續追蹤修改,並在多輪互動後仍然做對決定。

這個內容特別適合以下讀者:
– 需要評估 AI 編程助手的人
– 關心 Claude Code、Kimi K3 這類模型實戰表現的人
– 想看原生 App、2D/3D 遊戲與前端生成能力差異的人
– 留意國產模型是否追上第一梯隊的人

影片同時提到 Kimi K3 的 2.8 兆參數與 100 萬 Token 上下文窗口,顯示它主打的是長文脈和複雜編碼任務。不過,真正要看的仍然是它在高難度項目裡能否穩定交付,而不是單看規格有多大。

項目主頁

Categories: 模型, 教學

VideoChat3 一個睇得耐又睇得準的影片模型

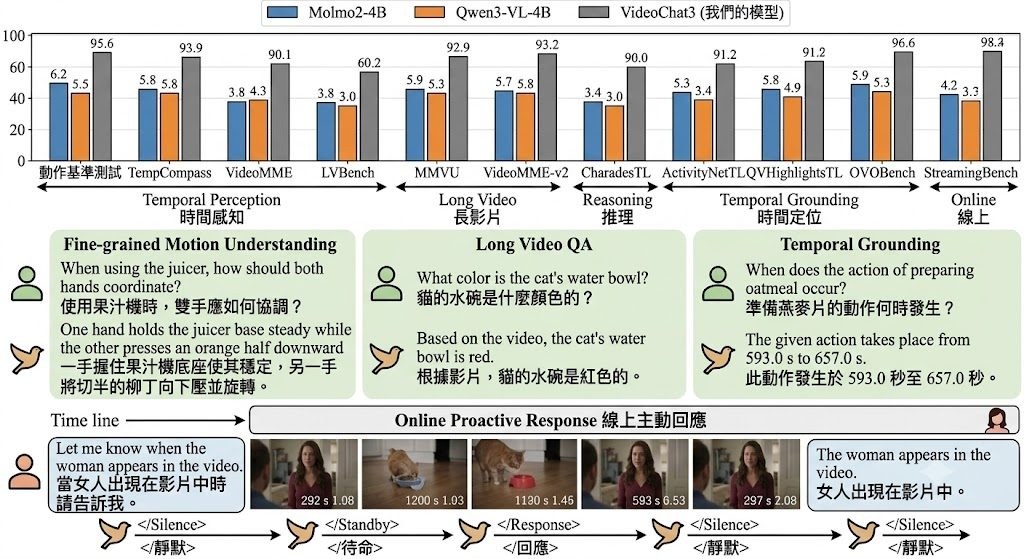
要同一個模型同時處理細微動作、長片理解同直播回應,一向好難。VideoChat3 把重點放在時序理解同效率,定位相當清晰。

VideoChat3 logo

影片理解最麻煩的地方,往往唔係「識唔識睇」,而係要一邊保留動作細節,一邊捱得住長時間片段。VideoChat3 就係朝住呢個矛盾落手:它屬於多模態模型(Multimodal Large Language Model, MLLM),目標係用同一個 4B 模型處理細微動作、長片推理、temporal grounding 同 live streaming 回應。

同類項目好多時只會專注其中一段工作流,例如短片動作辨識,或者長片問答。VideoChat3 的取向係做 generalist video understanding,代價就唔係追求單一場景最極致的規格,而係用 I3D-ViT 同 Adaptive Frame Resolution 平衡 token 成本、時序證據同延遲,令模型唔需要全程用高成本方式讀完整段影片。

  • 重點唔只係睇單格畫面,而係保留跨時間的證據
  • I3D-ViT 提供 16× spatiotemporal compression,主打效率
  • Adaptive Frame Resolution 會按需要提高畫面解析度,較適合 streaming 場景
  • 已公開 model weights 同完整訓練數據,但 training code 仍未釋出

部署同測試的理解方式幾直接:現階段較接近研究釋出與模型體驗,適合先經 Hugging Face 取用 models & data,再按示範場景驗證長片問答、時間定位同串流回應表現。README 已列明完整訓練資料包括 Academic2M、LV116K、OL617K,對研究團隊、做 video agent、或者要建構影片檢索與監察流程的團隊最有參考價值。

公開資訊亦交代咗幾個關鍵數字:4B parameters、3M curated instruction samples、2,048 frames 下約 20.4s latency。呢啲數據未必代表所有環境都會有同樣效果,但至少講清楚它想證明的方向:唔靠超大模型,都可以把影片中的時間線索、事件關聯同即時反應放入同一套架構。相關模型與模組則以 VideoChat3、I3D-ViT、Adaptive Frame Resolution 為核心,整體更似一個面向研究與進階應用的開源影片理解項目。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, 模型, 視覺模型, 多模態模型, Video, 框架, 3D

KeyFrame-Compass:關鍵幀尺度評測

想知道影片生成有沒有跟住關鍵畫面,KeyFrame-Compass 就把這個矛盾拆開量度。它同時看畫面有沒有到位、順序有沒有跟足,還會檢查整體影片質感。

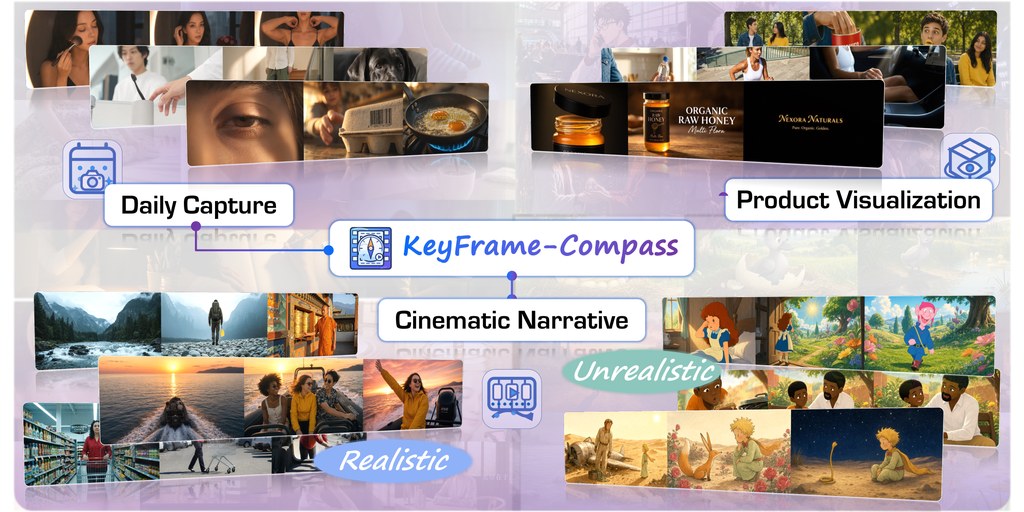
KeyFrame-Compass benchmark domains and examples

KeyFrame-Compass 是一個用來評測 keyframe-conditioned video generation 的基準項目,重點在於檢查模型能否同時跟住文字提示同一組按順序排列的 keyframes 生成影片。對做影片生成的人來說,這類測試最有價值的地方,是它不只看成片好不好看,還會追問畫面有沒有真係按要求出現、順序有沒有走樣。

這個項目把評測拆成兩層:一層看 keyframe execution,包括關鍵畫面存在、視覺還原、時間順序、定位、持續性同回應唯一性;另一層看 overall video quality,會用 evidence-grounded MLLM(Multimodal Large Language Model, MLLM)判斷,加上專門的感知模型去量度視覺質素、時間連貫性、指令遵從同音訊表現。這種分法比單純比對整體分數更清楚,因為它能分辨出模型係「畫得靚」定「跟得準」。

官方提供 386 個案例,涵蓋三個應用領域,亦分有 multi-shot 同 one-take 片段,配合四種 keyframe 密度。安裝上需要 Linux、Conda 或 Mamba、NVIDIA GPU,同埋可用的 VLM API;倉庫亦提供 envs、assets 同 all 三種設定模式,方便只建環境、只拉資產,或者一次過做完整驗證。

  • 把影片生成的「跟畫面」同「成片質感」分開量度,結果較容易解讀
  • 支援不同 keyframe 密度,較適合比較模型對控制力的穩定度
  • 適合做影片生成模型、研究原型或產品 demo 的質量驗證
  • 需要 GPU 同外部 VLM API,部署門檻唔算低
  • 相關模型類別可歸到 Video、視覺模型、多模態模型、模型、工具

GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Gemini, API, Video, 工具, Linux

awesome-Self-Improving-Agents:拆解自我改進 Agent 地圖

想追蹤 self-improving agents 點樣由概念走到方法,呢個整理庫比單看論文更省時間。它把分散做法收成一張可導航地圖,方便快速判斷研究路線。

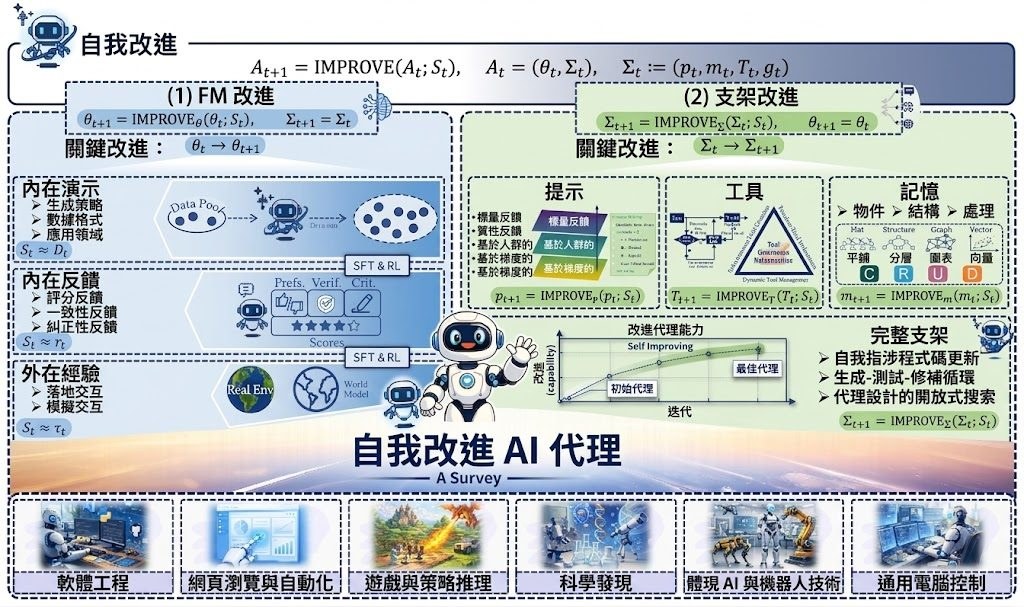
Main figure of the survey

當大家都在談 Agent 會否愈跑愈聰明,真正麻煩的往往不是資料太少,而是做法太散、名詞太多、更新位置又不一樣。awesome-Self-Improving-Agents 把這件事整理成一個論文地圖型資源庫,核心不是教你直接部署系統,而是幫你分清楚 self-improving agentic systems 究竟在改進模型本身,還是在改進 prompt、memory、tools 與 control logic 這些外圍 scaffolds。

現有討論常把各類自我改進方法混在一起看,作者則用一條很實際的分界重組內容:一邊是 Foundation Model Improvement,另一邊是 Scaffolding Improvement。這個切法的好處,是你很快知道某篇工作追求的是更持久但較重的參數更新,還是較快、較平、亦較容易回退的代理層更新,閱讀時不會把 LoRA、工具路由、記憶結構調整當成同一類問題。

它不是可即裝即跑的軟件工具,更像研究與產品規劃都用得著的索引庫。你可以直接從 GitHub README、survey hub 同 arXiv 論文交叉閱讀;要測試這個項目的價值,最直接的方法是按 taxonomy 揀一條路,例如 Intrinsic Generative Demonstrations、Intrinsic Evaluative Feedback,或者 memory、tool refinement、full scaffolding,看看它能否幫你更快找到代表性工作與相近分支。

  • 把 self-improvement 分成 Foundation Model Improvement 與 Scaffolding Improvement 兩大路線
  • 收錄 239 篇 papers,當中 73 篇屬 FM improvement,166 篇屬 scaffolding improvement
  • 細分到 Intrinsic Generative Demonstrations、Intrinsic Evaluative Feedback、dynamic tool routing、autonomous tool creation 等機制
  • 適合研究員、Agent 產品團隊、技術寫作者整理文獻脈絡與比較方法取向

相關模型與系統脈絡圍繞 Foundation-Model-Based Agents 展開,但這個項目本身不提供單一模型權重或 benchmark 分數,也不是 OSWorld 那類直接跑任務的評測框架。它的價值在於建立閱讀順序與判斷框架;想找可落地的 agent 改進方向,這份 curated map 比單篇 survey 更接近工作清單。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 模型, 多模態模型, Meta, Dataset 數據集

MetaView 補回生成的空間感

只用一張相就想轉出大幅度新視角,最難是畫面似真之餘仲要守住空間比例。MetaView 針對的正是這個卡位。

teaser

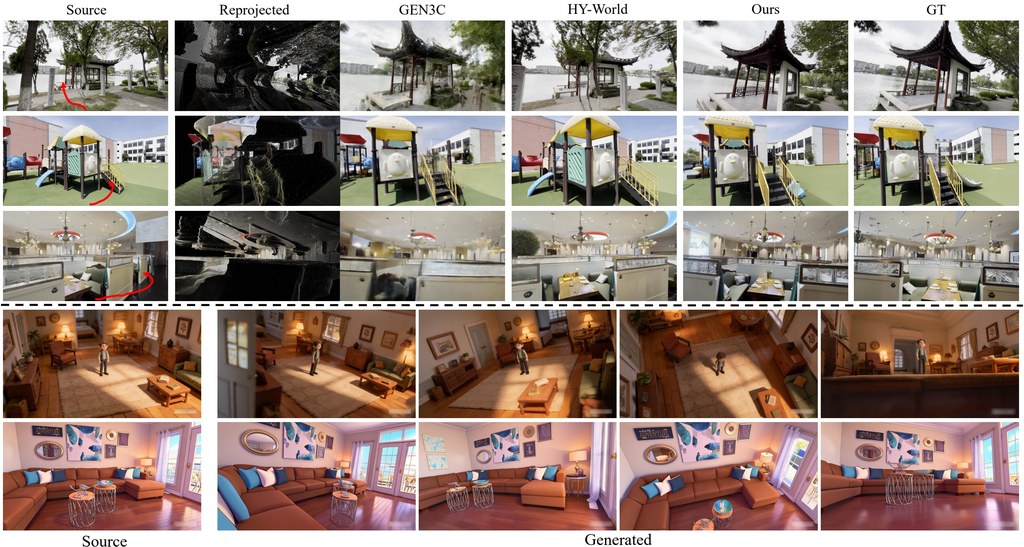
單靠一張圖片生成大角度新視角,很多方法一轉得遠就會出現結構鬆散、比例飄移,鏡頭控制亦未必準。MetaView 屬於影像生成框架,集中處理 monocular novel view synthesis,目標是在不做顯式 3D reconstruction pipeline 的前提下,仍然保住 geometry consistency 同可控的 camera pose rendering。

它的取向幾清楚:唔想被重建流程綁死泛化能力,但又唔接受純 implicit 方法常見的 scale drifting。項目把 Depth Anything 3 提供的 implicit geometry priors 接到 pretrained MM-DiT backbone,做法是加入 non-invasive parallel attention layers;同時再用 modified RoPE,配合 PRoPE 為 z-axis 留出額外子空間,把場景尺度固定在較一致的 3D metric space。

對研究團隊、做 novel view synthesis、3D-aware image generation,或者需要從單張圖控制鏡頭輸出的工作流,這個項目值得留意。現有資訊較像研究原型:README 與 project homepage 已提供 paper、demo 與 model 入口,但未見完整安裝與部署細節,所以現階段較合理的理解方式,是先用 demo 看大視角轉換與 spherical poses control 的效果,再等待公開模型與程式流程補齊。

  • 單張圖片輸入,主打大幅度 viewpoint changes 下仍保持高保真輸出
  • 不走 explicit 3D reconstruction pipelines,換取更高彈性與泛化空間
  • 用 Depth Anything 3 幾何先驗補結構,再用 modified RoPE 處理 scale anchoring
  • 比較對象包括 ViewCrafter、Gen3C、Voyager、PE-Field、HY-World、Lingbot-World

MetaView 在具挑戰性的 monocular large viewpoint changes 測試中,表現優於多個 reconstruction-based 與 implicit 方法,強調的是 geometry consistency、precise controllability 與 generalization。現階段較適合把它視為一個方向鮮明的研究項目:它不是單純追求更靚畫面,而是嘗試把單圖生成長期欠缺的空間尺度感補回來。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, Image, 影像模型, 香港, 3D

GigaWorld-Policy-0.5 推向機械人即時反應

機械人要邊看邊動,卡位往往不在「會不會做」,而在「能不能夠即時做」。GigaWorld-Policy-0.5嘗試用更輕量的推理路徑,保留世界模型訓練收益,同時壓低本地延遲。

機械人控制最難受的地方,常常不是動作生成本身,而是模型一邊理解畫面、一邊預測未來場景時,推理成本高到難以閉環運作。GigaWorld-Policy-0.5屬於 World Action Model(WAM),重點是保留未來視覺動態對訓練的幫助,但在執行階段只解碼動作,減少為了生成未來影片而付出的額外開銷。

它延續 action-centered 的路線,再加入 Mixture-of-Transformers 架構,將視覺建模與動作生成分成不同 expert。咁樣做的取捨很清楚:訓練期間仍然利用未來場景演化強化動作學習,推理時則走較輕的 action-only pathway,提升即時控制效率。資料提到,它在本地 RTX 4090 上可做到 85ms inference latency,目標就是支援更接近即時的部署。

另一個值得留意的位置,是它不只改模型結構,亦加入 agent-based AutoResearch pipeline 來搜尋訓練配置。這種做法主要是減少手動調 hyperparameter 的時間,讓實驗設定更有系統地被篩選。對做 Robotic、世界模型或策略學習的人來說,這比單純追求更高指標更實用,因為整個訓練流程的效率同樣影響迭代速度。

  • 保留 future visual dynamics 的訓練收益,但推理時只輸出動作
  • 用 Mixture-of-Transformers 分開 visual expert 與 action expert,降低活躍計算量
  • 以 mixed Action-Conditioned World Modeling(AC-WM)和 WAM 訓練,加強視覺與動作的耦合
  • 引入 agent-based AutoResearch pipeline,提升訓練配置搜尋效率
  • 已公開論文、程式碼與模型,方便研究用途跟進

整體來看,GigaWorld-Policy-0.5處理的是世界模型常見的速度與控制落地矛盾:訓練想要看得多、學得深,部署又要夠快。現有資料顯示,它把重心放在更有效率的 action-centered WAM 路線,適合關注即時機械人控制、閉環部署與本地推理表現的人。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, 模型, 模型訓練, Video, Robotic, 框架, 編程

MonkeyOCRv2 文件通用 OCR 底座

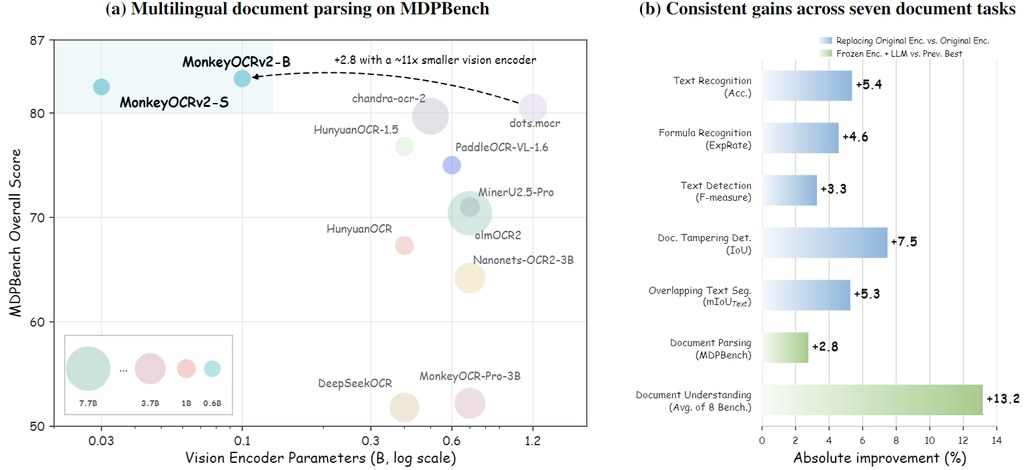
掃描文件、表格、公式到場景文字,往往要分開處理。MonkeyOCRv2想做的是用同一套視覺編碼器,接住多語言文件理解與 OCR 工作流。

overview

文件 AI 最麻煩的地方,在於文字辨識、版面解析、文件理解、公式辨識,甚至竄改檢測,很多時都要拆成幾個模型串起來。MonkeyOCRv2 把自己放在視覺文字基礎模型的位置,核心不是只追單一 OCR 指標,而是想用同一個 encoder 同時覆蓋多語言文件 parsing、understanding、text recognition、formula recognition 以至 scene text detection。

它採取的路線很明確:不像部分做法會按任務各自訓練小模型,MonkeyOCRv2 強調 fine-grained text modeling、cross-task representation learning 同 cross-lingual generalization,等於先把「文字作為視覺內容」這件事學得更深,再把能力分流到不同文件任務。這種取向的好處,是同一套底座較適合研究團隊或產品團隊整合工作流;代價則是現有資訊仍以模型發布為主,完整效能對比與部署細節還要結合論文與 checkpoint 再判斷。

現階段最值得留意的,是項目已不只放出單一模型名稱,而是分成幾條較清晰的能力線。 MonkeyOCRv2 vision encoder,以及面向 multilingual document parsing 的 MonkeyOCRv2-Parsing、面向 efficient document understanding 的 MonkeyOCRv2-Und,並提供 Hugging Face 與 ModelScope checkpoint,代表測試方式大致會圍繞下載權重後,按任務接入 parsing、recognition 或 understanding 流程,而不是單純打開一個聊天介面就完成。

  • 涵蓋 OCR、文件理解、公式辨識、竄改檢測、重疊文字分割等多類任務
  • 提供 MonkeyOCRv2-S、MonkeyOCRv2-B、MonkeyOCRv2-AS,不同 backbone 對應不同場景
  • S、B 版本偏向 Recognition / Parsing / Understanding,AS 版本偏向 Detection / Segmentation
  • 已公開 Demo、Hugging Face 集合與 MonkeyDocv2 數據集線索,方便交叉驗證

從現有公開資訊看,這個項目較適合做 Document AI、智能審核、票據與表單處理,也適合想比較 dots.mocr、PaddleOCR-VL、Qwen3-VL 這類路線差異的人。它未必是最輕量的選擇,但「一個編碼器橫跨多任務與多語言」這個方向,對需要長期維護文件工作流的項目有相當吸引力。

GitHub · Paper

Categories: 開源, 模型, 多模態模型, Qwen, OpenAI, 影像處理, 框架, Medical醫學, Dataset 數據集

RINO 用圖像編輯統一視覺任務

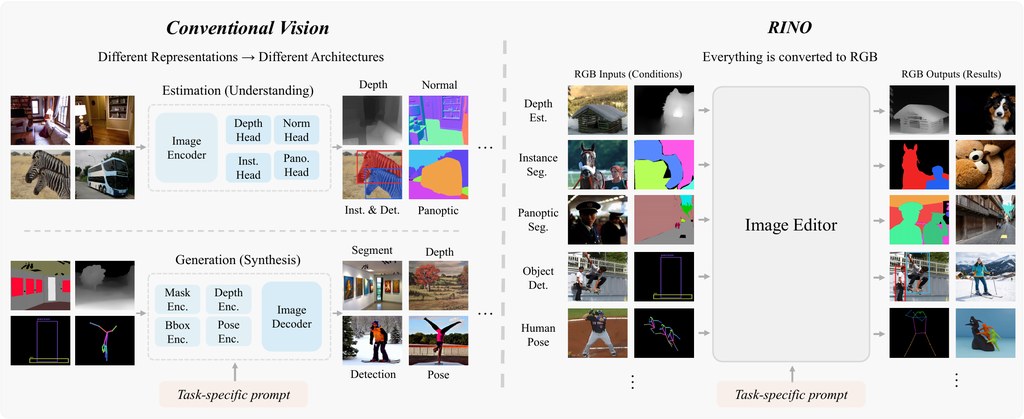
把深度、分割、姿態估計都改寫成 RGB 圖像輸入輸出,RINO 想驗證一個大膽方向:凍結式 image editor 能否直接兼任理解與生成。

RINO unifies vision under a single RGB interface: one frozen image editor, driven by a task-specific prompt, handles est

與其為每個視覺任務各自接駁 head、decoder 或 adapter,RINO 選擇更激進的路線:全部改寫成 RGB In, RGB Out。它屬於一個以 PyTorch 實作的研究型評測與實驗項目,核心問題是檢查單一凍結式 image editor,能否同時處理視覺理解與條件生成,而毋須為深度、segmentation、pose 之類任務另建模組。

這個定位帶來的吸引力很直接:流程統一、介面統一、後端也能互換。項目目前接上三個開源 image-edit 模型作為黑盒後端,包括 Qwen-Image-Edit、FireRed-Image-Edit 與 LongCat-Image-Edit;任務目錄結構一致,每個 task 都有獨立 evaluate 程式與 output 結果,方便逐項跑 benchmark,比起各任務各寫一套推理邏輯,整理與比較都省事得多。

但它的取捨同樣明顯。RINO 並沒有訓練新模型,也不做 fine-tuning,而是堅持用 released weights 直接測 zero-shot 表現;好處是比較乾淨,較能反映 image editor 本身的泛化能力,限制則是上限會被原生編輯模型綁住,對結構化輸出是否穩定、是否容易受 prompt 與渲染方式影響,仍要按任務逐個看。

  • 重點不是追求單一任務最佳成績,而是測試「同一個 RGB 介面」能否橫跨多類視覺工作
  • 三個後端可互換:Qwen-Image-Edit、FireRed-Image-Edit、LongCat-Image-Edit
  • 採用 copied official metric code 評分,數字理論上較容易與既有文獻對齊
  • 部署理解不複雜:安裝依賴後,按 task 準備 dataset,再選 BACKEND 與對應 MODEL 便可執行評測

較適合留意這個項目的,會是想研究 unified vision 介面、比較不同 image editor 泛化力,或者想把多個 benchmark 收攏到同一工作流的團隊。現有資訊未列出完整成績表,但它已清楚交代評測方法、資料夾規格與模型來源;作為研究驗證平台,價值在於提出一套可重覆比較的做法,而不是即刻取代每類任務的專用模型。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, Image, 影像處理, Python, Dataset 數據集

MuScriptor 把多樂器轉譜拉近可用水位

想把整首歌拆成可編輯的 MIDI,MuScriptor 提供一條比舊式轉譜工具更貼近真實錄音的路。它重點唔係只識單一樂器,而係處理混音後仍然保留多聲部。

MuScriptor logo

聽住一段完整歌曲,直接整理出可編輯的 MIDI,本來最易卡住嘅位係多樂器同時出現之後,音色、失真同重疊頻段會令轉譜結果迅速走樣。MuScriptor 針對嘅正正係呢種情況:它屬於開源音樂轉譜模型,目標係將真實世界嘅多樂器錄音轉成符號化樂譜,而唔係只喺單一樂器或合成資料上做得好睇。

舊一代 Automatic Music Transcription 往往依賴大量 synthetic training data,代表性做法如 MT3,喺合成測試集成績可以唔錯,但一落到真實混音音樂就容易失準。MuScriptor 嘗試修正呢個範式,先分析 synthetic data pre-training 嘅作用,再結合真實音訊 fine-tuning,同時加入 reinforcement learning 做 post-training,重點唔係追求實驗室式乾淨訊號,而係提升跨曲風、多樂器錄音嘅泛化能力。

對一般創作者、編曲人、音樂研究者同需要把歌曲快速轉成 MIDI 工作流嘅團隊來講,呢個項目吸引力幾直接。它提供 web UI 同 CLI 兩種方式,本地可先用 uvx muscriptor serve 背後嘅介面理解效果,亦可以用命令列批次處理;首次執行前要有 HuggingFace 帳戶並接受模型授權,權重會下載後快取,本地網頁服務預設只開喺 127.0.0.1,改成 --host 0.0.0.0 就可以喺區域網路存取。

  • 已公開 small、medium、large 三個模型,分別為 103M、307M、1.4B 參數
  • small 較適合 CPU-only 環境,medium 係預設速度與準確度平衡,large 追求更高準確率但更重
  • 模型架構採用 transformer decoder only
  • 支援 instrument presence conditioning,用來控制轉譜時聚焦邊類樂器
  • 播放功能唔係單純示意,而係透過完整 SoundFont synthesizer SpessaSynth 回播

限制亦寫得算坦白:權重受 CC BY-NC 4.0 約束;Intel Mac 要留意 PyTorch 同 Python 版本配搭。現有資料指出它訓練用到 170k 首歌,涵蓋 classical music 到 heavy metal,定位上明顯比只靠小量真實資料、再用大批合成音訊補足嘅方法更著重真實混音可用性。對需要高質多樂器 AMT 嘅人,MuScriptor 目前最值得留意嘅,係它唔再只展示「可以轉譜」,而係開始處理「轉出嚟能否進入後續編曲或分析」呢個關鍵差距。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Mac, Python, 音樂, Dataset 數據集

[技術文章] Xiaomi-Robotics-U0 小米用世界模型打通機械人

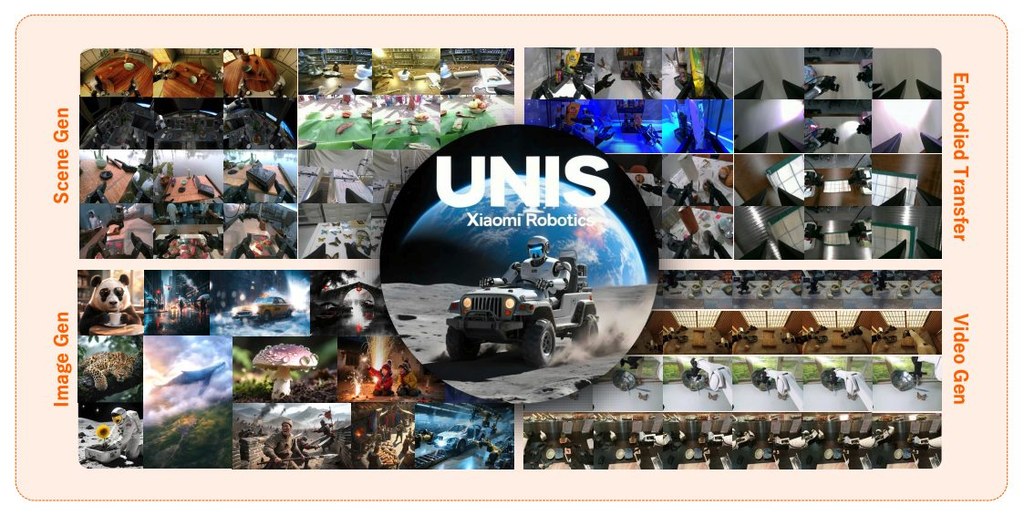
同一個模型兼顧場景生成、影像編輯同機械人操作資料合成,重點唔只係畫面靚,而係多視角一致同可直接餵去訓練策略。

smileybones small

當世界模型式的影像與影片生成能力要落到機械人場景,難題唔止係出圖或出片,而係同一個場景喺多個視角下都要合理,物件幾何要一致,仲要符合唔同 robot embodiment 嘅操作限制。

Xiaomi-Robotics-U0 屬於 world foundation model 路線,針對的正是這類 embodied synthesis 工作:一邊保留大型 image and video generation model 已學到的視覺知識,一邊補上機械人資料需要的可控性與一致性。

常見做法通常係用有限的機械人資料去微調 foundation model,但作者認為呢種範式容易犧牲大規模預訓練帶來的泛化能力。Xiaomi-Robotics-U0 改用 unified embodied synthesis 設計,把 text-to-image generation、image editing、embodied scene generation、embodied transfer 同 embodied video generation 放入同一個 38-billion-parameter multimodal autoregressive model 聯合優化,將 embodied generation 視為 foundation image and video generation 的延伸,而唔係另一條割裂的任務線。
呢個項目最有用的地方,在於它不只生成好看的資料,而是生成可拿來支援機械人學習的資料。文中提到它首次支援跨多種 robot embodiments 的高品質 multi-view scene generation,亦加入 structured、controllable embodied transfer,做細緻編輯時仍可保留 multi-view consistency 同 interaction dynamics,對要做模擬資料擴增、場景改寫、操作軌跡配套生成的工作流幫助較大。

  • 聯合處理多種任務,減少每個場景各自做模型適配的割裂流程
  • 核心差異在於保住 pre-trained world foundation model 的泛化,同時加入 embodied constraints
  • 支援 multi-view scene generation 與 embodied transfer,重點放在幾何一致性與互動連貫性
  • 生成結果可作為 scalable data engine,服務後續 policy training

效能上,Xiaomi-Robotics-U0 在 single-step 與 sequential generation 任務都做到 state-of-the-art,human evaluations 中於 embodied scene generation 同 transfer 超過 GPT-Image-2.0,embodied video generation 在 World Arena 排名第一。更實際的指標來自真實操作任務:它把 π 0.5 \pi_{0.5} 在 out-of-distribution 情況下的 success rate 由 36.9% 提升到 63.2%,說明這類 world model 不只是內容生成工具,亦開始成為 embodied intelligence 的資料引擎。

文中亦提到完整流程涵蓋 dataset curation、unified annotation pipeline、single-step training、sequential training,以及配合 FlashAR 與 vLLM Integration 的 inference 設計。整體訊息很清楚:作者想證明 foundation world models 可以同時扮演 embodied world models 與合成資料基建,讓機械人訓練不再只依賴昂貴而稀缺的真人示範。

Paper

Categories: 模型, 多模態模型, 視頻模型, 世界模型, 模型訓練, Video, Image, 影像模型, txt2img, Robotic, 軟件, Dataset 數據集, 小米-Xiaomi

Page 32 of 59
1 … 30 31 32 33 34 … 59