S2L-PO 用小模型帶動大模型推理訓練

清華與港校團隊提出 S2L-PO,改用小模型提供多樣推理路徑,補足 GRPO 易收斂過快的問題。

S2L-PO method overview

這個項目來自跨校團隊,作者包括 Yiming Ren、Yiran Xu、Zicheng Lin 等人,通訊作者是 Yu Qiao 與 Ruihang Chu;所屬機構包括清華大學、上海人工智慧實驗室、香港中文大學及香港城市大學。以研究背景看,團隊明顯集中在大型語言模型訓練、推理強化學習與數學評測。

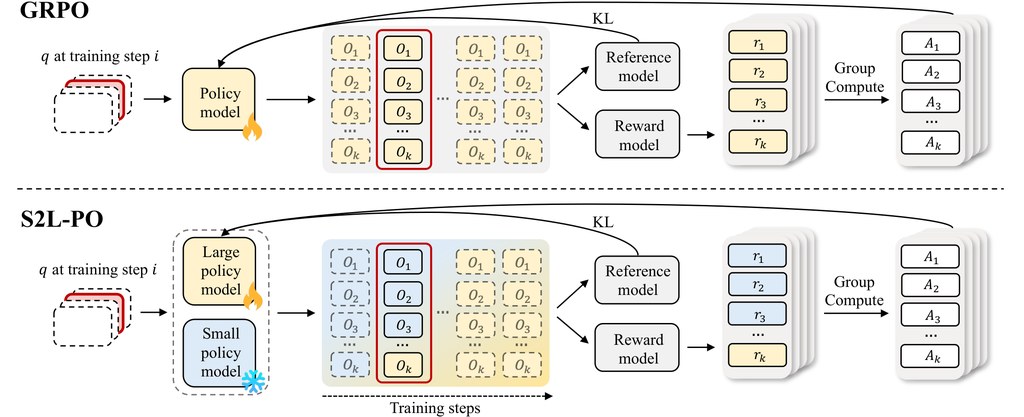
這是一個針對 Group Relative Policy Optimization(GRPO)訓練流程的研究型框架,目的是提升大型語言模型在推理任務上的 rollout diversity。現有做法多數靠提高 temperature,從 token-level randomness 增加變化,但論文指出這種固定範式容易在長推理鏈累積噪音,令軌跡變得不連貫。

S2L-PO(Small-to-Large Policy Optimization)換了一個角度:不用同一個大模型不停抽樣,而是找同家族的較小模型做 explorer,先產生一部分 qualitatively different reasoning trajectories,再讓大模型用混合 rollout 依照標準 GRPO 訓練。之後再用 progressive annealing,逐步由 small-model exploration 過渡到 fully on-policy learning,避免中途被小模型能力上限拖慢。

論文提供的結果頗有說服力。以 Qwen3-8B learner 配 1.7B explorer 為例,AIME24 Pass@1 由 15.0 提升到 23.8,AIME25 Pass@1 由 12.1 提升到 22.5;Qwen3-14B learner 配 4B explorer 亦比基線 GRPO 高。作者同時聲稱 rollout compute 還可降低,這點對訓練成本敏感的團隊尤其有吸引力。

如果你想測試這個項目,較合理的方式不是當作即裝即用工具,而是把它視為一個訓練策略參考:先看論文與公開模型設定,再比較自己手上的 GRPO 流程是否同樣受 rollout 同質化影響。硬件門檻不算低,資料列出 8B 模型約需 20 GB GPU 記憶體、14B 模型約需 32 GB,較適合研究人員、模型訓練工程師,或正在做數學推理微調的團隊。

  • 核心判斷:這是模型訓練框架,不是一般聊天應用,重點在改善 GRPO 的探索品質
  • 方法差異:由 token-level randomness 轉向 policy-level diversity,減少長鏈推理失真
  • 主要創新:用較小同家族模型充當 natural explorers,再以 progressive annealing 收回大模型主導權
  • 已列相關模型:Qwen3-1.7B、Qwen3-4B、Qwen3-8B、Qwen3-14B
  • 適合場景:數學推理、可驗證獎勵訓練、想提升 RLVR 與 GRPO 收斂效率的項目
GitHub: https://github.com/qishisuren123/S2L-PO

Paper: https://arxiv.org/pdf/2605.30789

Categories: 開源, 香港中文大學, 香港城市大學, 清華大學, 上海人工智慧實驗室, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 框架, 香港, 工具, Python, 深度學習

[技術文章] KAIST 與 Qualcomm 重塑長影片 RAG 評測

這項研究先由 KAIST 與 Qualcomm AI Research 團隊提出新基準,再用新方法改善長影片 RAG 檢索。重點在於拆開評測檢索與生成,找出真正有效的證據片段。

Hero image preview

這項研究由 KAISTQualcomm AI Research、Qualcomm Korea 團隊合作提出,聚焦長時間第一身影片中的 Retrieval-augmented generation(RAG)。作者指出,現有 VideoRAG 常沿用「每條查詢只配一種 modality 與一種 temporal granularity」的固定範式,但長影片的證據片段差異很大,單一設定未必適合全部片段;加上不少既有 benchmark 的問題甚至不用看影片也能答中,令最終分數難以反映檢索是否真的做對。

因此,團隊提出 V-RAGBench,把資料整理成 ⟨query, evidence chunk, answer⟩ triplets,明確分開查詢、證據片段與答案。這種設計針對的是過去「只看最終回答正確率」的盲點,讓研究者可以更忠實地分開檢查 retrieval 與 generation,知道系統究竟是靠對的影片片段,還是靠語言偏見、常識或靜態線索作答。

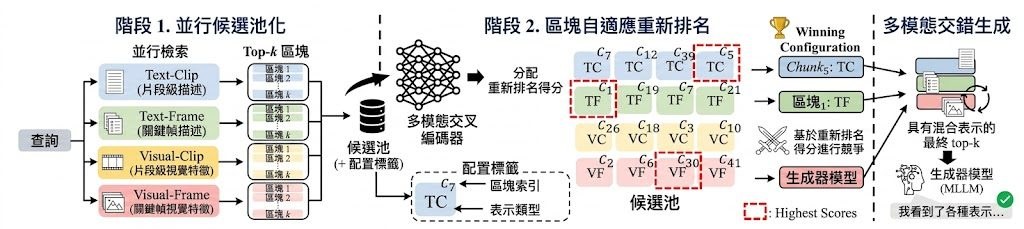
方法上,作者再提出 CARVE。它不是替整條查詢預先選定一種設定,而是讓多個 retriever 以不同 modality 與 granularity 並行工作,再用 chunk-adaptive reranking 為每個 evidence chunk 挑出最合適的 winning configuration。之後,這些片段會連同各自勝出的設定一併送入 generator,形成 interleaved evidence,令檢索階段的片段級決策延續到生成階段。

對想使用這個項目的人來說,切入點很清楚:先用 V-RAGBench 測試自己的 VideoRAG 流程,分開看檢索與生成表現;若系統目前仍採用查詢級單一設定,可再比較 CARVE 這種片段級配置方式。這種思路較適合長影片問答、egocentric video 分析,以及需要從多模態證據中找出正確時間片段的 Agentic 系統。

  • V-RAGBench 以 evidence chunk 為核心,補足舊 benchmark 無法準確檢查檢索對錯的問題
  • CARVE 改為片段級選擇 configuration,不再假設一條查詢只需一套 modality/granularity
  • 作者指出 generator 最後接收的 chunks 會交錯來自多種 configuration,這是 query-level 方法做不到的
  • 論文稱 CARVE 勝過 8 個近期 VideoRAG baselines,顯示片段級決策在長影片檢索更有優勢

整體來看,這項工作不是單純再加一個 VideoRAG 方法,而是先批評舊有評測與建模範式,再用新 benchmark 和新 retrieval framing 一起修正問題。如果你關心的是長影片 RAG 到底應該取回什麼、以及取回後怎樣交給模型使用,這項研究提供了相當清晰的分析框架。

Paper: https://arxiv.org/pdf/2606.13141

Categories: Agentic, AI productions, RAG, 模型, 多模態模型, Video, 框架, 新聞, Dataset 數據集

MBench 專看長影片世界模型記憶力

MBench不是看單幀靚唔靚,而是追問模型能否記住離鏡後再出現的人與場景。它把長影片記憶拆成三條能力軸,令評測更貼近生成連續影片的難題。

Teaser

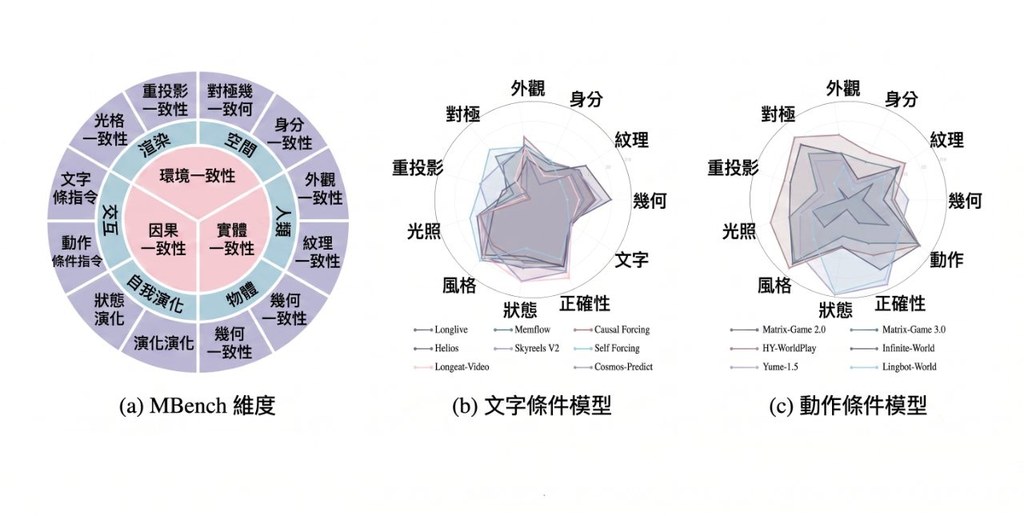
現時不少長影片評測,仍偏向單幀畫質或短距離 prompt following;畫面一旦切走、角色離鏡,很多模型便容易在回到同一情境時「失憶」。MBench 這個benchmark正是針對這個盲點而設,聚焦 long-video world models 的 memory capability,檢查模型能否在時間拉長後維持一致的世界狀態。

作者把問題拆成三個互相獨立但又彼此關連的方向:Entity Consistency、Environment Consistency、Causal Consistency。這種設計比籠統地給一個總分更有分析價值,因為你能看清模型究竟是忘記角色外觀、搞亂場景空間,還是未能延續畫面外仍在發生的物理過程;同時它再分成 MBench-A 與 MBench-T,分別對應 action-conditioned world models 與 text-segment-conditioned 長影片續寫模型。

如果你本身有影片生成或世界模型項目,這個儲存庫的用途很明確:先準備模型輸出,再用 mbench 這套 contract-driven、plugin-based CLI 跑完整評測流程。儲存庫已提供 12 個官方 metric implementation,亦整合 VLM trigger judge,代表它不只是論文概念,而是一套可落地比較不同模型表現的評測工具鏈。

  • 項目類型:這是一個 benchmark/評測工具鏈,用來量度長影片世界模型是否具備穩定記憶與時序一致性。
  • 創新位置:不是只看畫面質素,而是把「長時間記住世界」正式定義成三條 capability axes。
  • 適合場景:長影片生成、world model 研究、模型比較、內部驗證新版本退步與否。
  • 可讀性高:MBench-A 與 MBench-T 將不同條件設定分開,較容易知道模型失分原因。

從評論角度看,MBench 的價值在於它批評了舊有固定範式:只獎勵 single-frame quality 或 short-horizon prompt following,卻未有檢驗跨鏡頭、跨時間的持續記憶。若你關心的模型包括各類 long-video world models、action-conditioned world models,以及 text continuation 類影片模型,這個項目很值得納入測試流程;不過目前提供的資料以 benchmark 與評測框架為主,是否能全面代表所有真實創作場景,仍要配合你自己的生成任務一併觀察。

GitHub: https://github.com/study-overflow/MBench

Paper: https://arxiv.org/pdf/2606.00793

Categories: 開源, 清華大學, 模型, 視頻模型, 世界模型, Video, 框架, 工具, , Win

OmniVideo-100K:增強影音推理訓練數據集

這是一個面向音訊與影片聯合理解的數據集項目,重點不在片段標註,而在較完整的跨模態推理。它更像是幫模型補課的訓練材料庫。

Framework Overview

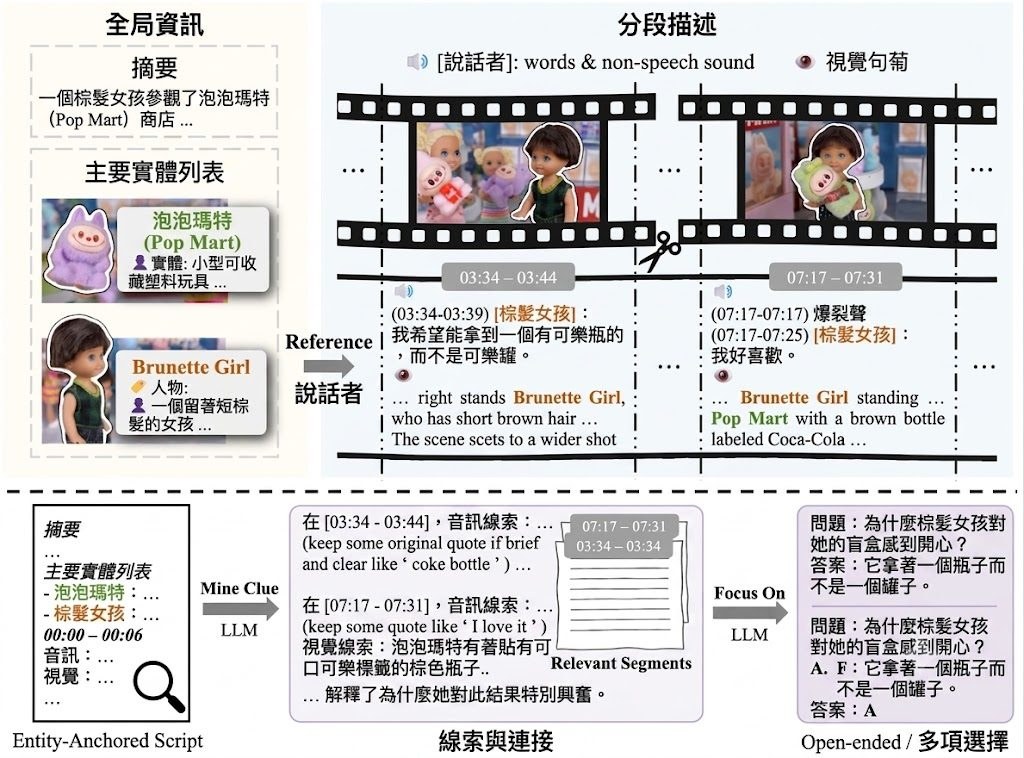
現時不少影音問答資料建立流程,普遍沿用「video-caption-QA」範式:先把影片切成短片段,再分開寫視覺與音訊描述,最後生成 QA。論文作者認為這種做法容易出現 modality bias、temporal misalignment,同一角色在不同片段亦可能描述不一致,令問題多數只圍繞局部事件,難以考驗長時間跨度的 audio-visual reasoning。

OmniVideo-100K 是一個 Dataset 數據集,目標是為 Multimodal Large Language Models (MLLMs) 提供較完整的影音推理訓練材料。它提出兩個核心機制:Entity-Anchored Video Scripting 先把原始影片整理成結構化 script,包括摘要、主要實體清單,以及帶時間戳的分段音畫描述;Clue-Guided QA Generation 則先抽取跨片段、跨模態線索,再生成較複雜的問答。

這種設計的關鍵,不在於題目數量大,而在於先整理證據鏈再出題。對比舊方法把長文本理解和 QA 合併成一步,OmniVideo-100K 把線索挖掘獨立出來,較有機會產生涉及因果、未來預測與假設推理的題目,而不只是問畫面中「見到乜」。

如果你想測試這個項目,可以先留意 Hugging Face 上的 OmniVideo-100K 與人手驗證的 OmniVideo-Test,看看資料結構是否適合自己的訓練流程;做研究的人則可直接比較模型在外部 benchmark 的變化。論文提到,VITA-1.5、Qwen2.5-Omni-7B、Qwen3-Omni-30B 經此資料集微調後,在 OmniVideo-Test 最多提升 20.59%,在 Daily-Omni、JointAVBench 也有最多 12.64% 增幅,同時盡量保留在 Video-MME 這類一般影片 benchmark 的能力。

  • 針對舊式「video-caption-QA」流程的三個痛點:modality bias、temporal misalignment、敘事不連貫
  • 用 structured scripts 加 entity list,補回跨片段指代一致性與聲音來源對應
  • 任務覆蓋 10 類,包括 FGP、STD、CU、CP、SA、ESO、SM、CR、FP、HR
  • 適合做影音理解、跨模態推理、指令微調資料研究的人參考
  • 相關模型包括 VITA-1.5、Qwen2.5-Omni-7B、Qwen3-Omni-30B

整體來看,這個項目的價值在於它不只新增一批資料,而是重寫影音 QA 資料的組織方法。若你關心的不是單張畫面問答,而是影片內角色、聲音、事件先後與推論之間的連結,OmniVideo-100K 會比一般自動合成資料集更有研究參考價值。

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, Qwen, Video, Audio, 工具, , 語音, Dataset 數據集

OmniDirector:免配對數據的多鏡頭運鏡克隆技術

OmniDirector 透過「相機網格」表示法,從多鏡頭影片中克隆運鏡動作,驅動靜態圖像生成動態影片,無需交叉配對數據訓練。

Play video

OmniDirector 由清華大學(Yu-Shen Liu 為北京清華大學團隊)與 Kling Team(快手科技)的研究團隊,共同開發,成員包括 Jiwen Liu、Shujuan Li、Zhixue Fang 等人,團隊來自多個機構,橫跨學術界與業界。研究團隊提出一種無需交叉配對數據的通用多鏡頭相機克隆方法,解決從參考影片中複製運鏡來驅動靜態圖像的難題。

傳統相機控制方法往往依賴大量成對數據進行訓練,而 OmniDirector 的核心創新在於提出「相機網格」(camera grid)表示法。將參考影片的相機姿態渲染為三維空間中的運動軌跡,形成統一的網格表示。配合階層式提示詞擴展代理(hierarchical prompt expansion agent),把多模態控制信號整合成協調的指令。

使用時,使用者只需提供一張源圖像和一段參考影片,OmniDirector 便能克隆其中的運鏡動作,生成動態影片。多鏡頭場景下,新方法支援鏡頭之間的連貫過渡與一致的內容呈現,保持原始的視覺語言。特殊運鏡方面,涵蓋希區柯克式變焦、子彈時間與鏡頭畸變效果,適用的場景類型包括人像、動物、建築及 AIGC 內容等。

OmniDirector: General Multi-Shot Camera Cloning without Cross-Paired Data

OmniDirector 適合從事影片創作、動畫製作或需要快速生成動態素材的內容創作者,以及研究相機控制技術的開發者。經過與其他頂尖相機控制方法的對比,新方法在控制穩定性與物件形變方面表現出色。

重點摘要
– 核心創新為「相機網格」表示法,免依賴交叉配對數據
– 支援極端運鏡、多鏡頭連貫過渡與特殊相機效果
– 場景泛化能力強,涵蓋人像、動物、建築及 AIGC 內容
– 開源提供論文與程式碼,方便研究與應用

目前 github.com/lisj575/OmniDirector 這個倉庫是空的,沒有 source code 或 model 。

項目: https://ymlinfeng.github.io/OmniDirector.github.io/

Categories: 北京大學, 清華大學, AI productions, 數字人, 模型, 視覺模型, Video, 框架

Orchestra-o1:多智能體協作框架拆解複雜多模態任務

由香港中文大學等團隊研發的 Orchestra-o1 採用 MainAgent + SubAgent 架構,在 OmniGAIA 基準上以 72.8% 準確率領先對手 10.3 個百分點。

Orchestra-o1 Framework

Orchestra-o1 由香港中文大學(CUHK)計算機科學與工程學系的 Fan Zhang 領銜,聯同北京大學、清華大學、同濟大學及 LIGHTSPEED 團隊共同開發。模型權重同步開源於 Hugging Face。

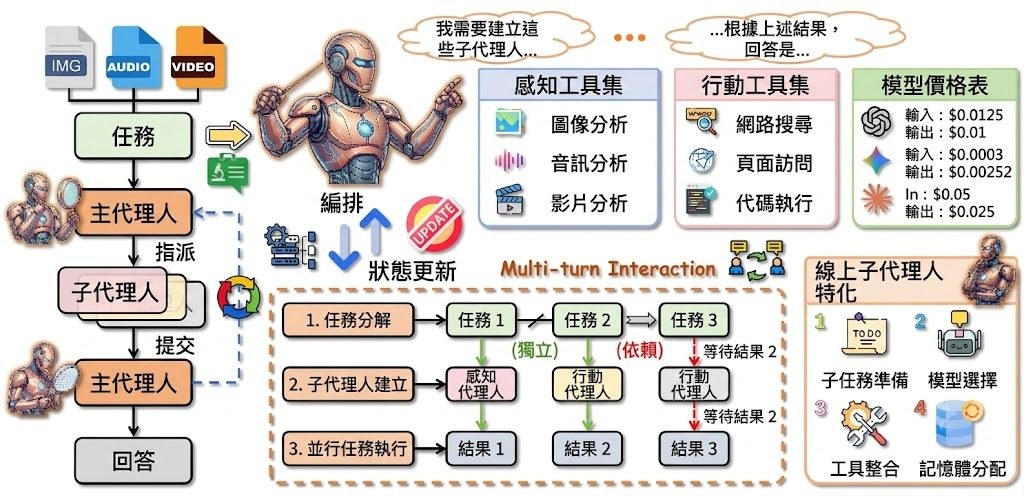
這個項目的定位是多智能體協作框架,針對文字、圖像、音訊、影片並存的「全模態」(omnimodal)場景,自動把複雜任務拆解成多個子任務,再分配給專責的 SubAgent 執行。MainAgent 負責規劃與協調,SubAgent 則配備搜尋、執行程式碼、影音分析等工具獨立運作,獨立子任務可同步執行以提升效率。

重點摘要:

  • 層級式架構:MainAgent 統籌拆解任務,SubAgent 各司其職,避免單一模型疲於應付多模態輸入。
  • 平行執行:無依賴的子任務同步進行,加快整體處理速度。
  • DA-GRPO 訓練法:以 Qwen3-8B 為基礎,搭配 Decision-Aligned Group Relative Policy Optimization 與 LLM-as-judge 獎勵機制微調。
  • OmniGAIA 表現:在 OmniGAIA 基準測試取得 72.8% 準確率,領先第二名 10.3 個百分點。
  • 開源生態:基於 Python 3.10+ 與 verl 框架,訓練需 8 張 H20 (96GB) GPU 單節點。

Orchestra-o1 的創新在於把「模態感知拆解」與「線上子智能體特化」結合,讓多模態協調不再依賴線性流程。適合需要處理多媒體資訊的研究團隊、Agent 開發者,以及關注 Computer-use agents(CUAs)與多模態模型應用的工程師。

效能方面,作者將 Orchestra-o1-8B 定位為同類開源全模態代理中最先進(SOTA),同時在商用模型(例如 GPT-5)推理腳本中亦提供整合,方便研究人員比較開源與閉源路線的差距。

GitHub: https://github.com/zfkarl/Orchestra-o1

Paper: https://arxiv.org/pdf/2606.13707

Categories: 開源, 香港中文大學, Agentic, 模型, 框架, OpenClaw, 深度學習

[技術文章] 從聊天機械人到數碼同事:AI 怎樣學會「持續工作」

一篇文章帶你了解 AI 從只懂回答問題,進化到能像同事般持續完成任務的關鍵轉變。

Hero image preview

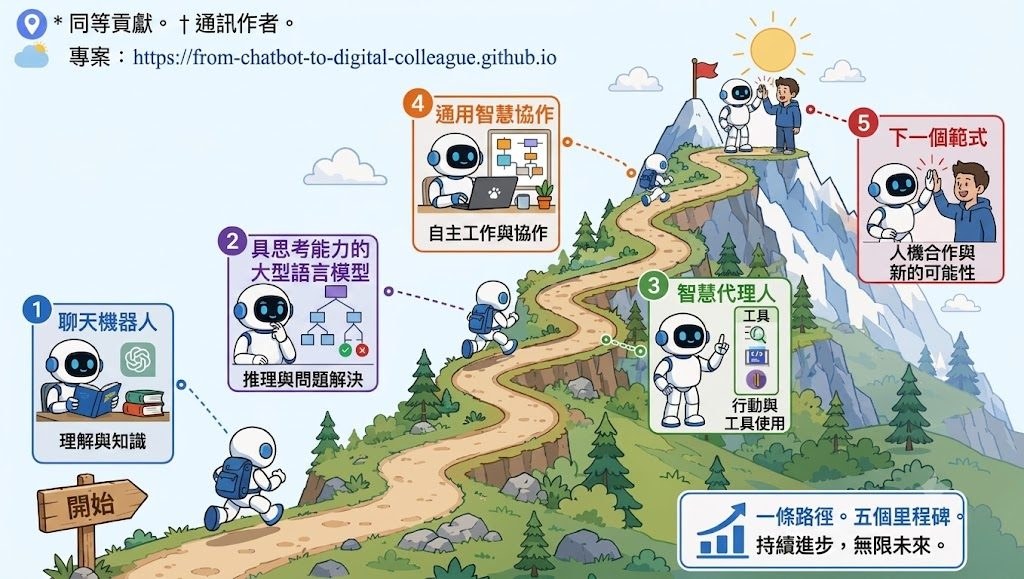
這項文章由騰訊優圖實驗室、清華大學、中山大學、中南大學及伊利諾大學芝加哥分校的研究團隊共同撰寫,提出一個核心觀點:大語言模型(Large Language Models, LLMs)正從「聊天機械人」邁向「數碼同事」,關鍵差異在於能否持續完成工作,而非只給出對話式回應。

團隊將這個轉變拆成兩個互相牽引的維度。第一個是「認知核心」的進化:LLMs 從依賴下一個詞預測的「快思維」,走向會運用推理時間計算、長思維鏈(Chain-of-Thought)、反思及強化學習的「思考型 LLM」,讓推理過程更謹慎可靠。第二個是「工具輔助任務執行」的進化:從臨時呼叫外部工具的 Agent,走向類似 OpenClaw 風格的工作站系統,配備持久化的工作區(Workspace)、可重用的技能(Skill)、驗證迴圈及治理機制。

文章特別強調「Workspace + Skill」這個範式是關鍵躍升。它讓原本零散的工具操作,變成像同事般有狀態記憶、可重用流程、能完成任務並累積經驗的工作模式。數據結構也從簡單的指令—回應配對,演進為「狀態—動作—觀察」的軌跡記錄;評估方式則從靜態基準測試,轉向沙盒化、可審計、能自我進化的 AI 生態系統。

這份內容適合關注 AI Agent 發展、想了解 LLM 下一代形態的研究者與產品設計者。讀者可透過項目網站(from-chatbot-to-digital-colleague.github.io)取得完整論文與相關資源。

重點摘要:
– 由騰訊優圖實驗室主導,聯同清華、中山、中南及 UIC 共同研究
– 提出從「聊天機械人」到「數碼同事」的範式轉移
– 認知層面:從快思維走向推理驅動的「思考型 LLM」
– 執行層面:從臨時工具呼叫走向持久化 Workspace + Skill 系統
– 評估方式同步轉向沙盒化、可審計的 AI 生態系統

Paper: https://arxiv.org/pdf/2606.14502

Categories: 開源, 清華大學, Agentic, 模型, 模型訓練, 框架

VISTA 準確提升 GUI grounding

VISTA 不是通用聊天模型,而是用來訓練 GUI grounding 的方法。它針對畫面定位學習訊號不足的問題,效果有明顯提升。

ScreenSpot-Pro accuracy curve

VISTA 是一個面向 GUI grounding 的訓練框架,核心目標是令模型更準確地在螢幕截圖中找出應該點擊的位置。它處理的不是一般文字理解,而是讓模型根據指令,在複雜介面上輸出座標,減少按錯按鈕、點錯輸入框這類問題。

這個項目的重點,在於它不是只從同一張截圖反覆抽樣,而是把同一個 GUI 畫面裁成多個仍保留目標元素的 view,再用這些 view 建立 GRPO 比較組。由於每個 crop 都會精確重映射座標,模型等於在語意相同、幾何位置不同的畫面上學習,能改善單一視角下「全部答錯」或「全部答中」而缺乏學習訊號的情況。

另一個關鍵設計是 self-verified cross-view anchor。它只會在目前 policy 已經產生 maximum-reward rollout 時,才加入 oracle coordinate,避免把訓練直接變成無條件模仿;這點對 GUI 座標生成尤其重要,因為短座標輸出很容易受微小偏差影響。從描述來看,這種做法比標準 GRPO 更重視穩定性,也更保留 reinforcement learning 的比較學習特性。

  • 這是一個訓練方法項目,不是最終應用程式,主要用來提升 GUI grounding 模型表現
  • 核心改動包括 view-consistent GRPO groups 與 self-verified cross-view anchor
  • 在 ScreenSpot-Pro 上,Qwen3-VL 4B/8B/30B-A3B 由 55.5/52.7/53.7 提升至 63.4/65.8/67.0
  • 以 Qwen3.5 初始化的 4B/9B/35B-A3B backbone,亦比 standard GRPO 再高 +2.0/+0.9/+1.2
  • 已公開相關模型包括 VISTA-4B、VISTA-9B

如果你本身有做 Computer-use agents(CUAs)、GUI 自動化、螢幕操作代理,這個項目特別值得留意。它較適合研究人員、模型工程師,或者正在調整 Qwen3-VL、Qwen3.5 視覺語言 backbone 的團隊;一般用家未必會直接部署這個項目,但可以把它視為提升介面定位能力的一套訓練方案。

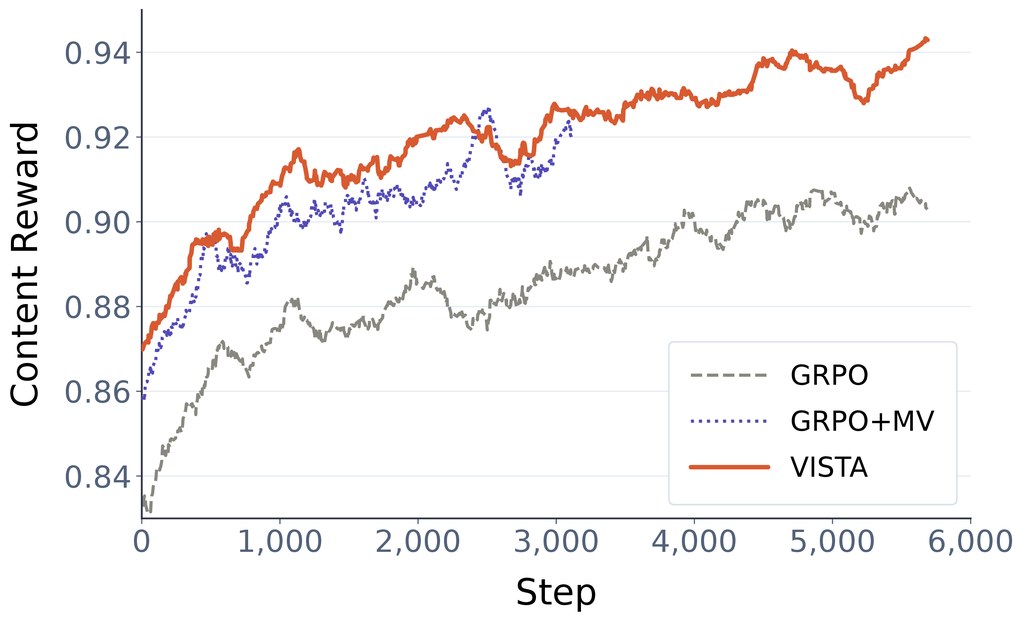
就公開資料看,VISTA 的說服力主要來自基準分數與訓練動態變化:content reward、更高的 informative group ratio,以及 ScreenSpot-Pro 準確度同步上升。再加上論文提到五個 GUI-grounding benchmarks、較高 worst-view accuracy 和較低 prediction flip rates,整體判斷是:這個項目不是靠包裝取勝,而是針對 GUI grounding 訓練訊號退化問題,提出了相當對症的改法。

GitHub: https://github.com/ZJUSCL/VISTA

Paper: https://arxiv.org/pdf/2606.14579

Categories: 開源, 模型, 模型訓練, 框架


SpatialClaw:用程式碼推動空間推理代理

SpatialClaw把程式碼變成代理的動作介面,主攻複雜空間推理。它在20個基準上交出明顯領先的平均成績。

SpatialClaw logo

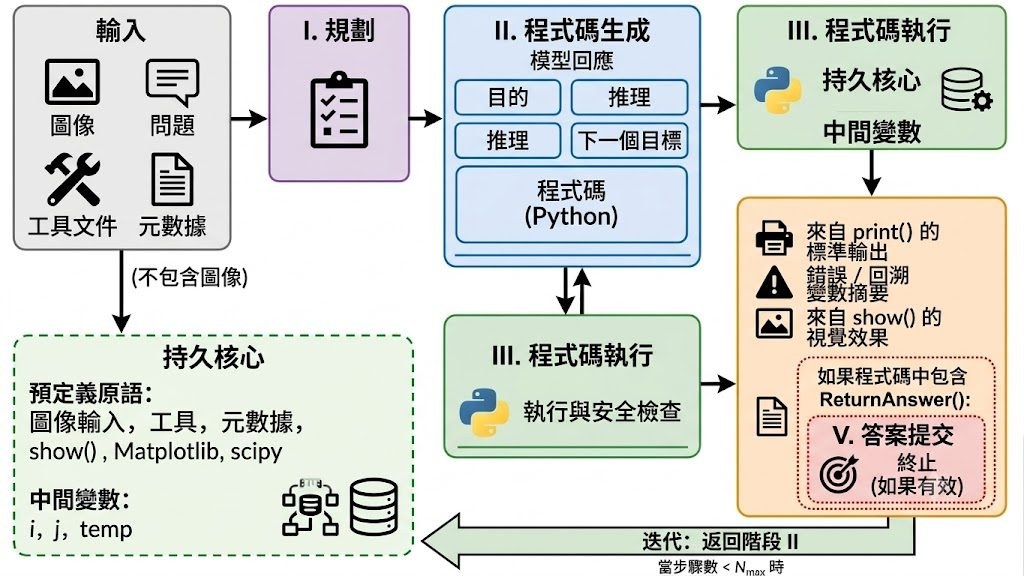
SpatialClaw 是一個免訓練的空間推理框架,重點不是再加更多工具,而是改寫代理如何調用工具。它把程式碼當成動作介面,讓 Vision-Language Model 代理逐步寫入 Python cell,在同一個持續運行的 Jupyter kernel 內查看中間結果、再調整下一步判斷,目標是處理 3D、4D 以及影片場景中的空間理解問題。

這個項目的新意,在於它避開單次執行整段程式或僵硬的 tool-call 方式。代理每次只提交一格程式,能結合 SAM3 segmentation、Depth-Anything-3 reconstruction、geometry utilities,以及 NumPy、SciPy、Matplotlib 這類科學運算庫,分析過程更像逐步查證,而不是一次過猜答案。

如果你想測試它,較合適的做法是用多視角圖片、影片片段,或需要判斷位置、距離、遮擋、移動關係的題目來跑。文件亦提到部署模型有明確硬件要求:FP8 版本需要 Linux 與 NVIDIA Hopper(H100)或更新 GPU;若手上是 A100 或 L40S,則可改用 models.json 內列出的 AWQ 或 GPTQ Int4 條目,並沿用相同 served_name,模型設定毋須重改。這也反映 NVIDIA 近年在 Robotic 與 World Model 相關項目上的投入相當積極。

成績方面,公開資料指出它在 20 個空間推理基準取得 59.9% 平均準確率,比先前最佳空間代理高 11.2 個百分點。更重要的是,這個結果據稱在相同 system prompt、工具組合與 hyperparameters 下完成,覆蓋六個 VLM 骨幹,代表它的提升未必只靠特定 benchmark 微調。

  • 屬於空間推理代理框架,解決 VLM 在 3D/4D 關係判斷上不夠靈活的問題
  • 核心方法是以程式碼作為動作介面,逐步執行與修正分析
  • 支援的感知模組包括 SAM3 segmentationDepth-Anything-3 reconstruction 與 geometry utilities
  • 公開結果涵蓋 20 個 benchmarks,平均準確率為 59.9%
  • 相關模型家族包括 Qwen3.5、Qwen3.6、Gemma4,規模由 26B 至 397B

這個項目特別適合研究 Computer-use agents、空間智能、機械人感知,或者想比較 tool-augmented agent 與 VLM 推理流程的人。若你關心的不是聊天表現,而是模型能否一步步觀察畫面、調工具、修正推論,SpatialClaw 展示了一條幾有說服力的路線。

GitHub: https://github.com/NVlabs/SpatialClaw

項目: https://spatialclaw.github.io/

Categories: 開源, Agentic, 模型, 視覺模型, NVIDIA

Page 22 of 37
1 20 21 22 23 24 37