KaiNinja 將 3D 生成推到部件級 – 直接拆零件

一張圖就能生成分件可拆的 3D 模型,毋須人手標註或語義分割。KaiNinja 用兩個 O-Voxel 體素保留部件接觸面,把原生 3D 生成器延伸到部件級。

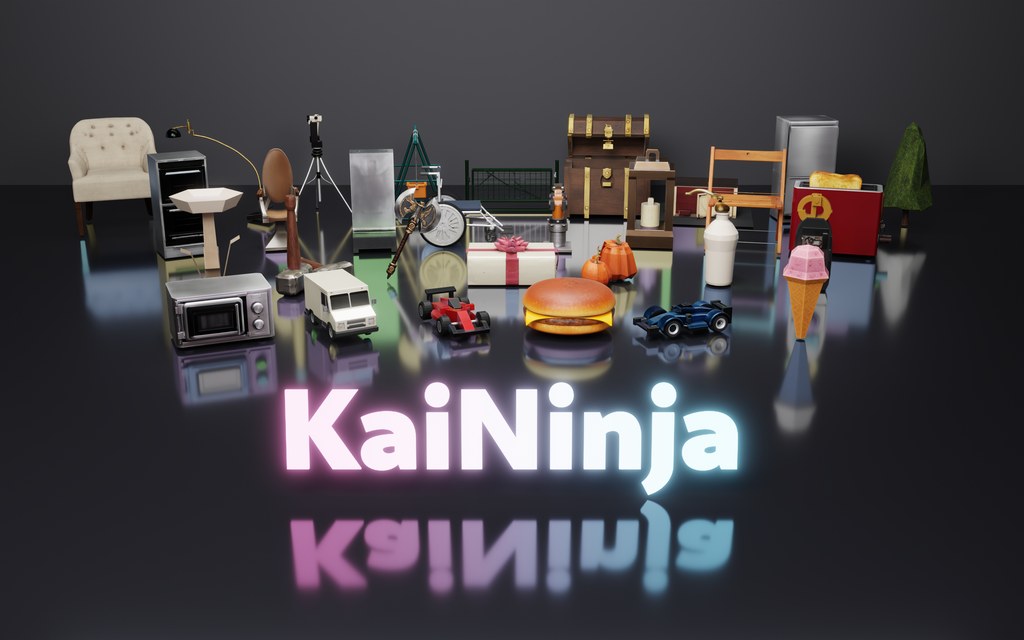
KaiNinja teaser

以往想做一張椅子、可以分開拆件再重新組裝的 3D 模型,往往要事先畫遮罩或跑一套語義分割網絡,既費時又限制後續編輯彈性。KaiNinja 由 Alaya Lab 團隊提出,目標是把 TRELLIS.2 這類原生 3D 生成器直接延伸成「部件級」輸出,毋須遮罩或分割網絡就能從單張圖生成可拆分的部件網格。

模型輸出兩個 O-Voxel 體素,各自解碼後透過連通區分量化成獨立部件,同時保留部件之間的接觸面,避免拆件後出現破洞或懸空。換言之,它在現有 3D 生成流程中替代或補強的,就是那一步手動標註與分割。

對遊戲美術、3D 資產設計、以及需要快速做可編輯原型的團隊來說,這類即拆即改的部件輸出明顯降低後製成本。雖然目前只釋出技術報告與項目頁面,推斷碼與預訓練權重尚未開源,但官方展示的下游材質替換與手繪動畫片段,已能看出部件分離對後續工序的實質幫助。

官方在 986 個物件的評測中,以匈牙利配對方式同時報告整體與部件級指標,在 CD、F1、mIoU 七個項目上均領先 X-Part、OmniPart、PartPacker、AutoPartGen 等同類方法,亦勝過用同一語料微調過的 TRELLIS.2。Fail 率(即整體 CD 大於 0.1 的比例)亦由 5.4% 降至 0.7%,代表部件拆分並沒有犧牲整體幾何質素。

重點摘要

  • 輸入單張圖片即可輸出部件級 3D 網格,免遮罩免分割網絡
  • 以兩個 O-Voxel 體素保留部件接觸面,避免拆件破洞
  • 在 986 件評測中,部件與整體指標同步領先 OmniPart、PartPacker、AutoPartGen
  • Fail 率由 TRELLIS.2 的 5.4% 降至 0.7%,整體幾何質素未受部件任務拖累
  • 目前僅有技術報告與項目頁面,源碼與權重標示為 Coming soon
項目主頁 · GitHub

Categories: 開源, 騰訊, AI productions, 模型, Image, 3D, 動畫

LLaDA-UI 首個開源擴散 GUI Agent 16.7B MoE 力壓 Qwen3-VL

Inclusion AI 把 block-wise 擴散語言模型搬進螢幕操作場景,推出約 16.7B 參數的 LLaDA-UI,在六個 GUI 基準上贏 Qwen2.5-VL-7B,部分項目更超越 Qwen3-VL-8B。

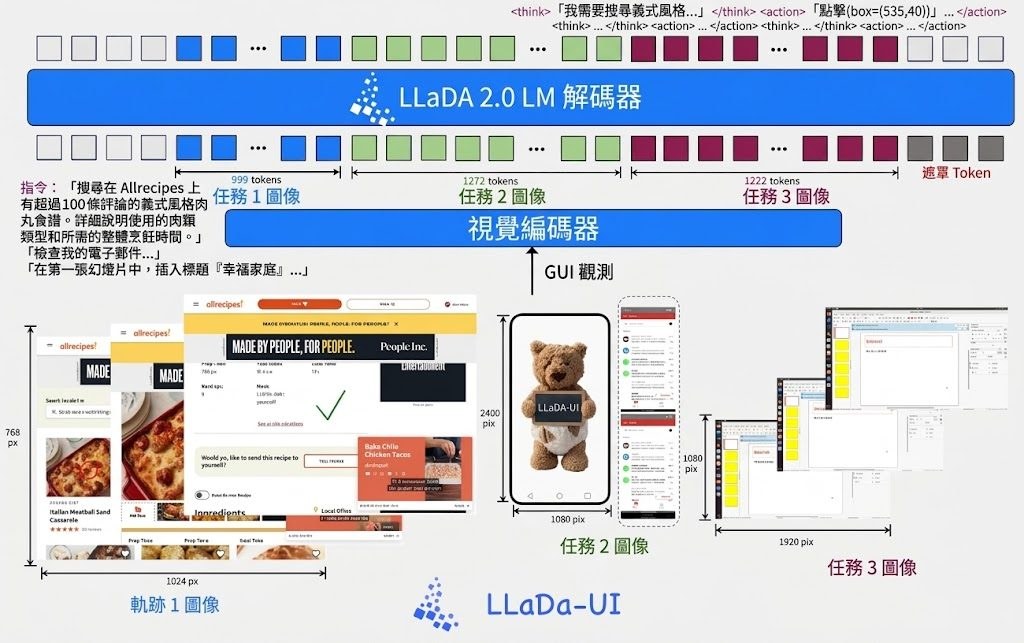
LLaDA-UI GUI-agent benchmark comparison and animated qualitative diffusion decoding

一般講 GUI Agent,都預設底層係自回歸 VLM;Inclusion AI 同螞蟻集團 Venus Team、西湖大學合作推出的 LLaDA-UI,偏偏選擇用 block-wise 擴散語言模型做骨幹,直接從遮罩 token 逐塊 denoise 出推理同動作,配合原生動態解像度視覺編碼器,覆蓋手機、桌面、網頁同 grounding 任務。模型全段約 16.7B 參數嘅 MoE 架構,訓練分兩階段,先做大規模多模態預訓練對齊 LLaDA2.0-mini-base,再做 GUI 監督微調。

喺 ScreenSpot-Pro、AndroidWorld、MobileWorld、WebVoyager 等六個基準上,LLaDA-UI 全部贏過 Qwen2.5-VL-7B,其中 ScreenSpot-Pro 52.9、AndroidWorld 53.5、WebVoyager 56.9,喺呢四項仲壓過 Qwen3-VL-8B;官方同時提到 API 速度最高有 8.95 倍 mean speedup。佢仲針對擴散解碼做咗一輪分析,包括動作合法性、軌跡長度、EOS 處理、denoising 步數同 block size 對表現嘅影響。

如果你做開手機或桌面自動化、需要 GUI Agent 處理長步驟任務又想避開自回歸延遲,LLaDA-UI 提供咗一套唔同嘅技術路線選擇;研究擴散語言模型落地嘅人,亦可以直接拎佢嘅 block-parallel 解碼行為做案例。

重點摘要

  • 約 16.7B 參數 MoE 擴散 GUI Agent,由 Inclusion AI、Ant Group Venus Team 與西湖大學共同發表
  • 骨幹為 LLaDA2.0-mini-base 配合 SigLIP 初始化嘅動態解像度 ViT
  • 六個 GUI 基準全部超越 Qwen2.5-VL-7B,ScreenSpot-Pro 等四項高過 Qwen3-VL-8B
  • 訓練涵蓋 100+ 中文與 70+ 英文手機 App,覆蓋 mobile、desktop、web、grounding
  • 附帶針對 block-wise 擴散解碼嘅分析,包括結構化動作有效性、EOS、denoising 步數等

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, UI/UX

PhysBrain 1.5 統一三項能力,機器人世界模型走進單一詞彙表

PhysBrain 1.5 把語言、動作軌跡、未來畫面全部折成離散詞元,用同一個自迴歸骨幹同時回答、理解與預測。它基於 Qwen3-VL 構建,2B 與 8B 兩個版本已開源。

DeepCybo · Zhongguancun Academy · Zhongguancun Institute of Artificial Intelligence

PhysBrain 1.5 把機器人的「看懂」、「出手」、「預測下一步畫面」三件事,塞進同一個自迴歸模型裡。對做具身智能的人而言,最直接的體感差異是:不用再為理解、動作、預測各掛一個任務頭(task-specific head),全部以離散詞元(discrete tokens)在同一個 next-token prediction 目標下聯合學習。等於讓模型在推理時,能在語句、空間輸出、末端執行器軌跡、未來 RGB 影像之間自由切換。

對比同類路線,許多開源具身模型要嘛只做視覺語言理解,要嘛只做動作生成;PhysBrain 1.5 則強調三者共享詞彙表(vocabulary),並透過 ActionPiece 詞元把不同機械臂、控制配置統一在一個動作碼本(codebook)下。預訓練以人類互動影片為主,監督微調混入真人示教、真機軌跡與模擬經驗,等於把世界模型與策略模型壓進同一副骨架。

2B 與 8B 的權重已上傳 Hugging Face,開發者可透過官方評測工具 PhysBrainEvalKit 對齊 28 個具身基準測試。PhysBrain 1.5-8B 整體得分 72.5,在 14 個基準上排開源第一、10 個排第二。對機器人團隊或在做 VLA、世界模型研究的人,這套統一詞表的做法,是現時少數能把三者一齊端出來的開源選擇。

重點摘要:

  • 三能力統一:理解、動作生成、未來狀態預測共享同一個自迴歸骨幹與 next-token 目標,無需任務專屬輸出頭。
  • 基於 Qwen3-VL:以 Qwen3-VL 為起點,把語言、空間、軌跡與視覺詞元納入同一詞彙表。
  • 2B 與 8B 開源:權重已釋出至 Hugging Face,2B 適合邊緣部署,8B 瞄準基準測試表現。
  • 基準表現:PhysBrain 1.5-8B 在 28 個具身基準取得 72.5 整體分,14 項開源第一、10 項第二。
  • 配套工具:PhysBrainEvalKit 評測工具與官方 Demo 已上線,方便重現結果與部署測試。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 世界模型, 模型訓練, Qwen, Video, Image, VLA, Robotic, 工具

OST:可撤回串流推理的「過早下結論」

香港大學與香港科大(廣州)團隊開源 Omni-Streaming Thinking(OST)針對解決串流影音推理中視覺先到、聲音後到的錯位問題。

Repository image for EnjunDu/OST

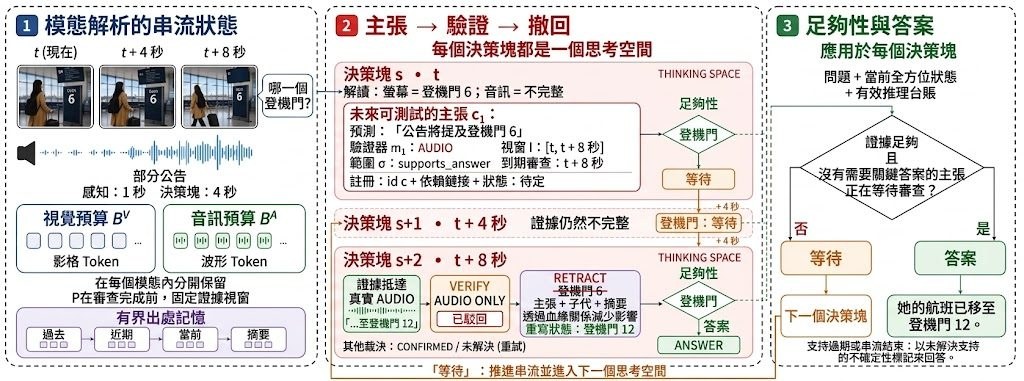
看串流影片做即時推理,最常見的卡位是視覺線索先到位、聲音事件卻還在展開——模型若把視覺猜測當成事實寫進記憶,後續聲音即使推翻它,舊結論仍可能一路延續下去。OST 正是針對這個「提早跨模態承諾」的失敗模式設計:每一個未解的詮釋都被記成一條 claim,附帶預期事件、指定驗證模態、證據到期時段,以及依賴它的狀態;期限一到就用對應模態的證據覆核,被推翻時連帶下修相關狀態,再由引導式解碼產出修正後的回應。

OST 以凍結的骨幹模型為基礎,所有新增的部分都是 adapter、soft prompt 或輕量 head,骨幹參數完全不會被改動。聲音與視覺各自有獨立的保留緩衝區與配額,避免高密度的視覺 token 把聲音擠出記憶;舊狀態以四向折疊收進金字塔結構,讓推理上下文維持在有界範圍內。回答閘門則會延遲輸出,直到所有影響答案的 claim 都完成覆核。

適合研究串流多模態推理、想重播或審視 claim–verify–retract 循環的團隊,會比較容易從中受益。程式碼只涵蓋推論與執行記錄,不包含訓練、評測 harness 或診斷 benchmark。

重點摘要:

  • 類型:串流影音推理的推論實作,骨幹凍結,僅加掛 adapter 與 head。
  • 核心機制:claim–verify–retract,未確認詮釋附帶驗證模態與到期時段。
  • 記憶設計:聲音與視覺分開配額,舊狀態四向折疊維持上下文有界。
  • 輸出控制:answer gate 會等到關鍵 claim 覆核完成才放行。
  • 範圍限制:僅推論,不含訓練、評測 harness 與 OST-DiagBench 資料集。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港大學, 香港科技大學, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio, 香港, Dataset 數據集

MiniCPM5-2B:小模型挑戰長文本與本機 Agent

MiniCPM5-2B 定位本機助理與 Agent 工作流,憑混合注意力機制在 256K 上下文速度達同類模型的 3.5 倍,1M 長度亦唔會 OOM。

minicpm logo

2B 級開源模型一向被視為「垃圾」,但 OpenBMB 推出 MiniCPM5-2B 想直接打破呢個印象。佢係一個密集 2B Transformer,專為本機部署、資源受限場景同 Agent 工作流而設,並非追求跑分,而係希望用細模型扛起編碼、工具調用同長文本推理嘅實際任務。

佢最大嘅賣點係混合注意力架構:25% InfLLM-V2 配 75% Lightning Attention,前者處理局部細節,後者負責廣域上下文,避開全注意力喺長序列嘅記憶體負擔。另一關鍵係 Transformer-to-Hybrid Continue Training,直接喺預訓練權重上做架構轉換,省去冷啟動訓練成本,整體訓練預算大約只需從頭練一個同級模型嘅 25%。

喺長文本佢喺 256K token 序列長度下推論速度達 Qwen3-8B 嘅 3.5 倍(A6000D 實測),1M token 仍可運行,而 Qwen3-8B 喺 1M 已經 OOM。短文本方面,佢嘅知識、數學、編碼能力貼近 Qwen3-8B,但長文本基準測試反而更高,可以理解為「細模型唔再需要喺長短場景之間二擇一」。

對想喺本機跑 Agent、或需要處理超長文件嘅開發者同團隊,呢個模型提供咗一個具體選項。OpenBMB 同時開源咗 UltraX 預訓練數據集、UltraData-Code、UltraData-SFT-Agent-2609(50 萬條 Agent 樣本)同 UltraData-RL-2609,方便下游微調。Hugging Face 有線上 Demo 可即時試,GitHub 上亦有部署與微調腳本。

  • 混合注意力:25% InfLLM-V2 + 75% Lightning Attention,兼顧局部同廣域上下文
  • 架構延續訓練:Transformer 權重直接轉為混合架構,訓練成本僅約 25%
  • 長文本表現:256K 推論速度為 Qwen3-8B 嘅 3.5 倍,1M token 仍可運行
  • 短文本保持競爭力:知識、數學、編碼接近 Qwen3-8B 水平
  • 配套開源數據:UltraData 系列涵蓋預訓練、Agent SFT、RL 樣本

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, 工具, Dataset 數據集

qisi-video-remix:喂一段參考片給 Agent 它直接交出改編劇本與分段提示詞

一個專給 AI Agent 用的視頻改編技能:丟一段參考視頻,它就吐回新故事、完整劇本、分鏡表和能直接複製貼去生視頻的分段提示詞。

Repository image for wyuzhi/qisi-video-remix

要做一條短片,常常卡在「找參考、拆敘事、寫分鏡、再翻譯成生成器看得懂的提示詞」這幾步之間。qisi-video-remix 把這條鏈條整進一個 Agent skill:你貼一段參考視頻(或者故事梗概、截圖、逐字稿),它先把原片的敘事手法抽出來,再以此為基礎寫出新故事,並按鏡頭兼容性和時長上限拆段,最後給出每段可獨立複製的生成提示詞。它不依賴特定後端或拼裝服務,所有結果先在對話中展開,能寫檔的環境下再另外存成 creative-plan.md。

重點摘要:
– 屬於視頻策劃向的 Agent skill,不帶模型或生成器,需由宿主 Agent 處理視頻讀取與生成。
– 默認做創意改編,要落實到人物選擇、事件發展或解決方式的變化,不止換名字。
– 分段先看場景、造型與動作複雜度,再看時長;15/30 秒是單段上限,不是固定段長。
– 提示詞各段獨立展開外貌、場景、動作和對白,可直接貼到所選視頻生成工具。
– 倉庫附一份 30 秒、6 鏡、2 段的完整示例,展示交付結構。

Codex 用戶只要把倉庫克隆到 ~/.codex/skills/qisi-video-remix/ 即可載入;其他支持 SKILL.md 的 Agent 按各自技能目錄安裝。它不替你選單段上限,未確認時會先詢問;遇到無法定論的聲音、身份或轉折會標明,不補造證據。對做豎屏短劇、廣告分鏡、或者想用 AI 視頻模型快速試腳本的個人和小團隊來說,這套指令能省下不少從分鏡到提示詞的人肉翻譯工作。

GitHub

Categories: 開源, Agentic, 模型, Video, Audio, 提示詞, 工具, 庫, Skill 技能

YuE2 用樂譜做中介 把 AI 寫歌變成可改寫的工序

由香港科大 M·A·P 團隊推出的 YuE2,把歌詞與風格提示先轉成旋律與和弦樂譜,再渲染成完整歌曲。比起直接端出成品的做法,這條路線讓編曲、翻唱與代理編輯都變得可介入。

YuE

AI 寫歌工具多數只給你一首成品,YuE2 想處理的是另一個問題:怎樣讓生成過程本身可被人讀懂和修改。M·A·P 與港科大的團隊把流程拆成兩步,先用歌詞加風格提示寫出一份旋律與和弦計劃,再用同一個模型把樂譜變成帶人聲與伴奏的完整歌曲。

Melody 和 chord 不再藏在黑盒裡,而是可以預覽、試播,甚至交給人或 AI 代理去修改。這意味著同一個 checkpoint 可以同時做三件事:從零寫歌、把一段錄音轉成新風格的翻唱、以及透過對話逐步修編曲與歌詞。零樣本翻唱與代理式編輯不再需要切換不同模型。

當多數音樂生成模型只能交出一條「不能再拆」的音檔時,YuE2 走出了一條比較少見的路:它先把歌詞和風格提示轉成一份明確的樂譜與和弦藍圖,再用那份藍圖去唱出完整歌曲。等於把創作流程切成「規劃」和「演奏」兩段,而那份中間的樂譜本身就是可讀、可播、可改的物件,創作者或 AI 代理都能直接在上面動手。

开源翻唱音乐模型-YuE2:你的专业程度=模型上限,没有suno的各种限制。演示《Butterfly》。
YuE2 in ComfyUI: AI Music with an Editable Piano Roll

衡量歌曲品質的 WildSongBench 上,YuE2 best-of-8 取得 6.9632 平均分,是目前該榜觀察到的最高均值,並在多個面向與 Suno v5/v6 拉成均勢。它不只追求像 Suno,而是把 Suno 做不到的那一步:讓成品背後的樂譜可被檢視與修改,當作核心能力。

獨立音樂人、編曲助理、以及想把 AI 寫歌串進更長工作流的開發者,都是比較直接的使用者。代理式編輯對於要快速試不同編曲方向、需要保留人聲或旋律骨幹再重做風格的場景特別有用。

重點摘要

  • 先樂譜後音效:歌詞與風格提示先產出 melody 與 chord 計劃,再渲染成完整歌曲
  • WildSongBench 最佳均值:YuE2 best-of-8 取得 6.9632 分,與 Suno v5/v6 在多個面向拉成均勢
  • White-box 控制:樂譜可預覽、可試播、可交由人或代理修改
  • 零樣本翻唱:同一個 checkpoint 支援把轉錄樂譜換成新風格詮釋
  • 代理式編輯:可用對話方式逐步修編曲、歌詞與編排

入門方面,項目提供 Hugging Face 上的 YuE2-3B 權重、Demos 頁面,以及 Discord 社群。舊版 YuE 的程式碼與授權保留在 YuE-v1 分支,方便比對兩代做法差異。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, 多模態模型, 工具, 音樂, 廣東話

MaP-WAM:把記憶變成計劃

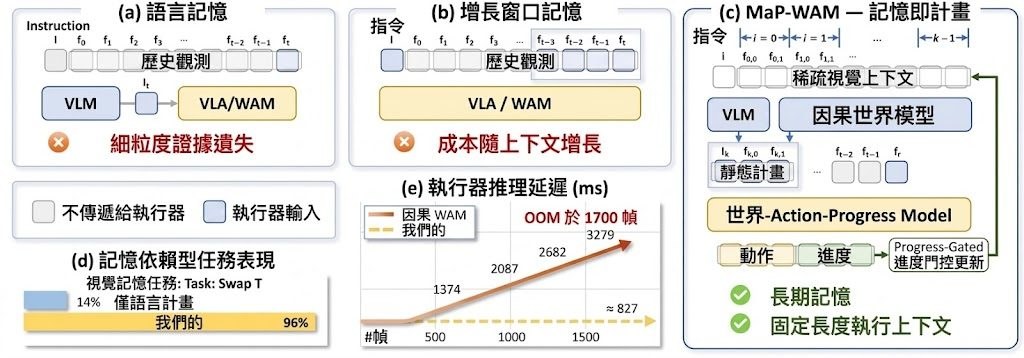
MaP-WAM 將機械臂長任務拆成「記憶 → 計劃 → 行動」三步,先保留稀疏視覺證據,再壓成固定長度的計劃執行,讓 executor 不再因歷史增長而越來越慢。

Repository image for aipixel/MaP-WAM

做過長任務的 robot policy 都知道,當動作序列拉長,模型要嘛靠語言摘要回憶過去,要嘛硬把一堆畫面塞進上下文,結果前者丟失精確視覺證據,後者則隨步數累積越來越慢。MaP-WAM 走的第三條路:把記憶視為「規劃時的證據」,而非「執行時的負擔」。它由哈爾濱工業大學、南洋理工大學及山東大學等團隊共同提出,屬於 VLA 框架與 World-Action Model 思路的延伸。

主流機器人策略通常採用馬可夫公式,但許多複雜的現實世界操縱任務本質上是非馬可夫的,需要超越當前觀察的長視野記憶。MaP-WAM 的核心分三層:每完成一段任務,便把該段的語言指令與少量真實執行幀打包成 episodic memory;之後由視覺語言模型生成下一段的語言計劃,並由因果世界模型補出對應的視覺引導;最後由 World-Action-Progress(WAP)模型在同一上下文內同時輸出動作 chunk 與進度,再以 plan-observation alignment 校正遞迴估計、以 progress-gated transitions 決定何時更新記憶並請求下一段計劃。由於已完成片段的 episodic 證據與當前計劃都可被 cache,executor 的上下文長度保持固定。

在 RMBench 上達到 83.3% 成功率、真機實驗約 78.0%,同時 executor 維持近似常數的 per-chunk 延遲。在三個長任務記憶方案中,這套設計拿來對比的恰是「語言記憶丟視覺證據」與「滑動視窗記憶吃 GPU」這兩個老毛病,並以固定上下文的方式直接拆解效率與覆蓋率的取捨。

適合關注機器人長任務、World-Action Model、VLA 框架的研究團隊與工程團隊參考。模型 checkpoint 標示為 Coming Soon,現階段只能讀 paper 與項目頁理解思路。

重點摘要:

  • Memory-as-Plans:將長任務記憶拆成「已完成片段的稀疏視覺證據 + 語言計劃」,而非把所有歷史塞回 executor。
  • WAP 模型:在同一上下文內同時輸出動作 chunk 與任務進度,並透過 plan-observation alignment 校正遞迴估計。
  • 固定上下文執行:已完成片段與當前計劃皆可 cache,executor 上下文長度不再隨歷史增長。
  • 對比清晰:直接挑戰語言記憶丟失視覺證據、滑動視窗吃 GPU 記憶體兩種主流做法。
  • 現況限制:訓練與推理程式碼、模型 checkpoint 均未釋出,目前僅有 paper 與項目頁可參考。

項目主頁 · GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 世界模型, 模型訓練, VLA, World-Action Model, Robotic, 框架

TempCloze:揭開 Video-LLM 的時間盲區

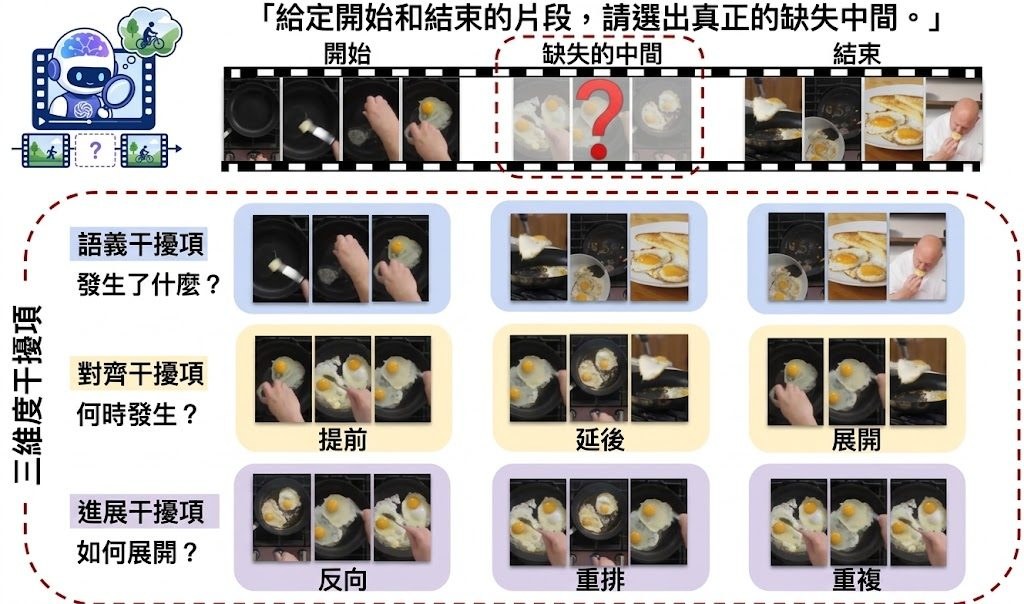
TempCloze 是一個專門測試 Video-LLM 視覺時間推理能力的影片填空基準,從七個來源收集 1,521 條長鏡頭與第一人稱影片,挑戰模型能否在四選一中找回正確的「消失中段」。它直接揭示現有模型在時間對齊上的明顯短板。

Overview of the TempCloze benchmark

TempCloze 的玩法相當直觀:給一段影片的開頭與結尾,要求模型從四段候選片段中挑出真正屬於中間缺失的那一段。四個選項全部來自同一條影片的素材,連文本線索都壓到最低,等於逼模型只能用眼睛去判斷時間先後與事件流暢度。

這套基準特別針對三個時間維度:語義(Semantic,考「發生了什麼」)、對齊(Alignment,考「應該在何時發生」)、推進(Progression,考「事件如何展開」)。對齊的干擾選項設計得很巧妙,例如把同一段內容前移、後移或拉長;推進維度則把片段倒播、重排、重複,看模型能否識破。題目素材刻意挑選長鏡頭與第一人稱影片,避免靠剪輯或場景切換就能蒙混過關。

跑完 31 個 Video-LLM(10 個閉源加 21 個開源)後結果很殘酷:無論是 GPT 類還是開源權重,模型在對齊任務上的準確率幾乎腰斬,閉源平均從語義 70.73% 跌到對齊 48.13%,開源平均更只剩 26.54%。相比之下,人類在嚴格協議下仍能達到 97% 平均正確率。換言之,現在的 Video-LLM 對畫面在時間軸上的位置幾乎沒概念,只能靠語義關聯硬猜。

對於做影片理解、embodied AI、多模態基準研究的人來說,這份工具包很值得關注。它提供統一抽幀協議(每段 16 幀,六片段題 96 幀),評測流程可直接套用,重點在於指出時間對齊才是視頻推理的真正瓶頸,數字與圖表都已經整理好。

重點摘要:

  • 任務設計:四選一影片填空,所有干擾項來自同一條原片,消除文本捷徑
  • 三維度考核:語義、對齊、推進,分別測事件、位置、展開方式
  • 數據規模:1,521 條影片,長鏡頭與第一人稱為主,七個公開來源
  • 核心發現:對齊維度是最大瓶頸,開源模型跌至 26.54%,閉源亦僅 48.13%
  • 工具價值:統一抽幀協議與評測腳本,可直接比較現有 Video-LLM 在時間推理上的差距

GitHub

Categories: 開源, Agentic, 模型, 視覺模型, Video, 影像處理, 框架, 工具

World in World 把 14B 世界模型變成你的虛擬攝影機

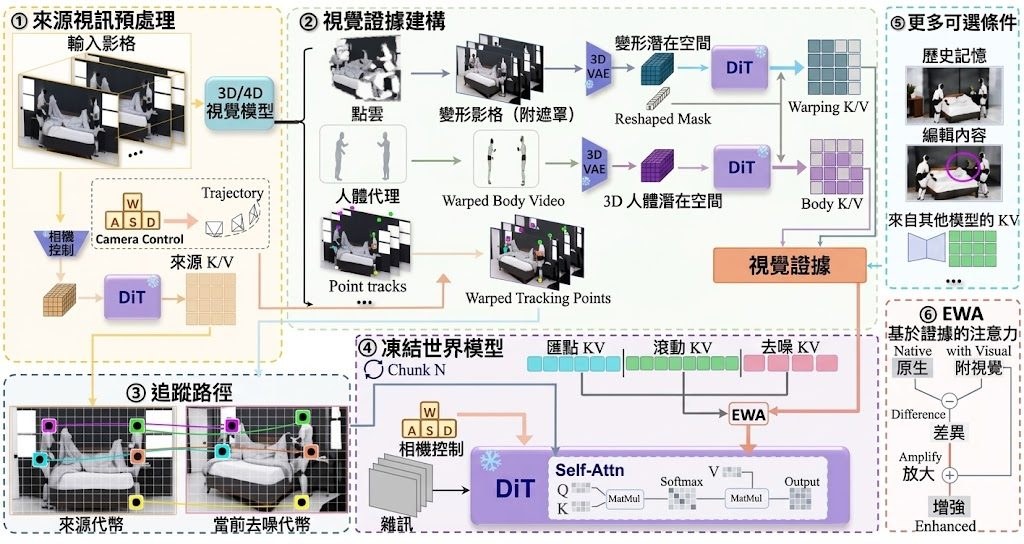
想用一條普通影片就做到 360 度重拍、子彈時間、視角切換?World in World 讓凍結的 14B 影片世界模型 LingBot-World 2.0 直接「走進」影片,無需微調,單卡 80GB GPU 即跑。

pipeline

對於做特效、剪輯或沉浸式內容的人來說,最頭痛的往往不是生成新畫面,而是手上明明有一段拍好的影片,卻想換個角度、換條鏡頭軌跡重新「拍一次」。Westlake-AGI-Lab 推出的 World in World,正是針對這個卡位:給定一段輸入影片和一條新相機路徑,模型會重新生成同一事件在新視角下的畫面,不用訓練、不用微調。

它本質是一個影片再攝影框架,骨幹是一個凍結的 14B 影片世界模型 LingBot-World 2.0。技術上沒有走 latent editing 或 GAN 反轉的老路,而是把所有可控制的訊號——來源影片、場景幾何、相機參數——全部變成視覺證據:先用深度把來源幀提升到 3D,依新相機路徑 warp 過去,再當成額外 key/value 塞進模型自己的 attention,讓模型「看到」新相機應該看到什麼,缺失的部分由它自己補完。這種做法讓相機軌跡、人物動作與場景幾何保持高度一致。

從結果來看,它已經放出自由相機重拍、子彈時間和影片編輯三項功能;大型角度 360 度重拍結合 3D 人體代理、跨模型記憶共享、長影片 frustum memory、串流互動生成、動作遷移等仍在路線圖中。對特效團隊、短片創作者、遊戲過場預覽、AR/VR 內容開發者來說,可以用一條現成素材快速產出多視角版本,而不必從零生成或手動三維重建。

官方在 Linux 上以 80GB A100 測試,峰值記憶體約 72GB,需 CUDA 12.4 與 Python 3.10,並預編譯 flash-attn wheel 以避免從源碼編譯。相較同類影片重生成方案,它放棄了對模型本體做適配,以 warp + attention injection 換取「即插即用」與較低硬體門檻,但代價是大角度旋轉、人物遮擋等極端情況仍依賴後續的 3D 代理與 frustum memory。

  • 凍結模型免訓練:以 warp 後的視覺證據作為 attention key/value,無需微調 14B 世界模型。
  • 多視角影片重拍:支援弧線、推拉、平移、定點旋轉等自由相機路徑。
  • 子彈時間與影片編輯:凍結任意一幀改變視角,或改第一幀讓編輯自然延伸至整段。
  • 單卡 80GB 可跑:Linux + A100 + CUDA 12.4 + Python 3.10,硬體門檻相對可控。
  • 路線圖仍在擴展:360 度重拍、跨模型記憶、串流生成等功能陸續排程中。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, 模型訓練, NVIDIA, Video, 框架, Content Creator, 3D, Linux, Python

Page 23 of 59
1 … 21 22 23 24 25 … 59