EdgeWise 讓長流程 AI 代理在本地運作更省成本

EdgeWise 讓本地模型處理大部分長流程任務,只在關鍵步驟呼叫雲端 LLM,兼顧表現與成本。

Og image

長流程 AI 代理不必每一步都依賴昂貴的雲端模型。NVIDIA 的 EdgeWise 是一套 edge-cloud collaboration framework,讓本地 SLM(Small Language Model)先負責解題,遇到需要更強推理能力的關鍵步驟,才選擇性地交由 cloud LLM 處理。

EdgeWise 用 step-level RL(Reinforcement Learning)同時訓練任務執行與自動分工,令代理自行判斷何時需要外援,而且不必在推理階段額外加入另一個決策模型。研究亦以 external judge-based delegation strategy 分析委派時機、分享多少上下文,以及雲端模型應該多久介入一次。

研究發現,雲端智慧需求通常集中在少數關鍵步驟,呼叫次數不一定越多越好;隨機把約 40% 步驟交給雲端,有時已能接近全雲端執行的表現。EdgeWise 在 SWE-Rebench 減少最多 62% inference cost,在 Terminal-Bench 2.1 減少最多 34%,並在本地工作站完成 edge-cloud 測試。

• 本地 SLM 負責主要任務流程
• 只在關鍵步驟委派 cloud LLM
• 以 step-level RL 學習委派決策
• 支援不同 agent harnesses
• 成本較全雲端執行最多低 62%

適合需要處理長流程編程、終端機操作或其他多步驟任務的工作流,尤其適合希望降低 inference cost、又不想完全犧牲模型能力的本地設備。雲端連線、委派判斷和上下文分享方式仍會影響結果,因此它並非完全脫離雲端的方案。
項目主頁

Categories: Agentic, 模型, 模型訓練, NVIDIA, World-Action Model, 框架, 編程, 強化學習

AesCode 以圖像生成資訊網頁

生成式 AI 做海報或儀表板時,常要在視覺美感與文字、數據正確之間取捨。AesCode 把圖片生成器當作設計參考,再輸出可編輯、可驗證的 HTML 與 CSS。

Infographics generated as editable HTML and CSS by AesCode

想用 AI 製作簡報、海報、儀表板或網頁,往往不只要內容齊全,版面層次和配色也要合適。AesCode 是一個視覺程式碼生成模型,透過圖片生成器提供美感參考,再把結果寫成可編輯、可驗證的 HTML 與 CSS;文字和數據仍以使用者提示為準,避免把參考圖中的錯誤內容照搬進成品。

AesCode 不把參考圖片當成正確答案,而是訓練模型分開處理內容要求與視覺線索。它先用設計圖表示文字、圖表、表格和版面區域之間的關係,再以多項可程式化檢查評估執行結果、文字、邊界、圖表數據、版面及留白;視覺評分則採用與設計圖連結的評分規準,並把不同評分渠道分開處理。

簡單講,就係「用 AI 將內容變成有設計感、而且可以修改嘅 HTML/CSS」:你提供文字要求,可以再加一張參考圖片,佢就生成資訊圖、簡報頁、海報或者儀表板,而唔係只生成一張平面圖片。

訓練從既有的 8B 和 32B 模型出發,並非從零訓練;項目提供 AesCode-8B 與 AesCode-32B 模型。首頁列出 3,000 個冷啟動監督微調示範和約 7,408 個強化學習提示,並提醒提示數量不等於完整強化學習生成次數。使用者可透過公開模型測試生成結果,再按需要修改 HTML 與 CSS;複雜插圖和照片則保留為語義佔位區,圖表交由 ECharts 處理,未涵蓋的視覺素材可在後續流程交給圖片生成器或人工補上。

測試結果顯示,移除推理階段的參考圖片後,AesCode-8B Visual 分數只下降 1.0 分,基礎模型則下降 19.6 分;即使政策模型推理時看不到參考圖,採用參考圖評分訓練後,僅依提示生成的 Visual 分數仍由 25.17 升至 69.71。AesCode-32B 在 GDB/lica、SlidesBench 和 Design2Code 的 14 項指標均高於 Qwen3-VL-32B 基礎模型,提升較多的項目集中在設計相關指標;這些結果支持設計能力能遷移至其他基準,但不代表每種版面都能一次生成妥當。

  • 參考圖片提供版面與風格線索,不作為文字和數據的事實來源。
  • 設計圖把元素及其對齊、包含和排列關係納入評估。
  • HTML 與 CSS 保留編輯空間,適合需要後續人工調整的設計工作。
  • 複雜插圖採用佔位區,圖表使用 ECharts,生成範圍因此有所限制。

需要大量製作資訊圖像、簡報或儀表板的設計與內容團隊,可以把 AesCode 納入生成及後期修改流程;熟悉 HTML、CSS 的開發者亦較容易檢查版面並修正細節。它的優勢在於把視覺指引轉化為可修改的程式碼,而非交付一張難以局部調整的平面圖;若成品需要精細插畫或照片,仍要安排額外素材生成或人工處理。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, Qwen, 微軟, Image, Dataset 數據集, UI/UX, 強化學習

Jeva 把可變選項決策搬到本地模型

面對候選答案會增減、排序又不應影響結果的任務,Jeva 以本地 4B 模型處理選擇、否定及評分。

Null-aware · Permutation-invariant · Option-scalable · Cacheable

候選答案數量不固定、選項次序不應改變判斷,正是 Jeva 嘗試處理的場景。它屬於開源本地決策模型,輸入狀態和 typed questions,輸出候選機率、Boolean probability 或 expected rubric score,亦能表達「沒有合適答案」。

Jeva 以共享語言編碼器獨立處理 state 和每個 option,再由 compact decision stack 只更新 state,對完整 option memory 作集合式判斷。這讓候選集合可以改變而毋須固定 label vocabulary;排序候選只會同步排列機率,不會改變語義身份。

模型權重可從 Hugging Face 載入本地推理,項目目前要求 Linux x86_64、NVIDIA GPU、CUDA 12.8 及 PyTorch 2.9.1。加速 kernel 可能在第一次請求時編譯,亦提供較慢的 reference installation;evaluation 和 fine-tuning 文件可用來延伸測試。

可重用的 option vectors、projected keys/values,以及完整 option tuples,適合候選內容反覆重組的分類、審核和評分流程。代價是硬件與 CUDA 環境要求較高,而項目提供的評估資料需要按自身任務重新核對,不能只憑模型名稱推斷效果。

  • 集合式決策: 候選數量可變,無需為每套選項重建輸出層。
  • Permutation symmetry: 重排候選只會重排對應機率。
  • Null awareness: 分開估計答案是否存在,以及候選之間的競爭。
  • 計算重用: 可快取整組選項,或重用個別 option 表示。
  • 適合場景: 本地化的選擇、審核、狀態判斷和 rubric 評分工作流。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, NVIDIA, Linux, Python

Urbex 讓城市級 3D 定位改用主動搜尋

Urbex 讓視覺語言代理在城市級 3D 場景自行搜尋證據,毋須預先建立物件候選框,定位能力與效率取捨更值得檢視。

Urbex logo

面對城市級 3D 場景,逐一比較預先產生的物件候選框容易拖慢搜尋,也會受候選品質限制。Urbex 屬於開源的 Agentic 視覺模型項目,將 3D grounding 改成主動空間搜尋,讓 vision-language agent 按需要查詢地標、縮放區域、切換斜視角,再提交目標 bounding box。

它不是只靠一次影像判斷,而是在互動式 multi-view environment 逐步收集證據。Reinforcement learning 同時訓練定位和搜尋決策,模型會學習應該檢查哪裏、何時縮窄範圍,以及幾時足以作答;這免除對 precomputed instance proposals 和 ground-truth boxes 的依賴,但每次搜尋仍要承受多步操作成本。

CityRefer 測試中,Urbex 的 ND Hit@1、Hit@3、Hit@5 為 25.8、39.2、42.3,NO 對應為 23.9、36.9、40.7,搜尋時間約 3.2 秒。相較 CityAnchor 的 32.1 秒,速度明顯較快;模型亦在 STPLS3D-Refer 取得 zero-shot 結果,反映跨場景泛化潛力,但不能直接等同於所有城市環境都同樣穩定。

• 支援 CityRefer 訓練及單查詢互動式 3D 推理
• 提供 Hugging Face 的 Urbex-4B 模型和 Urbex-Data 數據集
• 可透過 Colab notebook 試用預測視圖
• 安裝需要 Linux、Python 3.11、CUDA 12.8 及 C++ 編譯器

研究城市建模、3D 視覺定位或多模態代理的團隊,較適合用它測試 candidate-free grounding;想快速驗證概念的人則可先用 Colab。完整訓練需要 CUDA 12.8、Megatron Core、Transformer Engine 和 FlashAttention,硬件及環境門檻明顯高於單純推理,因此本地部署前應先確認 GPU、編譯工具和數據下載流程。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Image, 工具, 3D, Linux, Python, Dataset 數據集, 強化學習

LensErase 超精確移除物件,水印

只需圖片與 mask,LensErase 便可移除物件、文字或水印,再按周圍內容補回較自然的畫面。

logo mark

移除圖片中的水印、文字或多個物件時,難處往往不在於遮走目標,而是要同時處理陰影、反光及原本被遮住的背景。LensErase 以 foundation model 形式處理這類影像擦除工作,輸入一張圖片和一個 mask,輸出清理後的結果,適合海報整理、圖片修復及內容再利用等場景。

項目配套的 LensErase-100M 包含 101.07M 組對齊的 input–mask–target 三元組,涵蓋一般圖片、水印、大範圍 mask、視覺文字及海報五類資料,另有 140K 組 SFT samples 和 19K 組 RL samples。高解析度資料會由 GPT-5.6 Sol 檢查 mask 有效性、編輯正確性、重建效果及非目標內容保留程度。

LensErase-Bench 收錄 500 個案例,毋須指定唯一的 ground-truth target,改以 Removal、Inpainting、Preservation 和 Cleanliness 四個維度評估,當中完整移除目標及相關效果佔總分 40%。較貼近擦除任務的實際情況,因為同一個遮罩可能存在多個合理的背景補全方案。

  • 支援物件、視覺文字、水印及其相關效果的移除
  • 以 LensErase-100M 支援 pretraining、SFT 及 RL
  • 以 LensErase-Bench 評估移除、補全、保留和畫面潔淨度
  • 提供與 GPT-Image2.5-Sunburst、Flux2-Erase 及多個開源模型的比較
  • 頁面目前只表示 Code coming soon,未提供安裝、下載或使用流程

項目展示了跨場景和多物件擦除能力,亦包括海報及反射等較複雜案例。對需要批量清理素材、保留非目標結構的影像工作流;不過使用者仍需等待程式碼及更多可重現資料。

項目主頁

Categories: 開源, 北京大學, 模型, 模型訓練, 微軟, OpenAI, Stable Diffusion, Image, Dataset 數據集, 強化學習

Multics:開源多玩家世界模型

Multics 是騰訊 ARC Lab 與港大合作的多玩家影片生成世界模型,靠分層通訊機制讓同一個訓練版本直接推廣到 6、8、10 人,玩家與鏡頭控制互不干擾。

Repository image for TencentARC/Multics

打機時如果有 4 個、6 個甚至 10 個玩家走在一起,畫面要保持連貫,又要讓每個人各自控制鏡頭與動作,舊做法往往一加人就 O(N²) 爆計,或出現互相干擾。Multics 正是針對這個卡位:來自騰訊 ARC Lab 與香港大學的開源世界模型,採用 Player → Group → Global 的分層通訊,動態根據最近鏡頭軌跡分組,限制無關事件直接混合。共享的 group-token 參數令用 4 人數據訓練的模型,可以直接推廣到 6、8、10 人而毋須重新訓練。

對於做多人遊戲原型、模擬訓練環境或敘事影片的團隊,這個項目直接省掉「人數一變就要重訓模型」的麻煩,同時降低自注意力計算量,GPU 開銷壓得較低。它的代價是依賴 NVIDIA GPU、CUDA 12.8 與 Linux 環境,安裝需用 uv 同步依賴,並從 Hugging Face 下載包含 VAE、tokenizer 與 4-player checkpoint 的完整推理包。

Repository 提供 inference.py 配合 YAML 配置,可選擇 4-player 範例或擴展到多人數測試,原始資料未列出具體的玩家數上限驗證結果,只說明同一個 4 人 checkpoint 能支援 10 人輸出。代碼以 Apache 2.0 授權,研究與商業應用皆可改作。

重點摘要:

  • 騰訊 ARC Lab 與香港大學共同開發的多玩家影片生成世界模型
  • 分層通訊機制降低注意力計算成本,避免無關玩家互相干擾
  • 共享參數設計讓 4 人訓練版本直接支援 6、8、10 人,毋須重新訓練
  • 推理需 Linux + CUDA 12.8 + NVIDIA GPU,模型權重經 Hugging Face 發佈
  • 適合多人遊戲畫面合成、模擬訓練、互動敘事等需要可擴展多視角的工作場景

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 騰訊, 模型, 世界模型, 模型訓練, NVIDIA, Video, 香港, Linux, Tokenize

WOVEN:把視覺世界模型放入多模態 LLM 的新訓練範式

WOVEN 提出視覺轉換推理(visual transition reasoning)框架,用約 2,000 條受控樣本就能讓多模態 LLM 在 22 個外部基準上進步最多 27.3 個百分點。

WOVEN

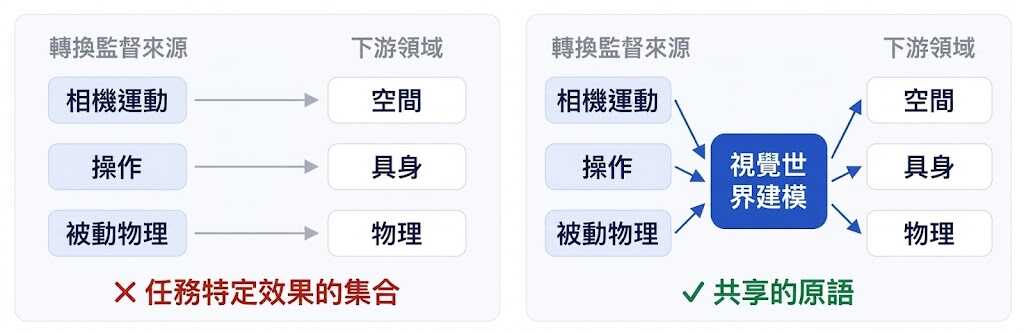
Multimodal LLMs 在空間推理、具身操作、物理常識、時間理解等多個範疇長期被當作獨立問題處理。WOVEN 把這些差距收斂到同一個原語:視覺轉換推理(visual transition reasoning),也就是在狀態—動作—新狀態 (s, a, s′) 中,根據已觀察部分推斷未觀察部分。這個框架既是訓練素材,也是一個評測基準。

WOVEN 內含 36,076 條四選題,覆蓋 20 種場景、5 種動作、8 種推理類型,並用影片生成模型嘅 rollout 構建。研究團隊在 Qwen2.5-VL-3B-Instruct 上以監督微調(SFT)加上 GRPO 訓練,11 個約 2,000 條嘅受控子集分別針對一類動作同推理家族,最終令 26 個外部基準中嘅 22 個出現提升,幅度最高達 27.3 個百分點,呢個幅度令人意外。

WOVEN 嘅分類包含前向動力學、逆向動力學、反事實移除、反事實替換、結果預測、線索預測、時間排序同時間相鄰性八種,並設計咗單因子受控變化、反事實 rollout、錯誤類型誘餌同三類測試集以排除偏差。研究者亦喺不同模型規模同模型家族上做咗複現。WOVEN 將視覺世界建模定義為可重用嘅原語,並非單一任務嘅效果集合。對做視覺推理、具身智能同多模態基準建設嘅團隊,呢套資料同訓練食譜提供咗一個統一切入點。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Qwen, Video, 框架

T3lescope 把多視角影像變成高質 3D 場景

由單一物件到城市級戶外場景,T3lescope 嘗試以生成模型兼顧整體幾何、細節,以及玻璃和鏡面表面重建。

T3lescope teaser

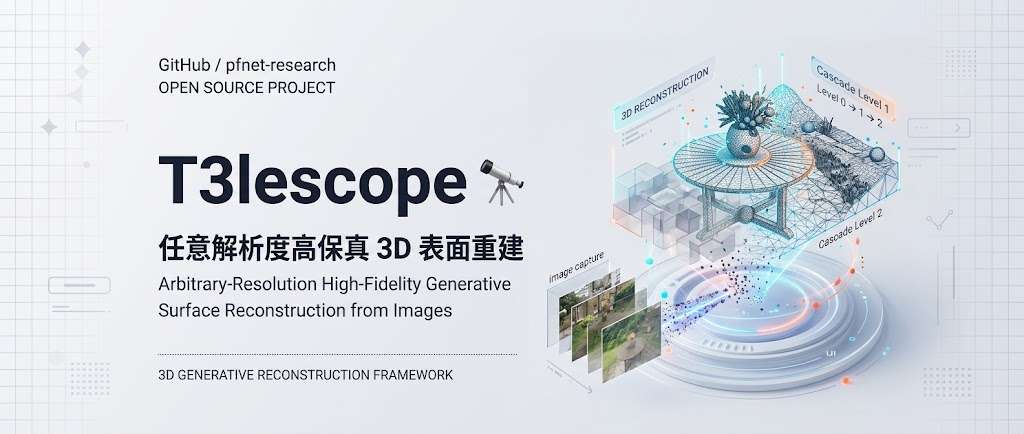
面對影像稀疏、表面反光或透明等情況,T3lescope 仍嘗試由已標定相機姿態的多視角影像重建高保真 3D scene mesh。它屬於生成式 3D 重建模型,處理的是大型場景難以同時維持覆蓋範圍與局部細節的問題。

模型以 mesh flow models 直接生成高解析度網格,並在推理階段採用 coarse-to-fine cascade:先用較粗層級建立全局布局,再於更細的 spatial cells 內擾動、去噪和補回幾何細節。各層共用同一個 fixed-resolution generator,訓練時以不同尺度的 cells 學習,因此層級數量、cell 尺度和位置都可於推理時調整。

這做法減少把大型場景切成多個獨立重建區域後出現的接縫和全局不一致風險,也不需要逐個場景進行 per-scene optimization。代價是重建品質仍取決於輸入影像數量、視角覆蓋和模型推理配置,而 README 未提供硬件要求、速度或完整操作流程。

T3lescope: Arbitrary-Resolution High-Fidelity Generative Surface Reconstruction from Images
  • 支援由單一物件、室內環境延伸至戶外和城市級場景
  • 可在推理階段選擇 cascade 層級與網格細緻程度
  • 針對稀疏觀測、細小結構、glossy 及 transparent surfaces 提供生成式補全
  • 在室內、戶外及城市場景測試中勝過 feed-forward 和生成式基線,並達到或超越部分 per-scene optimization 方法

適合需要多視角影像轉 3D 資產的視覺研究、數碼孖生、機械人感知和場景製作團隊,較容易受惠於這種跨尺度重建能力。不過 GitHub 項目目前只標示 Code is coming soon,尚未提供可安裝程式碼;現階段可參考 arXiv、項目網站和示範影片理解結果,未能按儲存庫直接測試。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Image, 3D, 庫

GroundAnything 以並行解碼提升視覺定位速度

GroundAnything 把多種視覺定位任務放進 4B 模型,嘗試同時處理精準座標與推理速度的取捨。

GroundAnything

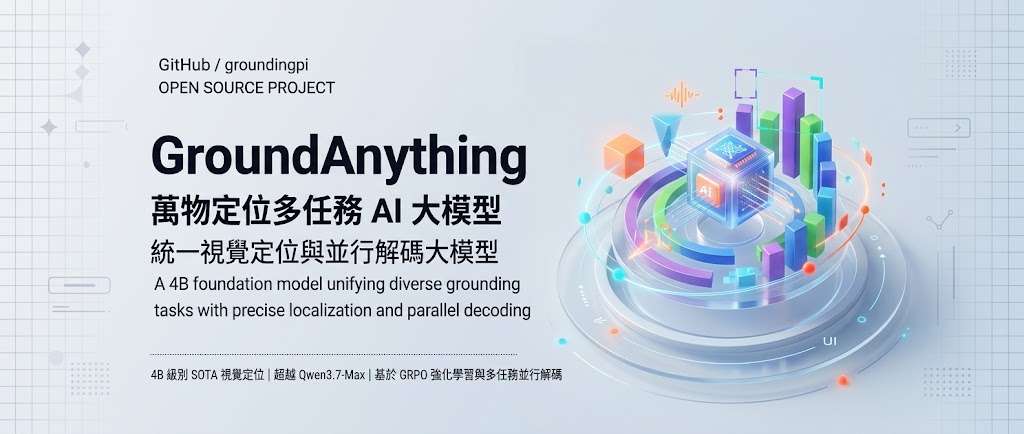
要在圖片中找出物件、位置和空間關係,GroundAnything 可一次處理多類 visual grounding 任務,減少逐個輸出座標帶來的延遲。它屬於 4B 級視覺基礎模型,實際處理的是影像內容與文字查詢之間的精準定位問題,適合影像標註、視覺搜尋及多模態分析工作流。

模型以 GroundAnything 的 diffusion decoding 配合 parallel decoding,讓空間假設可以並行生成;GroundAnything-VLM 則是獨立的 autoregressive checkpoint。前者針對序列生成的速度限制,後者保留自回歸模型路線,兩者均使用 GAM evaluation mode,並非同一模型的不同介面。

項目透過 grounding pretraining、AR-to-diffusion conversion、joint objectives、supervised fine-tuning 和 GRPO-based reinforcement learning 建立模型。30 個基準測試中,GroundAnything 勝過同級自回歸模型的整體最佳結果,亦超越較大的 Qwen3.7-Max;GroundAnything-VLM 在同級別取得新的整體最佳結果,並與 GPT-6 Astra 保持競爭力。

適合需要精準視覺定位、又要控制推理延遲的研究團隊和影像處理項目,硬件需求、實際吞吐量及不同圖片任務的穩定性仍需自行驗證。

  • 速度取捨:以 diffusion decoding 和並行輸出減少空間預測的序列等待。
  • 模型關係:GroundAnything 是 diffusion 路線,GroundAnything-VLM 是獨立 autoregressive checkpoint。
  • 評估範圍:涵蓋 30 個 benchmarks,並比較 MTP-based generation 與多階段基礎設施優化。
  • 適用場景:影像定位、批次標註、視覺搜尋及需要座標輸出的多模態工作流。

項目主頁 · GitHub

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, Image, 影像處理, 香港, 強化學習

GroundingPI 以 4B 視覺基礎模型連接感知與機械控制

GroundingPI 把視覺定位轉成可供機械系統使用的點和框,主打複雜場景下的精準感知與控制效率。

GroundingPI

要讓自動駕駛或機械人準確知道「要處理哪件物件、位置在哪裏」,單靠一般視覺語言模型仍可能在雜亂畫面和細小物件上失準。GroundingPI 屬於視覺 grounding foundation model,以 4B 參數模型處理定位問題,輸出可供後續控制使用的視覺結構。

模型以 visual primitives 為核心,將點和框表示成 shared vocabulary 中的 quantized coordinates,再配合 vision-language model、tokenizer、processor 和 custom model code。這種做法針對 VLA(vision-language-action)及 WAM(world-action models)常見的感知瓶頸,並讓 perceptual foundation 可以轉移到 autonomous driving 和 robotic manipulation。

  • 定位方式:同時支援點與框,適合指定目標及描述空間位置。
  • 模型規模:4B 參數,目標是在能力與運算成本之間取得平衡。
  • 評測結果:涵蓋 34 個 grounding benchmarks、11 種感知能力,對比 44 個基準模型平均達 73.68%,高於 GPT-6 Astra 的 71.54%。
  • 轉移價值:在 ID 和 OOD 評估,以及 action-data efficiency 方面,展示對自動駕駛和機械人操作的幫助。

對研究團隊而言,GroundingPI 不只是單次定位模型,亦可作為 System-1 foundation-model 的感知層,補足未必擅長精準 grounding 的通用視覺模型。項目提供 Hugging Face 模型及 Demo,並列出 vLLM、Transformers backend、OpenAI-compatible API 和 JSONL batch annotation 工作流;不過提供的儲存庫資料未交代完整硬件需求,部署前仍需按文件確認環境。

研究重點同時放在 pretraining scale 和 data composition 如何影響 grounding 及轉移效果。需要即時視覺定位、閉環控制或希望減少 action data 的自動駕駛、機械人及 embodied AI 團隊,會較容易從這個模型的感知能力受益;純文字或一般影像分類工作則未必能直接發揮其價值。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 清華大學, 模型, 視覺模型, 多模態模型, 模型訓練, API, Image, VLA, World-Action Model, Robotic, 香港, 庫, Tokenize

Page 7 of 38
1 … 5 6 7 8 9 … 38