AgentMercury 生成可驗證商業世界

把企業情境轉成可執行環境,讓AI代理在多服務流程中訓練,再轉移到未見過的評測項目。

Og image

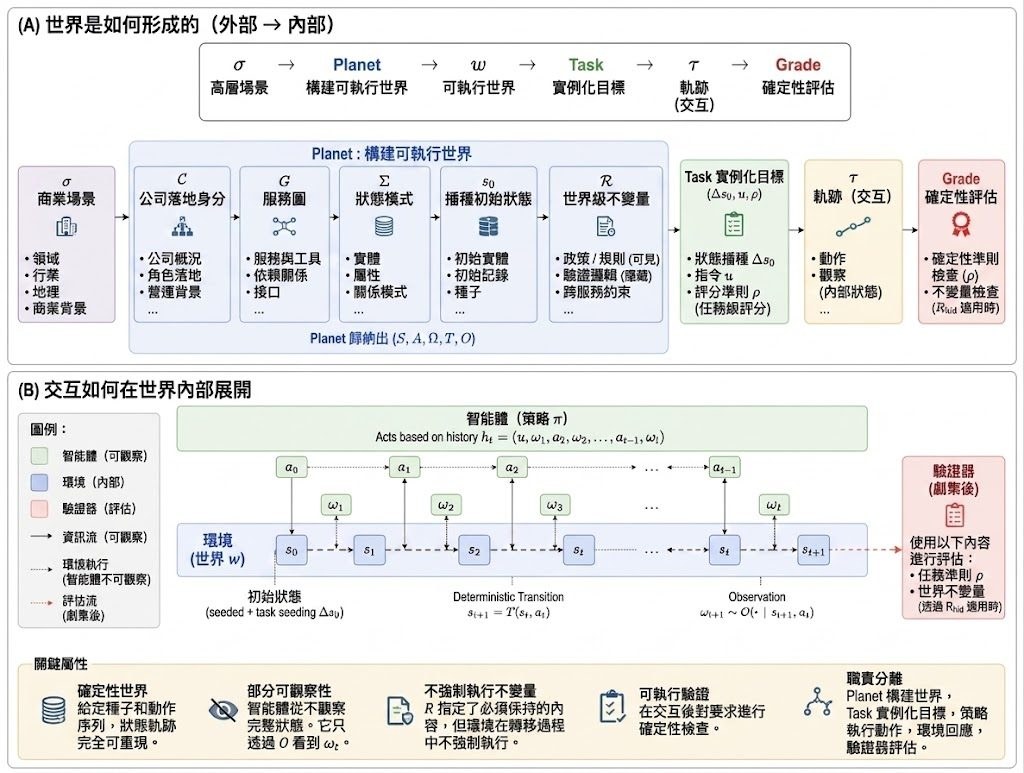
當AI代理要處理跨部門企業流程,難點往往不只在於選擇工具,還要在多個服務之間維持一致狀態,最後交出可以核實的結果。AgentMercury是一個用於訓練 Computer-use agents(CUAs)的環境生成項目,讓高層次商業情境直接變成可執行、可重播和可驗證的虛擬世界,代理可以在其中進行多輪操作,而系統會按完成後的狀態計算獎勵。

常見做法會先為指定任務或 benchmark 手工建立環境,環境自然只覆蓋測試者預先想到的流程。AgentMercury則把環境建構本身交給 Planet:它由公司身份、服務圖、資料表結構、初始狀態和跨服務不變條件組成一個完整世界,再由 Task 在共享世界上加入不同目標和評分規則。一個世界可以承載多個任務,減少每個新流程都要重新造環境的成本。

驗證條件主要以環境資料庫上的 SQL 形式執行。代理完成一輪操作後,系統會根據任務 rubric 和隱藏的不變條件,對整條 trajectory 進行確定性評分;環境不會在每一步替代理判斷對錯,代理必須自行處理跨服務要求,完成後才接受檢查。這種安排讓結果可以重播,也令 Reinforcement Learning(RL)訓練得到較穩定的回饋。

目前項目整理出4,783個 executable worlds,涵蓋14個產業和50個國家,包含13.98M seeded state rows、842種工具和43,300個可驗證 RL 任務。典型世界約有13項服務、65種工具、31張狀態表,以及約15個以 SQL 編寫的 deterministic verifiers;訓練資料涉及4,326個公司環境,但 Qwen3.5-4B 的報告只使用其中3,200個任務取得梯度,仍覆蓋53.5%的環境、62.9%的產業和75.8%的工具。

項目以 Qwen3.5-4B 和 Qwen3.5-35B-A3B 進行 RL 訓練,代理透過 Model Context Protocol(MCP)操作即時形式的商業軟件,並以 GRPO(Group Relative Policy Optimization)為主要優化方法,SAO 則作為另一種選項。Qwen3.5-4B 的平均獎勵約由0.25升至0.53,截斷回應比例由78%降至3%;在未參與訓練的 EnterpriseOps-Gym 八個企業領域,平均分數由12.3升至15.7,增幅為27.6%。35B-A3B 使用 GRPO 和 SAO 後,平均分數分別由24.8升至28.1及28.3,但結果仍屬項目所報告的訓練和評測範圍,未代表代理已能可靠處理所有企業工作。

  • 將高層次商業情境編譯成可執行世界,而不是只為單一任務造環境
  • 以共享資料庫、SQL 驗證條件和可重播評分檢查跨服務結果
  • 提供4,783個環境、842種工具和43,300個可驗證 RL 任務
  • Qwen3.5 系列在多輪 MCP 工具操作訓練後,獎勵和未見領域表現均有改善
  • 仍需留意合成環境與真實企業軟件之間的差距,以及評測範圍有限的問題

項目主頁 · 模型

Categories: 開源, Agentic, MCP, 模型訓練, Qwen, Dataset 數據集

τ₀-VLA:為長程機械人任務補上分層推理

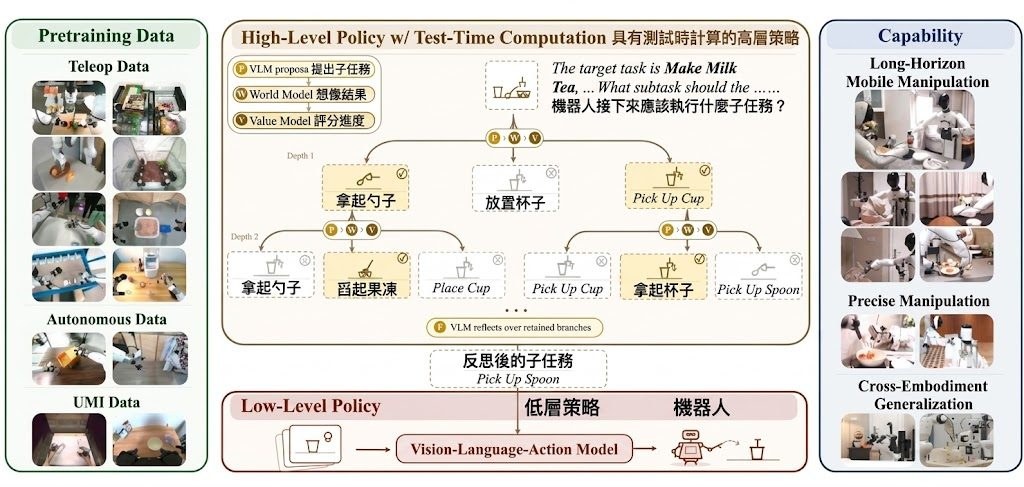
τ₀-VLA 把長程機械人操作拆成高層規劃與低層執行,先想下一步,再落到實際動作。它特別針對多步驟、要記住進度又要回復失誤的場景。

τ₀-VLA overview

τ₀-VLA 是一個機械人基礎模型,主打長程操作任務,例如清理房間、準備食材和沖奶茶這類要連續完成多個步驟的工作。它先用帶記憶的高層策略決定下一個子任務,必要時再用 world-model-guided test-time computation 比較不同做法,然後交由低層策略執行。

這種分層方式比單次前向推理更適合處理長流程,因為模型不只要做動作,還要跟進已完成進度、預測結果,再決定下一步。對需要機械人跨場景操作的團隊來說,比只處理單一步驟的控制模型更接近真實工作流程。

  • 高層負責規劃子任務,低層負責具體控制
  • 會在需要更多推理時做分支搜尋,不是即時拍板
  • 低層策略結合 Qwen3.5 vision-language backbone 與 Mixture-of-Transformers action expert
  • 訓練資料來自 40,115 小時真實機械人數據,涵蓋多模態協同訓練
  • 目前公開 v1 只支援 joint-control checkpoints,EEF serving 未提供

官方提供 Python 3.11、CUDA 12.8、PyTorch 2.7.1 的參考環境,也有 example_data 同配置的 post-training 例子,可用來接入自己的資料集或機械人設定。文中四個長程任務涵蓋 13 至 25 個步驟,重點不只是在動作準確,還包括進度保持、結果驗證和失誤後恢復。

對做機械人研究、具身智能系統,或要把語言理解和實體控制接起來的團隊,這個項目提供了一個較完整的分層基線;限制也很明確,公開版本先集中在 joint-control,較適合有相應訓練與部署條件的環境。

項目主頁 · GitHub · 模型

Categories: 開源, 多模態模型, 模型訓練, Qwen, NVIDIA, VLA, World-Action Model, Python

NAPE 簡化自監督音訊片段訓練

NAPE 以因果 Transformer 預測下一個音訊 patch embedding,省去解碼器與 tokenizer,探索更精簡的音訊表徵學習方法。

NAPE Architecture

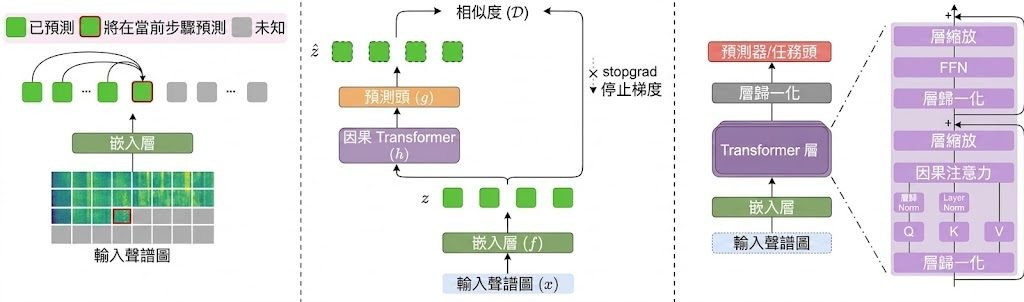
音訊模型要兼顧訓練成本、表徵能力與模型規模,往往需要加入多個輔助模組。NAPE(Next Audio Patch Embedding prediction)是一個自監督音訊表徵學習框架,將 log-mel spectrogram 切成 patch,再由因果 Transformer 根據前面的片段預測下一個 patch embedding。

NAPE 沒有 reconstruction decoder、acoustic tokenizer、student-teacher 架構或額外正則化損失。它依靠三個機制維持學習訊號:causal masking 隱藏未來位置、prediction shift 要求位置 t 預測 t+1,以及 stop-gradient 固定目標 embedding,避免模型退化成輸出相同向量。

二維 spectrogram 會按指定 scanning order 轉成一維序列,研究涵蓋 raster、diagonal、zigzag 和 time-major 四種排列;其中 raster、diagonal 及時間方向的排列較符合聲音事件的發展。模型在 AudioSet 預訓練,再於 AudioSet-2M、AudioSet-20K、ESC-50、Speech Commands V1/V2 和 IEMOCAP 進行微調或 linear probing,資料顯示它在多項任務取得 state-of-the-art fine-tuning 結果,並具備穩定的跨規模擴展能力,但原始資訊沒有提供各項具體分數。

要求系統有 Python 3.10、PyTorch 2.8.0 和 Transformers 4.56.2 的環境,並提供 requirements 檔及部分資料集處理程式;ESC-50、Speech Commands V1/V2 和 IEMOCAP 有下載腳本,AudioSet 則要自行處理涉及 YouTube 的下載流程。研究團隊亦列出程式碼及預訓練 checkpoint 的發布資訊,但 Hugging Face checkpoint 仍標示為待辦,不能把完整模型取得流程視為已經齊備。

  • 訓練訊號精簡:只用下一個 patch embedding 預測與 stop-gradient。
  • 適合音訊表徵:可支援語音指令、環境聲音及情緒辨識等任務。
  • 排列順序有影響:spectrogram 的線性化方式會改變模型看到的時間關係。
  • 測試門檻清楚:需要 AudioSet 或下游資料集,以及 W&B 追蹤實驗。
  • 限制在資料流程:AudioSet 不提供同等簡化的下載方式,checkpoint 取得狀態亦未完全明確。

項目主頁 · GitHub

Categories: 開源, Embedding, 模型訓練, Audio, Python, 語音

ForgeWM 把遊戲世界模型推向 72 FPS 即時互動

由中大、騰訊等團隊開發的 ForgeWM,將遊戲畫面生成壓縮至一至四步,讓鍵盤、滑鼠及手掣輸入能即時改變虛擬世界。

ForgeWM

中香港中文大學、騰訊 PCG、復旦大學、上海人工智慧實驗室及香港科技大學的研究團隊,將 ForgeWM 做成開源的 action-conditioned video world models 訓練項目,處理遊戲輸入與連續畫面生成難以兼顧的問題。它以 Matrix-Game 2(MG2)為基礎,讓模型根據鍵盤、滑鼠或 gamepad 操作即時推演遊戲畫面。

ForgeWM 的價值在於把生成步數降至 1、2 或 4 步,換取更低延遲的互動體驗;取捨是畫面質素、控制準確度與推理速度仍要依賴訓練資料和硬件。相較只展示影片生成的做法,ForgeWM 直接處理 frame-aligned 的動作訊號,並將同一套流程移植到另一個 gamepad 驅動的 FPS 領域。

  • 一套四階段流程:bidirectional SFT、teacher-forced causal AR、consistency distillation、on-policy DMD
  • ForgeWM-1、ForgeWM-2、ForgeWM-4 分別對應一、二及四步生成
  • 單張 H20、352×640 畫面下,1-step 模型最高達 72 FPS
  • 完整公開 weights、training code 及 pre-encoded data

模型並非各自獨立訓練:Stage 0 先對目標遊戲作 bidirectional fine-tuning,之後固定為教師;Stage 1 將生成器改成 causal AR,Stage 2 壓縮 sampling trajectory,Stage 3 再用學生自行 rollout 的結果進行 on-policy matching。這個結構讓 ForgeWM-1、-2、-4 可從相同基礎流程按步數預算建立。

研究、遊戲 AI 及需要即時互動生成的團隊較容易受益,尤其適合測試鍵鼠控制的 Minecraft 或 gamepad FPS。資料提供的指標包括 168 ms per chunk、72 FPS 及 8×H20 完整訓練配置;模型及數據連結整理環境,要預留 8 張 H20 重現完整訓練流程。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, 上海人工智慧實驗室, 騰訊, 世界模型, 模型訓練, Video, World-Action Model

FACET-Terminal:讓終端任務由可執行環境先行生成

FACET 把技能、Docker 環境、解法與驗證器連成同一狀態,產出可真正執行驗證的終端任務。

FACET: Preserving Source Intent and Executable State in Terminal Task Synthesis

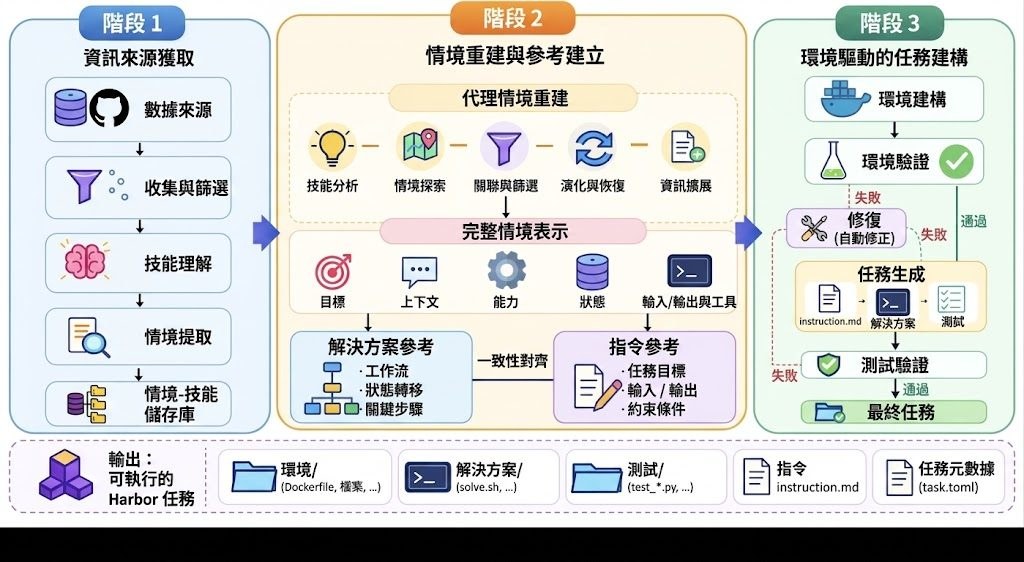
終端 AI Agent 最怕指令寫得合理,環境、解法和驗證器卻互相對不上。FACET(Fine-grained Agentic Construction of Executable Tasks)是一套終端任務合成框架,先建立並修復 Docker 環境,再讓指令、參考解法和驗證器共享同一套執行狀態,處理複雜任務難以穩定測試的問題。

項目由 71,341 個來源技能整理出 7,852 條場景—技能種子,最後取得 6,078 個通過執行驗證的任務,並從成功 rollout 篩選約 1.2K 條完整軌跡,用於監督微調 Qwen3.5 系列模型。環境中的檔案、路徑、套件、連接埠、資料結構和測試資料會沿流程傳遞,減少純文字交接造成的落差。

資源包括 FACET-Terminal-Tasks-6k 數據集,以及 FACET-Terminal-Qwen3.5-4B、9B 和 27B 模型。要重現任務合成流程,需要 Python 3.11–3.13、uv、Docker 和模型 API;配置與 Python 程式集中在 facet/,並提供 FORWARDREVERSEJOINT 三種生成策略作比較。

Terminal-Bench 2.1 的三次獨立執行平均結果顯示,4B、9B、27B 模型分別由 17.60、27.34、40.82 提升至 24.72、35.58、47.57;4B 相對提升 40.5%,27B 更接近同設定下 Qwen3.5-397B 的 49.06。這批數據規模仍然有限,任務質素亦依賴 Docker 環境和驗證器是否正確,較適合研究 Agent 訓練、Terminal-Bench 評測及需要可重現終端操作的團隊。

  • 資料基礎:6,078 個通過執行驗證的任務
  • 生成方式:環境先行,指令、解法與驗證器共享狀態
  • 公開模型:Qwen3.5 4B、9B、27B
  • 評測結果:27B 在 Terminal-Bench 2.1 達 47.57
  • 適合場景:終端 Agent 訓練、任務合成及可重現評測

項目主頁 · GitHub · 模型

Categories: 開源, 上海人工智慧實驗室, Agentic, 模型, 模型訓練, API, Python, 中國, Dataset 數據集

SkillGate:9B 模型修補任務中的技能

SkillGate 針對代理在長任務中揀技能時得不到足夠學習訊號的問題,將選擇與執行分開計算。你可以把它理解成一套訓練方法,讓模型學懂何時讀哪份技能文件。

SkillGate mechanism demo

SkillGate 是一套用來訓練 agent 選技能的開源方法,處理的是長鏈任務裡「揀啱技能」比「做完動作」更難學的問題。它把技能讀取視為中途決策,避免單靠結果獎勵去反推整條路徑,令選擇技能的 token 不再被後段執行訊號沖淡。

SkillGate 同時分出兩條互不干擾的信用路徑:結果分數只回傳到執行 token,而動作局部的優勢值只回到技能名稱 token。這樣做的目的,是讓模型在讀技能文件時得到更直接的學習訊號,而不是等整段任務成敗去間接修正。

作者做了 12,800 條訓練軌跡分析,指出技能選擇 token 的損失權重中位數只有 0.14%,而且不少樣本的優勢值會因為後段失敗而變成負值。這類「selector credit starvation」問題,正是 SkillGate 想修正的核心。

在五個 agentic 基準上,9B 規模版本錄得 53.2% 試驗成功率,屬於同級裡較強的結果。資料集和模型都已公開,訓練與評估亦配合字節對齊的實際提示詞流程,適合做 agent 訓練、技能庫管理,或者研究長鏈強化學習的人參考。

  • 把技能選擇同任務執行分開計分,減少信用稀釋
  • 針對 mid-episode 技能讀取決策,不只看最終成敗
  • 9B 版本在五個 agentic 基準上有 53.2% 成功率
  • 公開了模型同資源,方便重現同類訓練流程
  • 對需要大量技能庫的 agent 系統較有參考價值

GitHub · 模型

Categories: 開源, Agentic, 模型訓練

moe_vie 視覺編碼器:CLIP 規模 MoE 化,最細版本也貼近 SOTA

Meta 團隊把 Mixture-of-Experts 帶進 CLIP 風格視覺編碼器,用細粒度專家路由配合自訂 Triton kernel,在零樣本分類與檢索上貼近體型大 1.7 倍的 SOTA 編碼器。

Repository image for facebookresearch/moe_vie

視覺編碼器愈變愈大,準確度換來的是推論成本與延遲同時膨脹,特別是高解析度圖片與長影片情境。MoE-ViE 想打破這個取捨:把 Mixture-of-Experts(MoE)機制引入 CLIP 風格的對比預訓練流程,讓模型總容量擴大,但每張圖、每段片只啟用一部分專家,把容量與實際計算脫勾。

與一般 MoE 不同,MoE-ViE 採用細粒度專家拓樸(fine-grained MoE topology),並提出一個無輔助損失(auxiliary-loss-free)的變體來平衡專家負載,避免傳統 MoE 常見的負載不均問題。同時,作者針對 MoE 額外開銷撰寫了專門的 Triton kernel,把推論延遲拉回接近密集模型的水準。

項目以 Vision Transformer 骨幹搭配上述 MoE 設計,配合穩健的對比預訓練流程(contrastive pretraining recipe),一口氣釋出 B / L / H 三個尺寸的模型,覆蓋 224 / 384 / 448px 解析度。在 ImageNet-1k、ObjectNet、COCO 文字檢索圖片、Kinetics-400、MSR-VTT 文字檢索影片等基準上,零樣本表現與各項強 CLIP baseline 相當甚至更佳,其中 H/14 版本在保持約 76% 延遲的情況下,貼近體型大 1.7 倍的 SOTA 編碼器。當對接 LLM 組成視覺語言模型時,MoE-ViE 在圖像與影片基準上亦勝過多個啟用參數多達 5 倍的編碼器。

另一個針對影片能力的處理方式是 frame-level distillation 加上一個新設計的凍結機制,目的是在引入影片理解的同時保留原本學到的圖像知識。這個步驟令同一組視覺編碼器可以同時服務圖像與影片任務,而不必訓練兩套模型。

重點摘要:

  • MoE 化的 CLIP 風格視覺編碼器:以 Mixture-of-Experts Vision Transformer 配合對比預訓練,支援 B / L / H 三種規模。
  • 細粒度專家拓樸 + 無輔助損失平衡:避免傳統 MoE 的專家負載不均,並以自訂 Triton kernel 控制推論延遲。
  • 圖像與影片兼顧:frame-level distillation 配合新凍結機制,讓單一編碼器同時處理圖像與影片理解。
  • 對接 LLM 後仍具競爭力:在多項圖像與影片基準上,表現勝過啟用參數多達 5 倍的既有編碼器。
  • 官方釋出代碼與零樣本評測套件:提供模型定義、配置檔與可重現的零樣本評估流程,惟授權為 CC BY-NC 4.0,需留意非商用限制。

本項目由 Meta 團隊發佈。需要留意的是授權為 CC BY-NC 4.0,僅限非商用場景使用;訓練細節、資料組成與對齊 LLM 的實作屬研究配置,重現成本不低,較適合作研究基準而非即取即用的產品元件。

GitHub · 模型

Categories: 開源, 多模態模型, 模型訓練, Meta

V-RAE 重整影片潛空間,生成更快更準

V-RAE把影片生成前最難處理的時間冗餘壓細,同時保住語意結構。對想做重建、生成同預測建模的團隊,呢個方向幾有參考價值。

V-RAE method

做影片生成時,潛空間一旦又大又雜,訓練速度、重建品質同後續生成都會一齊受拖累。V-RAE放喺呢個位置切入:它屬於影片表示自編碼器模型,將 frozen vision foundation model 的表徵再壓成更緊湊的 generative latents,處理的是影片表示太冗長、但又不能失去語意同動態連續性的問題。

V-RAE不是重新訓練整個視覺骨幹,而是接在 DINOv3、SigLIP2、V-JEPA2.1、EUPE 這類 frozen encoder 之上,用 lightweight temporal pooling module 減少時間維度上的重複資訊,再交由 video decoder 重建連續動作。這種做法的取捨在於,它更依賴現成視覺表徵的品質,但換來較輕量的影片 latent 壓縮流程,亦令 semantic latents 可以變成 directly decodable predictive state space。

V-RAE:重构视频潜在空间以实现高效生成 2026-08-16

項目提供了訓練、評估與重建示例所需的程式結構,安裝條件寫明要用 Linux、NVIDIA GPUs、CUDA 相容驅動、FFmpeg,以及 Python 3.10 或以上。可配合已釋出的 checkpoints 與對應 frozen encoder 做重建測試,但能否自由下載、下載範圍是否完整,仍要以當前發佈頁面為準,不適宜直接假設任何人都可無限制取得全部模型。

結果 V-RAE在 K600 reconstruction 取得 2.13 rFVD,數值優於文中比較的大型 pretrained video VAEs;class-conditional generation 則在 UCF101 與 K600 分別達到 117.86 與 19.16 gFVD,並提到可快最多 6 倍收斂。作者亦提出 tFVD,令它與人類判斷的一致性提升,在 UCF101 與 K600 的 Pearson correlation 分別達到 r = 0.621 與 r = 0.919,這點對影片生成評測有直接意義。

  • 接在 frozen vision foundation model 後面做壓縮,避免由零建立整套影片表徵
  • 用 temporal pooling 減少時間冗餘,同時保住 semantic structure
  • 同時覆蓋 reconstruction、class-conditional generation 與 predictive modeling 場景
  • 倉庫已包含 training、evaluation、sampling 所需結構,但部署前提偏向研究級 Linux + NVIDIA GPU 環境
  • 適合研究影片生成、世界狀態建模、長序列表示學習的團隊參考其 latent 設計

V-RAE較適合有影片模型實驗能力的研究團隊、做 VideoDiT 類生成流程的人,以及想把影片 latent 拿去做預測狀態空間建模的項目。對於怎樣把強大的視覺表徵轉成更可生成、可重建、可評測的影片 latent,已經給出一條相當具體的路線。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Linux, Python

needle:14MB 本地工具模型,專攻結構化操作

Needle 2 把工具呼叫、裝置操作和結構化抽取收進單一 14MB 引擎,本地跑完整對話只需約 28MB RAM。它適合要低記憶體、離線部署又要輸出 JSON 的工作流。

Needle

Needle 2 屬於用於 tool calling 的小型模型,同時處理 device use 和 structured extraction。它把輸入文字轉成可直接接入工作流的結構化結果,適合在本地裝置、隔離網絡環境或資源很緊的情況下部署。

這個 Python package 提供 inference、LoRA fine-tuning 和 export,安裝後會先從 Hugging Face 下載一次 engine,再在本機快取,之後不再依賴網絡。開發者只要描述工具,模型就會按 schema 產生 JSON,並用 byte-level grammar 收窄輸出範圍,減少格式跑偏。

This 14MB AI Model Runs Locally — Needle 2 Explained

它和同類小模型的取捨很明確:45M 參數、單一 14MB binary,換來的是極低記憶體佔用和離線運行能力;官方測試也顯示,它會和 FunctionGemma 270M、LFM2.5 230M 及 Apple FM 互有勝負,但體積小得多。另一個做法是加入 confidence score,低於門檻就可以交回人工或上層流程處理。

  • 單一引擎打包,部署時不用分開管理權重檔
  • 以 JSON 與 schema 約束輸出,方便串接工具鏈
  • 支援大量工具目錄,但每輪只取 top five
  • 256-token sliding window 令記憶體維持在約 28MB
  • 適合離線裝置、邊緣設備和需要穩定結構輸出的團隊

GitHub · 模型

Categories: 開源, 模型, 模型訓練, Python, , 蘋果

Qwen-Video-Edit:開源影片編輯模型

它把文字指令式影片編輯做得更直接,透過現成的 image editing model 去改寫影片 latent。對需要長片段、分段修改同一條影片的工作流,會比重起一套 video transformer 更省力。

input contact sheet

Qwen-Video-Edit 是一個 instruction-based video editing 項目,核心做法是把 Qwen-Image-Edit 直接搬去處理影片 latent,再用兩個可訓練 projection 接上 Wan 2.1 的 video-VAE。這樣做的價值很清楚:不用再依賴 video-pretrained transformer,也能按文字指令改影片內容。

安裝和測試路線已經整理得相當明確。train.py 走單機多 GPU 訓練,infer.py 負責長影片逐段編輯與 Wan 2.2 denoising-enhancement,dataset.py 則讀取 Ditto 格式的 source、edited、instruction 配對。

和一般影片編輯方法相比,差異在於它不是從頭學影片理解,而是借用影像編輯模型的先驗,再用 warm-started projections 與 grid positional encoding 去補上時間維度。這代表訓練成本和架構複雜度較低,但限制也在於效果仍仰賴 Wan 2.1 latent 空間、Ditto-1M 資料,以及後段 enhancement。

  • 支援 LoRA 或 full fine-tuning,取捨在訓練成本與自由度之間
  • 長影片可以分段套用不同指令,適合剪接、局部修改、旁白對齊內容
  • 輸出 checkpoint 以 trainable-weights-only .safetensors 形式提供,載入流程較直接
  • 另有 zero-training demo,可先看 image-grid 與 latent-grid 編輯行為
  • 模型權重已公開,方便直接做復現或二次改造

項目主頁 · GitHub · 模型

Categories: 開源, 視頻模型, 模型訓練, Qwen, Video, Image, 影像模型, Dataset 數據集

Page 6 of 23
1 4 5 6 7 8 23