StreamingSwap 把影片換臉推向 20 FPS 即時串流

StreamingSwap 針對長片換臉的身份穩定與速度取捨,透過較短上下文支援單卡即時處理。

StreamingSwap

長時間影片換臉最難維持的不是單幀效果,而是身份一致、原有動作和畫面細節能否一路穩定。StreamingSwap 是一個參考圖像引導的影片換臉模型框架,處理把來源身份轉移到目標影片、同時保留目標人物屬性與動態的問題。

它分兩個階段改善速度與穩定性。Face-RoI Generation 只集中處理臉部區域,配合按噪聲程度調整身份與重建比重的 Joint Rec-ID Loss;其後以 Short-Context Rollout Training 使用模型生成的歷史畫面,減少串流生成中的誤差累積。這套方法針對換臉只改變身份、其他視覺內容大致不變的特性,補足單靠 flow-matching supervision 對身份差異不夠敏感的問題。

提供的結果包括:
– 單張 NVIDIA RTX 4090 達到 21.174 FPS 的端到端吞吐量
– 評估影片最長達 10 分鐘,並展示 19 分鐘、20 FPS 取樣的直播串流測試
– HumanFaceVid 包含 1,000 小時電影風格訓練資料,以及各 200 段短片和長片評估集
– 研究結果在身份轉移和視覺質素之間取得具競爭力的平衡,但資料建構程式和訓練資料仍標示為準備中

電影後期、直播特效和長片角色替換等情境,較能受惠於這種空間與時間上下文都較節省的做法;單卡 RTX 4090 的測試結果亦令即時串流更接近可行範圍。項目提供的是研究模型與展示資料,原始資訊未交代完整安裝指令、未有直接下載的模型權重或訓練資料,因此不宜當成已可隨意下載使用的成品。
項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, NVIDIA, Video, Image, 框架, Dataset 數據集

SWIFT 把擴散模型的訓練誤差轉成性能優勢

有限訓練令擴散模型偏離理想預測,SWIFT 從較弱模型找出偏差方向,再把訓練目標推向更準確的位置。ImageNet-256 上,它在不改採樣器的情況下取得具競爭力的 FID。

Og image

擴散模型訓練時間有限,預測結果往往未能到達理想的後驗平均值;SWIFT(Self-guided Weak-to-strong dIFfusion models via Target extrapolation)利用這種可預測的偏差,改善模型生成影像的能力。它適合關注影像生成品質、又希望保留原有推理流程的研究者與模型開發者。

SWIFT 先使用一個凍結的弱模型,估計目前模型會在哪個方向偏離理想預測,再把訓練目標沿相反方向外推。訓練時改變的只有預測目標,損失函數、權重、網絡架構及採樣器都維持不變;使用時無須更換原有採樣器。

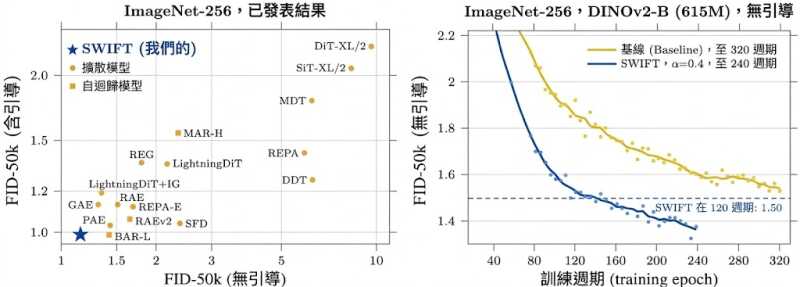
在 ImageNet-256 評測中,SWIFT 不使用 guidance 時的 FID 為 1.15,使用 guidance 時為 0.99。研究亦在配對的 DINOv2-B 設定下比較訓練進度,SWIFT 在訓練過程中持續領先基準模型。

  • 以凍結的弱去噪模型估計訓練偏差方向。
  • 將乾淨樣本與弱模型預測之間的差距用來外推回歸目標。
  • 保留原有模型架構、損失設定及採樣器。
  • ImageNet-256 的 FID 為 1.15(無 guidance)及 0.99(有 guidance)。

這種方法針對的是有限訓練預算下的模型誤差,並非更改生成時的採樣流程。現有內容未提供完整安裝或使用步驟,採用 SWIFT 前仍需查閱論文及相關資源確認實作細節。

項目主頁

Categories: 南京大學, 阿里巴巴, 模型, 模型訓練, Image

PhysSkin++ 令 3D 模型郁得唔再硬掘掘!

PhysSkin 把靜態 3D 形狀轉成可泛化的物理動畫控制,減少每個模型重新訓練的成本。

teaser

不同模型形狀、網格密度甚至空間表示法各異,物理動畫往往要重新建立變形控制。PhysSkin 屬於 3D 動畫模型,透過自監督 Neural Skinning 學習連續 Skinning Fields,讓不同形狀可以共用即時物理動畫能力。

模型先用 transformer-based shape encoder 讀取形狀,再由 cross-attention field decoder 產生與形狀相關的變形子空間;physics-informed self-supervised objectives 則以物理約束和正交性要求取代完整模擬軌跡標註。這個組合針對的是泛化能力與運算速度之間的取捨,而不是單純追求更細緻的離線模擬。

README 提供 Python 3.11、PyTorch 2.7.1 等環境版本,以及資料目錄、physskin_vis.ipynb 視覺化筆記本和訓練流程。資料包含 (1, 256, 768) 的 float32 latents 與三維內部點,項目亦列出預訓練 checkpoint 路徑;原始資料沒有交代公開下載方式,不能因此假設模型可隨意取得。

  • 可跨不同形狀與 discretization 使用連續 Skinning Fields
  • 以自監督物理目標減少動畫標註依賴
  • 支援即時 physics-based animation 的研究與互動控制場景
  • README 沒有提供具體 FPS、誤差或同類方法差距

對動畫研究、3D 內容工具及需要碰撞互動的圖形團隊,PhysSkin 更適合用作研究原型或既有 rig 的物理補強。配套的 PhysSkin++ 描述進一步延伸至 meshes、point clouds、NeRFs 和 3D Gaussians,但這些能力不應直接當成本 GitHub 項目中同一 checkpoint 已完整提供的功能。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, 工具, 3D, Python, 動畫

SolarRenderer:Minimax H3 四步完成影片

SolarRenderer 將遊戲引擎或智能體輸出的結構訊號,於 MiniMax-H3 上以四步推理生成風格統一的影片,並以區塊串流方式即時輸出畫面。

teaser

過往要做「結構可控」的影片生成,往往要為每種輸入(灰盒、語義圖、骨骼、深度)各自訓練一支分支模型。SolarRenderer 試圖打破這個分工限制:它以兩組 LoRA 在 MiniMax-H3 上做 post-training,無需 condition-type label,純粹由 prompt 描述結構本身,再交由模型自行解讀。同一段結構影片,配合首幀與文字描述,可以分別輸出寫實、動漫、像素或水墨等風格。

更直接的價值在於速度與即時性。對比 50 步取樣,SolarRenderer 的四步推理聲稱快 12.3 倍,並在影像質素與結構保真度上同時達標。配合兩組 LoRA 的 block-causal 版本,影片可以逐區塊即時生成,每完成一塊便即時輸出,等候延遲約 0.7 秒出一個 17 幀區塊,整體滯後約 1.1 秒。對 agent 互動或即時預覽這類工作流,這個差距幾關鍵。

訓練資料與評估同為開放:weights、訓練資料,以及涵蓋 208 個高難度案例、53 段 held-out 影片的 benchmark 套件,連同評分代碼、輸出結果與裁判評語一併釋出。項目建基於 SolarWM 框架,並非隨意下載的開源玩具,但對從事可控影片生成、世界模型或 agent 影片預覽的研究者與團隊而言,是一個值得排入評估名單的選項。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 世界模型, 模型訓練, Video, Image, 框架, Dataset 數據集, MiniMax, LoRA

FocusGUI 自動揀對的訊息做 GUI 代理

南洋理工大學與阿里共同發表的 FocusGUI,主打用極少可訓練參數處理多模態 GUI 代理嘅分心問題。你能把它理解成幫現有多模態模型動態挑選畫面、音訊、影片當下最相關訊息嘅外掛模組。

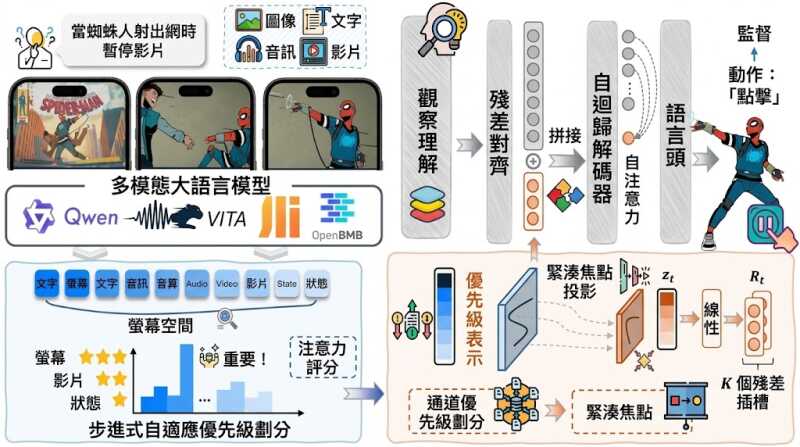
FocusGUI architecture: channel prioritization, compact focus, and residual alignment with a frozen decoder

南洋理工大學與阿里巴巴合作的 FocusGUI,試圖解決多模態 GUI 代理一個很具體的困擾:畫面、音訊、影片、互動紀錄同時湧進來,模型往往被不相關的訊息干擾,導致操作軌跡逐步失控,研究團隊稱之為「Sequential Distraction」。FocusGUI 的回應方式相當克制——它是一個輕量的 adapter(適配器),只在每一步動態替當前決策挑選最相關的多模態證據,再壓縮成低維潛向量,最後透過零初始化的殘差注入到凍結 decoder 的嵌入空間中。原始的 Transformer decoder 與語言模型頭完全不被替換,背骨模型也保持凍結。

它和一般做法的主要差別,是不把整段完整觀察平均塞進去處理,而是針對每一步決策參考做「step-adaptive prioritization」。頻道分解先拆解當下觀察裡互補的證據來源,緊接著做加權,再壓縮成低維表示,最後用殘差對齊方式回接到動作生成邊界。輸出仍以結構化 JSON 形式自迴歸生成,方便整合到既有的 GUI 代理 pipeline。對於已有穩定 GUI 代理系統、想提升多模態場景精準度但不想重新訓練底層模型的團隊,FocusGUI 提供了一條低侵入式的升級路徑。

對開發者而言,這代表幾個直接的好處:訓練時只需要動作標註,不依賴模態相關性標註;可訓練參數只有 1.15 至 1.45 百萬,卻在四款多模態背骨模型上把 Type Match 提升 33.2 個百分點,Exact Match 從原本的 11.2% 提升至平均 33.5%,相對於凍結底層提升約三倍,並在 24 個測試場景全部取得最佳表現。對比目前最強的增強方法,Type Match 仍領先 30.1 個百分點。

項目適合負責多模態代理研發、GUI 自動化測試、或在手機與桌面環境構建 Agentic 流程的團隊。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio

Google Harness² 讓 Agent 自我改良執行系統

Harness² 能在模型不變下,按任務改進提示詞、工具與技能,並將經驗沿用至後續任務。

Harness²

Agent 的落差往往不只來自模型能力,提示詞、工具配置、記憶和任務編排同樣影響結果。Google Research 開源的 Harness²,便是一個處理這層「執行系統」的研究框架:它固定模型權重,先按眼前任務調整 harness,再把成果與經驗帶到下一項任務。

它的核心是兩層遞迴。Task-level recursion 透過 Propose–Probe–Compose,先提出修改、在相同任務測試效果,再整合有效部分;Harnessing-level recursion 則把已採用的 harness 與有證據支持的經驗寫入持久 improvement harness,協助後續改進。這種取捨是把資源由重新訓練模型,轉向持續優化模型周邊配置。

  • 模型權重固定,主要改進 prompts、tools、memory、skills 與 orchestration。
  • 不依賴標準答案,以同一任務不同執行結果的行為差異作為回饋。
  • 支援 parallel、sequential recursion,以及 OpenCode、Codex executors。
  • 可配合 JobBench、LAB、WorkBuddy-Bench 測試。

在四種 model–harness 組合中,Harness² 為 GLM-5 與 Gemini 3.5 Flash 的基礎 harness 帶來提升:WorkBuddy-Bench 最高增加 11.5 分,JobBench 增加 4.5 分,LAB partial pass rate 增加 11.8 個百分點;提高 task-level recursion budget 還可繼續增加結果。不過,資料涵蓋三個專業 benchmark,尚不足以證明所有工具和模型組合都能受惠,而且每輪提出、測試及整合會增加執行成本。

需要多工具、複雜編排或持續接力的 Agent 團隊,較能感受到這種架構的價值;維護者可用 JobBench 流程建立環境,再按自身 executor 與評估基準測試。研究人員亦可沿用遞迴設計,但應核對額外呼叫、錯誤傳播及 improvement harness 累積錯誤等問題。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, Google, Gemini, 提示詞, 框架, 工具, Dataset 數據集, Skill 技能

CoPE 讓 Agent 逐步預測行動,節省一半訓練樣本

CoPE 以多步行動預測補強 Agentic RL,在不增加推論成本下,提升語言智能體的學習效率。

CoPE

長軌跡只靠完結時一次獎勵學習,往往會令多數步驟欠缺直接回饋。CoPE 是建基於 AgentGym-RL 及 verl 分支的強化學習框架,透過逐步預測智能體接下來會採取的 K 個行動,為每個決策位置加入更細緻的訓練訊號。

模型骨幹同時負責 acting 與 forecasting:智能體按既有 policy 行動,並在每一步預測未來行動;完成 rollout 後,真實行動序列會監督預測結果,再把學習成果蒸餾回同一個 policy。關閉相關功能後,訓練路徑便維持標準 Group Relative Policy Optimization(GRPO),方便按研究需要比較。

  • 每一步預測 K 個後續行動,補充終結獎勵欠缺的分步監督。
  • acting 與 forecasting 共用一個模型,不需額外模型或預訓練階段。
  • 推理時仍逐步行動,不加入額外運算開支。
  • 支援 SciWorld、ALFWorld、WebShop、AppWorld 及 τ²-bench 五個互動環境。

結果顯示,CoPE 在上述環境擊敗 GRPO 與 predictive-auxiliary baselines;樣本效率最高提高 2 倍,其中 ScienceWorld 為 2.0 倍、AppWorld 為 1.6 倍。任務成功率相對 GRPO 在 ALFWorld、WebShop 與 ScienceWorld 分別增加 5.0、12.5 及 8.0 個百分點。

配置需要 Python 3.10 訓練環境及獨立環境服務;WebShop 使用 Python 3.8,τ²-bench 需要 Python 3.12 或以上,並須取得 AgentGym submodule。這套架構適合研究互動式語言智能體、計算成本受控的團隊,以及比較 action forecasting 與稀疏獎勵訓練方法的開發者,但多環境配置與 GPU 需求增加了安裝門檻。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, 框架, Python, Meta, 強化學習

ScaleNav 把影片變成導航能力

ScaleNav 先從互聯網第一視角影片學習路徑規律,再轉成機器人動作,面對語言指定目標的局部導航。

ScaleNav navigation: real robot on the left, simulation on the right

網上第一視角影片 seldom 附帶機器人動作,但當中蘊藏大量「沿走廊前進、避開障礙、轉入目標房間」的視覺規律。ScaleNav 是一個研究型導航模型,試圖把這些 action-free 預訓練所得到的 navigation priors,轉移到有動作標籤的模擬軌跡,再用於 language-conditioned local navigation:按文字尋找初始畫面可見的目標並停下來。

模型屬共享式 Diffusion Transformer,會根據指令、目前 RGB 影像及記憶,共同預測未來 video latents 和 action chunks。流程分三階段:先從互聯網第一視角影片學習目標導向視覺動態,再進行 action alignment,最後 joint fine-tuning,同時保留影片回放並微調共享骨干與輸出頭。

ScaleNav 與同類做法的主要取捨,是毋須先收集大量完整機器人示範,便能借助互聯網影片建立導航先驗;代價是仍要依賴模擬軌跡、動作對齊及多階段訓練。官方模型約 10.02 GB,推論及評估建議使用支援 BF16 的 NVIDIA GPU、24 GB GPU 記憶體與 64 GB 系統記憶體,並按文件配置 Linux、Habitat-GS 和場景轉換工具。

結果涵蓋 HabitatGS-LN、Short-Horizon OVON 與真實四足機械人;公開資料列出 ScaleNav 在兩項模擬評估的成功率分別為 94.9% 及 86.5%,真實機械人則在 60 次試驗中錄得 83.3% 成功率。團隊亦整理 gallery 導航影片、軌跡、目標與結果,以及 summary.json 內的 SR、SPL 和逐任務成績,方便比較與重現。

  • 影片預訓練不必附帶逐格動作標籤
  • 同一模型處理影片動態與動作生成
  • 支援模擬環境及真實四足機械人
  • 提供模型、資料、評估結果與操作文件

這套方法較適合研究 embodied navigation、 robotics 與 VLA(Vision-Language-Action)的團隊;評估數字雖亮眼,仍須留意各方法採用不同設定,跨模型比較應同時核對 episode 數、場景及 fine-tuning 條件。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, VLA, Robotic, 工具, Linux

MT-Forcing:多輪改圖守住細節唔再走樣

連續改同一張圖時,主體、紋理與構圖往往會慢慢偏離;MT Forcing 以多輪訓練與教師引導改善這類累積錯誤。

MT Forcing teaser

連續要求「改杯色、加條紋、再調光線」時,圖片往往未到最後一輪已經失真。MT Forcing 是針對多輪圖像編輯的訓練框架,配合自迴歸擴散模型,減少每輪修改帶來的漂移。

方法把單輪 DMD(Distribution Matching Distillation)與 Teacher-Forcing Guidance 結合:學生模型逐步編輯自己生成的歷史,凍結的單輪教師則從原圖一次套用累積指示,提供分布層面的引導。參考真實編輯軌跡後,模型既要改善畫質,也要維持跨輪次內容關係。

  • 以自身多輪輸出作為訓練歷史
  • 引入單輪 DMD 改善視覺品質
  • 用 Teacher-Forcing Guidance 減少誤差累積
  • 展示最長十五輪及八輪編輯比較

官方程式碼要求 Python 3.11.13、NVIDIA CUDA GPU,以及指定 checkpoint、架構資源和擴充 U1.5 tokenizer;配置完成後,可在同一工作階段依序執行多個編輯提示。公開資料未交代完整硬件門檻、推理速度或標準化定量結果,因此較適合作為需要 NVIDIA GPU 的研究重現工具,而非直接比較成本已知的消費級服務。

它以 SenseNova-U1.5 作為相關基礎模型,並在多輪比較中加入 MT Forcing。對需要逐步修訂產品 concept、人物姿勢或場景細節的設計團隊,單輪教師可作品質參照。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 清華大學, 模型, 模型訓練, NVIDIA, Image, 影像模型, 框架, 工具, Python, Tokenize

Scene-Designer:智能 3D 場景生成與設計

Scene-Designer 把場景生成、質素評估與反覆修正放進同一套 Agent 訓練流程,減少無效改動。

Scene-Designer bear logo

3D 場景生成最難的地方,往往不是砌出物件,而是知道場景是否合理,以及修正錯誤時避免愈改愈亂。Scene-Designer 是一個面向 Agentic 3D Scene Generation 的研究框架,目標正是讓模型學習設計場景、評審質素,再按評語作有效修正。

  • 以 Scene-OTA-35K 的 Observation–Thought–Action 軌跡學習設計與修改流程。
  • 透過 Scene-OTC-15K 的 Observation–Thought–Critic 經驗,比較場景質素。
  • 用 Branch-ranking reward 比較同一父場景產生的分支。
  • 以 Improvement reward 判斷子場景是否真正優於原場景。

Causal Trajectory Consolidation 會移除沒有下游貢獻的無效操作,同時保留有效決定及必要中間狀態。Scene perturbations 則刻意加入佈局偏差、功能退化和物理違規,再建立偏好比較,令模型不只是 spotting 錯誤,而是學習指出哪個場景較好。

Scene-GRPO 結合分支排名與改進獎勵,讓代理在相同起點的候選場景中選擇較佳設計,並減少沒有帶來實際進步的反覆修改。這種做法比只追求最終生成結果的訓練多了一層質素判斷,亦直接回應通用模型「識錯但不懂有效修正」的問題。

研究團隊比較了模型與 GPT-5.2 在成對場景比較及四場景偏好排序上的表現;首頁亦提供十組 prompt-to-scene 示範。不過,公開資料未交代完整安裝流程,Hugging Face 上已列出 Scene-Builder-Qwen3-VL-8B-Instruct 模型與 Scene-OTC-Bench 資料集,較適合具 3D 生成、Agent 訓練及模型評估經驗的團隊先行研究。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, OpenAI, 影像模型, World-Action Model, 框架, 3D, Dataset 數據集

Page 5 of 38
1 … 3 4 5 6 7 … 38