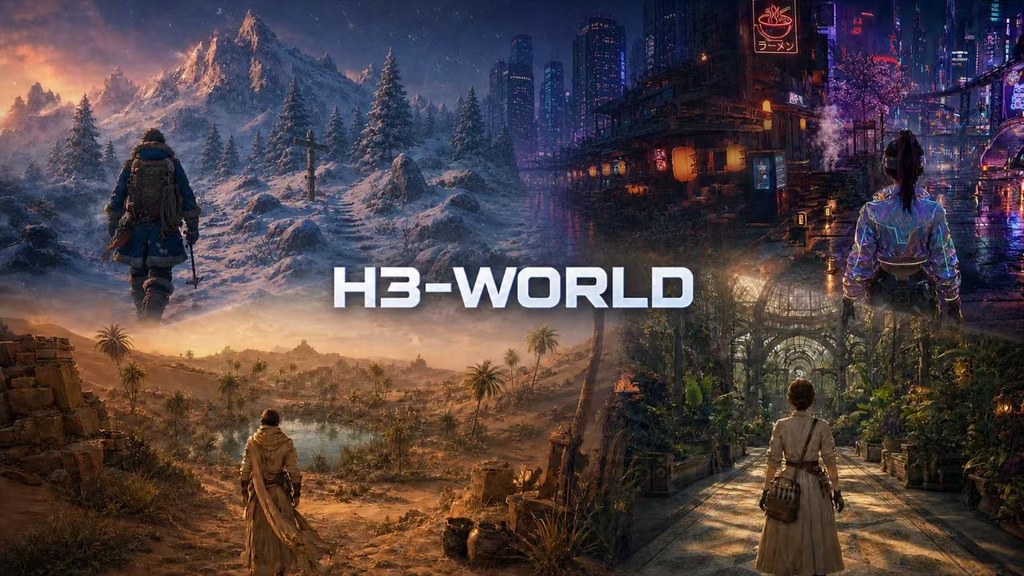
H3-World 讓鍵盤控制生成影片世界

H3-World把鍵盤輸入轉成可控制的未來畫面,展示互動式世界模型由理解指令走向操控環境。

Repository image for Danzer1xxxxChan/H3-World

按下 W、A、S、D 控制角色,或以 I、J、K、L 操控鏡頭,H3-World 便會由初始畫面生成相應的動作影片。這個項目屬於互動式世界模型,實際處理的是角色與鏡頭動作如何連貫地影響後續畫面,適合遊戲代理、視覺模擬及 Computer-use agents(CUAs)相關研究。

H3-World 建基於 MiniMax-H3,將每個鍵盤狀態轉換成對應未來 video latent 的語言指令,再透過 directed attention routing 把指令綁定到相應的 latent 區間。模型以 8,000 段 ABot-World-Explorer-500h gameplay clips 訓練,只學習 65.6M 個 Low-Rank Adaptation(LoRA)參數,約佔 33B backbone 的 0.199%,在保留大型模型能力與控制專用訓練成本之間取得折衷。

目前資料提供的重點包括:
– 角色控制使用 W、A、S、D;鏡頭控制使用 I、J、K、L,F 代表快速鏡頭移動。
– H3-World LoRA 是 MiniMax-H3 的 delta,不能直接套入未修改的 MiniMax-H3 pipeline。
– 推理需要約 135 GB 的 MiniMax-H3 base weights,以及 H3-World 的 directed-attention patch。
– 公開資料沒有列出明確的畫質、延遲或成功率比較,因此未能判斷它在不同世界模型之間的性能差距。

儲存庫提供 Python 3.10、CUDA 12.8、PyTorch 2.10.0 和指定版本 DiffSynth-Studio 的配置要求;模型權重及 LoRA checkpoint 則分別放在 Hugging Face 指定位置,訓練另需 ABot-World-Explorer-500h。研究團隊、遊戲代理開發者及需要可控影片生成的視覺模擬項目較容易受益,但硬件容量、專用 patch 和模型授權條款都是採用前必須核對的條件。
項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 多模態模型, 視頻模型, 模型訓練, NVIDIA, Video, Python, MiniMax

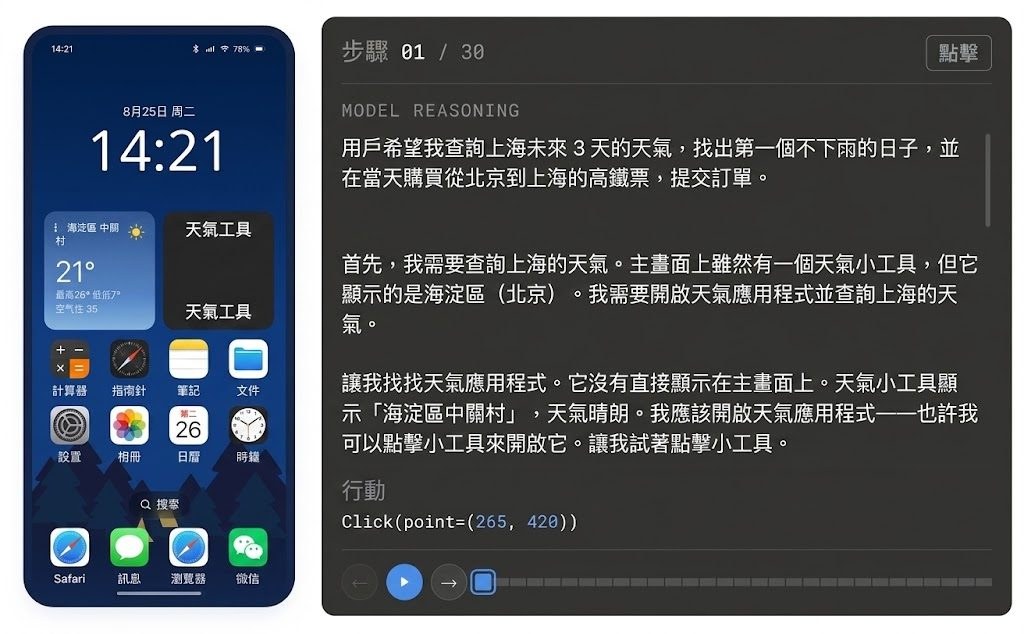
UI-Venus:多平台介面的高性能代理

UI-Venus 是一個針對手機、桌面和網頁介面的 GUI agent,重點處理視覺定位與互動導航。它用 35 萬筆專業標註資料和 RFT 提升長流程操作與跨平台泛化。

UI-Venus Performance Across Datasets

UI-Venus 是一個 GUI agent,直接面向手機、桌面和網頁介面,目標是解決看得懂畫面、點得準位置、又能沿著多步驟流程完成任務這幾個卡位。它把 Reinforcement Fine-Tuning(RFT)放進訓練流程,令動作預測不只是識判斷,仲可以連住環境回饋去修正下一步。

項目提供 7B 同 72B 兩個 checkpoint,亦交代咗評估流程同推理腳本,方便按截圖、標註檔同模型路徑去做測試。不過原始資料未提供完整安裝細節同實際部署步驟,較合理的理解係先用它的推理與評估流程驗證在 ScreenSpot-Pro、OS-World-G、AndroidWorld 等基準上的行為。

它的賣點不只是識辨認介面元件,而係把 credit assignment 放到長鏈路任務入面處理,令代理在連續操作時較易對齊目標。官方聲稱它在 AndroidWorld、ScreenSpot-v2、UI-Vision 同相關跨平台基準有競爭力,對需要自動化操作、界面導航同複雜任務拆解嘅團隊會較有吸引力。

  • 針對 GUI 理解同 action prediction,覆蓋 mobile、desktop、web 三類場景
  • 以 350K 高質量、專業標註樣本訓練,並加入 RFT
  • 提供 7B 與 72B checkpoint,以及評估和推理腳本
  • 強調長流程任務的 credit assignment,適合多步驟互動工作
  • 基準表現覆蓋 AndroidWorld、ScreenSpot-Pro、OS-World-G 等項目

對要做介面代理、手機自動化、網頁操作或桌面工作流整合的團隊,UI-Venus 比較像一個可以直接拿去評估能力邊界的基礎模型。它的限制亦清楚:原始資料未交代完整安裝與落地流程,實際接入時仍要按你手上的環境、介面類型同任務難度再做驗證。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, UI/UX

StudentSim:為每個學生建立模擬器,令輔導教學更準

StudentSim 把稀疏的學生紀錄轉成個人化模擬器,用來測試哪種提示或輔導真正改變答案。它同時處理答題相似度與對指導的反應,適合做教學策略比較。

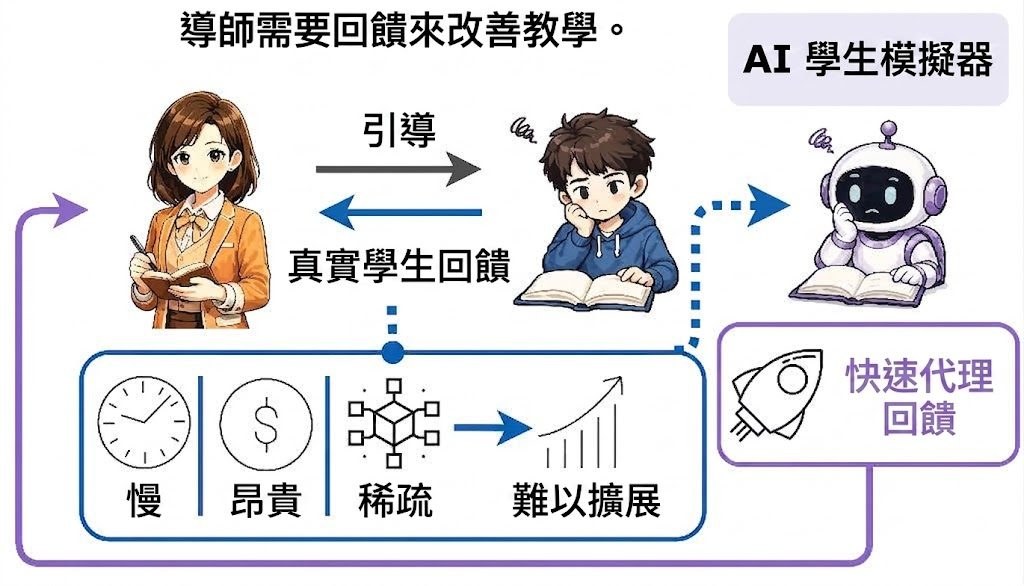
fig motivation

StudentSim 是一個由 Microsoft 研究的工具套件,核心是替每位學生建立獨立模擬器,解決「真實學生回饋太慢、太少、太貴」這個輔導優化難題。它先從多名學生的資料做 pooled training,再針對單一學生做 specialization,讓模擬器不只答得像,還要在收到指導後出現和原學生相近的變化。

它涵蓋 chess、second-language English writing (L2) 和 middle-school mathematics 三個場景,安裝時可按需要選擇 chessl2mathinferencetutor_rlbaselines 等 extras。訓練與評估可以在本地按模組跑起來,若要做 tutor reinforcement learning,還需要 libcairo 供棋盤繪製;涉及語言模型的步驟則要設定 AZURE_OPENAI_ENDPOINTAZURE_OPENAI_API_KEY

和一般只模仿答案的做法相比,StudentSim 更重視兩件事:一是 behavioral fidelity,二是 guidance responsiveness。前者看模擬器有沒有保留學生的能力層次與弱點,後者看學生收到輔導後會不會像真實紀錄那樣改變答案;在 chess 裡,它還示範了把 student simulator 當成 reward 來源,直接訓練 AI tutor 產生更有效的指導。

  • 可用來比較不同輔導語句對同一學生模型的影響
  • 適合教學科技、學習分析和 AI tutor 研究團隊
  • 支援多領域資料,方便觀察模型在不同學科的差異
  • 提供 closed-model baselines,方便和角色扮演式提示做對照
  • 評估不只看答對率,也看指導後是否真的改變行為

項目主頁 · GitHub

Categories: 開源, 模型訓練, 微軟

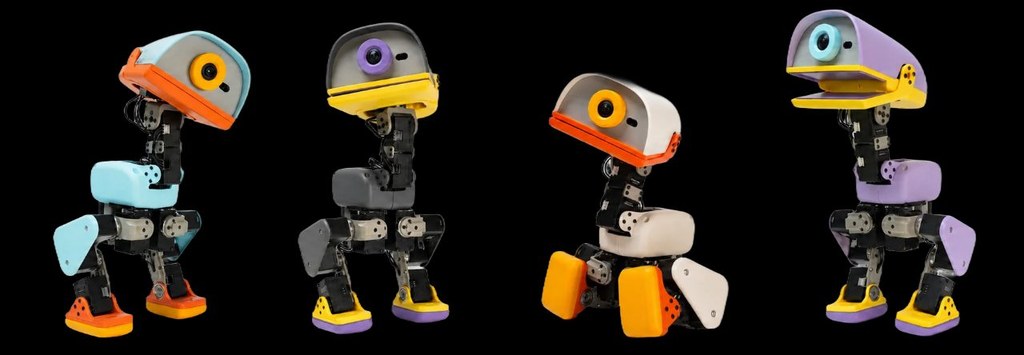
Microduck:細小雙足機械鴨的 RL 控制腦

Microduck 把雙足行走、拾取、起身與遙控操作收進同一套控制系統。它更像一個可落地的機械人控制項目,而不只是展示動作的樣機。

Repository image for pollen-robotics/microduck

Microduck 係一個機械人控制項目,核心係為約 25 厘米、800 克嘅雙足機械鴨提供執行層,解決步行、起身、拾取同模式切換呢類動作控制問題。它唔只做單一演示,而係把無線電、相機、更新流程同 50 Hz 控制迴圈一齊放入同一個執行環境。

呢個項目嘅做法係喺 Rockchip RK3566 上跑幾個 daemon,並用神經策略驅動 15 個伺服。策略本身喺另一個項目 microduck_rl 訓練,採用 MuJoCo、PPO 同 sim2real,再匯出做 ONNX 俾這邊載入;原始資料未提供完整安裝或部署步驟,只能確認佢有 cheat sheet 同 duckctl 等操作入口。

同一般遙控機械人相比,Microduck 將控制、感知同更新機制綁得更緊,重點係讓細小雙足平台可以穩定接收新軟件,而唔會刷壞機器。它亦支援兩套行走形態,行走同輪式模式可以切換,顯示出硬件形態同策略之間嘅配合。

  • 以 RL policies 驅動雙足動作,而唔係只靠固定腳本
  • 在 RK3566 上運行,控制迴圈為 50 Hz
  • 由 microduck_rl 提供訓練與 ONNX 匯出
  • 具備相機、無線電同更新管理
  • 目標場景偏向機械人開發、控制驗證同現場操作

對做機械人研究、控制系統整合,或者想測試 sim2real 流程嘅團隊,呢個項目會較有參考價值。評估數字喺提供資料入面唔多,但已經可以見到它把「細體積、雙足、可更新」呢幾個限制同時處理。

項目主頁 · GitHub · 項目

Categories: 開源, 模型訓練, Robotic

[技術文章] 淘寶直播 AI 主播團隊提出 HAT 訓練法 解決小模型難以跟上快速更新的張力

淘寶直播 AIGC 團隊針對直播帶貨 AI 主播的實時互動需求,提出 Harness-Aware Training(HAT)框架,令小模型能在頻繁更新的策略環境中保持低延遲與高適應力。

Hero image preview

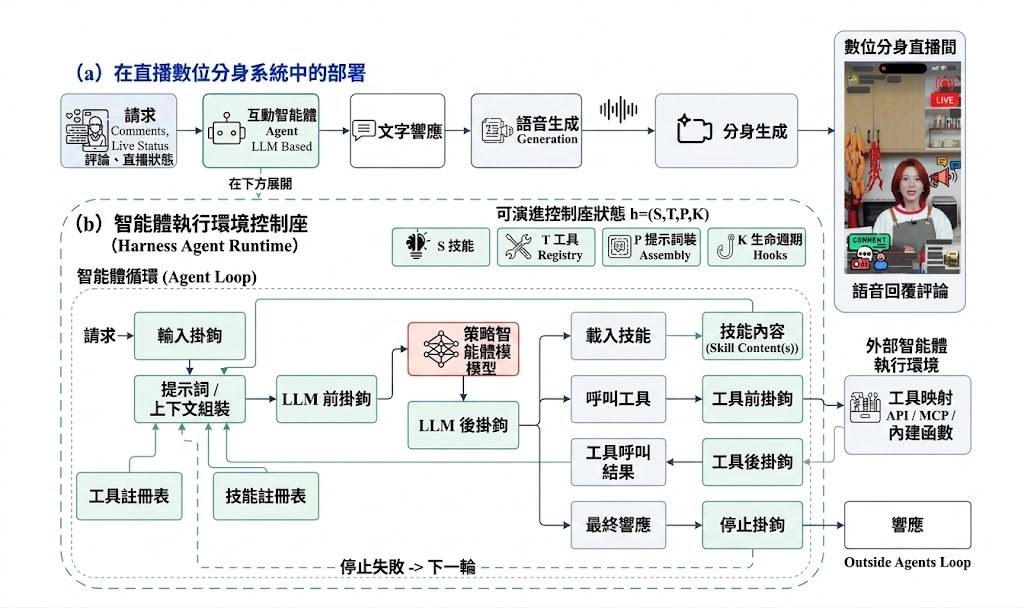
淘寶直播旗下的 TaoLive AIGC LLM 團隊發表技術報告,提出一套名為 Harness-Aware Training(HAT)的訓練方法,專門用於訓練能在直播帶貨場景中即時回答商品問題、與觀眾互動並執行營銷策略的數字人主播。團隊指出,直播帶貨對延遲極為敏感,同時行銷規則與商戶偏好又會持續變動,因此業界普遍採用「可演化 Harness」設計,把 Skills、Hooks、prompts 和 tools 與模型參數解耦,策略改動時不必重新訓練模型。然而這種做法帶來明顯取捨:大模型雖然泛化能力強,能夠零樣本適應 Harness 變動,但延遲太高;小模型延遲符合實時要求,卻容易過拟合到固定的 Harness 設定,一旦配置更新就需要重新訓練。

HAT 的核心思路是在訓練階段就讓模型接觸大量不同的 Harness 配置,使它學會「讀懂當前的 Harness」,而非記住某一個固定版本。具體做法引入 Harness-State Augmentation(HSA),對 Skill 識別碼、Skill 內容、工具 schema、prompt 結構及 Hook 函數施加保留任務語義的轉換。訓練分為三個階段:HSA-SFT 讓小模型從強模型生成、在多樣化環境中收集的高質量軌跡學習,直接提升推理與工具調用能力;General OPD 透過 On-Policy Distillation 在通用從基礎模型學習,恢復 SFT 過程中受損的泛化能力;HSA-RL 則在經 HSA 增廣的多樣化環境中做強化學習,進一步強化模型對變動 Harness 的理解與工具調用穩定性。

HAT 訓練的模型在 Live-Stream QA 上平均得分 94.8,明顯高於基礎模型的 80.3 和最強通用 LLM 的 93.0;在 Harness-Variant QA 上亦達到 94.6,遠超基礎模型的 75.4。傳統 Fixed-Harness SFT 會令 IFEval 分數較基礎模型下跌 7.7 分,而 HAT 不單避免這種下跌,更取得 83.5 分。在部署層面,模型可在單張 NVIDIA H20 GPU(啟用優化)上運行,P50 延遲 3.4 秒、P95 8.1 秒,已滿足實時互動門檻。系統已落地至淘寶直播的生產環境,線上 A/B 測試顯示相對 ReAct 對照組,Harness 實驗組在確認收貨 GMV 上帶來 4.33% 的 UV 標準化提升、商品頁瀏覽量提升 0.91%。

對需要快速疊代策略、又受制於延遲與算力的實時對話代理團隊而言,這份報告展示了一條可落地的工程路徑。

重點摘要
– 淘寶直播 AIGC 團隊針對直播帶貨 AI 主播提出 HAT 訓練框架
– 解決小模型過拟合固定 Harness、無法跟上策略更新的核心矛盾
– 透過 HSA 增廣與三階段訓練兼顧延遲、泛化與工具調用穩定性
– IFEval 分數避免傳統 SFT 出現的 7.7 分下跌,反升至 83.5
– 已在淘寶直播生產環境上線,A/B 測試帶來 GMV 與瀏覽量提升

Paper

Categories: 阿里巴巴, Agentic, 模型訓練, 框架, Skill 技能

[技術文章] 淘寶直播 AI 主播團隊提出 HAT 訓練法 解決小模型難以跟上快速更新的張力

淘寶直播 AIGC 團隊針對直播帶貨 AI 主播的實時互動需求,提出 Harness-Aware Training(HAT)框架,令小模型能在頻繁更新的策略環境中保持低延遲與高適應力。

Hero image preview

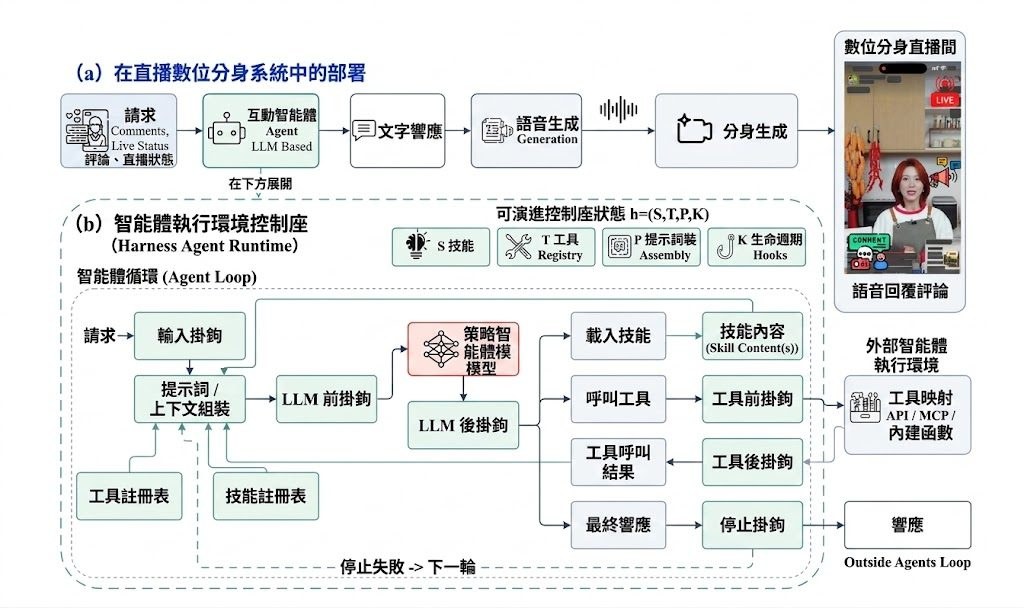
淘寶直播旗下的 TaoLive AIGC LLM 團隊發表技術報告,提出一套名為 Harness-Aware Training(HAT)的訓練方法,專門用於訓練能在直播帶貨場景中即時回答商品問題、與觀眾互動並執行營銷策略的數字人主播。團隊指出,直播帶貨對延遲極為敏感,同時行銷規則與商戶偏好又會持續變動,因此業界普遍採用「可演化 Harness」設計,把 Skills、Hooks、prompts 和 tools 與模型參數解耦,策略改動時不必重新訓練模型。然而這種做法帶來明顯取捨:大模型雖然泛化能力強,能夠零樣本適應 Harness 變動,但延遲太高;小模型延遲符合實時要求,卻容易過拟合到固定的 Harness 設定,一旦配置更新就需要重新訓練。

HAT 的核心思路是在訓練階段就讓模型接觸大量不同的 Harness 配置,使它學會「讀懂當前的 Harness」,而非記住某一個固定版本。具體做法引入 Harness-State Augmentation(HSA),對 Skill 識別碼、Skill 內容、工具 schema、prompt 結構及 Hook 函數施加保留任務語義的轉換。訓練分為三個階段:HSA-SFT 讓小模型從強模型生成、在多樣化環境中收集的高質量軌跡學習,直接提升推理與工具調用能力;General OPD 透過 On-Policy Distillation 在通用從基礎模型學習,恢復 SFT 過程中受損的泛化能力;HSA-RL 則在經 HSA 增廣的多樣化環境中做強化學習,進一步強化模型對變動 Harness 的理解與工具調用穩定性。

HAT 訓練的模型在 Live-Stream QA 上平均得分 94.8,明顯高於基礎模型的 80.3 和最強通用 LLM 的 93.0;在 Harness-Variant QA 上亦達到 94.6,遠超基礎模型的 75.4。傳統 Fixed-Harness SFT 會令 IFEval 分數較基礎模型下跌 7.7 分,而 HAT 不單避免這種下跌,更取得 83.5 分。在部署層面,模型可在單張 NVIDIA H20 GPU(啟用優化)上運行,P50 延遲 3.4 秒、P95 8.1 秒,已滿足實時互動門檻。系統已落地至淘寶直播的生產環境,線上 A/B 測試顯示相對 ReAct 對照組,Harness 實驗組在確認收貨 GMV 上帶來 4.33% 的 UV 標準化提升、商品頁瀏覽量提升 0.91%。

對需要快速疊代策略、又受制於延遲與算力的實時對話代理團隊而言,這份報告展示了一條可落地的工程路徑。

重點摘要
– 淘寶直播 AIGC 團隊針對直播帶貨 AI 主播提出 HAT 訓練框架
– 解決小模型過拟合固定 Harness、無法跟上策略更新的核心矛盾
– 透過 HSA 增廣與三階段訓練兼顧延遲、泛化與工具調用穩定性
– IFEval 分數避免傳統 SFT 出現的 7.7 分下跌,反升至 83.5
– 已在淘寶直播生產環境上線,A/B 測試帶來 GMV 與瀏覽量提升

Paper

Categories: 阿里巴巴, Agentic, 模型訓練, 框架, Skill 技能

Super-Star:讓數字人邊聽邊做

Super Star 將串流語音、對話和身體動作連成一條即時管線,令 3D 數字人毋須等待完整語音才開始配合手勢。

logo

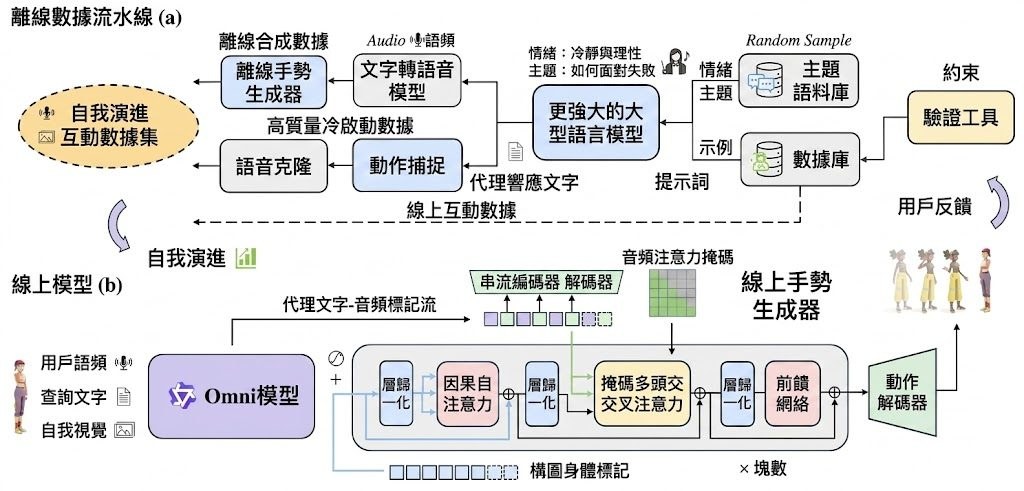
數字人要一邊回應、一邊自然做出配合語氣的動作,關鍵不只是生成語音,而是不能偷看未來內容。Super Star 屬於面向 3D 數字人的即時互動框架,處理多模態輸入、串流回應語音,以及與語音同步的身體姿態生成。

Super-Star 把 Streaming Speech Response 與 Online Gesture Generator 兩個模組接合。前者採用 Qwen3-omni 產生串流回應語音,後者是因果多模態自回歸模型,根據目前收到的語音和 motion history 預測下一段動作,因此可在低延遲下生成手勢,不需等整段對話完成。

離線資料流程會按主題和情緒建立人機對話,再為回應語句生成 co-speech gestures;線上互動收集到的使用者偏好,會回流到 closed-loop self-evolving data pipeline,支援持續調整。相比先取得完整語音再生成動作的做法,Super Star 以較少未來資訊換取即時性,但動作預測亦更依賴目前語音片段和歷史狀態。

  • 串流語音與動作同步,適合虛擬陪伴、直播角色及互動式數字人
  • Qwen3-omni 負責回應語音,Online Gesture Generator 負責身體動作
  • 研究結果主張改善 latency-quality trade-off、語音動作同步及使用者偏好
  • 訓練 Motion Tokenizer 和 Online Gesture Generator 時需要 WAV 音訊
  • CUDA driver 需為 12.4 或以上,完整執行細節仍要配合 Qwen3-omni 及 vLLM-Omni 文件

提供的資料包含 training、inference 和 evaluation code。訓練部分使用 RQVAE 的第一層 codebook 解碼,對應論文線上模型採用的 VQVAE,測試者需要準備 WAV 檔案並填寫音訊路徑和輸出目錄。對研究團隊及需要低延遲數字人互動的開發者而言,項目較適合作為研究原型或客製化系統的起點,而非即裝即用的成品。

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, 多模態模型, 模型訓練, Qwen, NVIDIA, Audio, 3D, 語音, Dataset 數據集

Code World Model:以 coding agent 當大腦,video model 演畫面,世界不再失憶

Code World Model 讓 coding agent 負責推演世界狀態,再由 video model 將結果呈現成影像,支援更持續的互動場景。

Pipeline of the proposed Code World Model

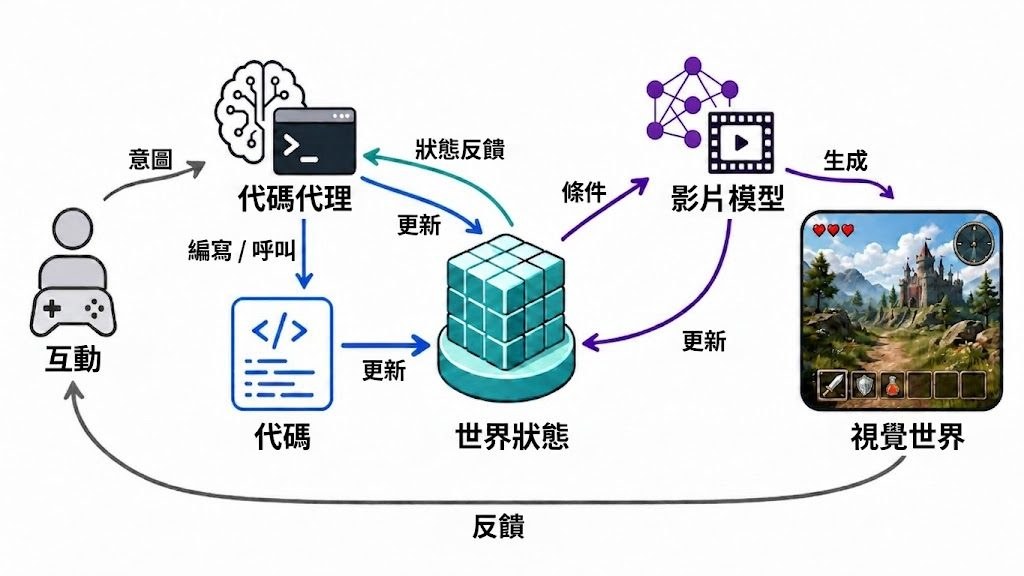
當影片模型只能呈現事件結果,卻難以記住規則、因果和長期後果,互動世界就容易變得不連貫。Code World Model 以 coding agent 作為「世界大腦」,透過可執行程式碼更新及控制世界狀態,再交由 video model 將狀態轉化為視覺觀察。

這種分工把世界演化和畫面生成拆開處理。coding agent 會根據事件推理後果、規劃變化並編寫程式;video model 則負責利用生成先驗呈現場景,讓同一個世界狀態可以延伸出不同視覺體驗。

項目展示了長時間生成及定期轉換風格的場景,包括海底港口、魔法學院、糖果運河和雲上海港等內容;展示中亦使用 RGB Proxy,並以約每60秒一次的節奏改變風格。這類架構適合研究開放式世界模擬、互動敘事,以及需要持續狀態和因果後果的視覺體驗。

• coding agent 負責規則、事件與世界狀態
• video model 負責將狀態實現為影像觀察
• 可支援較長時間的世界演化與持續後果
• 透過分離邏輯和畫面,減少只從影像學習動態的限制

目前資料集中於框架概念、展示場景及研究論述,因此不能視為已確認可自由下載的模型。使用者亦需要留意,視覺效果和世界狀態的一致程度仍會取決於 coding agent 的推理、規劃及編程能力,以及 video model 的生成能力。

項目主頁 · Paper

Categories: 開源, Agentic, 視頻模型, 世界模型, 模型訓練, Video, 框架, Vibe Coding, 編程, AGI, 動畫, MiniMax

StreamPI 機械人模型的記憶系統

StreamPI 為單幀 Vision-Language-Action 模型加入記憶與幾何線索,並將多幀推理的延遲增幅壓至較低水平。

Overview of the StreamPI architecture and streaming inference workflow

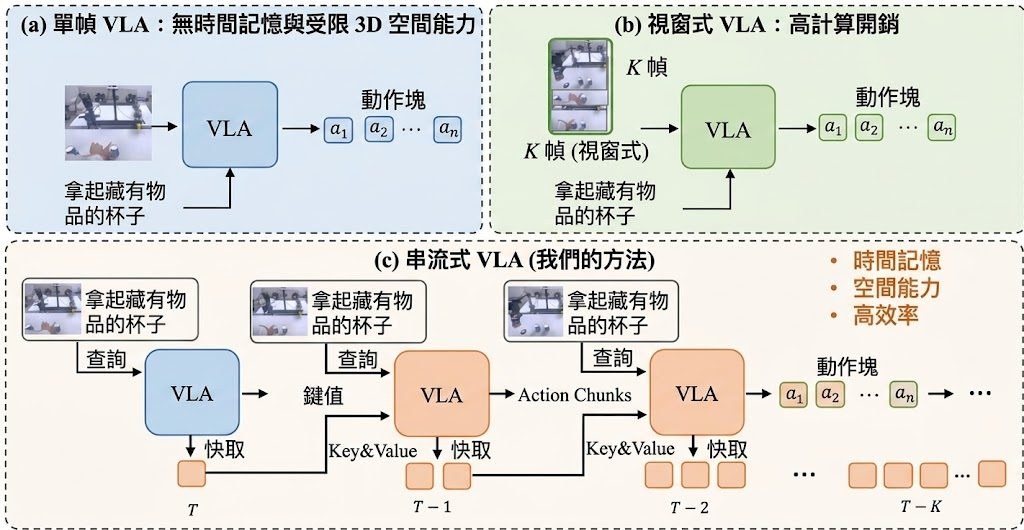
機械人執行抓取、插入等連續任務時,只看當前畫面容易失去物件位置變化;StreamPI 將每組視覺觀察與語言指令視為一個時序單元,屬於為 Vision-Language-Action (VLA) 模型加入串流時序推理能力的框架,針對的正是單幀 π₀.₅ 無法保留歷史觀察的限制。

它沒有額外加入模型參數,而是把多組 token 接在同一序列,再用 block-wise attention mask 控制資訊流。每個單元內採用雙向注意力,讓視覺與語言充分融合;單元之間採用因果注意力,配合 KV cache 保留過去內容,避免每次重新處理完整歷史。重複放入語言指令亦可令任務目標在視覺內容增加後保持清晰。

  • 以預訓練單幀模型延伸至單幀或多幀推理
  • 不增加參數,支援彈性上下文長度
  • 以 random-interval sampling 配合 temporal masking,模擬非固定觀察時間
  • KV cache 適合串流推理及非同步機械人控制
  • RTX 4090 由一幀增至五幀,平均延遲只由 94.4 ms 升至 103.6 ms

訓練時加入隨機幀間隔,讓模型接觸不同觀察節奏;研究資料亦提到每三幀取樣可令動作更快、更平順。這比固定時間同步的訓練更貼近真實機械人環境,但效果仍取決於感測器頻率、控制週期及任務本身,不能只以幀數推斷所有場景都會改善。

項目建基於 openpi,並提供 JAX multi-node distributed training 的額外支援;README 同時列出 real-robot 任務及示範影片。現有資料未提供完整安裝流程、可直接下載的模型權重或測試指令,官方項目頁只表示程式碼及權重預定於 2026 年 8 月 30 日公開,因此目前較適合機械人研究團隊參考其架構和評測方向,而非當作即時可用的套件。

項目主頁 · GitHub

Categories: 開源, 香港大學, Agentic, 視覺模型, 多模態模型, 模型訓練, VLA, Robotic, 香港, Dataset 數據集

VGI-Bench 揭示影片模型推理仍未可靠

影片生成模型不只要畫面合理,還要令事件按正確過程演變。VGI-Bench以27項任務測試這種能力,最高分只有51%。

Repository image for hexuan21/VGI-Bench

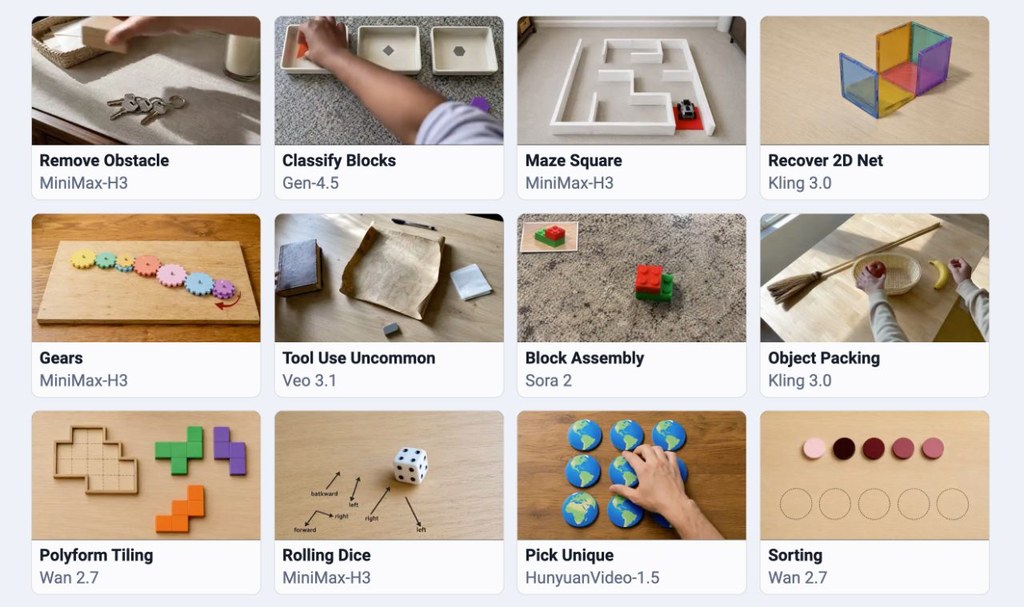
當影片生成模型要處理空間關係、時間變化、物理操作或結構謎題時,畫面好看並不代表推理正確。VGI-Bench屬於影片模型視覺推理評測基準,實際處理的是如何檢查模型能否生成符合條件、而且過程連貫的影片,而非只交出一個合理的最後畫面。

VGI-Bench包含27項任務及810個測試實例,按任務領域和 skill tags 分成兩層分類,並設有 easy、mid、hard 三個難度級別。測試輸入盡量貼近現時影片模型熟悉的視覺先驗,同時要求輸出反映有效的 evolving process;評分採用 rubric score × completeness score,兼顧答案是否正確及是否完成要求。

結果反映模型能力仍有明顯缺口:Seedance 2.0以51.0%取得最高總分,在 Visual Organization、Spatiotemporal 和 Physical Manipulation 領域領先;MiniMax-H3則以50.6%在 Structured Puzzles 領先。Sora 2、Gen-4.5、Wan 2.7及Veo 3.1等模型亦被納入比較,方便分辨影片品質與視覺推理能力之間的差距。

  • 生成畫面合理,不等於推理過程正確
  • 覆蓋視覺組織、時空推理、結構謎題及物理操作
  • 最高總分只有51.0%,可靠性仍不足
  • 分析涵蓋輸出失敗模式及輸入條件敏感度
  • 去噪後期主要修整早期假設,未必能修正推理錯誤

研究團隊亦檢查 synthetic fine-tuning 的性能轉移邊界,並從 internal denoising 角度分析模型如何修正答案。結果指向有限的 self-correction:後續步驟多數是在完善早期假設,而不是重新推翻錯誤推理。這個基準較適合影片模型研究團隊、模型供應商及需要比較生成式視覺推理能力的評測項目;GitHub資料提供 project page 及 Hugging Face Data & Res 連結,但所給資料沒有列出安裝步驟或完整測試流程,不能直接假定可下載後即時重現。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型訓練, Robotic, Dataset 數據集, MiniMax, Skill 技能

Page 4 of 23
1 2 3 4 5 6 23