Mask Forcing:雙重遮罩幫影片擴散模型

Mask Forcing 針對自回歸影片擴散蒸餾中嘅模式塌縮問題,利用雙重雜訊遮罩嘅 rollout 策略,令學生模型分佈覆蓋更多教師模式,同時唔使額外影片資料或後訓練。

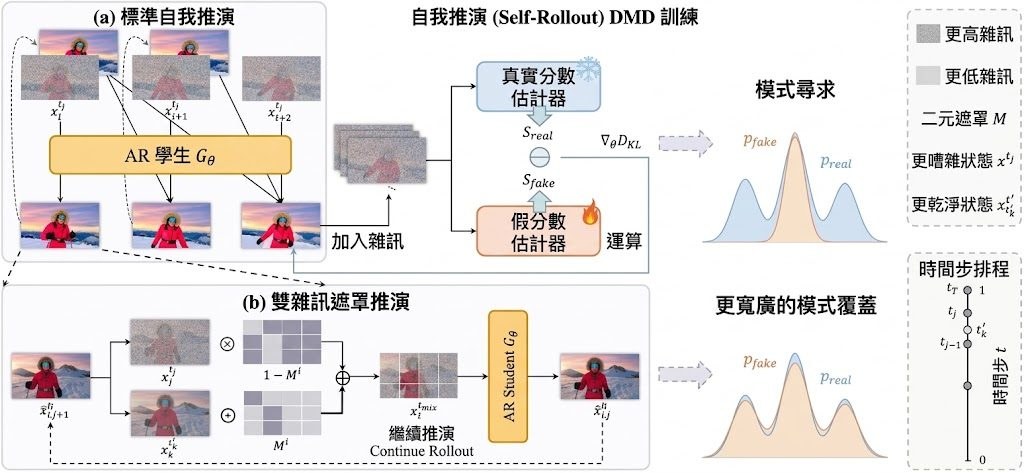
Mask Forcing pipeline

用 DMD(Distribution Matching Distillation)把雙向影片擴散模型蒸餾成自回歸(AR)學生模型時,影片往往出現過度飽和同過度平滑嘅情況,背後成因係 reverse-KL 目標嘅 mode-seeking 傾向,令學生分佈容易塌縮到教師模型嘅少數模式之上。Mask Forcing 嘅切入點正正係呢個矛盾:佢喺 AR 蒸餾嘅 self-rollout 過程中,沿空間同時間軸隨機遮罩、注入較乾淨嘅 token,藉此擾動 rollout 軌跡,令學生有機會探索教師分佈嘅更多區域。

呢個做法同時帶來兩個好處:擾動令 DMD 嘅學習訊號唔再局限於學生已經覆蓋嘅模式;而較乾淨嘅 token 亦可以作為引導,協助同一 chunk 入面較嘈雜嘅 token 去噪,等中間過渡更穩定,從而減少錯誤喺後續 denoising step 同 chunk 之間累積。整個方法唔需要真實影片監督、唔需要額外後訓練階段,亦唔會增加推論成本,純粹改動訓練期嘅 rollout。

Mask Forcing 屬於一種蒸餾增強策略,主要服務於想把 AR 影片生成做快、但又想避開 DMD 視覺質素下降嘅團隊,例如做實時或近實時影片生成嘅研究同產品線。佢同一般做法嘅取捨清晰:放棄模式集中所帶來嘅短期穩定,換取分佈多樣性同中間步預測嘅可靠性。

  • 針對 AR 影片擴散蒸餾中 DMD 嘅 mode-seeking 問題,用雙重雜訊遮罩擾動 rollout
  • 不需真實影片監督或額外後訓練階段,唔改動推論流程
  • 令學生分佈覆蓋更多教師模式,並以較乾淨 token 引導較嘈雜 token 去噪
  • 適用於追求實時影片生成、又想提升視覺質素嘅研究同產品場景

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港科技大學, AI productions, 模型, 模型訓練, Video, 影像模型

MovieGrid 把長片拆成方格生成,解決多鏡頭一致性

來自 UC Santa Cruz 等院校的 MovieGrid 框架,把長片拆成空間方格同步生成,目標是同時兼顧鏡頭內連續動作與跨鏡頭視覺一致性。

Repository image for jwmao1/moviegrid

MovieGrid 針對的痛點很直接:現有影片生成模型傾向犧牲多鏡頭敘事完整性來換取單鏡頭內的動作連貫,而傳統把整段故事沿時間軸壓縮的做法,更會加深這個偏差。

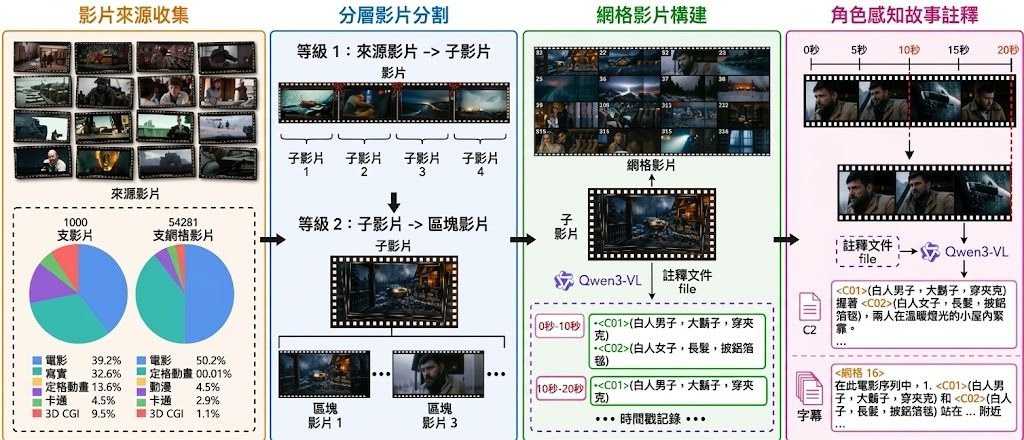
核心做法是把一段長影片切成分佈於空間方格上的短片段,每格只負責少量鏡頭與較短的時間跨度,從而降低單格需要建模的轉場數量;同時所有格子會被聯合生成,並透過 Grid Embedding、角色感知的 Story Prompt 以及 Grid Boundary Loss 來維持格與格之間的銜接。訓練時採用的 Noise-Free Random-Grid Training,會隨機保留部分格子作為乾淨視覺上下文,引導其餘格子的去噪過程。

項目以 Wan2.2-TI2V-5B 作為基座模型,並配搭自家構建的 MGLV 資料集——從 1,000 段長片萃取出 54K 條方格影片,每條都附有角色級故事標註。在等量 token 預算下,MovieGrid 在 1,616 幀長片裡可生成比 Temporal Packing 基線多 6.05 倍的鏡頭,並在自建基準上取得 0.9131 的鏡頭內一致性與 0.5914 的跨鏡頭一致性,分別優於 HoloCine 與 StoryMem。

目前已開源 16 格與 64 格的訓練與推理配置,以及對應的 MovieGrid-16、MovieGrid-64 LoRA 權重;環境需以 Python 3.10 搭配官方 Wan2.2 倉庫安裝。對需要批量產出多鏡頭短片、廣告分鏡或敘事預覽的團隊,這套框架提供了比單時間軸方案更可擴展的路徑,但生成品質仍受基座模型與資料規模所限,未來計劃加入 first frame 與 storyboard 條件控制。

重點摘要:
核心方法:將長片切成空間方格短片段並聯合生成,減輕每格時間跨度負擔。
關鍵機制:Grid Embedding、角色感知 Story Prompt、Grid Boundary Loss 與 Noise-Free Random-Grid Training。
基座與資料:基於 Wan2.2-TI2V-5B,配搭自建 MGLV 資料集共 54K 條方格影片。
開源狀態:已釋出 16 格與 64 格的推理配置、訓練代碼,以及對應 LoRA 權重。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, Embedding, 模型, 模型訓練, Video, 框架, Python, , Dataset 數據集

Perplexity 開源 Lily:Mac 本地推理專用提速引擎

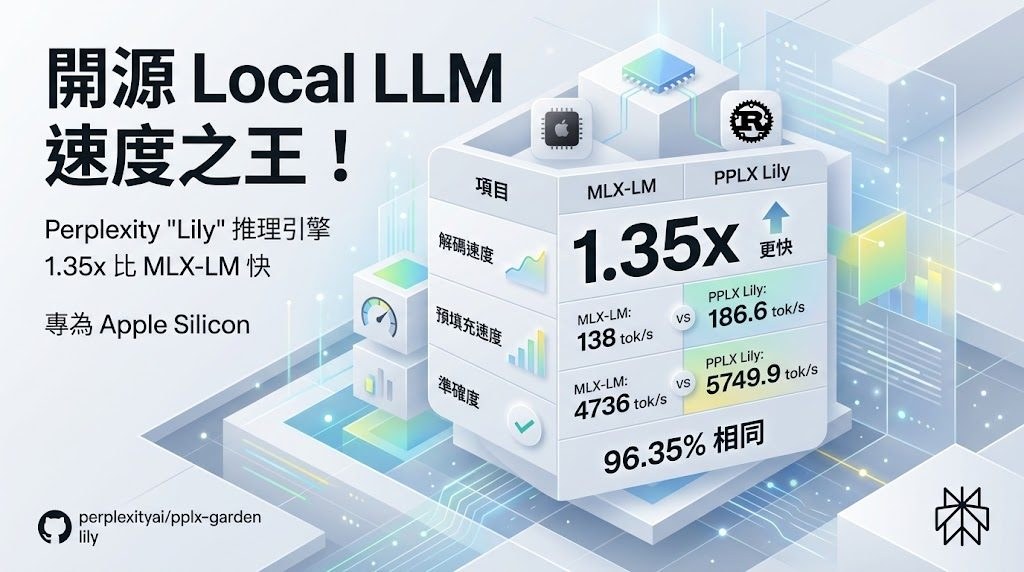
Perplexity 推出針對 Apple Silicon 與 Qwen3.6-35B-A3B 的本地推論引擎 Lily,繞過 PyTorch 與 MLX,以 Rust 和自訂 Metal kernels 改善預填充及解碼效率。

Repository image for perplexityai/pplx-garden

當大型模型開始負責處理 Mac 上的私人檔案與應用程式,本地推論速度就不再只是開發者實驗的指標。Perplexity 開源嘅 pplx-garden 入面,Lily 以工具項目形式處理 Apple Silicon 上 Qwen3.6-35B-A3B 的推論,目標係令提示詞處理及文字生成更快,並透過 OpenAI-compatible HTTP API 串接聊天流程。

Lily 唔似 MLX-LM 般追求支援多款模型,而係集中服務 Qwen3.6-35B-A3B:Rust runtime 負責載入 checkpoint、管理 session state 同生成迴圈,自訂 Metal kernels 就處理模型特定運算。呢種單一進程、模型與 runtime 共同協調嘅做法,減少通用 kernel 帶來嘅額外調度,亦避開 PyTorch 和 MLX execution path。

pplx-garden 不只是 Mac 本地推論工具。fabric-lib 提供 RDMA TransferEngine,同時涵蓋 P2P MoE dispatch 與 combine kernel;pplx-unigram 則係針對 Unigram tokenizer 嘅 CPU encoder。相關內容亦包括 trillion-parameter model 喺 AWS EFA 上嘅部署,以及 RL post-training 權重轉移、分離式 prefill 和 decode 等系統研究,顯示儲存庫涵蓋由裝置端推論到分散式 LLM infrastructure 嘅多個瓶頸。

適合需要喺 Mac 處理敏感資料、又希望保留本地生成能力嘅開發者及研究團隊;需要 RDMA、MoE 溝通或 tokenizer 優化嘅系統工程人員亦可參考相關元件。現有資料集中講述 Lily 分別量度 prefill throughput 同 decode throughput。

重點摘要:
– Lily 專為 Apple Silicon 與 Qwen3.6-35B-A3B 設計,支援 OpenAI-compatible HTTP API。
– 以 Rust runtime 配合自訂 Metal kernels,分開處理 prefill 同 decode。
– 不經 PyTorch 或 MLX execution path,代價係模型及硬件支援範圍較專門。
– fabric-lib 同 p2p-all-to-all 面向 RDMA、MoE dispatch 與 combine 等分散式推論問題。
– 效能應按裝置、上下文及生成負載實測,不能只依賴官方定位作比較。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Qwen, OpenAI, API, 提示詞, 工具, Mac, Python, , 蘋果, Dataset 數據集

EditVid:零訓練、單一框架處理五大影片編輯任務

伊利諾伊大學 PLAN Lab 推出 EditVid,毋須訓練即可在一個框架內完成風格轉換、屬性修改、物件插入等多種影片編輯。

PLAN Lab Logo

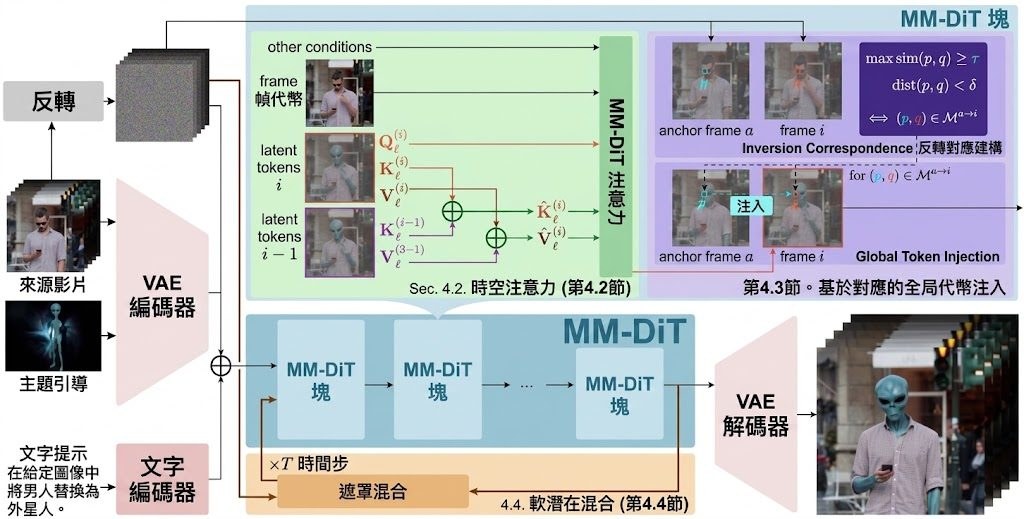
想用同一套方法幫一段影片換風格、改顏色、甚至換主體,又唔想為每種任務訓練專屬模型?PLAN Lab(伊利諾伊大學厄巴納-香檳分校)嘅 EditVid 正正就係為呢個煩惱而設計。佢屬於免訓練(training-free)嘅影片編輯框架,直接喺凍結嘅多模態擴散 Transformer(MM-DiT)圖像編輯器上動手術,同時支援文字指令引導同參考圖引導兩大路線。

對一般用家嚟講,最大體感差異係:一條原本只能用嚟改顏色嘅編輯鏈,現在仲可以做局部部件編輯、物件插入、主體替換等五類任務,唔使每樣重新煉模型。你叫佢「將大象變藍色」、「將海浪轉做黑色」、「將衣服轉紅色」,佢都能在同一條流程內完成。

佢能夠兼顧短距離同長距離一致性,關鍵在於三個互相配合嘅設計:

  • 稀疏因果記憶:每幀只向前一幀取視覺鍵值狀態,避免長距離 RoPE 交互變得唔穩定。
  • 後注意力 Token 注入:用置信度同循環一致性匹配把幀同錨點幀對齊,再注入匹配到嘅視覺表示,維持主體外觀一致。
  • 軟潛空間混合:根據時間步動態調整保留權重,源內容需要保留嘅地方唔會被強行覆蓋。

量化結果方面,喺 FiVE 基準上 EditVid 拎到 78.16 分 FiVE-Acc,比目前最強嘅訓練免費基準高出近 20 分;喺 IVEBench 上面亦取得具競爭力嘅成績。用戶研究入面,超過一半受訪者(51.8%)傾向揀 EditVid 而唔係其餘 7 種對比方法。

如果日常工作涉及大量短片二次創作、廣告素材改版、或者需要快速試驗唔同視覺風格,EditVid 提供嘅「零訓練、單一框架」思路可省卻大量前置準備成本。

項目主頁 · GitHub · Paper

Categories: 開源, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, 框架

OmniEvalKit:唔使重新訓練 VLM 都可以聽聲答問題

MBZUAI Oryx 團隊把 OmniEvalKit 開源出嚟,主打唔使改動 VLM 任何參數,就為佢加掛語音理解能力。對於想評估或部署多模態模型嘅團隊,可以直接拎現成骨幹即試。

Training-Free Omni

想為一個視覺語言模型加入語音理解,但又唔想重新訓練?MBZUAI Oryx 團隊開源嘅 OmniEvalKit(Training-Free Omni)就正正針對呢個痛點。它把語音先經 Whisper 抽取成帶時間戳、語言同信心分數嘅結構化文字,再連同圖片或影片幀一齊餵俾凍結嘅 VLM,所有推理都沿用原本嘅 prompt 接口,骨幹權重全程不動。換句話講,任何新嘅視覺骨幹都可以即插即用,毋須再做語音—視覺對齊微調。

它同時係一個統一嘅多模態評測框架,支援文字、圖片、影片、音頻同音視頻任務,並預載 118 個資料集適配器,涵蓋 Qwen、Gemma、MiniCPM、VILA、OmniVinci 等模型,方便做公平對齊測試。對研究人員同部署團隊而言,最直接嘅好處係可以一次過跑 56 個 benchmark、21 種語言,直接比較凍結骨幹同原生 omni 模型之間嘅差距,睇下語音能力究竟係新加出嚟定係由舊能力交換得嚟。

如果你關心 VLM 加掛語音後會唔會「失憶」,呢套框架正正提供 matched comparison,可以量化評估圖像理解、視覺定位、編碼、數學等原有強項有冇被削弱。額外支援嘅 CosyVoice3 文字轉語音輸出,亦令文本答案可以直接變成語音回覆。

要本地跑得起嚟,需要 Python 3.10+、ffmpeg,再針對 CPU、CUDA 或 ROCm 安裝對應嘅 PyTorch。之後透過 eval.sh 配環境變數指定模型同資料集即可開跑,加 MAX_SAMPLES=3 可以做煙霧測試,中斷後設 RESUME=True 可以接返。

以下係幾個值得留意嘅重點:

  • 凍結骨幹、零微調:所有 VLM 權重完全不變,語音理解透過 Whisper 抽取文字證據再加 prompt 融合達成。
  • 即插即用嘅 omni 能力:支援 Qwen2.5-Omni、Gemma、MiniCPM、VILA、OmniVinci 等多個模型適配器,方便横向比較。
  • 覆蓋廣嘅評測矩陣:內置 118 個資料集適配器,涵蓋 56 個 benchmark 與 21 種語言。
  • 原生 omni 同凍結骨幹嘅 matched 對照:可以清晰分辨新增能力同保留能力,避免重訓帶嚟嘅 capability drift。
  • 可選語音回覆:透過 CosyVoice3 把文字答案合成語音輸出,適合對話式場景。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, Image, 框架, Python, 語音, Dataset 數據集

MiniMax-H3 Singularity:提升影像轉影片品質

基於 MiniMax-H3 深度微調的多模態影片模型,針對動作模糊、遠景人臉失真與光影過油等痛點進行修補。

Minimax-h3_Singularity 是建基於 MiniMax-H3 的多模態影片生成模型,採用 Apache-2.0 授權,於 ComfyUI 環境原生支援 Text-to-Video(T2V)、Image-to-Video(I2V)、Reference-to-Video(Ref2V)以及 Video-to-Video(V2V)四種工作流程。開發者並非單純做一次 LoRA 貼片,而是將 refflb25-49 等多個關鍵 checkpoint 進行策略性融合,再以高步數深度微調,最後花三天做精準剪枝與權重優化,目的是在保留 MiniMax-H3 原生 prompt 適應力與泛化能力的同時,壓住高步數訓練帶來的鬼影與過擬合。

這個版本重點針對三類常見瑕疵:高動態場景的運動模糊、Medium-to-Long Shot 距離下的人臉崩壞與糊化,以及人物皮膚過油、光澤不自然的問題。在功能面上,它特別加強了武打對戰、魔法施法、粒子光暈等奇幻動作場景的動感張力,同時提升鏡頭語言對搖鏡、推拉、追蹤等運鏡指令的回應度。

模型以 ComfyUI 節點工作流為主要入口,並附帶 RunningHub 線上 Demo 以及 YouTube、Bilibili 展示頻道連結,方便先觀察實際輸出再決定整合方式。

MiniMax H3 Singularity开源!全面微调融合,基础能力还在!嗨,大家好,这里是啊ban!快去玩!纯推荐分享视频!

重點摘要:

  • 基礎模型:以 MiniMax-H3 為底,融合 refflb25-49 等 checkpoint 做高步數微調與剪枝
  • 支援工作流:T2V、I2V、Ref2V、V2V 四種 ComfyUI 多模態流程
  • 主要修正:HDR 影像品質、遠景人臉修復、去油感光影、強化武打與魔法 VFX 動感
  • 鏡頭控制:對 pan、tilt、zoom、tracking 等運鏡指令有更敏銳回應

項目主頁

Categories: 開源, ComfyUI, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, MiniMax

MiniMax H3 Semantic Bridge:單卡煉成的極輕量視頻生成適配器

約 11 MB 的小型適配器,可在不改動 H3 權重的情況下,把跨架構語意信號融入 MiniMax H3 的視頻生成流程。

Og image

由社群開發者 speach1sdef178 發佈的 MiniMax H3 Semantic Bridge,基於 MiniMaxAI 嘅 MiniMax-H3 進行延伸,定位係一個輕量嘅 conditioning-space 適配器,主要服務於標準 H3 FL2VA 文字生成視頻流程,整個項目僅用單張 NVIDIA RTX 3090 Ti 24 GB 完成訓練,並無動用多 GPU 叢集。

這並非 LoRa、checkpoint 合併或傳統的參數轉接。此適配器在影片Transformer之前轉換原生H3條件,並將學習到的語意表示以可控強度融合回H3。佢嘅核心做法係將原本用於 SenseNova U1.5 嘅語意表示,透過跨架構遷移與蒸餾,壓縮成一個獨立嘅小型檔案(MiniMaxH3_SemanticBridge_v1.safetensors)。使用時 SenseNova 完全唔需要載入,適配器會喺視頻 transformer 之前轉換 H3 嘅原生 conditioning,再以可控強度將學到嘅語意信號混合返入 H3。檔案本身只有約 11 MB,並唔係 LoRA、權重合併或者傳統參數嫁接,安裝方法係將 MiniMax_H3_Semantic_Bridge_v1.0.zip 解壓至 ComfyUI 自訂節點目錄,再將適配器放入新增嘅 ComfyUI/models/semantic_bridge/ 資料夾即可。

目前 v1 只支援文字條件嘅標準 FL2VA 流程,Ref2VA 參考圖生成或參考音訊工作流並唔適用。官方亦提到,喺參考音訊場景插入呢個適配器時,唱歌同嘴型同步表現會明顯下降,因此使用前要留意任務邊界,避免硬套落唔支援嘅流程。呢個項目提供咗 examples/ 對照素材、workflow JSON 同研究文章,方便用家直接喺 ComfyUI 內做 Native H3 同 Semantic Bridge 嘅 A/B 比較。

重點摘要:

  • 基礎模型:MiniMaxAI/MiniMax-H3,定位係 H3 嘅 conditioning-space 適配器而非權重合併。
  • 檔案規模:約 11 MB 嘅獨立 .safetensors,外加 ComfyUI 自訂節點 zip 同 workflow JSON。
  • 訓練條件:單張 RTX 3090 Ti 24 GB 完成,無需多 GPU 叢集,SenseNova 只用於訓練階段。
  • 支援範圍:適用於 H3 FL2VA 文字生成視頻,Ref2VA 同參考音訊流程未獲支援。
  • 整合方式:放入 ComfyUI custom nodes,並透過新增節點將 conditioning 同 latent 注入原有 H3 流程。

項目主頁

Categories: 開源, ComfyUI, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Audio, MiniMax

RoboTok:用 YouTube 影片教機械手做家務

RoboTok 把網上大量的人手操作影片變成機器人訓練素材,對應一段示範就能自動撈出動作相似的影片做模仿學習,等 AI 機械手多了一條低成本數據來源。

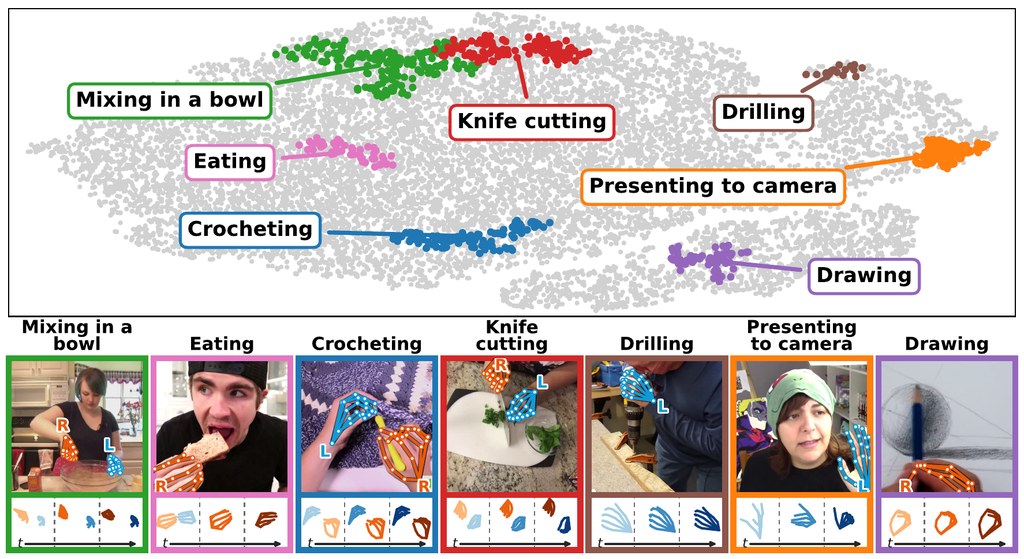
Retrieval embedding space and example clips

想訓練機械手做家務,最貴的部分往往不是模型,而是數據。RoboTok 由 Rice University 及 NVIDIA 合作開發,直接從海量網絡影片中撈取人手操作片段,再交給擬人機械手學習。它屬於一種數據引擎兼策略學習框架,把「找對數據」這一步自動化掉。

核心做法是把人手動作抽成以軀幹為基準的 3D 手部軌跡,再學一個嵌入空間,用 DTW(Dynamic Time Warping)相似度作監督,令同一種操作(例如倒水、摺衫)在不同鏡頭、不同人、不同場景下都能對齊。查詢時只要給一段示範影片,系統就用 cosine similarity 找出動作最相近的網絡片段。

  • 以軌跡為單位做檢索:避開外觀差異,直接比動作本體,所以鏡頭變、場景變、人變都唔會影響配對。
  • 配套軀幹估計模型:用雙手軌跡反推出身體/軀幹參考框,減少裁切與遮擋帶來的偏差。
  • FAISS + GPU DTW:向量檢索用 FAISS,DTW 內核用 numba CUDA,跑大規模影片庫唔會慢到難以迭代。
  • 機械人策略學習閉環:檢索結果直接餵下游模仿學習,做擬人機械手 policy 訓練,並已在仿真及真機任務做評估。

同類做法多數只用影片幀或粗糙動作標籤做檢索,容易被背景雜訊干擾。RoboTok 走 3D 手部軌跡嵌入這條路,換來更精準的動作匹配,但代價是 pipeline 較重:要裝 MANO/SMPL-H 體模、CUDA 環境,再跑一套自帶的訓練與評估流程。

最受惠的是做擬人機械手、靈巧操作(dexterous manipulation)研究的團隊,以及想用低成本網絡影片取代部分遙操作數據的工作小組。對只想要開箱即用機械人策略的人來說,門檻仍然偏高;對做數據策展與 representation learning 的人,呢套引擎本身就值得參考。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型訓練, NVIDIA, Robotic, 3D

Atlas 世界模型一次處理文字、圖片、影片與 3D

World Labs 推出 Atlas,聲稱是目前首個原生同時處理文字、圖像、影片與 3D 的「omni」世界模型,能從一張相機路徑推算未見過的視角,並重建真實場景。

Og image

World Labs 公開了新一代世界模型 Atlas。它的特別之處在於從訓練階段就同時處理四種輸入——文字、圖像、影片、3D——並把它們整合到同一個空間脈絡裡,再以多模態自迴歸擴散 Transformer 推算下一個畫面。這意味著 Atlas 不只是「看得更多」,而是嘗試理解世界怎樣呈現、怎樣變化,並把想像中的場景渲染出來。

從使用場景來看,Atlas 主要涵蓋四類工作:相機控制生成、空間重建、空間時間模擬,以及純文字生圖與 360 度全景。其中相機控制生成支援 1 至 6 張輸入圖片,可輸出最高 1440p、最長約 1 分鐘的影片,並以像素級精度的相機幾何作為輸入,而不只是粗略的文字描述。

重建方面,Atlas 只需要 1 張到幾十張相片,就能還原真實場景並產出新視角的影像幀與明確的 3D 輸出。團隊指出,這項表現優於專門做 3D 重建的同類模型。空間時間模擬則可從影片重新取景,生成電影級視覺效果,並支援 Real-to-Sim 流程,供機器人規劃動作。

以下幾點值得留意:

  • 原生多模態:文字、圖片、影片、3D 一開始就共享同一空間脈絡,並非後期拼接。
  • 像素級相機控制:把精確相機幾何列為原生輸入,能逐格構圖、逐段運鏡。
  • 超越專用模型:3D 重建表現優於專門訓練的模型。
  • 支援 Real-to-Sim:能把真實影片轉成可模擬的世界,供機器人規劃。
  • 規模持續擴展:團隊表示表現會隨訓練算力提升,並預期這個趨勢會延續下去。

World Labs 表示,Atlas 將驅動他們自家 Marble 的未來版本及其他產品,現已開放早期使用的申請。

項目主頁

Categories: AI productions, 多模態模型, 世界模型, 模型訓練, API, Video, Image, 影像模型, Robotic, 3D

SolarWM 開放視頻世界模型全流程基建

SolarWM 不只公開模型權重,連數據處理、訓練流程和長時推理方法一併開放,目標是降低互動式視頻世界模型的研究門檻。

SolarWM teaser: one framework for diverse interactive worlds

從數秒訓練片段推演出長達數分鐘甚至更長時間的互動視頻,一直是世界模型(World Model)發展中的難題。SolarWM 把焦點放在整個研發鏈條,而不只是單一模型,結合開放數據管線、訓練框架與推理流程,形成一個面向互動式視頻世界模型的完整研究基礎設施。

項目屬於世界模型訓練框架與開放研究基建,處理的問題是如何把不同來源的視頻資料整理成一致格式,並在不同模型骨幹之間建立可擴展的長時推理能力。團隊將來自 14 個資料集、約 143 萬段影片統一整理,讓資料準備與訓練配方可以分離,研究人員毋須重複建立資料處理流程。

與許多只圍繞單一架構設計的方法不同,SolarWM 強調保留原生骨幹能力,同時支援 Wan2.2、LTX-2.5 與 MiniMax-H3 等不同模型家族,涵蓋 5B 至 33B 規模。研究團隊提出三階段訓練流程,包括雙向適應、結合 AnyFlow 的教師強制訓練,以及長時互動推理策略,希望在不依賴超長訓練影片的情況下維持世界演化一致性。

  • 開放釋出資料處理管線、資料集及模型權重
  • 支援多個主流視頻生成骨幹,而非綁定單一架構
  • 利用約五秒片段訓練,目標達成分鐘級甚至小時級推理
  • 涵蓋 143 萬段影片與約 25TB 數據規模
  • 提供可重組資料配方與不同訓練策略組合

適合世界模型研究團隊、互動式模擬系統開發者,以及探索 World-Action Model 與長時視頻生成的學術機構。SolarWM 的價值不只在單次生成效果,而在於把過往難以重現的資料處理和訓練步驟公開,讓不同研究單位更容易比較方法與建立可重複驗證的實驗流程。長時間推理的一致性仍有待更多公開基準驗證,但這套框架已經把世界模型研究由單一模型競賽推向完整基礎設施層面。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, 世界模型, 模型訓練, NVIDIA, World-Action Model, 3D, LTX, Dataset 數據集, MiniMax

Page 3 of 23
1 2 3 4 5 23