Qwen-Image 的 LoRA 訓練

影片主要介紹如何使用 Ostris AI 開發的 AI Toolkit,在僅有 24 GB VRAM 的 RTX 4090 或 3090 GPU 上,訓練一個基於 Qwen-Image 模型的 LoRA(Low-Rank Adaptation)風格模型。Qwen-Image 是一個 20 億參數的巨型模型,通常需要更高規格的硬體(如 32 GB VRAM 的 RTX 5090),但作者透過創新技術(如量化與 Accuracy Recovery Adapter)實現了在消費級 GPU 上的訓練。影片強調這是對先前影片的延續,先前影片曾在 5090 上使用 6-bit 量化訓練角色 LoRA,而本次聚焦於更常見的 24 GB VRAM 硬體。

Train a Qwen-Image LoRA on 24GB VRAM With AI Toolkit

影片主要介紹如何使用 Ostris AI 開發的 AI Toolkit,在僅有 24 GB VRAM 的 RTX 4090 或 3090 GPU 上,訓練一個基於 Qwen-Image 模型的 LoRA(Low-Rank Adaptation)風格模型。Qwen-Image 是一個 20 億參數的巨型模型,通常需要更高規格的硬體(如 32 GB VRAM 的 RTX 5090),但作者透過創新技術(如量化與 Accuracy Recovery Adapter)實現了在消費級 GPU 上的訓練。影片強調這是對先前影片的延續,先前影片曾在 5090 上使用 6-bit 量化訓練角色 LoRA,而本次聚焦於更常見的 24 GB VRAM 硬體。

Categories: 開源, 模型, 多模態模型, 視頻模型, 模型訓練, 影像模型, 影像處理, 教學

n8n 與 ComfyUI 自動化生成本地 AI 視頻

教程展示了AI工具鏈整合的未來趨勢,將碎片化任務轉爲端到端自動化系統,適合想提升創作效率的技術型用戶。若需實作細節,可參考影片中的Docker指令與節點配置截圖。

教程展示了AI工具鏈整合的未來趨勢,將碎片化任務轉爲端到端自動化系統,適合想提升創作效率的技術型用戶。若需實作細節,可參考影片中的Docker指令與節點配置截圖。

n8n with ComfyUI AI Video Automation Local Setup Walkthrough
Categories: ComfyUI, 影像模型, 影像處理, txt2img, 教學


WAN 2.1 VACE 模型的原生支援

1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。 影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)

1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。

影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)

  • ComfyUI現在原生支援WAN 2.1 VACE模型,提供1.3B(適合低顯存顯卡)和14B(適合高顯存顯卡)兩種模型。
  • 多種 AI 影片生成工作流程
    • 文字轉影片(Text-to-Video)
    • 圖像轉影片(Image-to-Video)
    • 影片控制(Video Control)
    • 影片外延(Video Outpainting)
    • 首尾影格生成(First Frame/Last Frame)
Amazing AI Video Natively in ComfyUI - An Introduction to WAN VACE
Categories: 開源, ComfyUI, 數字人, 影像模型, 影像處理, txt2img

LTX-Video 0.96

LTX-Video 是第一個基於 DiT 的視訊生成模型,可以即時產生高品質的視訊。它可以以 1216×704 的分辨率生成 30 FPS 的視頻,比觀看這些視頻的速度還快。該模型在多樣化影片的大規模資料集上進行訓練,可以產生具有逼真和多樣化內容的高解析度影片。模型支援文字轉圖像、圖像轉影片、基於關鍵影格的動畫、影片擴充(正向和反向)、影片轉影片以及這些功能的任意組合。

LTX-Video 是第一個基於 DiT 的視訊生成模型,可以即時產生高品質的視訊。它可以以 1216×704 的分辨率生成 30 FPS 的視頻,比觀看這些視頻的速度還快。該模型在多樣化影片的大規模資料集上進行訓練,可以產生具有逼真和多樣化內容的高解析度影片。模型支援文字轉圖像、圖像轉影片、基於關鍵影格的動畫、影片擴充(正向和反向)、影片轉影片以及這些功能的任意組合。

Categories: 開源, 多模態模型, 視頻模型, 影像模型, 影像處理

FramePack 6Gb vRAM 出 60 秒影片

FramePack 是一種新的視頻擴散設計,用壓縮上下文令工作量不會隨著影片的長度而增加,只需一張圖片,就可以令你的 6GB vRAM 的電腦透過 13B 模型生成每秒 30 格影片的 60 秒影片。而用 RTX 4090 的話,最快速度為每格 1.5 秒。 作者 Lvmin Zhang

FramePack 是一種新的視頻擴散設計,用壓縮上下文令工作量不會隨著影片的長度而增加,只需一張圖片,就可以令你的 6GB vRAM 的電腦透過 13B 模型生成每秒 30 格影片的 60 秒影片。而用 RTX 4090 的話,最快速度為每格 1.5 秒。

作者 Lvmin Zhang

FramePack Run In Gradio & ComfyUI - Generate Long Length image2Video AI Video - Installation Guide
Categories: 開源, ComfyUI, 視頻模型, 影像模型, 影像處理

InfiniteYou 克隆自己

InfiniteYou 的獨特之處在於其強大的身份保留技術!透過核心組件 InfuseNet,即使在生成全新場景或是不同風格的相片,也能精準保留相片中的人物特徵。您可以僅以文字描述,就能讓同一人物出現在不同情境、穿著不同的衫,甚至呈現不同的風格。它亦支援 ControlNet 和 LoRA 的進階控制,令創意揮灑的同時,也能精細調整生成結果,直至符合您需要的獨特內容!(ByteDance)

InfiniteYou 的獨特之處在於其強大的身份保留技術!透過核心組件 InfuseNet,即使在生成全新場景或是不同風格的相片,也能精準保留相片中的人物特徵。您可以僅以文字描述,就能讓同一人物出現在不同情境、穿著不同的衫,甚至呈現不同的風格。它亦支援 ControlNet 和 LoRA 的進階控制,令創意揮灑的同時,也能精細調整生成結果,直至符合您需要的獨特內容!(ByteDance)

Categories: 開源, 數字人, 模型, 影像處理

LHM 體態模型

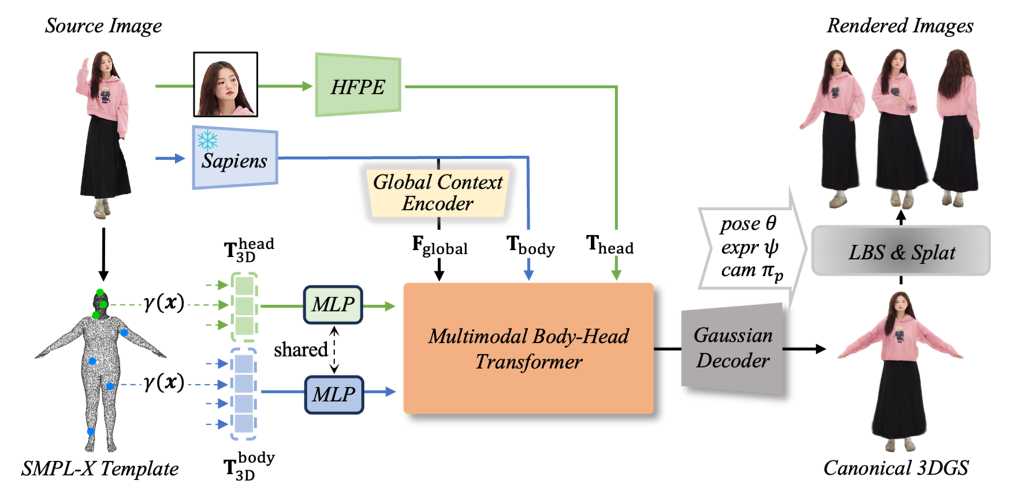
LHM (Large Animatable Human Reconstruction Model) 是一個高效及高質量的 3D 人體重建方案模型,能夠在幾秒鐘內生成影片。模型利用了多模態的 Transformer 架構,以注意力機制,對人體特徵和影像特徵進行編碼,能夠詳細保存服裝的幾何形狀和紋理。為了進一步增強細節,LHM 提出了一種針對頭部特徵的金字塔型編碼方案,能夠生成頭部區域的多種特徵。(阿里巴巴)

LHM (Large Animatable Human Reconstruction Model) 是一個高效及高質量的 3D 人體重建方案模型,能夠在幾秒鐘內生成影片。模型利用了多模態的 Transformer 架構,以注意力機制,對人體特徵和影像特徵進行編碼,能夠詳細保存服裝的幾何形狀和紋理。為了進一步增強細節,LHM 提出了一種針對頭部特徵的金字塔型編碼方案,能夠生成頭部區域的多種特徵。(阿里巴巴)

Categories: 開源, 數字人, 多模態模型, 視頻模型, 影像處理

LatentSync 1.5 – 最穩定的 LipSync 開源方案

LatentSync 1.5 是 ByteDance 團隊在 GitHub 上發佈的開源專案。1.5 版本增強了中文影片的表現。它的主要功能是直接地將音頻資訊轉換成為逼真的口型動作。專案提供了完整的訓練和推論程式碼,包含資料處理流程、兩種模型訓練步驟(U-Net 和 SyncNet),以及詳細的推論指令。

LatentSync 1.5 是 ByteDance 團隊在 GitHub 上發佈的開源專案。1.5 版本增強了中文影片的表現。它的主要功能是直接地將音頻資訊轉換成為逼真的口型動作。專案提供了完整的訓練和推論程式碼,包含資料處理流程、兩種模型訓練步驟(U-Net 和 SyncNet),以及詳細的推論指令。

LatentSync 1.5 | 2025最强数字人,完美适配无人直播间,带货必备,优化中文语音,唇形同步!
LatentSync In ComfyUI Another Level Of AI Talking Avatar—Open Source Plus It Works!
Categories: 影像處理, 教學

FlashVideo 高速生成高解像度影片

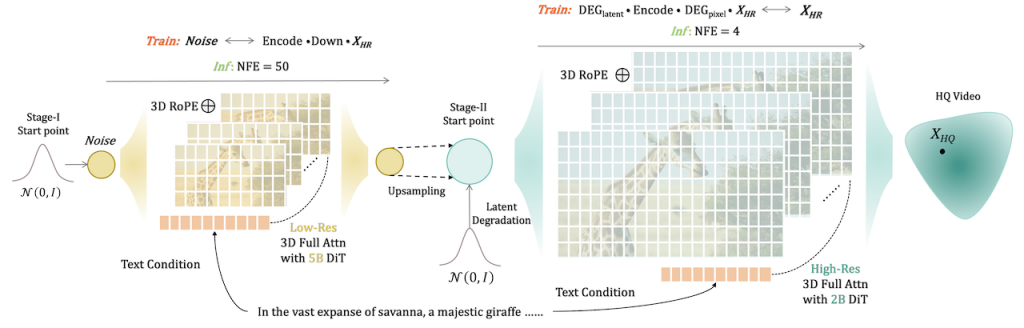
FlashVideo 由香港大學、香港科技大學及 ByteDance 聯合開發,你只需要準備一張或者幾張參考圖片,加上文字提示詞,就可以生成高解像度的影片。過程主要分為兩部份,第一部分是優先處理提示詞,同時以低解像度處理圖片,減少 DIT 的運算時間。第二部分會建立低解像度和高解像度之間的匹配。結果能夠以高速生成 1 0 8 0 P 的高清影片。[DiT] Diffusion Transformer | [NFE ] Number of Function Evaluations

FlashVideo 由香港大學、香港科技大學及 ByteDance 聯合開發,你只需要準備一張或者幾張參考圖片,加上文字提示詞,就可以生成高解像度的影片。過程主要分為兩部份,第一部分是優先處理提示詞,同時以低解像度處理圖片,減少 DIT 的運算時間。第二部分會建立低解像度和高解像度之間的匹配。結果能夠以高速生成 1 0 8 0 P 的高清影片。[DiT] Diffusion Transformer | [NFE ] Number of Function Evaluations

Categories: 開源, 香港科技大學, 視頻模型, 影像處理

Page 16 of 21
1 14 15 16 17 18 21