TempCloze:揭開 Video-LLM 的時間盲區

TempCloze 是一個專門測試 Video-LLM 視覺時間推理能力的影片填空基準,從七個來源收集 1,521 條長鏡頭與第一人稱影片,挑戰模型能否在四選一中找回正確的「消失中段」。它直接揭示現有模型在時間對齊上的明顯短板。

Overview of the TempCloze benchmark

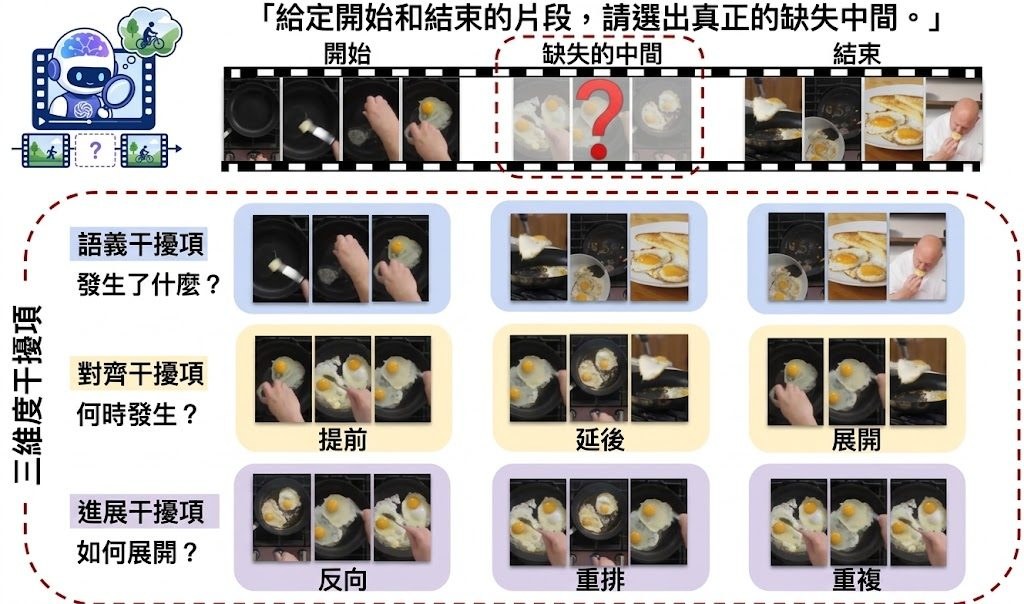
TempCloze 的玩法相當直觀:給一段影片的開頭與結尾,要求模型從四段候選片段中挑出真正屬於中間缺失的那一段。四個選項全部來自同一條影片的素材,連文本線索都壓到最低,等於逼模型只能用眼睛去判斷時間先後與事件流暢度。

這套基準特別針對三個時間維度:語義(Semantic,考「發生了什麼」)、對齊(Alignment,考「應該在何時發生」)、推進(Progression,考「事件如何展開」)。對齊的干擾選項設計得很巧妙,例如把同一段內容前移、後移或拉長;推進維度則把片段倒播、重排、重複,看模型能否識破。題目素材刻意挑選長鏡頭與第一人稱影片,避免靠剪輯或場景切換就能蒙混過關。

跑完 31 個 Video-LLM(10 個閉源加 21 個開源)後結果很殘酷:無論是 GPT 類還是開源權重,模型在對齊任務上的準確率幾乎腰斬,閉源平均從語義 70.73% 跌到對齊 48.13%,開源平均更只剩 26.54%。相比之下,人類在嚴格協議下仍能達到 97% 平均正確率。換言之,現在的 Video-LLM 對畫面在時間軸上的位置幾乎沒概念,只能靠語義關聯硬猜。

對於做影片理解、embodied AI、多模態基準研究的人來說,這份工具包很值得關注。它提供統一抽幀協議(每段 16 幀,六片段題 96 幀),評測流程可直接套用,重點在於指出時間對齊才是視頻推理的真正瓶頸,數字與圖表都已經整理好。

重點摘要:

  • 任務設計:四選一影片填空,所有干擾項來自同一條原片,消除文本捷徑
  • 三維度考核:語義、對齊、推進,分別測事件、位置、展開方式
  • 數據規模:1,521 條影片,長鏡頭與第一人稱為主,七個公開來源
  • 核心發現:對齊維度是最大瓶頸,開源模型跌至 26.54%,閉源亦僅 48.13%
  • 工具價值:統一抽幀協議與評測腳本,可直接比較現有 Video-LLM 在時間推理上的差距
GitHub

Categories: 開源, Agentic, 模型, 視覺模型, Video, 影像處理, 框架, 工具

FFmpeg 變身 AI Agent 影片剪輯師:28 個工具全程本地執行

ffmpeg-skill 為 Claude Code、Cursor、Codex 等編碼代理補上影片剪輯能力。28 個結構化工具涵蓋剪接、字幕、HDR 轉 SDR、多機位等流程,全程本地運作、不上傳素材。

FFmpeg Skill: media processing for AI agents

很多時候,你想叫 AI 幫你剪片、抽音、轉格式,但手上的影片根本不想上傳到雲端。ffmpeg-skill 就針對這個卡位——它不是模型,而是一套 Agent Skill,把 FFmpeg 包成 Claude Code、Cursor、Codex 或任何讀得到 SKILL.md 的代理都能用的工具集。只要機器裝好 ffmpeg 和 Python 3.9+,整套 28 個工具就能離線跑。

它跟一般「叫 AI 寫 ffmpeg 指令」的做法最大分別,在於每個工具都是帶型別參數的腳本,並非丟一段 shell 字串給模型拼裝。代理會先用 probe.py 量度時長、幀率、解析度、色彩和音軌,再依結果決定怎樣剪,文件名稱完全不被當成依據。輸出之後,結果會再被 probe 一次、比對目標規格,畫面有動過的話甚至生成 contact sheet 做肉眼覆檢。

工具覆蓋的工序相當完整:剪接、合併、去靜音、配合時長與比例、字幕與卡拉 OK 效果、overlay 與 motion graphics、HDR 轉 SDR 及 LUT、音頻清理與動態處理、含飄移修正的同步、多機位、響度校準、交付檢查、批次資料夾。音訊部分可從影片直接抽出、淨化,甚至指定軌號。而整組工具既是 CLI 也是 MCP tool,並由一份 machine-readable contract(SPEC)描述——CLI 的 argparse parser 同時衍生出 input_schema 和 MCP 定義,CI 會在規格漂移時自動失敗。

影片從業人員、剪接助理,或者任何需要把 FFmpeg 操作交給 AI 代理、又不想把素材外流的團隊,都會較易受惠。對一般開發者而言,這也是少數把 SPEC 概念實踐到「CLI 即 schema」程度的開源項目。

GitHub

Categories: 開源, Agentic, AI productions, MCP, Video, 影像處理, Audio, 工具, Python, Skill 技能

MMLVE-Agent 點樣唔再搞亂多鏡頭影片

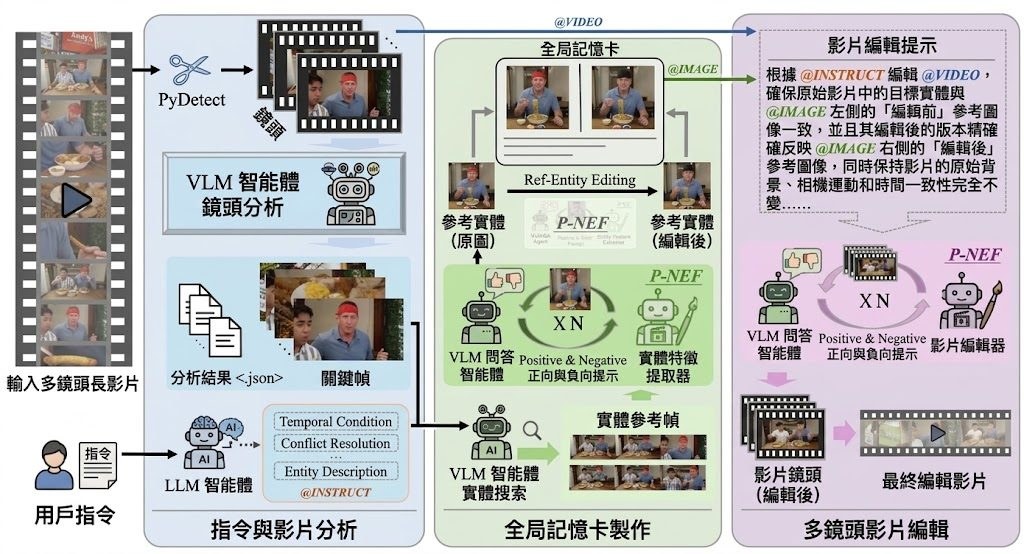
過往 AI 影片編輯碰到多鏡頭長片就容易認錯人、漏改背景。MMLVE-Agent 用 LLM 與 VLM 協作,把每個鏡頭拆開處理,再靠全局記憶鎖住主體身份。

MMLVE-Agent framework

用一句「將男人嘅紅色衫變成藍色」就改完成條片、每個鏡頭都認得返同一個人——呢個係南開大學同騰訊團隊提出嘅 MMLVE-Agent 想要解決嘅痛點。過往影片編輯模型主要處理單鏡頭或幾秒短片,落到幾分鐘、橫跨多個鏡頭嘅長片就容易出現主體身份斷裂、編輯幻覺同時間連續性受損。呢個項目本質係一個異構多智能體框架,結合 LLM 做指令解析、VLM 做鏡頭級拆解同評估,再透過全局記憶卡(Global Memory Card)將 top-k 關鍵幀合成統一參考,確保主體身份唔會跨鏡頭走樣。

團隊同時定義咗 MMLVE 任務嘅三個核心目標:跨鏡頭編輯一致性(CSEC)、多指令解耦(MID)以及對非目標區域嘅零破壞(ZDSS)。其中 Pos-Neg Editing Feedback(P-NEF)令 VLM 評估器可以同時輸出負向提示同正向提示,主動修正錯誤同時保留應有細節,取代坊間常見嘅單向反饋機制。佢哋亦同步推出 MMLVE-Bench 數據集,涵蓋密集異質指令同稀疏隨機分佈嘅實體,對應真實影片剪接場景。

團隊聲稱喺呢個基準上超越咗 Seedance 2.0 等閉源方案,特別喺消除編輯幻覺同保持時空連貫性方面。不過要留意,原始資料只提供項目頁、論文同 benchmark 數據集,並無公開模型權重或安裝入口,想實際部署嘅讀者需要留意後續開源進度。

重點摘要:

  • MMLVE-Agent 係一個多智能體影片編輯框架,專門處理多鏡頭長片嘅自然語言指令編輯
  • 核心創新在於全局記憶卡同正負反饋機制,前者鎖定跨鏡頭主體身份,後者主動修正編輯錯誤
  • 同步推出 MMLVE-Bench 數據集,涵蓋高密度指令同稀疏實體分佈等真實場景
  • 團隊報告在自建基準上超越 Seedance 2.0 等閉源方案
  • 原始資料未提供模型下載或部署方式,實際可用性有待後續開源進度確認

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, 視覺模型, 影像處理, Dataset 數據集

[影片教學] 利用開源探索 3D 世界

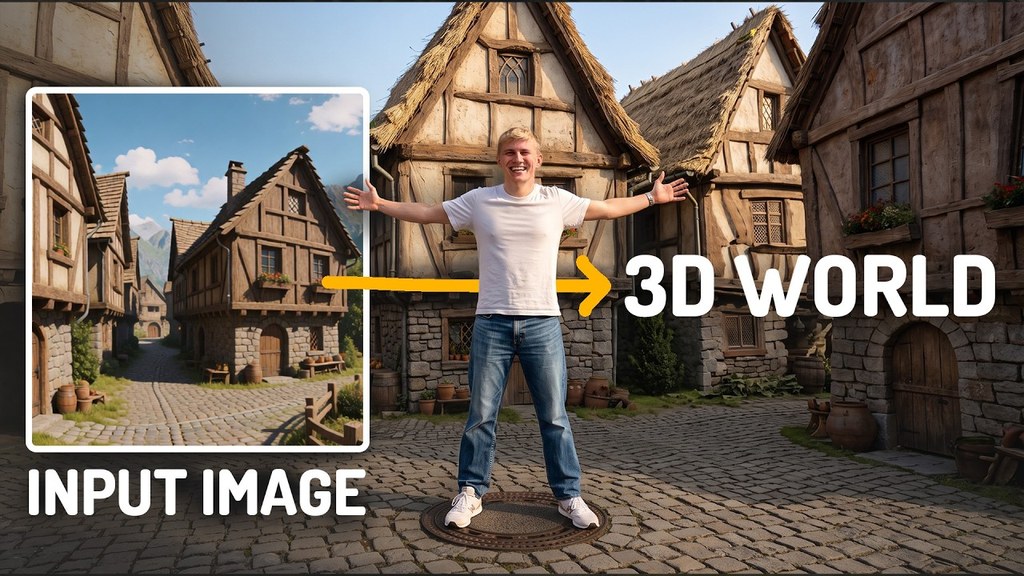
這個開源項目讓你用一張圖或一段文字 prompt,在本地免費生成可自由行走的 3D 世界,毋須依賴雲端服務。

Og image

過往要把一張圖變成可探索嘅 3D 場景,往往需要動用雲端 GPU 或者封閉式商業工具。一個新開源嘅世界生成項目反其道而行,主打「本地、免費、完全開源」,用家只需要餵一張圖片,或者寫一段文字 prompt,就可以產出一個可以行入去慢慢逛嘅 3D 場景。對遊戲開發、空間設計或者 VR 內容創作嚟講,呢種「零門檻起手」嘅流程可以省卻大量建模時間。

同一般文生圖或者文生影片模型唔同,呢類世界生成系統要處理嘅唔係單一畫面,而係保持視點一致嘅連續空間。背後通常會結合影像生成、深度估計同體積渲染(volumetric rendering)等幾組技術,再用 NeRF(Neural Radiance Fields,神經輻射場)或類近嘅 3D 表徵方式重建場景,等用家可以即時改變視角行入去睇。

對玩家嚟講,最直接嘅體驗係輸入一張京都街景相或者一句「霧夜嘅科幻實驗室」,幾分鐘之後就有一個可以操控角色行入去嘅小型世界;對開發者嚟講,由於整套工具鏈都係本地行得通,唔使擔心 prompt 或者素材被上傳到第三方伺服器,私隱同成本都較易掌控。

不過本地跑呢類模型對 GPU 仍然有要求,視訊記憶體唔夠嘅話生成時間會明顯拉長;另外世界嘅規模同互動深度仲未去到遊戲引擎嗰種水平,比較適合作為概念驗證或者素材起手稿,而唔係完整場景嘅最終方案。

以下係幾個值得留意嘅重點:

  • 支援圖生世界(image-to-world)同文生世界(text-to-world)兩種入口
  • 完全開源,可在本地離線運行
  • 採用神經輻射場或類近技術做 3D 重建,保持視角一致
  • 私隱同成本上比雲端方案更具優勢
  • 對 GPU 仍有要求,目前較適合做概念驗證階段

項目主頁

Categories: AI productions, 世界模型, Image, 影像處理, 教學, 3D

OraRL:標註即 Rollout,統一多模態模型強化學習

OraRL 把影片標註轉成可靠的正向 rollout,令同一模型兼顧定位、分割、追蹤、問答與空間理解。

Animated OraRL method preview

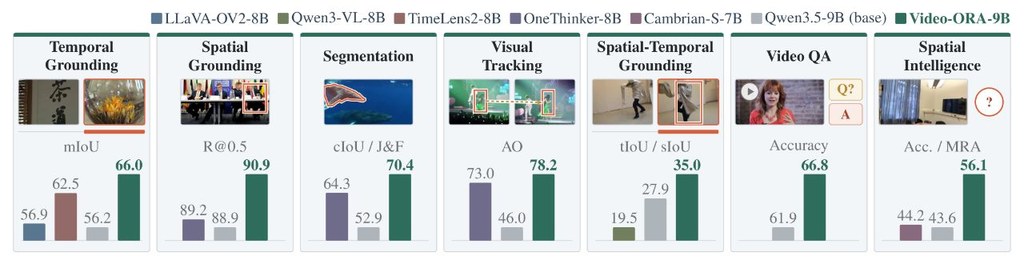
面對一段長影片,模型要同時回答內容問題、找出時間片段、定位畫面區域,往往要在多套任務方法之間取捨。OraRL 是一個用於統一影片多模態模型(video MLLMs)強化學習的研究項目,將原本只用來評分答案的標註,序列化成模型可直接學習的 oracle rollout。

它的核心做法是把一條標註答案加入同一提示的 policy samples,再只用 policy rewards 計算 on-policy baseline,避免準確標註扭曲模型原本的相對比較;annotation-policy reward gap 則用於方向性修正,最後以 sign-balanced pruning 篩選更新訊號。這個安排保留探索,同時不需要 chain-of-thought supervision 或額外解碼。

同一套更新規則覆蓋 temporal grounding、spatial grounding、segmentation、tracking、spatial-temporal grounding、video QA 及 spatial intelligence,Video-ORA-9B 則以一個模型處理七類影片理解任務。4B 設定的更新時間由每步 92.5 秒降至 62.4 秒,速度提升 1.48 倍,單張 GPU 峰值記憶體亦由 62.4 GB 降至 50.9 GB。

推理部分提供較實用的取捨參考:H20 以 vLLM 和 BF16 載入時,4B 及 9B 分別佔 8.6 GiB 和 17.6 GiB;十分鐘、每秒兩幀的影片採用 answer-only decoding 後,總延遲由 29.03 秒降至 24.30 秒。儲存庫列出 Environment、Training 及 Evaluation 文件,但提供的資料未包含完整安裝步驟或可直接下載模型的細節,較適合研究團隊按文件檢查環境後測試。

  • 訓練方法:標註同時作為正向 rollout 和任務有效的學習目標。
  • 涵蓋範圍:一套 RL recipe 支援七類影片感知任務。
  • 效率改善:4B 更新速度提升 1.48 倍,記憶體需求下降。
  • 推理優化:支援影片快取、一次解碼重用及 answer-only decoding。
  • 適合情境:需要統一處理影片定位、追蹤、分割、問答和空間推理的研究或工程團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 世界模型, 模型訓練, Video, 影像處理, 框架, Dataset 數據集

DiffusionOPSD:將自我蒸餾影像獎勵轉為可更新訓練目標

DiffusionOPSD 將影像級獎勵轉成可反覆更新的中間目標,補上 diffusion 訓練中間步驟的監督空白。它適合想在有限訓練預算下,改良生成質素同可診斷性的團隊。

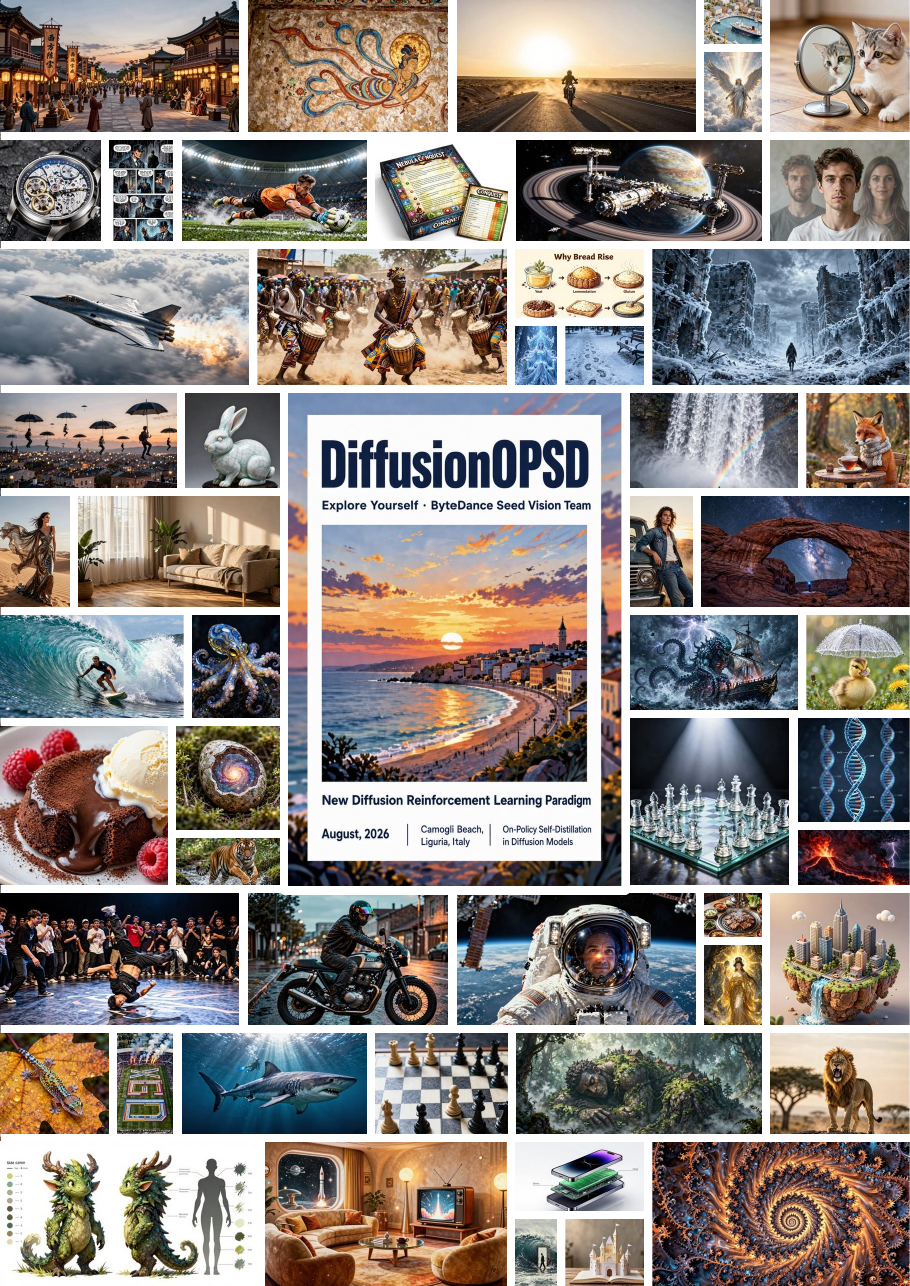
DiffusionOPSD qualitative gallery

DiffusionOPSD(ByteDance Seed) 主攻的是 diffusion 模型後訓練時,只有最終圖片分數、欠缺中間步驟指引的問題。它屬於一套用於模型後訓練的開源方法,透過 on-policy self-distillation,把影像級 reward 轉成可直接學習的中間目標。

它的做法不是單純追分,而是先用凍結的 behavior policy 收集低噪聲查詢狀態,再用 reward gradient 建出正負兩種 bounded target,最後由可訓練 policy 去擬合這些切斷計算圖的目標。這種安排把目標品質和模型更新分開處理,亦令 supervision 可以隨住模型演化持續刷新。

實作層面,公開版本支援 SD3.5-M 512²,同時覆蓋原生 few-step 的 Z-Image-Turbo 1024² 設定;文件亦提到可做單一 reward 或多個 reward 的加權訓練。原文未提供完整安裝流程或逐步使用指引,只能確認它有項目頁與程式碼釋出,適合自行拉取後依研究環境配置。

它和同類 diffusion reward optimization 的主要分別,在於用 on-policy 查詢配合 EMA 持續重建 supervision,而不是只依賴離線或固定噪聲替代狀態。官方結果聲稱在多個 evaluator 與兩種 backbone 上都有較強的最終 held-out 表現,亦以較少 GPU-hours 完成訓練;這令它特別適合做生成模型後訓練、獎勵對齊與方法比較的研究團隊。

  • 將 image-level reward 轉成可學習的中間目標
  • 用 EMA 反覆刷新 trajectory、anchor 與 target
  • 支援 SD3.5-M 與 Z-Image-Turbo 兩種 backbone
  • 可做單一 reward,亦可做多 reward 加權
  • 適合研究 diffusion 後訓練同 reward alignment 的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 字節跳動, 模型訓練, Image, 影像處理, txt2img, 框架

Rest2Art 用單張靜態觀察重建可動 3D 物件

只見到物件關上的樣子,Rest2Art 仍可推回零件結構與關節。對數碼孿生、模擬和機械人操作都幾實用。

Og image

只見到抽屜關上、櫃門未打開,系統仍要估到哪些部分可以動、會沿哪個軸轉或滑,這正是 Rest2Art 想處理的難題。它屬於 articulated object reconstruction,目標是由單一 closed-state observation 重建出可直接放入模擬環境的 articulated asset,而不需要先拍到物件在不同狀態下的運動。

這個做法的價值,在於把原本要靠動態觀察先完成的工作,提前到靜態輸入就處理好。Rest2Art 會先用 vision-language model 與 segmentation model 互相校正零件層級和遮罩,再把結果對應回 mesh;之後再借助 video diffusion model 產生可能的 articulation hypotheses,但真正的 joint parameters 不是直接照抄影片,而是再用幾何一致性去驗證。

回應了一個很現實的限制:很多日常物件未必容易拍到完整開合過程,但建模、模擬與機械人任務仍然需要知道它如何運動。Rest2Art 用 explicit mesh 作為中介,方便跨模型比對與融合,最後再把各部分轉成封閉體積,令輸出不只是「睇得明」,而是可用於 physical simulation。

  • 單靠 single closed configuration 重建 part-level geometry 與 joint parameters
  • 結合 vision-language model、segmentation model 與 video diffusion model 補足缺少 motion cues 的問題
  • 以 explicit mesh 做 cross-model verification and fusion,減少不同模型輸出互相衝突
  • 可輸出 simulation-ready articulated asset,並支援 URDF 匯出

論文描述顯示,它在 reconstruction-based、generation-based 與 modular pretrained-model families 之間,都能做到有競爭力的表現,重建出的零件分解與關節亦具備 physical plausibility。對數碼孿生、虛擬場景整合、real-to-sim-to-real,以及機械人 policy learning 而言,這種由靜態觀察直接產生可互動資產的流程,明顯比只重建外形更進一步。

項目主頁

Categories: 視覺模型, 多模態模型, Video, 影像處理, 框架, 3D, Dataset 數據集

LeapTalk:1 步生成會話數字人

講人像相片同語音,就能連續生成對嘴影片。LeapTalk把速度拉到接近即時,同時盡量守住人臉一致性。

teaser

想做會話數字人?卡位通常唔係能否生成,而係夠唔夠快、個樣會唔會愈播愈走樣。LeapTalk屬於開源 talking-head generation 項目,針對的正是即時串流、人臉一致性同嘴型同步三件事一齊要兼顧的難題。

它的吸引力在於每個影片片段只用 1 NFE 就可推進,在 Lite 設定下標示可達 200 FPS,而且 Web Demo 已經做成可載入人像圖、用文字或咪高峰對話的介面。底層並非單靠硬推速度,而是建基於 SoulX-FlashHead-1_3B,再配合 LoRAaudio_proj_step_*.ptwav2vec2-base-960h,用 audio-driven classifier-free guidance 強化對嘴。

  • 以 chunk-by-chunk streaming pipeline 連續生成長片
  • Brownian bridgeBridge Forcing 減少長片身份漂移
  • README 已交代需另外下載 base model、語音模型與 LeapTalk 權重
  • 推論前要自行填入 COND_IMAGEAUDIO_PATH 等本地路徑

同類做法常見取捨是速度快但畫面累積誤差,或畫質穩定但延遲高;LeapTalk明顯站在「先把延遲壓到可互動」這一邊,再用 reference-anchored data-to-data transport 補回穩定度。

現適合做數字人互動、虛擬主播、即時內容生成的團隊。200 FPS 與單張 H200 GPU 的說法來自項目提供資訊,普通硬件能否複製同樣效果、Web Demo 的完整部署細節是否齊備,仍要等更多實測佐證。

項目主頁 · GitHub

Categories: 開源, AI productions, 數字人, 視頻模型, 影像處理, Audio

MiniMax H3 萬眾期待的開放多模態模型

文字、圖片、影片同音訊都可混合輸入,再直接生成帶原生立體聲的短片。MiniMax H3把理解與生成放進同一套多模態系統,重點在跨模態一致性。

Og image

一段提示未必只得文字,亦可以連同圖片、影片甚至音訊一齊交畀模型處理;MiniMax H3就是朝住呢種工作流而設。頁面未提供 based onbase modelfine-tuned from 資訊,所以無法確認它係唔係建基於其他基礎模型微調而成,但已清楚標示為 image-text-to-video,而且屬於可同時理解同生成多模態內容的 generative system。

它處理的重點不只是由文字生片,而係把 text、images、video、audio 放入同一個上下文,再輸出最長 15 秒、最短 4 秒、可到 2K 的影片,並且附帶 native stereo audio。呢種設計的價值,在於畫面、聲音同指令可以一齊對齊,適合做 image-to-video、video-to-video、text-to-audio-video 以至 reference-to-audio-video 等任務,減少要分開串接多個模型的工序。

H3 是 task-generalization-oriented system,意思是模型在 pre-training 階段已經針對廣泛任務泛化而設計,唔係只為單一路徑生成。它強調 unified understanding of multimodal contexts,同時支援多種輸入來源與輸出規格;比例覆蓋 21:9、16:9、4:3、1:1、3:4、9:16 等常見格式,短邊預設 768 像素,最高可到 2K,反映它偏向面向內容製作與跨媒體生成,而不只是研究展示。

  • 支援 text-to-video、image-to-video、video-to-video,同時覆蓋 audio-video-generation
  • 可生成 4 至 15 秒影片,並輸出 native stereo audio
  • 輸入上下文可混合 text、images、video、audio,屬於 omni-modal 路線
  • Hugging Face 頁面標示 library_name: diffusers,代表可沿用 diffusers 生態整合

現階段較能確定的是,它把多模態理解與帶聲影片生成放入同一模型體系,對需要一致視聽輸出的項目有直接吸引力,但部署細節仍要等更完整技術文件補足。

項目主頁 · 模型

Categories: 開源, 多模態模型, 視頻模型, Video, Image, 影像模型, 影像處理, Audio, 3D, MiniMax

Montara 本地優先影片工作台

想用同一套時間軸管理生成、剪接同輸出影片,Montara 提供咗一條幾務實嘅路。它唔靠單一雲端服務,先確保你能穩定產出真正可播放嘅 MP4。

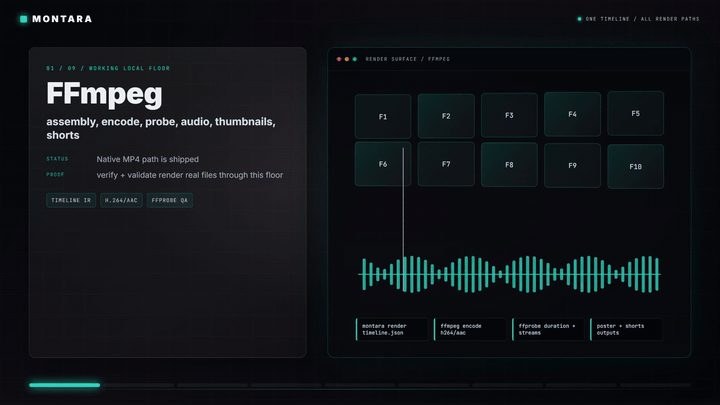
Montara engine matrix demo preview

做影片流程最麻煩,往往唔係生成一段畫面,而係素材、剪接決定、旁白、輸出格式同後續修改散落喺唔同工具。

Montara 就係朝住呢個痛點而來:一個本地優先嘅開源影片製作工具/框架,用 Timeline IR 做唯一時間軸來源,將規劃、編輯、渲染同交接串返埋。

它吸引嘅地方,在於先處理「冇雲端都要交到片」呢個現實限制。就算零 API keys,仍可經 FFmpeg 走本地 fallback 輸出可觀看 MP4,連字幕卡、語音路徑同部分媒體都預留咗本地方案;有裝 Remotion 就做 native smoke,冇裝亦會退回 FFmpeg,呢種設計比起只展示理想雲端流程嘅項目踏實得多。

同類做法常見係綁死某個生成服務或者某款剪片介面,Montara 反而把 provider 放成可插拔層,會建立 request、做 redaction、支援 dry-run 同 live-audit,但付費雲端呼叫要明確開啟。代價亦好清楚:它而家最成熟嘅係時間軸驗證、編輯操作、渲染路徑、editor bridge 匯入匯出,同埋真實 MP4 渲染與 post-render QA;README 亦講明長片規模仍屬 roadmap,唔係所有電影級工作流都已全面驗證。

  • Timeline IR 把場景計劃、剪接決定、匯入 editor cut 同生成素材收斂成一份 JSON
  • 本地路線完整,FFmpeg 係通用底線,部分 video/image/speech/music 有 fallback
  • 可匯出 EDL、OTIO、FCPXML,方便轉去 Premiere、Resolve、Final Cut 繼續做
  • provider 機制重視審計與可驗證性,適合要保留流程紀錄嘅團隊 較受惠嘅會係想把 AI 生成同傳統後期接埋嘅內容團隊、要保留本地控制權嘅創作者,或者打算讓 agent 參與影片流水線嘅開發者。

Montara 已經唔止係 demo 級拼裝,因為它把「可編輯來源」、「真實渲染結果」同「可交畀剪輯軟件接手」放埋同一條線;不過想追求高度成熟嘅長篇製作,仍要留意目前覆蓋範圍主要集中喺已測試嘅 renderer 同橋接能力。

GitHub

Categories: 開源, Agentic, API, Video, 影像處理, 框架, LTX

Page 1 of 21
1 2 3 21