用comfyui工作流制作PS免费插件,全攻略本地版!

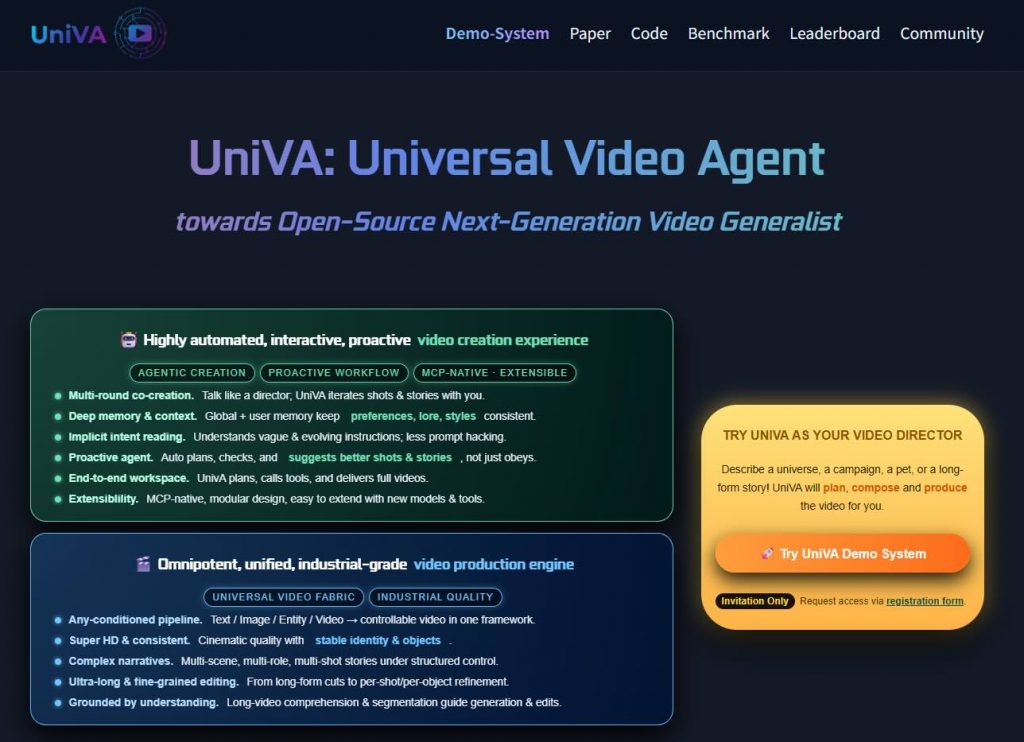
一套開源、多代理的「全能型影片處理框架」UniVA,目的是將影片理解、分割、剪輯與生成等功能統合成自動化且可擴展的工作流程。 主要創新與架構
一套開源、多代理的「全能型影片處理框架」UniVA,目的是將影片理解、分割、剪輯與生成等功能統合成自動化且可擴展的工作流程。


最近 AI 生成技術越來越流行應用 image to video,其中最常見的是駛用(first frame)和(last frame)作為提示(prompt)來引導 AI 模型產生更平滑的影片延續效果。令到生成的影片更加有連貫性。例如想由一個影片平滑過渡到另一個影片。ElFrame 正是專為這種工作流設計的簡單輔助工具,它專注影片快速提取最後一幀,用家能夠輕鬆攞到這些關鍵圖像作為後續 AI 生成的輸入。 ElFrame 是一個免費的(Video Frame Extractor),可以快速提取影片的任何一幀。這些提取出的圖像可以直接用於像 Wan 2.1 的 First-Last-Frame to Video 或者其他類似的 AI 工具(例如 Veo3、Luma Dream Machine、Runway ML),作為生成影片的邊界提示,減少生成過程的抖動和不連貫問題。順帶一提,呢個免費服務係由 OpenSpec 協助一邊睇戲一邊自動生成!
最近 AI 生成技術越來越流行應用 image to video,其中最常見的是駛用(first frame)和(last frame)作為提示(prompt)來引導 AI 模型產生更平滑的影片延續效果。令到生成的影片更加有連貫性。例如想由一個影片平滑過渡到另一個影片。ElFrame 正是專為這種工作流設計的簡單輔助工具,它專注影片快速提取最後一幀,用家能夠輕鬆攞到這些關鍵圖像作為後續 AI 生成的輸入。
ElFrame 是一個免費的(Video Frame Extractor),可以快速提取影片的任何一幀。這些提取出的圖像可以直接用於像 Wan 2.1 的 First-Last-Frame to Video 或者其他類似的 AI 工具(例如 Veo3、Luma Dream Machine、Runway ML),作為生成影片的邊界提示,減少生成過程的抖動和不連貫問題。順帶一提,呢個免費服務係由 OpenSpec 協助一邊睇戲一邊自動生成!
開源 Cosmos DiffusionRenderer 是一個視訊擴散框架,用於高品質影像和視訊的去光和重光。它是原始DiffusionRenderer 的重大更新,在 NVIDIA 改進的資料管理流程的支持下,實現了顯著更高品質的結果。 最低要求 Python 3.10 NVIDIA GPU 至少配備 16GB VRAM,建議配備 >=48GB VRAM NVIDIA 驅動程式和 CUDA 12.0 或更高版本 至少 70GB 可用磁碟空間 教學:
開源 Cosmos DiffusionRenderer 是一個視訊擴散框架,用於高品質影像和視訊的去光和重光。它是原始
DiffusionRenderer 的重大更新,在 NVIDIA 改進的資料管理流程的支持下,實現了顯著更高品質的結果。
最低要求
Python 3.10
NVIDIA GPU 至少配備 16GB VRAM,建議配備 >=48GB VRAM
NVIDIA 驅動程式和 CUDA 12.0 或更高版本
至少 70GB 可用磁碟空間

教學:


USO 全稱為「Unified Style-Subject Optimized customization model」,能將任何影像主體融入任何風格,開啟創作新紀元並在各種情境中自由揮灑創意。 傳統上,風格驅動生成模型側重於風格相似性,而主體驅動生成模型則強調主體的一致性,這兩者往往難以兼顧。USO 模型的誕生,打破了這種壁壘,它提出了一種統一的框架,透過對「內容」與「風格」的解耦與重組,實現了兩者的自由組合。無論您想將特定人物融入動漫風格,或是為靜物照片賦予水彩畫的韻味,USO 都能輕鬆應對。
你是否曾因圖像模糊而感到困擾?想放大照片卻又擔心細節盡失?在數位時代,清晰的視覺體驗至關重要。今天,我們將深入探討一項令人興奮的技術——Vision-SR1,一個基於視覺空間推理網路的圖像超解析度解決方案,它有望徹底改變我們處理低解析度圖像的方式。 圖像超解析度(Super-Resolution, SR)的目標是從低解析度(Low-Resolution, LR)圖像中重建出高解析度(High-Resolution, HR)圖像。這項技術在監控、醫學影像、娛樂等多個領域都有廣泛應用。然而,如何有效恢復細節並生成逼真的高解析度圖像,一直是研究人員面臨的挑戰。Vision-SR1 正是為了解決這一挑戰而誕生的創新方法。 Vision-SR1 項目,全名為「Visual-Spatial Reasoning Network for Image Super-Resolution」(用於圖像超解析度的視覺空間推理網路),其核心在於引入了一個獨特的視覺空間推理機制。這意味著它不僅僅是簡單地放大圖像,而是能夠理解圖像中的空間關係和視覺語義,進而更智慧地推斷和重建缺失的細節。透過這種方式,Vision-SR1 能夠生成更為精確和自然的高解析度圖像,顯著提升視覺品質.。
你是否曾因圖像模糊而感到困擾?想放大照片卻又擔心細節盡失?在數位時代,清晰的視覺體驗至關重要。今天,我們將深入探討一項令人興奮的技術——Vision-SR1,一個基於視覺空間推理網路的圖像超解析度解決方案,它有望徹底改變我們處理低解析度圖像的方式。
圖像超解析度(Super-Resolution, SR)的目標是從低解析度(Low-Resolution, LR)圖像中重建出高解析度(High-Resolution, HR)圖像。這項技術在監控、醫學影像、娛樂等多個領域都有廣泛應用。然而,如何有效恢復細節並生成逼真的高解析度圖像,一直是研究人員面臨的挑戰。Vision-SR1 正是為了解決這一挑戰而誕生的創新方法。
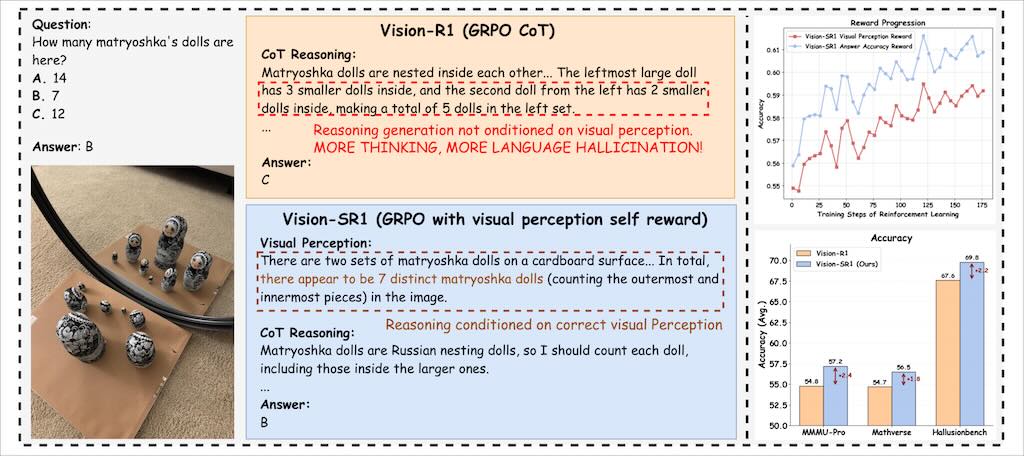
Vision-SR1 項目,全名為「Visual-Spatial Reasoning Network for Image Super-Resolution」(用於圖像超解析度的視覺空間推理網路),其核心在於引入了一個獨特的視覺空間推理機制。這意味著它不僅僅是簡單地放大圖像,而是能夠理解圖像中的空間關係和視覺語義,進而更智慧地推斷和重建缺失的細節。透過這種方式,Vision-SR1 能夠生成更為精確和自然的高解析度圖像,顯著提升視覺品質.。
ROSE2025,全名為「可靠且開放集事件修補(Remove Objects with Side Effects)」。旨在推動電腦視覺領域,為處理複雜、動態的視覺數據缺失問題提供更穩健、更智能的解決方案。在不斷演進的電腦視覺領域,事件修補(Event Inpainting)正成為一項引人注目的新興研究方向。 ROSE2025 涵蓋了多個關鍵研究主題,包括但不限於:基於生成式模型的事件修補方法、深度學習在事件資料恢復的應用、新穎的損失函數與評估指標、開源數據集與基準的創建、以及與機器人、自動駕駛、監控等實際應用場景的結合。
ROSE2025,全名為「可靠且開放集事件修補(Remove Objects with Side Effects)」。旨在推動電腦視覺領域,為處理複雜、動態的視覺數據缺失問題提供更穩健、更智能的解決方案。在不斷演進的電腦視覺領域,事件修補(Event Inpainting)正成為一項引人注目的新興研究方向。
ROSE2025 涵蓋了多個關鍵研究主題,包括但不限於:基於生成式模型的事件修補方法、深度學習在事件資料恢復的應用、新穎的損失函數與評估指標、開源數據集與基準的創建、以及與機器人、自動駕駛、監控等實際應用場景的結合。
