在動態場景中精確追蹤物體,一直是電腦視覺領域的一大挑戰。傳統的單目追蹤器常受限於深度模糊和遮擋問題,而現有的多攝影機解決方案又往往需要多達20多個攝影機,並進行繁瑣的逐序列優化。然而,一項由ETH Zürich等機構開發的創新技術——MVTracker,正以其獨特的方法,為多視角3D點追蹤領域帶來革命性的突破。
引領多視角3D追蹤進入數據驅動新時代
(more…)在動態場景中精確追蹤物體,一直是電腦視覺領域的一大挑戰。傳統的單目追蹤器常受限於深度模糊和遮擋問題,而現有的多攝影機解決方案又往往需要多達20多個攝影機,並進行繁瑣的逐序列優化。然而,一項由ETH Zürich等機構開發的創新技術——MVTracker,正以其獨特的方法,為多視角3D點追蹤領域帶來革命性的突破。 引領多視角3D追蹤進入數據驅動新時代
Logan Kilpatrick 目前在 Google DeepMind 任職資深 AI 團隊成員。主持人與 Logan Kilpatrick 的一次對談與示範,介紹Google最新的圖像生成與編輯AI模型Nano Banana(基於Gemini 2.5 Flash Image 模型)
Logan Kilpatrick 目前在 Google DeepMind 任職資深 AI 團隊成員。主持人與 Logan Kilpatrick 的一次對談與示範,介紹Google最新的圖像生成與編輯AI模型Nano Banana(基於Gemini 2.5 Flash Image 模型)

LIA-X (Interpretable Latent Portrait Animator)強調其控制性,適合 AI 研究者和內容創作者使用,旨在將臉部動態從驅動影片遷移到指定的頭像,並實現精細控制。 LIA-X 功能列表 LIA-X 的可解釋性與細粒度控制能力,使其支援多種實際應用: 圖像動畫 (Image Animation):能夠將驅動影片的臉部動態轉移到來源肖像上,並可透過控制面板進行編輯。使用者可以上傳來源圖像和驅動影片,然後使用控制面板編輯來源圖像,並生成動畫影片。 圖像編輯 (Image Editing):允許使用者上傳來源圖像,並透過控制面板對其進行精確編輯。這包括對臉部細節的控制,例如偏航 (yaw)、噘嘴 (pout)、閉眼和眼球移動。 影片編輯 (Video Editing):支援使用者上傳影片,並透過控制面板編輯影片的第一幀,以產生新的編輯後影片。同樣支援細粒度控制,例如頭部偏航和閉眼。 線性操控 (Linear Manipulation):可以進行諸如偏航 (yaw)、俯仰 (pitch)、眼睛閉合與張開,以及眼球移動等臉部動態的線性控制。 3D 感知肖像影片操控 (3D-aware Portrait Video Manipulation):這是一個更進階的應用,LIA-X 的可控性質支援此類應用。 動畫化個人資料 (Animating Your Own Data):支援使用者自行準備圖像和影片資料(例如裁剪),然後進行動畫化處理。 細粒度、使用者引導的圖像和影片編輯:作為其可解釋和可控性質的直接結果,LIA-X 能夠實現這種精確的編輯。
LIA-X (Interpretable Latent Portrait Animator)強調其控制性,適合 AI 研究者和內容創作者使用,旨在將臉部動態從驅動影片遷移到指定的頭像,並實現精細控制。
LIA-X 的可解釋性與細粒度控制能力,使其支援多種實際應用:
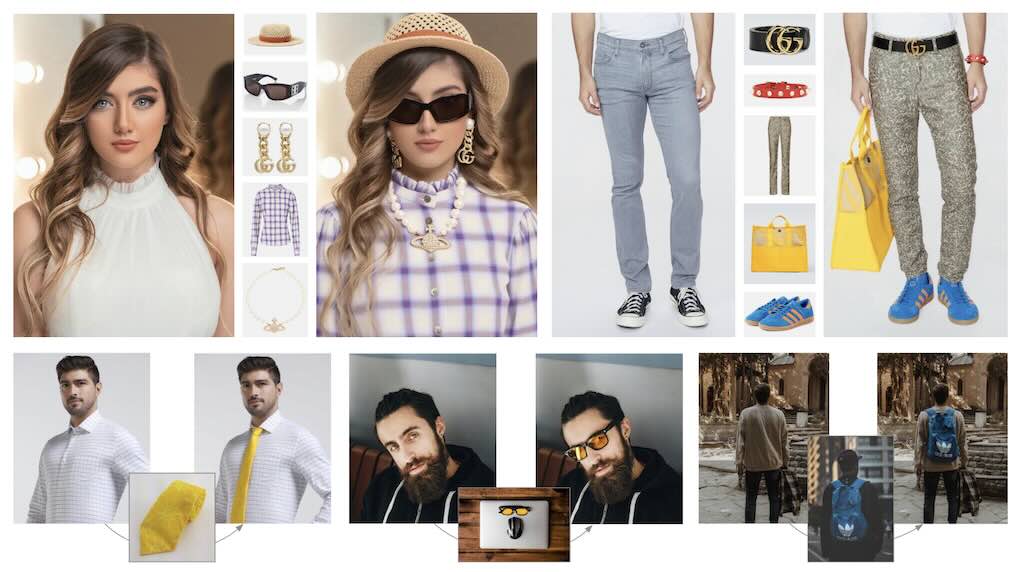
OmniTry,這是一個由昆位元人工智慧和浙江大學開發的虛擬試穿框架。該系統旨在擴展虛擬試穿功能,使其不僅限於服裝,還能應用於各種可穿戴物品,例如珠寶和配飾,並且支援無遮罩設置,更適合實際應用。OmniTry 採用了兩階段訓練管道,首先利用大量不成對的圖像進行無遮罩定位訓練,然後再利用成對圖像進一步精細調整以確保外觀一致性。該專案的程式碼、模型權重和評估基準都已公開發布,供研究人員和開發者使用。
LongSplat 是個用於從隨機拍攝的長影片中生成新穎視角的三維高斯噴灑(3D Gaussian Splatting)框架。它能夠解決從隨機拍攝、具有不規則攝影機運動和未知攝影機姿態的長影片中進行新視角合成的關鍵挑戰。
LongSplat 是個用於從隨機拍攝的長影片中生成新穎視角的三維高斯噴灑(3D Gaussian Splatting)框架。它能夠解決從隨機拍攝、具有不規則攝影機運動和未知攝影機姿態的長影片中進行新視角合成的關鍵挑戰。
Qwen-Image-Edit 是 Qwen-Image 的圖像編輯版本,基於20B模型進一步訓練,支持精准文字編輯和語義/外觀雙重編輯能力。它具備多項關鍵功能與技術優勢:
Qwen-Image-Edit 是 Qwen-Image 的圖像編輯版本,基於20B模型進一步訓練,支持精准文字編輯和語義/外觀雙重編輯能力。它具備多項關鍵功能與技術優勢:

傳統的卡通/動漫製作耗時耗力,需要技藝精湛的藝術家進行關鍵影格、中間畫和上色。 ToonComposer 利用生成式 AI 簡化了這個流程,將數小時的中間畫和上色手動工作簡化為一個無縫銜接的流程。
傳統的卡通/動漫製作耗時耗力,需要技藝精湛的藝術家進行關鍵影格、中間畫和上色。 ToonComposer 利用生成式 AI 簡化了這個流程,將數小時的中間畫和上色手動工作簡化為一個無縫銜接的流程。

FantasyPortrait 支援使用多個單人影片或單一多人影片驅動多個角色,產生細緻的表情和逼真的肖像動畫。 從靜態圖像中製作富有表現力的臉部動畫是一項極具挑戰性的任務。現有方法缺乏對多角色動畫的支持,因為不同個體的驅動特徵經常相互幹擾,使任務變得複雜。FantasyPortrait 提出了 Multi-Expr 資料集和 ExprBench,它們是專門為訓練和評估多角色肖像動畫而設計的資料集和基準。大量實驗表明,FantasyPortrait 在定量指標和定性評估方面均顯著超越了最先進的方法,尤其是在具有挑戰性的交叉重現和多角色情境中表現出色。
FantasyPortrait 支援使用多個單人影片或單一多人影片驅動多個角色,產生細緻的表情和逼真的肖像動畫。
從靜態圖像中製作富有表現力的臉部動畫是一項極具挑戰性的任務。現有方法缺乏對多角色動畫的支持,因為不同個體的驅動特徵經常相互幹擾,使任務變得複雜。FantasyPortrait 提出了 Multi-Expr 資料集和 ExprBench,它們是專門為訓練和評估多角色肖像動畫而設計的資料集和基準。大量實驗表明,FantasyPortrait 在定量指標和定性評估方面均顯著超越了最先進的方法,尤其是在具有挑戰性的交叉重現和多角色情境中表現出色。

Story2Board 是個無需訓練的框架,用於從自然語言中生成富有表現力的故事板。目標是將敘事呈現為一系列連貫的故事板面板——每個面板描繪不同的場景,同時保留主要角色的身份和外觀。
Story2Board 是個無需訓練的框架,用於從自然語言中生成富有表現力的故事板。目標是將敘事呈現為一系列連貫的故事板面板——每個面板描繪不同的場景,同時保留主要角色的身份和外觀。

Omni-Effects 是一套針對視覺特效(VFX)生成的統一框架,主打多效果合成和空間可控性。這項技術突破了以往僅能針對單一特效單獨訓練(如 per-effect LoRA)的限制,可同時在指定區域生成多種特效,極大拓展了在影視製作及創意領域的應用可能性。 框架的核心包含兩項關鍵創新:(1) 基於 LoRA 的混合專家 (LoRA-MoE),將多種效果整合到統一模型中,同時有效地減少跨任務幹擾。 (2) 空間感知提示 (SAP)將空間遮罩資訊合併到文字標記中,從而實現精確的空間控制。
Omni-Effects 是一套針對視覺特效(VFX)生成的統一框架,主打多效果合成和空間可控性。這項技術突破了以往僅能針對單一特效單獨訓練(如 per-effect LoRA)的限制,可同時在指定區域生成多種特效,極大拓展了在影視製作及創意領域的應用可能性。
框架的核心包含兩項關鍵創新:(1) 基於 LoRA 的混合專家 (LoRA-MoE),將多種效果整合到統一模型中,同時有效地減少跨任務幹擾。 (2) 空間感知提示 (SAP)將空間遮罩資訊合併到文字標記中,從而實現精確的空間控制。