UA-NWM 不確定性無人機導航

無人機朝目標圖片飛行,最難唔係預測一條路,而係判斷目標畫面是否仍屬合理路徑。UA-NWM 解決「模型解釋唔到」的誤差。

Repository image for DurYi/UA-NWM

戶外無人機導航最易出錯的位置,在於前方畫面未必只有一種合理變化。UA-NWM 把這個問題當成 world model 的評分工作處理,面向 aerial image-goal navigation,唔再只估一個未來畫面再同目標硬碰硬,而係判斷目標圖片是否落在模型預測的未來狀態分佈之內。

它最值得留意的技術點,是用 Hierarchical Error Projection(HEP)把預測與目標之間的差距拆成可由不確定性子空間解釋的部分,同埋解釋唔到的殘差,最後只用後者作為 trajectory cost。呢種做法同單點預測式 ranker 的分別很直接:同樣見到偏差,UA-NWM 會先問偏差是否屬於合理未來變化,而唔係一概當成走錯路。

模型本身會預測未來的 DINO latent features,配合 deterministic future feature map 同 uncertainty subspace 做單次 forward scoring,避免靠隨機抽樣多個未來狀態先完成比較。同一個 checkpoint 可配合兩種 inference strategy,包括 uncertainty-aware 的 UA-NWM 與 deterministic baseline,適合研究團隊直接比較兩種評分邏輯帶來的差異。

  • 適合 UAV 導航、戶外機械人感知,以及要由目標圖片反推行進路線的團隊
  • 重點唔係生成最像的未來畫面,而係判斷目標是否仍在合理未來分佈內
  • 提供 AirGoal-10k 的 training、evaluation、trajectory ranking、CEM/MPC planning 與 visualization workflow
  • deploy/ 內有真實部署用的 server-side policy wrapper,但原始資料未完整交代整套部署步驟

它已對應 AirGoal-10k,並包含真機 UAV demo、資料集連結與 pretrained checkpoints;受益最大的是需要處理大範圍戶外場景、多解未來觀測,以及想把 world model 直接接到規劃器如 CEM/MPC 的團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, 世界模型, 模型訓練, Image, Dataset 數據集, 百度

SimWAM:把 AI 影片變成自動駕駛規劃

華中科大與東風研發團隊提出的 SimWAM,將影片專家和動作專家共同訓練,再丟掉影片分支只保留規劃器。它把未來畫面學到的動態先驗,轉成較低延遲的軌跡預測。

Overview of the SimWAM architecture with isolated attention

華中科技大學與東風研究團隊合作提出 SimWAM,重點是把影片生成的能力轉成自動駕駛規劃訊號,而不是在推理時硬做未來影像生成。它屬於 World-Action Model (WAM),直接處理端到端自動駕駛中的軌跡預測與規劃問題,目標是減少延遲,同時保留對交通動態的理解。

訓練時,系統會把預訓練影片專家和輕量動作 DiT 一起做 joint flow matching,讓未來畫面學到的動態先驗滲入動作表示。兩邊共享注意力流,但用 isolated attention mask 令未來片段和動作 token 不會互相偷看,推理時就可以直接丟掉影片分支,只留下動作專家。

  • 研究團隊來自 Huazhong University of Science & Technology 和 Dongfeng Research & Development Institute。
  • 推理階段不需要未來場景生成,也不需要額外動作模組。
  • 動作專家可獨立縮放,影片骨幹亦可替換,結構相對靈活。
  • 在 NAVSIM 上取得 91.5 PDMS,並可 zero-shot 遷移到 nuScenes。
  • 強化學習部分用 FlowGRPO 去優化組合式駕駛獎勵,只更新動作專家的 LoRA adapters。

它最值得留意的地方,不在於把模型堆得更大,而是把訓練用的影片訊號和部署用的規劃器切開,令系統在保留動態理解的同時減少推理負擔。官方沒有完整列出安裝步驟,因此較適合先按論文與程式庫說明理解其訓練和部署流程。

GitHub · 模型

Categories: 開源, 視覺模型, VLA, 中國

RVC WebUI:低門檻變聲框架的實用與代價

這個語音音色轉換框架把訓練、推理和即時變聲放進同一個網頁介面,重點是讓少量語音資料也能做出可用效果。它的強項在於速度、易用性和模型融合,代價是硬件與延遲條件仍會影響體驗。

Repository image for RVC-Project/Retrieval-based-Voice-Conversion-WebUI

RVC(Retrieval-based Voice Conversion)WebUI 把語音音色轉換、變聲推理和即時變聲收進同一套 Web 介面,適合要快速做 AI 歌聲、配音修音或聲音風格替換的人。它不是單純展示效果,而是把訓練、檢測、推理和即時輸出串成一條可操作流程,降低了進入門檻。

這個項目主打少量資料也能訓練出可用模型,官方建議至少準備 10 分鐘低底噪語音。它採用 top1 檢索去替換輸入特徵,減少音色洩漏,並用 InterSpeech2023-RMVPE 做人聲基頻提取,處理哑音問題時速度快、資源占用也較小。

支援 Python 3.12 x64;Ubuntu 24.04、Windows 與 Linux 都有對應路徑,A 卡和 I 卡則走 CPU 依賴方案,Windows 亦可用 DirectML。即時變聲延遲官方標示可達端到端 170ms,配合 ASIO 輸入輸出設備時可進一步降到 90ms,但對硬件驅動支援要求較高。

  • 可用少量語音資料訓練,門檻比傳統聲音模型低
  • WebUI 同時覆蓋訓練、推理與即時變聲
  • ckpt-merge 允許用模型融合去調整音色
  • 可接入 pymss/MSST 分離人聲與伴奏
  • 更適合配音、歌聲轉換、直播變聲與聲音原型測試

GitHub

Categories: 開源, 數字人, 模型, Linux, Python, 語音, 中國

AVE-Compass:音畫編輯終於有了更嚴格的驗收尺

AVE-Compass 把音效、畫面與指令完成度放在同一套測試中,揭示編輯模型最容易忽略的失真與不同步問題。

AVE-Compass overview

音畫編輯模型最難兼顧「改得夠準」與「其他內容不走樣」。AVE-Compass 是一套針對自由格式音訊影片編輯的診斷基準及評估工具,檢查模型有沒有完成指定修改,同時保留非目標畫面和聲音,亦會捕捉音畫不同步與感知瑕疵。

測試範圍包括145段來源影片、196條經人工核實的音畫指令、2,688項細緻 checklist,以及28種編輯操作,涵蓋聯合音畫、語音、純影片和純音訊修改。它以 Multimodal Large Language Model (MLLM)-as-Judge 配合跨模態、影片及音訊自動指標,分開計算 Instruction Following、Fidelity Preserving、Editing Intent 和 Realism。

MiniMax H3 Turbo LoRA Faster Sampling Steps & Prompt Agent Skill

使用者可從 AVE-Compass-v2 資料集取得樣本,再按設定檔和輸入模板交予評估 pipeline,輸入來源影片、指令、checklist 及模型產生的編輯結果。樣本以共享的識別值配對,來源影片則由 instruction JSON 解決;未啟用或缺失的客觀指標會維持未設定,不會被當成虛構的零分。

重點可整理為:
– Editing Intent 同時要求完成修改及保留非目標內容,避免模型不作修改卻取得偏高保存分數。
– 音訊執行和音畫時間同步是常見失分位置。
– AVE-Agent 加入 planning 和 self-reflection,對複雜指令的 Editing Intent、Instruction Following 及音訊處理有較明顯改善。
– 基準適合研究團隊比較模型,也適合影片生成產品建立回歸測試。

它的價值不在於只給一個總分,而是把「改錯了甚麼」拆開呈現;代價是需要模型輸出影片、完整評估資源及相應 MLLM,部署門檻高於單純像素或音質比較。對正在開發跨模態編輯模型的團隊,AVE-Compass 更像一套找出失敗原因的驗收框架,而不只是排行榜。

項目主頁 · GitHub

Categories: 開源, 南京大學, Agentic, 多模態模型, 語音, Dataset 數據集

Ego2Robot 把人類影片轉成機械人訓練數據

Ego2Robot將第一身人類操作影片轉化成大規模機械人訓練數據,改善 VLA 模型面對陌生環境時的泛化能力。

Ego2Robot pipeline overview

機械人要應付陌生場景,往往需要大量而且多樣化的示範數據;Ego2Robot選擇從第一身人類操作影片取材,將人手動作轉換成不同機械人形態可以使用的訓練資料。這個數據合成項目面向 Vision-Language-Action(VLA)模型預訓練,處理人類影片與機械人動作、視覺外觀不一致的問題。

流程分為動作對齊、視覺對齊和品質篩選三部分。系統會把拇指、食指、中指指尖及手腕等關鍵點重新映射到夾爪的 TCP、開合幅度和方向,再以 Savitzky–Golay 及 SLERP 平滑動作;視覺處理則結合 SAM 3、ProPainter、機械人底座姿態搜尋和 IK solving,把機械人手臂合成到已修補的人類場景中。

項目支援已有手部姿態標註的數據集,也可以從原始影片估算姿態,後者使用 WiLoR 逐幀重建和 DynHaMR 時序最佳化。統一流程可以平行產生 15 種 robot morphologies,累積 18,561 小時訓練數據,涵蓋較多任務、場景和機械人配置。

重點包括:
– 同時支援 curated datasets 和 in-the-wild videos
– 以多層 quality curation 篩走動作及視覺合成中的低質資料
– RoboTwin 2.0 加入視覺外觀、場景佈局、機械人形態和任務語義等干擾軸
– 與機械人數據聯合預訓練後,多種 out-of-distribution 情況下的泛化能力提升
– 改善效果亦在真實機械人部署中獲得驗證

對需要建立通用機械人操作模型的研究團隊,Ego2Robot提供了一條減少真人示範收集成本的路線。不過,合成數據的品質仍取決於手部姿態估算、動作重定向、逆運動學和場景合成是否準確,因此它較適合作為真實機械人數據的補充,而不是完全取代實體部署資料。

項目主頁

Categories: 阿里巴巴, 視覺模型, 多模態模型, 模型訓練, Qwen, Video, VLA, Robotic, 中國, Dataset 數據集

DeepVoyager-VL 把視覺線索放回搜尋流程中

DeepVoyager-VL不只是睇圖再答題,而係會用新取得嘅視覺證據決定下一步搜尋。對長流程多模態檢索項目而言,呢個改動幾關鍵。

Comparison of multimodal search data synthesis paradigms

當一個多模態 agent 要連續查多步資訊,最易失準嘅位置往往唔係答題,而係中途搵錯線索。DeepVoyager-VL處理嘅正正係呢個問題:佢屬於長流程多模態 deep-search 框架,讓新取得嘅圖片證據直接影響下一輪檢索,而唔係只喺輸入開頭或答案結尾先用到視覺資訊。

呢種做法令佢同一般把視覺訊息包裝成前置條件嘅方法有明顯分別。DeepVoyager-VL背後用 EventVoyage-VL 生成帶有中間視覺依賴嘅長流程問題,再用整理過嘅 trajectories 做 Supervised Fine-Tuning(SFT),而唔加額外 reinforcement learning 階段;取捨好清楚,訓練流程較可重現,但效果仍然要靠資料合成質素同軌跡篩選撐住。

倉庫而家已經放出 paper、project page,同可重現嘅 Megatron SFT training bundle,亦提供 DeepVoyager-VL-8B 同 DeepVoyager-VL-30B-A3B 模型,以及 EventVoyage-VL dataset。想理解點樣驗證,最直接係沿住現成模型、資料集同訓練 bundle 睇完整流程;README 亦提到 SWIFT RUNTIME=bundled 會使用儲存庫內嘅 source trees,定位上比較接近研究與訓練復現項目,而唔係即開即用嘅消費級產品。

  • 核心改動:把 vision in the loop 放入搜尋中段,圖片可按需要先載入或裁切
  • 資料來源:EventVoyage-VL 先做 structure-before-language synthesis,再抽出可監督軌跡
  • 訓練路線:以 supervised-only 為主,冇再疊 reinforcement learning 階段
  • 結果:8B 同 30B-A3B 平均分別為 54.8 同 58.6,並在十個 benchmark 入面分別拿下八個同九個最佳成績

分數本身已經講到定位:DeepVoyager-VL不只是追求更大模型,而係想改善「見到新圖之後,下一步應該搵乜」呢個決策環節。較受益嘅會係做多步檢索、多模態問答、研究型 agent pipeline 嘅團隊;要留意嘅限制亦同樣直接,成效高度依賴合成資料點樣把中途視覺依賴編排得夠真實,離開相關 benchmark 之後,泛化深度仲要靠後續驗證。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 北京大學, 華為, Agentic, 模型, 多模態模型, 模型訓練, 框架, Dataset 數據集

MBM:跨類別動作轉移突破

你可以把它理解成一套跨類別影片動作轉移框架,重點是外形差很多時仍保住動作與身份。

Framework

想把一段動作搬到另一個角色或畫面,最怕形態差太遠時連身份都一併扭曲。MBM 走的是一套 motion transfer 研究框架,重點是把跨類別動作轉移做得更穩,讓 reference video 的動作可以連同 text,必要時再加一張 reference image,一起驅動生成。

它分兩段處理:Stage I 先學 heterogeneous abstract motion conditions,再 bootstrap cross-category motion pairs;Stage II 再用 raw reference videos 把這套監督內化。推理時直接靠 reference video、text 和 optional reference image,不需要 explicit motion extraction 或 test-time optimization。

它和只在相近外形之間搬動作的做法不同,目標是連 same-category、near-category 到 far-category 都盡量維持 motion fidelity 與 target preservation。資料同時提到 OpenVMT-Dataset 和 OpenVMT-Bench,前者是 instance-level motion-equivalent cross-content pairs,後者則用逐步拉大的 category gap 去測。

  • 兩階段框架先學抽象動作,再把監督內化到生成流程
  • 推理端直接吃 reference video、text、optional reference image,流程較短
  • 主打跨類別動作轉移,適合影片生成、角色動作遷移、動畫合成
  • 在大形態差距下仍可維持較好的動作保真與目標保留

項目主頁 · GitHub

Categories: 開源, 北京大學, AI productions, Video, Image, 框架

[技術文章] StyleForge 以反事實推理統一室內家具風格配搭

面對固定間隔的室內佈局,StyleForge 不再逐件揀家具,而是連同整個房間一齊判斷風格協調。你可以把它理解成一個會追蹤跨家具衝突的選件框架。

Hero image preview

固定佈局的室內家具風格配搭,難點唔係搵到單件外觀相符嘅家具,而係放埋一齊之後會唔會撞色、撞材質,甚至整體氣質唔夾。StyleForge 就係針對呢個問題而設,喺唔改變家具類別、位置、朝向同比例嘅前提下,幫系統為每個家具槽位揀出更一致嘅組合。

現有做法多數只係逐件檢索,或者靠靜態關係去描述房間,結果容易忽略全局配搭。StyleForge 改用 scene-level structured selection framework,先由凍結嘅 multimodal large language model(MLLM)抽取風格線索,再由可學習嘅候選分佈配合 dynamic hypergraph style field,捕捉家具之間更高階嘅依賴。

佢另一個重點係 counterfactual style preference learning。做法係將每個候選視為當前風格場入面嘅局部替換,然後用 Mahalanobis energies 去評估同上下文嘅相容性,訓練時再交替優化風格場同候選 logits;推理時只更新房間專屬嘅候選 logits,逐步修正跨槽位衝突。

  • 同時考慮單件相關性同整體房間協調
  • 用動態 hypergraph 去表達跨家具依賴
  • 以反事實推理檢查候選喺場景中的相容性
  • 推理階段只調整房間專屬 logits,模型主體保持凍結
  • 喺 3D-FRONT 上做出較一致嘅固定佈局家具安排

作者喺 3D-FRONT 上展示咗更高嘅 furniture retrieval 表現,同時亦提升 scene-level style coherence。對做虛擬室內設計、3D 內容製作,或者需要穩定室內擺設嘅 immersive embodied environments,呢種「先睇整體,再揀單件」嘅方法會更貼近實際需要。

Paper

Categories: 框架, 3D, 中國

See2Think 驗證多模態模型有冇「睇圖再諗」

多模態模型會畫輔助線、標示區域,未必代表後續推理真係依賴咗呢些中間視覺狀態。See2Think想量度的,正正就是這段常被忽略的過程。

See2Think — Do Multimodal Models Really Use Intermediate Visual States?

見到模型會畫線、裁圖、標記物件,很多人自然會當它「有睇過先答」。See2Think屬於基準測試加診斷框架,焦點不是只看最後答啱幾多,而是拆開檢查中間視覺狀態有冇被真正用到、渲染是否忠實,以及後續推理有冇因此改變,這點對多模態模型(Multimodal Models)尤其關鍵。

它的核心設計分成兩部分:See2ThinkBench 收錄 1,200 條 visually dependent 問題,涵蓋 2D structured reasoning、3D scene reasoning 同 real-world visual reasoning;另一部分是 Visual Action-of-Thought(VAoT)流程,會把文字思路、structured visual actions、rendered states 同之後的推理串連起來。這種做法比單看 final-answer accuracy 更有診斷力,因為可以分辨模型是在「做出圖像」還是在「依賴圖像」。

同類研究常停留在結果分數,See2Think較著重受控比較。它設有 CoT、NoRender、Full、WrongRender 等 matched comparisons,又會檢查 render-benefit、corrupted-feedback sensitivity,以及 process judging 裡的 relevance、faithfulness、uptake,換句話說,不只問模型答得對不對,還會問中間那一步是否相關、是否被正確執行、以及模型有沒有吸收回來的視覺資訊。

  • 適合研究多模態推理、agent 行為分析、視覺工具鏈設計的團隊
  • 強項在於把「中間圖像是否有用」變成可觀察、可干預的測試問題
  • 覆蓋圖表、幾何、符號結構、3D 空間關係到真實圖片場景
  • GitHub 已公開程式與 quick start 線索,但論文仍標示為 coming soon,細部實驗設定仍要以後續正式文件核對

對模型評估要求較細緻的情境,這個項目很有參考價值;想拿它直接當應用工具就未必是同一回事。它更像研究型基礎設施,幫團隊判斷多模態系統的推理鏈是否可信,而不是單純追求更高答題分數。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 上海人工智慧實驗室, Agentic, 多模態模型, 3D, Dataset 數據集

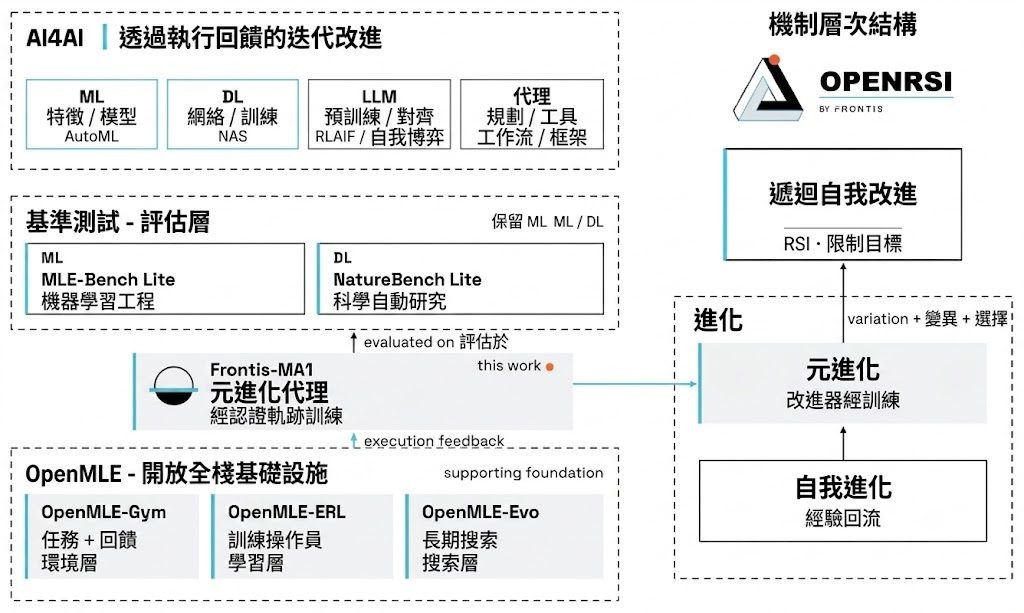
OpenRSI 實現 AI 可控的自我進化流程

OpenRSI唔只放出模型,而係連訓練、任務、搜尋流程一併公開。對想研究 AI4AI 同 Machine Learning Engineering 的團隊來說,它更像一套可重跑的實驗場。

OpenRSI by Frontis

OpenRSI(Recursive Self-Improvement) 唔係單獨放出一個模型,而係把「AI improving AI」拆成可以執行、量度同重現的整套機械學習工程流程。它屬於開源研究框架加模型組合,核心想處理的是:點樣令 AI 不只寫程式,而係能夠持續改良建立 AI 的方法本身。

OpenRSI 由 OpenMLE 同 Frontis-MA1 連動組成。OpenMLE 負責提供可驗證任務環境、執行回饋、RL 與 evolutionary search;Frontis-MA1 則是一個 post-trained AI4AI model,圍繞 Draft、Improve、Debug、Crossover 四種程式演化操作運作,將訓練到的能力接到長步驟搜尋流程之中。呢種做法的取捨很明顯:它追求可重跑與可評測,所以系統較完整,也比只放模型權重的項目更講究環境與任務設計。

項目較適合研究 Agentic workflow、Machine Learning Engineering、自動化實驗搜尋,或者想分析 execution-grounded learning 點樣落地的團隊。資料已列出 Hugging Face 模型、GGUF 衍生版本、Tasks 同 SFT traces,亦有專屬 project page;但目前公開資訊著重系統構成與結果展示,README 摘錄未完整交代詳細安裝步驟,部署前仍要配合原始倉庫與外部連結自行核對。

  • OpenMLE 提供 gym、RL、Evo 等完整堆疊,不只是一組 benchmark
  • Frontis-MA1 把 operator learning 同 long-horizon search 接埋,重點在可執行研究循環
  • 公開內容包括模型、任務資料集、SFT traces,同時照顧訓練與評測重現
  • 提供 GGUF 格式在本地執行推理 的衍生版本,方便不同部署路線

效能方面,項目頁面列出 Frontis-MA1 在 MLE-Bench Lite 由 39.39 提升到 71.21,設定為每個 task 12 小時、單張 RTX 4090 並限制 12 GB VRAM,成績高於 GPT-5.5 + Codex。呢個結果反映它強項在於把執行回饋、後訓練同演化搜尋接成一個閉環;不過現階段它仍主要面向 Machine Learning Engineering,較像一個為 RSI 研究而建的開放實驗平台,而唔係通用型開發工具。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, 模型, Dataset 數據集

Page 8 of 20
1 … 6 7 8 9 10 … 20