ForgeWM 把遊戲世界模型推向 72 FPS 即時互動

由中大、騰訊等團隊開發的 ForgeWM,將遊戲畫面生成壓縮至一至四步,讓鍵盤、滑鼠及手掣輸入能即時改變虛擬世界。

ForgeWM

中香港中文大學、騰訊 PCG、復旦大學、上海人工智慧實驗室及香港科技大學的研究團隊,將 ForgeWM 做成開源的 action-conditioned video world models 訓練項目,處理遊戲輸入與連續畫面生成難以兼顧的問題。它以 Matrix-Game 2(MG2)為基礎,讓模型根據鍵盤、滑鼠或 gamepad 操作即時推演遊戲畫面。

ForgeWM 的價值在於把生成步數降至 1、2 或 4 步,換取更低延遲的互動體驗;取捨是畫面質素、控制準確度與推理速度仍要依賴訓練資料和硬件。相較只展示影片生成的做法,ForgeWM 直接處理 frame-aligned 的動作訊號,並將同一套流程移植到另一個 gamepad 驅動的 FPS 領域。

  • 一套四階段流程:bidirectional SFT、teacher-forced causal AR、consistency distillation、on-policy DMD
  • ForgeWM-1、ForgeWM-2、ForgeWM-4 分別對應一、二及四步生成
  • 單張 H20、352×640 畫面下,1-step 模型最高達 72 FPS
  • 完整公開 weights、training code 及 pre-encoded data

模型並非各自獨立訓練:Stage 0 先對目標遊戲作 bidirectional fine-tuning,之後固定為教師;Stage 1 將生成器改成 causal AR,Stage 2 壓縮 sampling trajectory,Stage 3 再用學生自行 rollout 的結果進行 on-policy matching。這個結構讓 ForgeWM-1、-2、-4 可從相同基礎流程按步數預算建立。

研究、遊戲 AI 及需要即時互動生成的團隊較容易受益,尤其適合測試鍵鼠控制的 Minecraft 或 gamepad FPS。資料提供的指標包括 168 ms per chunk、72 FPS 及 8×H20 完整訓練配置;模型及數據連結整理環境,要預留 8 張 H20 重現完整訓練流程。
項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, 上海人工智慧實驗室, 騰訊, 世界模型, 模型訓練, Video, World-Action Model

FACET-Terminal:讓終端任務由可執行環境先行生成

FACET 把技能、Docker 環境、解法與驗證器連成同一狀態,產出可真正執行驗證的終端任務。

FACET: Preserving Source Intent and Executable State in Terminal Task Synthesis

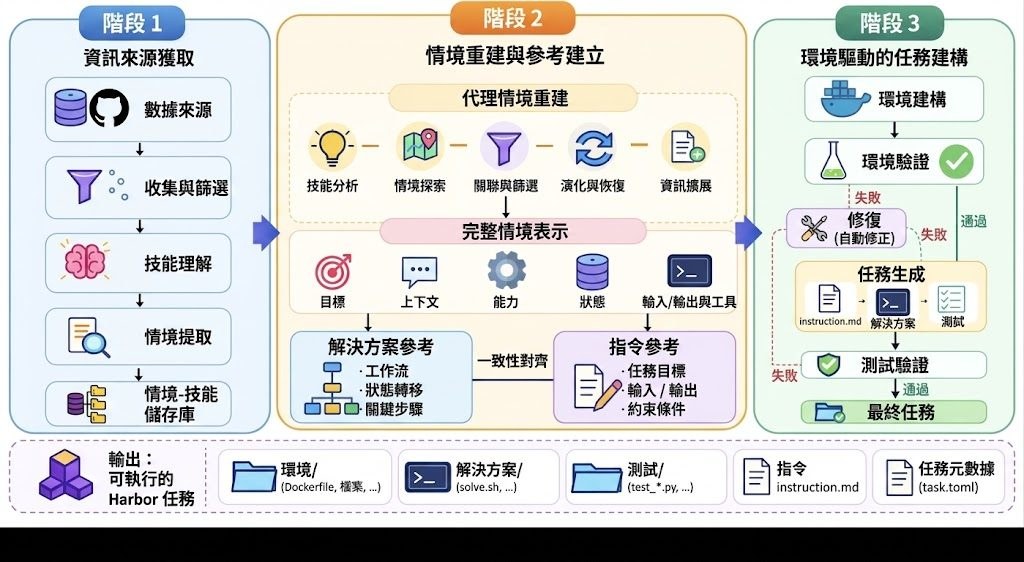
終端 AI Agent 最怕指令寫得合理,環境、解法和驗證器卻互相對不上。FACET(Fine-grained Agentic Construction of Executable Tasks)是一套終端任務合成框架,先建立並修復 Docker 環境,再讓指令、參考解法和驗證器共享同一套執行狀態,處理複雜任務難以穩定測試的問題。

項目由 71,341 個來源技能整理出 7,852 條場景—技能種子,最後取得 6,078 個通過執行驗證的任務,並從成功 rollout 篩選約 1.2K 條完整軌跡,用於監督微調 Qwen3.5 系列模型。環境中的檔案、路徑、套件、連接埠、資料結構和測試資料會沿流程傳遞,減少純文字交接造成的落差。

資源包括 FACET-Terminal-Tasks-6k 數據集,以及 FACET-Terminal-Qwen3.5-4B、9B 和 27B 模型。要重現任務合成流程,需要 Python 3.11–3.13、uv、Docker 和模型 API;配置與 Python 程式集中在 facet/,並提供 FORWARD、REVERSE、JOINT 三種生成策略作比較。

Terminal-Bench 2.1 的三次獨立執行平均結果顯示,4B、9B、27B 模型分別由 17.60、27.34、40.82 提升至 24.72、35.58、47.57;4B 相對提升 40.5%,27B 更接近同設定下 Qwen3.5-397B 的 49.06。這批數據規模仍然有限,任務質素亦依賴 Docker 環境和驗證器是否正確,較適合研究 Agent 訓練、Terminal-Bench 評測及需要可重現終端操作的團隊。

  • 資料基礎:6,078 個通過執行驗證的任務
  • 生成方式:環境先行,指令、解法與驗證器共享狀態
  • 公開模型:Qwen3.5 4B、9B、27B
  • 評測結果:27B 在 Terminal-Bench 2.1 達 47.57
  • 適合場景:終端 Agent 訓練、任務合成及可重現評測

項目主頁 · GitHub · 模型

Categories: 開源, 上海人工智慧實驗室, Agentic, 模型, 模型訓練, API, Python, 中國, Dataset 數據集

HarnessEval-W 讓世界模型評測留下可核查推理鏈

世界模型評測不再只給一個分數,HarnessEval-W把每次判斷拆成可追溯的證據樹,讓物理與因果錯誤更容易核對。

HarnessEval logo

當世界模型生成一段互動場景,真正難判斷的往往不是畫面是否漂亮,而是物理、因果和世界狀態有沒有隨行動正確演變。HarnessEval-W 屬於開源的 agentified benchmark,實際處理的是如何把這些需要理解上下文的評測工作,轉化成可檢查、可重現的判斷流程。

它借用 Large Language Model(LLM)生態常見的 harness 思路,先按每個 evaluation case 的初始世界、action 和 probe intent 分解問題,再由具備不同工具與上下文的 specialized sub-agents 分工判斷,最後由 parent agent 驗證證據並整合 verdict。每次評測都會留下 evidence tree,記錄測試內容、視覺依據和完整推理鏈,研究團隊可以追查分數由何而來,而不是只接受一個難以解釋的 scalar score。

  • 支援 330 個 evaluation cases、5,940 次 scored rollouts
  • 以 11 個 specialized evaluation skills 覆蓋品質、轉換與持續性
  • 涵蓋 18 個 world models,並提供 leaderboard 與可執行評測程式
  • 包含 harnesseval-metrics,以及 physical-plausibility backend harnesseval-pavrm

HarnessEval-W 在 intentional transition 上與人類 Bradley–Terry ranking 的 Spearman correlation 為 0.93;physical transition 的 pairwise accuracy 達 71.7%,高於 WBench 的 31.9%。重複評測的結果範圍亦較 WBench 窄 4.9 倍,但這些數字仍取決於案例設計、技能路由和代理判斷品質,不能直接視為所有世界模型任務的通用排名。

項目提供固定 plans、benchmark 資源、metric backends 和可延伸的 skill library;團隊可以先重現既有 cases,再提交新世界、新 action、新 probe family 或新 skill。它較適合研究世界模型、建立可審計評測流程,或需要比較物理合理性與狀態持續性的團隊;對只想快速取得單一分數的測試流程而言,完整證據樹會增加運算與整合成本,但換來更清楚的錯誤定位能力。

項目主頁 · GitHub

Categories: 開源, 北京大學, Agentic, 世界模型, 庫, Dataset 數據集, Skill 技能

[技術文章] pixel-space 模型可以追平甚至超過 latent-space 對應模型

研究聚焦 pixel-space text-to-image diffusion models 的訓練卡位,找出點樣喺大規模條件下兼顧畫質同速度。作者用 latent-to-pixel 策略,令 pixel-space 模型更接近甚至超過 latent-space 表現。

Hero image preview

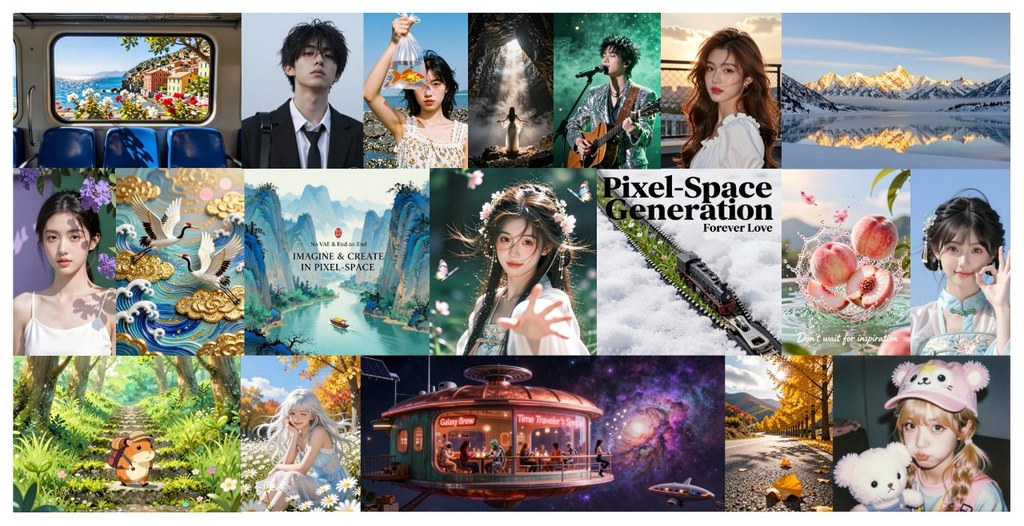
上圖是透過 pixel-space text-to-image diffusion models 的方法訓練的 Z-Image-Turbo (Pixel) 產生的圖像。在企業級 H800 GPU 上,推理延遲僅約 0.2 秒。

Pixel-space text-to-image diffusion models 一直有兩個吸引位:直接生成像素,唔受 VAE 壓縮上限限制,亦可以省去解碼步驟。但喺大規模訓練下,佢哋收斂速度明顯慢過 latent-space 模型,令「畫質、效率、可訓練性」三者之間嘅平衡一直唔夠成熟。

呢篇工作針對嘅正係呢個落差。作者先比較 pixel-space 同 latent-space 喺大規模 pre-training 下嘅行為,再提出 latent-to-pixel 策略:先喺 latent space 學到生成先驗,再轉去 pixel space 做 post-training,避免一開始就喺難度更高嘅像素空間硬推。

佢哋亦系統研究咗多個轉換設計,包括 weight initialization、data composition、prediction target、decoder architecture 同 noise schedule,整理出一套可行做法。結果顯示,做法調整得當之後,pixel-space 模型可以追平甚至超過 latent-space 對應模型,推理端仲有 3.18 到 4.75 倍嘅速度提升。

  • 直接處理 pixel-space diffusion models 喺大規模訓練時收斂慢嘅問題
  • 用 latent-to-pixel 路線,先學先驗,再轉入像素空間微調
  • 檢視多個關鍵訓練選項,搵出實用 recipe
  • 在畫質不退讓之下,換取更快的 end-to-end inference
  • 對想做高效文生圖系統、又在意生成細節保留嘅團隊最有參考價值

Paper

Categories: 香港科技大學, 南京大學, 阿里巴巴, 模型, 模型訓練, Image, txt2img, 香港

ClawGym:為 Claw 類代理搭建可訓練環境

ClawGym 讓本地、帶狀態的工作空間可用來合成資料、訓練代理同評估表現。你可以把它理解成一套面向 Claw-style personal agents 的研究與實驗框架。

Og image

ClawGym 把原本分散的代理開發流程收攏到同一個工作框架內,重點是處理本地、帶狀態工作空間中的任務生成、訓練同評測。對做 agent 研究或想驗證 Claw-style personal agents 的人來講,佢解決嘅唔係單一模型能力,而係點樣有系統咁建立可重複的實驗流程。

它嘅做法唔係只提供一個執行環境,而係同時涵蓋資料合成、agent 訓練同 benchmark 評估。令研究者可以用同一套基礎去跑不同任務,再睇代理喺有狀態工作空間入面表現有幾穩定。

幾個重點值得留意:
– 針對 local、stateful workspace,適合需要保留上下文同操作痕跡的任務
– 同時涵蓋 synthesized data、training 同 evaluation,減少流程分散
– 聚焦 Claw-style personal agents,而唔係泛用式聊天代理
– 已釋出 ClawGym-Bench 同 ClawGym-SynData,方便做對照測試同資料實驗

從公開資訊睇,ClawGym 亦一路延伸到更大範圍的 RL on general agent tasks,甚至可以透過 OpenClaw、Claude Code 呢類較複雜的 black-box agent harness 去做統一訓練。對想比較不同 agent 工作流、或者研究黑箱代理強化學習的人,佢提供咗一個較完整的基座。

項目主頁 · 模型

Categories: 開源, Agentic, MCP, 模型訓練, 軟件, Medical醫學, 安全, OpenClaw, 中國, Dataset 數據集, Skill 技能

MobileMem 把手機長期記憶放入真實場景測試

手機助手要記住一年的生活,難點不只是搜尋資料,更要理解跨應用、跨模態的長期脈絡。

logo

手機助手若要回答「女兒七歲生日有哪些照片」或核對過敏藥物,單靠短對話記憶很快會失準。MobileMem 屬於端側長期記憶(on-device long-term memory)的評測框架與資料集,將一年手機經歷整理成可重現的測試環境,檢驗記憶系統能否跨應用保留、連結及找回重要資訊。

它涵蓋 365 天、12 個應用程式,以及每位使用者平均 1.72M tokens 的資料規模,來源包括對話、日曆、筆記、瀏覽紀錄和相片等異質內容。與只測單輪問答或獨立文件檢索的做法相比,MobileMem 更接近長期使用情境,但同時令資料整理、隱私處理和推理成本變得更複雜。

資料分為兩條 benchmark track:text 供文字記憶系統處理長期對話與結構化 mobile-app events;omni 則加入 screenshots 和 photos,測試多模態記憶。它本身不是模型,而是用來比較不同 memory systems、分析失敗原因及建立 leaderboard 的測試基礎。

  • 支援文字與多模態兩類測試
  • 涵蓋跨應用、長期且知識密集的 mobile agent trajectories
  • 可從 HuggingFace 下載資料集
  • Dataset Explorer branch 提供互動式資料瀏覽
  • 現有資訊未列出具體模型分數,需查看 leaderboard 或自行重跑測試

研究人員可先下載 HuggingFace 資料集,按 text 或 omni 軌道接入自己的記憶模型,再利用網站和 Dataset Explorer 檢查案例。適合開發 mobile agents、personalized assistant、長期 RAG 或 multimodal memory 的團隊;涉及健康紀錄、家庭相片等私人內容時,仍要自行確認資料授權、匿名化和端側部署要求。

項目主頁 · GitHub

Categories: 開源, Agentic, RAG, 多模態模型, Medical醫學, 中國, Dataset 數據集

HumanTracker 想解決人形動作評測失真

影片睇落穩唔穩,未必等於關節誤差低。HumanTracker把人類偏好納入評測,補回人形動作追蹤最常被忽略的一段。

HumanTracker

只看關節角度誤差,往往會把腳滑、落地時機錯、支撐不穩這些觀感上很明顯的問題沖淡。HumanTracker屬於資料集加評測工具類型,核心不是再做一個追蹤模型,而是替 humanoid motion tracking 建立更貼近人眼判斷的 benchmark,讓 teleoperation 與 whole-body imitation 的結果不只「數值過關」,影片也更可信。

它的價值在於同時補兩個缺口:一邊擴大測試覆蓋,另一邊重寫評分方法。項目收錄約 153 小時光學動作資料、來自 24 位專業表演者,整理成四類動作家族,專門拉開日常步態、高動態、互動動作與接地穩定性之間的差異;再用 12K human-labeled preference pairs,訓練出偏好對齊的 HumanScore,去判斷哪條 tracker trajectory 更接近人會接受的效果。

跟 MPJPE 這類逐幀 kinematic 指標相比,HumanScore 重點不在每一幀有幾準,而在整段軌跡有沒有出現長時間滑步、抖動、漂移與失去平衡。官方提供的結果顯示,HumanScore 在測試集對人類偏好的對齊率達 90.83%,比較強的傳統診斷指標高 6.78 分;README 亦保留 Succ、MPJPE 與 HumanScore 幾種分數,代表它不是取代舊指標,而是把「物理上站不站得住」這件事補回評估流程。

  • 約 153 小時新採集 optical motion,涵蓋 25K 級別標註片段
  • HumanScore 來自 trajectory reward model,學的是人對整段動作的偏好
  • 儲存庫提供 evaluation harness、HumanScore reward model 同數據處理工具
  • 適合做人形機械人追蹤、模仿學習、teleoperation 評測的研究團隊使用

這個 GitHub 儲存庫比較像研究評測基建:重點是下載資料集、跑 evaluation harness、再用 HumanScore 與傳統指標一起看結果,而不是即開即用的終端產品。受益最大的會是做人形控制、動作追蹤與模仿策略比較的團隊,因為它能幫你分辨模型究竟只是把姿勢角度擬合得好,還是真的把接觸、穩定與動作連貫度處理好。限制也很明確:它主要提升的是評測可信度,不等於直接改善 tracker 本身能力。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, World-Action Model, Dataset 數據集

OpenART:把 Agent 安全測試搬進可演化環境

OpenART 將工具型 code agent 的安全評估做成可重現的 Docker 工作流,重點不是跑單一任務,而是觀察環境變化如何累積成風險。你可以把它理解成一個用來做 agent red teaming 的開源框架。

Repository image for AI45Lab/OpenART

OpenART 把工具型 code agent 的安全測試,拉到一個更貼近長流程工作的環境裡。它不是單純驗證模型會不會答對,而是看 agent 在共享狀態、連續工具操作與環境演化之下,會不會慢慢走偏,這對做安全研究、紅隊測試或 agent 平台驗證的人都更有參考價值。

整個項目是 Docker-native 的框架,安裝後可先跑本地 smoke task,確認容器、評估器和路徑都正常,再切換到高複雜度任務。README 內也提供 target-only 與 attacker 兩種跑法,方便對比單看目標 agent 與加入 OpenCode-compatible attacker 的差異;任務圖會從 openart-tools 自動選取所需工具,使用方式偏向可控實驗而不是即插即用服務。

它的取捨很清楚:OpenART 把重點放在可重現、可擴展的安全評估,而不是包裝成一個面向終端用戶的產品。項目保留可執行 runtime、少量高複雜度示例與管理過的工具子集,卻刻意不放批次實驗驅動、生成結果和私有場景語料,代表它更像研究與測試底座,適合需要自行編排實驗的人。

論文背景提到,OpenART 提供超過 10,000 個已驗證 stateful scenarios,涵蓋 50 個領域,並支援 75 種 agent-model 配置的統一評估;EMHA(Evolutionary Markov Hypergraph Attack)則是用來推動環境演化的黑箱策略,無需更新參數。文中亦指出,複雜環境下,環境演化比只改指令更容易揭示安全失誤,這正是它相對一般短任務 benchmark 的關鍵差別。

  • 支援先做本地 smoke run,再轉入高複雜度任務驗證
  • 以 Docker 與任務圖管理工具,便於重現與隔離環境
  • 可比較 target-only、attacker 與不同 agent-model 配置
  • 適合做 agent 安全、紅隊測試與平台兼容性檢查
  • 強調長流程與 stateful 環境,較能暴露累積性風險

GitHub

Categories: 開源, 上海人工智慧實驗室, Agentic, 安全, Dataset 數據集

StateFlow 把預視化變成可反覆編修 3D 世界

想像先搭好一個可重用的3D世界,再慢慢改鏡頭、物件同事件。StateFlow想處理的,正是生成式預視化最常見的連貫性問題。

StateFlow teaser

影像預視化最麻煩的地方,往往不是生成一條片,而是改完場景、換完鏡頭之後,前後內容仲要講得通。StateFlow屬於面向 previsualization 的 3D world-state modeling 框架,它把場景視為可持續保存的 3D world states,令同一個世界可以反覆建構、演化、再取用,而唔使每次修改都由頭生成。

呢個做法先處理內容一致性,再處理畫面輸出。StateFlow用 object-centric structured 3D state 去描述世界,每個物件都帶有 geometry、spatial pose 同 semantic attributes,將底層世界內容同最終 render observations 分開,於是場景結構、物件關係、動態事件同 cinematic camera direction 可以分步調整。

整個流程分成三段。State Construction 針對 2D 內容提升到 3D 世界時容易出現的歧義,用 prior-guided、conflict-aware dual-view initialization 建立較一致的起始世界;State Evolution 把使用者修改轉成 structured state transitions,保留 world memory,避免每次編修都重建整個場景;State Access 則配合 render-feedback reflection,把鏡頭意圖修正成視覺上可行的 cinematic trajectories。

  • 把一次性影片生成,改成可編修、可重用的 persistent world
  • 同一套世界狀態可支援 video production 同 3D game prototyping
  • 重點不只是生成畫面,而係保住場景結構、物件關係同時間上的連貫性
  • 鏡頭控制加入 render-feedback reflection,提升拍攝路徑的可行性

使用場景相當清楚:要先做分鏡、試鏡頭、試事件節奏的創作團隊,或者想由 3D scene 快速走到 playable prototype 的遊戲項目,都會較受用。現有內容著重方法展示、應用示例同與 baselines 的 3D scene generation 對比,但未見完整論文與量化細節公開,所以目前較適合視為一個值得留意的工作流方向,而唔係已完全定型的產品規格。

項目主頁

Categories: 北京大學, 視頻模型, Video, World-Action Model, 框架, 3D

MiLMMT-v1.0:小米升級開源翻譯模型:支援至 46 種語言

小米把旗下開源多語翻譯項目 GemmaX 升級至 MiLMMT-v1.0,支援語言一舉擴至 46 種,並透過強化學習與模型合併提升翻譯品質。

gemmax

過去想用開源 LLM 做多語翻譯,往往要遷就 20 多種語言的覆蓋,遇上東歐、非洲或東南亞較少見的語種就容易撞牆。MiLMMT-v1.0 把覆蓋範圍一口氣推至 46 種,這個改變對做跨國內容本地化、跨境電商文案,或是需要處理多語客戶查詢的團隊尤其受用。

這個項目屬於多語翻譯模型(multilingual machine translation model),並非框架或工具,核心目標是讓 Gemma3 等開放權重模型在多語翻譯場景下,貼近商用翻譯引擎的水準。它以 Gemma3-1B 與 Gemma3-4B 為基底,先做持續預訓練,再用翻譯指令微調,最後透過強化學習(GRPO)配合 xCOMET、OpenLID、CometKiwi 等無參考指標作為獎勵訊號。

與傳統依賴大型封閉模型、或需要平行語料的監督式微調不同,MiLMMT 強調 reference-free 後訓練:不需要人工對照譯文也能用 LLM-as-judge 改善翻譯結果。同時配合模型合併(model merging),在 1B 規模的小模型上嘗試兼顧多語泛化與低資源語種的穩定性,這點對硬體資源有限、想自建翻譯服務的工作場景相當關鍵。

重點摘要:

  • 支援語言從 28 種擴展至 46 種,覆蓋更多低資源語種
  • 基於 Gemma3-1B / Gemma3-4B 開放權重,可離線部署
  • 採用 GRPO 強化學習搭配 xCOMET、OpenLID 等無參考獎勵
  • 提供 Hugging Face Spaces 線上 Demo,亦有 RL launcher 與獎勵服務腳本可重現訓練流程
  • 相關論文已上 arXiv,紀錄後訓練與模型合併的實證結果

對本地化團隊、開發者或研究人員而言,這個項目提供了一條毋須依賴商業 API 的多語翻譯路線,1B 等級的模型體積亦令自部署門檻大幅降低。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 中國, 小米-Xiaomi

Page 7 of 20
1 … 5 6 7 8 9 … 20