MoVerse 把單張相變成可遊走 3D 世界

MoVerse 想處理的,不只是補畫面,而是由一張相片生成可移動視角的 3D 場景。它把全景、3D 結構與影片細化拆開處理,方向相當清晰。

MoVerse

MoVerse 是一個偏研究型的方法項目,目標是把一張 narrow-field-of-view image 轉成可導航的 3D 世界,並輸出可互動影片。它想解決的問題,是單張相片通常只得一個視角,但很多生成系統一移動鏡頭就容易穿崩、閃爍,或者空間結構不連貫。

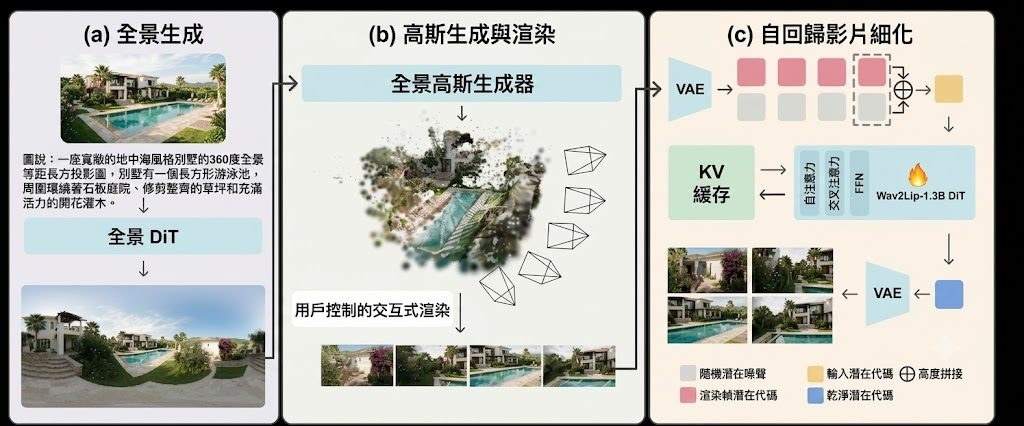
這個項目的核心做法分成三段:先由單張圖生成 360° ERP panorama,再建立 Panoramic 3D Gaussian Scaffold,最後用 Autoregressive Video Refinement 按指定鏡頭路徑補成寫實影片。把「世界建構」同「觀察畫面生成」分開,的確比直接由單張圖硬推整段漫遊影片更有條理,也較容易維持時間連續性。

如果你想了解它表現如何,現階段最合適是先看 Project Page 的示範影片、360 度瀏覽內容與 3D Gaussian scaffold 視覺化。原因很簡單:GitHub 頁面已說明程式碼與 pretrained models 仍在 corporate compliance and security review,中短期內較像一個可追蹤的研究項目,而不是即刻下載就能本地測試的工具。

從公開資料看,MoVerse 有幾個重點值得留意:
– 只需單張 NFOV image 作輸入
– 支援 user-controlled camera trajectories,自由漫遊場景
– 官方稱可在單張 RTX 4090 上做到 8 FPS
– 場景涵蓋室內、室外,以及較風格化畫面如 anime landscapes
– 相關方向可留意 PanoWorld 等世界模型研究

它較適合關注 Computer Vision、3D generation、video world modeling 的研究者與內容技術團隊參考,也適合想評估單圖建場景能力的人。若你要的是即裝即用生產工具,這個項目暫時未到那一步;但如果你在看新一代由 2D 走向可漫遊 3D 的生成路線,MoVerse 的方法、效能數字與分段式架構,都有相當高的參考價值。
GitHub: https://github.com/Orange-3DV-Team/MoVerse

項目: https://orange-3dv-team.github.io/MoVerse/

Categories: 開源, 世界模型

AHA-WAM:讓機械人決策一致的世界動作模型

AHA-WAM 透過分離長程規劃與高頻動作執行,解決機械人策略中節奏錯位的難題,並在模擬與真實環境均創下新高成功率。

PDF

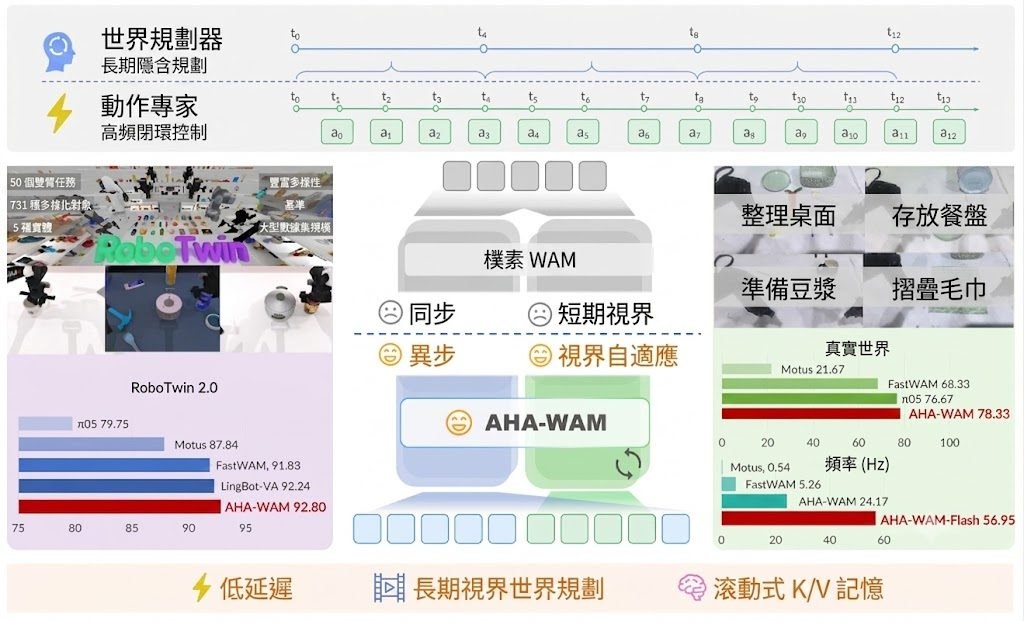
機械人學習操作技能時,往往要把「預測未來畫面」和「即時輸出動作」綁在同一個節奏上,導致規劃與控制互相拉扯。上海交通大學、百度智能雲及上海人工智能實驗室等團隊提出的 AHA-WAM(Asynchronous Horizon-Adaptive World-Action Modeling)項目,就是要把兩者拆開來處理。

核心架構:雙分支異步運作

AHA-WAM 採用兩個 Diffusion Transformer(DiT)分支:低頻的 video DiT 負責長程的視覺世界規劃,並利用滾動式 K/V 記憶體儲存可重用的上下文;高頻的 action DiT 則接收本體感覺訊號,向 video DiT 查詢所需上下文後,即時產生短時閉環動作區塊。兩者各司其職,避免互相拖累。

兩項關鍵訓練與推論機制

  • Horizon-Adaptive Offset Training(水平自適應偏移訓練):讓執行器在規劃器與執行器出現相位差時仍能穩定運作。
  • Observation-Guided Video-Context Routing(觀察引導的視覺上下文路由):根據最新觀察調整快取的規劃上下文,無需重新運行 video DiT 即可對齊當下狀態。

實測表現亮眼

在 RoboTwin 2.0 模擬環境的 50 項雙臂任務中,AHA-WAM 達到 92.80% 平均成功率,且無需任何機械人數據預訓練;在四項原始設定的真實雙手任務中則取得 78.33% 成功率。控制頻率方面,閉環頻率達 24.17Hz;經 ODE 蒸餾的輕量版 AHA-WAM-Flash 更可達 56.95Hz,相比 Fast-WAM 提升約 10.82 倍。

AHA-WAM 適合研究世界模型、機械人操控策略,以及追求高頻閉環控制的開發團隊;其異步架構亦為離線規劃與即時控制分離的設計思路提供新參考。

項目: https://serene-sivy.github.io/aha-wam/

Categories: 開源, 香港大學, 上海人工智慧實驗室, 模型, 視頻模型, 世界模型, 百度

OmniDreams:NVidia 點樣重塑自駕模擬

OmniDreams把單張畫面、文字提示與地圖軌跡結合,實時生成多鏡頭擬真影片。這類 world model,正改變自動駕駛模擬的可擴展性。

Repository image for nv-tlabs/omni-dreams

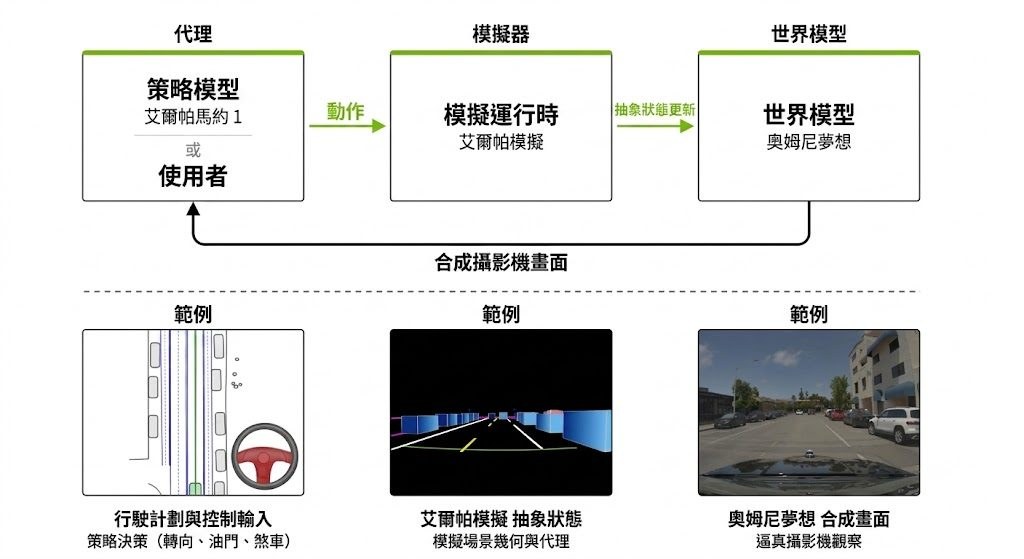
NVIDIA OmniDreams 是一個用於自動駕駛模擬的 world model,重點不在重播已錄好的路面片段,而是在系統提供條件後,持續生成多鏡頭、近乎寫實的影片畫面。它吃進一張真實 RGB 起始影像、文字提示,以及每幀的 coarse HD map image 和 trajectory poses,再以分段方式推進後續畫面。

這個項目想處理的核心問題,是傳統神經模擬器雖然可以很像真,但通常受限於原本拍到的資料,遇到少見天氣、突發交通行為或未見過的場景時,彈性不足。OmniDreams 走的是自回歸生成路線,會根據過往畫面、模擬器狀態與即時駕駛動作,繼續生成下一段感測畫面,較接近 closed-loop simulation 的需要。

從公開資料看,它的創新點在於把 Cosmos diffusion model 的視覺先驗,延伸成可即時反應動作的生成式 world model,並且支援 multi-camera photorealistic video。論文亦提到它曾在 21k 小時駕駛場景上做 mid-training 與 post-training,目標是覆蓋更多傳統模擬器難以刻畫的情境。

使用這個項目時,較適合把它視為研究與後訓練樣本發佈點;互動式推論與 live driving demo 則放在配套項目 FlashDreams。倉庫亦提供 post-training 樣本,圍繞 Cosmos2 SV-HDMap world model 微調,並提到 student-init、bidirectional teacher 與 self-forcing distillation 等訓練路線,但硬件門檻不低,官方列明最低為單個 8-GPU Ampere/Hopper 節點。

  • 可從單張真實畫面開始,生成連續多鏡頭影片
  • 輸入條件清晰,包括文字提示、HD map 與 trajectory poses
  • 重點場景是 closed-loop autonomous vehicle simulation
  • 相關模型與系統包括 Cosmos diffusion model、Cosmos2 SV-HDMap、FlashDreams、Alpamayo 1、AlpaSim、WAM
  • 論文初步結果指出,從 OmniDreams 後訓練出的 WAM 在 Physical AI Autonomous Vehicles NuRec 上表現不俗,且總參數量少於 VLA-based Alpamayo 1.5 的五分之一

整體來看,OmniDreams 不是一般開箱即用的消費級工具,而是面向自動駕駛研究、模擬平台與生成式 world model 開發流程的關鍵項目。對研究團隊、模擬系統工程師,或者想追蹤 NVIDIA 在 Physical AI 與 AV simulation 方向的人來說,這個項目很有參考價值。

GitHub: https://github.com/nv-tlabs/omni-dreams

項目: https://research.nvidia.com/labs/sil/projects/omnidreams-blog/

Categories: 開源, 世界模型, NVIDIA

AdaState 令串流影片生成更自然流動

AdaState 用可演化的隱藏錨點取代首幀依賴,讓長片段生成保留連貫之餘,動態和鏡頭移動更自然。

Motivation figure: attention bias and qualitative comparison of reference strategies

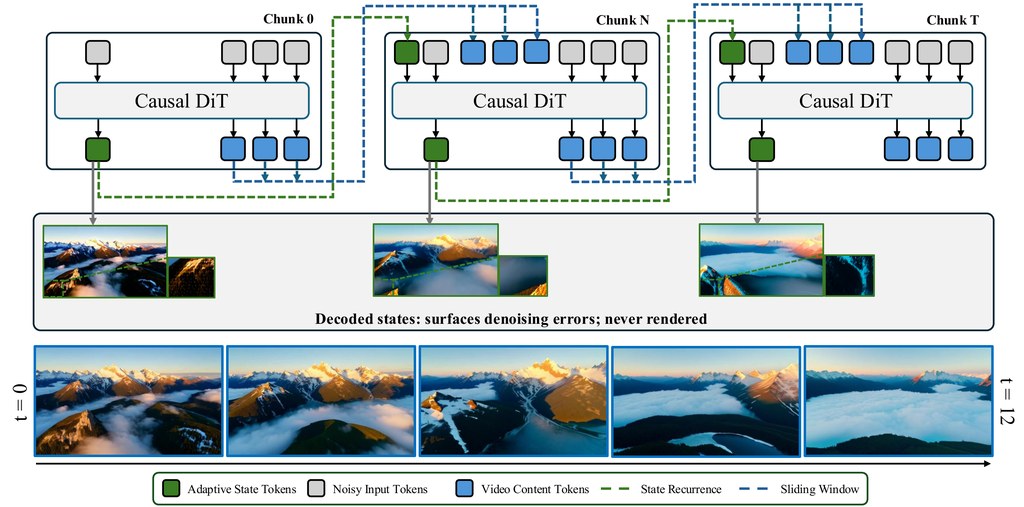
AdaState 是一個用於 Streaming Video Generation 的方法,目的是改善自回歸影片 diffusion 模型過度依賴第一幀的問題。原有做法會把首幀當成固定參考,令後續內容雖然一致,卻容易出現畫面過於靜止、鏡頭難以自然移動、場景變化被壓抑的情況。

項目的核心是用一個會隨內容更新的 adaptive state 取代凍結的 first-frame anchor。這個隱藏狀態會在每個 chunk 與內容一同 denoise,但本身不會直接輸出成畫面,模型改為參考上一個 state 與目前內容,逐步形成會演化的場景錨點。

對一般讀者來說,可以把它理解為:模型不再死跟開頭那一格畫面,而是一路保存一個會成長的「場景記憶」。這樣做有助支援更長的 rollouts,也更容易產生連續 camera motion 和自然的 scene progression,同時不需要額外外接模組。

重點可先留意以下幾點:
– 解決首幀長期主導 attention cache 的限制
– 以 adaptive state 建立可持續更新的隱藏參考
– 採用 relative time 的生成觀念,每一步看到相似的位置結構
– 把 recurrence 引入生成流程,並以 denoising 作為狀態轉移
– 項目頁面表示可提升影片 dynamics、motion 與長時段連貫性

AdaState 的優勢集中在 richer dynamics、longer rollouts 與 coherence 之間的平衡;長片段內容延展、虛擬鏡頭運動的研究。

項目: https://adastate.github.io/

Categories: 開源, 世界模型, 框架

MVCHead:少資源做高擬真 3D 頭像

MVCHead主打只靠2D圖片學出多視角一致的3D Gaussian頭像。對想降低3D人物製作門檻的人,這個項目相當有參考價值。

Teasor

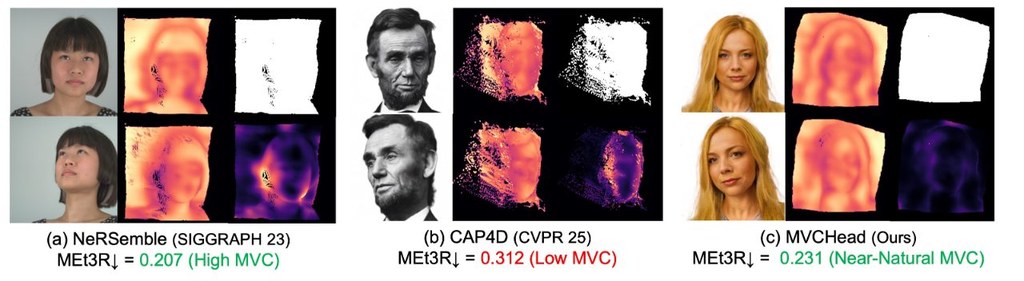
MVCHead 是一個聚焦 3D Gaussian head avatars 生成的研究項目,目標很清晰:不依賴 multi-view 資料、3D 掃描,甚至不需要中間視角生成,也能做出高擬真、multi-view consistent 的頭像。對非技術讀者來說,它想處理的問題就是:以往做這類 3D 人頭資產,通常要大量拍攝設備和昂貴流程,這個項目則希望用較少資源完成。

目前公開內容以論文與項目頁為主,程式碼、weights 及 FaceGS-10K dataset 仍標示為即將推出。現階段較適合先閱讀方法設計、觀察展示圖片與論文結果,了解它是否符合 AR/VR、telepresence、digital humans 或遊戲角色資產製作需求,再決定之後是否跟進測試。

它的核心做法,是用 single-shot state space model 直接在 3D 表徵裡約束 multi-view consistency,而不是先補中間視角。當中包含 Hierarchical State Space(HiSS)block、Hierarchical Bi-directional State Scan(HiBiSS),以及 SE(3) Multi-view Critic;前兩者負責由粗到細調整 3D Gaussians,後者則檢查不同自我渲染畫面是否像來自同一個 3D 結構。

  • 只需 randomly sampled 2D images,毋須 multi-view data 或 3D supervision
  • 生成重點放在 wrinkles、hair wisps、lip contours、eyes、accessories 等細節
  • 論文表示在 perceptual quality 屬 state-of-the-art
  • texture 與 geometric consistency 超越既有方法,shape consistency 則維持可比水平
  • 另提出 FaceGS-10K,作為大規模 3D Gaussian head assets 資料集

這個項目特別適合研究 3D 頭像生成、虛擬人、低資源內容製作流程的人留意。若你期待的是可立即部署的生產工具,現時資訊仍偏研究導向;但若你關心 3D head models 怎樣擺脫多視角拍攝依賴,MVCHead 展示的方向相當具前瞻性。

GitHub: https://github.com/humansensinglab/MVCHead

項目: https://humansensinglab.github.io/MVCHead/

Categories: 開源, 模型, 視覺模型, 世界模型

ViGeo:一個模型處理影片幾何重建

ViGeo把影片或單張畫面的幾何資訊一次估出來。對深度、法線、3D點與鏡頭位姿有興趣的人,這個項目很值得留意。

Repository image for aigc3d/ViGeo

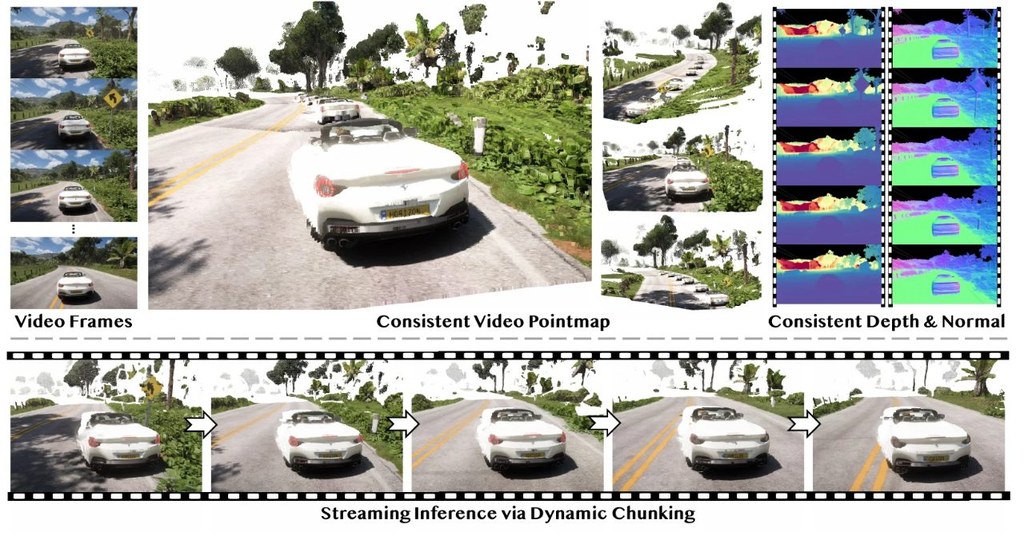
ViGeo 是一個用來估算場景幾何的項目,輸入可以是影片片段,也可以是單張影像。它會輸出 depth、3D points、normals、confidence,處理連續影格時亦可估算 camera poses,重點是盡量保持時間上的一致性,減少前後幀結果跳動。

使用這個項目時,先按手頭資料選擇模式:完整影片可用 offline,串流畫面可用 online,長影片則可分段用 chunk 處理。這種安排對做影片重建、機械人感知、AR、導航或後期視覺分析的人較實用,因為不需要為不同輸入形式換另一套模型。

它想解決的核心問題,是影片幾何估計常見的兩難:不是短片效果好但難以串流,就是能即時推理但長時間一致性不足。ViGeo 以同一個 feed-forward foundation model 統一 full-sequence reconstruction、streaming inference 與 long-video inference,論文指出關鍵在 dynamic chunking attention,讓模型可因應測試情境切換時間關注方式,而不用重新訓練。

另一個重要部分是 VideoLDCM,完整名稱是 VideoLDCM,負責 depth completion。它在這項工作中用作 data-refinement model,把稀疏或帶雜訊的深度觀測整理成較乾淨的 dense depth supervision,對訓練幾何模型有幫助,也解釋了為何這個項目不只看單幀品質,還強調跨影格穩定性。

  • 同時支援 offline、online、chunk 三種推理流程
  • 可由影片或單張影像估算 depth、3D points、normals 等結果
  • 以 dynamic chunking attention 兼顧串流與長影片處理
  • 結合 VideoLDCM 改善深度監督資料品質
  • 論文聲稱在多項 video geometry 任務達到 state-of-the-art
ModelDownloadDescription
ViGeoLINK用於深度、點、法線、姿態和置信度的主要視覺幾何模型
VideoLDCMLINK用於稀疏深度濾波、泊松補全和深度細化的資料細化模型

性能方面,論文描述它在 online、offline、long-video depth estimation、surface normal estimation、video point map estimation 都有很強表現,並以 public datasets 訓練。不過目前公開 checkpoint 亦已註明存在已知 loss implementation 問題,可能在 camera poses 視覺化與遠距區域出現輕微瑕疵,因此較適合先用來理解能力範圍,再決定是否放入要求很高的生產流程。

GitHub: https://github.com/aigc3d/ViGeo

項目: https://pkqbajng.github.io/ViGeo/

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 世界模型

URM 自動駕駛點樣看見被遮擋風險

用統一風險地圖處理視線死角,幫自動駕駛在看不清環境時作出較穩妥判斷。

Hero image preview

這項研究由中國復旦大學提出,聚焦自動駕駛在部分可觀察環境中的難題:前方或路口被遮擋時,系統看不到潛在車輛或行人,但仍要提早規劃安全路線。現有方法通常走兩個方向,一類根據可到達狀態估算風險,往往過於保守;另一類用學習方法預測隱藏目標軌跡,但在高遮擋不確定性下未必夠準。

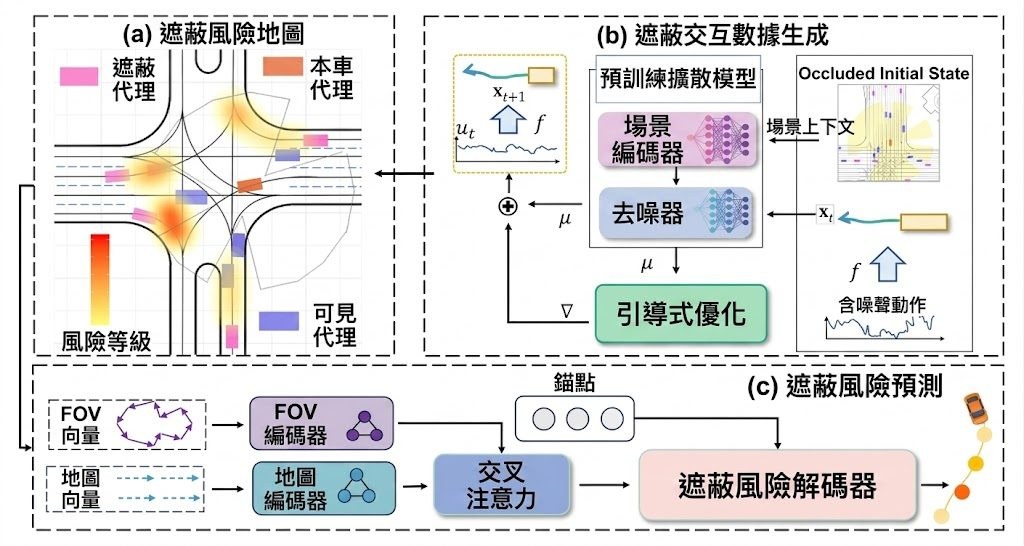
項目首先提出一個 URM (Unified Risk Map),把交通流風險與碰撞風險放入同一個時空框架建模。前者從 multimodal trajectory distributions 估算密度,後者則透過模擬 ego vehicle 軌跡,找出不同時間與位置的高風險區域,令系統不只知道「可能有東西」,亦知道「哪裏更危險」。

為了補足遮擋互動場景不足的問題,研究同時加入 diffusion-based scenario generation framework,生成既真實又帶挑戰性的情境,用來訓練 unified risk map。整體框架把風險建模、學習與規劃串連起來,目標是在 partial observability 下支援 risk-aware planning。

重點可概括為:
– 把 traffic flow risk 與 collision risk 合併成單一風險表示
– 針對 occlusion-aware prediction 的盲點,提供更細緻的時空風險判斷
– 用 diffusion-based scenario generation framework 製造稀缺的遮擋互動情境
– 在 Waymo Open Motion Dataset 上,較現有 occlusion-aware baseline 有明顯提升

這個方法在 Waymo Open Motion Dataset 上,把 minimum time-to-collision 改善 0.78 倍,average time-to-collision 改善 1.67 倍,顯示系統能更早避開高風險情況。這個項目較適合關注 autonomous driving、Planning under Uncertainty、Integrated Planning and Learning 的研究者與工程團隊;如果你想了解自動駕駛如何處理視線死角,這套方法提供了相當具體的方向。

Paper: https://arxiv.org/pdf/2605.22189

Categories: 開源, 視覺模型, 世界模型, 框架

YoCausal 用影片倒播測試模型因果感

YoCausal唔係教你生成影片,而係檢查模型有冇真正理解先後因果。它用真實影片倒播做基準,設計相當清晰。

YoCausal Logo

YoCausal 是一個用來評測 Video Diffusion Models(VDMs)嘅項目,核心問題好直接:模型見到一段影片時,究竟係理解事件因果,定只係記住畫面常見嘅時間模式。呢個項目用正播同倒播影片比較 denoising loss,若模型對正向影片分數更合理,代表它較能分辨自然因果關係。

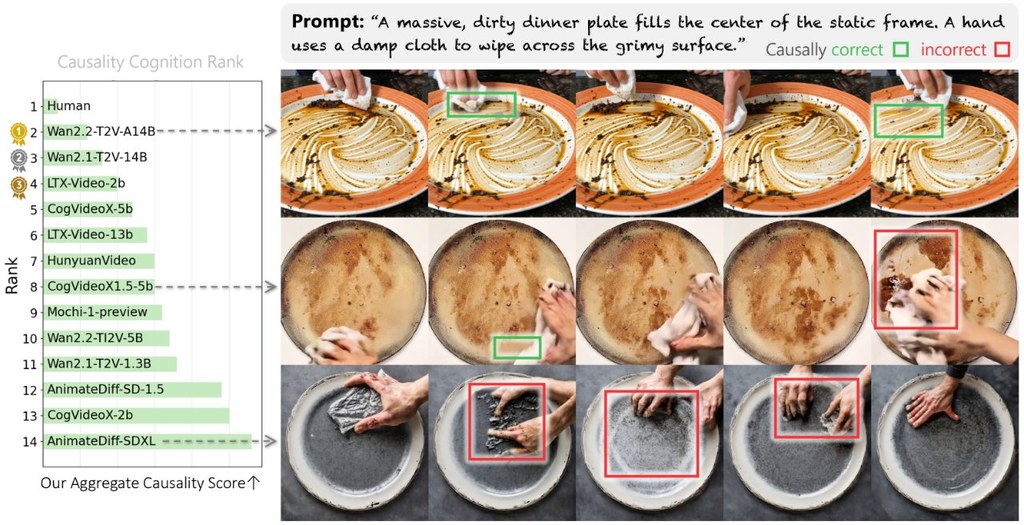
它提出兩個關鍵指標:Reverse Surprise Index(RSI)同 Causality Cognition Index(CCI)。RSI 主要睇模型有幾多次偏好正向時間流;CCI 再進一步將「知道時間方向」同「真正理解因果」分開,避免只靠時間線索就被誤判為懂因果。

使用呢個項目時,重點唔係訓練新模型,而係替現有模型寫 evaluator,然後用指定資料集跑評測。項目亦提供 leaderboard 提交格式,會要求模型名稱、版本或 checkpoint、模型大小,以及 evaluation result JSON 檔案;若改動過預設設定或 preprocessing protocol,也要一併說明。

YoCausal: How Far is Video Generation from World Model? A Causality Perspective
  • 用真實世界影片倒播做 counterfactual,比純合成資料更貼近常見場景
  • 以 denoising loss 比較正播與倒播,測法清楚而且可擴充
  • RSI 測時間方向感知,CCI 嘗試拆出更接近因果理解嘅部分
  • 已評測 13 個 state-of-the-art VDMs,結果顯示時間感知不等於因果理解
  • 文件提到 Wan Model Evaluation(DiffSynth-Studio),亦支援排行榜提交流程

由論文內容看,YoCausal 最大價值係指出一個常被忽略嘅落差:影片生成愈靚,唔代表愈接近 world model。評測結果顯示,即使係表現較前嘅模型,例如 Wan2.2-A14B,與 human baseline 之間似乎仍有明顯差距;中後段模型如 CogVideoX1.5-5B、AnimateDiff-SDXL 則較易出現違反因果嘅畫面變化。

呢個項目適合研究 Video Diffusion Models(VDMs)、world model、影片理解與生成評測嘅人,也適合想比較不同模型因果能力嘅團隊。對一般開發者而言,它最有用之處係提供一套較有解釋力嘅檢查方法,幫你知道模型失分係因為唔懂因果,定只係對時間方向反應不足。

GitHub: https://github.com/youzhe0305/YoCausal

項目: https://www.youzhexie.me/papers/YoCausal/index.html

Categories: 開源, 視覺模型, 世界模型, 框架, 3D

contrastive-probing:拆解 VLM 空間判斷偏差的輕量診斷項目

這個項目不是再做一次答題測試,而是直接觀察 VLM 內部怎樣表示左右、高低與遠近。對想研究模型偏差的人很有參考價值。

Repository image for cheolhong0916/contrastive-probing

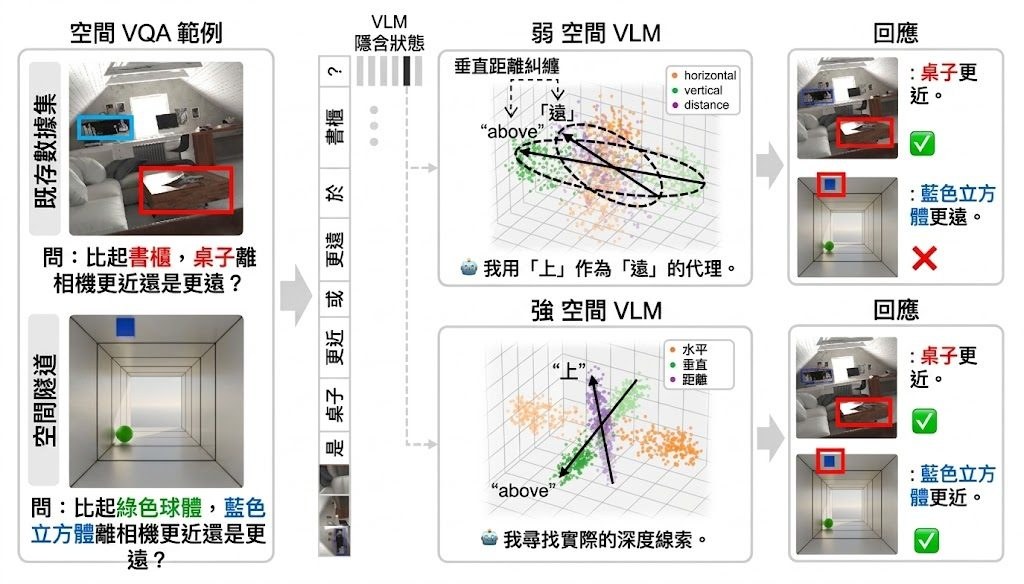
contrastive-probing 是一個用來檢查 Vision-Language Models(VLMs)內部空間表示的輕量項目,焦點不是模型答對幾多題,而是它腦內如何分開 left / right、above / below、far / close。它沿用論文《Why Far Looks Up: Probing Spatial Representation in Vision-Language Models》的 contrastive probing 方法,透過交換問題中的兩個物件,再比較 hidden states 差異,抽出 Δ vectors 作分析。

使用時,做法是把一張圖片配上一條原始空間問題,再生成一條交換 obj1 ↔ obj2 的對照問題,之後對同一個 VLM 跑兩次 forward,並在每層 transformer 擷取最後 token 的表示。這個流程可配合 🤗 transformers 載入的模型,然後輸出 Axis Coherence、6×6 Δ-similarity heatmap、2D/3D PCA 視覺化,以及 Vertical–Distance Entanglement Index(VD-EI)等結果。

這個項目解決的核心問題,是 benchmark accuracy 往往只告訴你模型有冇答中,卻未必揭示它是否用對了空間線索。論文與附帶說明指出,多個模型家族都出現 vertical-distance entanglement,也就是把畫面較高的位置誤當成較遠,反映自然照片常見的 perspective heuristic「higher in the image ⇒ farther away」。

  • 用最少對照設計觀察表示層,而不只看答題分數
  • 可比較不同 layer 的空間軸是否清晰分離
  • 能發現 vertical 與 distance 是否糾纏,幫助找出偏差來源
  • 適合分析 EmbSpatial-Bench、SpatialTunnel 這類空間推理資料

對研究者、模型分析人員,或者要檢查 multimodal assistant、robotics、embodied agents 背後空間推理可靠性的人,這個項目尤其有用。現有資料顯示,就算 benchmark 分數相近,不同 VLM 的內部表示也可能差很遠,而空間軸分得較清楚的模型,通常在不同測試上的穩健性會較好。

整體來看,這不是訓練新模型的項目,而是一套偏向診斷與解釋的工具。它的創新點在於用 minimal contrastive pairs 加上 representation-level analysis,把「模型為何會答對或答錯」拆成更具體的內部結構問題,對想深入理解 VLM 空間能力的人,價值比單看排行榜更高。

GitHub: https://github.com/cheolhong0916/contrastive-probing

項目: https://cheolhong0916.github.io/whyfarlooksup.github.io/

Categories: 開源, 視覺模型, 世界模型, 模型訓練, NVIDIA, 框架, 3D

minWM:由影片生成走向 World Model

minWM不是單一模型,而是一套由資料到推理的 World Model 框架。它特別照顧初學者,也兼顧研究與改造彈性。

Repository image for shengshu-ai/minWM

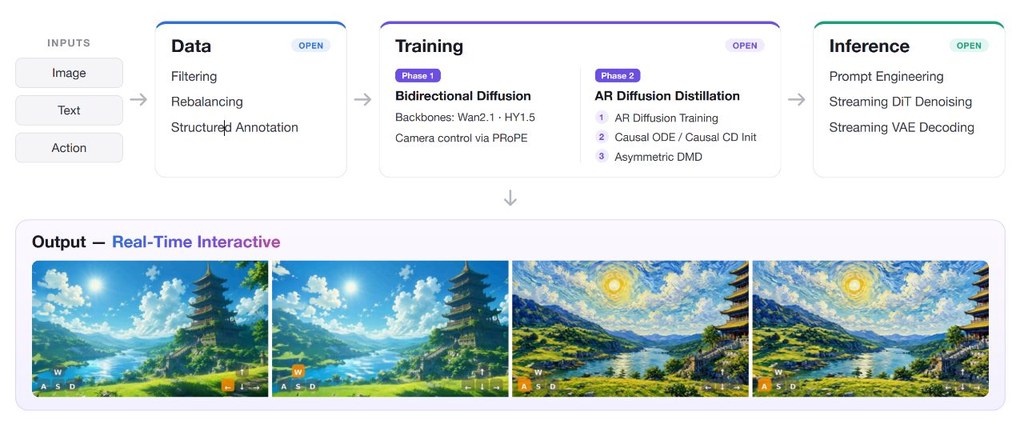
minWM 的定位很清楚:它不是再提供一個新模型,而是把建立 video world model 的整條流程拆開,讓人由 bidirectional T2V(Text-to-Video)或 TI2V(Text-and-Image-to-Video)基礎模型,一步步轉成 action-conditioned video world model。對剛接觸這個領域的人來說,這種完整路線比只放權重或單段程式碼更有幫助。

這項目重點不是「裝完即用」,而是按它提供的資料處理、訓練、蒸餾與推理流程逐段走。項目公開了 data → training → inference 的全流程,並提供 example data、runnable scripts、Claude Skills 與新手知識整理,方便你先跟一次標準流程,再按自己需要改 backbone、資料分佈或控制方式。

它要解決的問題,在於高質影片生成模型未必等同可互動的 world model。要做到低延遲、可因果 rollout、可回應鏡頭軌跡等操作,背後需要 camera control、autoregressive training、few-step distillation 及 streaming inference 等整套機制;minWM 正是把這些環節模組化,並用 Causal Forcing、Causal Forcing++、Teacher Forcing 與 asymmetric DMD 串連起來。

  • 支援 4-step DMD inference,並提到 multi-GPU sequence parallelism
  • 可用 pose strings 或 JSON 檔控制 camera trajectory
  • 提供 debug-world-model,整理 loss NaN、jitter、camera drift 等常見失敗模式
  • 提供 integrate-new-backbone,示範怎樣接入新的 video DiT
  • 參考 backbone 包括 Wan2.1-T2V-1.3B、HY1.5-TI2V-8B,亦提到 HY Action2V、HY TI2V、Wan Action2V

項目的新意在於它同時處理「怎樣訓練」與「怎樣改造」。除了支援不同 backbone 與 condition injection 方式,也把團隊累積的排錯經驗與 Claude 協作流程寫進項目,令研究者或工程人員不只看到結果,還能理解常見錯誤從哪裡出現。

它的目標是 real-time interactive video world models,並附有對 camera trajectory quality、controllability training steps、minimal batch-size requirements 的實驗分析。不過公開資訊較偏向框架與流程,若你想比較單一模型跑分,這個項目更適合當作建立、重現及擴展 World Model 的工作底座。

GitHub: https://github.com/shengshu-ai/minWM

Categories: 開源, 香港科技大學, Agentic, 模型, 視覺模型, 視頻模型, 世界模型, 模型訓練, 影像模型, 影像處理, 框架

Page 7 of 9
1 5 6 7 8 9