Embodied Agent Arena:測試十款 VLM 的任務能力

十款前沿視覺語言模型接受 1,000 個具身任務測試,結果顯示,能生成可執行動作,不代表能完成多步操作或精細接觸任務。

logo transparent

要判斷視覺語言模型(Vision-Language Models,VLMs)能否勝任機械人通用操作,不能只看它有沒有成功發出動作。Embodied Agent Arena 是一個具身代理評測項目,以共同測試流程比較十款模型在五類能力上的表現,涵蓋 1,000 個案例,並把幾何理解、空間推理和視覺定位納入評測。

項目把任務理解、推理和動作選擇交由模型處理,再以同一套精簡評測框架測試不同模型。測試資料整合 32 個既有來源,另加入 168 個案例的 GeoProbe 幾何基準;相比只看機械人互動任務,這種安排能同時檢視模型理解空間資訊的能力,以及能力能否轉化為實際任務成果。

結果反映,單一指標容易掩蓋任務是否真正完成。Gemini 4 Argon 的 3D 路徑誤差最低,為 0.310 米,但 56 條路徑中只有 24 條符合全部限制;Manipulation 成功率最高的 Opus 5.5 亦只有 47.8%。CALVIN 測試中,100 個序列有 60 個完成第一個目標,完成全部五個目標的只有 9 個;在五項 ManiSkill 診斷任務中,Opus 5.5 能完成拾取、放置和堆疊,卻未能完成插入插銷或充電器。

  • 同一批 157 項 Planning 任務中,至少有一款模型完成 142 項;仍有 15 項十款模型全部失敗。
  • Astra 的 31 項失敗任務耗用 55.5% token;失敗任務平均耗用的 token 是成功任務的 5.1 倍。
  • CALVIN 有 65 個序列曾遇到執行錯誤;其中 62 個後來能無錯執行程式碼,但只有 3 個最終完成序列。
  • Case Atlas 收錄 181 個涵蓋五類能力的案例,提供十款模型的紀錄;缺少影片的項目會使用共用任務場景,API 中斷則標記為失敗嘗試。

這些結果適合用來比較模型在哪些環節失手,亦提醒研究團隊不要把路徑精度、程式碼執行成功或單一步驟操作,直接當成完整任務能力。項目提供線上結果、案例影片、資料集及程式碼。
項目主頁 · GitHub · 數據集

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, AI productions, 世界模型, Qwen, DeepSeek, Gemini, API, VLA, Robotic, 框架, 香港, Anthropic, Dataset 數據集

Wizard:讓 AI 即時改動遊戲世界與戰鬥規則

Wizard 讓玩家用指令改變場景、角色和戰鬥狀態,再即時生成連貫影片。它適合探索互動遊戲原型與可控世界模型的創作方式。

favicon

改變地形、召喚敵人,甚至令角色變身,Wizard 都能把這些操作整合到即時遊戲畫面中。這個世界模型項目以代理控制修改遊戲狀態,再由影片生成模型呈現變化,目標是讓互動不只限於移動角色,也能改動環境與戰鬥規則。

使用者可透過按鍵、文字指令或單張畫面控制世界。場景幾何、角色骨架、動作和戰鬥狀態會分開記錄,因此系統可以處理平台升降、地面變形、角色攻擊與受傷等變化;影片生成器則以每秒 24 幀輸出畫面。項目亦稱,展示中的場景和角色都是模型未曾見過的內容。

整個流程分成快速建置和遊戲期間的控制。建置階段會重建場景與角色、配置骨架並整理動作;遊戲期間,代理更新幾何、動作和戰鬥狀態,再交由 Wan2.2-TI2V-5B 生成影片。文字指令會轉成幾何操作程式,戰鬥則由狀態追蹤、攻擊規劃和規則控制器處理。

• 適合想測試可互動遊戲場景、角色動作及戰鬥變化的研究者與創作者。
• 可用文字指令、按鍵或畫面輸入控制世界,也能比較生成影片與場景代理畫面。
• 每秒 24 幀生成,並以兩步去噪處理;項目描述的建置階段少於五分鐘。
• 程式碼尚未公開,現有資料亦未提供下載或使用流程。

Wizard 把可明確追蹤的遊戲狀態與即時影片生成結合,適合探索「能否直接操控世界規則」這類互動設計。它的應用仍受限於目前展示和程式碼尚未開放的狀態,外部使用者暫時難以自行驗證或整合。

項目主頁

Categories: 騰訊, Agentic, AI productions, 模型, 視頻模型, 世界模型, Qwen, Video, Image, 框架, Content Creator, 動畫

L3G-World 可以連續生成長達數分鐘影片

L3G-World 把單張影像、文字提示和鏡頭路徑接成可持續探索的 3D 世界,重點在長片段一致性與生成速度。

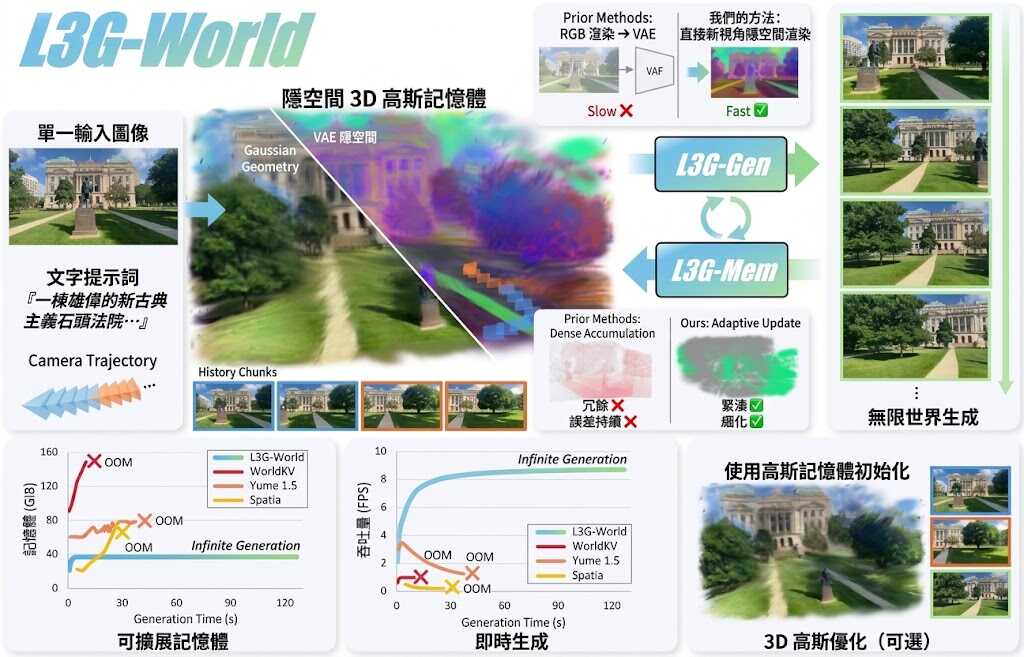
L3G-World overview: input images, text and cameras initialize latent 3D Gaussian memory; L3G-Mem updates the memory whil

由單張影像、文字提示和鏡頭路徑開始,L3G-World 可以連續生成長達數分鐘、視角一致的影片。它屬於世界模型及視頻生成模型項目,針對長時間生成容易失去場景結構、記憶不斷膨脹的問題,加入可持續更新的 3D 記憶。

L3G-Mem 會在新探索區域建立 Gaussian,重訪舊區域時則修正原有幾何資料;L3G-Gen 再利用更新後的記憶,自回歸生成下一段影片。每個 Gaussian 儲存 VAE latent,直接渲染到 diffusion 的 latent space,省去先渲染 RGB、再重新編碼的步驟,配合 few-step video model,目標是支援即時生成。

  • 長時一致性:影片片段會共享持續更新的 3D memory。
  • 記憶增長受控:記憶量跟隨探索範圍,而不是單純跟隨影片幀數增加。
  • 多視角探索:支援單張影像或少量多視角輸入,沿不同 camera trajectory 延伸場景。
  • 速度取捨:直接 latent rendering 減少重建成本,但項目仍屬研究原型。

對需要從影像建立可探索場景的研究團隊、世界模型開發者、機械人和虛擬環境項目較有參考價值。相比每段影片獨立生成的做法,它把場景記憶放入閉環流程;代價是需要同時處理 3D Gaussian 記憶、latent rendering 和擴散模型,工程整合較複雜。

項目首頁展示了 minute-long generation、不同鏡頭路徑和多視角場景延伸,但未提供明確的 FPS、GPU 型號或 VRAM 要求。儲存庫列出的 L3G-Mem、L3G-Gen、推理程式及 Fast checkpoints 仍在發布計劃中,因此目前只能按公開展示理解能力,未能據此確認安裝流程、所需硬件或可直接部署程度。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Video, Image, World-Action Model, 3D, 庫

Google Genie 4:即時探索與互動世界模型

Genie 4 可按文字或圖像提示生成可探索的 3D 世界,讓研究人員測試 AI 如何在變化中的環境裡理解場景和採取行動。

Hero image preview

輸入一段描述或一張圖像,AI 便能生成可探索的 3D 世界,並隨玩家的操作即時改變場景。Google DeepMind 推出的 Genie 4 是一個世界模型研究項目,目標是建立能模擬環境、回應互動場景,為訓練和研究具身 AI 提供測試空間。

Genie 4: A new generation of world simulation

這類場景並非預先錄製的影片:玩家可以移動和探索,模型則持續生成後續畫面。研究人員可藉此觀察 AI 能否掌握環境的空間關係,並在多種情境中持續採取合適行動;不過,生成結果能否長時間保持一致,仍是世界模型需要面對的挑戰。

Genie 4 延續 Google DeepMind 的 Genie 系列研究。官方介紹聚焦於模型生成互動世界的能力,但未提供足以比較不同模型的完整量化評測,因此不宜單憑展示內容推斷它已能穩定支援所有模擬或訓練工作。

  • 可由文字或圖像提示生成可探索的 3D 世界。
  • 場景會隨玩家輸入即時變化,而非只播放固定影片。
  • 可用於研究 AI 的場景理解與行動能力。
  • 長時間維持世界一致性的能力及量化表現,仍需更多資料評估。

對具身 AI、遊戲環境生成和世界模型研究者而言,Genie 4 提供一種建立互動測試場景的方向;一般使用者則可透過生成世界,直觀感受模型如何把提示轉化為可操作的環境。

項目主頁

Categories: AI productions, 模型, 世界模型, 模型訓練, Google, Video, Image, 3D

World-in-Context 讓世界模型即時切換視角

操控生成影片時,切換第一人稱、第三人稱與自由鏡頭,畫面仍要延續同一個世界。World-in-Context 以共享控制機制處理這項挑戰。

Alibaba Token Hub

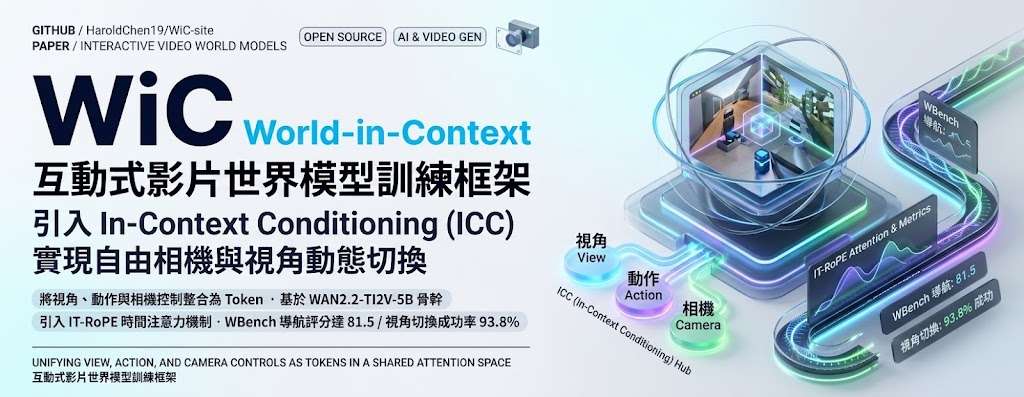
想在生成影片中移動鏡頭、改變觀看角度,甚至在第一人稱與第三人稱之間切換,畫面仍須保持連貫。World-in-Context(WiC)是為互動影片世界模型而設的訓練框架,目標是讓視角、動作和鏡頭控制在同一段影片中協同運作,而不是各自處理。

WiC 以 Wan2.2-TI2V-5B 作為基礎模型,透過 In-Context Conditioning(ICC)把視角、動作與鏡頭控制轉成共享注意力空間中的 tokens;Interaction-Transport RoPE(IT-RoPE)則把累積的控制變化納入時間注意力。這讓系統可支援自由鏡頭、第一人稱及第三人稱視角,也能在影片進行中切換,適合研究互動式場景生成、遊戲環境及長時間因果推演。

在 WBench 評測中,WiC 的導航平均分為 81.5,視角切換成功率為 93.8%。這些結果反映它能處理導航與鏡頭切換,但不能單憑分數判斷生成影片在所有場景都同樣穩定;GPU 記憶體需求亦會隨影片尺寸和設定改變。

目前程式碼、訓練程式及 WiC 權重仍在審核,尚未公開,因此現階段無法自行安裝並重現推理結果。計劃中的版本要求 Linux、Python 3.10,以及支援 BF16 的 NVIDIA GPU;預設生成設定為 832×480、81 幀、16 FPS 和 50 個採樣步驟,並預計提供 11 個包含起始圖片、提示詞與控制資料的範例。

  • 以 Wan2.2-TI2V-5B 為基礎,加入 WiC adapter。
  • 同一影片支援自由鏡頭、第一人稱與第三人稱視角。
  • WBench 導航平均分 81.5,視角切換成功率 93.8%。
  • 程式碼與權重尚未公開,現時未能重現結果。

對研究影片生成、虛擬環境導航或互動遊戲場景的團隊而言,WiC 提供一條把鏡頭與動作控制合併訓練的路線;但在公開程式碼和權重推出前,這些能力仍主要停留在研究成果與展示範例,還不能直接納入工作流程測試。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, AI productions, 模型, 世界模型, 模型訓練, NVIDIA, Video, Image, 提示詞, 框架, 3D, Linux, Python

RoboJudge:把影片的物理合理性與指令分開評測

RoboJudge 分開檢視具身影片的物理合理性與指令完成度,並以人類評分訓練模型,供團隊比較生成結果。

RoboJudge overview

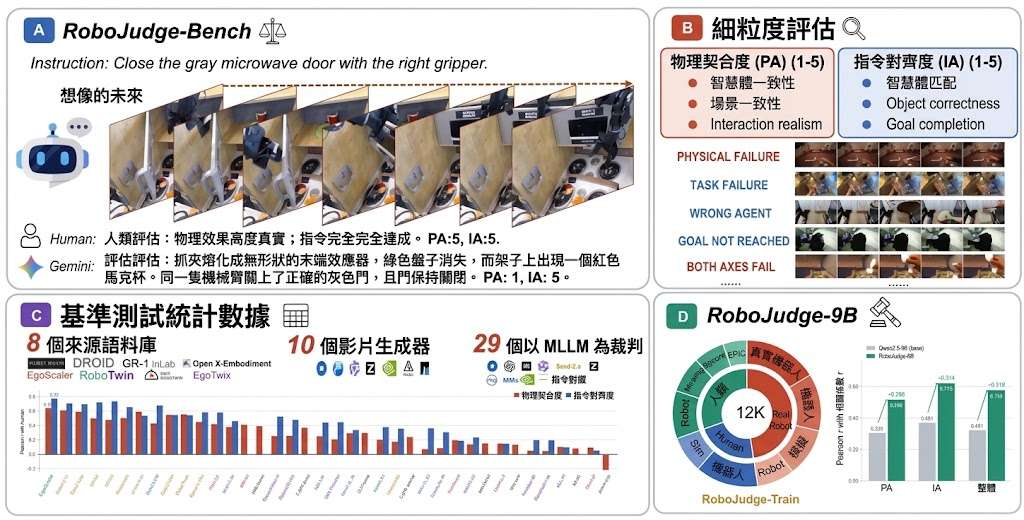
具身影片可能動作自然卻未完成指令,也可能完成任務但違反物理規律。RoboJudge 以 Multimodal Language Models (MLLMs) 評審生成影片,分開衡量 Physical Adherence (PA,物理遵循) 與 Instruction Alignment (IA,指令符合度)。

這有助機械人及具身世界模型團隊分辨動作可信度和任務完成度。RoboJudge-Bench 收錄 800 段人工標註影片,涵蓋 8 個語料來源、10 個影片生成器,以及夾爪、人手與靈巧手。

RoboJudge-Train 收錄 12,000 段影片及 25,000 筆人工評分與理由;RoboJudge-9B 經監督學習及強化學習訓練。Pearson 相關係數在 PA 為 0.645、IA 為 0.775、整體為 0.719,較測試中的最佳專有基線高 0.089;相關性不代表每次判斷都正確。

GitHub 提供推理和基準評估程式,並連結模型與資料集。README 列出依賴安裝及執行流程,但沒有硬件需求資料,採用前宜先確認設備能否負擔模型載入與影片處理。

  • PA 檢視影片是否符合物理與時間約束。
  • IA 檢視影片動作是否符合指令。
  • 基準可用於比較評分,不能取代人工核對。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Video, 香港, Dataset 數據集, 強化學習

從影片理解世界:統一 Video World Models 的四種能力

一份涵蓋 669 篇參考文獻的調查,整理影片模型如何讀取、生成、共享及互動於不斷變化的世界。

Og image

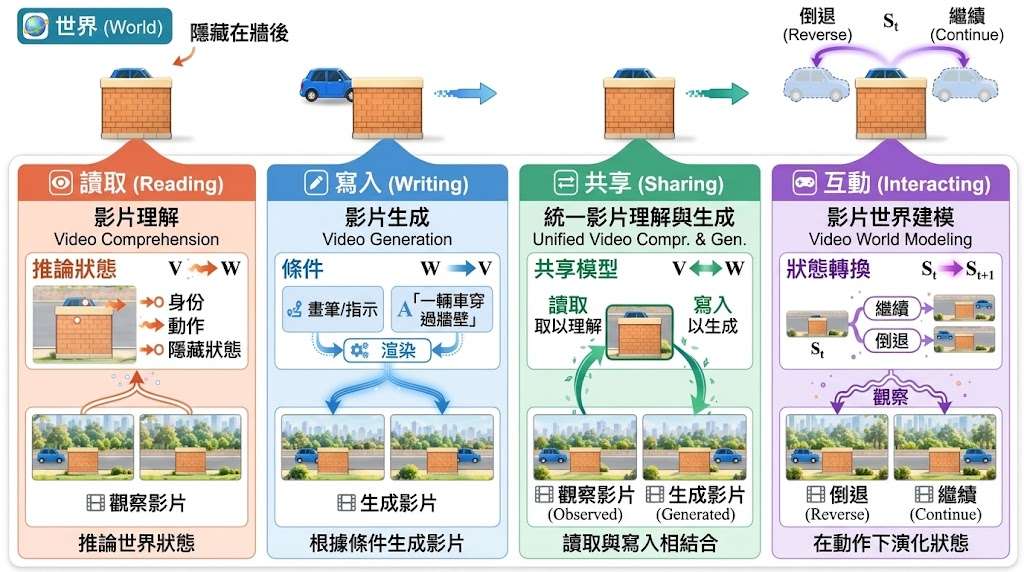
當模型要由片段影片理解場景、推演未來,甚至回應外部行動時,單純辨認畫面中的物件並不足夠。這份影片世界模型調查以影片與世界狀態的關係為主線,整理 Video Foundation Models 如何處理觀察不完整、時間變化和因果推理等問題。

調查將能力分成四個互相關聯的操作:Reading 從影片讀取語意、空間、時間、物理及因果資訊;Writing 生成可能發生的未來;Sharing 建立可供不同任務共用的表示;Interacting 則把感知結果連接到行動、控制和環境回應。內容涵蓋影片表示學習、Video-LLMs、影片生成、影片代理及世界預測等方向。

影片只是世界的部分記錄,而且可能遺失被遮擋的物件、視角以外的資訊或事件之間的因果關係。調查因此區分 temporal coherence 與 world consistency:畫面可以連續流暢,但物件再次出現時未必保持同一身份;鏡頭突然切換,也不一定代表世界狀態中斷。

• 以世界狀態統一影片理解與生成
• 覆蓋 2017 至 2026 年的研究發展時間線
• 比較 contrastive、masked、predictive 及 generative learning
• 關注長片段、串流觀察與影片代理的證據累積
• 收錄 669 篇參考文獻及多個尚待解決的研究問題

這份材料適合研究影片模型、World Models、多模態模型和 Computer-use agents 的讀者,也可作為設計影片理解、未來預測、模擬環境或機械人互動工作流時的索引。它屬於調查項目,並非可直接下載或安裝的單一模型;原始資料亦沒有提供具體使用流程。

項目主頁

Categories: Agentic, AI productions, 模型, 多模態模型, 世界模型, Video, Discord, 動畫

LaLa-World 用自然語言連接機械人規劃

以文字描述動作,模型便可從模擬、機械人、圖片和影片學習並預測未來畫面,讓規劃不必為每個任務各自訓練世界模型。

NAVER AI Lab

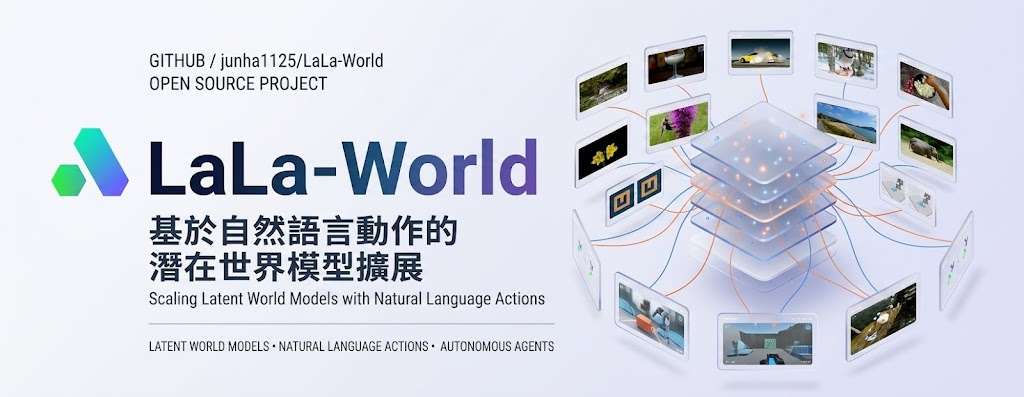
只用文字描述動作,就能讓同一個世界模型從模擬、機械人、圖片和影片學習,並預測行動後的視覺變化。LaLa-World 是語言條件式潛在世界模型,目標是減少不同領域各自訓練模型的需要,支援跨場景規劃;它亦可微調成 LaLa-Policy,同時預測機械人動作和未來表徵。

關鍵做法是把自然語言當成共通的動作介面,再於潛在空間預測未來視覺表徵,而不是直接生成完整影片。研究結果指,加入圖片和影片資料可改善規劃能力,亦令模型較能適應不同動作措辭;這讓研究團隊可以把多種來源的資料納入同一套規劃流程。

  • 在平均 MPC 規劃 LaLa-World 優於按領域或任務分開訓練的潛在世界模型。
  • 與採用相同條件的 RAEv2 影片生成模型相比,規劃表現相若,訓練成本低 6 倍,規劃速度快 13.9 倍。
  • LaLa-Policy 在 LIBERO 和 RoboCasa 的結果可與 Cosmos Policy 比較,推理速度最高快 5.5 倍。
  • 跨模態資料可提升規劃表現及對動作措辭的穩健性,對需要跨模擬與真實機械人資料研究的團隊較有吸引力。

這些結果令項目適合用作機械人規劃與政策學習研究,尤其是希望整合影片資料、減少逐個任務訓練成本的團隊。不過,GitHub 儲存庫目前仍在補齊內容:環境設定和資料準備程式已提供,LaLa-World 訓練及規劃評估程式、預訓練檢查點和解碼器則尚未公開,因此現階段未能按完整流程重現結果。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, 模型訓練, Video, Image, 庫

SolarRenderer:Minimax H3 四步完成影片

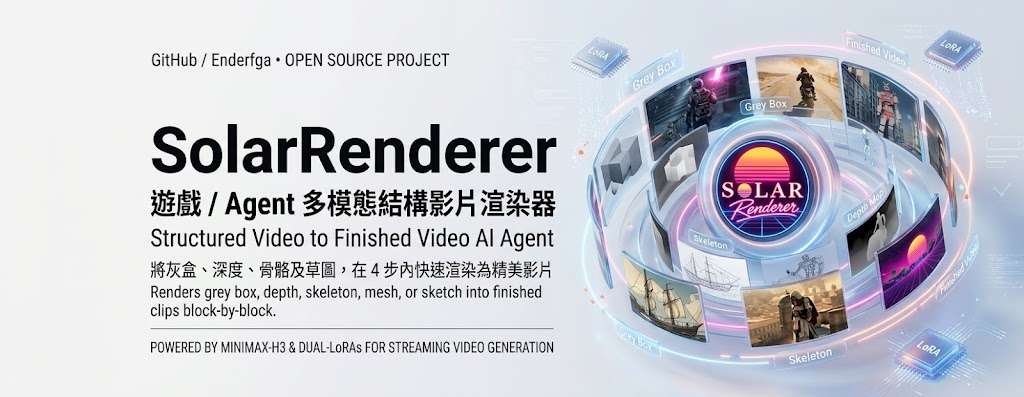
SolarRenderer 將遊戲引擎或智能體輸出的結構訊號,於 MiniMax-H3 上以四步推理生成風格統一的影片,並以區塊串流方式即時輸出畫面。

teaser

過往要做「結構可控」的影片生成,往往要為每種輸入(灰盒、語義圖、骨骼、深度)各自訓練一支分支模型。SolarRenderer 試圖打破這個分工限制:它以兩組 LoRA 在 MiniMax-H3 上做 post-training,無需 condition-type label,純粹由 prompt 描述結構本身,再交由模型自行解讀。同一段結構影片,配合首幀與文字描述,可以分別輸出寫實、動漫、像素或水墨等風格。

更直接的價值在於速度與即時性。對比 50 步取樣,SolarRenderer 的四步推理聲稱快 12.3 倍,並在影像質素與結構保真度上同時達標。配合兩組 LoRA 的 block-causal 版本,影片可以逐區塊即時生成,每完成一塊便即時輸出,等候延遲約 0.7 秒出一個 17 幀區塊,整體滯後約 1.1 秒。對 agent 互動或即時預覽這類工作流,這個差距幾關鍵。

訓練資料與評估同為開放:weights、訓練資料,以及涵蓋 208 個高難度案例、53 段 held-out 影片的 benchmark 套件,連同評分代碼、輸出結果與裁判評語一併釋出。項目建基於 SolarWM 框架,並非隨意下載的開源玩具,但對從事可控影片生成、世界模型或 agent 影片預覽的研究者與團隊而言,是一個值得排入評估名單的選項。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, AI productions, 模型, 世界模型, 模型訓練, Video, Image, 框架, Dataset 數據集, MiniMax, LoRA

ORBIA 測試世界模型當鏡頭回頭後場景是否仍在

影片流暢,不代表場景能保持一致。ORBIA 讓鏡頭離開再折返,檢查世界模型有沒有「忘記」剛生成的內容。

ORBIA overview

鏡頭繞一圈後,同一件物件應該仍在原位。ORBIA 這套互動影片世界模型基準測試,透過探索與重訪場景,檢查生成畫面能否構成一致的 3D 世界,而不只看影片是否漂亮。

測試輸入包括圖片、場景描述及鏡頭軌跡,並以已對齊的彩色與深度影像(Red Green Blue–Depth,RGB-D)及標註物件作參照,比單一整體影像分數更能定位場景改變的位置。

  • 輸入保留(input preservation):原有場景與地標是否保留。
  • 生成內容持續性(generated-content persistence):重訪時,新生成內容是否一致。
  • 3D 自洽性(3D self-consistency):不同視角能否支持同一個 3D 重建。

儲存庫提供評估程式、模型適配器及資料建構流程,供研究團隊接入模型測試。720 個案例涵蓋六種軌跡,包含 22 秒及一分鐘版本;長版本安排三次重訪,能檢查較長時間的場景記憶。

項目已評估 27 個模型,但所提供資料沒有具體排名或分數。它適合補強世界模型的驗證流程,不能單憑測試規模判斷哪個模型更可靠。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, Video, Image, 3D, 庫, Dataset 數據集

Page 1 of 12
1 2 3 … 12