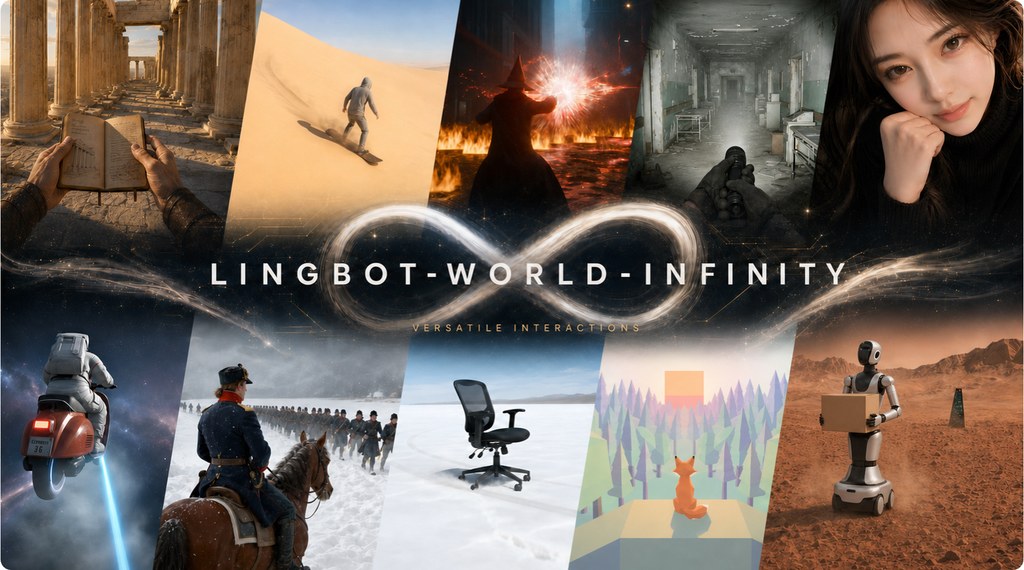
LingBot-World 2.0 把互動世界拉長

想像一個會持續生成、又跟得上操作節奏的互動世界模型。LingBot-World 2.0吸引人的地方,在於它同時追求連續性、速度與可玩性。

teaser

最值得留意的,不是單純生成影片,而是它嘗試把世界模型做成可持續互動的系統:畫面不只要動,還要在長時間互動下維持一致,並且跟得上即時操作。LingBot-World 2.0,也叫 LingBot-World-Infinity,定位上屬於模型項目,處理的是互動式世界生成容易愈玩愈散、反應又唔夠快的問題。

同類做法很多時偏向短片段展示,或者重視視覺效果多於操作連續性;這個版本反而把焦點放在「interaction horizon」拉長,同時保住輸出穩定度。它亦加入 agentic harness,由 pilot agent 規劃角色行為、director agent 補出新環境元素,方向上更接近可演進的遊戲式世界,而唔只係被動播放內容。

現階段最容易理解的試法,是先經 Reactor 的 Web 版本或 LingGuang 的流動平台體驗即時版;README 亦提供 Hugging Face 與 ModelScope 上的模型頁面。官方說明指出,平台版本方便試玩,但完整能力仍以官方設置為準,換句話說,公開體驗較適合感受互動節奏,未必等同完整表現。

  • 支援長時間互動,主打 unbounded interaction horizon
  • 提供即時變體,官方稱可驅動 720p、60 fps 影片串流
  • 動作與事件更豐富,包括攻擊、射箭、施法、射擊等互動
  • 以 pilot agent 與 director agent 分工,推進角色與場景演化

現有資料未見完整基準表或系統化對比結果,性能描述主要來自項目方公開說明,所以較適合把它視為一個展示取向鮮明的前沿模型。相關模型目前可見的是 lingbot-world-v2-14b-causal-fast;而從 Robbyant 整體路線來看,它亦與 LingBot-Vision、LingBot-Depth、LingBot-VLA、LingBot-Video 等項目一起指向 embodied AI 與世界模型的長線布局。
項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 多模態模型, 世界模型, Video, VLA

AlayaWorld 想做可玩式長時影片世界

它唔止係生成影片,重點係讓鏡頭可即時移動、途中改提示,場景仍盡量記得之前發生過乜。AlayaWorld瞄準的,是更接近「可探索」而唔只係「可觀看」的世界模型。

fig1 AlayaWorld

一段生成影片能否變成可探索空間,關鍵唔係畫面靚唔靚,而係鏡頭轉向、路徑改變、甚至中途加入新事件之後,個世界仲認唔認得自己。AlayaWorld屬於world model 研究項目,目標係處理長時間影片生成入面最麻煩的幾件事:互動控制、記憶一致性,同埋長序列愈滾愈走樣的問題。

而家不少影片生成做法偏向一次過出片,畫面可以吸引,但未必承受到持續探索;鏡頭一郁、提示一改,前後場景就容易斷裂。AlayaWorld明確反對呢種偏靜態範式,改用 interactive autoregressive world model 路線,把 3D cache、frame-history embedding,同 chunk-level prompt switching 組合起來,嘗試同時保住空間記憶、時間連續性,同中途插入事件的能力。

它最有辨識度的地方有幾個:一方面用 rendered 3D cache 配合輕量 AdaLN camera modulation,令 6-DoF 鏡頭控制更貼地;另一方面又用壓縮後的歷史影格表示,幫手維持 revisited places 的辨識度。為咗減少長時間 rollout 累積錯誤,團隊亦加入 drifted histories 訓練同 error bank,把已出現的瑕疵重新注入記憶與目標,避免失真一路放大。

  • 支援 real-time camera control,同時可在片段邊界切換 prompt
  • 以 3D cache 加 frame-history embedding 處理空間與時間記憶
  • 透過 few-step DMD distillation 爭取即時生成效率
  • 官方展示指向 720p、24 FPS、60s+ long-horizon、15B parameters
  • 目前公開的是 technical report、示範頁與影片,code 與 weights 尚未釋出

現階段較適合把它理解成研究原型,而唔係可立即部署的開源工具。想測試的人,暫時只能先睇 demo 同 technical report,重點觀察鏡頭移動、風格切換、事件插入後的連貫度;等 inference code 同 pretrained weights 釋出後,先有條件判斷佢喺內容製作、互動敘事、遊戲原型或世界模型研究工作流入面,究竟可以走到幾實用。

項目主頁 · GitHub · Paper

Categories: 開源, 視頻模型, 世界模型, 3D, Dataset 數據集

Deform360 補上可變形物體世界模型短板

做布料、繩索、海綿這類可變形物體研究,最缺的往往不是模型,而是夠完整的真實數據。Deform360把多視角影像、觸覺與3D標註放在同一套資料流程內,定位相當清晰。

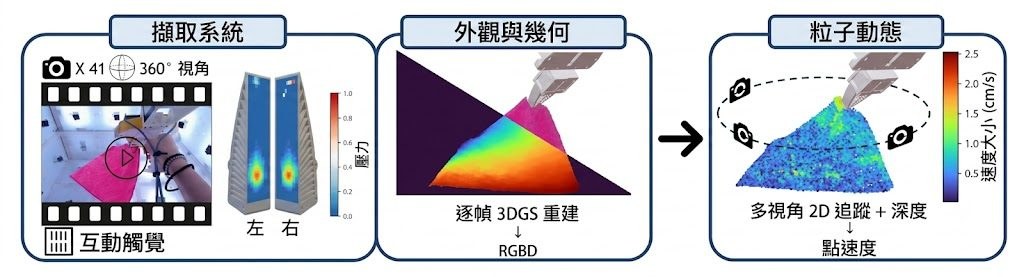
Deform360: per-frame 3D reconstruction alongside 360-degree multi-view capture.

一遇到布料、線材或柔軟玩具,很多世界模型很快就會暴露盲點:畫面看得到表面變化,卻未必掌握形變本身。Deform360屬於Dataset 數據集項目,集中處理的正是可變形物體研究長期缺少的真實多模態資料,讓2D video world models與3D particle world models可以放在同一基準下比較。

它的吸引力不只在於量大,還在於資料結構相當完整。項目收錄198件日常可變形物體、1,980段機械人互動、215.7小時累積錄製內容,配合41部同步720p RGB相機做360°拍攝,另有雙手UMI-based tactile grippers的四組16×32觸覺串流。對研究團隊來說,這代表不只是「有影片可看」,而是可以對齊視覺、觸覺、相機幾何與3D粒子標註去做分析。

跟不少只提供單視角影片、少量物件,或者只放最終標註的資料集相比,Deform360更重視重建與對齊流程。作者採用markerless visuotactile tracking pipeline,把ArUco calibration、3D Gaussian Splatting、CoTracker3與physics-informed refinement串起來,目的不是包裝成一鍵訓練工具,而是把可重用的資料契約、幾何工具、annotation I/O與multimodal alignment utilities公開。

  • 針對198件可變形物體,涵蓋多視角影像、觸覺與dense 3D particle annotations
  • 適合比較2D video world models與3D particle world models在真實形變上的差異
  • GitHub 目前主要釋出資料存取、preprocessing、geometry與對齊工具
  • 未附world-model baselines、training code、pretrained checkpoints或一鍵端到端流程

部署與測試的理解方式也要先講清楚:這不是拿來即刻訓練完整模型的全包框架。現有儲存庫提供Python 3.10以上的安裝入口,並連到 Hugging Face 資料集;你可以把它當成研究資料管線與讀取工具,用來下載資料、做相機去畸變、處理觸覺對齊、載入標註與幾何資訊。原始資料沒有提供完整基線訓練流程,因此較適合已有world model、tracking或robot learning流程的團隊接入。

性能方面,項目頁面有交代基準結論:ParticleFormer在held-out episodes預測較好,pretrained Cosmos在unseen objects的視覺指標領先,但可能偏離指令動作。這種結果也反映Deform360的價值不在於替某一類模型背書,而是把可變形動態、視覺觀測與觸覺證據放回同一個較公平的測試場。相關模型與方法脈絡包括2D video world models、3D particle world models、ParticleFormer、Cosmos,以及資料製備中用到的 CoTracker3 與 3D Gaussian Splatting。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, 世界模型, 模型訓練, Video, Robotic, 3D, Python, Dataset 數據集

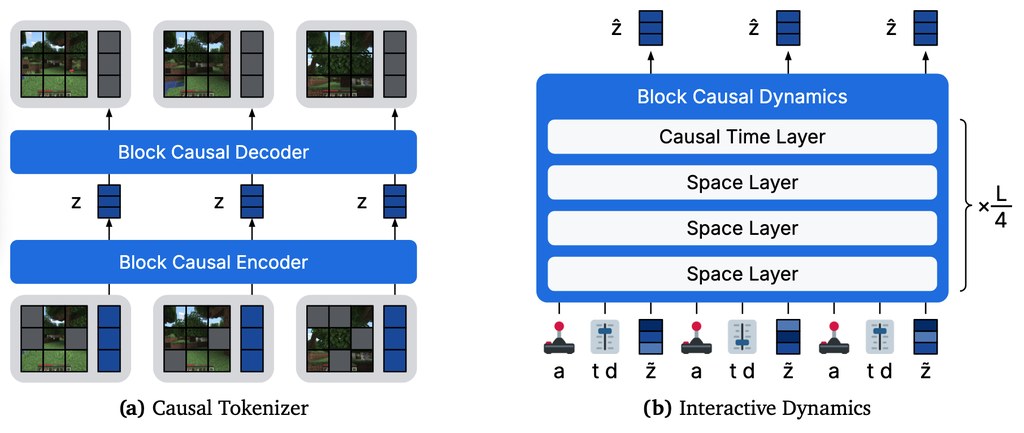
MIRA 把《Rocket League》變成可互動世界模型

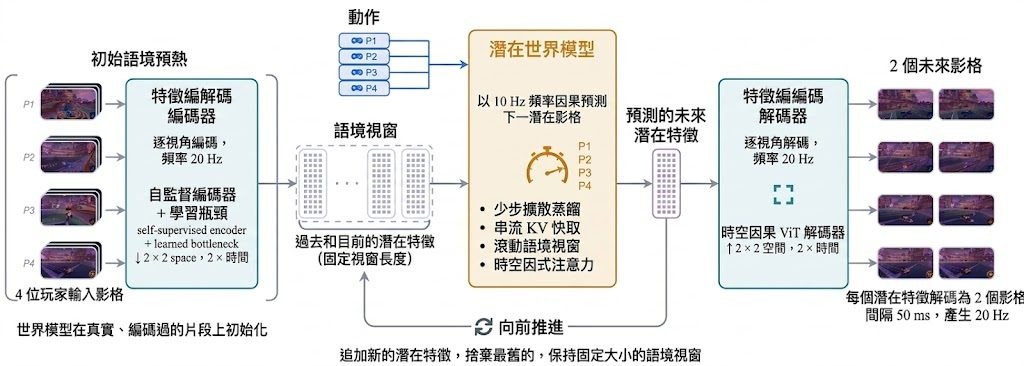
MIRA 唔係單純重播比賽片段,而係讓四名玩家動作一齊驅動畫面生成。你可以把它理解成一個能即時模擬 2v2 對戰走勢的世界模型研究項目。

Repository image for mira-wm/mira

打機畫面一路變化,背後又有四名玩家同時輸入動作,呢類情境一向好難靠 world model 穩定重建。MIRA 屬於開源框架兼研究型模型項目,處理的是多人互動環境中,如何按四條 action streams 即時生成《Rocket League》對戰畫面,令 2v2 比賽可以直接在模型內運行。

現有做法多數集中在 single-player world models,其他角色通常只被當成環境一部分;作者明確反對呢種 fixed framing,因為多人場景入面,畫面變化要分得清楚邊個玩家造成。MIRA 改用 multiplayer conditioning,並配合 Representation Autoencoders 同 latent diffusion,目標唔只係畫面似真,而係令物理互動、攻守切換同多角色行為保持連貫。

個項目的取向相當鮮明:它唔係先追求最輕量部署,而係用 5B parameters 模型換取即時互動與長時間 rollout 穩定性。資料來自 10,000 小時 gameplay,README 亦公開了 RocketScienceDataset,當中每個 sample 都包含四個同步視角、逐格 keyboard action 同 game state,對做世界模型、VLA 或互動模擬研究的團隊都很有參考價值。

  • 屬於開源框架加世界模型研究項目,重點是部署、資料使用與評估多人互動生成
  • 與單人 world model 最大分別,在於同時按四名玩家動作生成畫面,而唔係把其他玩家當背景擾動
  • 官方指出模型可在單張 NVIDIA B200 GPU 上以 20 FPS 生成完整 2v2 對戰
  • 相關資料集 rocket-science 提供同步視角、動作與 game state,方便重做測試與分析
  • README 提供 pixi 環境安裝與 test suite 入口,但更完整部署細節仍要靠原始程式與技術報告配合理解

就公開結果看,MIRA 最有說服力的地方唔係單一 benchmark 數字,而係它把「多人動作歸因」變成核心問題,再補上對物理理解的 targeted evaluations。官方亦表示,雖然模型只用短片段訓練,distributional quality 可維持到五分鐘量測範圍,實驗中甚至能持續更長時間;不過硬件門檻高,定位更接近前沿研究平台,而唔係一般人可隨手在本地執行的輕量工具。

項目主頁 · GitHub · Paper

Categories: 開源, 世界模型, NVIDIA, Gemini, VLA, Dataset 數據集

GigaWorld-1:機械人世界模型開源路線圖

GigaWorld-1 不只是模型,亦是一套圍繞機械人世界模型的訓練與推理流程。它的重點是用模擬 rollout 協助評估 robot policy。

GigaWorld-1 Teaser

GigaWorld-1 是一個面向 robot world models 的開源工具鏈與研究原型。它主要用來訓練、推理、處理資料,並把世界模型當成 robot policy evaluation 的替代評估器,減少每次都要落真機做 rollout 的成本。

現有做法通常依賴真實機械人測試,或者用偏重短片畫質的 video world models 觀察結果;作者認為這種範式未必足夠反映 policy 是否可靠,因為短期視覺真實感不等於長時序、動作一致的 rollout 準確度。這個項目連同 WMBench 一齊提出較清晰的評測框架,重點放在 long-horizon、action-faithful rollout consistency,而不是只看畫面似唔似真。

和一般只放模型權重的 GitHub 項目相比,GigaWorld-1 較完整地公開了訓練、inference、資料處理、checkpoint conversion 及 LoRA merge 流程,取向明顯偏向可重現與可擴充。基礎模型亦不是由零開始孤立建立,而是結合 Wan、Diffusers、Helios、Genesis 等元件,反映它更像一條可調整的工作流程,而不只是單一模型展示。

  • 重點不在短期畫面好看,而在 rollout 是否長時間維持動作一致性
  • 提供 training、inference、data processing、checkpoint conversion、LoRA merge 等完整流程
  • 相關模型與元件包括 WanDiffusersHeliosGenesis
  • 配套有 ToyDataset、CVPR 2026 WorldModel Track Dataset 與 WMBench benchmark

部署思路相對明確:環境以 Python 3.10+、PyTorch 2.x、Linux 為主,再按 README 準備資料、模型與推理流程;需要下載模型或資料時,亦已有獨立工具說明。硬件需求未算輕量,但首頁提到 1.3B / 5B 變體與低於 24GB 記憶體的生成設定,代表它並非只面向超大規模研究機構。

較適合受益的群體,是做 embodied AI、robotics、world model research 的團隊,以及想建立 policy evaluator 管線的人。現有資訊顯示它背後有 12,000+ 小時訓練影片、324,000+ 模擬 rollout 配對真機執行,以及 7 類 video world models、4 種 action representations 的比較;這些數字未必等於任何場景都會即插即用,但足以說明它的價值在於提供一套有 benchmark 支撐的評估方法,而不只是再多一個生成模型。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, 世界模型, 模型訓練, Video, VLA, Robotic, 框架, Linux, Python, Dataset 數據集

WorldDirector 14B:可控影片世界模型點樣做長時記憶

呢個項目想解決影片世界模型難以長時間記住物件身份與動作邏輯的問題。重點不在單純出片,而是把鏡頭、物件移動與一致性分開控制。

Repository image for pPetrichor/WorldDirector

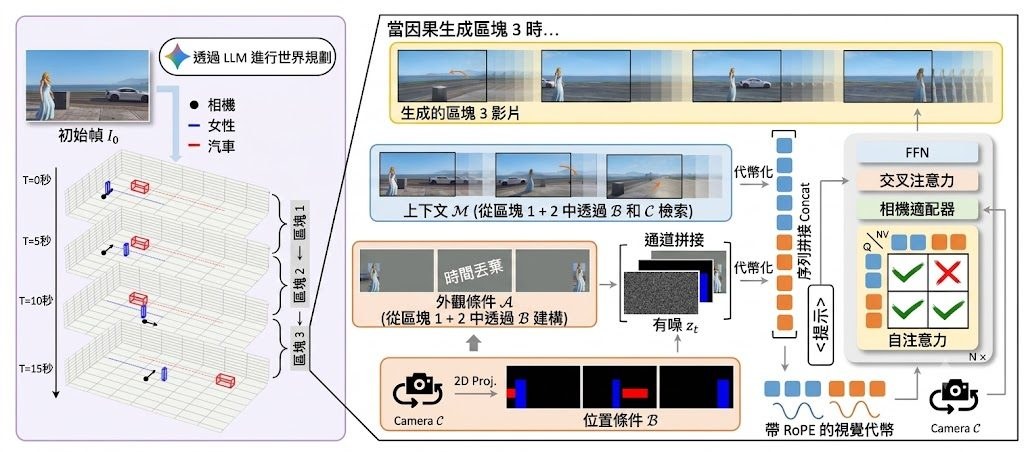
WorldDirector 是一個影片世界模型框架,屬於研究原型兼開源推理項目。它的核心任務,是讓系統在生成長片段影片時,仍能記住動態物件的身份、位置變化與鏡頭運動,減少角色或物件一離開畫面就「變樣」或失去連續性的情況。

它的做法不是直接把所有事情交畀單一生成模型處理,而是先用 Large Language Model(LLM)規劃 3D 物件軌跡與相機路線,再把規劃投影成 2D 控制訊號交畀視覺生成模組。呢種拆分令項目的取向很清晰:先保住語意層面的動作因果,再處理畫面生成,因此比起只靠像素連續性的世界模型,更重視可控性、物件恆常性同長時段一致性。

目前已公開的是完整 inference code 同 WorldDirector-14B 權重,同時亦交代依賴 Torch 2.4.0、FlashAttention,以及 Hugging Face 下載模型的流程。換句話說,現階段較適合已有 GPU 環境、懂得整理 JSON 規劃輸入的人測試;它不是裝完即用的消費級工具,而較接近可重現論文結果的研究型項目。

項目展示的例子集中在人物、車輛、鏡頭切換與長時間事件編排,重點是物件暫時離開視野後再返回,外觀仍能維持穩定。公開資訊提到它支援 persistent dynamic object memory 同 unrestricted viewpoint exploration,但未見提供完整量化基準細節,因此現階段較適合把它理解為一個方向鮮明、控制力強的世界模型方案,而不是已全面驗證的通用產品。

  • 類型定位:影片世界模型框架,主打可控生成與長時記憶
  • 主要差異:把運動規劃同視覺生成拆開,先處理 3D 語意軌跡
  • 較適合情境:研究團隊、影片生成工作流、需要鏡頭與角色一致性的實驗
  • 部署理解:需先配置依賴、下載 WorldDirector-14B,並準備符合格式的 JSON 計劃輸入
  • 相關模型:WorldDirector-14B;流程中亦依賴 Large Language Model(LLM)參與動作與鏡頭規劃

整體來看,WorldDirector 最有價值的地方,在於它把「世界模擬」由單純畫面續寫,推進到可描述、可規劃、可回放的控制流程。對想研究影片 world model、角色一致性與可操控鏡頭生成的人來說,呢個項目值得留意;對只想快速出片的人,現有門檻仍然偏高。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, 世界模型, Google, NVIDIA, 3D, 蘋果

PhysisForcing 提升機械人世界模擬可靠性

這是一個強化影片生成物理一致性的訓練框架,用來改善機械人操作模擬的可信度。

Teaser Figure

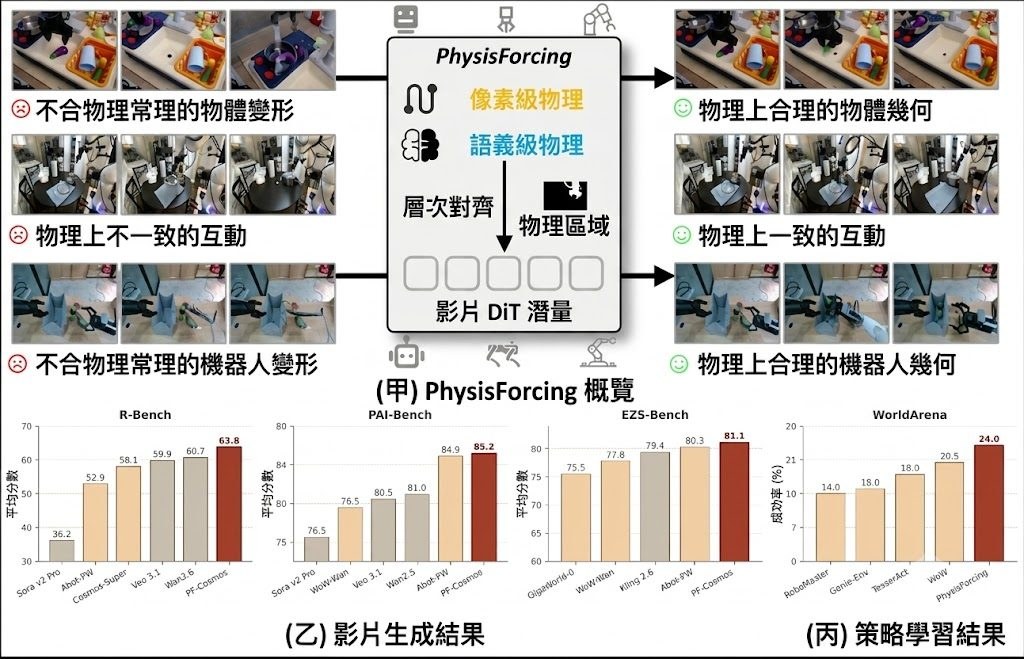
這是一個用於機械人操作的世界模擬訓練框架,名為 PhysisForcing。它主要解決影片生成模型在模擬抓取、推動與物件互動時,常出現動作軌跡不連續、物件變形和互動不合物理規律的問題。

PhysisForcing 的做法不是單靠生成更像真的畫面,而是把訓練重點放在與物理相關的區域,並同時加入像素層與語意層兩種約束。像素層的 trajectory alignment loss 會用參考點軌跡監督 DiT features,語意層的 relational alignment loss 則利用凍結的影片理解編碼器,對齊區域之間的互動關係,令機械臂與物件之間的時空關聯更穩定。

和一般通用影片生成模型,或只針對機械人資料做微調的方法相比,這個框架更集中處理「物理合理性」而非單純畫面觀感。它可套用在標準 diffusion video backbones 之上,已展示於 Wan2.2-I2V-A14B 與 Cosmos3-Nano 這兩個基礎模型。

  • 核心重點是分層物理對齊:同時改善運動一致性與互動關係一致性
  • 適合用於 embodied world simulation、robotic manipulation 與下游動作規劃
  • 在 R-Bench、PAI-Bench、EZS-Bench 都較強基線有提升
  • R-Bench 上,Wan2.2-I2V-A14B 提升 +22.3%,Cosmos3-Nano 提升 +9.2%
  • 納入 WorldArena action-planner protocol 後,closed-loop success rate 由 16.0% 升至 24.0%

這項工作對需要用影片模型做機械人訓練、模擬驗證或策略學習的人較有參考價值,因為它不只改善生成片段的外觀,亦提升作為 world model 的可用性。現有資料顯示,物理對齊後的影片表徵亦能帶動下游 policy success,說明這類方法不只是視覺修飾,而是直接影響機械人操作結果。

項目主頁 · Paper

Categories: 開源, 北京大學, 模型, 視頻模型, 世界模型, 模型訓練, NVIDIA, Video, Robotic, 框架

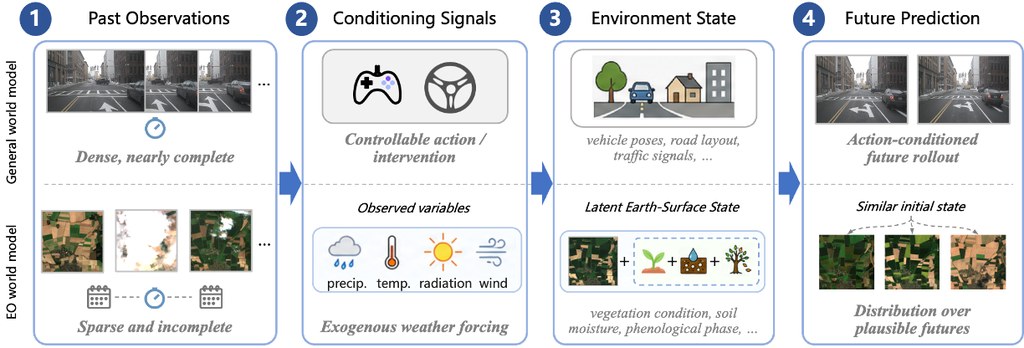
EO-WM:把衛星影像預報變成天氣驅動的世界模型

EO-WM 以物理引導的潛在影片擴散架構預測未來衛星觀測,並針對極端天氣下植被退化與天氣響應準確度提出全新基準。

EO-WM overview

這是一個結合物理知識的影片擴散世界模型(EO-WM),專門用於多光譜衛星影像的概率預測。整體目標是把地球觀測(Earth Observation, EO)預報重新定位為「部分可觀察、天氣驅動的世界建模」任務,在稀疏衛星上下文與未來氣象條件下預測地表動態,並支援災害監測、作物產量預估及植被變化追蹤等下游應用。

過去的 EO 預測方法分為兩類:決定式模型把不確定性壓縮成單一未來影像,擴散式方法則往往把天氣變量當成籠統的條件輸入。這兩種做法都難以正確反映「氣象條件如何改變地表狀態」這個核心問題,而且現有 benchmark 多聚焦於像素重建準確度,未能衡量模型在改變天氣條件時是否會產生方向正確的響應。EO-WM 為了解決這個落差,引入一個 EO 專屬 VAE 把稀疏衛星觀測編碼為潛在影片 token,再用擴散 Transformer(diffusion transformer)經由獨立條件路徑同時處理三種信號:氣候基線(climatological baseline)、天氣異常(weather anomaly)與累積物理壓力(cumulative stress),並持續將空間上下文重新注入影片 token 流。

在評測方面,作者提出兩個以 EarthNet2021 為基礎的診斷式 benchmark:Extreme Summer Benchmark 衡量極端熱浪與乾旱下植被退化的嚴重程度感知能力,引入 TN-MAE 與 Drop Amplitude Error;Seasonal Matched-Pair Benchmark 則衡量當天氣條件改變時預測方向與幅度是否正確,以 Divergence Reproduction Ratio、Directional Hit Rate 與 Paired Divergence Correlation 為指標。報告結果顯示 NDVI 下降幅度的預測誤差相對減少 5.63%,方向命中率相對提升 7.80%,同時在像素級 ENS、P-MAE、N-MAE 等指標上仍具競爭力。

這個項目對遙感研究者、農業監測團隊及氣候風險分析團隊特別有價值,因為它同時提供模型與基準資料,讓外界可在統一的評測框架下比較不同方法的天氣響應能力。從工程角度來看,架構設計強調物理分離條件與空間重注入,而非單純堆疊參數,這種取捨有助於提高極端情境下的可解釋性。需留意的是,目前 GitHub 倉庫主要釋出 benchmark CSV 與 Earthformer 參考評測腳本,模型權重與完整訓練流程屬於配套資源,重現完整結果仍需自行準備 EarthNet2021 的 extreme 與 seasonal 切分資料。

重點摘要:

  • 重新定義 EO 預報範式:把衛星影像預測視為天氣驅動的世界建模,而非純粹的影像重建。
  • 物理分離條件:天氣信號被拆分為基線、異常與累積壓力三條獨立條件路徑。
  • 診斷式 benchmark:Extreme Summer 與 Seasonal Matched-Pair 兩個基準專門檢驗模型在天氣改變下的響應正確性。
  • 可量化的天氣敏感度:NDVI 下降誤差降低 5.63%,方向命中率提升 7.80%,標準指標仍具競爭力。
  • 目前釋出內容:以 benchmark CSV 與評測腳本為主,完整訓練流程需搭配 EarthNet2021 資料集。

GitHub · Paper

Categories: 開源, 香港大學, 香港理工大學, 模型, 世界模型, Stable Diffusion, 框架, 香港, , 深度學習

MMBench2 點樣預測 World Model 幻覺

MMBench2唔只係資料集,亦連同模型、評測同互動介面一齊公開。重點在於預測同減少 World Models 出現 hallucination。

walker run

MMBench2 是一個圍繞 large generative world models 的研究型基準與開源項目,結合資料集、模型、訓練與評測程式。它主要處理 World Models 在生成未來軌跡時出現 hallucination 的問題,也就是畫面看似合理,但已經偏離真實動態與動作條件。

現有做法多數集中在把 world model 做得更大,或沿用固定的 open-loop rollout 範式觀察生成效果;作者認為這樣很難直接找出模型何時開始失真。這個項目改以「可預測、可預防」為核心,提出三種 runtime hallucination predictors:tokenizer round-trip residual、flow instability、inter-seed denoising variance,並配合 motion-normalized 版本做即時監測。

模型設計大致跟隨 Dreamer 4 路線,但重點不只在架構本身,而是把 coverage-aware training 與 targeted data collection 放入同一套流程。作者把 hallucination 視為 data coverage 問題,因此會重抽樣 under-represented 的 state-action space,亦會用 predictors 當 curiosity reward 做 closed-loop online data collection,這比單純加大模型更有方向性。

部署理解上,這個項目已提供互動式網頁介面,可在 CUDA GPU 上直接啟動,並用 live simulators 種出 rollout,連完整資料集都唔一定要先下載。官方亦公開 350M-parameter pretrained 與 finetuned world models,以及 427 小時、涵蓋 210 個 continuous control tasks、10 個 domain 的 MMBench2 dataset,方便研究團隊重做訓練、比較不同變體,或者先用 checkpoint 檢查 hallucination predictor 的表現。

  • 項目性質:研究型 benchmark 加工具鏈,不只是單一模型
  • 核心差異:把 hallucination 當成 coverage 問題,而非單靠更大模型硬推
  • 可測內容:即時 predictor 疊圖、不同模型變體、互動 rollout 對照
  • 相關模型:base、coverage_aware、combined 三類變體,以及 350M-parameter world models
  • 適合情境:world modeling、planning、policy learning、模型安全檢查

這個項目較適合研究 world models、Robotic 控制、模型可靠性與安全的團隊閱讀和試驗。它未必是一般開發者即裝即用的應用工具,但作為 benchmark、分析框架與資料基礎設施,辨識 hallucination 成因與改善方向都相當清楚。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 世界模型, 模型訓練, Robotic, 框架, 安全, Dataset 數據集

PhysiFormer 用座標預測物理運動

這是個用世界座標模擬3D物體運動的擴散模型。它把剛體、彈性體與多物件互動放進同一個生成框架。

Og image

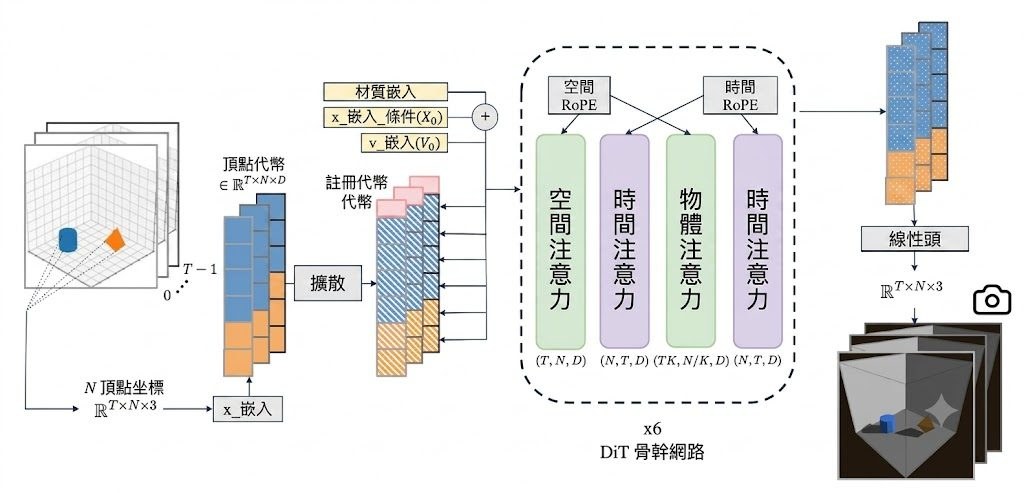
PhysiFormer 是一個 diffusion transformer 模型,用世界座標中的 3D mesh 直接模擬物體運動。它要處理的是在已知初始頂點位置、速度與材質條件下,生成之後一段時間內合理可信的 4D 動態軌跡。

它和常見 video world models 的分別,在於不是在視角相關的像素空間推測畫面變化,而是直接預測 world coordinates 裡的 vertex trajectories。論文指出,這個做法不依賴手動指定的模擬結構、shape latent,亦不需要明確加入 rigid-transform prediction 一類限制,改用單一步驟的去噪擴散過程學習完整時域軌跡。

模型同時支援 rigid 與 elastic 物件,亦能處理 mixed-material dynamics、碰撞,以及靜止與移動中的多個物件。為了提升效率,PhysiFormer 採用在時間、空間與物件三個維度分解的 attention,令多物件推理保留 permutation-invariant 特性,毋須額外手動編碼物件身份。

  • 3D coordinate diffusion 建模,重點是視角無關而且幾何結構清晰
  • 用超過 100k simulated trajectories 訓練,覆蓋多種剛體與彈性體運動
  • 可生成多個合理未來,而非只輸出單一路徑,適合存在未觀察不確定性的情境
  • 它在 trajectory accuracy、rigidity preservation 與 momentum-based physical consistency 上明顯優於 autoregressive baselines

這類項目較適合 robotics、graphics、physical design,以及需要幾何感知 world modelling 的工作流。現有資料顯示它對未見過的真實幾何形狀、更大的物件數量,以及混合材質場景有一定泛化能力,但內容主要來自模擬資料與論文結果,真實部署表現仍要配合具體場景再驗證。

項目主頁: https://yimingc9.github.io/physiformer/

Paper: https://arxiv.org/pdf/2606.27364

Categories: 開源, 模型, 世界模型, 模型訓練, Video, Robotic, 框架, Vibe Coding, Content Creator, 3D, 深度學習

Page 5 of 9
1 3 4 5 6 7 9