Qwen-VLA 用單一模型打通機械人任務

Qwen-VLA把操作、導航與軌跡預測放入同一個模型。重點在跨機械人平台與跨場景泛化能力。

Hero image preview

Qwen-VLA 是一個把視覺、語言與動作整合起來的項目,目標是用同一套模型處理機械人操作、導航,以及軌跡預測。過往很多 embodied intelligence 系統都只針對單一任務或單一機械人設計,結果是能力分散,換場景、換任務或換機體後便難以沿用。

這個項目以 Qwen3.5 Vision-Language Model 為基礎,再加入 DiT-based action decoder,令模型不只看圖和理解文字,還能產生連續動作與軌跡。研究團隊亦加入 embodiment-aware prompt conditioning,用機械人專屬文字描述去標示當前機體與控制方式,讓同一模型可支援多種 robot embodiments。

核心概念是把不同類型資料一同訓練,包括 robotics manipulation trajectories、human egocentric demonstrations、synthetic simulation data、vision-and-language navigation data,以及 auxiliary vision-language data。對開發者來說,這代表項目不是只做問答或只做控制,而是把 manipulation、navigation 與 trajectory prediction 放進同一個 action-and-trajectory prediction 框架。

重點可先看以下幾項:
– 用單一 Vision-Language-Action Model 處理多類 embodied 任務
– 同時支援文字回應、動作生成與軌跡生成
– 透過 embodiment-aware prompt conditioning 適配不同機械人平台
– 強調 out-of-distribution generalization,涵蓋光線、背景、物件配置與機體變化
– 適合研究通用機械人控制、跨任務遷移與多平台部署的人員

論文列出 Qwen-VLA-Instruct 在多個基準上有不錯表現,包括 LIBERO 97.9%、Simpler-WidowX 73.7%、RoboTwin-Easy/Hard 86.1/87.2%、R2R 的 69.0% OSR、RxR 的 59.6% SR;在真實世界 ALOHA 實驗亦錄得 76.9% average OOD success,在 DOMINO dynamic manipulation 有 26.6% zero-shot success rate。若你關注的是一個可橫跨任務、環境與 robot embodiments 的通用型項目,展示了統一式 Vision-Language-Action Modeling 的清晰方向。

Paper: https://arxiv.org/pdf/2605.30280

Categories: 阿里巴巴, Agentic, 模型, 世界模型, 中國

LongCat-Video 1.5:生成更實用的長片

項目把多種影片生成工作放進同一模型,重點放在長影片質素與效率。對想比較開源影片模型的人,很有參考價值。

LongCat-Video

LongCat-Video 是一個 13.6B 參數的影片生成項目,主打把文字生成影片、圖片生成影片,以及影片續寫放進同一套架構。對一般使用者來說,最易明白的價值是:不用為不同影片任務分開找不同模型,處理流程可以更集中。

它解決長影片生成常見的畫面走樣、色彩飄移,以及愈生成愈差的情況。項目特別提到自己原生預訓練了影片續寫能力,因此在長時間內容上較有優勢,目標是生成分鐘級影片時仍保持穩定。

先決定輸入方式:有文字概念就做 Text-to-Video,有單張圖片就做 Image-to-Video,要接續既有片段就用 Video-Continuation。提供相關模型與延伸版本,包括 LongCat-Video、LongCat-Video-Avatar 1.5,以及 Hugging Face 與 ModelScope 上提供的模型頁面。

它同時強調速度與畫質。項目表示透過時間與空間兩個方向的 coarse-to-fine 生成策略,再配合 Block Sparse Attention,可在數分鐘內產出 720p、30fps 影片;這類設計對高解析度生成尤其重要,因為影片模型最常見瓶頸就是算力與等待時間。

  • 單一模型支援 Text-to-Video、Image-to-Video、Video-Continuation
  • 強調長影片生成,主打減少色偏與畫質退化
  • 以 coarse-to-fine 加速推理,兼顧效率與解析度
  • 提到用多重獎勵的 GRPO 強化學習提升整體表現

這項目較適合關注開源影片生成、長片段內容、角色或場景延續的人,也適合想研究統一式影片模型設計的開發者。其表現可比肩領先開源模型與新近商業方案,但更細的分數與比較細節,仍需要配合技術報告一併閱讀會較穩妥。

Evaluation Results

Text-to-Video

The Text-to-Video MOS evaluation results on our internal benchmark.

MOS scoreVeo3PixVerse-V5Wan 2.2-T2V-A14BLongCat-Video
AccessibilityProprietaryProprietaryOpen SourceOpen Source
ArchitectureMoEDense
# Total Params28B13.6B
# Activated Params14B13.6B
Text-Alignment↑3.993.813.703.76
Visual Quality↑3.233.133.263.25
Motion Quality↑3.863.813.783.74
Overall Quality↑3.483.363.353.38

Image-to-Video

The Image-to-Video MOS evaluation results on our internal benchmark.

MOS scoreSeedance 1.0Hailuo-02Wan 2.2-I2V-A14BLongCat-Video
AccessibilityProprietaryProprietaryOpen SourceOpen Source
ArchitectureMoEDense
# Total Params28B13.6B
# Activated Params14B13.6B
Image-Alignment↑4.124.184.184.04
Text-Alignment↑3.703.853.333.49
Visual Quality↑3.223.183.233.27
Motion Quality↑3.773.803.793.59
Overall Quality↑3.353.273.263.17

GitHub: https://github.com/meituan-longcat/LongCat-Video

Categories: 數字人, 模型, 視覺模型, 視頻模型, 世界模型, 影像處理

DexJoCo:靈巧機械手模擬實驗入門

這個專案用 MuJoCo 建立靈巧操作模擬流程,亦照顧到示範收集與遙控操作。對研究機械手任務的人來說,方向相當清晰。

Repository image for brave-eai/dexjoco

DexJoCo 是一個以 MuJoCo 為基礎的模擬基準與工具集,重點放在「有目標的靈巧操作」:例如用機械手完成特定任務,而不只是做單一抓取動作。對初學者來說,它的價值在於把模擬環境、示範收集,以及遙控操作相關元件放在同一個專案內,較容易看清整體流程。

如果你想使用,先把它當成任務模擬平台,再了解示範資料如何被記錄。README 提到可輸出 Zarr 格式重播資料與相機影片,這表示它不只用來「睇畫面」,亦方便之後做訓練、重播或比較不同方法表現。

它較有意思的地方,是把遙控操作設計成依賴明確的 UDP 封包協定。換句話說,模擬器本身與外部裝置之間有一定解耦,無論是 Vive tracker、Rokoko,甚至內含的 GeoRT 流程,都較像可替換的輸入橋樑,令擴充與整合更實際。

  • 以 MuJoCo 為核心,集中處理靈巧操作任務
  • 支援示範收集,並輸出重播資料及影片
  • 內建多種遙控相關橋接元件,方便接駁外部追蹤資料
  • 可切換互動模式與較適合策略執行的無畫面模式

適合的讀者主要是機械人研究者、學生,或者想測試手部操作任務的人;如果你正研究 imitation learning、policy evaluation,這類資料輸出會特別有用。從專案內容可見的相關組件包括 MuJoCo、Vive bridge、Rokoko、GeoRT,以及用於資料儲存的 Zarr;至於 README 亦提到 policy mode 與離屏渲染設定,反映它同時兼顧互動收集與批次實驗兩種場景。

整體來看,DexJoCo 未必是面向一般用家的即開即用工具,但作為研究型基礎設施,它的定位相當清楚。若你需要一個把任務模擬、遙控輸入和示範記錄串連起來的環境,這個專案值得留意。

網址: https://github.com/brave-eai/dexjoco

Categories: 開源, 香港中文大學, 世界模型, Robotic

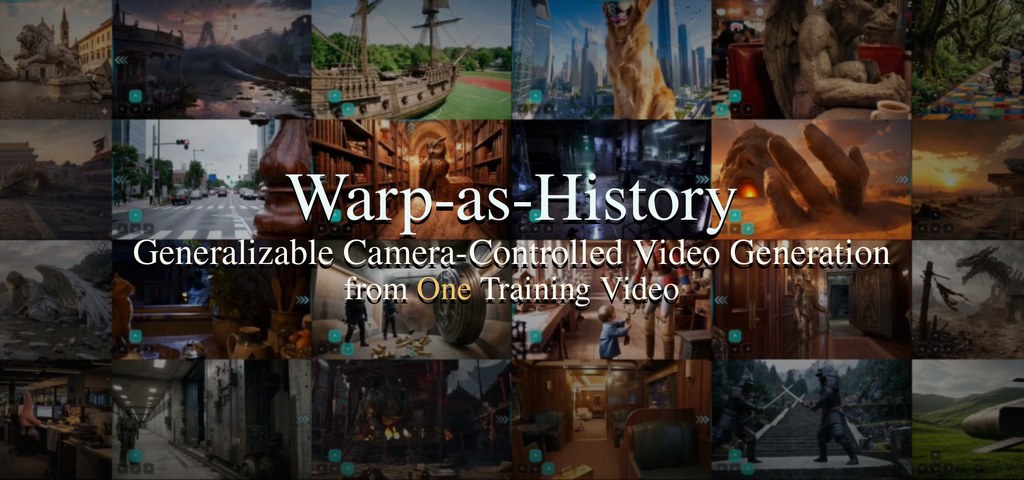
Warp-as-History:一段片訓練出「鏡頭操控」

專案主打用一段已標註鏡頭資訊的影片,生成可跟隨視角移動的新片段。對想試相機控制式影片生成的人來說,方向相當清晰。

Warp-as-History teaser

如果你對 AI 影片生成有興趣,但又覺得「要大量素材先訓練」門檻太高,Warp-as-History 的吸引力正在於它嘗試只用一段訓練影片完成相機視角控制。簡單講,它想做的是讓系統學會原片中的空間與運鏡關係,再按你指定的鏡頭路徑生成新畫面。

對一般使用者來說,理解這個專案的最好方法,不是把它當作普通文字生片工具,而是視為一個偏向「鏡頭操控」的研究型方案。你需要先準備一段帶有相機資訊的影片,再配合指定模型做推理或訓練;官方列出的預設組合包括 Helios-DistilledWarp-as-History LoRA,而 Helios-Mid 主要用於訓練,另外 README 亦提到 Pi3X

它解決的重點問題,是生成影片時常見的視角不穩、鏡頭移動不連貫,以及難以精準控制觀看方向。這個方法特別強調互動式鏡頭軌跡跟隨與視點調整,定位上與 HappyOyster、Genie 3 這類方向相近,但賣點是把所需訓練資料壓到單一範例,這點相當有研究價值。

  • 一段訓練影片 已是核心設定,對資料收集要求較低
  • 重心不在純文字生成,而在鏡頭路徑與視角控制
  • 相關模型包括 Helios-Distilled、Warp-as-History LoRA、Helios-Mid、Pi3X
  • 較適合研究實驗、效果驗證,未必是即開即用的消費級工具

如果你是做生成式影像研究、互動敘事、虛擬攝影,這個專案值得留意;若你只是想快速剪片或一鍵出成品,可能會覺得前置準備仍然偏技術性。整體來看,Warp-as-History 最有意思的地方,是把「影片歷史資訊」由單純上下文提升為可延續的視角依據,令相機控制這件事更像真正可操作的生成條件。

網址: https://github.com/yyfz/Warp-as-History

Categories: 開源, 視頻模型, 世界模型, 影像處理, 中國

Awesome-WAM:看懂機械人點樣先諗後做

這個整理庫聚焦 World Action Models,幫你快速理解機械人如何一邊預測世界、一邊決定動作。

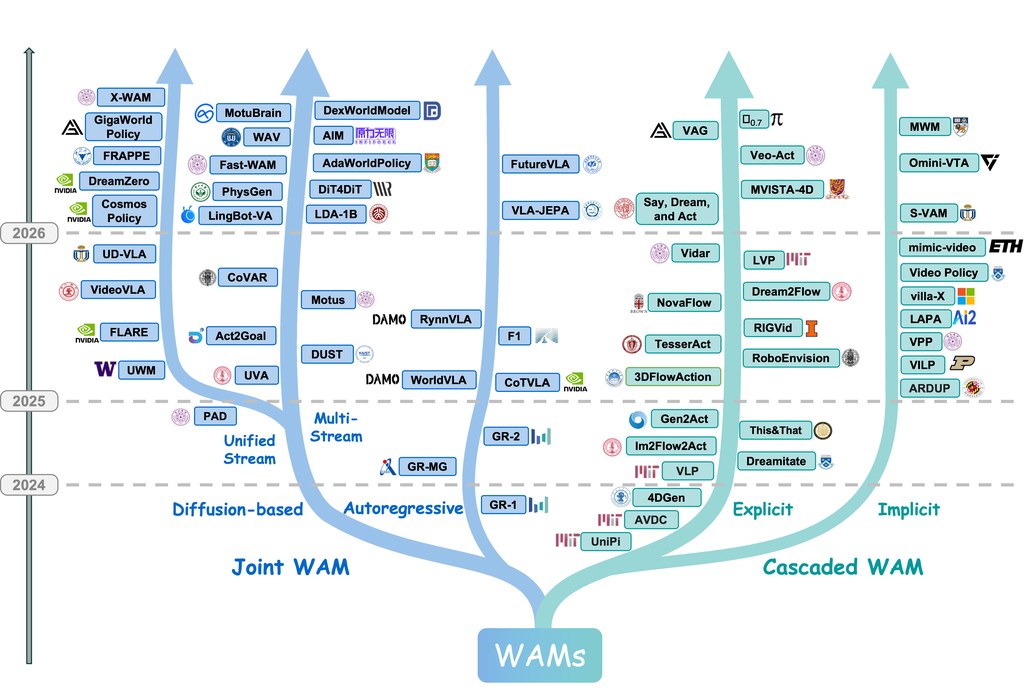
Temporal evolution and taxonomy of representative works on World Action Models (WAMs).

如果你對機械人或 AI 有興趣,但又唔想一開始就埋頭讀大量論文,Awesome-WAM 其實幾好入手。它本身唔係一個直接拿來部署的機械人程式,而係一個系統化整理庫,集中介紹 World Action Models 這個新方向,並附有每篇論文的重點摘要,方便讀者由概念開始慢慢建立理解。

這個主題想解決的核心問題,其實幾直觀:不少模型能夠由影像或文字直接產生動作,但未必真係「理解」下一步世界會點變。WAM 的做法,是將環境變化預測同動作生成放埋一齊考慮,令機械人唔只係反應快,亦更似先模擬後行動。

這個儲存庫最有價值的地方,在於它唔單止列論文,而係嘗試用統一框架整理整個領域,例如分開 Cascaded 與 Joint 兩類路線,亦有提到訓練資料來源、評估方式,以及與 Vision-Language-Action 發展之間的關係。對初學者來講,這種分類比單看論文名更易掌握全貌。

  • 提供系統化總覽,適合先建立概念再深入讀文獻
  • 有每篇文章的簡短導讀,節省篩選時間
  • 涵蓋相關模型與方向,如 RT-2、OpenVLA、π0,以及庫內收錄的 DREMA、RoboScape、Ctrl-World
  • 重視架構分類、數據來源與評估方法,唔只係單純清單

如果你想上手,最實際做法係先看它對 WAM 的整體定義,再沿分類去揀有興趣的論文摘要閱讀。研究人員、學生、做機械人產品規劃的人都會受用;即使你未必會親自訓練模型,這個整理庫都能幫你較快分清哪些方法偏向預測世界、哪些更強調動作生成控制。

整體來說,Awesome-WAM 比較似一張持續更新的地圖,而唔係單一工具。對想跟進 embodied AI、VLA 與 world model 交叉發展的人,它的價值在於幫你用較低成本看清研究脈絡,同時保留足夠細節,方便之後再深入追文。

網址: https://github.com/OpenMOSS/Awesome-WAM

網址: https://openmoss.github.io/Awesome-WAM/

Categories: 開源, 世界模型

HERMESV2:把3D理解與未來預測合而為一的自駕世界模型

HERMES++試圖把場景理解與未來幾何生成放進同一套框架。對研究自駕感知與世界模型的人來說,這個方向很值得關注。

HERMES++ overview

HERMES++是一個面向自動駕駛的統一世界模型,核心目標不是只做未來場景生成,而是同時處理3D場景理解未來幾何預測。這點很關鍵,因為多數方法通常偏重其中一端,導致語意理解與物理演化之間仍有落差。

實際使用上,它比較適合拿來當研究型框架:先把多視角輸入整理成BEV表示,再讓模型在共享表示上同時回答當前場景理解任務,並推估未來幾何變化。若團隊正在做自駕感知、模擬預測或世界模型整合,這種設計能減少分散建模的成本。

這個專案最有意思的創新,在於把適合語意推理的資訊與幾何演化需求接起來。它透過BEV token承接多視角空間資訊,再加入LLM-enhanced world queriesCurrent-to-Future LinkJoint Geometric Optimization,讓目前場景語意能更自然地影響未來結構生成。

重點摘要如下:
– 以單一框架同時支援3D理解與未來點雲/幾何預測
– 使用BEV表示壓縮多視角輸入,保留較一致的空間結構
– 透過語言推理增強的world queries傳遞語意與世界知識
– 用幾何顯式與隱式約束提升未來場景結構一致性

若從應用場景來看,HERMES++最適合用在需要「理解現在、推演未來」的自駕研究,例如未來場景模擬、感知與預測聯合建模,或作為下游規劃系統的前端世界表徵。README與專案頁面顯示它在多個基準上有不錯表現,但若要評估實務部署價值,仍建議進一步確認推論成本、資料需求與特定任務設定。

如需特定模型,專案內容明確提到會結合大型語言模型(LLMs)進行語意知識轉移;不過實際採用的基礎模型細節,從目前提供資訊中不宜過度推定。整體而言,這不是入門型套件,而是一個相當有研究含量、試圖打通理解與生成邊界的自駕世界模型方案。

Source: https://github.com/H-EmbodVis/HERMESV2

Categories: 開源, 香港大學, 世界模型, 影像處理

iWorld-Bench:互動世界模型評測新基準

iWorld-Bench 針對互動世界模型建立統一評測框架,涵蓋動作控制、記憶與多場景能力。它也補上大型資料集與標準化測試不足的缺口。

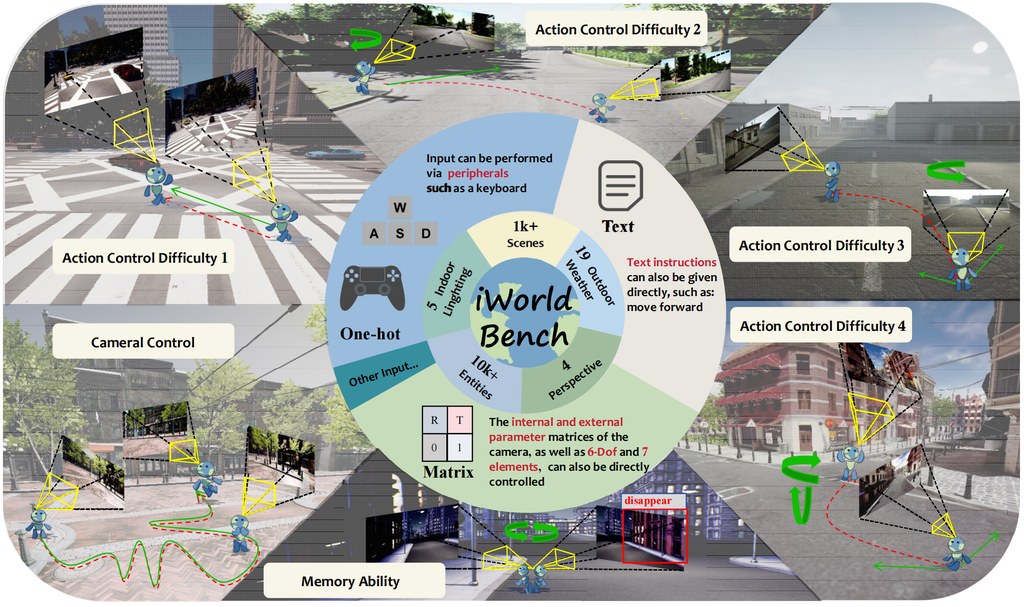
iWorld-Bench Overview

iWorld-Bench 是一個面向互動式世界模型的基準測試,目標是評估模型在外部動作序列驅動下的感知、推理與回應能力。網站資訊指出,它提供 33 萬段影片資料、4,900 個測試任務,以及 9 項綜合指標,用來觀察模型在距離感知、記憶與軌跡跟隨等面向的表現。

實際使用上,研究者可把不同類型的世界模型接到其統一的 Action Generation Framework,將多種輸入模態轉換為可比較的互動任務。這種做法特別適合訓練後評測、模型橫向比較,以及檢查模型在多視角、不同天氣與多場景條件下的穩定性。

這個專案的主要創新,在於把原本互動形式不一致的世界模型拉到同一套評估框架中,並設計六類任務統一測試。相較既有基準多偏向一般世界模型或操作策略評估,iWorld-Bench 強調多輸入、動作控制、鏡頭控制、記憶能力,以及跨場景與全天候適應性。

  • 提供 33 萬段影片與 4,900 個測試任務
  • 以統一動作生成框架比較不同互動世界模型
  • 評測重點涵蓋視覺生成、軌跡跟隨與記憶能力
  • 支援多模態輸入、多視角、多場景與全天候條件
  • 已用於評估 14 個具代表性的世界模型

從應用角度看,會受惠的工作包含具身 AI、機器人模擬、可控影片生成、自主代理訓練,以及需要互動式環境建模的研究。性能與評估方面,網站明確表示其以 9 項指標檢驗 14 個代表性模型,並指出現有方法仍有侷限;但由於論文、程式碼、資料集與排行榜尚未公開,部分細節仍需等待正式發布確認。

模型列表:文中僅提到共評估 14 個代表性世界模型,頁面內容未列出具體名稱。

Categories: 視覺模型, 世界模型, AGI

MultiWorld 可擴充的多代理、多視角視頻世界模型

探索 MultiWorld,一個可擴充的多代理、多視角視頻世界模型。適合從事人工智慧和機器人領域的研究人員和開發人員。

Screenshot

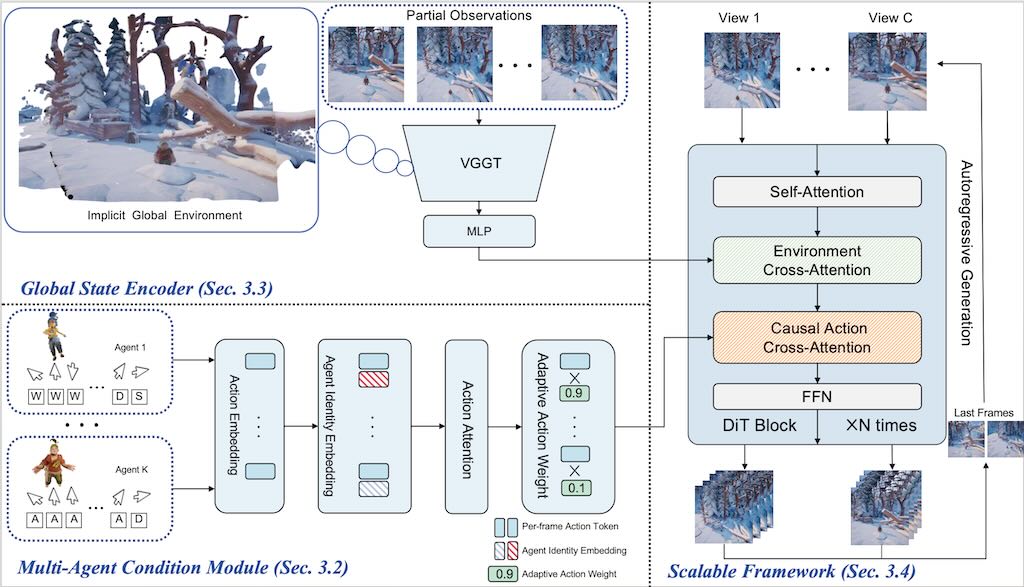
MultiWorld 在可擴充的多代理、多視角視頻世界模型的開發上代表了一個重要的進步。這個專案對於那些希望在複雜環境中模擬多個代理和視角的人工智慧和機器人領域的研究人員和開發人員特別有價值。在深入研究 MultiWorld 時,首先需要理解其基礎概念:建立一個虛擬世界,讓多個代理能夠同時從各種角度進行互動和學習。這種設定不僅增強了模擬的真實感,還提供了一個堅實的平台,用於在動態和不可預測的情境中測試和優化 AI 算法。

在實際應用中,MultiWorld 通過將先進的機器學習技術與複雜的模擬環境相結合來運作。該系統允許創建詳細的虛擬世界,每個代理可以從其獨特的視角感知環境,與其他代理互動,並從這些互動的結果中學習。這種方法對於需要高度情境意識和適應性決策的應用特別有益,例如自動駕駛汽車導航或複雜的機器人任務。然而,需要注意的是,這種系統的複雜性也帶來了某些權衡。例如,運行多個代理和視角的計算需求可能相當大,需要強大的硬體和高效的資源管理。

從 MultiWorld 中受益最大的研究人員和開發人員是那些從事需要深入了解多代理互動和多視角感知的專案的人。這包括人工智慧研究、機器人技術,甚至遊戲開發領域的專業人士,這些領域中真實和動態的環境是必不可少的。通過利用 MultiWorld,這些專業人士可以創建更準確的模擬,從而做出更明智的決策和創新。然而,實施時必須清楚了解專案的目標和模擬環境的具體需求。

在考慮將 MultiWorld 用於專案時,有幾個因素需要注意。首先,系統的複雜性意味著需要對底層的機器學習演算法和模擬環境有深入的了解。這可能需要額外的培訓或與這些領域的專家合作。其次,運行模擬所需的計算資源可能是相當大的,因此仔細規劃和優化是必不可少的。最後,雖然 MultiWorld 為模擬多代理、多視角場景提供了一個強大的工具,但重要的是要認識到其侷限性,並考慮這些侷限性可能如何影響專案的結果。通過仔細權衡這些考慮因素,開發人員和研究人員可以最大化 MultiWorld 的好處,同時最小化潛在的缺點。

對於那些希望在多代理系統和多視角模擬領域取得進展的人來說,MultiWorld 提供了一個令人信服的機會。儘管在理解和資源方面需要大量的投資,但在增強模擬能力和改進 AI 算法方面的潛在回報是巨大的。對於那些準備應對挑戰的人,MultiWorld 為人工智慧和機器人領域的創新和發現提供了一個強大的平台。

Source: https://github.com/CIntellifusion/MultiWorld

Categories: 開源, 香港大學, 世界模型

HY-World 2.0 世界的多模式世界模型

HY-World 2.0以其多模式方法革新了3D世界建模。適合開發人員和研究人員探索先進的3D資產創建。

HY-World-2.0 預告片
Tencent-Hunyuan/HY-World-2.0 在 GitHub 上

HY-World 2.0作為一個先鋒框架,使用各種輸入模式生成和重建3D世界。這個工具對於計算機視覺、圖形和AI領域的開發人員、研究人員和愛好者特別有價值,他們希望推動3D資產創建的邊界。該框架能夠接受如文本、單視圖圖像、多視圖圖像和視頻等輸入,使其極其靈活。用戶應首先專注於由WorldMirror 2.0驅動的世界重建功能,該功能可以高效地將多視圖圖像或視頻轉換為詳細的3D表示,包括網格和高斯濺射。

在實踐中,HY-World 2.0通過一個複雜的管道運行,其中包括全景生成、軌跡規劃、世界擴展和世界組成等階段。每個階段都建立在上一個階段之上,將簡單的輸入轉變為複雜、可導航的3D環境。例如,用戶可以上傳一系列城市景觀的照片,HY-World 2.0會重建該場景的詳細3D模型,包括紋理和光線效果。這種能力對於需要精確、可編輯3D模型的建築師、城市規劃師和遊戲開發人員尤其有益。

最能從HY-World 2.0中受益的個人和團隊是那些從事創建沉浸式體驗的人。遊戲開發人員可以利用該工具快速原型化新關卡,而電影製片人可能會用它來生成虛擬場景。此外,教育工作者和培訓師可以創建互動3D模擬以供培訓之用。然而,也有一些權衡需要考慮。雖然HY-World 2.0在生成高質量3D資產方面表現出色,但它需要大量的計算資源,特別是在處理大型數據集或高分辨率輸出時。用戶應確保擁有強大的硬件,理想情況下有多個GPU,以充分利用該框架的能力。

此外,當前的開源計劃表明,一些組件,如世界生成的完整推理代碼和特定模塊如HY-Pano 2.0和WorldStereo 2.0,仍在等待發布。早期採用者應做好準備,應對這些功能可用時可能出現的限制和更新。儘管有這些考慮,HY-World 2.0代表了3D世界建模的重大進步,提供了一個堅固的創新和創造平台。

使用HY-World 2.0時要記住的關鍵點包括:

  • 輸入模式的多樣性:該框架支持廣泛的輸入類型,使其適應各種使用案例。
  • 高品質輸出:生成的3D資產非常詳細,可以輕鬆集成到流行的遊戲引擎和設計軟件中。
  • 計算需求:確保有足夠的硬件資源來滿足處理要求。
  • 持續開發:跟蹤最新發布和改進,以充分發揮該框架的潛力。

總體而言,HY-World 2.0是一個強大的工具,它架起了想像與現實之間的橋樑,使用戶能夠創建持久、可編輯的3D世界,這些曾經只存在於理論中。

Source: https://github.com/Tencent-Hunyuan/HY-World-2.0

Categories: 開源, 騰訊, 世界模型, 中國

LingBot-world 高保真世界模型

LingBot-World 是一個專為交互式世界模型設計的開源框架。其核心 LingBot-World-Base 致力於提供高保真模擬與精准控制、且邏輯一致的模擬環境。該模型由一個可擴展數據引擎(Scalable Data Engine)驅動,通過從大規模遊戲環境中學習物理規律與因果關係,超越了傳統的被動式視頻合成,實現了與生成世界的交互。 LingBot-World 告別了隨機的“幻覺”式生成。它支持精細化的、由動作驅動的生成(action-conditioned generation),能夠精確響應用戶指令,渲染出高質量且符合物理真實感的動態場景。

LingBot-World 是一個專為交互式世界模型設計的開源框架。其核心 LingBot-World-Base 致力於提供高保真模擬與精准控制、且邏輯一致的模擬環境。該模型由一個可擴展數據引擎(Scalable Data Engine)驅動,通過從大規模遊戲環境中學習物理規律與因果關係,超越了傳統的被動式視頻合成,實現了與生成世界的交互。

LingBot-World 告別了隨機的“幻覺”式生成。它支持精細化的、由動作驅動的生成(action-conditioned generation),能夠精確響應用戶指令,渲染出高質量且符合物理真實感的動態場景。

Categories: 開源, 視頻模型, 世界模型

Page 8 of 9
1 6 7 8 9