Spatial Memory Intelligence:讓世界模型記住空間關係

長影片生成愈往後,舊畫面愈難整理,也容易出現空間前後不一致。SMI 以理解能力管理長期空間記憶,現時仍未公開程式碼與模型權重。

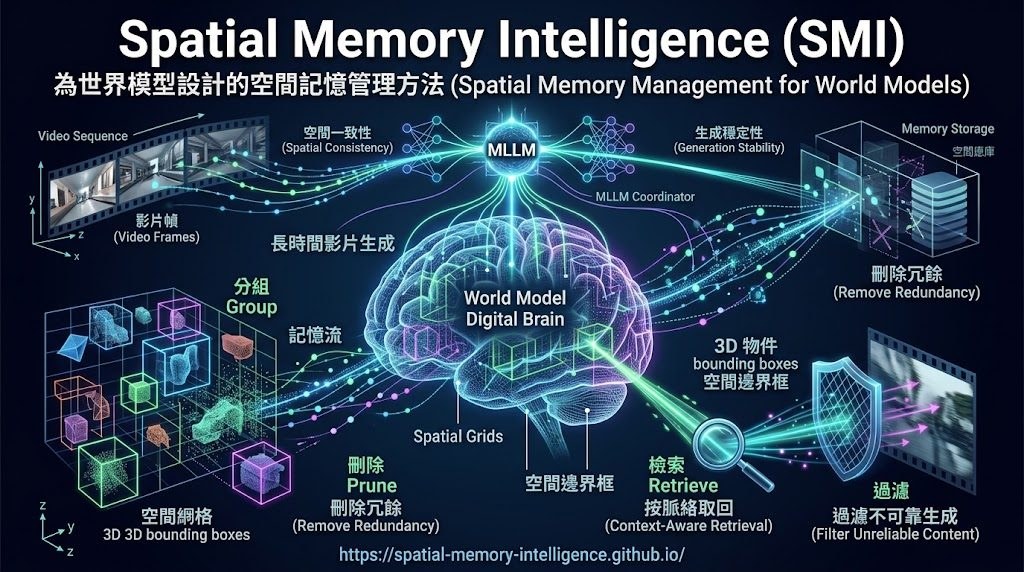
SMI overview: organizing spatial memory, retrieving relevant observations, and improving consistency and stability.

長影片生成要延續物件位置與場景結構,不能只靠不斷累積舊觀察;記憶太多會帶來冗餘,也可能把不可靠內容帶進後續生成。Spatial Memory Intelligence(SMI)是為世界模型設計的空間記憶管理方法,目標是改善記憶精簡度、空間一致性與生成穩定性。

SMI 以具語義與空間理解能力的多模態大型語言模型(MLLM)協調四項操作:把相關觀察分組、刪除群組內冗餘內容、按近期脈絡及下一步動作取回記憶,並過濾不可靠的生成觀察。它不只整理記憶,也會在生成過程中更新及提取資料,適合研究長時間影片生成與世界模型記憶管理的團隊。

項目網站提供 HY1.5 與 Wan2.2 的同步影片比較,主要對照 SMI 與 Base;部分案例亦列出 FramePack、Deep Forcing、MoC、VMem 及 MemFlow。紅框標示部分空間或結構不一致之處,方便檢視案例,但目前沒有公開可供核對的量化指標,不能單靠示範影片判斷改善幅度。

  • 記憶管理涵蓋分組、精簡、檢索與可靠性過濾。
  • 檢索會考慮近期上下文及下一個使用者動作。
  • 網站可觀看 HY1.5、Wan2.2 的影片比較。
  • 訓練、推理及評估程式碼、資料集與模型權重仍在準備發布。

目前 GitHub 儲存庫主要提供項目介紹與示意圖,尚未能據此安裝或自行重現結果。研究人員可以先查看網站示範及論文,待程式碼、資料集和權重公開後,再測試它能否在不同世界模型與長片段生成任務中維持空間一致性。
項目主頁 · GitHub

Categories: 開源, 香港中文大學, 南京大學, 阿里巴巴, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Video, 香港, 庫, Dataset 數據集

HelixWorld 即時生成互動視聽世界

輸入一張圖片和提示詞,再用方向指令探索場景,HelixWorld 會同步更新畫面與空間聲音。預覽版已提供瀏覽器示範及離線推理程式碼,但硬件門檻不低。

HelixWorld — Sound and vision, born together

轉身時,聲音方向也會跟着視角改變,這是 HelixWorld 與一般先生成畫面、再配上音軌的做法不同之處。它是 Noiz AI 開發的即時互動視聽世界模型,讓使用者從一張圖片和提示詞出發,以方向指令在生成場景中移動,並同步產生影像與聲音。

瀏覽器示範適合先感受互動效果;想離線測試,則可使用已公開的 Preview v1 推理程式碼和預覽模型。它目前支援 Linux、Python 3.11 和 CUDA 12.x,建議使用配備 80 GB VRAM 的 NVIDIA GPU;BF16 單卡測試約需 70 GB VRAM,對個人電腦使用者而言是明顯門檻。

操作時可輸入前進、轉向或停止等動作,並設定第一人稱視角及生成影格數;提示詞亦可分別描述影片、音訊或視聽內容。輸出會整理成 MP4,適合研究人員、互動內容創作者及想探索空間音效生成的團隊測試,但目前公開資訊未提供性能評測數據,亦未公開完整模型與訓練資料。

  • 畫面和聲音會隨鏡頭移動同步更新,空間聲場跟隨視點改變。
  • 可先用瀏覽器示範體驗,也可在符合硬件條件的 Linux 系統離線推理。
  • 預覽版已開放,完整模型、訓練資訊及報告仍待公開。

HelixWorld 展示了視聽生成從固定片段走向可操控場景的一種做法;不過,現階段的高顯示記憶體需求和有限評測資訊,令它較適合研究與原型測試。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, NVIDIA, Video, Image, Audio, 提示詞, Content Creator, Linux, Python

4Director:3D 幾何精準控制影片世界模型

4Director 將鏡頭、物件與新加入的物件放進同一個 3D 空間,改善影片生成中動作失控和視角不一致的問題。

4Director

想令影片中的鏡頭、原有物件和新加入的物件按指定路徑移動,4Director 提供了一個較接近 3D 動畫製作的控制方式。它屬於影片世界模型,處理的是生成影片時深度、旋轉和跨視角一致性難以同時維持的問題。

系統會先為每件物件重建一個 canonical mesh,再以每幀一組 rigid transformation 推動物件,並把整個場景渲染成深度影片。Motion Adapter 之後將這份幾何骨架轉換成具備外觀、光照和非剛性動態的影片;新物件則可透過參考影像插入場景,並與鏡頭及原有物件共同控制。

相較只控制鏡頭、依賴 image-plane cues,或使用 3D tracks、blobs 的方法,完整網格能保留物件未被鏡頭看見的幾何,減少物件離開畫面後再出現時形狀和身份改變的情況。影片生成研究、視覺特效預演,以及需要精確安排物件運動的製作團隊較容易受益,但重建網格和建立剛性軌跡亦增加了準備工作。

  • RealCOD-Rigid 提供 20,774 段附有剛性 3D 場景標註的影片片段。
  • Identity-Gated IoU(IG-IoU)同時衡量物件動作是否跟隨指令,以及物件身份能否保持。
  • 實驗報告指 4Director 在畫質、鏡頭控制和物件控制方面優於多種先前方法。

4Director 目前更適合作為研究原型和可控影片生成的實驗基礎,而非即裝即用的剪片工具。理解其效果時,應同時檢查生成畫面的外觀品質、指定軌跡的遵循程度,以及物件離開後重新出現時的身份一致性。

項目主頁 · GitHub

Categories: 開源, AI productions, 世界模型, Video, 工具, 3D, 動畫

Physis-Lang 讓影片模型理解物理因果

影片畫面看似合理,動態卻可能違反物理規律。Physis-Lang 以可演化的物理語言,改善影片資料整理、訓練與生成。

Physis

當影片模型能生成融化中的牛油,卻未必理解升溫、重力與形變之間的關係,Physis-Lang 便嘗試補上這個落差。這個由 NVIDIA、MIT 與 University of Oxford 研究團隊提出的 Video World Model 研究項目,把物理因果、相互作用、支配原理與結果寫進共享語言表示,協助模型生成更合理的世界演化過程。

Physis-Lang 不只描述畫面發生了甚麼,還要求字幕交代事情為何發生。例如牛油融化的描述會進一步指出升高的溫度提供熱力,熱力促成融化,而重力令牛油向下塌成淺層液體。物理概念會經由 Physics-aware critic 找出遺漏或缺乏視覺證據的說法,再由 agent 修訂共同的 captioning guidelines,captioner 本身則維持不變。

整套方法連接資料整理、模型訓練與推理:模型失敗會轉化成物理領域查詢,再透過 language-guided retrieval 找出能補足缺口、而且視覺內容多樣的影片;演化後的語言會重新製作訓練字幕,並擴展 inference prompts,同時加入針對場景的 negative descriptions,減少不合理動態。

  • PhysCapBench 收錄 246 段經審核的物理影片及 3,794 個人工驗證 assertions
  • 評估字幕對物理細節的 precision、recall 與 F1
  • Physis-Lang · Cosmos3-Super 在 Physics-IQ 公開排行榜列第一,平均分數為 48.2 ± 1.4
  • Physis-Lang · Cosmos3-Nano 列第二,平均分數為 43.3 ± 1.5

這項研究適合關注 Video World Models、物理推理和影片生成可靠性的讀者。排行榜結果顯示,加入可演化的物理語言後,Cosmos3 系列模型在相關評測中取得進展,但分數只反映指定基準,並不代表所有影片場景都能避免物理錯誤。

項目主頁

Categories: Agentic, 世界模型, 模型訓練, NVIDIA, Video, 框架

WorldLine 讓機械人先看見動作後果

WorldLine 把機械人動作轉成影像及空間訊號,預測場景如何變化,再協助評估策略及規劃操作。

Repository image for Zhengsh123/WorldLine

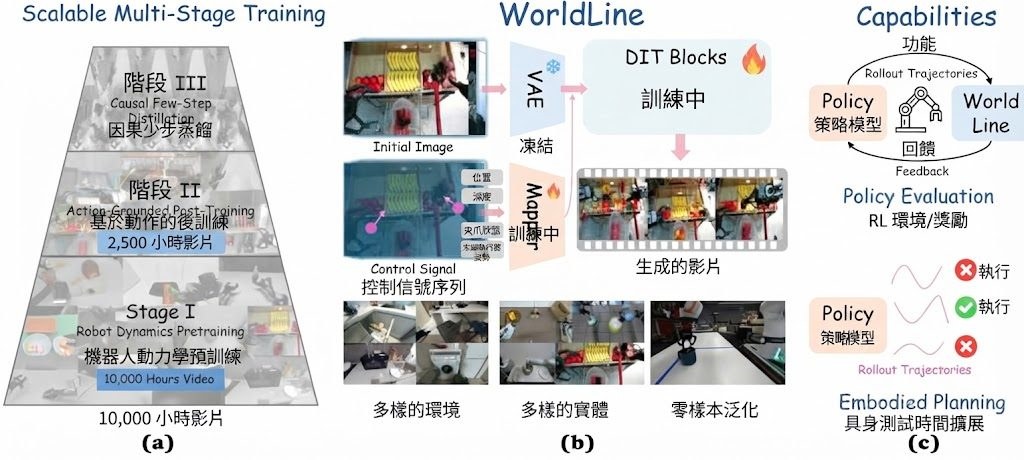
機械人要搬動物件前,WorldLine 可以先在視覺模擬中預測動作會如何改變場景,減少每次都依賴實體試錯。它屬於面向機械人操作的世界模型及視覺模擬器,處理的是「控制指令如何造成可觀察結果」這個核心問題,而不是按照任務文字生成畫面。

WorldLine 先用超過10,000小時的無動作標註機械人影片學習機械人與物件的互動,再把末端執行器的位置、深度、方向及夾爪狀態投影到經校準的相機視角。這些 image-space actions 成為不同機械人之間的共同介面;另外超過2,000小時、涵蓋10多種 embodiments 的動作軌跡,負責把通用 dynamics 對應到個別控制方式。

WorldLine 把 action grounding 分開處理,較有利於跨機械人及跨鏡頭遷移,代價是需要校準相機、動作軌跡及失敗案例。模型以 block-autoregressive 方式因果 rollout,每個區塊用四步 denoising 生成,兼顧互動速度與預測細節,但不代表能取代真實環境驗證。

  • 用於 policy evaluation、embodied planning 及實體操作前的預測
  • 以 image-space action 統一不同機械人的視覺控制介面
  • 透過 multi-view、failure-enriched training 及 relational regularization 強化互動敏感度
  • 以 few-step distillation 減少 rollout 所需計算

研究團隊包括香港科技大學、Joy Future Academy、北京大學及香港中文大學。較適合研究機械人學習、視覺規劃及模擬器的團隊先按程式碼建立推理環境,再以不同 camera view、embodiment 和失敗動作測試預測穩定性;需要即時控制的人員則應同時量度延遲、動作偏差及真實機械人的遷移落差。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港科技大學, 北京大學, AI productions, 模型, 視覺模型, 世界模型, 模型訓練, Video, Image, 香港, Dataset 數據集

WorldPlay2 即時控制互動世界模型

WorldPlay2嘗試令世界模型在多樣場景中持續演化,同時保留即時反應與細緻控制,代價是系統仍未準備好供外部重現。

Repository image for WorldPlay2/WorldPlay2

想令場景隨鏡頭、角色動作和語意事件持續發展,世界模型往往要在即時反應、控制彈性與長時段一致性之間取捨。WorldPlay2 屬於互動世界模型,處理的正是這個矛盾:它可以跨越不同場景與角色生成連貫內容,並回應多種控制訊號。

模型把控制拆成兩層:一層是與影格對齊的連續動作,例如相機俯仰;另一層是結構化語意控制,分開處理場景外觀、角色身份和動態語意事件。這樣做比只依賴單一動作介面更容易表達複合指令,但亦令控制學習和資料整理更複雜。

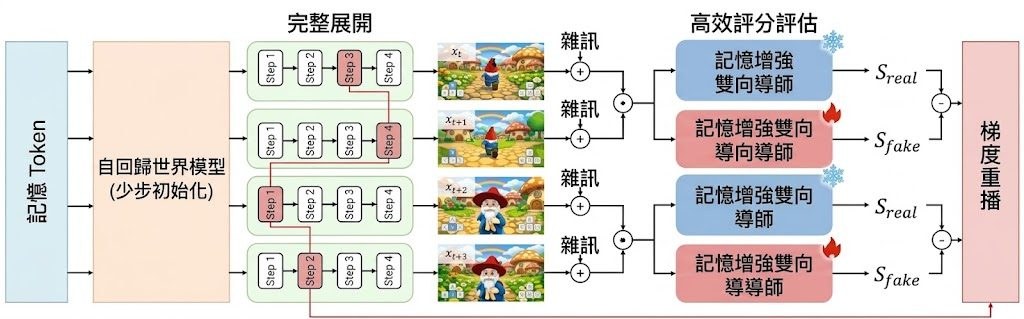
長時段生成由壓縮記憶和 Stable Forcing 支撐。歷史影格會被壓成緊湊的 memory tokens,供自回歸 student 與雙向 teacher 共用,蒸餾時改以分片、受記憶條件約束的分數評估,避免每次都處理整段 rollout;Stable Forcing 則先以少步策略初始化 student,再透過完整 rollout replay 維持長序列品質。

  • 可跨多樣場景與角色保持較長時間的一致性
  • 同時支援影格對齊動作與結構化語意控制
  • 以壓縮記憶降低長時段蒸餾開銷
  • 實驗聲稱整體表現優於既有方法,但未提供可核對的詳細指標

研究者、互動遊戲原型團隊和需要可控視頻生成的開發者較容易從中受益,尤其適合研究鏡頭控制、角色持續性及長期世界演化。儲存庫仍在整理程式碼與權重,README 沒有提供安裝、下載或測試流程,現階段較適合先觀看展示影片和研究方法;正式重現仍要等待相關檔案公開。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 世界模型, Video, 庫

object-permanence:讓世界模型學識記住被遮擋嘅物件

透過 150 個 Blender 任務同 150 萬條訓練樣本,訓練一個 16B 世界模型喺物件被遮擋時仍能保持記憶,處理視頻生成中常見嘅「物件消失」問題。

Training Object Permanence in World Models

當一件物件被屏幕或牆壁擋住再出現時,現時嘅世界模型往往會「忘記」佢原本嘅樣貌同位置。PWM-WROP 正正針對呢個限制:佢係一個基於 NVIDIA Cosmos3-Nano 微調嘅 16B 多模態世界模型(Multimodal World Model),專門訓練物件永續性(object permanence)——即係物件即使被遮擋都要喺內部表示中保留落去。

訓練數據嚟自一個 Blender 渲染嘅數據工廠,包含 150 個任務生成器,涵蓋六大認知家族,例如 turntable_behind_screen_task 等。每個樣本會輸出五件檔案:input_video、target_video、prompt、trajectory.npz 同 metadata.json,方便用嚟做 video-to-video 監督學習。整個訓練用原生 PyTorch(避免 XLA graph tracing)喺 AWS Trainium2 上跑,透過 tensor parallel × FSDP2 跨 64 個 NeuronCore。

對於從事物理推理、機器人模擬或影片生成嘅團隊呢個項目特別有用——佢直接提供可生成嘅訓練數據、預訓練權重(BF16,約 15B 參數)同 benchmark(WROP 300 題),減少由零建立物件永續性測試嘅成本。Hugging Face 上面已有模型。

重點摘要:

  • 數據規模:150 個 Blender 任務生成器,每個 20 條樣本,合共約 150 萬條 video-to-video 訓練數據
  • 模型規模:PWM-WROP 為 16B 參數(FP16 約 15B),基於 Cosmos3-Nano 微調
  • 硬件要求:訓練需要 AWS Trainium2(trn2.48xlarge,64 NeuronCore),推論則視乎部署方式
  • 授權限制:採用 CC BY-NC 4.0,僅限非商業使用,商用需另行聯絡作者
  • 生態整合:配搭 WROP 300 題 benchmark,可以量化唔同影片模型嘅物件永續性表現

同一般只做外觀預測嘅世界模型相比,PWM-WROP 強調「被遮擋都要記得」,並透過軌跡數據(trajectory.npz)提供逐幀 ground truth 做監督,對於需要物件級別一致性嘅應用場景(例如機械臂操作預演、視頻預測品質提升)會有明顯幫助。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 多模態模型, 視頻模型, 世界模型, NVIDIA, Video, Python, Dataset 數據集

InternW0 讓機械人邊預測未來邊靈活操控

面對接觸、受力和環境變化,InternW0把未來視覺預測與連續動作控制結合,提升機械人完成操作任務的穩定性。

Shanghai Artificial Intelligence Laboratory

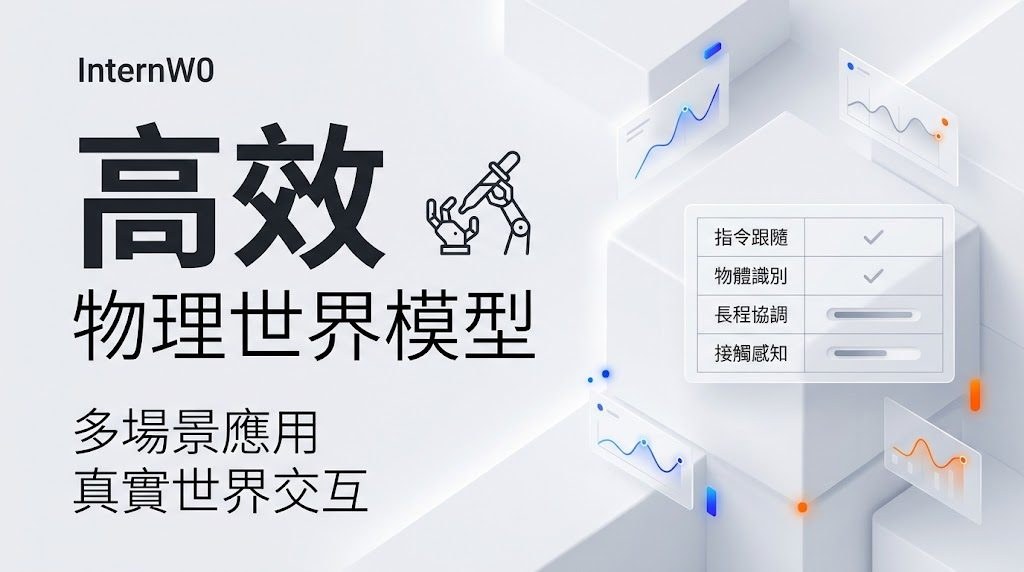
機械人處理實驗室器具、液體轉移或其他需要接觸感知的工作時,往往要同時理解下一刻會見到甚麼,以及當下應該施加甚麼動作。InternW0屬於 Physical World Model,透過非對稱 video–action 架構,把未來視覺預測與連續控制放進同一套流程。

它採用 mixture-of-transformers backbone,由高容量 video expert 預測較長時間範圍的視覺變化,再由較輕量的 action expert 根據最新觀察調整動作。Observation-conditioned context routing 會隨視覺和物理回饋更新上下文;force 與 tactile channels 則在 contact-aware post-training 中加入,協助處理接觸場景。

訓練部分以 joint video–action flow matching 學習未來動態與控制策略,Wan VAE 負責影片編碼,DINOv3 encoder 提供當前視覺觀察。七個數據集合共提供 7,233.5 小時資料,涵蓋真實機械人軌跡、模擬操作,以及 EgoLab 的實驗室第一身影片。

  • LIBERO 四個任務套件平均成功率達 98.6%
  • RoboTwin 2.0-Full 平均成功率為 93.12%
  • Clean2Random 平均成功率為 75.60%
  • RTX 5090D 上每次動作更新需時 60.73 毫秒,模型端策略更新率為 16.47 Hz

InternW0較適合需要長程預測、即時反應和接觸控制的機械人研究與實驗室工作流。資料未有提供完整安裝或下載使用流程,讀者應按官方提供的 Paper、GitHub、Hugging Face 或 ModelScope 資源確認可用版本與存取方式。

項目主頁

Categories: 開源, 上海人工智慧實驗室, 模型, 世界模型, 模型訓練, Video, Robotic, Dataset 數據集

WorldCrafter 記住你走過的世界

WorldCrafter把單張圖片或文字提示變成可操控鏡頭的連續場景,改善長時間探索時畫面失憶與視角不一致的問題。

鏡頭移開再回望時,生成場景仍能維持空間關係,正是 WorldCrafter 要處理的核心卡位。它屬於影片世界模型,能從單張圖片或文字提示建立可探索場景,並按照鏡頭控制生成後續畫面,減少長時間移動、回訪視角時的內容漂移。

WorldCrafter以可由鏡頭查詢的隱式 3D-aware memory 保存過往觀察,讓指定視角決定哪些歷史資訊交給影片生成器;記憶編碼器與姿態條件讀取模組會把不同視角的資料整理成目標視角適用的 memory tokens。它不依賴顯式深度估計或幾何 warping,近期 temporal context則負責維持動態物件和連續動作。

WorldCrafter Video Demo

提供 WorldCrafter-Base,以及經蒸餾、面向較快推理的 WorldCrafter-Fast。兩者可在 Linux、Python 3.11、NVIDIA GPU 和相容 CUDA 驅動環境運行,模型權重放在 Hugging Face;Fast 版本較適合互動式串流,但硬件要求和生成速度仍取決於本地配置。

  • 支援圖片轉可探索世界,也支援文字轉可探索世界
  • 可控制鏡頭、揭示未見區域,並回到曾經觀察的視角
  • 設計同時兼顧靜態場景、動態場景和長時間探索
  • 評測涵蓋145個場景及725條鏡頭軌跡

評測中,WorldCrafter在長時間回訪一致性和鏡頭控制準確度上優於參與比較的基線,整體 VBench 分數亦最高;項目展示的點雲與鏡頭軌跡重建,則用來檢查生成影片的幾何連貫性。研究團隊來自 Tencent ARC Lab 與北京大學,較適合研究生成式世界模型、可控影片、虛擬場景探索及互動內容的團隊測試。

項目主頁 · GitHub · 模型

Categories: 開源, 北京大學, 騰訊, AI productions, 模型, 世界模型, NVIDIA, Video, Image, 3D, Linux, Dataset 數據集

XGEN-JING 世界模型開源:邊走邊生成影片與音效

XGEN Labs 把互動式第一人稱世界模型 JING 開源:輸入動作與參考圖,就能邊走邊生成對應影片與環境音效,等於把世界模型變成可即時體驗的 demo。

過往的世界模型 demo 多半停留在「按一個鍵播一段片」,XGEN-JING 想把互動感再推一步:鍵盤操作鏡頭、輸入文字引導角色對話,模型即時生成第一人稱影片與配對音訊,並以參考圖約束人物、物件與場景的一致性。這個項目是一個以 MiniMax-H3 為骨幹的 egocentric interactive experience 模型,屬於世界模型 / 互動影片生成一類,目標是讓「在同一個起點做出不同選擇」這件事變得可視聽。

XGEN-JING 的核心差異在「四步雙向推論」與即時性:JING-Flash-v1 用四個步驟完成推論,再把動作、觀察歷史、參考圖同時餵進去生成下一段片段;鏡頭移動、物件互動、人物對話都由文字與按鍵驅動,而畫面與聲音同步輸出,所以更像「邊走邊生成」而不是「先想好再剪片」。

Step Into a World That Responds | XGEN Labs

這版本同時提供 Inference code、examples 與 Prompt skills,後者可以從故事與參考圖自動生成經過驗證的推論案例,降低試錯成本;但因果模型與技術報告尚未釋出,想深入架構細節的人需要再等等。硬件門檻亦偏高:項目方以六張 H100 做驗證,其中一張跑 text encoder、一張跑影音 VAEs、四張跑 DiT 加 sequence parallelism,並指定 FlashAttention-4 為預設後端。

以下幾類人會比較快從中受惠:做世界模型研究、需要互動 demo 的研究者;做遊戲 / VR / 沉浸式敘事、需要快速產出第一人稱體驗的開發者;以及關心 video generation xa in 2026 路徑、想理解「影片 + 音訊 + 動作」三軸如何耦合的團隊。對一般玩家或創作者而言,Hugging Face 上的模型頁與 xgenlabs.ai gallery 已足夠先看 demo,再決定是否投入本地部署。

重點摘要

  • JING 是以 MiniMax-H3 為基礎的第一人稱互動體驗模型,支援鍵盤控鏡、文字對話與參考圖約束。
  • JING-Flash-v1 以四步雙向推論同時生成影片與音效,比單向生成更貼近即時體驗。
  • 官方硬件門檻為六張 H100(1 text encoder + 1 VAEs + 4 DiT),預設 FlashAttention-4,後端依賴 SGLang 特定 commit。
  • Prompt skills 可從故事與參考圖自動產生驗證過的推論案例,方便快速試玩法。

項目主頁 · GitHub · 模型 · 影片集

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Google, NVIDIA, Video, Audio, Content Creator, MiniMax, Skill 技能

Page 3 of 12
1 2 3 4 5 … 12