LensVLM 用壓縮頁面減少長文閱讀成本

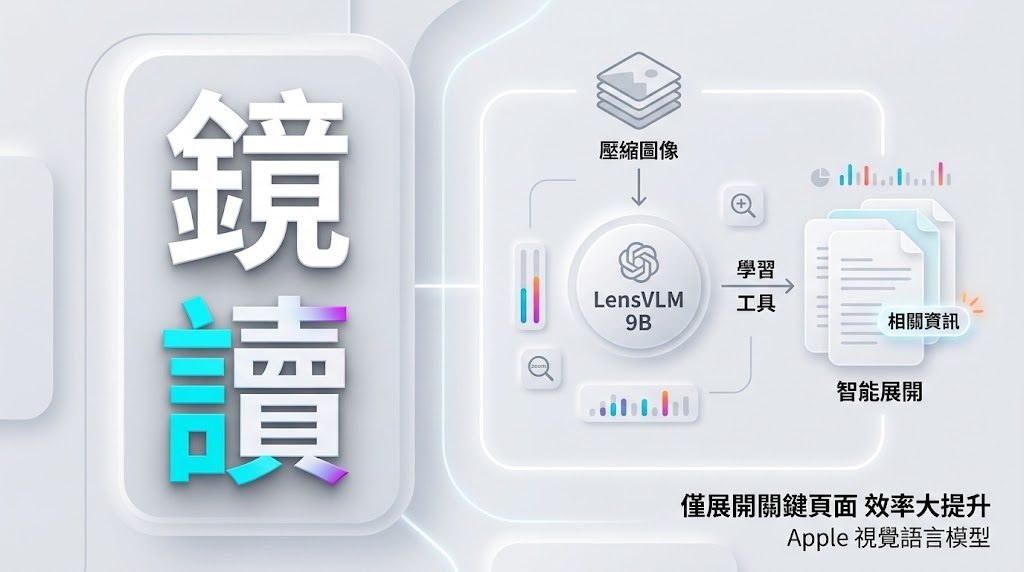
LensVLM先掃描低成本頁面圖,再只讀取與問題相關的完整頁面,將長文件問答的視覺輸入壓縮成按需取用。

Repository image for apple-aiml-research/ml-lensvlm

面對多頁文件問答,LensVLM不必一開始把每頁完整內容送入模型,而是先以壓縮頁面圖定位線索,再讀取相關頁面的全文。這個項目屬於多模態 Vision Language Model(VLM),實際處理的是長文件輸入過大、文字內容難以一次放入上下文的問題。

LensVLM是經微調的 Qwen3.5-9B,配合學習得到的 read_page 工具,讓模型在掃描頁面縮圖後按需擴展內容。示範包括模型檢查15頁文件,只讀取第10頁,經兩輪互動便由人物資料連結到答案;壓縮比例可選5x、10x或15x,取捨是壓縮越高,初步掃描成本較低,但頁面細節亦可能減少。

  • 先處理壓縮頁面圖,再按問題讀取完整頁面
  • 支援自訂文字文件及 HuggingFace 評估數據準備
  • 輸出頁面圖與結果檔案,方便檢查推理軌跡
  • 適合長報告、資料集問答及文件檢索測試

項目提供 requirements 安裝方式、示範流程及自訂文件參數,結果會寫入指定輸出目錄;原始資料沒有交代硬件要求、推理速度或記憶體消耗。提供的示例能說明工作流程,但未有完整準確率、延遲或與其他長文件 VLM 的量化比較,因此較適合作為研究原型和評估基礎,而非已證實在所有文件類型上都更快或更準的方案。

需要處理大量頁面、又希望控制視覺 token 成本的研究者和工程團隊,較容易從這種按需展開機制受益。文件版面複雜、關鍵答案分散,或問題需要跨頁整合時,仍要留意壓縮圖能否保留足夠線索,以及 read_page 讀取到的文字是否完整。
GitHub · 模型

Categories: 開源, 視覺模型, Qwen, 蘋果

Ming-Image 把設計圖拆成可編輯圖層

Ming-Image 同時處理視覺設計生成與圖層還原,令 UI、海報和簡報內容更容易交由代理程式接手修改。

Ming-Image-0.1-Design on the Artificial Analysis UI/UX Design leaderboard

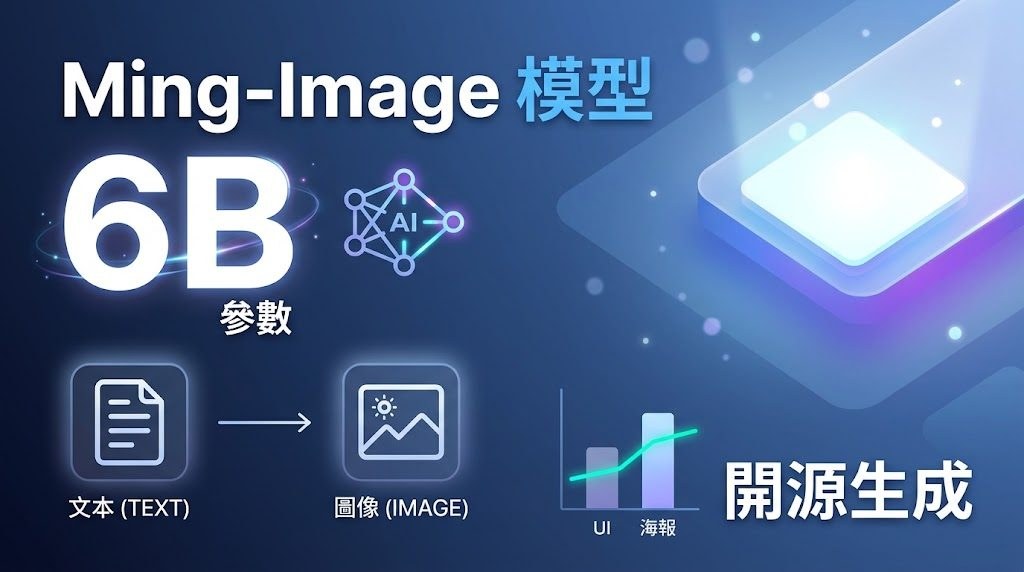
由文字生成完整 UI、資訊圖表、海報,再把扁平化圖片拆回透明可編輯圖層,Ming-Image 0.1 Design 系列處理的是設計稿難以延續修改的問題。它屬於視覺設計生成模型系列,實際用途是協助代理程式建立、檢查和重組圖像內容,而不只產生一張不可拆分的圖片。

系列包括兩個 6B 參數模型,Ming-Image-0.1-Design 負責生成文字密集的完整視覺構圖,Ming-Image-0.1-Design-Layer 則把成品分解成獨立、透明背景的圖層。後者支援將文字和簡單形狀抽出,配合 Image to Editable PPT 工作流程,把一頁設計或簡報圖片重建成可編輯 PowerPoint 元素;Ling UI Design 工作流程則利用生成參考圖和圖層分解,協助代理程式編寫及視覺檢查 UI 程式碼。

模型支援 RGBA 輸出,透明背景生成需使用指定的 RGBA 提示語。公開模型卡列出 1024 或 2048 解析度、12 sampling steps、CFG scale 1.0 及 BF16 等建議設定;2048 x 2048 生成在一張具備 80 GiB VRAM 的 CUDA GPU 上驗證,較適合有圖形運算資源的設計團隊,而非一般辦公室電腦即時使用。

Ming-Image-0.1-Design GGUFs | LOW VRAM Workflow
  • 生成 UI、資訊圖表、海報及其他文字密集設計
  • 將扁平圖片拆成獨立透明圖層
  • 可支援 UI 程式碼視覺檢查及可編輯 PPT 重建
  • 需要 Python 3.10+、CUDA-capable PyTorch 和模型 checkpoint

完整推理仍需按 companion Ming-Image 項目的依賴和模型服務配置處理。適合需要從參考圖快速建立設計草稿、處理透明素材,或把 AI 生成結果交回設計工具繼續修改的團隊;對只有一般 GPU 資源的使用者,VRAM 要求會是主要限制。

GitHub · 模型

Categories: 開源, 模型, Qwen, NVIDIA, Image, 工具, Python, UI/UX

Confucius4-T3PO:14B 即時翻譯模型,邊聽邊譯並兼顧延遲

逐段輸入文字後,模型以 AI 判斷何時繼續等候、何時輸出譯文,減少即時翻譯必須在速度與語境之間二選一的情況。

Confucius4-T3PO

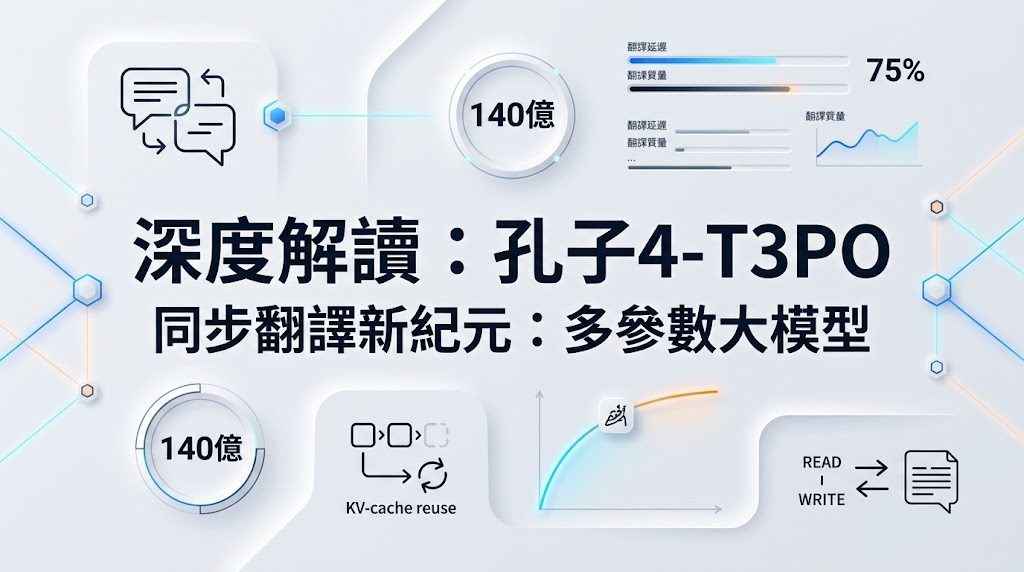
會議口譯或直播字幕需要盡快顯示譯文,但太早翻譯又可能欠缺上下文。Confucius4-T3PO 是一款 140 億參數的文字即時翻譯模型,接收細粒度文字片段後,會決定繼續等候還是輸出部分譯文,支援中英互譯。

它以 READ/WRITE 決策控制等待與輸出,並提供不同延遲模式,讓使用者按即時性需要調整速度與翻譯質素的取捨。已提交的譯文只會逐段追加,不會回頭改寫;交錯式歷史紀錄亦可重用 KV cache,減少重複計算。模型以 Qwen2.5-14B 為基礎,經串流翻譯冷啟動及 Pareto-aware 強化學習,兼顧翻譯質素與延遲。

模型本身只處理文字,並不原生接收語音。語音翻譯需要串接串流自動語音辨識(ASR);項目另有 R2T2 ASR 模型,可組成語音轉文字翻譯流程。推理介面包括逐段文字翻譯 API,以及接收 16 kHz 單聲道 PCM16LE 音訊的 WebSocket 串流示範。

  • 適合需要逐步顯示字幕或翻譯結果的串流應用及口譯流程。
  • 可按低、原生或高延遲模式調整輸出節奏;延遲與翻譯質素需要取捨。
  • API 可查詢分段統計及 WAIT/TRANS 統計,方便觀察單次工作階段的決策情況。
  • 儲存庫提供推理程式碼,並連結模型頁及線上示範;所列資訊未提供硬件需求或效能基準,正式部署前宜先測試目標語言、音訊流程及延遲。

對字幕平台、遠端會議及串流口譯團隊而言,逐段輸出有助減少等待完整句子才見到譯文的落差;但語音流程仍依賴外部 ASR,部署成本亦會受 14B 模型及推理環境影響。

GitHub · 模型

Categories: 開源, 模型, Qwen, API, Audio, 語音

Qwen-Image 2.1 四步生成加速,但複雜編輯仍未完善

Viggle 將 Qwen-Image 2.1 蒸餾至四步生成,換來速度提升,同時保留編輯能力上的取捨。

Og image

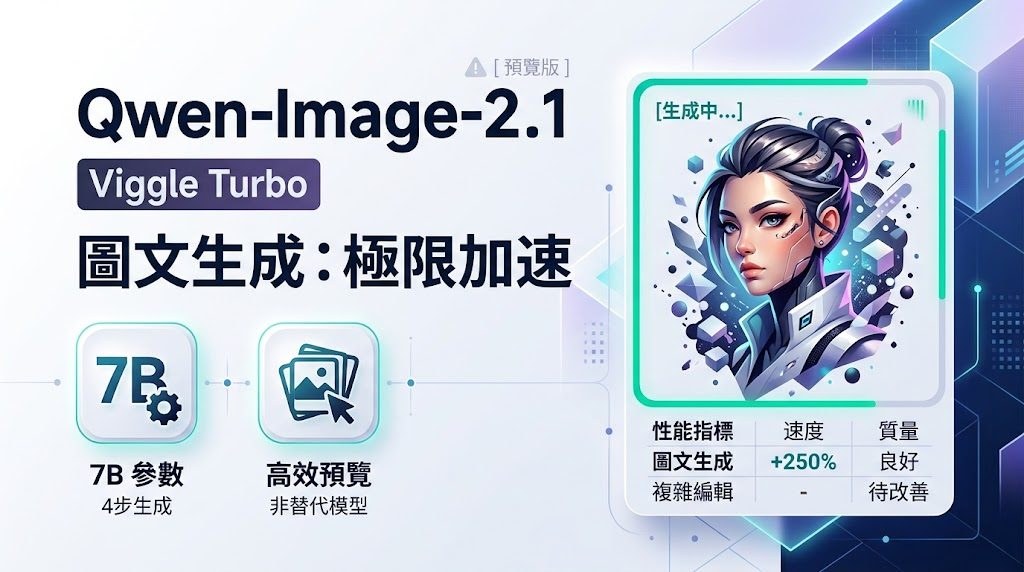
面對需要較快出圖、又要按文字指示修改圖片的場景,Qwen-Image-2.1-viggle-turbo 把原始 Qwen/Qwen-Image-2.1 由 40 次 Transformer passes 壓縮至 4 次,支援 text-to-image 及 image-to-image 編輯,亦可配合 1 至 3 張參考圖。模型屬於基於 Qwen/Qwen-Image-2.1 的 adapter 項目,由 Viggle 使用 Distribution Matching Distillation(DMD)訓練,並取消 classifier-free guidance。

項目提供兩個學生模型,取捨集中在下載體積與編輯精準度:

  • transformer/:完整微調的 bf16 Transformer,約 14.2 GB,會取代基礎 Transformer;頁面目前推薦這個版本,質性比較中編輯更忠實。
  • Qwen-Image-2.1-viggle-turbo-4step-lora-r64.safetensors:rank 64、約 340 MB 的 LoRA adapter,載入基礎 Transformer 後運行,下載較快但效果稍弱。
  • peft/:同一 LoRA 的 PEFT key format、F32 權重;LoRA 不會合併入 Transformer,運行時載入可避免 bf16 合併造成的損失。
  • text encoder、VAE 及 processor 沒有隨項目重新發布,會從基礎模型儲存庫載入。

完整微調版本的 DMD objective 加入 low-frequency teacher anchor,兩個版本都是各自訓練流程的 step-400 EMA checkpoint。Text-to-image 在四步下已具可用性,但 v0.1 仍是 preview;多參考圖合成、換臉、保留身份,以及同時包含多項限制的指令,明顯不及原本 40 步的 base model,因此不能視為完整替代品。

因為 QwenImage21Pipeline 尚未納入已發布的 diffusers;同時要安裝 peft、PyTorch、Transformers、Accelerate、Safetensors 及 Pillow。提供內容沒有 GGUF 檔案、GGUF 檔案大小、量化級別、mmproj、上下文長度、Ollama、LM Studio 或 llama.cpp 支援資料,亦沒有 MTP draft speculation 或正式 benchmark 數字;硬件需求只能按完整 Transformer 約 14.2 GB bf16 權重另行規劃。

模型

Categories: Qwen, Image, 影像模型, 影像處理, txt2img, Python, 庫, Dataset 數據集, LoRA

ImIR 免提示詞處理六類影像修復,

ImIR 讓同一個影像修復模型自行判斷輸入問題,毋須提示詞或降級標籤,涵蓋六種常見修復工作。

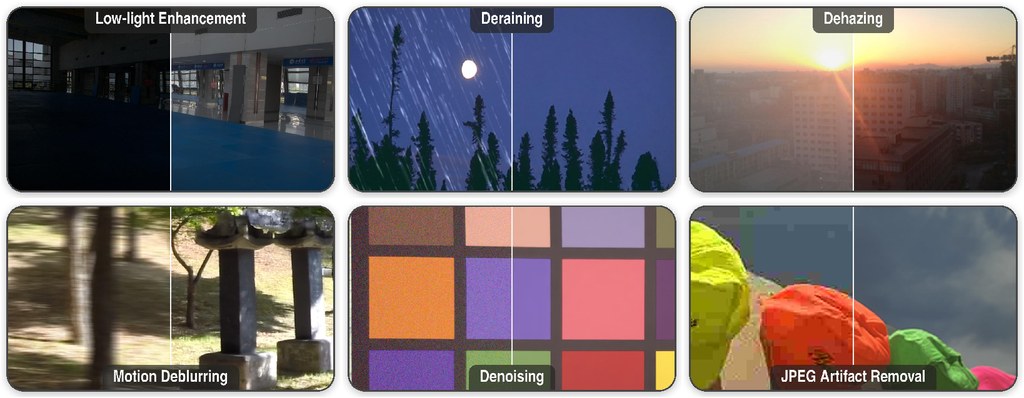
ImIR examples for low-light enhancement, deraining, dehazing, deblurring, denoising, and JPEG artifact removal. Each til

遇到低光、雨痕、霧化或 JPEG 壓縮痕跡時,ImIR 會只從輸入影像推算修復指令,不要求使用者先判斷問題類型。這個項目屬於影像修復模型與推理工具,實際處理的是一個模型難以同時應付多種退化、又依賴文字提示詞的工作流程。

ImIR 把影像分成兩條路徑送入 Qwen-Image-Edit-2511:VAE 保留空間結構,Qwen2.5-VL 配合輕量 token mapper 產生接近乾淨影像的語義指令;主幹模型保持凍結,只訓練一個共享 LoRA adapter。指令強度可以調節,低光增強等答案不唯一的任務,因而能在不同修復程度之間取捨。

項目提供 CLI 和 Python API,使用 Python 3.10 或更新版本、具 CUDA 能力的 NVIDIA GPU,並可從 Hugging Face 自動下載 checkpoint。顯存不足時可啟用 CPU offload,但需要足夠系統記憶體。

  • 一個 adapter 覆蓋除雨、低光增強、去霧、去模糊、去噪及 JPEG 瑕疵移除
  • 不需要文字提示詞,也不需要 degradation label
  • 單一 adapter 約三小時、以一張 GPU 完成訓練
  • 匹配比較中,影像指令優於文字 conditioning

對研究人員而言,這種做法適合測試 task-agnostic restoration;影像處理團隊則可用它簡化多任務推理流程。不過項目需要 NVIDIA CUDA 硬件。

項目主頁 · GitHub · 模型

Categories: 開源, Qwen, NVIDIA, Image, 影像模型, 影像處理, Python, LoRA

Taste-Bench :避免把時間和計算資源花在錯路上

AI Agent 要做的選擇,當下往往看似合理,代價卻可能在很久之後才浮現。Taste-Bench 把這類決策分岔整理成測試,檢查模型能否及早選對方向。

Taste-Bench

AI Agent 做長任務時,選錯方向可能要到多個步驟之後才看得出代價。Taste-Bench 是一套評測資料集,讓模型閱讀任務背景、分岔前的操作紀錄,以及兩個候選下一步,再判斷哪個選擇較好;它測試的不是單步答題,而是能否避免把時間和計算資源花在錯路上。

資料集有 502 題,從軟件工程與機器學習研究任務的操作軌跡中整理而成,沒有逐題由專家標註。題目分為兩類:不同嘗試在同一位置分岔,最後結果提供判斷依據;或同一次執行中,Agent 遇到失敗後放棄原路並恢復。研究團隊從 4,657 個候選分岔中剔除過於簡單或無法判定的題目,並以後續結果標示較佳方向。

測試時可從 Hugging Face 取得資料集,按題目提供的紀錄比較模型選擇;程式碼庫亦提供 Python 3.11 以上的快速開始方式。評分要求模型在兩種選項排列順序下都答對,減低單靠固定選位置取得高分的可能。較貼近方向判斷能力,但題目仍集中於 SWE-bench、SWE-bench Pro,以及 METR 的 MALT 研究軌跡,未必涵蓋所有長任務場景。

14 個前沿模型中,最高平均正確率為 59.7%,仍有約四成題目判斷錯誤;當關鍵證據要到更後段才出現,準確率會由 62.3% 降至 21.0%,增加推理預算亦未能改善結果。研究亦報告,透過事後答案蒸餾訓練的 Qwen3.6-27B,在未見任務上的正確率由 30.0% 升至 47.9%;用它提供建議後,SWE-bench Pro 成功率由 14.6% 升至 33.7%。這些結果顯示評測不只用來比較模型,也提供了改善 Agent 決策的訓練方向。

  • 評測核心:在結果尚未揭曉時,從兩個下一步中選出較佳方向。
  • 題目來源:軟件工程與機器學習研究任務的真實操作軌跡。
  • 主要限制:目前 502 題的領域與任務來源有限,不能代表所有 Agent 工作。
  • 適合對象:研究長任務 Agent、比較模型決策能力,或訓練工具使用策略的團隊。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型訓練, Qwen, 工具, Python, Dataset 數據集

RecreationWorld:從操作到重建軟件介面

代理不只觀察介面,還要自行寫程式、啟動成品及核對結果,測試由操作走向完整交付。

RecreationWorld logo

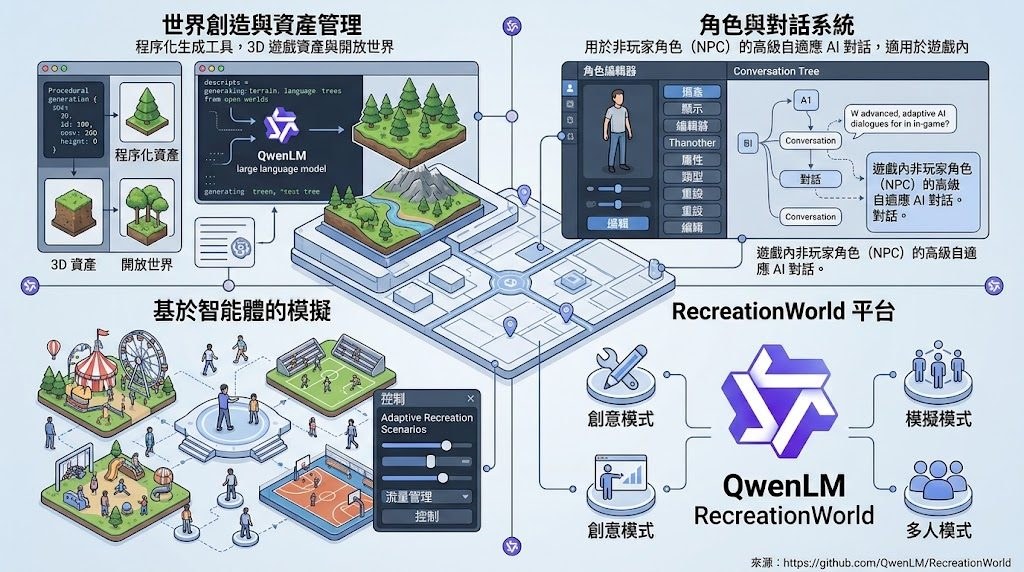
給代理一個正在運行的參考程式,它要邊操作、邊寫程式,再自行啟動及檢查成品。RecreationWorld 是研究混合式電腦操作代理(hybrid computer-use agents)的五平台框架,處理代理能否按可見行為重建軟件的問題。

它把參考程式當作可執行判準,讓代理反覆進行探索、實作與驗證,而非依固定階段完成任務。最終評分看功能與畫面是否吻合,不要求源碼、語言或架構相同,保留了實作自由。

  • 涵蓋 Ubuntu、macOS、Windows、Android 與 Web
  • RecreationBench 提供 250 個未公開於訓練流程的應用任務
  • 同時採用程式化檢查與視覺模型(Vision-Language Model,VLM)評分
  • 可比較完成度、接近滿分的應用比例及每項任務成本

已列出的結果中,GPT-6 Astra 平均 58.06%,領先 Claude Opus 5 的 44.16%,但估算成本達每項任務 115.80 美元;較便宜的模型則要接受明顯分數差距。這反映長時間探索、編碼與視覺核對仍然昂貴,而且只有少量應用能達到完整功能分數。

開發代理、GUI 自動化或程式生成系統的團隊,可下載 RecreationBench 資料集並依儲存庫的 Quickstart 配置環境;自行託管模型的正式評估需要聯絡團隊。它較適合作研究與模型比較,未見足夠資料證明可直接充當一般軟件重建服務。

項目主頁 · GitHub · 數據集

Categories: 開源, 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, Qwen, 框架, Mac, Linux, 庫, Dataset 數據集

ComfyUI-DeGrid:Qwen VAE 解碼網格修正

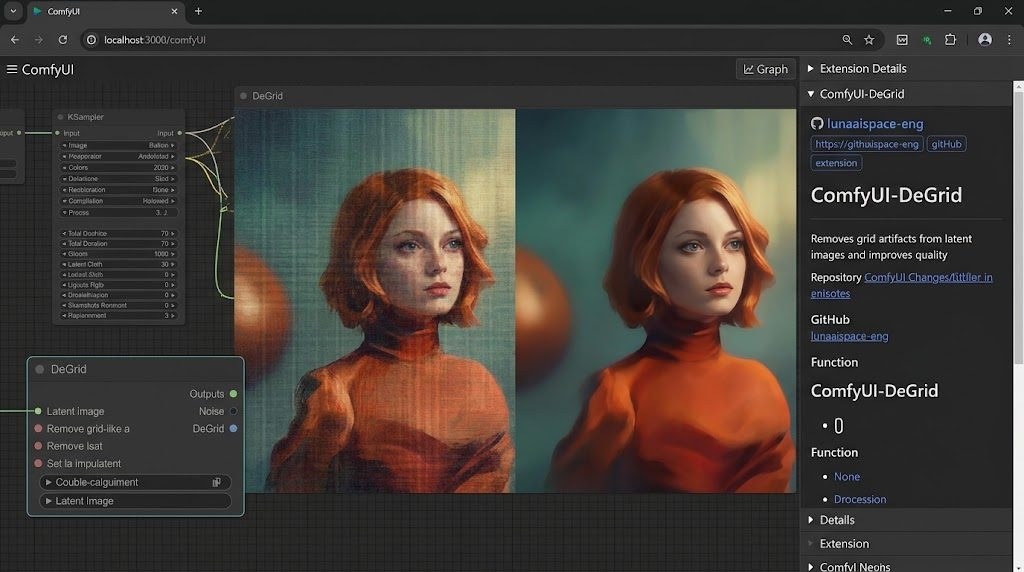
Qwen Image 解碼後的 2px 網格容易被放大流程強化,ComfyUI-DeGrid 讓修正可以在放大前自動完成。

Repository image for lunaaispace-eng/ComfyUI-DeGrid

Qwen Image、Qwen Image 2.1 及部分 Wan 2.1 VAE 生成的平坦暗位,可能帶有不易察覺的 2px 像素網格;經過銳化或放大後,瑕疵會變成明顯紋理。ComfyUI-DeGrid 是一個 ComfyUI 影像修正節點,專門在 VAE Decode 後移除這種規律格線。

它採用 VAE DeGrid(Nyquist Notch)處理方式,auto 模式會逐張影像量度網格強度並自動設定修正上限,無需自行調參;未偵測到網格時則原樣傳遞。節點亦會顯示 grid 強度、修正上限及受保護邊緣比例,方便確認是否有執行過度。

安裝只需放入 ComfyUI/custom_nodes,依賴 torch,亦不需要 OpenGL 或 GLFW,因此可在 headless 環境運行。工作流應接成 VAE Decode → VAE DeGrid → 銳化、放大或 SeedVR2 等後續處理,因為縮放後才修正,可能已經太遲。

  • 支援以 Qwen Image、Qwen Image 2.1、Wan 2.1 VAE 為基礎的相關工作流
  • auto 模式按影像校準,manual 模式則可自行設定 limit
  • 可用 enabled 開關快速作 A/B 比較,關閉時完全不修改影像
  • 沒有提供速度或畫質基準測試,效益主要取決於輸入是否含有網格
  • 不應與 ComfyUI-SaveSimple 同時安裝,兩者包含相同的 VAEDeGrid 節點 ID

需要處理 Qwen Image 或 Anima 解碼瑕疵的創作者,會較容易感受到它對後續放大流程的幫助;但若工作流沒有相關 VAE,或影像本身沒有網格,節點只會增加一個檢查步驟,未必帶來可見差異。

GitHub

Categories: 開源, ComfyUI, AI productions, Qwen, Image, Content Creator

Qwen-Image-2.1 開源:透明圖層生成與多圖編輯

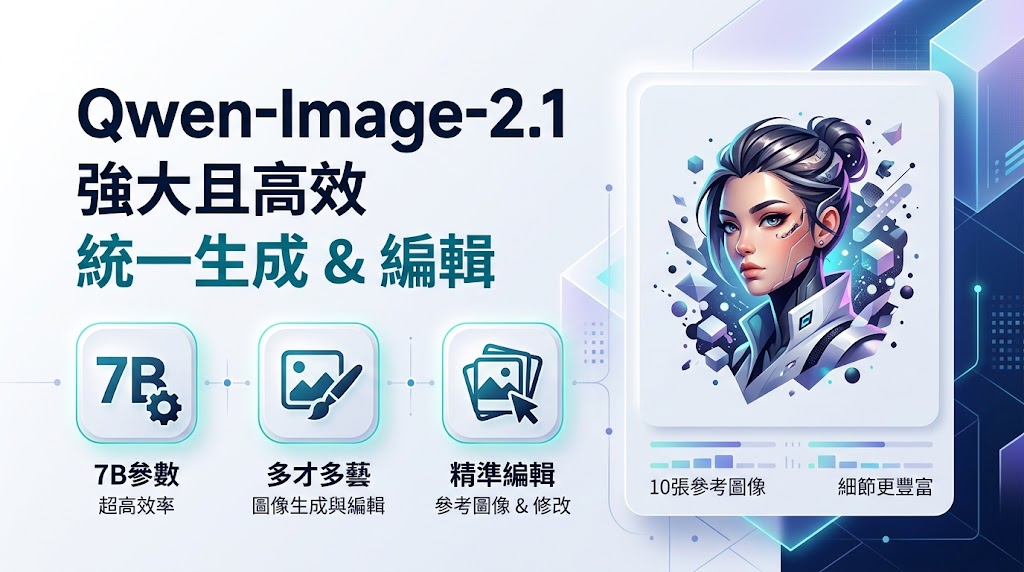
7B 參數的 Qwen-Image-2.1 把文生圖、圖片編輯、透明背景生成整合在同一個模型,一次可參考 10 張圖片,門檻不高但功能更齊全。

在 AI 繪圖的世界裡,能同時處理文生圖、改圖、還能直接輸出透明背景圖的開源模型並不多。Qwen 團隊這次開源的 Qwen-Image-2.1,把這幾件事整合進同一個 7B 參數的視覺生成模型,使用時不需要切換不同模型或額外加工。對做貼圖、做商品圖、做素材整理的人來說,這種「一個模型走到底」的做法很貼合日常工作流。

模型採用 32 層 Single-Stream DiT 結構,配合混合粒度注意力與 prefix KV cache 復用,把運算成本壓低。即使在顯示卡記憶體有限的環境下,仍能輸出品質不錯的圖片;Apple Silicon 用戶也能用 MPS 加速跑得動。

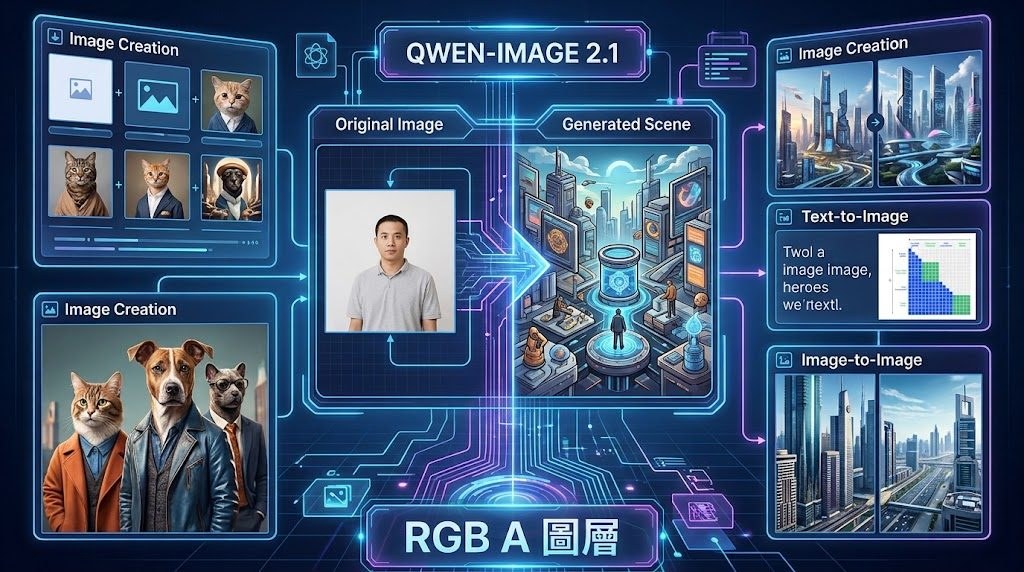
Qwen-Image-2.1 對透明背景(RGBA)的處理是這次的亮點之一。文字描述可以直接生成帶 Alpha 通道的圖,也能把照片裡的主體分離出來變成透明底,省去摳圖步驟。編輯功能同樣豐富:最多可同時參考 10 張圖片,用圓圈、塗鴉或遮罩標記局部修改位置,並在人物、產品場景保留識別特徵,避免改一處卻跑掉整個主體。

Og image

文字渲染和人像光影也比上一代細緻,招牌、卡片、海報一類需要清晰排字的場景更實用。整體定位偏向「夠用、好用、可商用」的工具型模型,不是衝榜級的影像模型。

重點摘要

  • 統一模型:文生圖、圖片編輯、RGBA 透明圖生成整合在同一個 7B 參數模型
  • 高效率架構:32 層 Single-Strteam DiT,搭配混合粒度注意力與 prefix KV cache 復用
  • 多圖參考編輯:最多支援 10 張參考圖,可用圓圈、塗鴉或遮罩指定修改區域
  • 主體保留:在人物、產品場景保持識別特徵,不會改一處就全跑掉
  • 透明背景原生支援:可文字直出 RGBA,也能從照片分離主體成透明底

模型已在 Hugging Face 開源,並提供 Diffusers 整合程式碼、Google Colab 與 Kaggle Notebook,Apple 用戶亦可透過 Draw Things 或 DiffusionBee 等本地 App 直接試用。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Qwen, Google, Image, 影像模型, 影像處理, txt2img, 蘋果

Qwen3.8 邊講邊翻譯即時生成字幕

阿里旗下 Qwen 推出 LiveTranslate 模式,用同一個模型一邊聽語音、一邊翻譯、一邊輸出字幕,支援中文、英文等多語言即時對話。

Og image

Qwen 團隊最近公開了 LiveTranslate 模式,主打邊聽邊譯、邊講邊出字幕。它把語音輸入、翻譯與字幕生成壓在同一個模型流程內,使用者開咪講一句,系統幾乎同步輸出另一種語言的文字,毋須額外挂接翻譯 API 或字幕引擎。

對於要做跨語言會議、外語直播、跨國客戶支援或聽打外語影片的團隊,這種一條龍處理可以直接省掉以往語音轉文字、再丟給翻譯模型、再做字幕排版的工序。直播主開英語節目時,中文觀眾可以即時睇到字幕;外語客戶打電話進來,中文客服亦可以一邊聽、一邊睇到對話內容。

LiveTranslate 屬於 Qwen3.8 系列下的語音功能延伸,目前支援普通話、英文等多語言之間互譯,亦可配合即時對話模式使用。Qwen.ai 用戶開啟 LiveTranslate 後揀選輸入與目標語言,便可以對住手機或電腦講話,螢幕同步顯示譯文。

Qwen 由阿里巴巴達摩院推出,屬於多語言、多模態大模型系列。LiveTranslate 的出現令 Qwen 在語音應用層面更貼近日常使用場景,而不限於純文字問答或文件分析。

重點摘要

  • Qwen3.8 新增 LiveTranslate 模式,主打邊聽邊譯、邊講邊出字幕
  • 語音輸入、翻譯、字幕生成整合在同一個模型流程內
  • 支援普通話、英文等多語言之間的即時互譯
  • 可用於跨語言會議、外語直播、客戶支援等場景
  • 透過 Qwen.ai 網站即可開啟試用,毋須額外安裝

項目主頁

Categories: 阿里巴巴, AI productions, 模型, 多模態模型, Qwen, API, Video, 語音

Page 6 of 20
1 … 4 5 6 7 8 … 20