Fold2Reason 讓語言模型學懂蛋白質結構

Fold2Reason 把蛋白質結構監督加入語言模型訓練,嘗試兼顧一般推理與三維結構讀取。

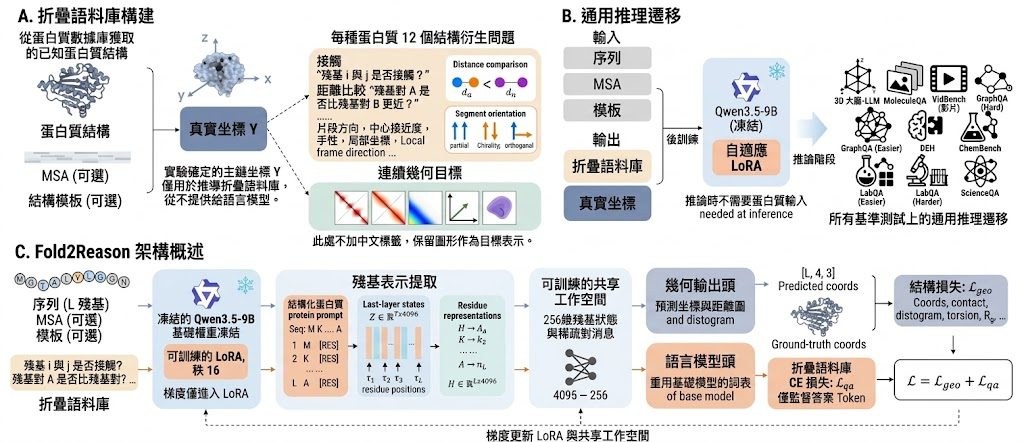
Fold2Reason diagram showing FoldingCorpus construction, general reasoning transfer, and the model architecture

要讓語言模型處理蛋白質問題,難點不只在文字理解,還包括如何保存三維空間關係。Fold2Reason 屬於模型訓練與研究型開源項目,透過 FoldingCorpus 監督資料、共享 spatial workspace 和凍結的 geometry decoder,處理語言模型推理與蛋白質結構讀取之間的銜接。

項目以 Qwen3.5 為主要訓練及評估流程,適合研究人員比較蛋白質結構後訓練對一般能力的影響。結構輸出不直接由語言模型單獨完成,而是交由 workspace 配合 decoder 讀取;一般推理則以適配後的語言模型評估,兩條結果路徑有清楚分工。

相較於只用 FoldingCorpus 訓練的 Pure-LoRA baseline,Fold2Reason 額外引入共享空間表示和凍結幾何解碼器,換來較完整的結構處理流程,同時增加資料、權重與硬件要求。項目提供確定性資料準備、LoRA/workspace checkpoint、已訓練 checkpoint 評估,以及重新訓練所需的管線。

  • 需要 Python 3.12、CUDA 相容的 PyTorch,以及指定版本的 Transformers 和 PEFT
  • dataset.zip 另行提供訓練資料、凍結 decoder 和三組 checkpoint
  • 可評估已發布 checkpoint,亦可重新進行 Qwen3.5 訓練
  • General-10 分數聚合器用於整理一般推理結果
  • 各基準測試相對基礎模型的增益,但未在提供內容列出完整數值

適合研究團隊、蛋白質 AI 模型後訓練及多模態空間表示方向的開發者。它未必適合只想快速調用蛋白質預測功能的使用者。但作為比較 LoRA、空間 workspace 與凍結幾何 decoder 的可重現實驗基礎,項目提供了比單一模型權重更完整的驗證路徑。
GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Medical醫學, 3D, Python, Dataset 數據集, LoRA

ScienceUtopia:研究科研政策、利益衝突

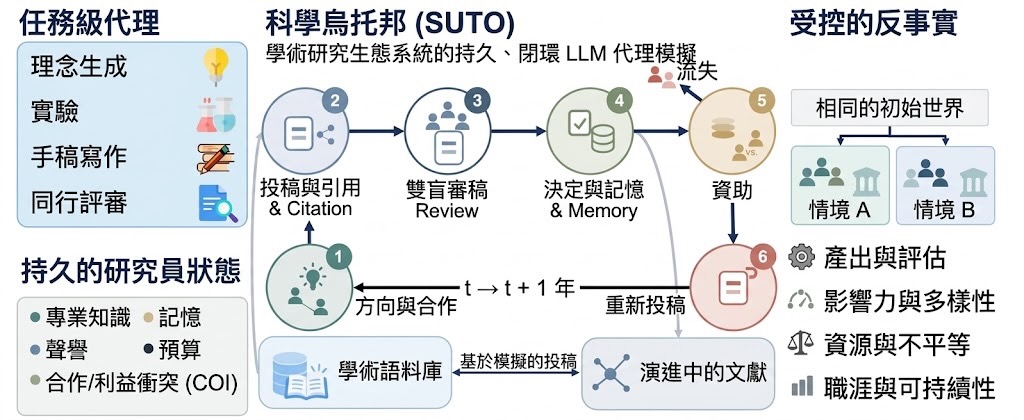
ScienceUtopia 讓語言模型扮演研究者,在選題、審稿與資助循環中觀察科研社群如何演變。

Repository image for Ahren09/ScienceUtopia

研究者會選擇方向、提交論文、互相審稿、獲得引用及爭取資助,結果再帶入下一年。ScienceUtopia 屬於開源科研模擬器,處理的是個人決策如何累積成研究社群、機構資源與科學產出的變化。

語言模型負責在明確規則下作結構化決策,研究者再從公開 SciEvo 數據集檢索候選論文;模擬器則串起研究週期、利益衝突、審稿、引用、資助和人才流失。相比只觀察單次回答的模型測試,這個項目可研究政策改動在多年循環後帶來的結果。

項目提供九類可配置實驗,可調整模型、隨機種子、端點及輸出位置。每次運行會保存年度 JSON checkpoint、請求紀錄、資助證據、來源雜湊和輸入身份,並配合 bootstrap 區間、隨機化測試、因子分解及資助門檻估計,方便重現和審查。

  • 適合研究科研政策、同行評審和資助制度的團隊
  • Python 3.11、PyTorch、Transformers 及 vLLM 構成主要執行環境
  • 網站本身是靜態頁面,直接開啟 index.html 即可查看,毋須後端或前端建置
  • 發佈版本不包含歷史活動成果、原始結果及繪圖程式

研究人員可先閱讀實驗定義和回歸測試,再按所需模型與 SciEvo 版本重跑項目;完整結果要視乎模型、快取、種子及端點而定。它更適合需要可稽核模擬證據的研究,而不是追求即時答案的日常工具。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, Qwen, 工具, Python, Dataset 數據集

OneStreamer 讓串流影片懂得記憶與適時回應

影片畫面離開視窗後,OneStreamer 仍可保留具時間線索的證據,並自行判斷何時已有足夠資訊回應問題。

OneStreamer

直播影片一閃即逝,畫面離開模型的視覺視窗後,之後的提問仍可能需要引用那些細節。OneStreamer 屬於串流影片大型語言模型,處理的正是記錄證據、理解新畫面,以及在資料足夠時主動回應之間的取捨。

它以 Qwen3-VL-4B-Instruct 為基礎,OneStreamer-4B 透過 Proactive Hierarchical Caption Memory(PHCM)保存局部細節和已完成事件摘要,再配合近期畫面作答,減少重看歷史影片特徵的需要。Proactive State Transition Learning(PSTL)則保留輸出錨點,挑選具代表性的狀態變化與持續狀態,只有 27.5% 標註狀態 tokens 需要監督。

你可從 Hugging Face 取得 OneStreamer-4B 模型及 OneStreamer-1M 數據集,配合串流影片、問答或字幕資料測試;儲存庫目前提供模型、數據集和示範頁面,但完整推理指令未在提供內容中列出,因此部署前仍需確認執行框架、硬件需求和輸入格式。OneStreamer-1M 合併串流字幕、串流 QA 及整理後的開源資料,共有 1.16M 筆互動記錄。

八項涵蓋線上感知、記憶和主動回應的基準測試中,OneStreamer-4B 在比較方法中取得最高的整體結果;這對需要持續觀看教學、監控或家庭影片的團隊較有參考價值,但生成式記憶仍可能受字幕品質、延遲和錯誤累積影響。

  • PHCM 同時保留局部細節與完成事件摘要
  • PSTL 針對回應時機和重複等待狀態作訓練
  • 模型、數據集及示範頁面均已公開
  • 八項基準測試涵蓋感知、記憶與主動回應
  • 適合研究串流影片理解及長時間上下文的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 南京大學, AI productions, 模型, 視覺模型, 模型訓練, Qwen, Video, 框架, 教學, 庫, Dataset 數據集

AutoGUIWorld:跨平台 GUI Agent 訓練場景及模型

以圖像生成模擬 GUI 狀態轉換,降低建立跨平台對真實軟件環境的依賴。

GUI Agent 要學懂跨平台操作,往往受限於收集資料時能夠安裝和重設的軟件環境。AutoGUIWorld 會生成 Windows、macOS、Ubuntu、Chrome、Android 或 iOS 的 GUI 場景,再由模型規劃點擊、開啟、切換等動作,透過圖像編輯生成每一步的畫面。它屬於面向 Computer-use agents 的資料生成框架,在毋須逐一啟動真實應用程式的情況下,建立有畫面、有動作、有座標標註的訓練軌跡。

AutoGUIWorld 把語意規劃和畫面轉換分開。Meta Planner 先按場景建立任務及動作序列,Voyager 讀取最新的乾淨截圖,描述下一個視覺狀態,再交由獨立的模型 adapter 處理文字、視覺和圖像生成或編輯;grounding backend 則負責找出指向目標的位置。每條軌跡會保留 obs_k.png、帶有目標框的 act_k.png,以及記錄任務、計劃、動作、畫面對應、grounding boxes 和 provenance 的 meta.json,方便日後檢查和重用。

  • 覆蓋 Windows 11、macOS、Ubuntu 24.04、Chrome、Android 和 iOS 場景
  • 技術報告使用的 AutoGUIWorld 訓練集包含 79,266 個 grounded and filtered examples
  • 支援 LocateAnything-3B、MAI-UI 或視覺語言 backend 進行 pointing grounding
  • 固定 random seed 可重現結構化場景,但模型輸出的文字和像素仍可能改變
  • 生成資料不會在真實桌面執行動作,也不會自行驗證任務是否完成

雖然 AutoGUIWorld 以視覺生成換取更快的場景擴展和較低的環境管理成本。代價是生成畫面未必等同真實軟件狀態,圖像模型也可能產生不合理的介面轉換,因此項目提供 scene validity、action alignment 和 transition fidelity 等品質檢查,但不能把這些檢查視為真實執行結果。

目前公開結果集中在資料生成和模型訓練流程。用家可隨時以軌跡微調 Qwen3.5-35B-A3B ,建立合成訓練資料。對只需要真實操作成功率、而且不能接受模擬畫面偏差的工作流程,仍應把真實環境測試放在資料生成之後。

GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Image, 框架, 軟件, Mac, Linux, Win, Dataset 數據集, UI/UX

Cloudflare Clef 多模態決策模型:直接輸出分類、路由與審核概率

Clef 將文字、JSON、影像或影片轉成結構化概率,毋須生成答案再解析。

Og image

面對發票分類、服務故障分流或影像核查等工作,Clef 可以直接為每條問題的可選答案計算概率,省去生成自由文本及再解析輸出的步驟。這個 27B 多模態決策模型基於 Qwen/Qwen3.8-27B 微調而成,能同時處理文字、JSON、影像及影片,並以單次 forward pass 回傳結果。

模型保留 Qwen/Qwen3.8-27B 的語言及視覺 backbone,再接上 joint schema head。這個小型 Transformer head 會讀取 backbone 的最終 hidden states,把狀態中的證據路由到每條問題,然後聯合計算所有選項的 logits;每條問題獨立套用 softmax 後,便可取得各選項概率。輸出不是自然語言,而是 choice、score 或 noul(true/false)等結構化結果,適合交由工作流程或 API 直接使用。

  • state 可接受字串或 JSON,問題支援 choice、有序的 score 及 noul。
  • images 和 videos 可與文字資料混合,文字及多模態記錄亦可放在同一批次處理。
  • encode_record 預設 max_length 為 16,384 tokens,亦可透過 max_state_tokens 限制狀態長度。
  • 模型檔案包括分片 safetensors、joint_head.safetensors、處理器設定及 joint_schema_model.py。

官方測試環境是單張 H200,配合 torch 2.11、transformers 5.10.2 及 pillow。

Clef 的取捨在於輸出控制性高,但用途受制於預先定義的問題、選項及 criteria,並非通用聊天模型。它與原始 Qwen/Qwen3.8-27B 的差異,是加入 joint schema head、記錄編碼及 SystemOne 介面,將生成式模型改造成可批量回答固定決策問題的模型;較小、較快的 Clef-Flash 則另行提供,頁面沒有交代兩者的參數規模或精度差異。Apache-2.0 授權及 Jev/SystemOne 相容 API,令它較適合整合到分類、路由、合規檢查及多模態審核流程。

模型

Categories: 模型, 多模態模型, Qwen, Tokenize

ThinkV2V 讓影片編輯先思考再生成

ThinkV2V讓多模態模型先理解影片中的因果與隱含意圖,再交由DiT完成較複雜的指令式影片編輯。

ThinkV2V Overview

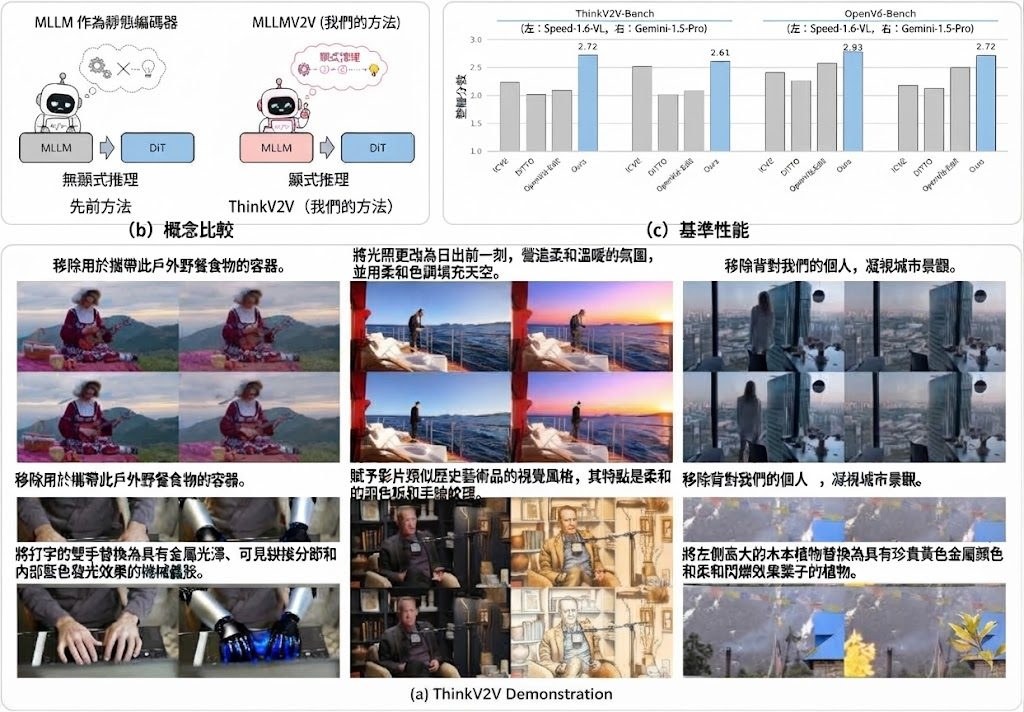
面對「按場景關係修改影片」這類指令,單靠文字語意對齊往往不足。ThinkV2V屬於推理導向的影片編輯框架,讓Multimodal Large Language Model(MLLM)先分析來源影片與指令,再把推理結果轉成DiT影片生成器可用的條件訊號,處理物件關係、時間變化及隱含意圖。

MLLM並非只擔任靜態語意編碼器,Qwen3-VL-8B-Thinking負責理解和推理,connector則把相關特徵對齊至DiT條件空間;原始文字嵌入、MLLM隱藏狀態及來源影片的VAE特徵會一同交由ThinkV2V-5B執行編輯。訓練由穩定的基本編輯逐步過渡至高解像度及推理密集案例,推理階段亦會生成多個候選計劃,再由MLLM篩選較可靠的一個。

  • 適合場景:需要根據時間脈絡、物件互動或因果關係修改影片的工作流程。
  • 評估資源:提供ThinkV2V-150K訓練數據集及ThinkV2V-Bench,後者包含308個樣本和5類推理密集編輯,預設支援720p。
  • 執行條件:Python 3.10、CUDA 12.x、PyTorch 2.6.0,並以torchrun或accelerate進行多GPU運算。
  • 資料限制:OpenVE-HQ-1M與ThinkV2V-150K主要是metadata釋出,下載腳本不會一併取得OpenVE-3M影片資料。

項目需要同時準備ThinkV2V、Qwen3-VL-8B-Thinking、Wan2.2-TI2V-5B及Lucy-Edit-Dev等權重,並按儲存庫指定的data與weights結構放置,較適合有CUDA多GPU環境及影片生成經驗的研究團隊。它相較只把MLLM當編碼器的做法,換取更深入的指令理解,但推理、多候選篩選及多模型權重亦會增加顯存、時間和安裝成本;儲存庫提供模型、資料集與基準測試,卻未在提供內容中列出可直接引用的量化領先幅度,不能只憑架構宣稱全面勝過其他影片編輯器。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 字節跳動, AI productions, 模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, 框架, 香港, Python, 庫, Dataset 數據集

RSIGame:生成遊戲及自行測試與進化

RSIGame 讓 AI 由遊戲構想開始反覆遊玩、找錯和改寫程式,直到品質提升飽和,再保留最佳版本。

RSIGame

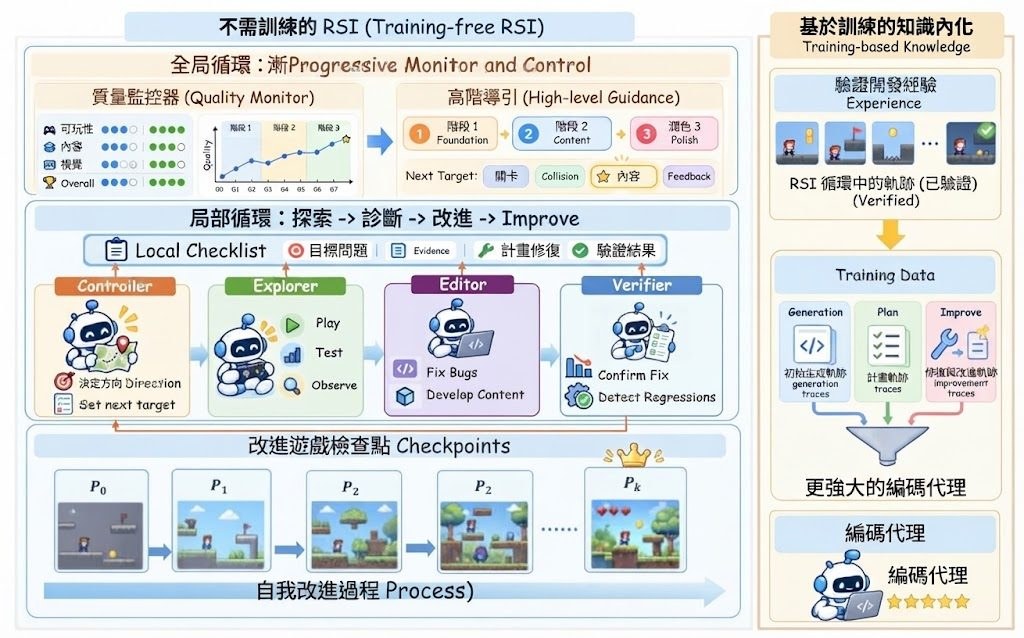
由一句高層遊戲構想開始,系統會自行產生可玩的版本,透過 AI agents 反覆遊玩、檢查問題,再改寫遊戲程式。RSIGame 屬於 autonomous agentic game development framework,實際處理的是生成遊戲難以持續修正、容易只迎合少量測試案例的問題。

RSIGame 把流程分成 local loop 和 global loop:前者執行 explore-diagnose-improve,廣泛探索遊戲、整理問題優先次序,再按證據修改;後者追蹤整體品質、保存最佳 checkpoint,並在長時間開發中識別停滯或回退。測試指引亦會逐步累積,令後續檢查不只依賴原本的提示。

透過 Hugging Face Space 輸入基本遊戲概念或設計方向,查看 agents 如何自動遊玩及產生較高評分版本。GitHub 項目要求 Python >=3.11,並以每次提交執行的測試檢查憑證外洩和內部 import 解析;自行研究或部署時,仍要留意所需模型、遊戲引擎及執行環境未在提供資料中完整列明。

在 140 個 GameCraft-Bench 任務、兩個遊戲引擎及五個生成器的相同開發預算下,RSIGame 持續提升遊戲品質。經驗內化後,Qwen3.8-27B 在 Godot 取得 61.38、在 Phaser 取得 58.53,超過 GPT-5.5 一次生成的分數,同時把 Qwen 的生成 token 減少 11 倍;結果仍屬基準測試,不能直接等同於所有遊戲類型的穩定表現。

  • 由高層構想生成遊戲,再自行遊玩、診斷和修正
  • local loop 負責局部問題,global loop 負責品質與版本選擇
  • 支援 Godot 和 Phaser 等遊戲引擎評估
  • 透過訓練內化成功的開發經驗,減少後續生成成本

RSIGame 適合研究 agentic coding、遊戲生成及長流程自我改進的團隊,也適合作為檢驗 AI 是否能處理多輪程式修正的研究框架。它的代價是流程需要較多執行時間、模型及遊戲環境配合,評分提升亦受測試任務和開發預算影響。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型訓練, Qwen, 框架, Python, 編程

Maestro:本地一鍵 AI 創作工作室,把導演、剪接、生成模型打包

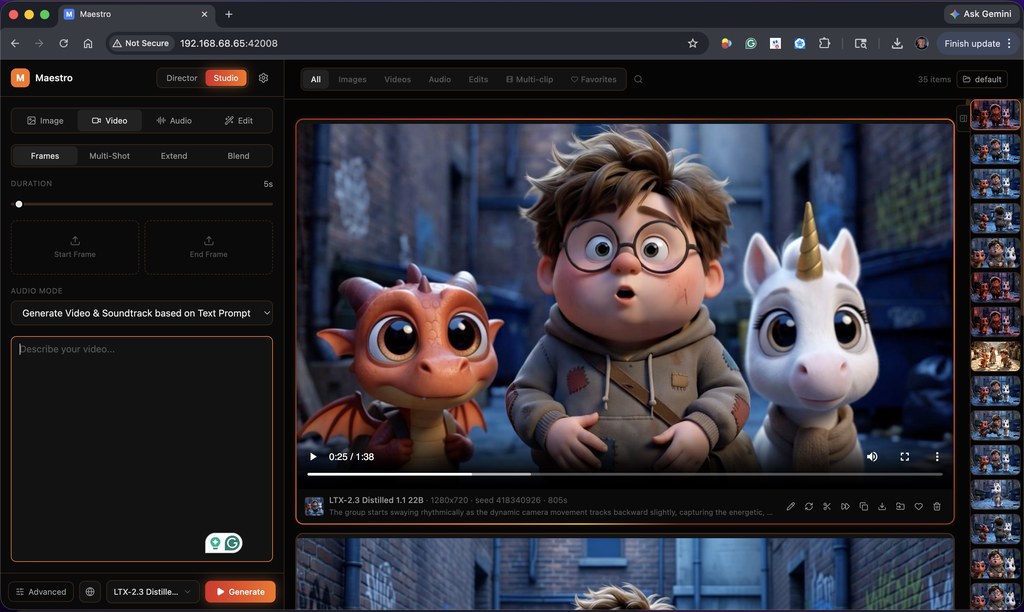
Maestro 把 LTX-2.5、MiniMax H3 等本地模型整合成一個創作介面,配合 LLM 編寫分鏡並自動生成音樂影片與短片,適合想在自己機器上完成後期的人。

Maestro UI

用 LTX-2.5 或 Hunyuan 這類本地模型做創作時,最麻煩的往往不是模型本身,而是要自己串接腳本、分鏡、剪輯和多軌音訊。Maestro 直接把這條工作流收進一個桌面介面:LLM 先讀懂你的音訊或劇本,再交由圖像、影片、音訊模型接力生成。Director Mode 同時支援 Music Video(節拍感知分鏡)同 Short Film(劇本連戲)兩種套路,前者會分析 BPM 與段落(主歌、副歌、橋接),再把鏡頭對齊落拍;後者靠 pacing-bias slider 控制剪接密度,並維持角色與對白的一致性。Auto Mode 可以一鍵跑完整條 analyze → plan → generate → combine 流程,Manual Mode 則保留每一步檢查點。

Director v2 架構把編劇、結構化分鏡、模型格式化分成三層,H3 路徑直接走自家編譯器,其他模型則用 per-model polish。Studio 那邊亦提供適應性寫作與連戲指引,並對源動作、對白歌詞做一致性檢查。對比逐個 CLI 工具拼接的傳統做法,Maestro 的差異在於把 director 邏輯、prompt 優化同非破壞性多軌剪輯綁定在一處,省下不少膠水程式。

硬件門檻方面,Performance Auto-Tune 會在首次啟動時偵測 GPU、VRAM、RAM,並自動選取量化、VAE tiling 與 VRAM 安全係數;OOM 時還會彈出建議橫幅,一鍵降 headroom。Qwen Image 2.1 7B 支援最多十張參考圖、透明 PNG 輸出與專屬 prompt 增強,但屬研究/評估授權,商用要另外處理 Qwen 的授權。

重點摘要

  • 整合 LTX-2.5、MiniMax H3、Wan、Hunyuan、SCAIL-2 等本地模型作影片生成、延伸、混合、重拍、上色與 upscale
  • Director Mode 用本地 LLM 自動規劃音樂影片分鏡或短片劇本,並維持角色與對白連戲
  • Auto Mode 全自動、Manual Mode 每步可審;Performance Auto-Tune 依硬件自動選 profile
  • Qwen Image 2.1 7B 支援十張參考圖、透明 PNG,但僅研究/評估授權
  • 原始資料未提供具體安裝步驟或下載連結,需自行到倉庫頁查閱

內容生成後想拿來做音樂 MV、自媒體短片或概念分鏡的獨立創作者、小型工作室,會較容易受惠;商業團隊則要留意 Qwen 等模型的授權細節。Maestro 在 JavisBench、V ABench 等基準上對 LTX-2.3 的對比屬同捆支援模型本身的表現,工具層並未自稱有獨立 benchmark。

GitHub · Paper

Categories: 開源, 香港理工大學, 上海人工智慧實驗室, 騰訊, AI productions, 模型, Qwen, NVIDIA, Video, Image, Audio, 香港, 工具, Content Creator, LTX, 音樂, MiniMax

OmniEcho:讓智能體真正「聽聲辨位」的全方位音視覺模型

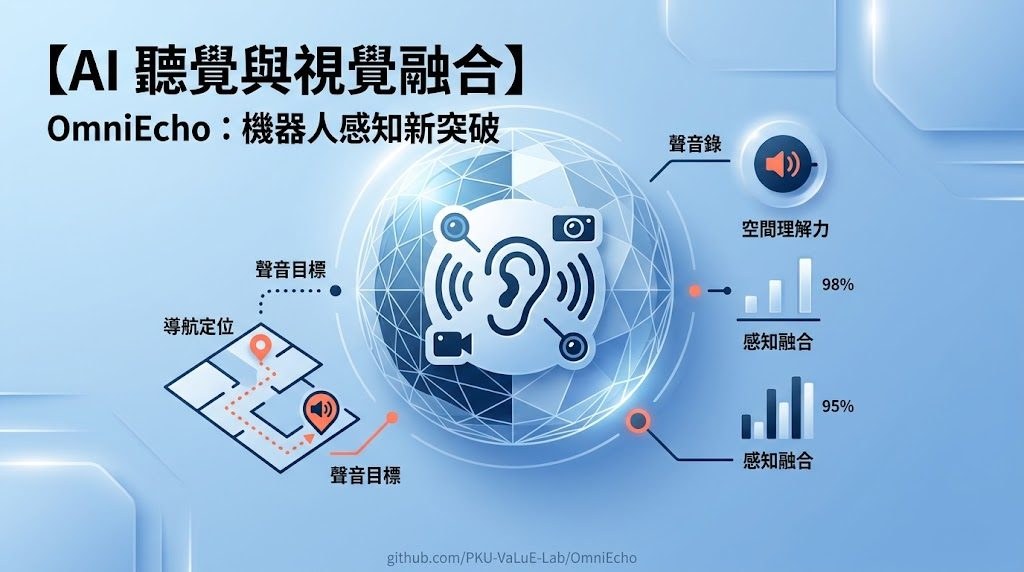
聲音從哪個方向來、距離多遠,是人類憑本能就能判斷的事,對機器人卻是一道難題。OmniEcho 把一階 Ambisonics 空間音訊、視覺與語言整合到同一個智能體,專門研究這類空間感知與聲源導航。

Repository image for PKU-VaLuE-Lab/OmniEcho

OmniEcho 是一個面向 embodied agent 的音視覺空間感知項目,由北京大學 PKU-VaLuE-Lab 開源。它要解決的問題很直觀:當一個智能體同時聽到聲音、看到畫面,它能否判斷聲源在哪個方向、距離多遠,並進一步循聲走去?這件事對人類毫不費力,但要讓 AI 真正做到,過去並不容易。

項目同時提供三樣東西:統一基準 OmniEchoBench、可控的空間音訊渲染管線,以及基於 Qwen3-Omni 改進的 OmniEcho 模型。後者最關鍵的設計,是在 Qwen3-Omni 既有語意音訊通路之外,加掛一個專門處理 FOA(一階 Ambisonics)空間資訊的編碼器,讓模型同時理解「聽到什麼」和「聲音從哪來」。

基準涵蓋六類任務,合共 197 個真實音視覺場景、2,972 條 QA 與 900 條導航樣本,全部由人工核對標註。OmniEcho 在空間音視覺感知上達到 state-of-the-art,而循聲導航的表現已經逼近傳統「靠文字指示」的視覺語言導航。不過細粒度的方位判定與距離估計,仍被作者列為尚未解決的難題。

對做機器人導航、音視覺融合研究,或需要智能體在真實場景中聽聲定位的團隊,這套項目提供了一個可以直接拿來跑評測、訓練、再挑戰的起點。原文並未附上完整的安裝或下載流程,相關代碼與模型權重目前標示為即將釋出。

重點摘要

  • 空間音訊加視覺語言:以 FOA 為輸入,與視覺、語言一起餵進 omni-modal agent。
  • 雙編碼器設計:在 Qwen3-Omni 之上新增 FOA 空間編碼器,保留原有語意音訊能力。
  • 真實世界基準 OmniEchoBench:六類任務、近 3,000 條 QA 與 900 條導航樣本,人工核對。
  • 循聲導航貼近文字導航:在 Nav 任務上接近傳統 VLN 水平,但方位與距離仍偏弱。
  • 代碼與權重待發佈: 標示 Coming Soon,暫無公開安裝步驟。

GitHub

Categories: 開源, 北京大學, Agentic, 模型, 視覺模型, 模型訓練, Qwen, VLA, Audio

Bonsai 2 27B:5.9GB 模型,筆電可本地處理視覺、PDF 與工具調用

Bonsai 2 27B 以近乎完整的推理能力縮至 5.9GB,兼顧視覺、工具調用與超長上下文。

Bonsai

想在筆記簿或單張 GPU 上處理 27B 級模型,Bonsai 2 27B 提供了一條更貼近本地工作的路線。這項目屬本地運行的低位元多模態語言模型示範工具,實際處理推理、圖片及 PDF 問答,以及需要工具往返的代理工作流。

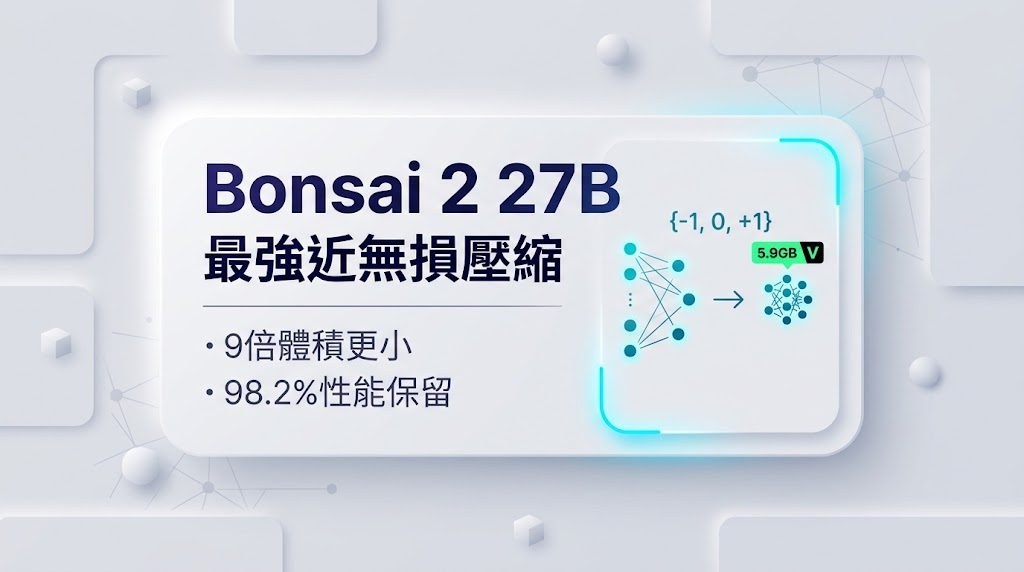
Ternary Bonsai 2 27B 建基於 Qwen3.8 27B,使用 {-1, 0, +1} 三值權重和 FP16 group-wise scaling,模型大小約 5.9GB,達到 1.76 effective bits per weight。項目聲稱保留完整精度模型 98.2% 的整體基準表現,數學能力只相差約半分,編程表現亦接近基線;代價是必須使用 PrismML 的 llama.cpp binaries,stock llama.cpp 無法直接載入相關檔案。

• 262K-token context,配合 hybrid-attention backbone,較適合長文件處理
• 支援照片、截圖及 PDF 問答,llama.cpp 與 MLX 均可運行
• 原生 OpenAI-style tool_calls,並支援 MCP servers
• PTQ1_0 約 1.75 bits per weight;PQ2_0 以增加約 1.3GB 換取較快提示處理

由 setup 流程取得對應模型及自訂後端,再透過示範介面開啟聊天、視覺和工具功能。Mac 可用 Metal,Linux 或 Windows 可選 CUDA、Vulkan、ROCm,亦可用 CPU;介面可調節 reasoning effort,方便比較回應速度與推理深度。

適合需要離線處理文件、想在有限記憶體硬件運行較大模型,或要把本地模型接入 MCP 工具的開發者和小型團隊。項目提供的多個 Bonsai、Bonsai (1-bit) 及 Ternary-Bonsai 型號,讓硬件容量與能力之間有更多取捨。

項目主頁 · GitHub · 模型

Categories: 開源, MCP, 模型, 多模態模型, Qwen, NVIDIA, OpenAI, Image, 工具, Mac, Linux, LLaMa, 編程, Dataset 數據集

Page 5 of 20
1 … 3 4 5 6 7 … 20