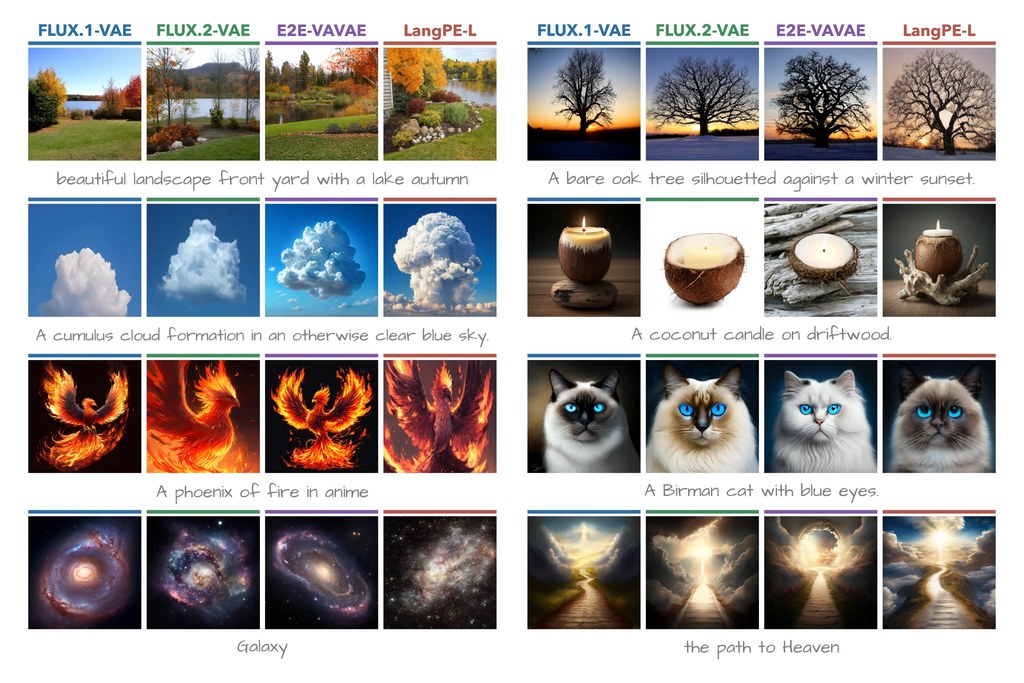
DiffusionBench:擴散模型評測框架

DiffusionBench 透過統一的 NanoGen 框架,橫向比較 25 種 DiT 方法在 ImageNet 與文字生成圖像的表現,挑戰僅靠 FID 評估擴散模型的舊範式。

DiffusionBench logo

這是一個針對擴散 Transformer(Diffusion Transformers, DiT)研究的基準測試項目(benchmark),核心目的是在 ImageNet 與文字生成圖像(T2I)兩種場景下,對擴散模型進行統一的訓練與橫向評測。舊有做法普遍以 ImageNet 的類別條件生成(class-conditional generation)為單一評測標準,作者批評這種範式已經難以反映生成模型的真實進展,因為 T2I 雖然更貼近實用,卻常被視為過於昂貴或不便而跳過。為此,項目推出 NanoGen 統一訓練框架,並以 DiffusionBench 重新組織評測結構,把 ImageNet 與 T2I 納入同一比較基準。

  • 統一訓練介面:NanoGen 只需約 12 行的配置更改,就能在 ImageNet 與 T2I 之間切換。
  • 跨任務方法比較:系統性收錄並比較 25 種 DiT 方法。
  • 多維度評測指標:涵蓋 FID 等多項 ImageNet 與 T2I 指標。
  • 研究成果已收錄 arXiv 論文(2606.24888),對應的模型權重同步上載至 HuggingFace。
  • 目前版本為 v0.1,作者明確標示仍處於初步階段,並積極招募社群貢獻者。

與單獨的 ImageNet 評測相比,DiffusionBench 的關鍵差異在於同時納入 T2I 任務,藉此揭示方法排名在兩類任務之間並無強相關(no strong correlation),這意味著 ImageNet 上的 FID 提升未必代表 T2I 生成品質同步改善。框架支援 VAE、RAE 與 Pixel space 等不同潛在空間(latent space)的訓練,技術上整合了 REPA-E 與 iREPA 等對比方法,適合 DiT 研究團隊、生成式模型工程師,以及關心基準公正性的學術工作者使用。受惠最大的,是需要評估自家方法在多任務泛化能力的團隊,以及希望避免單一指標誤導的審稿人與研究者。

GitHub: https://github.com/End2End-Diffusion/diffusion-bench

項目主頁: https://end2end-diffusion.github.io/diffusion-bench/

Model: https://huggingface.co/diffusion-bench/diffusion-bench
Categories: 開源, 模型, 模型訓練, Image, 影像模型, txt2img, 框架, 深度學習

Qwen-AgentWorld:用語言模型模擬七大代理環境的世界模型

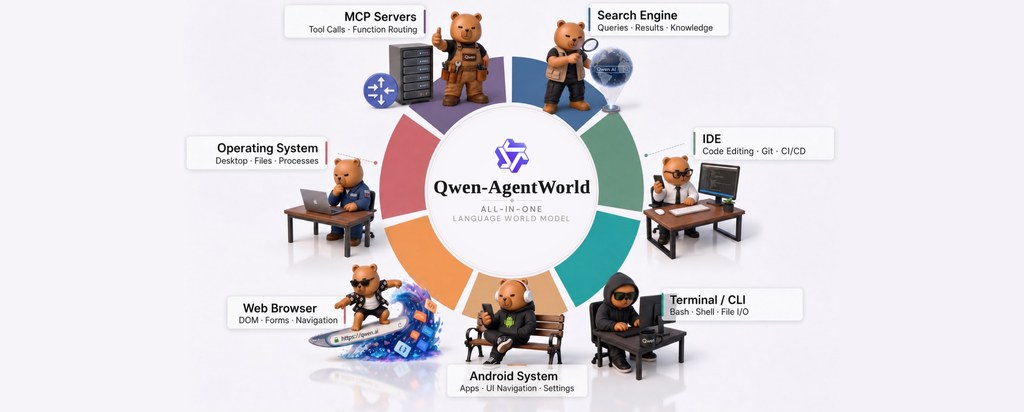
Qwen-AgentWorld 是首個覆蓋 MCP、Search、Terminal、SWE 等七大領域的原生語言世界模型,透過三階段訓練管線與千萬級真實互動軌跡,為代理訓練提供可擴展、可控的環境模擬器。

logo

Qwen-AgentWorld 是阿里 Qwen 團隊開源的語言世界模型(Language World Model),屬於模型與訓練框架類項目,核心任務是透過長鏈思維推理模擬代理(agent)在七大領域的環境動態,並為代理強化學習提供可擴展、可控的模擬環境。

現有做法普遍把世界模型視為代理訓練完成後的「後加配件」(post-hoc add-on),僅在需要時才引入環境模擬能力,這種範式限制了模擬品質與遷移效果。Qwen-AgentWorld 的差異在於從 CPT 階段起就把環境建模作為訓練目標,透過 CPT 注入環境知識、SFT 啟動下一狀態預測推理、RL 以混合獎勵機制銳化模擬保真度,最終在超過 1000 萬條真實互動軌跡上完成訓練。

這個項目同時釋出 Qwen-AgentWorld-35B-A3B(MoE 架構,總參數 350 億、激活 30 億、256K 上下文)以及 AgentWorldBench 評測基準,後者涵蓋 Tool Decathlon、Terminal-Bench 1.0/2.0、OSWorld-Verified 等九個基準,從五個維度以真實標籤評分世界模型品質。團隊亦提出兩種互補應用範式:作為解耦的環境模擬器支援大規模代理 RL,或作為統一代理基礎模型,以世界模型預訓練作為下游代理任務的暖身步驟。

重點摘要:

  • 七大統一領域:MCP、Search、Terminal、SWE、Android、Web、OS,首次由單一語言模型覆蓋。
  • 原生世界模型:環境建模從 CPT 階段即為訓練目標,非後加適配。
  • 可泛化模擬器:支援零樣本遷移到分布外環境(如 Claw Agent),並允許可控擾動與虛構世界構建。
  • 代理基礎模型:單輪非代理軌跡上的 LWM RL 暖身,可遷移至多輪工具調用代理任務。
  • 開源權重與基準:模型權重與 AgentWorldBench 均於 Hugging Face 與 ModelScope 釋出。

部署方面,模型可透過 Hugging Face 模型 ID 直接下載,或在無法存取 HF Hub 的環境下透過 ModelScope 配合 SGLang、vLLM 等框架載入。對於需要大量代理 RL 訓練數據的團隊,這個項目提供了一條以模擬取代部分真實環境互動的路徑,有助降低成本並提升可控性。

GitHub: https://github.com/QwenLM/Qwen-AgentWorld

Paper: https://arxiv.org/pdf/2606.24597

Categories: 開源, 阿里巴巴, Agentic, MCP, 模型, 世界模型, 模型訓練, Qwen, 框架, 深度學習

SSync 用選擇式蒸餾改善影片物件分解

SSync 針對影片物件分解常見的對齊成本高、訊號互相拖累問題,提出更精準的學習方式。它不是改整套架構,而是補強 slot-based 方法的弱點。

SSync

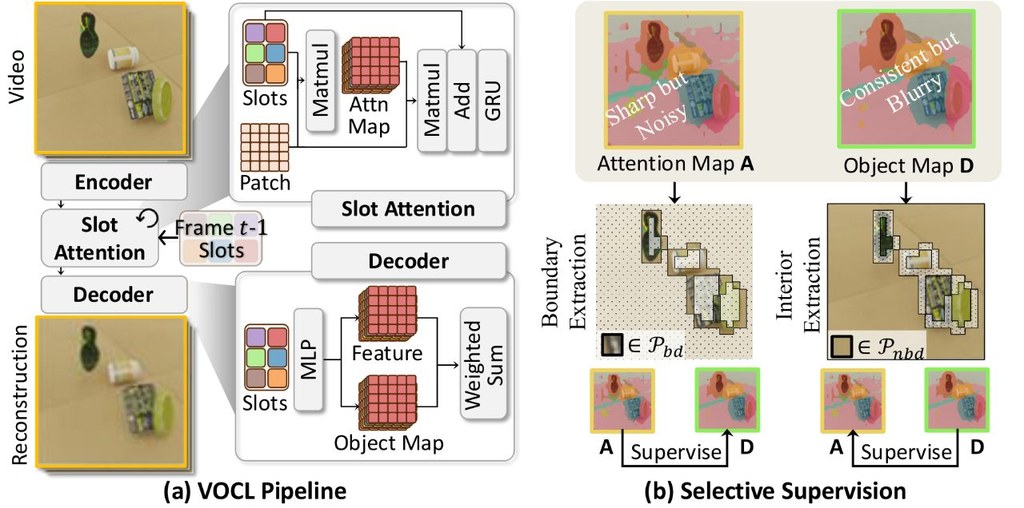
現有的 video object-centric learning(VOCL)多數沿用 slot-based frameworks,通常建基於 reconstruction-driven encoder–decoder architectures:encoder 產生 attention maps,decoder 產生 object maps,再嘗試把兩者對齊。近年的 dense alignment strategy 會對所有 spatio-temporal patches 做 contrastive learning,但這種全對全對齊會把 encoder 的雜訊和 decoder 的模糊邊界一併放大,計算量亦會升到 quadratic complexity,影片一長就更難擴展。

SSync(Selective Synergistic Learning)屬於一個可插入現有流程的 PyTorch 學習模組,目標是改善影片中的物件分解質素。它不是強迫所有 patch 全面一致,而是只挑選較可信的訊號做 mutual-distillation:用 encoder 幫手修邊界,用 decoder 清理物件內部雜訊,方向相當明確。

這項目把「全部都對齊」改成 selective distillation,並透過 pseudo-labeling 把成本降到 linear complexity。作者亦加入 transitive pseudo-label merging,處理 slot redundancy,將時序上反覆重疊的 slots 合併,減少模型把同一物件拆成多份的偏差。

如果你本身有研究 Slot Attention、影片分解、無監督物件發現,這項工作相當值得細看;如果你只是想快速試概念,亦可直接留意作者提供的 PyTorch implementation、Hugging Face 權重和 project page。它屬於 plug-and-play module,較適合已有 VOCL 基礎模型的人接入比較,而不是給完全零基礎讀者當成獨立應用程式。

  • 核心問題:dense alignment strategy 計算昂貴,亦會傳播 encoder 與 decoder 各自的錯誤
  • 核心方法:Selective Synergistic Learning 只蒸餾可靠線索,分開處理 boundary refinement 與 interior denoising
  • 結構補強:加入 transitive pseudo-label merging,減少 slot redundancy
  • 論文聲稱:可提升 decomposition quality,並對 slot configurations 有較強 robustness
  • 相關技術詞:VOCL、slot-based frameworks、Slot Attention、mutual-distillation、pseudo-labeling

整體來看,SSync 的價值不在於另起爐灶,而是在既有 slot-based video learning 範式上,直接指出 dense patch alignment 的兩個痛點:錯誤傳播與計算擴張。對研究型讀者而言,這比單純再堆模型容量更有意思;對工程導向團隊而言,它也提供了一個較容易插入現有項目的改良方向。

GitHub: https://github.com/wjun0830/SSync

項目:https://wjun0830.github.io/SSync/

Categories: 開源, 模型, 視覺模型, Video, 框架, IDE, Python, 編程, 深度學習

WAPO:穩定 RLVR 訓練時的損失函數項目

針對 GRPO 類方法的崩潰問題,加入 WAPO 等研究用損失函數。適合做語言模型強化學習與穩定性比較。

logobox

這是一個強化學習訓練工具項目,核心是為 Reinforcement learning with verifiable rewards(RLVR)加入多種損失函數,用來改善語言模型訓練時容易出現的崩潰問題。作者指出,傳統 GRPO 類方法雖然常見,但在 off-policy 更新下仍可能因梯度動態而失穩,所以這個 fork 直接把研究中的新損失實作進 vf.RLTrainer,方便對照測試。

項目內保留了 grpo、gspo、dr_dapo 等基線,並新增 wapo。其中 wapo 只針對正向回報的 rollout 更新,配合單向截斷與分組歸一化,思路比一般對稱 clip 更保守,目標是減少把模型推向錯誤方向的更新。

這個項目的新意不在於重新訓練一個模型,而是重新整理「哪些樣本值得被強化」這件事。論文提出的 gradient perspective 也把 token 層面的穩定性拆開分析,對想研究訓練動態的人很有參考價值。

適合以下人使用:
– 做 language model RLVR 研究的人
– 想比較 GRPO、GSPO、DR-DAPO、WAPO 差異的人
– 需要在數學推理或 multi-hop QA 做穩定性實驗的人
– 想沿用 vf.RLTrainer 再加自訂 loss 的開發者

性能方面,附帶的 arXiv 內容表示,WAPO 在數學推理與 multi-hop QA benchmark 上可提升訓練穩定性,並在多個模型家族上達到或超過基線。相關模型或方法包括 RLVR、GRPO、GSPO、DR-DAPO 與 WAPO。

GitHub: https://github.com/layer6ai-labs/wapo

Paper: https://arxiv.org/pdf/2606.16154

Categories: 開源, 模型, 模型訓練, Qwen, 工具, LangChain, LangGraph, Python, 深度學習

BadWorld:如何解決癱瘓視覺世界模型的未來推演

香港理工大學團隊提出無需標籤的對抗攻擊框架,揭露 Matrix-Game-2.0 與 Astra 等世界模型在單一擾動圖下即可能全面崩潰的結構性脆弱。

Chart

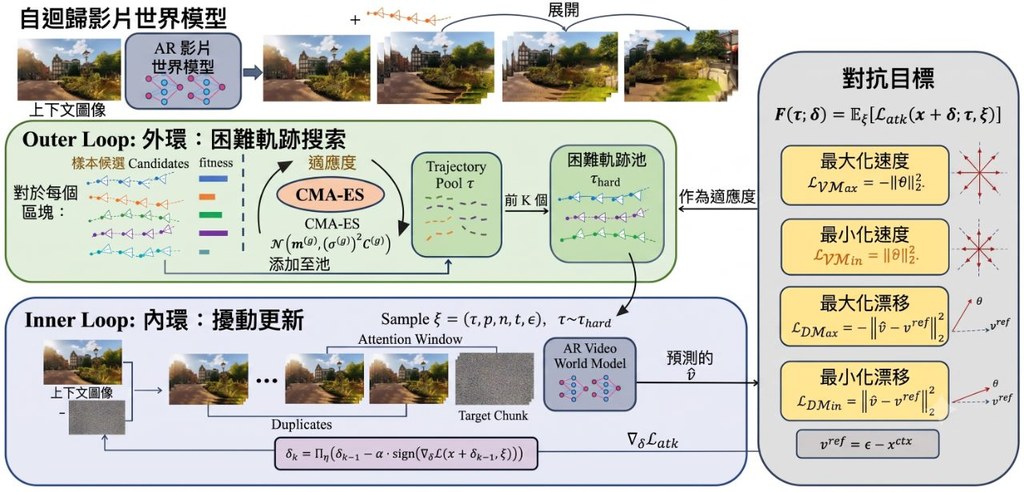
視覺世界模型(Visual World Models, VWMs)能從一張起始圖片,根據使用者動作序列合成出互動式的未來影片。現有做法多數沿用文字生成圖像或文字生成影片的對抗攻擊範式,但這類方法通常假設有固定的參考輸出或可取得的未來幀標籤。BadWorld 的作者指出,攻擊 VWMs 面對兩道根本限制:攻擊者根本拿不到真實的未來影片當作監督訊號,也無法預測使用者接下來會輸入什麼動作,因此傳統攻擊範式無法直接套用。

為此,團隊提出 BadWorld 框架,屬於一種安全研究工具,專門用來壓力測試自回歸式世界模型的時序穩健性。它繞過「需要未來監督」這道牆,採用自監督的速度擾動攻擊(self-supervised velocity attack),直接破壞模型早期的去噪動力學;同時,為了讓攻擊在未知動作下仍然有效,設計了軌跡自適應雙層優化(trajectory-adaptive bi-level optimization),主動挖掘困難的動作序列以鍛造「對動作無感」的擾動。

從測試結果來看,視覺上幾乎無法分辨的對抗圖片,能可靠觸發後續推演的災難性退化,出現去噪不完全、結構崩塌、控制訊號前後不一致等現象。這些發現對準備把世界模型應用於自動駕駛、機器人等安全關鍵場景的開發者是一記警鐘,同時也提供了一種可操作的隱私保護機制。

如果想自行驗證,可以針對 Matrix-Game-2.0 與 Astra 兩款開源世界模型測試。Matrix-Game-2.0 需約 32GB 顯示記憶體,Astra 則需 80GB,環境需要搭配 FlashAttention 與 NVIDIA Apex 等加速庫,並從 Hugging Face 下載預訓練權重。

  • 屬於安全研究工具,針對視覺世界模型做對抗壓力測試。
  • 突破傳統攻擊需「未來監督」的限制,採自監督速度擾動。
  • 透過軌跡自適應雙層優化,鍛造對未知動作仍有效的擾動。
  • 已在 Matrix-Game-2.0 與 Astra 上展示結構性崩潰。
  • 對自駕、機器人、遊戲模擬等安全關鍵部署具警示意義。

GitHub: https://github.com/LinghuiiShen/BadWorld

Paper: https://arxiv.org/pdf/2606.16519

Categories: 開源, 香港理工大學, 清華大學, 模型, 世界模型, 模型訓練, NVIDIA, Video, Image, 框架, 香港, 工具, 庫, 安全, 深度學習

BRDFusion:物理與生成模型合體,城市街景逆向渲染新框架

結合物理渲染與生成式擴散模型,把城市影片拆解為幾何、材質與 HDR 光源,支援夜景模擬與物件插入等編輯應用。

logo

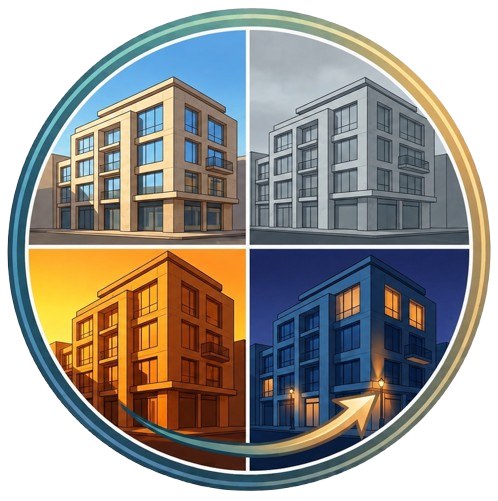
現有的城市場景逆向渲染方法長期面臨兩難:基於物理的渲染(physically-based rendering)雖然能嚴格遵守光學物理,但在重建與渲染階段容易產生雜訊與破圖;生成式模型(generative models,例如 DiffusionRenderer)能產出逼真影像,卻難以精準控制光源,例如車燈這類局部照明往往被忽略。BRDFusion 正是針對這個 trade-off 而設計的混合框架。

這個項目屬於研究型框架,目標是把多視角城市影片分解為幾何(法線、深度)、材質(albedo、roughness、metallic)與 HDR 環境光源,並支援新視角重照明、夜景模擬與動態物件插入等下游應用。具體做法上,它先用物理模型取得明確且一致的場景屬性,再借助生成式先驗(generative priors)緩解優化過程中的歧義;前向渲染時,物理模型負責可控渲染,生成模型則負責去噪與修補瑕疵。

測試方面,作者提供預處理資料集與預訓練權重,研究人員可直接下載並透過 tools/run_pipeline.py 跑推理與評估;硬體需求偏高,建議使用 NVIDIA RTX A6000,RTX 4090 在記憶體允許下可執行部分階段,但 Gen. Render 階段可能突破 24 GB 限制。資料集與評估影片亦同步發佈於 Hugging Face,方便重現結果。

這個項目的創新之處在於把「物理一致性」與「生成式品質」放在同一條管線中互補,而非二選一。對從事自動駕駛模擬、遊戲或影視場景重建的研究團隊而言,這是一個值得關注的方向。

重點摘要

  • 混合範式:物理渲染負責可控性,生成模型負責修補瑕疵,突破單一方法的極限。
  • 完整分解:輸出幾何、材質與 HDR 光源,支援新視角、夜景與物件插入。
  • 高硬體需求:建議 RTX A6000,4090 僅能跑部分階段。
  • 完整開源資源:程式碼、預訓練權重、資料集與評估影片均已公開。
  • 適用場景:自動駕駛模擬、城市數位孿生、影視級場景編輯。

GitHub: https://github.com/shigon255/BRDFusion

Categories: 開源, 清華大學, 模型, 視覺模型, 模型訓練, NVIDIA, Stable Diffusion, Video, Image, 影像模型, 影像處理, 框架, 工具, Meta, 深度學習

RhymeFlow:加快影片生成的新路線

RhymeFlow 針對影片生成太慢的老問題,提出免訓練加速方法。它不只追求更快,亦嘗試保住畫面連貫度。

Repository image for Simon-Dcs/RhymeFlow

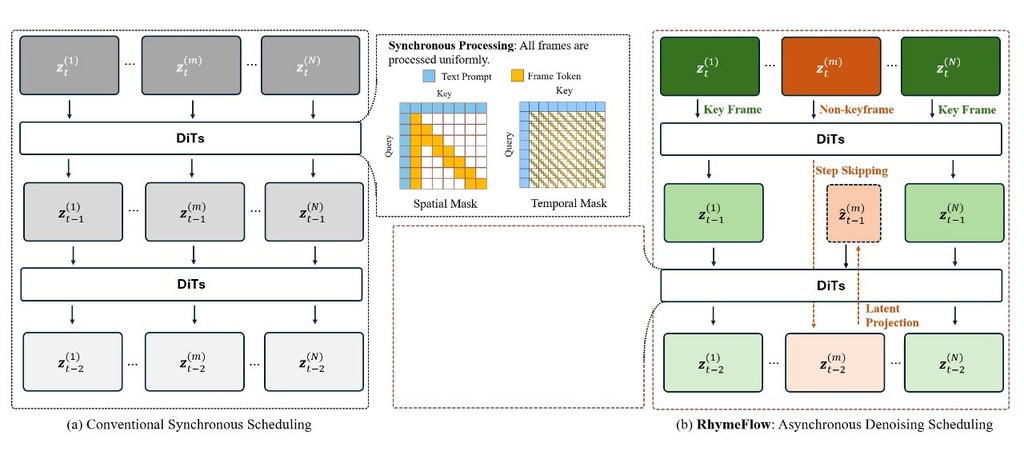
現時不少影片生成加速方法,主要仍沿用標準 diffusion pipeline:每一幀都要在所有 diffusion timesteps 完整做一次 dense denoising,再配合 sparse attention 或 KV-caching 減少單步計算。RhymeFlow 指出,這種固定範式忽略了相鄰影格內容與動作高度相關,令自然影片裡大量中間步驟其實屬於重複運算。

這是一個免訓練的影片生成加速框架,核心目標是替 DiT(Diffusion Transformers)影片模型減少推理延遲與運算成本。它將不同影格的 denoising trajectory 拆開處理:先找出主導語意變化的 keyframes,讓 keyframes 保持逐步去噪,非 keyframes 則逐步跳過部分步驟,再用 latent trajectory projection 補回時間一致性。

這個做法的創新,不在於單純把 attention 再稀疏化,而是直接挑戰「所有影格都要同步、密集去噪」的舊假設。論文描述,RhymeFlow 在現有 DiT-based video generation models 上,能同時取得更高 inference speed 與更好 visual quality;不過 GitHub 目前公開重點放在 Wan 2.1 adaptation,HunyuanVideo adaptation 仍在準備中。

如果你想試,較合理的切入點是把它當成 Wan 2.1 的加速實驗框架,比較 dense、svg、sap、rhyme、rhyme_sap 幾種方法輸出時間與畫面差異。環境要求偏高,文件列出 CUDA 12.4 / 12.8 與 PyTorch 2.5.1 / 2.6.0,亦牽涉 FlashInfer、flash-attn 和自訂 kernels,較適合已有 GPU 與 PyTorch 經驗的人。

  • 項目類型:training-free 影片生成加速框架,處理 DiT 影片模型推理太慢的問題
  • 方法重點:keyframes 做 dense denoising,非 keyframes 跳步處理,再用 latent trajectory projection 維持時序一致
  • 可比較方法:dense、svg、sap、rhyme、rhyme_sap
  • 相關模型:Wan 2.1 已有 adaptation,HunyuanVideo adaptation 尚未完整釋出
  • 適合場景:研究影片生成推理優化、比較不同加速策略、測試速度與畫質取捨

整體來看,RhymeFlow 的價值很明確:它不是改模型權重,也不是重新訓練,而是重排 denoising flow scheduling,從流程層面節省計算。對研究者與進階開發者而言,這類思路比單純堆硬件更有參考價值;對一般創作者來說,現階段門檻仍在部署與 GPU 環境。

GitHub: https://github.com/Simon-Dcs/RhymeFlow

Paper: https://arxiv.org/pdf/2606.06309

Categories: 開源, 清華大學, 騰訊, AI productions, 視頻模型, 模型訓練, NVIDIA, Video, 框架, Content Creator, Python, 深度學習

S2L-PO 用小模型帶動大模型推理訓練

清華與港校團隊提出 S2L-PO,改用小模型提供多樣推理路徑,補足 GRPO 易收斂過快的問題。

S2L-PO method overview

這個項目來自跨校團隊,作者包括 Yiming Ren、Yiran Xu、Zicheng Lin 等人,通訊作者是 Yu Qiao 與 Ruihang Chu;所屬機構包括清華大學、上海人工智慧實驗室、香港中文大學及香港城市大學。以研究背景看,團隊明顯集中在大型語言模型訓練、推理強化學習與數學評測。

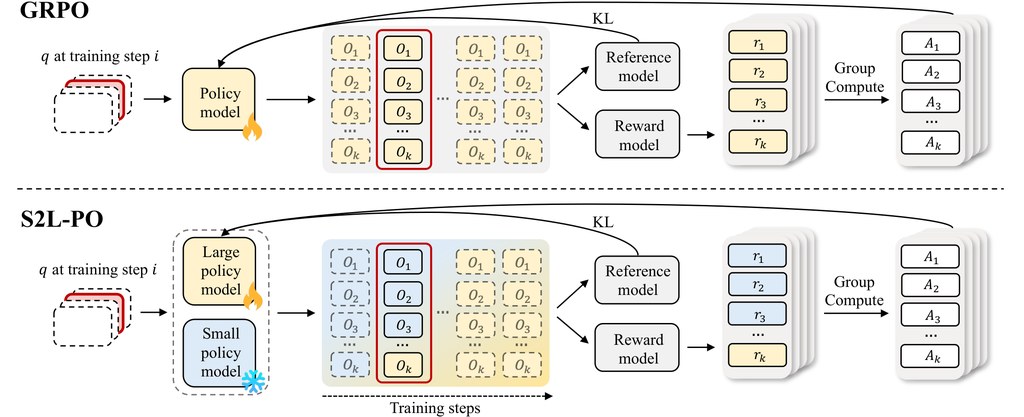
這是一個針對 Group Relative Policy Optimization(GRPO)訓練流程的研究型框架,目的是提升大型語言模型在推理任務上的 rollout diversity。現有做法多數靠提高 temperature,從 token-level randomness 增加變化,但論文指出這種固定範式容易在長推理鏈累積噪音,令軌跡變得不連貫。

S2L-PO(Small-to-Large Policy Optimization)換了一個角度:不用同一個大模型不停抽樣,而是找同家族的較小模型做 explorer,先產生一部分 qualitatively different reasoning trajectories,再讓大模型用混合 rollout 依照標準 GRPO 訓練。之後再用 progressive annealing,逐步由 small-model exploration 過渡到 fully on-policy learning,避免中途被小模型能力上限拖慢。

論文提供的結果頗有說服力。以 Qwen3-8B learner 配 1.7B explorer 為例,AIME24 Pass@1 由 15.0 提升到 23.8,AIME25 Pass@1 由 12.1 提升到 22.5;Qwen3-14B learner 配 4B explorer 亦比基線 GRPO 高。作者同時聲稱 rollout compute 還可降低,這點對訓練成本敏感的團隊尤其有吸引力。

如果你想測試這個項目,較合理的方式不是當作即裝即用工具,而是把它視為一個訓練策略參考:先看論文與公開模型設定,再比較自己手上的 GRPO 流程是否同樣受 rollout 同質化影響。硬件門檻不算低,資料列出 8B 模型約需 20 GB GPU 記憶體、14B 模型約需 32 GB,較適合研究人員、模型訓練工程師,或正在做數學推理微調的團隊。

  • 核心判斷:這是模型訓練框架,不是一般聊天應用,重點在改善 GRPO 的探索品質
  • 方法差異:由 token-level randomness 轉向 policy-level diversity,減少長鏈推理失真
  • 主要創新:用較小同家族模型充當 natural explorers,再以 progressive annealing 收回大模型主導權
  • 已列相關模型:Qwen3-1.7B、Qwen3-4B、Qwen3-8B、Qwen3-14B
  • 適合場景:數學推理、可驗證獎勵訓練、想提升 RLVR 與 GRPO 收斂效率的項目

GitHub: https://github.com/qishisuren123/S2L-PO

Paper: https://arxiv.org/pdf/2605.30789

Categories: 開源, 香港中文大學, 香港城市大學, 清華大學, 上海人工智慧實驗室, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 框架, 香港, 工具, Python, 深度學習

Orchestra-o1:多智能體協作框架拆解複雜多模態任務

由香港中文大學等團隊研發的 Orchestra-o1 採用 MainAgent + SubAgent 架構,在 OmniGAIA 基準上以 72.8% 準確率領先對手 10.3 個百分點。

Orchestra-o1 Framework

Orchestra-o1 由香港中文大學(CUHK)計算機科學與工程學系的 Fan Zhang 領銜,聯同北京大學、清華大學、同濟大學及 LIGHTSPEED 團隊共同開發。模型權重同步開源於 Hugging Face。

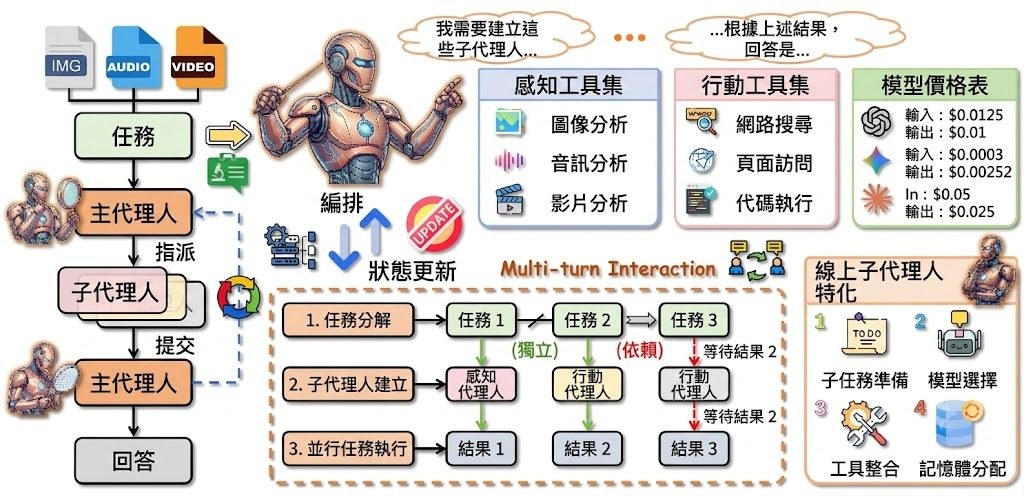
這個項目的定位是多智能體協作框架,針對文字、圖像、音訊、影片並存的「全模態」(omnimodal)場景,自動把複雜任務拆解成多個子任務,再分配給專責的 SubAgent 執行。MainAgent 負責規劃與協調,SubAgent 則配備搜尋、執行程式碼、影音分析等工具獨立運作,獨立子任務可同步執行以提升效率。

重點摘要:

  • 層級式架構:MainAgent 統籌拆解任務,SubAgent 各司其職,避免單一模型疲於應付多模態輸入。
  • 平行執行:無依賴的子任務同步進行,加快整體處理速度。
  • DA-GRPO 訓練法:以 Qwen3-8B 為基礎,搭配 Decision-Aligned Group Relative Policy Optimization 與 LLM-as-judge 獎勵機制微調。
  • OmniGAIA 表現:在 OmniGAIA 基準測試取得 72.8% 準確率,領先第二名 10.3 個百分點。
  • 開源生態:基於 Python 3.10+ 與 verl 框架,訓練需 8 張 H20 (96GB) GPU 單節點。

Orchestra-o1 的創新在於把「模態感知拆解」與「線上子智能體特化」結合,讓多模態協調不再依賴線性流程。適合需要處理多媒體資訊的研究團隊、Agent 開發者,以及關注 Computer-use agents(CUAs)與多模態模型應用的工程師。

效能方面,作者將 Orchestra-o1-8B 定位為同類開源全模態代理中最先進(SOTA),同時在商用模型(例如 GPT-5)推理腳本中亦提供整合,方便研究人員比較開源與閉源路線的差距。

GitHub: https://github.com/zfkarl/Orchestra-o1

Paper: https://arxiv.org/pdf/2606.13707

Categories: 開源, 香港中文大學, Agentic, 模型, 框架, OpenClaw, 深度學習

Stable-Layers:靠 VLM 評分強化學習,毋須配對數據也能改良圖層分離

Stability AI 提出 Stable-Layers 框架,利用 VLM 評分與 Flow-GRPO 微調圖層分解模型,解決配對數據不足的限制。

Hero image preview

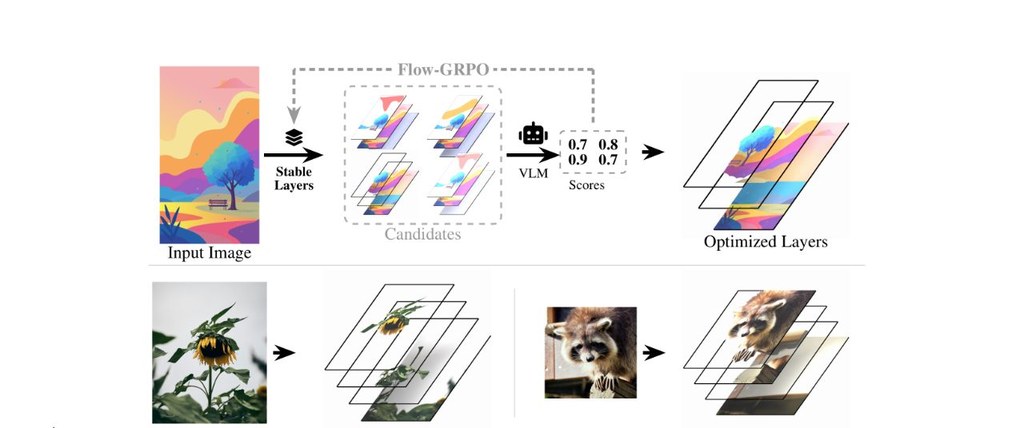
圖像圖層分解(image layer decomposition)是指把一張圖分成幾層可獨立編輯的 RGBA 影像,再合併回原本的畫面。這個技術是專業修圖與合成工作流的基本工序,但要訓練模型做這件事並不容易:同一張圖往往存在多種合理分層方式,而且品質好壞取決於下游是否好用,例如語意分層是否清晰、alpha 遮罩是否乾淨、是否有冗餘層,以及被遮擋的部分能否被合理填回。

傳統做法會用合成的配對數據集(即同一張圖同時提供「原圖」與「正確分層」)來監督模型學習,但這會帶來先天限制:當多種分層都同樣合理時,強迫模型擬合單一標準答案,等於懲罰了其他可行的解法。Stable-Layers 嘗試繞過這個限制,改用強化學習(reinforcement learning)讓模型直接朝「看起來品質好」的方向優化,監督訊號只來自一個視覺語言模型(vision-language model,VLM)。

具體而言,項目以 Qwen-Image-Layered 為起點,結合 Flow-GRPO 與 LoRA(Low-Rank Adaptation,低秩適應)微調,針對每張圖採樣多個候選分層,再用 VLM 評分,從群組相對優勢(group-relative advantages)來更新策略。當中最大的挑戰是設計可靠的獎勵訊號:VLM 單獨評分時容易把所有樣本擠進一個狹窄的分數區間,導致 GRPO 缺乏組內變化可以學習。為此,Stable-Layers 採用兩階段評估流程——先按五個編輯向標準逐項評分,再把所有候選並排放在標記好的比較網格上重新評分一次,藉此取得更細緻的相對校準。

Stable-Layers 重點摘要:

  • 毋須配對數據:在完全沒有標註的圖像上訓練,解決合成數據集帶來的偏誤問題
  • VLM 擔任評審:利用視覺語言模型就五個編輯標準打分,提供獎勵訊號
  • 兩階段評估:先獨立評分,再以比較網格重新校準,避免分數過度集中
  • 強化學習微調:結合 Flow-GRPO 與 LoRA,從 Qwen-Image-Layered 開始改良
  • 實測表現:在 Crello 數據集上,圖層分離度更高、空白或帶瑕疵的層更少、每層重建誤差也較低

適用場景與對象:這個項目適合做圖像編輯、合成或設計工具的研究者與工程師,尤其是手上沒有大量配對分層數據、又想提升分層品質的團隊。對強化學習應用於視覺生成感興趣的人,也能從它處理「組內變化不足」的設計中得到啟發。

效能與評估:團隊在 Crello 數據集上測試,結果顯示 Stable-Layers 相比基礎模型,圖層分離更明確、出現空白或帶雜訊的層更少,而且每層的重建誤差也更低。論文獲 NeurIPS 2026 接收(arXiv:2605.30257v1)。

引用的模型:Qwen-Image-Layered(基礎分層模型)、Flow-GRPO(強化學習算法)、LoRA(高效微調方法)、視覺語言模型評審。

項目: https://stability-ai.github.io/stable-layers.github.io/

Categories: 開源, 模型, 影像模型, 影像處理, 深度學習

Page 2 of 4
1 2 3 4