OraRL:標註即 Rollout,統一多模態模型強化學習

OraRL 把影片標註轉成可靠的正向 rollout,令同一模型兼顧定位、分割、追蹤、問答與空間理解。

Animated OraRL method preview

面對一段長影片,模型要同時回答內容問題、找出時間片段、定位畫面區域,往往要在多套任務方法之間取捨。OraRL 是一個用於統一影片多模態模型(video MLLMs)強化學習的研究項目,將原本只用來評分答案的標註,序列化成模型可直接學習的 oracle rollout。

它的核心做法是把一條標註答案加入同一提示的 policy samples,再只用 policy rewards 計算 on-policy baseline,避免準確標註扭曲模型原本的相對比較;annotation-policy reward gap 則用於方向性修正,最後以 sign-balanced pruning 篩選更新訊號。這個安排保留探索,同時不需要 chain-of-thought supervision 或額外解碼。

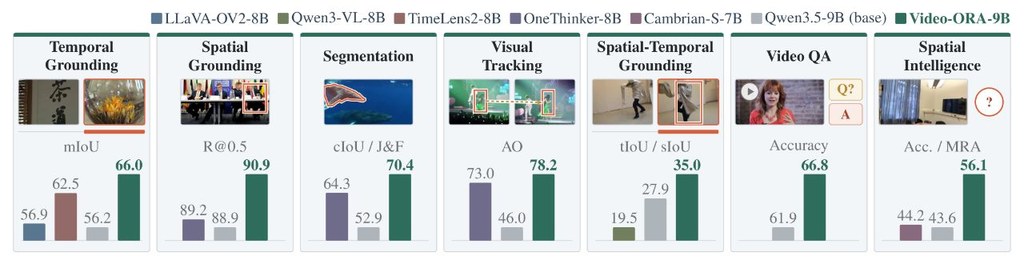
同一套更新規則覆蓋 temporal grounding、spatial grounding、segmentation、tracking、spatial-temporal grounding、video QA 及 spatial intelligence,Video-ORA-9B 則以一個模型處理七類影片理解任務。4B 設定的更新時間由每步 92.5 秒降至 62.4 秒,速度提升 1.48 倍,單張 GPU 峰值記憶體亦由 62.4 GB 降至 50.9 GB。

推理部分提供較實用的取捨參考:H20 以 vLLM 和 BF16 載入時,4B 及 9B 分別佔 8.6 GiB 和 17.6 GiB;十分鐘、每秒兩幀的影片採用 answer-only decoding 後,總延遲由 29.03 秒降至 24.30 秒。儲存庫列出 Environment、Training 及 Evaluation 文件,但提供的資料未包含完整安裝步驟或可直接下載模型的細節,較適合研究團隊按文件檢查環境後測試。

  • 訓練方法:標註同時作為正向 rollout 和任務有效的學習目標。
  • 涵蓋範圍:一套 RL recipe 支援七類影片感知任務。
  • 效率改善:4B 更新速度提升 1.48 倍,記憶體需求下降。
  • 推理優化:支援影片快取、一次解碼重用及 answer-only decoding。
  • 適合情境:需要統一處理影片定位、追蹤、分割、問答和空間推理的研究或工程團隊。
項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 世界模型, 模型訓練, Video, 影像處理, 框架, Dataset 數據集

DiffusionOPSD:將自我蒸餾影像獎勵轉為可更新訓練目標

DiffusionOPSD 將影像級獎勵轉成可反覆更新的中間目標,補上 diffusion 訓練中間步驟的監督空白。它適合想在有限訓練預算下,改良生成質素同可診斷性的團隊。

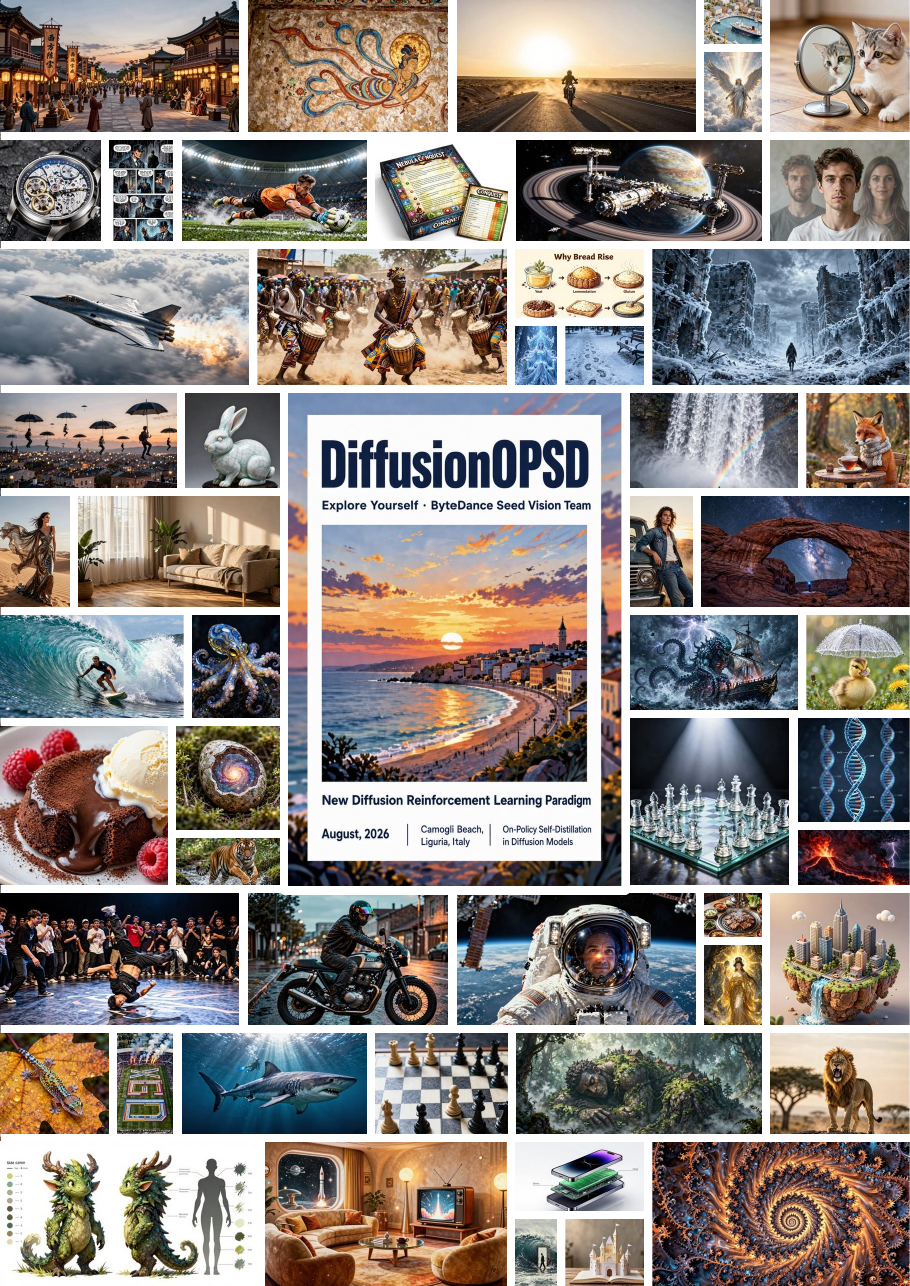
DiffusionOPSD qualitative gallery

DiffusionOPSD(ByteDance Seed) 主攻的是 diffusion 模型後訓練時,只有最終圖片分數、欠缺中間步驟指引的問題。它屬於一套用於模型後訓練的開源方法,透過 on-policy self-distillation,把影像級 reward 轉成可直接學習的中間目標。

它的做法不是單純追分,而是先用凍結的 behavior policy 收集低噪聲查詢狀態,再用 reward gradient 建出正負兩種 bounded target,最後由可訓練 policy 去擬合這些切斷計算圖的目標。這種安排把目標品質和模型更新分開處理,亦令 supervision 可以隨住模型演化持續刷新。

實作層面,公開版本支援 SD3.5-M 512²,同時覆蓋原生 few-step 的 Z-Image-Turbo 1024² 設定;文件亦提到可做單一 reward 或多個 reward 的加權訓練。原文未提供完整安裝流程或逐步使用指引,只能確認它有項目頁與程式碼釋出,適合自行拉取後依研究環境配置。

它和同類 diffusion reward optimization 的主要分別,在於用 on-policy 查詢配合 EMA 持續重建 supervision,而不是只依賴離線或固定噪聲替代狀態。官方結果聲稱在多個 evaluator 與兩種 backbone 上都有較強的最終 held-out 表現,亦以較少 GPU-hours 完成訓練;這令它特別適合做生成模型後訓練、獎勵對齊與方法比較的研究團隊。

  • 將 image-level reward 轉成可學習的中間目標
  • 用 EMA 反覆刷新 trajectory、anchor 與 target
  • 支援 SD3.5-M 與 Z-Image-Turbo 兩種 backbone
  • 可做單一 reward,亦可做多 reward 加權
  • 適合研究 diffusion 後訓練同 reward alignment 的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 字節跳動, 模型訓練, Image, 影像處理, txt2img, 框架

Rest2Art 用單張靜態觀察重建可動 3D 物件

只見到物件關上的樣子,Rest2Art 仍可推回零件結構與關節。對數碼孿生、模擬和機械人操作都幾實用。

Og image

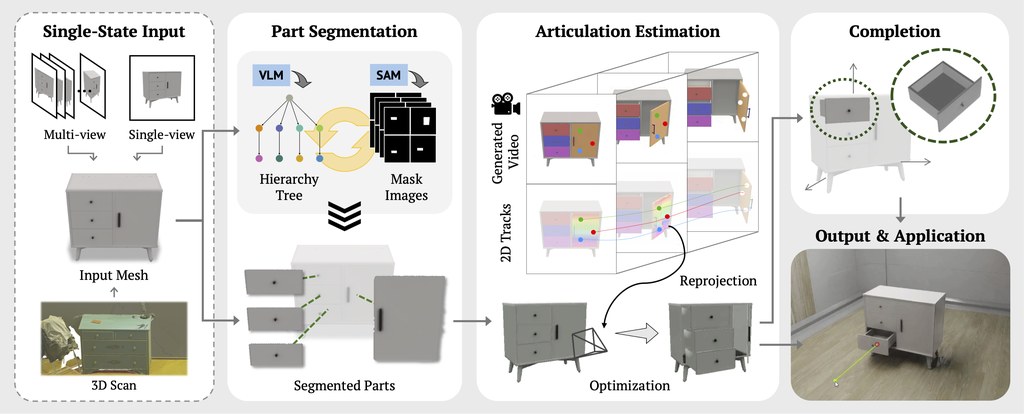
只見到抽屜關上、櫃門未打開,系統仍要估到哪些部分可以動、會沿哪個軸轉或滑,這正是 Rest2Art 想處理的難題。它屬於 articulated object reconstruction,目標是由單一 closed-state observation 重建出可直接放入模擬環境的 articulated asset,而不需要先拍到物件在不同狀態下的運動。

這個做法的價值,在於把原本要靠動態觀察先完成的工作,提前到靜態輸入就處理好。Rest2Art 會先用 vision-language model 與 segmentation model 互相校正零件層級和遮罩,再把結果對應回 mesh;之後再借助 video diffusion model 產生可能的 articulation hypotheses,但真正的 joint parameters 不是直接照抄影片,而是再用幾何一致性去驗證。

回應了一個很現實的限制:很多日常物件未必容易拍到完整開合過程,但建模、模擬與機械人任務仍然需要知道它如何運動。Rest2Art 用 explicit mesh 作為中介,方便跨模型比對與融合,最後再把各部分轉成封閉體積,令輸出不只是「睇得明」,而是可用於 physical simulation。

  • 單靠 single closed configuration 重建 part-level geometry 與 joint parameters
  • 結合 vision-language model、segmentation model 與 video diffusion model 補足缺少 motion cues 的問題
  • 以 explicit mesh 做 cross-model verification and fusion,減少不同模型輸出互相衝突
  • 可輸出 simulation-ready articulated asset,並支援 URDF 匯出

論文描述顯示,它在 reconstruction-based、generation-based 與 modular pretrained-model families 之間,都能做到有競爭力的表現,重建出的零件分解與關節亦具備 physical plausibility。對數碼孿生、虛擬場景整合、real-to-sim-to-real,以及機械人 policy learning 而言,這種由靜態觀察直接產生可互動資產的流程,明顯比只重建外形更進一步。

項目主頁

Categories: 視覺模型, 多模態模型, Video, 影像處理, 框架, 3D, Dataset 數據集

LeapTalk:1 步生成會話數字人

講人像相片同語音,就能連續生成對嘴影片。LeapTalk把速度拉到接近即時,同時盡量守住人臉一致性。

teaser

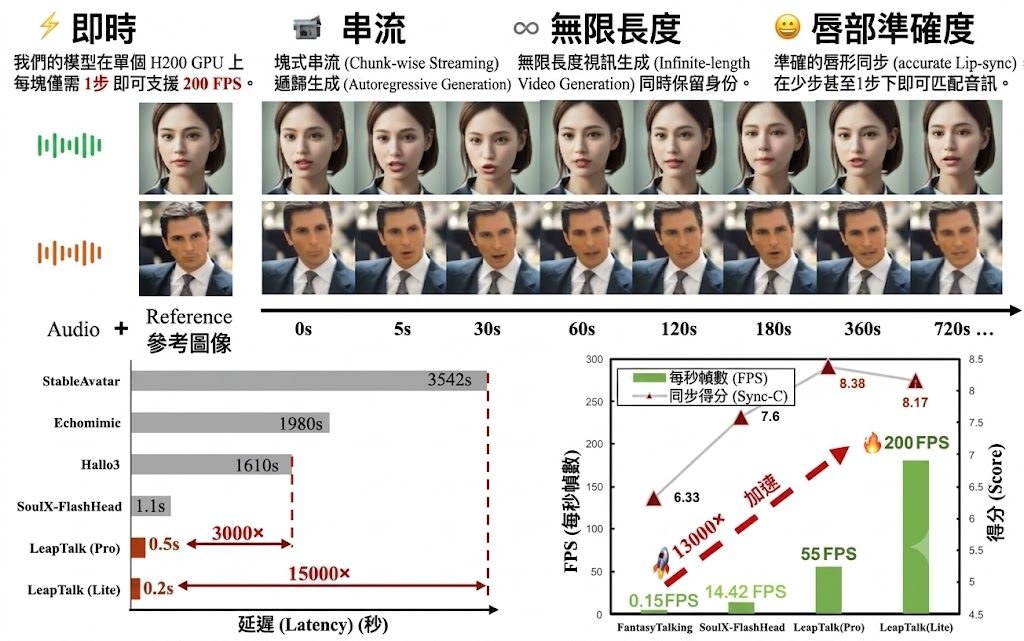
想做會話數字人?卡位通常唔係能否生成,而係夠唔夠快、個樣會唔會愈播愈走樣。LeapTalk屬於開源 talking-head generation 項目,針對的正是即時串流、人臉一致性同嘴型同步三件事一齊要兼顧的難題。

它的吸引力在於每個影片片段只用 1 NFE 就可推進,在 Lite 設定下標示可達 200 FPS,而且 Web Demo 已經做成可載入人像圖、用文字或咪高峰對話的介面。底層並非單靠硬推速度,而是建基於 SoulX-FlashHead-1_3B,再配合 LoRA、audio_proj_step_*.pt、wav2vec2-base-960h,用 audio-driven classifier-free guidance 強化對嘴。

  • 以 chunk-by-chunk streaming pipeline 連續生成長片
  • 用 Brownian bridge 同 Bridge Forcing 減少長片身份漂移
  • README 已交代需另外下載 base model、語音模型與 LeapTalk 權重
  • 推論前要自行填入 COND_IMAGE、AUDIO_PATH 等本地路徑

同類做法常見取捨是速度快但畫面累積誤差,或畫質穩定但延遲高;LeapTalk明顯站在「先把延遲壓到可互動」這一邊,再用 reference-anchored data-to-data transport 補回穩定度。

現適合做數字人互動、虛擬主播、即時內容生成的團隊。200 FPS 與單張 H200 GPU 的說法來自項目提供資訊,普通硬件能否複製同樣效果、Web Demo 的完整部署細節是否齊備,仍要等更多實測佐證。

項目主頁 · GitHub

Categories: 開源, AI productions, 數字人, 視頻模型, 影像處理, Audio

MiniMax H3 萬眾期待的開放多模態模型

文字、圖片、影片同音訊都可混合輸入,再直接生成帶原生立體聲的短片。MiniMax H3把理解與生成放進同一套多模態系統,重點在跨模態一致性。

Og image

一段提示未必只得文字,亦可以連同圖片、影片甚至音訊一齊交畀模型處理;MiniMax H3就是朝住呢種工作流而設。頁面未提供 based on、base model 或 fine-tuned from 資訊,所以無法確認它係唔係建基於其他基礎模型微調而成,但已清楚標示為 image-text-to-video,而且屬於可同時理解同生成多模態內容的 generative system。

它處理的重點不只是由文字生片,而係把 text、images、video、audio 放入同一個上下文,再輸出最長 15 秒、最短 4 秒、可到 2K 的影片,並且附帶 native stereo audio。呢種設計的價值,在於畫面、聲音同指令可以一齊對齊,適合做 image-to-video、video-to-video、text-to-audio-video 以至 reference-to-audio-video 等任務,減少要分開串接多個模型的工序。

H3 是 task-generalization-oriented system,意思是模型在 pre-training 階段已經針對廣泛任務泛化而設計,唔係只為單一路徑生成。它強調 unified understanding of multimodal contexts,同時支援多種輸入來源與輸出規格;比例覆蓋 21:9、16:9、4:3、1:1、3:4、9:16 等常見格式,短邊預設 768 像素,最高可到 2K,反映它偏向面向內容製作與跨媒體生成,而不只是研究展示。

  • 支援 text-to-video、image-to-video、video-to-video,同時覆蓋 audio-video-generation
  • 可生成 4 至 15 秒影片,並輸出 native stereo audio
  • 輸入上下文可混合 text、images、video、audio,屬於 omni-modal 路線
  • Hugging Face 頁面標示 library_name: diffusers,代表可沿用 diffusers 生態整合

現階段較能確定的是,它把多模態理解與帶聲影片生成放入同一模型體系,對需要一致視聽輸出的項目有直接吸引力,但部署細節仍要等更完整技術文件補足。

項目主頁 · 模型

Categories: 開源, 多模態模型, 視頻模型, Video, Image, 影像模型, 影像處理, Audio, 3D, MiniMax

Montara 本地優先影片工作台

想用同一套時間軸管理生成、剪接同輸出影片,Montara 提供咗一條幾務實嘅路。它唔靠單一雲端服務,先確保你能穩定產出真正可播放嘅 MP4。

Montara engine matrix demo preview

做影片流程最麻煩,往往唔係生成一段畫面,而係素材、剪接決定、旁白、輸出格式同後續修改散落喺唔同工具。

Montara 就係朝住呢個痛點而來:一個本地優先嘅開源影片製作工具/框架,用 Timeline IR 做唯一時間軸來源,將規劃、編輯、渲染同交接串返埋。

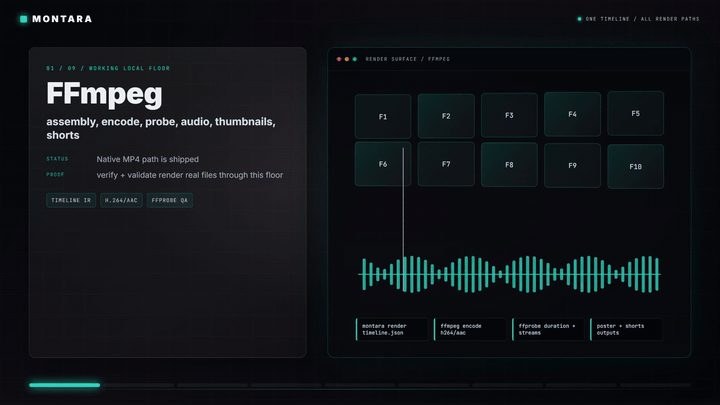
它吸引嘅地方,在於先處理「冇雲端都要交到片」呢個現實限制。就算零 API keys,仍可經 FFmpeg 走本地 fallback 輸出可觀看 MP4,連字幕卡、語音路徑同部分媒體都預留咗本地方案;有裝 Remotion 就做 native smoke,冇裝亦會退回 FFmpeg,呢種設計比起只展示理想雲端流程嘅項目踏實得多。

同類做法常見係綁死某個生成服務或者某款剪片介面,Montara 反而把 provider 放成可插拔層,會建立 request、做 redaction、支援 dry-run 同 live-audit,但付費雲端呼叫要明確開啟。代價亦好清楚:它而家最成熟嘅係時間軸驗證、編輯操作、渲染路徑、editor bridge 匯入匯出,同埋真實 MP4 渲染與 post-render QA;README 亦講明長片規模仍屬 roadmap,唔係所有電影級工作流都已全面驗證。

  • Timeline IR 把場景計劃、剪接決定、匯入 editor cut 同生成素材收斂成一份 JSON
  • 本地路線完整,FFmpeg 係通用底線,部分 video/image/speech/music 有 fallback
  • 可匯出 EDL、OTIO、FCPXML,方便轉去 Premiere、Resolve、Final Cut 繼續做
  • provider 機制重視審計與可驗證性,適合要保留流程紀錄嘅團隊 較受惠嘅會係想把 AI 生成同傳統後期接埋嘅內容團隊、要保留本地控制權嘅創作者,或者打算讓 agent 參與影片流水線嘅開發者。

Montara 已經唔止係 demo 級拼裝,因為它把「可編輯來源」、「真實渲染結果」同「可交畀剪輯軟件接手」放埋同一條線;不過想追求高度成熟嘅長篇製作,仍要留意目前覆蓋範圍主要集中喺已測試嘅 renderer 同橋接能力。

GitHub

Categories: 開源, Agentic, API, Video, 影像處理, 框架, LTX

MPIE-Bench:多人修圖基準

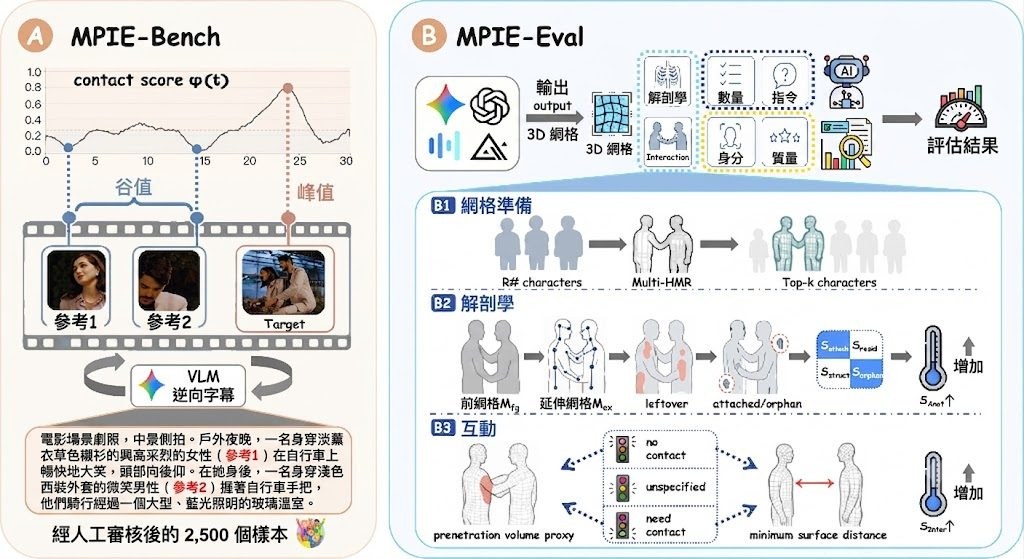
多人影像編輯最易出事的,往往不是畫質,而是人物關係、肢體接觸同身份一致性。MPIE-Bench 把這些難題拆開量度,適合用來判斷模型到底可靠到哪一步。

apple pie icon

當多人影像編輯開始涉及互動動作、身體接觸,例如擁抱、攜帶或擒抱,同多角色參考圖,模型最常翻車的地方就不只是一張圖靚唔靚。MPIE-Bench 屬於基準測試資料集與評分工具,焦點是檢查編輯模型能否在跟從指令之餘,同時保住人物數量、身份一致性、肢體結構同互動幾何是否合理。

MPIE-Bench 不是再做一個生成模型,而是替多人編輯建立較完整的檢查方法。測試集有 2,500 個案例,並按接觸密度分成 C0 到 C3,意思是由沒有接觸到高密度接觸場景都會覆蓋;這種切法有助分辨模型是單純怕多人,還是特別怕擁抱、扶持、碰撞這類複雜互動。

評分設計亦有取向。六個軸線,除了身份、指令遵從、人物數量與整體畫質,亦把 anatomy 和 interaction 拉成重點,並用 mesh-anchored Anatomy / Interaction 來處理較難主觀判斷的部份。對研究團隊或做產品評測的人來說,這比只看美感分數更有參考價值,因為它直接對應多人編輯最容易出錯的位置。

  • 官方提供 2,500-sample test set、evaluation protocol 同 scoring code
  • 重點量度多人編輯中的身份保持、人物數量、動作互動同整體質素
  • 測試案例按接觸密度 C0–C3 分類,方便看清模型失誤模式
  • 可把模型輸出放到指定資料夾,再跑 E2E scorer 完成整體評分

部署資訊已有基本方向,安裝細節放在 docs/INSTALL.md,而且評分流程需要額外權重、環境設定,以及 AI_GATEWAY_URL、AI_GATEWAY_KEY 等配置;單靠儲存庫首頁未足以完整重現全部步驟。另有三個 closed-source baseline 的 frozen judgments,可作對照,但 open-source model dumps 沒有公開,這表示它更適合拿來評測自己的輸出,而不是直接比較所有現成模型結果。

對開發多人影像編輯、角色一致性編輯,或要驗證 VLM、影像生成模型在複雜人物互動表現的團隊來說,MPIE-Bench 的價值在於它把「多人」這件事拆成可追蹤的失敗類型。它未必能代替最終人工審美判斷,但很適合放進模型迭代流程,幫你更早發現哪些能力其實只在簡單場景先成立。

GitHub

Categories: 開源, 視覺模型, 影像處理

SpatialCLI 用空間工具補強視覺推理

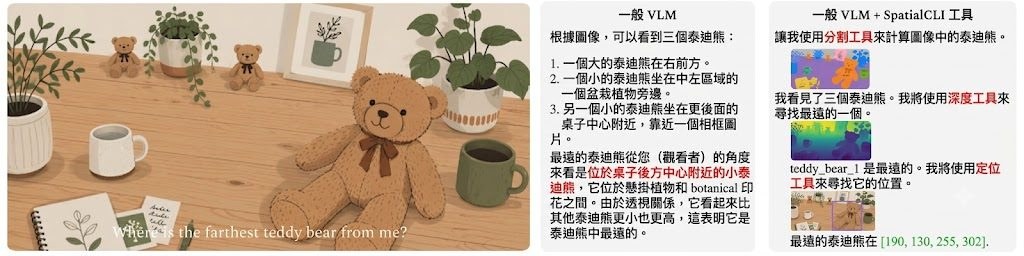
模型唔係睇唔明圖,而係成日差半步先答得準。SpatialCLI 想補上的,正正係定位、分割、深度與姿態判斷呢類容易失手的細節。

A comparison between a general VLM and a general VLM augmented with SpatialCLI tools

一到要指出物件位置、分清遮擋關係,或者估計深度與姿態,純 Vision-Language Model 往往會答到有方向但未夠準。SpatialCLI 把呢個落差處理得幾直接:它不是單靠一個大模型硬撐,而是把空間能力拆開,先讓模型懂得呼叫工具,再進一步把這些能力學回自己身上;整體定位更像一個結合模型、工具鏈與訓練方法的研究項目。

它最有意思的地方,在於三段式 Call-Learn-Internalize。第一步先接上做 localization、segmentation、metric depth、pose 的 specialist vision models,第二步用 Cold-Start SFT 與 agentic RL 訓練模型判斷幾時要用哪個工具、怎樣整合結果,第三步再把成功軌跡轉回模型能力。取向很清楚:寧願先借助外部工具拿到更可靠的局部感知,再追求把能力內化,減少每次推理都依賴外掛模組。

對研究團隊或做多模態 Agentic 工作流的人來說,這個項目值得留意,因為它同時放出 SpatialCLI code、SpatialCLI-8B 與 SpatialCLI-Data,不只是概念展示。理解它的部署方式也不難:代碼庫負責工具調用與訓練流程,Hugging Face 上的模型與資料集則對應推理、微調和重現實驗的核心材料;要完整驗證效果,通常要連同外部空間工具一併配置。

  • 類型上屬於模型加框架的研究項目,目的是提升多模態模型在空間推理上的準確度與工具使用能力。
  • 重點不只在「可呼叫工具」,而是進一步把工具使用經驗轉化成模型本身的能力。
  • 已公開論文、SpatialCLI-8B 與 SpatialCLI-Data,方便重現與延伸訓練。
  • 適合要處理定位、分割、深度、姿態等視覺任務的人員參考其工作流設計。

現有資訊未見 README 完整列出量化結果細節,但評測章節與 specialist models 章節已預留,顯示作者不是把它包裝成單一模型升級,而是把「何時調工具、如何學會不用工具也保留能力」當成核心問題。這種做法的代價也很明顯:系統整合與訓練鏈會比單純跑一個 VLM 複雜,不過換來的是更貼近真實空間任務的推理穩定性。

GitHub

Categories: 開源, Agentic, 視覺模型, 多模態模型, 影像處理

ID-V2V:先拍片後改風格的影像研究

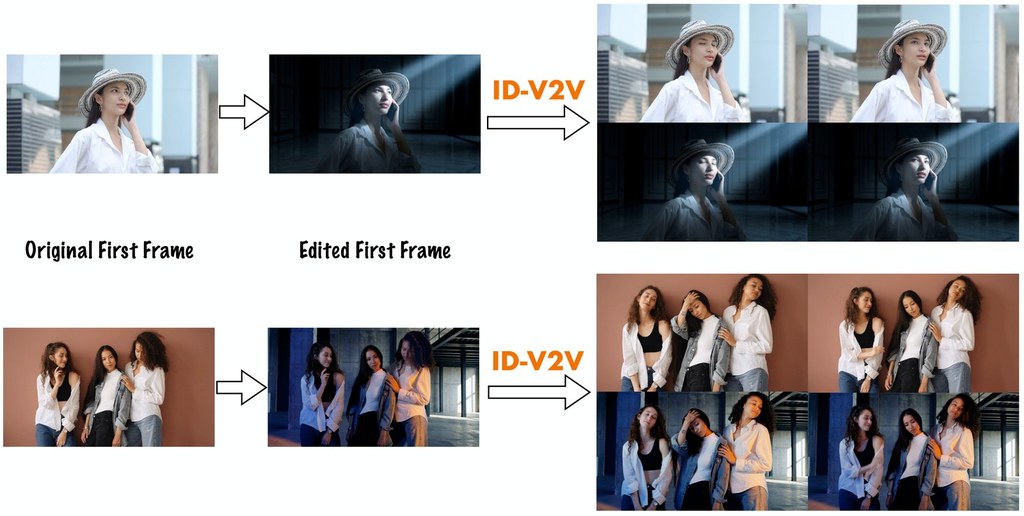
Netflix 與 Eyeline Labs 把焦點放在一件很難的事:換掉影片風格與光線之餘,角色樣貌和表演仍要留得住。ID-V2V 正是朝這個製作流程而來的研究項目。

ID-V2V teaser

開發團隊來自 Netflix 與 Eyeline Labs。這個研究項目瞄準影像製作中最棘手的一段流程:想改影片風格、場景氣氛甚至補做光線,但又不想犧牲演員的表情、眼神、口型同步和肢體動作;ID-V2V 屬於 video-to-video 生成框架,處理的正是這種「保留身份與表演、再把風格傳播到整段影片」的問題。

現有做法常把影片重繪理解成一般風格轉換或逐格生成,作者認為這種範式很難同時守住 facial likeness 與細微 performance。ID-V2V 的切入點是把 identity preservation 重新表述成 video relighting,再把 edited keyframe 帶來的風格變化交給 controlled video synthesis 處理,並結合 relit facial regions、facial normal maps、edited keyframes 與 depth sequences,將身份約束與整體畫面變化拆開處理。

這個取向的價值很直接:你先拍好 source video,再準備一張 stylized keyframe,系統便嘗試把光線、場景與風格延展到整段片,同時盡量守住人物。原始資料亦提到 imperfect keyframe 的情況,即使首張風格幀和原片姿勢未必完全對齊,模型仍會在之後的幀數重新貼近 source video 的身份與表演,這點比只追求單幀好看更貼近製作流程。

  • 提供兩個模型變體:idv2v 以及加入 normal-depth 訊號的版本
  • preprocess → generate 的推理流程與輸入輸出結構
  • 環境集中在單一 uv 環境,另需下載多個 checkpoints,預設資源需求相當高
  • 已測試於 8× A100-80GB,代表它較接近研究與製作級部署,不是輕量玩具
  • 項目定位寫得很清楚,只供 demonstration and inspiration purposes

部署與測試資訊算完整,提供環境設定、checkpoint 下載、推理流程和多種案例,但門檻不低:需要 Python 3.10、torch 2.6+cu118、SAM3 權限,以及連同 Wan2.1 相關元件在內的大量模型檔案。性能方面,項目與首頁都表示在 preserving facial likeness 與 fine-grained facial performance 上明顯優於既有方法,並支援 single-subject 與 multi-subject 場景。

項目主頁 · GitHub · Paper

Categories: 開源, Video, 影像處理, Python, Dataset 數據集

Microsoft Mage:4B 多模態輕量路線

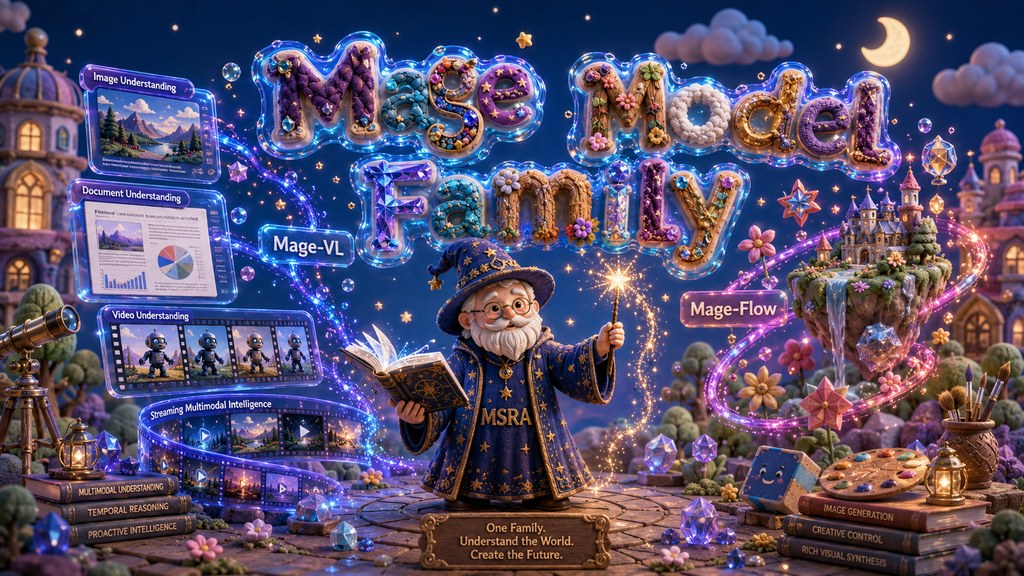
想做影像生成、編輯,甚至進一步研究多模態模型,但運算資源有限,Mage 會係一個值得留意的方向。它把 4B 規模壓到夠細,同時仍然追住更大模型的表現。

gallery

當你想喺有限 GPU 預算下做影像生成、編輯,甚至延伸到影像與影片理解,Mage 這個開源模型家族的定位就相當直接:用固定 4B 參數規模,處理多模態理解與生成兩條路線,目標唔係堆大模型,而係保留研究可控性同部署可行性。

Mage 目前最完整的是 Mage-Flow,屬於模型家族中的生成與編輯分支。它把 Mage-VAE 同 Native-Resolution Multimodal Diffusion Transformer 組合起來,前者負責更高效率的 latent tokenizer,後者負責文字生圖與指令式修圖;同時提供 Base、RL-aligned 同 4-step Turbo 版本,方便按畫質、對齊程度與速度取捨。另一條線 Mage-VL 對準 image/video understanding,但程式與權重細節仍待釋出。

同類開源影像模型很多都靠更大參數量換效果,Mage 的判斷明顯不同:它把重點放喺 codec-aligned efficiency,同一個 checkpoint 已可覆蓋 512 到 2048、不同長闊比,連 4:1 這類極端尺寸都原生支援,減少多套模型或額外縮放流程。它在生成、編輯表現上可與 Qwen-Image 20B、FLUX.2 32B、FireRed-Image-Edit 20B 等較大型開源系統競爭,但取捨是 Mage-VL 仍未完整開放,整個家族現階段更適合關注研究與工作流整合的人先行評估。

Super fast Image Edit model Mage-Flow on 8GB VRAM
  • 固定 4B 規模,主打可訓練、可微調、可部署
  • Mage-Flow 已覆蓋 text-to-image 與 instruction-based image editing
  • Mage-VAE 以更低 encode/decode MACs 減輕高解析度瓶頸
  • 單一 checkpoint 支援 512–2048 與多種 aspect ratio
  • Turbo 版本強調速度,1024² 在單張 A100 有明確推理數字

部署與測試方面,現有資料顯示 Hugging Face 已提供多個 Mage-Flow 與 Mage-Flow-Edit 權重,適合先用現成 checkpoint 驗證生成、修圖與速度,再決定是否進一步做微調。對做垂直領域影像項目、想研究後訓練方法,或者需要把高解析度生成放入較實際算力條件的人,Mage 的吸引力不在花巧包裝,而在它用一條輕量路線,把研究、性能與部署成本拉回較平衡的位置。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 多模態模型, Qwen, 微軟, Stable Diffusion, Video, Image, 影像模型, 影像處理, txt2img, Medical醫學

Page 3 of 22
1 2 3 4 5 … 22