FoMo 不用人手標註,讓影像更貼近感知

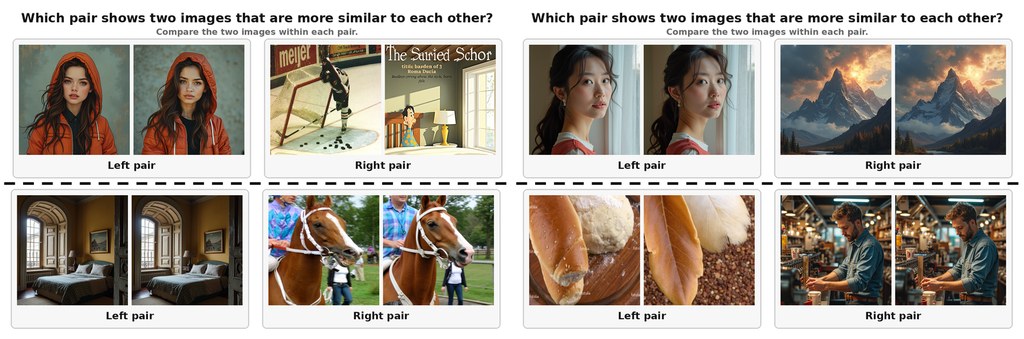
FoMo 借助 diffusion model 生成由淺入深的影像變體,免除大量人工標註,訓練出可比較兩張圖片感知差異的模型。

FoMo: data generation from the forking moment of the diffusion trajectory, and ranked-BCE training

比較原圖與修改版本時,像素差異未必等於人眼感受到的差異。FoMo 以 reference-based perceptual distance metrics(參考式感知距離模型)處理這個問題,透過 FLUX.1-dev 的 img2img 軌跡製造有次序的影像變體,並以此訓練影像品質評估(image quality assessment,IQA)模型,屬於開源模型項目。

它的關鍵做法,是在 diffusion model 的去噪流程中,於不同 denoising steps 重新接回生成軌跡。重新接入得越早,生成圖與原圖的感知偏離通常越大;這個 forking moment 便提供了密集而有排序的監督訊號。項目用 480k 組影像資料配合 pairwise ranking objective,減少依賴人手逐張標註的成本。

項目提供七個模式,涵蓋 LPIPS、DISTS、DreamSim,以及以 frozen DINOv3、CLIP、MAE backbone 配合 prediction head 的版本。DreamSim 透過 LoRA adapters 微調,而 dinov3、clip、mae 會把兩張圖片按次序讀入同一組 token;預設會計算兩個方向的平均分,處理輸出可能不對稱的問題。

  • lower score 代表兩張圖片更相似,raw 輸出也是公開評估採用的數值
  • output=’loss’ 可提供以 identity pair 為錨點的 perceptual loss
  • CNN 類模型使用固定 256px crop,DreamSim 使用固定 224px crop
  • DINOv3、CLIP、MAE 支援 64 至 256px 隨機裁剪,並以 zero-padding 和 attention masking 組批
  • 項目可透過 Python 套件 fomo-iqa 載入預訓練模型,直接比較參考圖與測試圖

FoMo 適合需要自動判斷生成圖片、編輯版本或重建結果相似程度的研究者與影像工具團隊。它的限制也很清楚:訓練訊號來自 FLUX.1-dev 的生成軌跡,不能直接等同人類偏好;不同 backbone 的輸出形式、裁剪策略與對稱處理亦會影響比較結果,因此應按工作流程選擇模型並自行驗證。
項目主頁 · GitHub

Categories: 開源, 模型訓練, Image, 影像處理, 工具, LoRA

Qwen-Image 2.1 四步生成加速,但複雜編輯仍未完善

Viggle 將 Qwen-Image 2.1 蒸餾至四步生成,換來速度提升,同時保留編輯能力上的取捨。

Og image

面對需要較快出圖、又要按文字指示修改圖片的場景,Qwen-Image-2.1-viggle-turbo 把原始 Qwen/Qwen-Image-2.1 由 40 次 Transformer passes 壓縮至 4 次,支援 text-to-image 及 image-to-image 編輯,亦可配合 1 至 3 張參考圖。模型屬於基於 Qwen/Qwen-Image-2.1 的 adapter 項目,由 Viggle 使用 Distribution Matching Distillation(DMD)訓練,並取消 classifier-free guidance。

項目提供兩個學生模型,取捨集中在下載體積與編輯精準度:

  • transformer/:完整微調的 bf16 Transformer,約 14.2 GB,會取代基礎 Transformer;頁面目前推薦這個版本,質性比較中編輯更忠實。
  • Qwen-Image-2.1-viggle-turbo-4step-lora-r64.safetensors:rank 64、約 340 MB 的 LoRA adapter,載入基礎 Transformer 後運行,下載較快但效果稍弱。
  • peft/:同一 LoRA 的 PEFT key format、F32 權重;LoRA 不會合併入 Transformer,運行時載入可避免 bf16 合併造成的損失。
  • text encoder、VAE 及 processor 沒有隨項目重新發布,會從基礎模型儲存庫載入。

完整微調版本的 DMD objective 加入 low-frequency teacher anchor,兩個版本都是各自訓練流程的 step-400 EMA checkpoint。Text-to-image 在四步下已具可用性,但 v0.1 仍是 preview;多參考圖合成、換臉、保留身份,以及同時包含多項限制的指令,明顯不及原本 40 步的 base model,因此不能視為完整替代品。

因為 QwenImage21Pipeline 尚未納入已發布的 diffusers;同時要安裝 peft、PyTorch、Transformers、Accelerate、Safetensors 及 Pillow。提供內容沒有 GGUF 檔案、GGUF 檔案大小、量化級別、mmproj、上下文長度、Ollama、LM Studio 或 llama.cpp 支援資料,亦沒有 MTP draft speculation 或正式 benchmark 數字;硬件需求只能按完整 Transformer 約 14.2 GB bf16 權重另行規劃。

模型

Categories: Qwen, Image, 影像模型, 影像處理, txt2img, Python, 庫, Dataset 數據集, LoRA

ImIR 免提示詞處理六類影像修復,

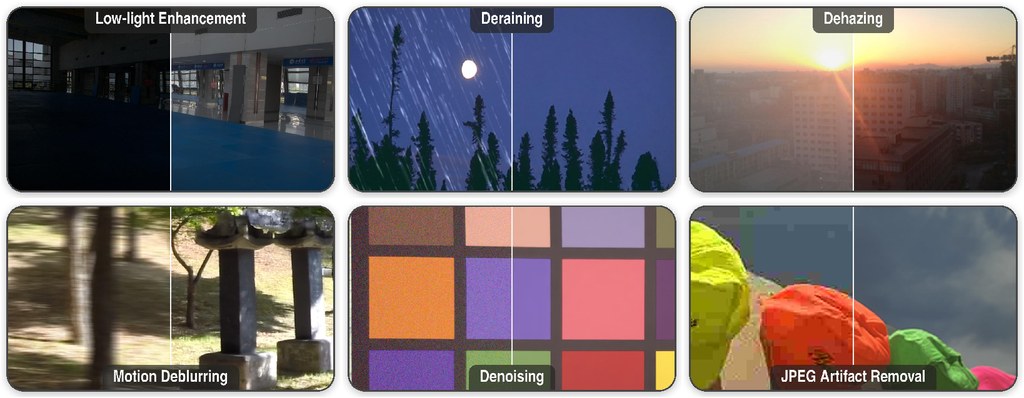
ImIR 讓同一個影像修復模型自行判斷輸入問題,毋須提示詞或降級標籤,涵蓋六種常見修復工作。

ImIR examples for low-light enhancement, deraining, dehazing, deblurring, denoising, and JPEG artifact removal. Each til

遇到低光、雨痕、霧化或 JPEG 壓縮痕跡時,ImIR 會只從輸入影像推算修復指令,不要求使用者先判斷問題類型。這個項目屬於影像修復模型與推理工具,實際處理的是一個模型難以同時應付多種退化、又依賴文字提示詞的工作流程。

ImIR 把影像分成兩條路徑送入 Qwen-Image-Edit-2511:VAE 保留空間結構,Qwen2.5-VL 配合輕量 token mapper 產生接近乾淨影像的語義指令;主幹模型保持凍結,只訓練一個共享 LoRA adapter。指令強度可以調節,低光增強等答案不唯一的任務,因而能在不同修復程度之間取捨。

項目提供 CLI 和 Python API,使用 Python 3.10 或更新版本、具 CUDA 能力的 NVIDIA GPU,並可從 Hugging Face 自動下載 checkpoint。顯存不足時可啟用 CPU offload,但需要足夠系統記憶體。

  • 一個 adapter 覆蓋除雨、低光增強、去霧、去模糊、去噪及 JPEG 瑕疵移除
  • 不需要文字提示詞,也不需要 degradation label
  • 單一 adapter 約三小時、以一張 GPU 完成訓練
  • 匹配比較中,影像指令優於文字 conditioning

對研究人員而言,這種做法適合測試 task-agnostic restoration;影像處理團隊則可用它簡化多任務推理流程。不過項目需要 NVIDIA CUDA 硬件。

項目主頁 · GitHub · 模型

Categories: 開源, Qwen, NVIDIA, Image, 影像模型, 影像處理, Python, LoRA

Mira-Scene 單張圖片重建可編輯 3D 場景,讓畫面變成可拆解空間

Mira-Scene 將單張圖片拆成物件、深度與環境,再組合成可編輯 3D 場景,降低由 2D 畫面建立空間內容的門檻。

Mira-Scene teaser

由一張圖片開始,Mira-Scene 能分辨場景內的物件、估算深度,再為各物件建立網格並組合成可編輯 3D 場景。它屬於單圖 3D 場景重建模型與推理項目,處理的是影像缺乏空間結構、物件難以獨立編輯的問題,適合概念設計、虛擬場景和後續模擬工作。

完整流程包括互動式 instance segmentation、monocular depth estimation、canonical coordinate map(CCM)、voxel prediction、逐物件 mesh generation、支援物件接觸關係的 scene assembly,以及 environment-map generation。Hugging Face 提供的 CCM diffusion checkpoint 只負責其中一個階段,並不是可直接輸出 GLB 的獨立 image-to-3D 模型;分割遮罩、mesh backend 和場景組裝階段仍要配合使用。

Mira-Scene 採用分階段推理,支援中斷後繼續執行、多個深度及網格後端,亦可按個案分配多張 GPU。使用者可依照中文 inference、visualization 和 evaluation 指南準備輸入圖片及遮罩,再檢視各階段產物;訓練程式碼和示例訓練數據仍列在待辦事項,研究用途以外需要自行處理環境和模型資源。

• 單張圖片重建可拆解的 3D 場景
• 以 CCM 和稀疏 voxel 表示物件空間結構
• 對比 SAM3D,3D-IoU 為 0.727,較 0.520 高
• 部分指標領先,但 EMD 略遜於 SAM3D
• 開源推理流程完整,訓練部分尚未公開

評測表中,Mira-Scene 使用 80k 規模、全自動流程的數據,CD、FS@0.1、3D-IoU、ICP-Rot、2D-IoU 和 ADD-S 均優於 SAM3D;EMD 則為 0.169,稍高於對方的 0.163。這反映它在整體形狀、投影對齊和姿態誤差上具競爭力,但不能把單一圖片重建視為完整真實世界掃描,遮擋、不可見背面和網格後端仍會影響結果。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 影像處理, 3D, 蘋果

Qwen-Image-2.1 開源:透明圖層生成與多圖編輯

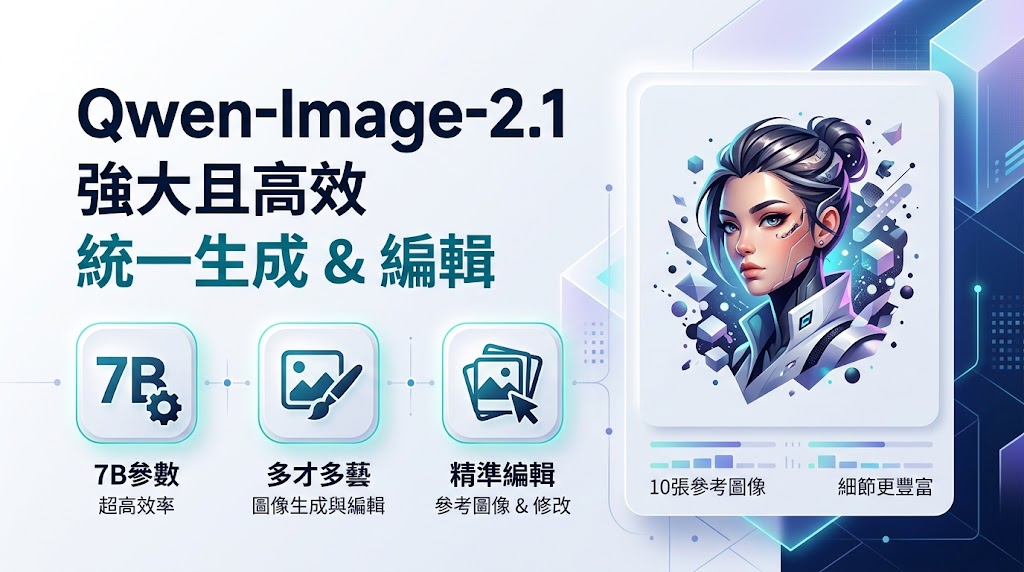
7B 參數的 Qwen-Image-2.1 把文生圖、圖片編輯、透明背景生成整合在同一個模型,一次可參考 10 張圖片,門檻不高但功能更齊全。

在 AI 繪圖的世界裡,能同時處理文生圖、改圖、還能直接輸出透明背景圖的開源模型並不多。Qwen 團隊這次開源的 Qwen-Image-2.1,把這幾件事整合進同一個 7B 參數的視覺生成模型,使用時不需要切換不同模型或額外加工。對做貼圖、做商品圖、做素材整理的人來說,這種「一個模型走到底」的做法很貼合日常工作流。

模型採用 32 層 Single-Stream DiT 結構,配合混合粒度注意力與 prefix KV cache 復用,把運算成本壓低。即使在顯示卡記憶體有限的環境下,仍能輸出品質不錯的圖片;Apple Silicon 用戶也能用 MPS 加速跑得動。

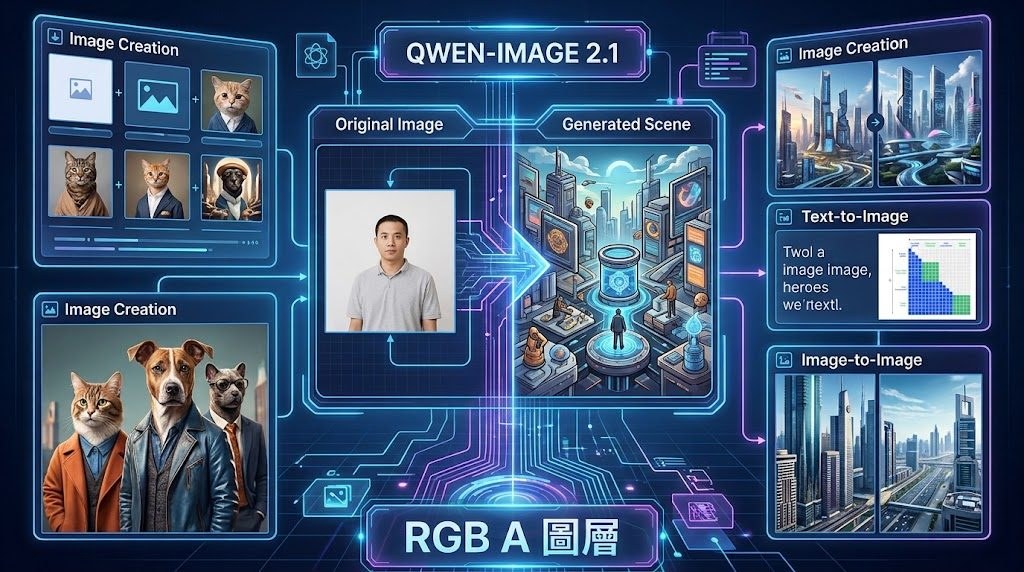
Qwen-Image-2.1 對透明背景(RGBA)的處理是這次的亮點之一。文字描述可以直接生成帶 Alpha 通道的圖,也能把照片裡的主體分離出來變成透明底,省去摳圖步驟。編輯功能同樣豐富:最多可同時參考 10 張圖片,用圓圈、塗鴉或遮罩標記局部修改位置,並在人物、產品場景保留識別特徵,避免改一處卻跑掉整個主體。

Og image

文字渲染和人像光影也比上一代細緻,招牌、卡片、海報一類需要清晰排字的場景更實用。整體定位偏向「夠用、好用、可商用」的工具型模型,不是衝榜級的影像模型。

重點摘要

  • 統一模型:文生圖、圖片編輯、RGBA 透明圖生成整合在同一個 7B 參數模型
  • 高效率架構:32 層 Single-Strteam DiT,搭配混合粒度注意力與 prefix KV cache 復用
  • 多圖參考編輯:最多支援 10 張參考圖,可用圓圈、塗鴉或遮罩指定修改區域
  • 主體保留:在人物、產品場景保持識別特徵,不會改一處就全跑掉
  • 透明背景原生支援:可文字直出 RGBA,也能從照片分離主體成透明底

模型已在 Hugging Face 開源,並提供 Diffusers 整合程式碼、Google Colab 與 Kaggle Notebook,Apple 用戶亦可透過 Draw Things 或 DiffusionBee 等本地 App 直接試用。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Qwen, Google, Image, 影像模型, 影像處理, txt2img, 蘋果

GPT-Policy 把 VLM 變現場教練

GPT-Policy 讓固定的視覺語言模型在現場讀懂示範影片、目標圖與互動回饋,直接輸出可執行的機械臂動作,省去微調與重訓成本。

GPT-Policy wordmark

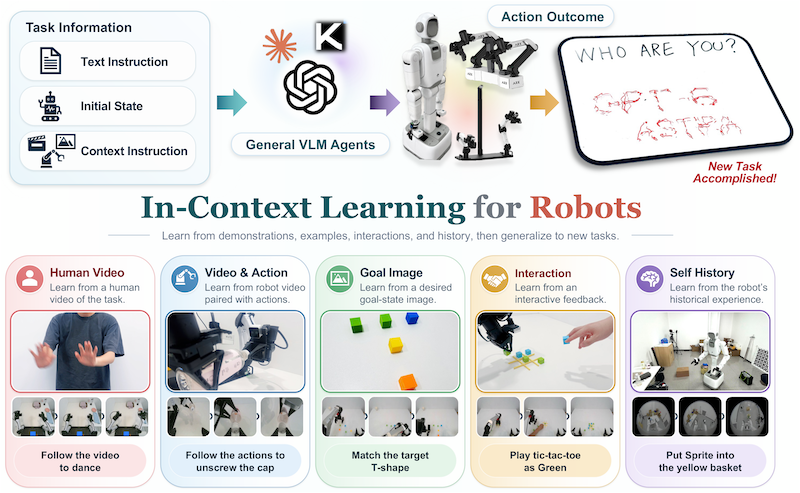
機械臂要適應新任務,傳統做法往往是收集大量數據再微調模型,成本高且迭代慢。GPT-Policy 走另一條路:保留一個固定的視覺語言模型(VLM)作為決策核心,現場把任務指令、示範影片、目標圖像、過往觀察與執行回饋打包成單一輸入,讓模型一次輸出一個結構化動作請求,再交給專屬的硬件適配器(adapter)驗證並執行。

的關鍵在於「context compiler」與「constrained controller」的分工。前者負責保留示範中與任務相關的視覺轉折,後者則檢查動作是否安全、可執行,並回報結果給 VLM 進入下一輪決策,整個過程沒有梯度更新,也不需要為新任務調整參數。對於 ARX X5 與 I2RT/YAM 兩款機械臂平台,項目已提供對應的適配器,支援笛卡兒目標、waypoint 序列、順序 IK 檢查、夾爪控制,以及 append-only 的運行記錄,方便日後追溯。

從結果來看,團隊在真實機械臂試驗中發現,即使只有人類影片而無機械臂動作標記,GPT-Policy 仍能改善任務完成率;若加上對齊的動作參考,表現會進一步提升,尤其在接觸敏感的任務上更明顯。對比同類做法,GPT-Policy 沒有走端到端策略網絡的路線,而是把通用 VLM 的推理能力當作即插即用的策略模組,取捨是更依賴適配器與閉環回饋的工程品質。

適合使用的場景包括:研究 VLM 與機器人結合的團隊、需要快速讓機械臂適應新任務示範的實驗室,以及想評估「不重訓」路線可行性的工程團隊。目前的限制在於硬件覆蓋仍集中在兩款臂,且效能高度取決於上下文編譯器能否保留關鍵視覺資訊。

重點摘要:

  • 固定 VLM 即決策核心:不微調、不重訓,靠現場上下文即時生成動作
  • context compiler + controller 雙層架構:前者保留任務相關視覺轉折,後者驗證並執行
  • 支援 ARX X5 與 I2RT/YAM:提供笛卡兒目標、IK 檢查、夾爪控制等適配器
  • 人類影片已能改善任務成功率:對齊動作參考後表現更穩,尤其接觸敏感任務
  • 定位為研究框架:適合探索通用模型在實體機器人上的即時學習能力

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, Video, Image, 影像處理, Robotic, 框架, 安全

TempCloze:揭開 Video-LLM 的時間盲區

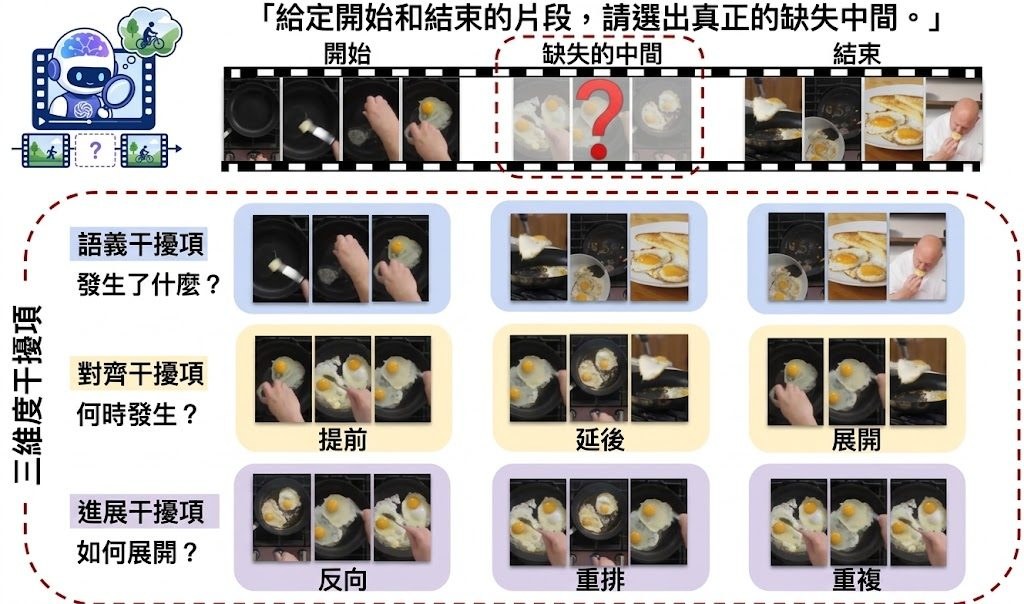
TempCloze 是一個專門測試 Video-LLM 視覺時間推理能力的影片填空基準,從七個來源收集 1,521 條長鏡頭與第一人稱影片,挑戰模型能否在四選一中找回正確的「消失中段」。它直接揭示現有模型在時間對齊上的明顯短板。

Overview of the TempCloze benchmark

TempCloze 的玩法相當直觀:給一段影片的開頭與結尾,要求模型從四段候選片段中挑出真正屬於中間缺失的那一段。四個選項全部來自同一條影片的素材,連文本線索都壓到最低,等於逼模型只能用眼睛去判斷時間先後與事件流暢度。

這套基準特別針對三個時間維度:語義(Semantic,考「發生了什麼」)、對齊(Alignment,考「應該在何時發生」)、推進(Progression,考「事件如何展開」)。對齊的干擾選項設計得很巧妙,例如把同一段內容前移、後移或拉長;推進維度則把片段倒播、重排、重複,看模型能否識破。題目素材刻意挑選長鏡頭與第一人稱影片,避免靠剪輯或場景切換就能蒙混過關。

跑完 31 個 Video-LLM(10 個閉源加 21 個開源)後結果很殘酷:無論是 GPT 類還是開源權重,模型在對齊任務上的準確率幾乎腰斬,閉源平均從語義 70.73% 跌到對齊 48.13%,開源平均更只剩 26.54%。相比之下,人類在嚴格協議下仍能達到 97% 平均正確率。換言之,現在的 Video-LLM 對畫面在時間軸上的位置幾乎沒概念,只能靠語義關聯硬猜。

對於做影片理解、embodied AI、多模態基準研究的人來說,這份工具包很值得關注。它提供統一抽幀協議(每段 16 幀,六片段題 96 幀),評測流程可直接套用,重點在於指出時間對齊才是視頻推理的真正瓶頸,數字與圖表都已經整理好。

重點摘要:

  • 任務設計:四選一影片填空,所有干擾項來自同一條原片,消除文本捷徑
  • 三維度考核:語義、對齊、推進,分別測事件、位置、展開方式
  • 數據規模:1,521 條影片,長鏡頭與第一人稱為主,七個公開來源
  • 核心發現:對齊維度是最大瓶頸,開源模型跌至 26.54%,閉源亦僅 48.13%
  • 工具價值:統一抽幀協議與評測腳本,可直接比較現有 Video-LLM 在時間推理上的差距

GitHub

Categories: 開源, Agentic, 模型, 視覺模型, Video, 影像處理, 框架, 工具

FFmpeg 變身 AI Agent 影片剪輯師:28 個工具全程本地執行

ffmpeg-skill 為 Claude Code、Cursor、Codex 等編碼代理補上影片剪輯能力。28 個結構化工具涵蓋剪接、字幕、HDR 轉 SDR、多機位等流程,全程本地運作、不上傳素材。

FFmpeg Skill: media processing for AI agents

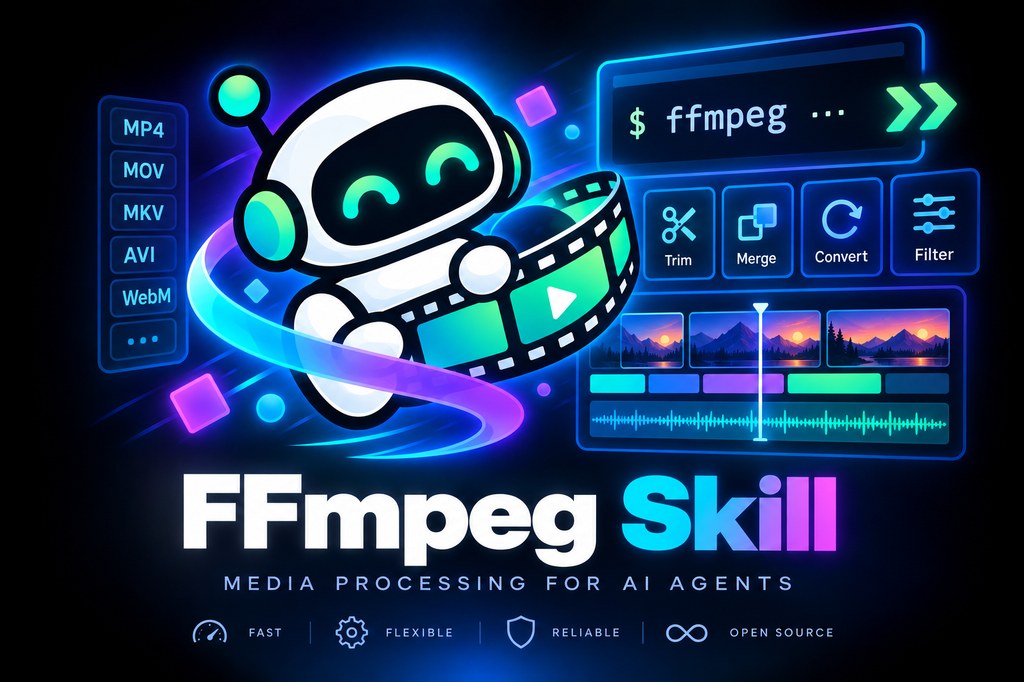
很多時候,你想叫 AI 幫你剪片、抽音、轉格式,但手上的影片根本不想上傳到雲端。ffmpeg-skill 就針對這個卡位——它不是模型,而是一套 Agent Skill,把 FFmpeg 包成 Claude Code、Cursor、Codex 或任何讀得到 SKILL.md 的代理都能用的工具集。只要機器裝好 ffmpeg 和 Python 3.9+,整套 28 個工具就能離線跑。

它跟一般「叫 AI 寫 ffmpeg 指令」的做法最大分別,在於每個工具都是帶型別參數的腳本,並非丟一段 shell 字串給模型拼裝。代理會先用 probe.py 量度時長、幀率、解析度、色彩和音軌,再依結果決定怎樣剪,文件名稱完全不被當成依據。輸出之後,結果會再被 probe 一次、比對目標規格,畫面有動過的話甚至生成 contact sheet 做肉眼覆檢。

工具覆蓋的工序相當完整:剪接、合併、去靜音、配合時長與比例、字幕與卡拉 OK 效果、overlay 與 motion graphics、HDR 轉 SDR 及 LUT、音頻清理與動態處理、含飄移修正的同步、多機位、響度校準、交付檢查、批次資料夾。音訊部分可從影片直接抽出、淨化,甚至指定軌號。而整組工具既是 CLI 也是 MCP tool,並由一份 machine-readable contract(SPEC)描述——CLI 的 argparse parser 同時衍生出 input_schema 和 MCP 定義,CI 會在規格漂移時自動失敗。

影片從業人員、剪接助理,或者任何需要把 FFmpeg 操作交給 AI 代理、又不想把素材外流的團隊,都會較易受惠。對一般開發者而言,這也是少數把 SPEC 概念實踐到「CLI 即 schema」程度的開源項目。

GitHub

Categories: 開源, Agentic, AI productions, MCP, Video, 影像處理, Audio, 工具, Python, Skill 技能

MMLVE-Agent 點樣唔再搞亂多鏡頭影片

過往 AI 影片編輯碰到多鏡頭長片就容易認錯人、漏改背景。MMLVE-Agent 用 LLM 與 VLM 協作,把每個鏡頭拆開處理,再靠全局記憶鎖住主體身份。

MMLVE-Agent framework

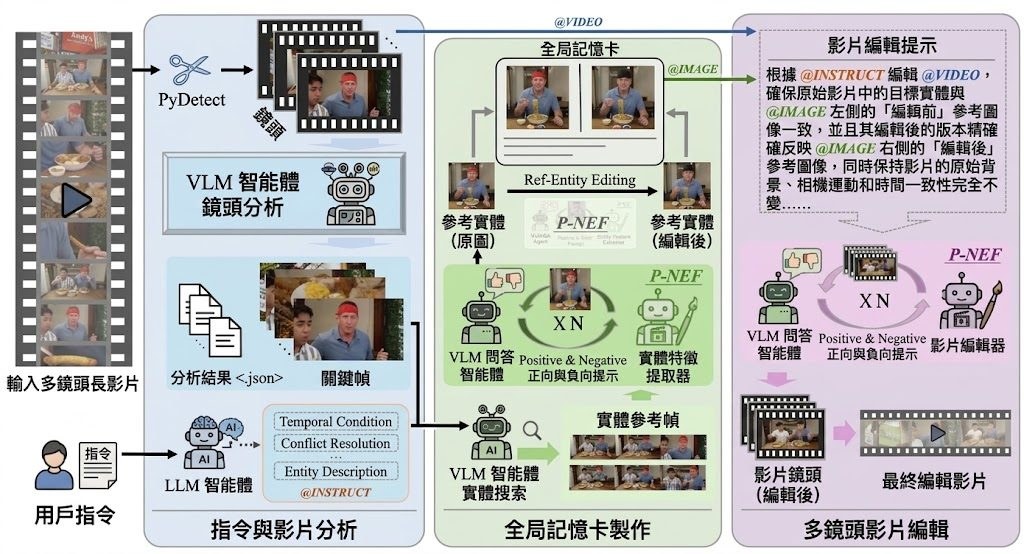
用一句「將男人嘅紅色衫變成藍色」就改完成條片、每個鏡頭都認得返同一個人——呢個係南開大學同騰訊團隊提出嘅 MMLVE-Agent 想要解決嘅痛點。過往影片編輯模型主要處理單鏡頭或幾秒短片,落到幾分鐘、橫跨多個鏡頭嘅長片就容易出現主體身份斷裂、編輯幻覺同時間連續性受損。呢個項目本質係一個異構多智能體框架,結合 LLM 做指令解析、VLM 做鏡頭級拆解同評估,再透過全局記憶卡(Global Memory Card)將 top-k 關鍵幀合成統一參考,確保主體身份唔會跨鏡頭走樣。

團隊同時定義咗 MMLVE 任務嘅三個核心目標:跨鏡頭編輯一致性(CSEC)、多指令解耦(MID)以及對非目標區域嘅零破壞(ZDSS)。其中 Pos-Neg Editing Feedback(P-NEF)令 VLM 評估器可以同時輸出負向提示同正向提示,主動修正錯誤同時保留應有細節,取代坊間常見嘅單向反饋機制。佢哋亦同步推出 MMLVE-Bench 數據集,涵蓋密集異質指令同稀疏隨機分佈嘅實體,對應真實影片剪接場景。

團隊聲稱喺呢個基準上超越咗 Seedance 2.0 等閉源方案,特別喺消除編輯幻覺同保持時空連貫性方面。不過要留意,原始資料只提供項目頁、論文同 benchmark 數據集,並無公開模型權重或安裝入口,想實際部署嘅讀者需要留意後續開源進度。

重點摘要:

  • MMLVE-Agent 係一個多智能體影片編輯框架,專門處理多鏡頭長片嘅自然語言指令編輯
  • 核心創新在於全局記憶卡同正負反饋機制,前者鎖定跨鏡頭主體身份,後者主動修正編輯錯誤
  • 同步推出 MMLVE-Bench 數據集,涵蓋高密度指令同稀疏實體分佈等真實場景
  • 團隊報告在自建基準上超越 Seedance 2.0 等閉源方案
  • 原始資料未提供模型下載或部署方式,實際可用性有待後續開源進度確認

項目主頁 · GitHub

Categories: 開源, 騰訊, Agentic, 視覺模型, 影像處理, Dataset 數據集

[影片教學] 利用開源探索 3D 世界

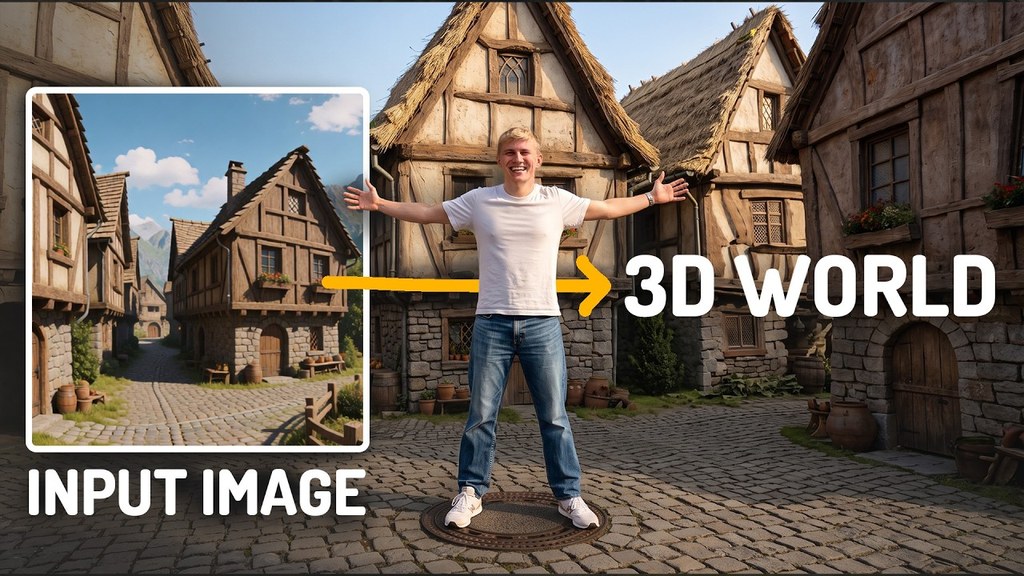
這個開源項目讓你用一張圖或一段文字 prompt,在本地免費生成可自由行走的 3D 世界,毋須依賴雲端服務。

Og image

過往要把一張圖變成可探索嘅 3D 場景,往往需要動用雲端 GPU 或者封閉式商業工具。一個新開源嘅世界生成項目反其道而行,主打「本地、免費、完全開源」,用家只需要餵一張圖片,或者寫一段文字 prompt,就可以產出一個可以行入去慢慢逛嘅 3D 場景。對遊戲開發、空間設計或者 VR 內容創作嚟講,呢種「零門檻起手」嘅流程可以省卻大量建模時間。

同一般文生圖或者文生影片模型唔同,呢類世界生成系統要處理嘅唔係單一畫面,而係保持視點一致嘅連續空間。背後通常會結合影像生成、深度估計同體積渲染(volumetric rendering)等幾組技術,再用 NeRF(Neural Radiance Fields,神經輻射場)或類近嘅 3D 表徵方式重建場景,等用家可以即時改變視角行入去睇。

對玩家嚟講,最直接嘅體驗係輸入一張京都街景相或者一句「霧夜嘅科幻實驗室」,幾分鐘之後就有一個可以操控角色行入去嘅小型世界;對開發者嚟講,由於整套工具鏈都係本地行得通,唔使擔心 prompt 或者素材被上傳到第三方伺服器,私隱同成本都較易掌控。

不過本地跑呢類模型對 GPU 仍然有要求,視訊記憶體唔夠嘅話生成時間會明顯拉長;另外世界嘅規模同互動深度仲未去到遊戲引擎嗰種水平,比較適合作為概念驗證或者素材起手稿,而唔係完整場景嘅最終方案。

以下係幾個值得留意嘅重點:

  • 支援圖生世界(image-to-world)同文生世界(text-to-world)兩種入口
  • 完全開源,可在本地離線運行
  • 採用神經輻射場或類近技術做 3D 重建,保持視角一致
  • 私隱同成本上比雲端方案更具優勢
  • 對 GPU 仍有要求,目前較適合做概念驗證階段

項目主頁

Categories: AI productions, 世界模型, Image, 影像處理, 教學, 3D

Page 2 of 22
1 2 3 4 … 22