ReDesign 把平面圖轉為可編輯設計

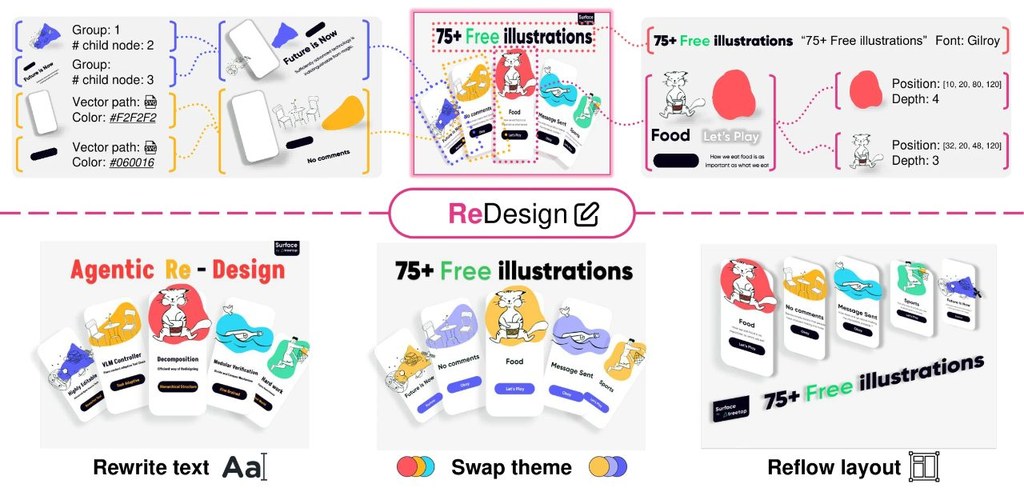
ReDesign想做的,就是把一張匯出圖,文字、圖層轉成獨立像素圖層結構,重新變成可編輯設計。

Repository image for jintae-00/ReDesign

設計原檔遺失之後,最麻煩唔係畫面睇唔到,而係改唔到字、拆唔開圖層、調唔到前後次序。ReDesign屬於Agentic取向的研究型工具,目標係由單張 raster image 重建出可編輯設計結構,輸出成帶有文字、向量形狀、群組同 z-order 的 JSON hierarchy。

它的判斷方式唔係一次過猜完整個版面,而係將設計當成 layer tree,由大區域開始逐層拆細,再用 verifier 檢查每一步成唔成立。呢個取向比起只做 OCR、只做分割,或者直接做多圖層分解更完整,代價就係系統較重,亦要配合多個視覺工具同較高 GPU 記憶體,當中 Qwen 相關 worker 官方已寫明大約要對應 55 GB 級別資源先容易跑得順。

相關模組之間的分工幾清楚:VLM controller 負責揀動作,文字會交由 PaddleOCR、字體辨識、Hi-SAM 同 LaMa 處理;物件與圖層則會用到 Qwen-Image-Layered、GroundingDINO、SAM 2、connected-component analysis 同 VTracer。換句話講,呢個項目唔係單一模型,而係把多個模型與工具串成一條可驗證的還原流程,較適合研究設計還原、可編輯圖形生成,或者想將靜態素材重新帶回設計工作流的團隊。

  • 單張平面圖可還原成可編輯 JSON hierarchy
  • 支援文字、向量形狀、圖片、群組與 z-order
  • 採用 coarse-to-fine tree expansion,加上 verifier 修正分支
  • 效能展示基於 Figma-909,指標上普遍優於多個 baseline

評測方面,項目頁面列出 Figma-909 這個 Dataset 數據集,並顯示 ReDesign 在 L1、PSNR、LPIPS、PQ 同 F1 等指標整體領先 baseline,說明它唔只重建外觀,亦較重視元素級別的可編輯性。儲存庫已提供 agent、baseline 同工具後端結構,但它更似一個研究系統而唔係輕量腳本;較值得留意的是多 GPU 分片、平行 worker 同視覺工具的資源安排,較適合有運算環境的研究者或產品團隊深入測試。
項目主頁 · GitHub

Categories: 開源, Agentic, 視覺模型, 多模態模型, Qwen, Image, 影像處理, Dataset 數據集

Krea 2 Outpaint:外擴 LoRA 補畫面

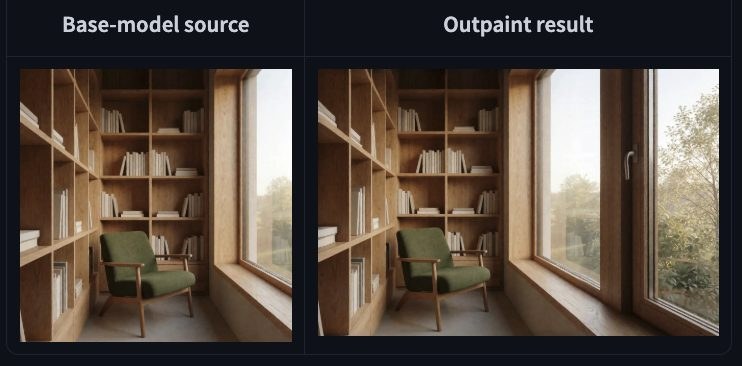
想將圖片自然延伸到更大畫布,又唔想主體走位,呢個 Krea 2 Outpaint 就係針對呢個卡位而來。它唔只做補邊,重點係知道原圖應該擺喺新畫布邊個位置。

Og image

畫面外擴最怕兩件事:原圖內容被改壞,或者延伸後透視、光線同結構接唔上。呢個項目明確建立在 Krea/Krea-2-Turbo 之上,並以 Krea 2 Raw 作訓練目標,形式係一個 rank-32 的 LoRA,用嚟做 image-to-image outpainting,重點唔係單純參考原圖,而係連原圖要放喺新畫布邊個區域都一併編碼。

它的做法是把來源 latent tokens 加上來自目標 bounding box 的 rotary coordinates,令 denoiser 能理解「已知畫面屬於整張新圖的哪個位置」。所以它比一般 image-reference adapter 更適合做左貼右擴、上貼下擴,甚至置中後向兩邊延伸,對透視、光照、紋理連續性的控制更直接。

檔案資訊相當清楚,但重點不在量化版本。頁面列出 krea2_outpaint_rank32.safetensors、pipeline.py、outpaint.py、example.py,另有授權與雜湊檔;同時明確說明 Hugging Face 自動產生的 Diffusers snippet 及一般 LoRA importer 不相容,要用隨附腳本與自訂 pipeline。這代表它不是即插即用型 LoRA,而係帶有功能性介面的適配器。

  • 基礎模型已指明為 Krea/Krea-2-Turbo,並針對 distilled 8-step inference 設計。
  • 核心差異在 registered reference_placements,可指定原圖在目標畫布的位置。
  • 已測試寫實、水彩、stylized 3D 等場景,涵蓋橫向、縱向與置中延伸。
  • 頁面沒有提供 GGUF、mmproj、llama.cpp、Ollama、LM Studio 或量化等資訊。

使用取向上,它更像為 Krea 2 編輯流程補上一個 UI 版的外擴能力,而唔係通用本地推理模型。由於依賴 diffusers 與自訂程式碼,適合已經在 Python 圖像流程中工作、需要穩定控制構圖位置的人。

項目主頁 · 模型

Categories: 開源, 視覺模型, Image, 影像模型, 影像處理, Ollama

MonkeyOCRv2 文件通用 OCR 底座

掃描文件、表格、公式到場景文字,往往要分開處理。MonkeyOCRv2想做的是用同一套視覺編碼器,接住多語言文件理解與 OCR 工作流。

overview

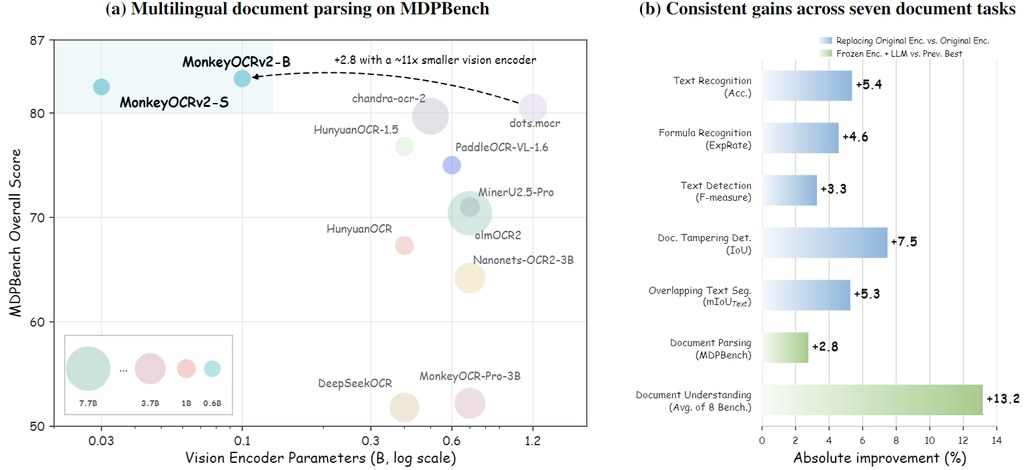
文件 AI 最麻煩的地方,在於文字辨識、版面解析、文件理解、公式辨識,甚至竄改檢測,很多時都要拆成幾個模型串起來。MonkeyOCRv2 把自己放在視覺文字基礎模型的位置,核心不是只追單一 OCR 指標,而是想用同一個 encoder 同時覆蓋多語言文件 parsing、understanding、text recognition、formula recognition 以至 scene text detection。

它採取的路線很明確:不像部分做法會按任務各自訓練小模型,MonkeyOCRv2 強調 fine-grained text modeling、cross-task representation learning 同 cross-lingual generalization,等於先把「文字作為視覺內容」這件事學得更深,再把能力分流到不同文件任務。這種取向的好處,是同一套底座較適合研究團隊或產品團隊整合工作流;代價則是現有資訊仍以模型發布為主,完整效能對比與部署細節還要結合論文與 checkpoint 再判斷。

現階段最值得留意的,是項目已不只放出單一模型名稱,而是分成幾條較清晰的能力線。 MonkeyOCRv2 vision encoder,以及面向 multilingual document parsing 的 MonkeyOCRv2-Parsing、面向 efficient document understanding 的 MonkeyOCRv2-Und,並提供 Hugging Face 與 ModelScope checkpoint,代表測試方式大致會圍繞下載權重後,按任務接入 parsing、recognition 或 understanding 流程,而不是單純打開一個聊天介面就完成。

  • 涵蓋 OCR、文件理解、公式辨識、竄改檢測、重疊文字分割等多類任務
  • 提供 MonkeyOCRv2-S、MonkeyOCRv2-B、MonkeyOCRv2-AS,不同 backbone 對應不同場景
  • S、B 版本偏向 Recognition / Parsing / Understanding,AS 版本偏向 Detection / Segmentation
  • 已公開 Demo、Hugging Face 集合與 MonkeyDocv2 數據集線索,方便交叉驗證

從現有公開資訊看,這個項目較適合做 Document AI、智能審核、票據與表單處理,也適合想比較 dots.mocr、PaddleOCR-VL、Qwen3-VL 這類路線差異的人。它未必是最輕量的選擇,但「一個編碼器橫跨多任務與多語言」這個方向,對需要長期維護文件工作流的項目有相當吸引力。

GitHub · Paper

Categories: 開源, 模型, 多模態模型, Qwen, OpenAI, 影像處理, 框架, Medical醫學, Dataset 數據集

RINO 用圖像編輯統一視覺任務

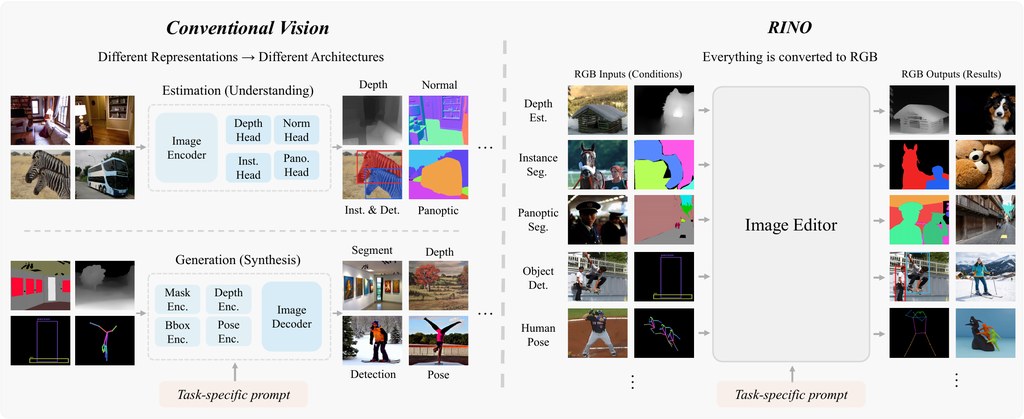
把深度、分割、姿態估計都改寫成 RGB 圖像輸入輸出,RINO 想驗證一個大膽方向:凍結式 image editor 能否直接兼任理解與生成。

RINO unifies vision under a single RGB interface: one frozen image editor, driven by a task-specific prompt, handles est

與其為每個視覺任務各自接駁 head、decoder 或 adapter,RINO 選擇更激進的路線:全部改寫成 RGB In, RGB Out。它屬於一個以 PyTorch 實作的研究型評測與實驗項目,核心問題是檢查單一凍結式 image editor,能否同時處理視覺理解與條件生成,而毋須為深度、segmentation、pose 之類任務另建模組。

這個定位帶來的吸引力很直接:流程統一、介面統一、後端也能互換。項目目前接上三個開源 image-edit 模型作為黑盒後端,包括 Qwen-Image-Edit、FireRed-Image-Edit 與 LongCat-Image-Edit;任務目錄結構一致,每個 task 都有獨立 evaluate 程式與 output 結果,方便逐項跑 benchmark,比起各任務各寫一套推理邏輯,整理與比較都省事得多。

但它的取捨同樣明顯。RINO 並沒有訓練新模型,也不做 fine-tuning,而是堅持用 released weights 直接測 zero-shot 表現;好處是比較乾淨,較能反映 image editor 本身的泛化能力,限制則是上限會被原生編輯模型綁住,對結構化輸出是否穩定、是否容易受 prompt 與渲染方式影響,仍要按任務逐個看。

  • 重點不是追求單一任務最佳成績,而是測試「同一個 RGB 介面」能否橫跨多類視覺工作
  • 三個後端可互換:Qwen-Image-Edit、FireRed-Image-Edit、LongCat-Image-Edit
  • 採用 copied official metric code 評分,數字理論上較容易與既有文獻對齊
  • 部署理解不複雜:安裝依賴後,按 task 準備 dataset,再選 BACKEND 與對應 MODEL 便可執行評測

較適合留意這個項目的,會是想研究 unified vision 介面、比較不同 image editor 泛化力,或者想把多個 benchmark 收攏到同一工作流的團隊。現有資訊未列出完整成績表,但它已清楚交代評測方法、資料夾規格與模型來源;作為研究驗證平台,價值在於提出一套可重覆比較的做法,而不是即刻取代每類任務的專用模型。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, Image, 影像處理, Python, Dataset 數據集

AMID 把醫學影像建模流程交畀代理協作

AMID唔係只幫你諗模型,而係想連驗證、提交物料同審計痕跡一併產出。你可以把它理解成面向醫學影像比賽與研究任務的自動化建模工作流。

AMID logo

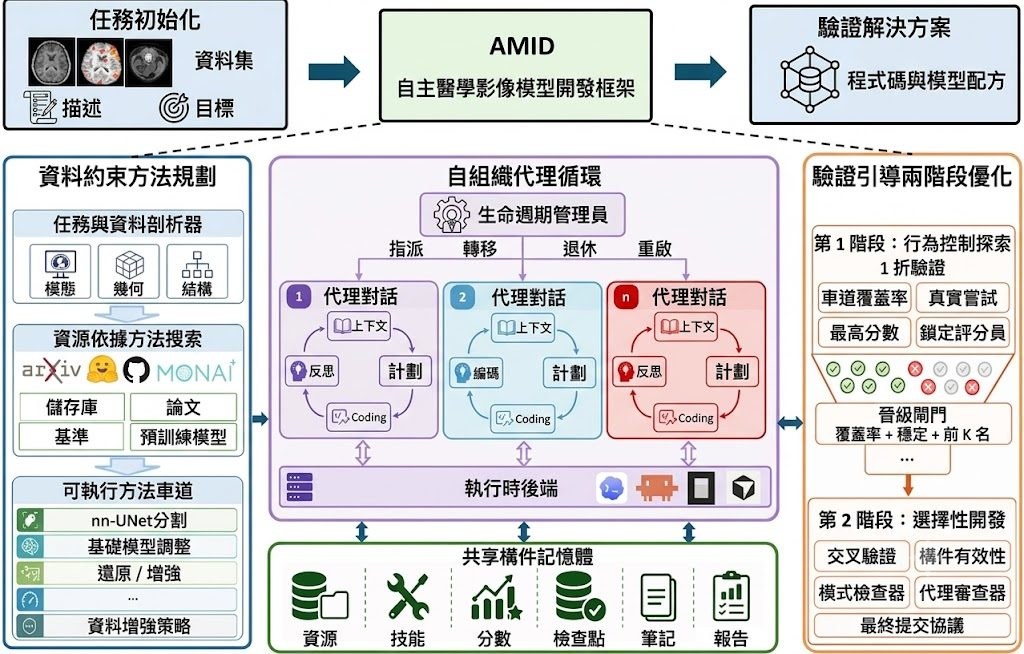
醫學影像建模最麻煩的位,往往唔係只係揀網絡,而係每個任務都有唔同資料形態、指標、切分規則同提交要求。AMID把呢個痛點拉到枱面:它屬於一個 autonomous multi-agent framework,目標唔係產生一段建議文字,而係交出可訓練、可推理、可驗證、可提交的完整模型產物。

現有通用 MLE agent 往往沿用比較粗略的搜尋與試錯範式,先提方案、再寫碼、再靠結果反覆修補;作者認為放到醫學影像場景,呢種做法容易忽略資料條件、驗證協議同提交格式。AMID改用 Data-Conditioned Method Planning,先按任務資料與可運行資源整理出可執行的 method lanes,再用 Verification-Guided Two-Stage Optimization 由早期廣泛探索,轉去後期集中追蹤有潛力路線,同時持續檢查 metric computation、validation protocol 同 prediction artifacts。

呢種取向的差異,在於它把「做得出分數」同「流程可核對」放埋一齊處理。對醫療 AI 團隊、挑戰賽參賽者,或者要同時管理 2D 影像、3D volumes、segmentation masks、class labels 等異質資料的人,AMID的吸引力在於減少人手串接流程的時間;代價是它目前仍以技術報告與任務解法報告為主,README亦寫明 source code 尚未釋出,暫時未到可以直接部署測試的階段。

效能方面,AMID用 ReX-MLE 的 20 個 medical imaging challenge tasks 做基準,比較對象包括一般用途 MLE systems,同時拿 human-designed challenge solutions 作參照。作者指出它整體表現優於被評測的通用系統,部分任務接近或追平人手設計方案;現階段較適合把它理解成一套清晰的方法論與工作流藍圖,而唔係即裝即跑的開源工具。

  • 核心定位係 autonomous multi-agent framework,處理醫學影像模型開發與驗證交付
  • 主要方法包括 Data-Conditioned Method Planning 同 Verification-Guided Two-Stage Optimization
  • 輸出唔止模型建議,仲包括 training code、inference code、weights、prediction files 同 audit trail
  • 基準測試來自 ReX-MLE 的 20 個任務,整體表現優於通用 MLE systems
  • 目前已公開 technical report 同 20 份 solution reports,source code 尚未發布

相關模型與系統脈絡方面,AMID直接對比的是 general-purpose MLE systems,同時以 human-designed challenge solutions 作為高水位參考。它未有把重點放在單一 backbone 或某個固定醫學影像模型,而是把多代理規劃、優化與驗證流程包成可重複的方法,呢點比單次調參工具更值得留意。

GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 多模態模型, 模型訓練, 微軟, Image, 影像處理, 框架, 香港, Medical醫學, 3D, Dataset 數據集

CtrlVTON 把虛擬試穿變成可控編輯

想像網購試衫唔只係換件衫上身,連鬆身、束入褲頭同疊穿位置都可以指定。CtrlVTON瞄準的,正正是這種以往 VTO 很難處理的控制感。

NXN LABS

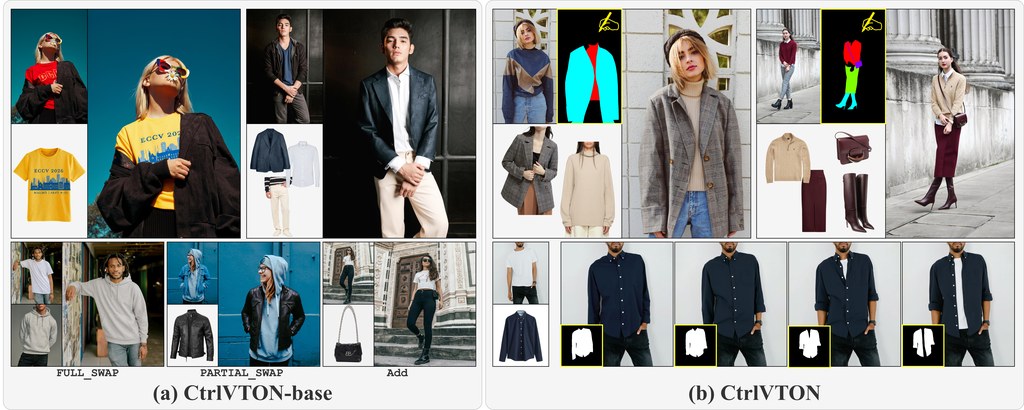
網購試衫最常見的落差,不是像不像,而是你根本無法指定件衫要點樣著。CtrlVTON 屬於影像生成與虛擬試穿項目,處理的是 Virtual try-on (VTO) 長期欠缺的可控性:同一件衫可以鬆身或貼身、束入或放出、打開或扣上,甚至改變穿著位置與疊穿方式。

現有做法多數把 VTO 當成 inpainting 問題,擅長補畫衣物,卻不容易精準跟住使用者指定的版型同位置。CtrlVTON 改用 image editing framing,再配合 segmentation mask 做 pixel-level control,重點不是單純生成得自然,而是令版面安排真正聽話。論文亦明確指出,它在服裝忠實度接近強勢 proprietary editing systems 的同時,對使用者提供的布局跟隨得更準。

支撐這套方法的另一半,是 Visual-Instance-Prompt Segmentation 與對應模型 VIP-SAM。以往常見的是 category-level visual-reference segmentation,但作者針對的是 instance-level 任務:先給你一張平拍服裝圖,再從人物穿著照片中分出同一件衣物。這一步對同類衣物干擾、遮擋,以及布料變形都更敏感,所以 VIP-SAM 會把 support features 提早注入 SAM backbone,目標是令定位更穩。

  • 把 VTO 由 inpainting 轉成 image editing,控制粒度更細
  • 用 segmentation masks 指定服裝大小、風格與身體上的位置
  • VIP-SAM 先解決「相中究竟係邊一件衫」的 instance-level 分割問題
  • 一個框架內處理 garment swapping、layering、selective switching、multi-garment composition
  • 已公開 VITON-HD-edit dataset,並有 arXiv 論文可交叉核對方法與結果

理解這個項目的較合理方式,不是把它當成即裝即用成品,而是研究型原型加資料集組合。,測試與部署會圍繞論文、GitHub 儲存庫,以及 Hugging Face 上的 VITON-HD-edit dataset 展開;較適合做可控試穿研究、電商影像流程驗證,或想比較 LoRA 式輕量微調能否取代大型封閉編輯服務的團隊。限制也很清楚:Project Page 尚未公開,README 釋出的安裝與推理細節仍不完整,現階段更適合有影像模型基礎的人先跟論文設定重現,再評估能否接入產品流程。

GitHub · Paper

Categories: 開源, Image, 影像模型, 影像處理, Dataset 數據集

phone-metrics:少量標註做語音音素切分

語音研究最花時間的一步,往往是逐段標好音素邊界。phone-metrics 指向一種更慳標註、又能同時做切分與辨識的做法。

Repository image for stephenmac7/phone-metrics

做語音分析時,最麻煩的不只是辨認講了甚麼音,還要知道每個 phone 在哪一刻開始、哪一刻結束。phone-metrics 對應的是一個語音研究項目,重點放在 phone segmentation 與 phone recognition 一起處理,目標是減少標註成本,同時保住辨識效果。

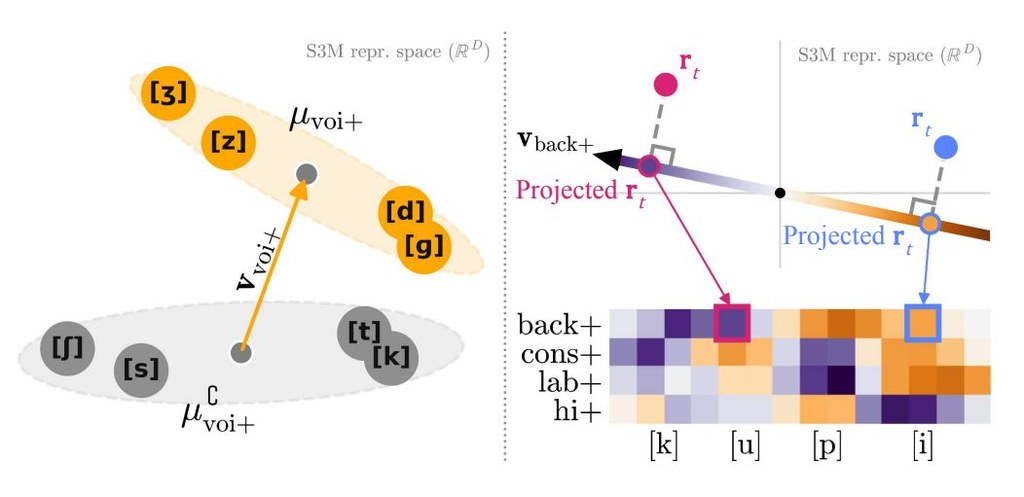
在語音處理中,有兩個核心任務: 音素分割(Phone Segmentation):找出一段話中,每個發音與下一個發音之間的「時間邊界」(例如在哪一毫秒從 [s] 轉變到 [z])。音素識別(Phone Recognition):認出這個發音到底是什麼音(類似音標)。傳統的做法: 這兩個任務通常是分開用不同的 AI 模型處理。而且,要訓練這種模型需要專家耗費大量時間(標註 1 小時的語音往往需要專家花 40 到 100 小時),成本極高。

現有做法常把 segmentation 和 recognition 分開建模,但這項工作認為兩者其實共享同一套語音結構,分開做會浪費訊號。作者改為從 self-supervised speech model(S3M)的表示中抽出 phonological feature activations,並用 SPAM(S3M-based Phonological Activation Mapping)把每個時間 frame 轉成像 voicing、nasality 這類語音特徵,再接兩個輕量、毋須 gradient descent 的 prediction heads,分別負責切分與辨識。

這個取向最值得留意的地方,是它對資料量要求很低。資料指出,少於一分鐘、而且帶 time-aligned phonetic transcriptions 的標註已可運作;同時它還能處理訓練期間未見過的 phones,對低資源語言、zero-shot phonetic analysis,甚至做跨語言比較都幾有吸引力。

  • 把 phone segmentation 與 phone recognition 聯合處理,唔再拆成兩個獨立流程
  • 依賴 self-supervised speech model(S3M)內部已有的語音結構,而唔係完全重新學起
  • SPAM 先把 frame 映射成 phonological activations,再交由兩個輕量 prediction heads 輸出結果
  • 標註需求非常低,少量 time-aligned phonetic transcriptions 已可測試方法價值
  • 已報稱在多個資料集上達到 SOTA phone segmentation,並取得穩健的 recognition 表現

部署和驗證這類項目時,較合理的理解方式不是把它當成即裝即用產品,而是研究型 pipeline:先準備語音資料與對齊好的音素標註,再接入 S3M 表示,之後檢查 segmentation 邊界與 recognition 輸出。它較適合語音研究團隊、低資源語言項目,或者想用更少標註測試新語音單位分析方法的人;若你要的是完整語音轉文字應用,它就不是直接替代 ASR 的那一路。

項目主頁 · GitHub · Paper

Categories: 開源, DeepSeek, 影像處理, Medical醫學, 語音, Dataset 數據集

ReChannel:用生成模型做密集預測

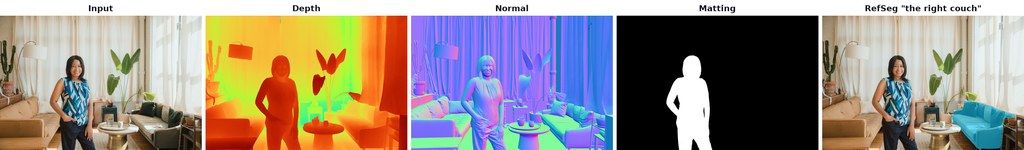
同一張圖直接讀出深度、法線、去背甚至文字指向分割,ReChannel把 text-to-image 模型變成實用視覺讀取器。它吸引人的地方,不在於加大模型,而是幾乎只靠輕量 LoRA 與線性頭完成轉向。

demo

一張 RGB 圖像想同時拿到深度、surface normal、matting 同 referring segmentation,通常意味住要換幾套模型;ReChannel偏偏反其道而行,將預訓練 text-to-image DiT 的空間 token 直接改作密集預測讀出。這不是完整訓練流程釋出,而是偏向 inference/質性展示的 GitHub 項目,定位很清楚:展示 FLUX-Klein 骨幹除咗生圖,亦可以做 pixel-space dense prediction。

它的類型更接近研究型模型讀出方法+推理示範工具,實際解決的是「可否沿用生成模型已有的空間表示,避免為每個密集任務重建一套重型解碼器」。做法上,骨幹維持 frozen,只為每個任務加 LoRA,再配一個 token-local linear head;標量任務頭部大約 33K 參數,surface normals 約 99K,沒有 convolution、沒有 upsampling,也沒有 target-side VAE decoder。

同類方法很多會把功夫放在額外解碼器或多尺度結構,ReChannel的取向剛好相反:盡量把空間結構留在 DiT token field 內,最後只做通道重映射。這種設計夠輕,但取捨亦直接,現有儲存庫沒有完整 benchmark pipeline,姿態估計亦未放入最小示範,所以更適合用來理解方法潛力,而非直接拿來做嚴格橫向比較。

  • 支援單張圖片推理,可輸出 depth、normal、matting、refseg,refseg 需要輸入文字描述
  • 依賴 CUDA GPU,首次執行會自動下載 black-forest-labs/FLUX.2-klein-base-4B 與對應 LoRA、線性頭權重
  • depth、normal、matting 會保留長寬比並可用 horizontal-flip TTA;refseg 固定在 512² 單次前向
  • 已公開的是 demo/inference 版本,不是論文表格所用的完整評測流程

受益最大的人,會是研究 dense prediction、生成模型再利用、或者想測試 LoRA 能否把同一骨幹轉成多任務視覺讀出的團隊。相關模型核心是 black-forest-labs/FLUX.2-klein-base-4B,再疊加每任務 LoRA adapters;對想研究生成模型表示能否外借到視覺理解工序的人,這個項目相當值得留意。

GitHub

Categories: 開源, 香港科技大學, NVIDIA, Stable Diffusion, Image, 影像處理, txt2img, Dataset 數據集

PanoWorld 把 360 影片生成拉回真實場景

想做會記得路徑同方位的全景生成,PanoWorld比一般短片模型更有方向感。它瞄準長距離一致性,重點不只係畫面靚,仲要前後場景講得通。

PanoWorld logo

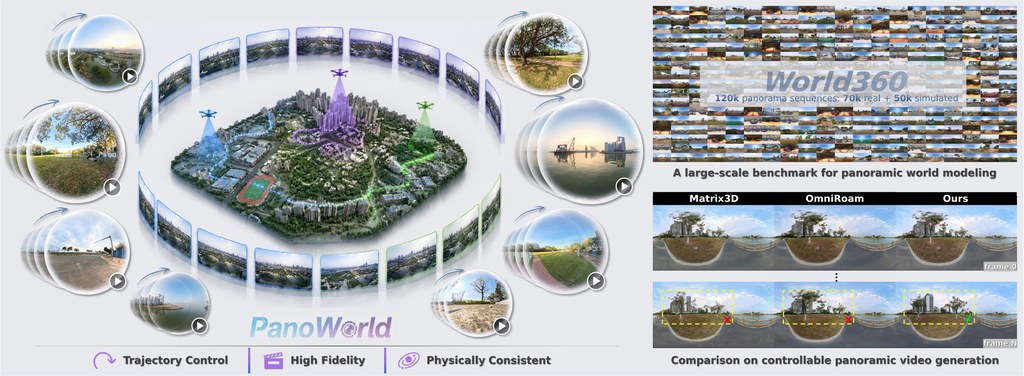
做 360° 影片生成,最易穿崩的往往不是單幀畫質,而是鏡頭轉了一大圈之後,場景記憶是否仍然連貫。PanoWorld屬於世界模型兼影片生成模型,針對全景 world model 的 long-range memory 問題,目標是生成更符合空間幾何與物理一致性的 panoramic video。

這個項目的取向幾明確:不是單純追求更短時間出片,而是利用 omnidirectional representations 的 rotation-equivariant 特性,將旋轉視為隱含幾何變換,再把相機軌跡簡化成固定朝向下的平移。核心做法包括 Dense Panoramic Ray-Conditioning (DPRC) 與 Geometry-aware Memory Augmentation (GMA),並建基於 Wan2.2 backbone 的 triple-stream DiT,處理當前動作建模與長程記憶。

現階段公開資訊較適合做推理測試與結果驗證,訓練代碼仍未釋出。環境要求也不算輕:Linux(已測 Ubuntu 22.04)、CUDA 12.8 以上、Python 3.10,並需要至少 20GB VRAM 的 CUDA GPU;README 亦提供 demo assets,可先用來跑 inference,觀察 81-frame 與 161-frame panoramic video 的生成表現。

  • 重點放在 long-range memory,而非只提升單段片段觀感
  • 可生成 81-frame、161-frame 的 panoramic video
  • 評測依託 World360,涵蓋真實全景無人機片段與 AirSim360 模擬資料
  • 官方表示在 World360 上明顯勝過其他方法,但目前公開細節以展示頁與推理資源為主

受益最明顯的,會是做 360 內容生成、沉浸式視覺、無人機視角模擬,或研究世界模型長時序一致性的團隊。它未必是最容易部署的項目,但定位很清楚:當一般 video model 在大範圍空間變化與光照變化下容易失憶,PanoWorld正面處理這個痛點,並且連同 World360 一起把評測場景拉近真實世界。

項目主頁 · GitHub

Categories: 開源, 清華大學, 視頻模型, 世界模型, NVIDIA, Video, 影像處理, 3D, Linux, Python, Dataset 數據集

GenCeption 單一模型多種視覺任務

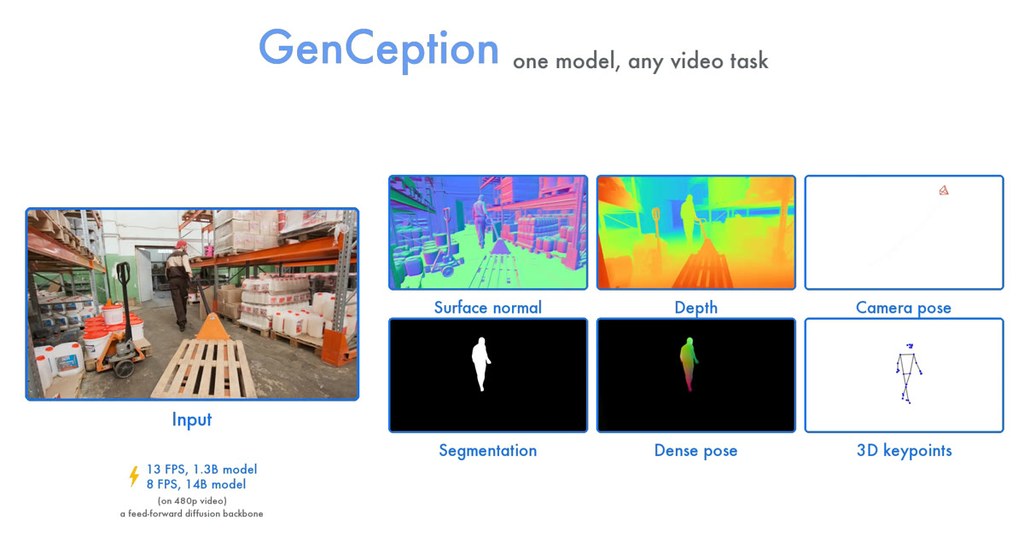
同一個模型就想處理深度、分割、姿態同關鍵點。GenCeption 把影片生成預訓練轉成通用視覺能力,方向相當清晰。

Og image

做影像理解時,很多人最頭痛的不是單一任務做唔到,而是每做一種任務就要換一套模型。GenCeption 屬於通用視覺模型,目標是把深度估計、法線、相機姿態、分割、2D/3D 關鍵點甚至 4D grounding 放入同一個流程,並且用文字指令控制輸出。

它處理的核心問題,是電腦視覺長期依賴任務專用模型,工作流容易分散、訓練與部署成本亦高。GenCeption 的做法,是先用 video generative diffusion model 做預訓練,吸收空間與時間上的 world priors,以及原生的 vision-language alignment,再經過 multi-task post-training,把原本偏生成式、多步驟的骨幹,改造成單步 feed-forward 推理模型。

這種路線跟常見做法最大分別,在於它不是為每個任務各自砌一個模型,而是用單一、task-agnostic architecture 應付 dense 與 sparse vision tasks。資料上亦以 synthetic data 為主,重點放在學習效率、sim-to-real transfer,以及遇到 out-of-distribution 物件類別時的泛化能力。

  • 支援多種視覺任務,包含 depth、surface normal、camera pose、segmentation、2D/3D keypoint prediction
  • 透過文字指令切換任務,保持同一模型介面
  • 把影片生成預訓練轉成 feed-forward 視覺推理,而不是停留在多步生成流程
  • 官方描述指它在多個任務上可與專用 SOTA 模型競爭,對比對象包括 DepthAnything3、D4RT、VGGT-Ω、SAM3、Sapiens、DAVID

對研究多模態模型、通用機械視覺,或者想整合複數感知任務的人來說,GenCeption 值得留意。現時公開內容仍以研究展示為主,Code 亦標示為 TBA,所以較適合先理解方法方向與能力邊界,再觀察後續開源與可重現程度。

項目主頁

Categories: 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Google, Video, 影像處理, 3D

Page 4 of 22
1 2 3 4 5 6 … 22