This AI Learned to Turn a Video Into Layers

Learning to Decompose Video into Layers 每一層都由一個完全可見的物件及其相關效果(如陰影和反射)組成。 https://www.youtube.com/watch?v=SD-VCNvTBg4
從影片創建 4D(動態 3D)場景 CAT4D 利用各種資料集組合上訓練的多視圖視訊擴散模型,以任何指定的資訊和時間下實現新的視圖合成來實現穩健的 4D 重建。

LTX-Video是第一個基於DiT的視訊生成模型 可以即時產生高品質視訊。它可以產生分辨率為 768x512 的 24 FPS 視頻,速度比觀看視頻的速度還要快。該模型在各種影片的大規模資料集上進行訓練,可以產生內容真實且多樣化的高解析度影片。 https://www.youtube.com/watch?v=PqMM_7Shn9E NEW VIDEO MODEL: LTXV day-1 Native Support in ComfyUI We’re excited, as always, to share that LTX Video (LTXV), the…


又一國內手足大作 ! 香港科大有份幫手!開源並已經可以下載。
又一國內手足大作 ! 香港科大有份幫手!開源並已經可以下載。

讓你直接編輯影像中的臉部表情。 gradio WebUI for AdvancedLivePortrait. Contribute to jhj0517/AdvancedLivePortrait-WebUI development by creating an account on GitHub. https://www.youtube.com/watch?v=P81puwCYOo0
GitHub - LituRout/RF-Inversion: Rectified Flow Inversion (RF-Inversion) (附 ComfyUI Node)Rectified Flow Inversion (RF-Inversion). Contribute to LituRout/RF-Inversion development by creating an account on GitHub.
超強AI擴圖!完全免費開源,diffusers-image-outpaint,附詳細本地安裝教程!- Diffusers Image Outpaint 是一種基於擴散模型的圖像生成方法。它根據現有圖像內容,生成圖像以外區域,使圖像看起來更自然和完整。
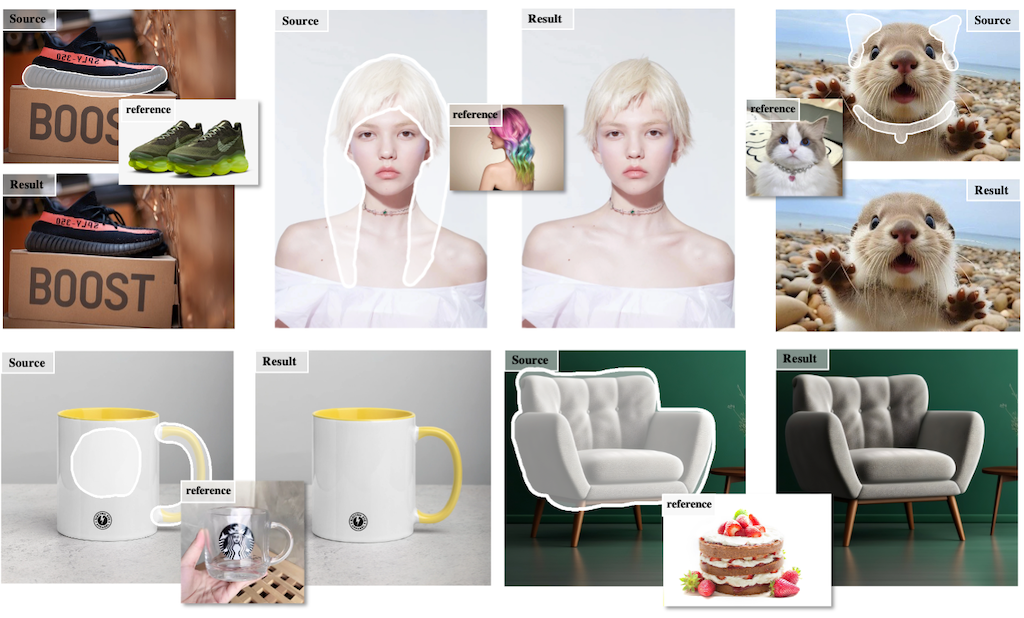
MimicBrush 的一種創新的圖像編輯方法,通過提供參考圖像來編輯圖片,而無需明確指定編輯的細節。MimicBrush 的核心思想是「模仿編輯」,只需在原始圖像中用 Brush 標記要編輯的區域,並提供一張參考圖片,模型就會自動理解參考圖像中與目標區域相關的語義,並將其應用於編輯。這種方法使用基於擴散模型的生成框架,通過從影片中隨機選取幀並遮罩部分區域來進行自行監督學習,使模型能夠捕捉不同圖像之間的語義關係,實現零樣本的圖像編輯。研究還提供了一個基準測試,旨在促進未來對此領域的研究。
MimicBrush 的一種創新的圖像編輯方法,通過提供參考圖像來編輯圖片,而無需明確指定編輯的細節。MimicBrush 的核心思想是「模仿編輯」,只需在原始圖像中用 Brush 標記要編輯的區域,並提供一張參考圖片,模型就會自動理解參考圖像中與目標區域相關的語義,並將其應用於編輯。這種方法使用基於擴散模型的生成框架,通過從影片中隨機選取幀並遮罩部分區域來進行自行監督學習,使模型能夠捕捉不同圖像之間的語義關係,實現零樣本的圖像編輯。研究還提供了一個基準測試,旨在促進未來對此領域的研究。